扩散模型当草稿,LLM 推理最高提速 6 倍
GitHub: https://github.com/z-lab/dflash
一句话总结
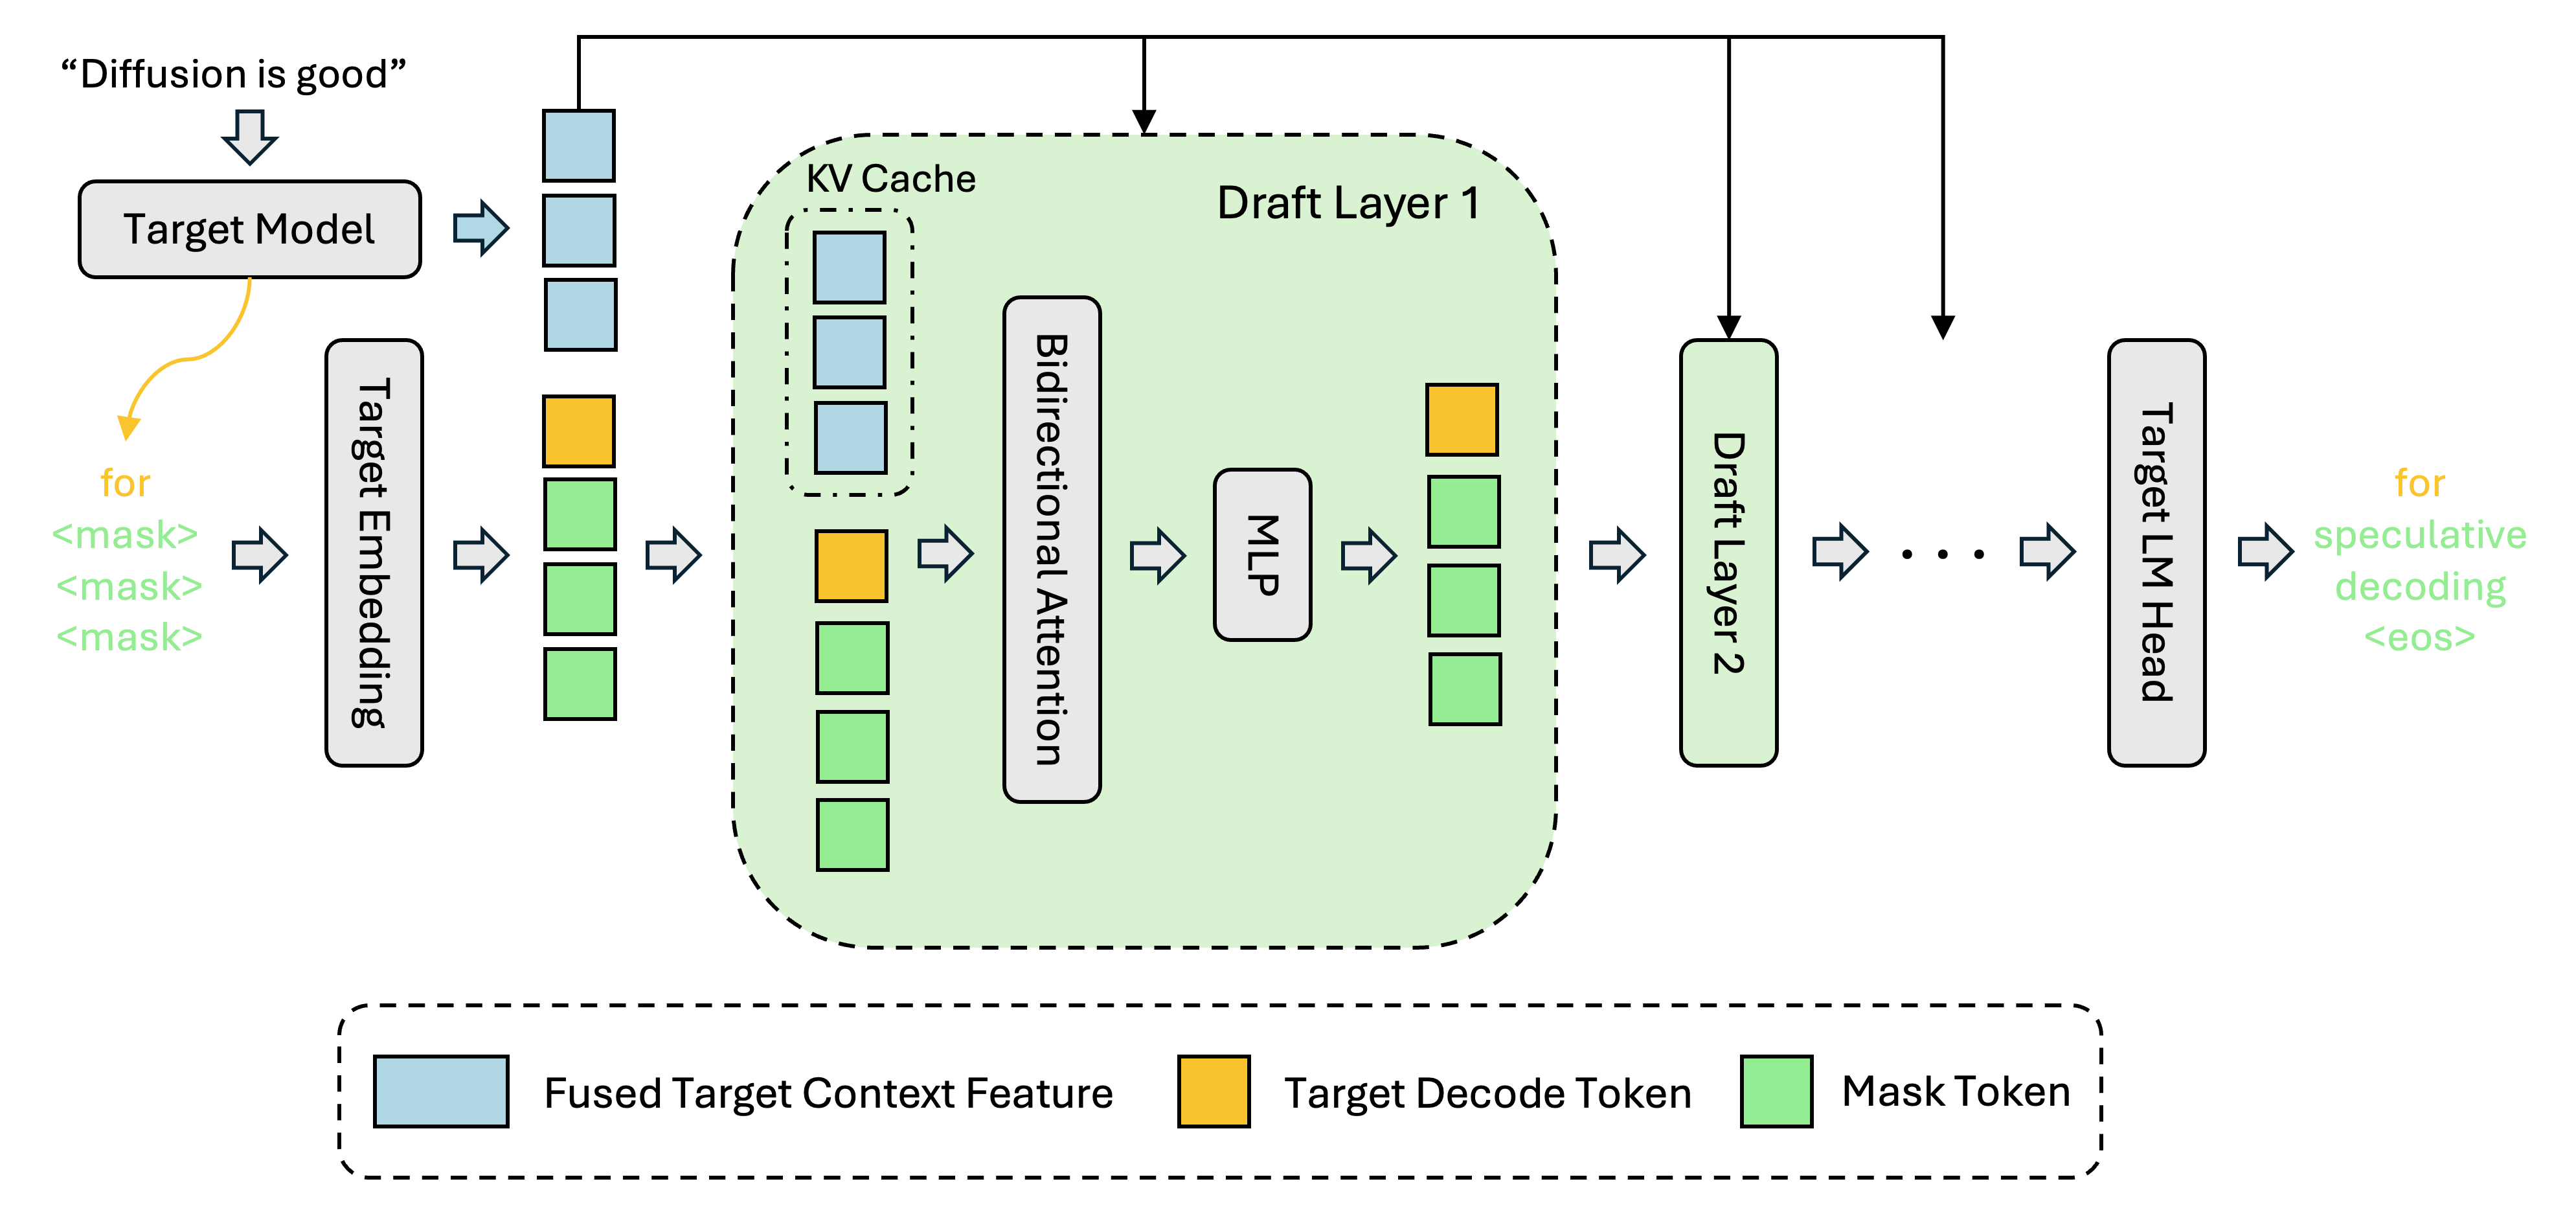
DFlash 把「块扩散(block diffusion)模型」用作投机解码(speculative decoding)的草稿器,给大模型推理提速。投机解码的原理是:让一个小而快的草稿模型一次性提议多个 token,大模型并行验证、接受正确的,从而在不损失质量的前提下加速生成。传统草稿器是自回归小模型(EAGLE、Medusa),逐 token 起草、速度封顶在 2-3×;DFlash 用扩散模型一次并行起草一整块(16 token),把投机解码的天花板抬到最高 6×(约为 EAGLE-3 的 2.4×)。它来自高效 AI 实验室 z-lab(PI Zhijian Liu),有论文 + 海量 HuggingFace 草稿权重,且已被 vLLM/SGLang 主线集成——是难得「论文 + 权重 + 工程落地」链路完整的研究成果。
值得关注的理由
- 范式级创新而非调参:用「扩散并行起草」替代「自回归逐 token 起草」,让起草成本几乎不随块长增长——这是把投机解码天花板从 2-3× 抬到 6× 的关键,不是堆 trick。
- 强工程可信度:研究成果被 vLLM v0.20.1+ 核心层主线接纳(NVIDIA 工程师推动)+ SGLang + Transformers + MLX(Apple Silicon) 多后端,区别于大量停留在玩具仓库的论文。
- 广泛适配主流开源 LLM:HF 上已发 20+ 草稿权重(gemma-4 / Qwen3.5·3.6 全系 / Kimi-K2 / MiniMax-M2 / gpt-oss / Llama-3.1 …),DeepSeek-V4 / GLM-5.1 coming。
项目展示
论文:arXiv:2602.06036 | 博客:z-lab.ai/projects/dflash | 模型:HuggingFace 合集。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/z-lab/dflash |
| Star / Fork | 4969 / 358(5 个月即破 4900,仍在爆发增长) |
| 代码行数 | ⚠️ 仅 1317 行、6 文件(Python 97.3%)——薄客户端 + 多后端胶水,真正价值在论文 + HF 权重 + 上游集成 |
| 项目年龄 | 5.1 个月(2026-01-04 起) |
| 开发阶段 | 稳定维护(峰值 2026-04 月 35 commit,核心已收口,近期低频更新模型列表) |
| 贡献模式 | 小型学术实验室(一作 Jian Chen 占 90%+,PI Zhijian Liu 挂名) |
| 热度定位 | 被低估的潜力股 / 小众精品(代码极简但价值密度高) |
| 质量评级 | 创新[高·扩散做草稿器] 背书[硬·MIT 韩松门下] 落地[已入 vLLM 主线] |
| License | MIT(研究项目里宽松友好,对二次训练/商用门槛低) |
作者视角:为什么存在这个项目
作者背景
z-lab(「Z Lab」,bio「Efficient AI. PI: Zhijian Liu」)。Zhijian Liu 是高效 AI 领域有声望的研究者——师从 MIT 韩松(Song Han),2024 年 MIT HAN Lab 博士毕业(方向高效 ML / TinyML / 模型压缩),经 NVIDIA Research 后任 UCSD tenure-track 助理教授,Google Scholar 引用 9000+。一作 Jian Chen(jianc99) 主导实现。这是「专做高效推理」的正经学术团队。
问题判断
LLM 推理慢、贵,投机解码是公认的无损加速路径,但被「草稿器必须自回归、一步一 token」的串行本质限制,speedup 多年封顶在 2-3×(EAGLE 系即代表)。团队看到的突破口是:草稿阶段并不需要严格自回归——扩散模型天然能并行生成多个 token,恰好契合「一次起草一整块」的需求。把扩散用作草稿器,就能让起草成本与块长解耦,从根上抬高加速天花板。
解法哲学
- 明确选择扩散做草稿器:非自回归并行起草,是全部加速增益的来源。
- 明确选择寄生式轻量设计:复用目标模型的 embedding 与 LM head,只训练少数中间扩散层(参数极小)。
- Feature Fusion + KV Injection:抽取目标模型隐藏态、把特征注入每一层草稿 KV cache(区别于 EAGLE-3 只在单层输入),再单步去噪并行出整块。
- 明确选择上游集成而非自建引擎:把支持做进 vLLM/SGLang,直接落到生产推理栈。
- 明确选择 MIT + 开放权重:宽松许可 + HF 权重动物园,最大化采用。
战略意图
DFlash 的意图是「把投机解码的速度上限往上推一个量级」,并通过「论文 + 开放草稿权重 + 主流引擎集成」让它真正可用,而非停在 benchmark。承诺「即将开源训练 recipe」以让社区自训草稿器适配任意 LLM——这一步若兑现,将把它从「z-lab 发的几十个权重」扩展成「人人可造」的通用加速器。
核心价值提炼
创新之处
- 扩散并行起草(最核心):一次前向并行起草一整块(16 token),起草成本几乎不随块长增长——官方称「多层 DFlash 起草 16 token 的延迟仍低于 1 层 EAGLE-3 起草 8 token」。
- 寄生式草稿器:复用目标模型 embedding/LM head,只训少数扩散层,参数极小、易适配。
- 特征注入到每一层 KV:Feature Fusion + KV Injection,比 EAGLE-3 单层输入注入更充分,提升草稿质量与接受率。
- 双向注意力起草(
is_causal=False):草稿块内可双向看,契合扩散的并行本质。
可复用的模式与技巧
- 用非自回归模型做草稿器:突破投机解码自回归瓶颈的思路,可启发后续加速研究。
- 寄生复用目标模型组件:只训增量层、最大化复用,降低训练与适配成本。
- 多后端薄客户端 + 上游集成:研究落地的工程范式——核心做进 vLLM/SGLang,仓库只留参考实现 + 基准。
- 统一多后端基准:
benchmark.py一套脚本测 Transformers/SGLang/vLLM/MLX 的吞吐、加速比、接受长度。
关键设计决策
- 扩散而非自回归草稿:差异化与全部增益来源。
- 寄生轻量:低成本适配众多目标 LLM 的前提。
- 收益依赖场景(见下):6× 是有前提的,需读者客观认知。
竞品格局与定位
竞品对比
| 方法 | 草稿方式 | 加速比 | 特点 |
|---|---|---|---|
| DFlash | 扩散并行起草整块 | 最高 ~6×(均值 4-5×) | 突破自回归天花板,已入 vLLM 主线 |
| EAGLE-3 | 特征级自回归 | ~2-3×(SOTA 基线) | 最主流、生态成熟,DFlash 头号对标 |
| Medusa | 多解码头并行 | 中等 | 实现简单,非贪婪下不保证无损 |
| Lookahead | Jacobi 迭代、免草稿 | 较弱 | 免训练 |
| Block Diffusion/LLaDA | 扩散语言生成本身 | —— | DFlash 的方法论血脉(但专做草稿器) |
差异化护城河
护城河 =「扩散式并行草稿这一差异化窄缝 + 显著超越 EAGLE-3 的实测加速 + 已被 vLLM/SGLang 主线接纳 + 海量开放权重 + 硬学术背书」。投机解码整体是红海(EAGLE 系主导),但「用扩散做草稿器」目前同路线竞品稀少——细分蓝海。
竞争风险
- EAGLE 系生态成熟:作为既有 SOTA、集成广,迁移惯性强。
- 训练 recipe 未开源:限制了「自训适配任意 LLM」,护城河尚未完全释放。
- 加速比的场景依赖:高吞吐大批量下投机解码收益递减,6× 不是普适。
生态定位
它是投机解码加速的前沿新范式,面向用 vLLM/SGLang 的推理团队与加速研究者。要立即可用且生态最成熟 → EAGLE-3;要追新范式 + 更高加速天花板 + 有对应 HF 草稿权重的目标模型 → DFlash。
套利机会分析
- 信息差:代码仅 1317 行却 4969 star,价值不在仓库代码量,而在「论文方法 + HF 权重 + 上游集成」整套生态——容易被「小仓库」误判。
- 技术借鉴:「非自回归做草稿器」「寄生复用目标模型」「特征注入每层 KV」对做推理加速极有启发。
- 生态位:低批量、延迟敏感的服务场景(如交互式对话、Agent 单请求)收益最大;要落地直接用 vLLM
[vllm]extra + 对应草稿权重。 - 趋势判断:投机解码加速持续是 LLM 推理工程热点;扩散草稿若训练 recipe 开源、覆盖更多模型,有望成为 EAGLE 之外的主流路线之一。
风险与不足
- ⚠️ 训练 recipe 尚未开源(最大空缺):头号 issue #1「Dflash training code」34 条评论——目前只能用 z-lab 已发布的草稿权重,无法自训适配官方未覆盖的 LLM。README 仅承诺「will open-source soon」。
- ⚠️ 加速比强依赖场景:issue #35「accept_len 高但吞吐低」——接受长度高 ≠ 吞吐高,收益取决于批大小/硬件/服务场景。6× 是低批量/延迟敏感场景的峰值,均值约 4-5×,高吞吐大批量下递减。
- 研究落地早期的工程门槛:gemma4 需临时 vLLM 构建/专用 Docker(#47),Docker 镜像还有权限问题(#101);新模型上手有真实摩擦。
- 仓库是薄客户端:核心工程重量在上游 vLLM/SGLang 集成 PR 与 HF 权重,不在这 1317 行——评估时别只看仓库。
- 内容安全:无敏感问题。
行动建议
- 如果你要用它:你在用 vLLM/SGLang 做 LLM 推理服务、且目标模型在它支持列表里(gemma-4/Qwen3.5·3.6/Kimi-K2/gpt-oss/Llama-3.1 等),想在低批量/延迟敏感场景拿到数倍无损加速——值得一试(
uv pip install -e ".[vllm]"+ 下载对应草稿权重)。要立即可用且生态最成熟 → 先看 EAGLE-3。客观预期:均值 4-5× 而非恒定 6×,高吞吐场景收益打折。 - 如果你要学它:重点读
dflash/model.py(DFlash 草稿模型 +dflash_generate投机解码主循环:块级并行起草 → 目标模型 verify → 按 cumprod 算接受长度 → crop KV cache)、dflash/benchmark.py(多后端基准),并配合论文理解 Feature Fusion + KV Injection + 单步去噪。 - 如果你要 fork/借鉴它:MIT 友好;最有价值的是借鉴「非自回归草稿器 + 寄生复用 + 特征注入每层 KV」的设计。注意训练 recipe 未开源,自训暂不可行——可关注其后续放出。
知识入口
| 资源 | 链接 |
|---|---|
| 论文 / 博客 / 模型 | arXiv:2602.06036 | z-lab.ai/projects/dflash | HuggingFace 草稿权重合集 |
| DeepWiki | https://deepwiki.com/z-lab/dflash (已收录,约 25 主题) |
| 作者 | Zhijian Liu 主页(PI)| Jian Chen(一作,jianc99) |
| 竞品/背景 | EAGLE-3 论文 | SafeAILab/EAGLE | Medusa | Block Diffusion/LLaDA |