GitHub推荐:阿里通义 19.5K stars 旗舰:Tongyi DeepResearch 怎么用 3.3B 激活参数做开源 Deep Research Agent
一句话总结
阿里通义实验室 2025 下半年系统性推出的开源 Deep Research Agent 旗舰项目——30.5B 总参 / 3.3B 激活 MoE 模型(基于 Qwen3 MoE)+ 完整 CPT→SFT→RL 训练栈 + 双推理范式(ReAct 评估 / IterResearch Heavy 上限),是开源生态首个在 HLE / BrowseComp / GAIA 等综合基准上对标 OpenAI Deep Research 的完全可复现项目。
值得关注的理由
- 唯一开源权重的 SOTA Deep Research Agent:30B-A3B 模型权重已发布在 HuggingFace(单月 10.5 万次下载、813 likes),并接入 OpenRouter API 与阿里云百炼商用服务;同期同赛道的 OpenAI Deep Research、字节豆包深度研究均闭源。
- 17 篇系列论文 + 56 作者技术报告构成完整研究谱系:从 WebWalker(ACL 2025)→ WebDancer(NeurIPS 2025)→ WebSailor / WebShaper / WebWatcher / WebResearcher / ReSum / WebWeaver / AgentScaler / AgentFounder 一脉相承,覆盖「数据合成 → 训练范式 → 推理策略 → 评估方法」全链条。
- 核心可复用方法论对学术界开源:leave-one-out advantage + token-level policy gradient、ReSum 周期压缩、WebShaper 集合论形式化数据合成、Hybrid Reward(ISR + ISE)等关键技巧在 README 中显式列出,是 Agentic RL 训练不可多得的中文开源参考。
项目展示
 — 项目主视觉与品牌标识
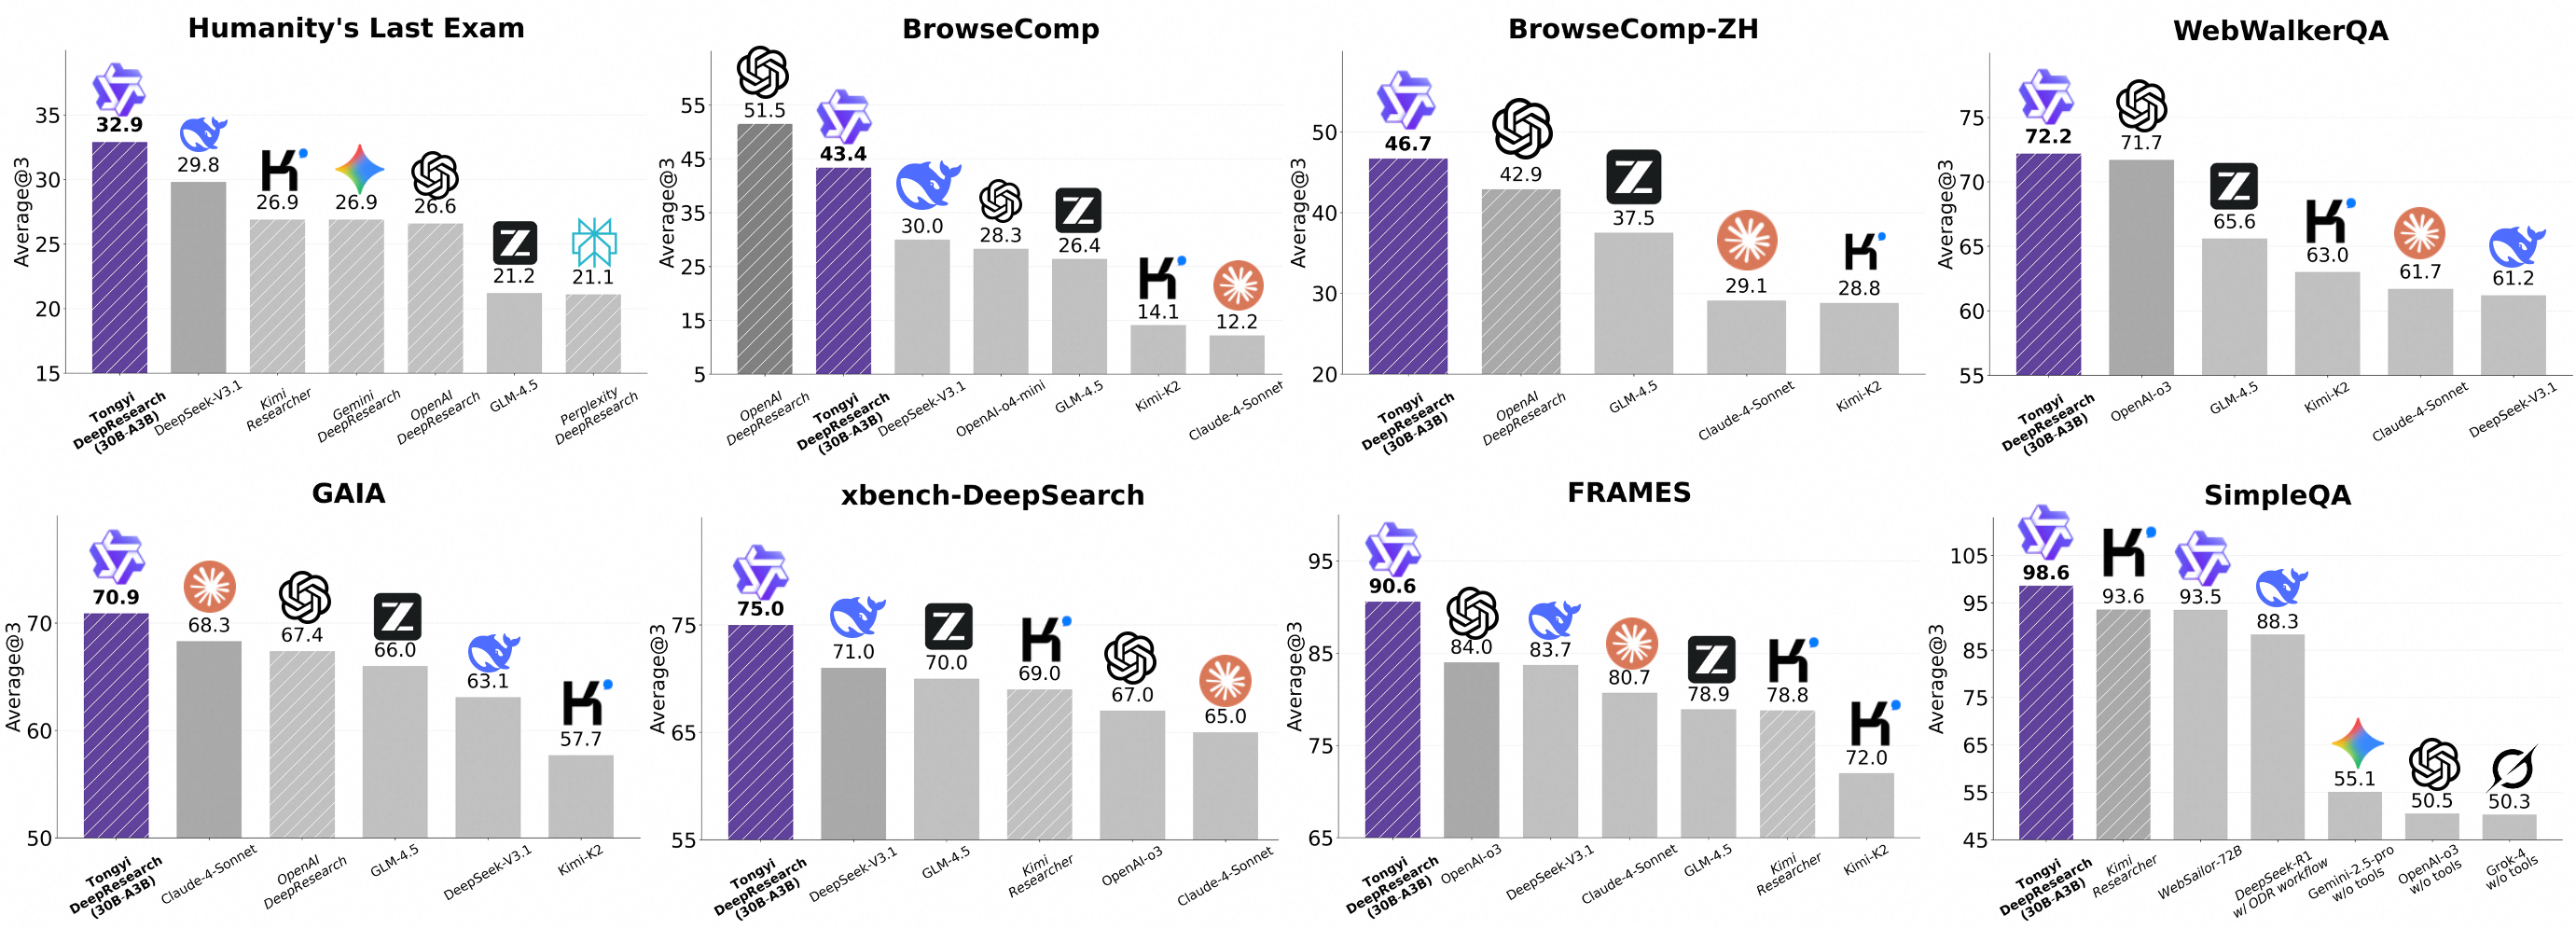 — 各综合基准(HLE / BrowseComp / GAIA / xbench-DeepSearch)的对标结果一览
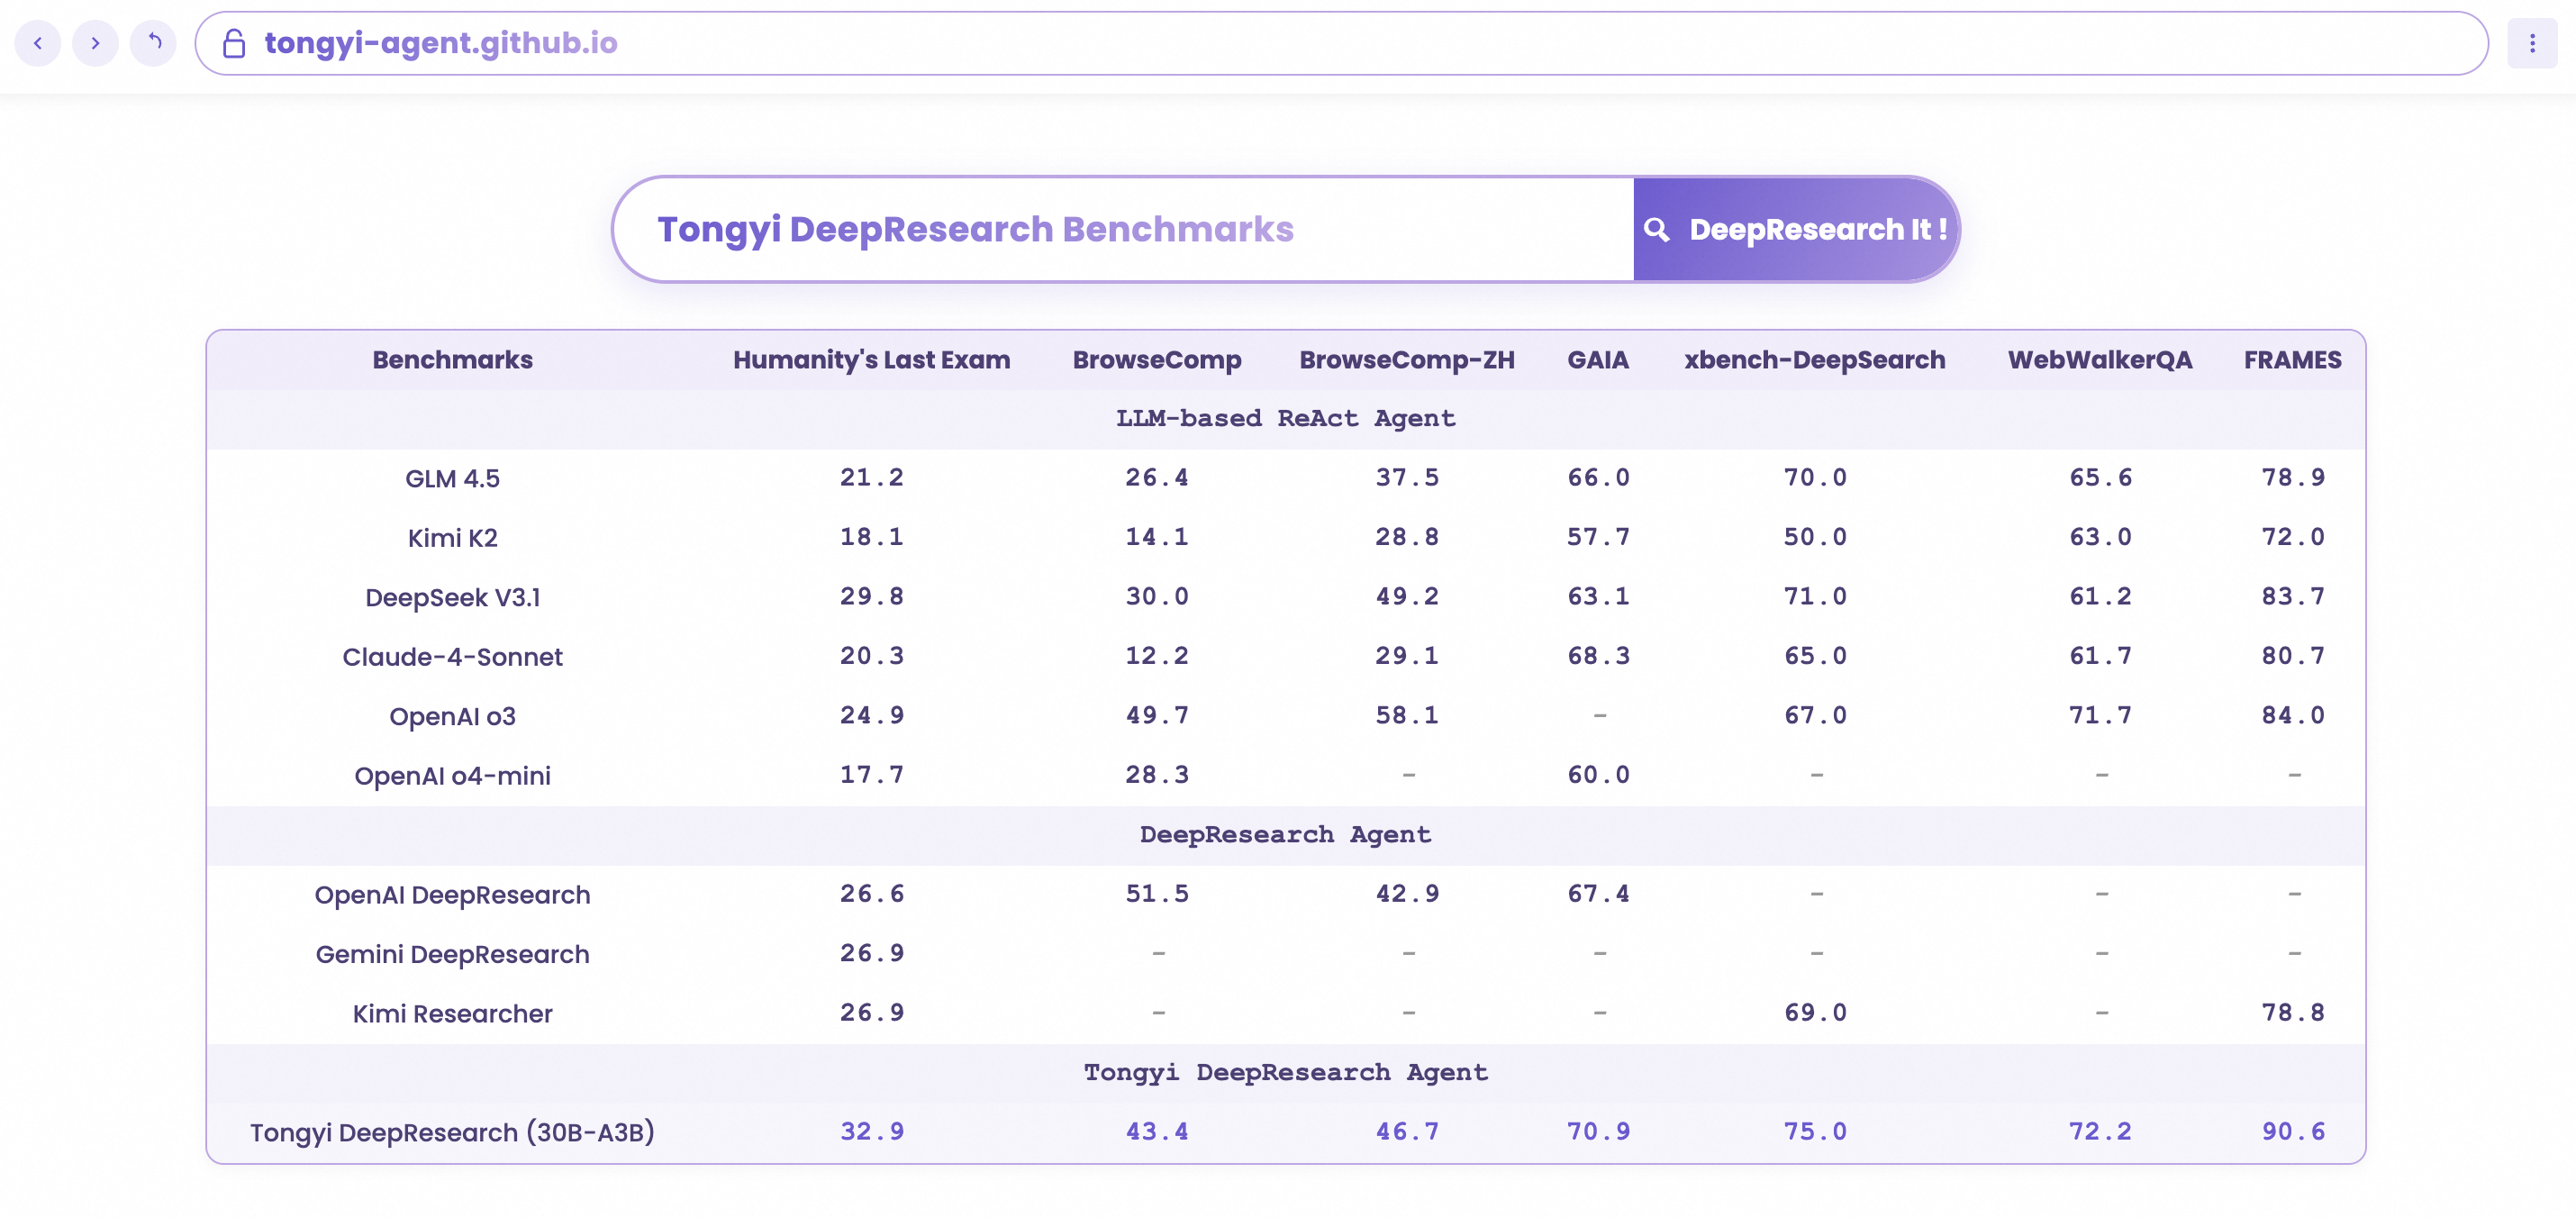 — 具体得分与竞品横向对比
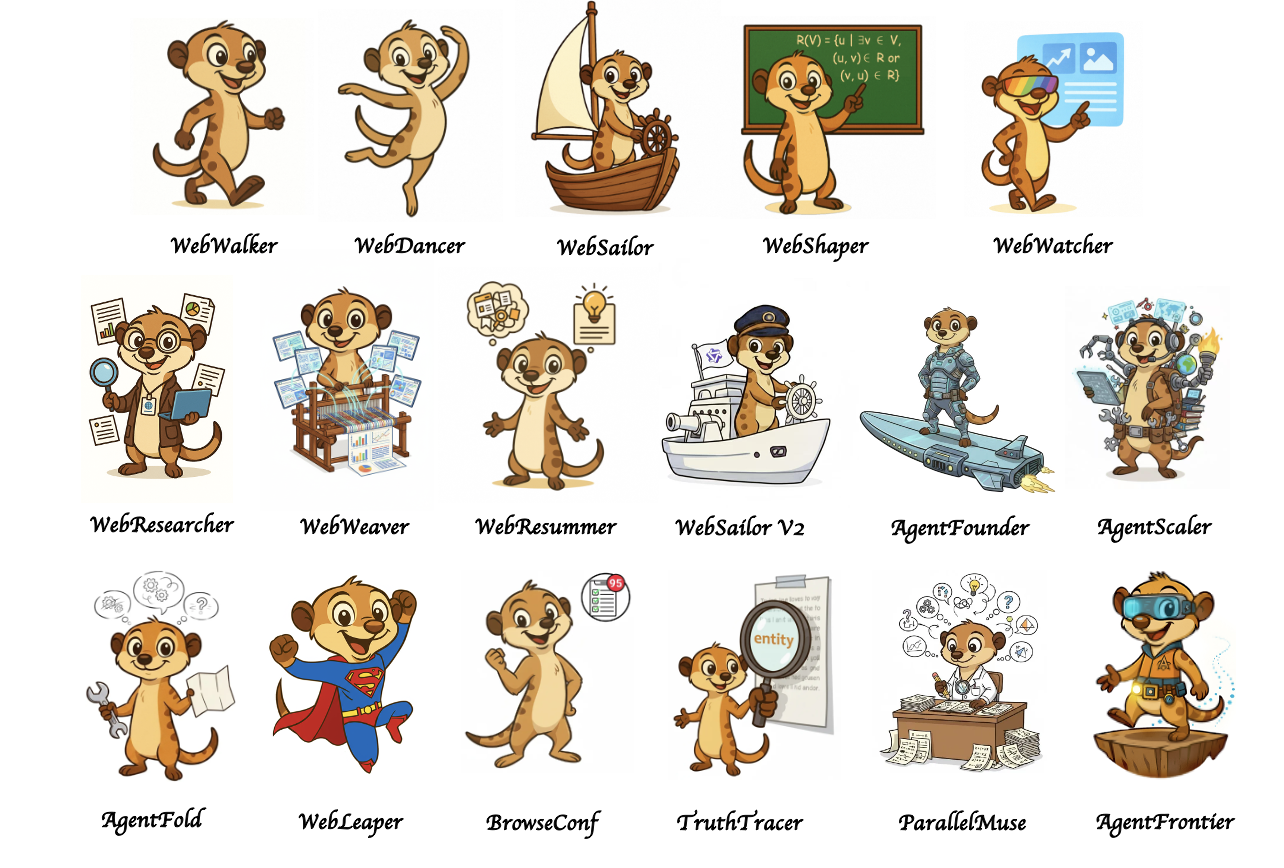 — 17 篇前置工作 + 模型谱系图,完整呈现研究脉络
 — 阿里云百炼 deep-search 商用部署入口
Star History Chart — 历史增长曲线
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/alibaba-nlp/deepresearch |
| Star / Fork | 19,521 / 1,493 |
| 代码行数 | 22,880(Python 97.9% / Shell 2.0% / Dockerfile 0.1%) |
| 项目年龄 | 17.4 个月(首次提交 2025-01-09) |
| 开发阶段 | 低维护(近 90 天 0 commit,2026-02-27 后无活动) |
| 贡献模式 | 核心 5 人 + 32 人外围(主作者 Jialong Wu 占 38.4%) |
| 热度定位 | 大众热门(19.5K stars,2025-07 GitHub Trending #1) |
| 质量评级 | 代码[一般] 文档[优秀] 测试[无] |
作者视角:为什么存在这个项目
创始人/作者背景
alibaba-nlp 是阿里达摩院 / 通义实验室 AI 搜索技术团队的官方组织账号(注册 6.2 年、43 个公开仓库),同时维护 ZeroSearch / VRAG / ViDoRAG / CHRONOS / ArenaRL 等多篇关联研究。DeepResearch 是该组织投入权重最高的旗舰项目——首个冲破 19k star,是阿里对标 OpenAI / Anthropic / 字节豆包 Deep Research 赛道的主力阵地。
主作者 Jialong Wu(109 commits / 38.4%)联合 callanwu、likuanppd、WenbiaoYin、ZhenZhang 等 5 人核心团队,加上 32 人外围贡献者,形成「明星研究小组」格局。组织同时维护 Qwen 系列基座模型,技术资产深厚。
问题判断
作者看到了三个被忽视的瓶颈:
- 数据瓶颈:人工标注 SFT 轨迹既贵又不可规模化——主流 Agent 项目(AutoGPT、MetaGPT 等)都卡在「人标数据」上。
- 训练范式瓶颈:标准 GRPO 在 Web Agent 上不稳定(on-policy 偏离 + 负样本爆炸 + token-level 奖励稀疏),缺乏定制化方案。
- 推理范式瓶颈:ReAct 单上下文长程推理会遭遇「context suffocation / 中段信息遗失 / 噪声污染」三大问题,单一架构难以兼顾「公平评估」与「测试时扩展上限」。
时机选择:2025 下半年 Web Agent 赛道进入白热化(OpenAI o3、Anthropic Computer Use、字节 Deer-Flow),团队以「饱和发布」节奏(半年内每月一篇技术报告)快速占据开源生态位。
解法哲学
核心哲学:「No human annotation, environment-scaling instead of human-scaling」——把 Agentic RL 的瓶颈从「人标数据」转嫁到「可扩展沙箱 + 合成数据 + 选择性负样本过滤」。AgentFounder / WebShaper / WebLeaper / AgentScaler 全部围绕「数据合成 pipeline」展开。
明确选择的取舍:
- 不发布训练数据(FAQ 显式说明):训练数据是组织最核心壁垒,是「open-core with data moat」姿态。Issue #35 显示社区对这一姿态持续追问。
- 不发布完整 Heavy Mode:仅开源 ReAct 推理部分,IterResearch / ReSum Heavy 模式后续逐步释放。
- 不发布 SuperAgent 编排框架(vs 字节 Deer-Flow):选择单 Agent 长程推理路线,不做多 Agent 编排。
- 不依赖 LangChain / LlamaIndex 生态:核心依赖为自家 qwen-agent + vllm/sglang/litellm,自成体系。
战略意图
这是阿里通义实验室「AI 搜索」团队的对外门面项目,明确走三层分发路线:
- 研究层:arXiv 2510.24701 技术报告 + 17 篇系列前置论文
- 模型层:HuggingFace / ModelScope 开源权重 + OpenRouter API 上架
- 商业层:阿里云百炼「deep-search」商用服务 + ModelScope/HF Spaces 在线 demo
开源策略是「genuinely open for reproducibility, but data is the moat」——方法 + 模型权重 + 推理代码全开源;训练数据 + Heavy Mode 部分开源。技术报告已自陈「next era of AI researcher」的愿景。
核心价值提炼
创新之处
按新颖度 × 实用性排序:
-
WebShaper 集合论形式化数据合成(新颖度 5/5)
- 把信息检索任务形式化为「Knowledge Projection(实体集合)+ R-Union + 交集」运算,Expander agent 先验证形式化再生成问题——保证合成数据无「推理捷径」(防止模型用关键词绕过实体链)
- 适用场景:训练数据质量差、模型靠关键词作弊的 Agent 项目
-
ReSum 周期压缩 + ReSum-GRPO 范式适配 RL(新颖度 5/5,实用性 5/5)
- ReAct 主循环里每 N 轮或 token 达到 90% 上限时,调用独立 30B 摘要模型压缩历史,再以「Question + 上一份 summary」重建消息列表继续
- RL 训练时把长轨迹分段,把整轨迹 advantage 广播到所有段
- 适用场景:所有长上下文 Agent 的训练 + 推理(可直接复用
summary_utils.py)
-
AgentFounder CPT 阶段 + Open-World Memory 合成(新颖度 4/5)
- 在标准 SFT/RL 之外新增「Agentic Continual Pre-training」阶段,把持续更新的数据流转成「open-world memory」合成多风格 QA
- FAS(Planning/Reasoning Action Synthesis)+ HAS(Decision-Making Action Synthesis)三套合成模式
- 适用场景:任何想用合成数据做 pretrain 的 Agent 项目
-
WebResearcher 的「Think / Report / Action」三轮式迭代(新颖度 4/5)
- 每轮不是「累加上下文」,而是「丢弃 Think、累积 Report、用 Action 决策下一步」——Report 作为「演进式中心记忆」传给下一轮
- 适用场景:所有 ReAct 上下文爆炸问题的解药
-
WebWeaver 双智能体(Planner + Writer)+ 动态大纲(新颖度 4/5)
- Planner 在 outline 草稿上不断插入 search/visit,根据新发现调整大纲;Writer 按大纲分段写作,每段去 memory bank 精确取 evidence——避免「loss in the middle」
- 适用场景:开放式深度研究(写报告、文章)的 Agent,适合做成可复用框架
-
on-policy GRPO + leave-one-out advantage + 选择性负样本过滤(实用性 5/5,可迁移性 5/5)
- 标准 GRPO 用 group mean 做 baseline,离群负样本会污染整组;leave-one-out 改用「剔除当前样本后的组均值」+ 对负样本做规则过滤(过短/过早截断的丢弃)
- 适用场景:所有用 GRPO 训练 Agent 的项目都能直接借鉴(README 自陈)
可复用的模式与技巧
-
<tool_call>...</tool_call>XML 字符串协议 + stop token 截断(inference/react_agent.py)- 替代 OpenAI Function Calling,支持
<think>+<tool_call>+tool_response+<answer>四种 tag 混合 - 适用:任何需要 LLM 混合输出「思考+工具调用+答案」的项目
- 替代 OpenAI Function Calling,支持
-
FnCallAgent 子类化 + custom_call_tool 重写(
qwen_agent.agents.fncall_agent.FnCallAgent)- 在 qwen_agent 框架上自定义 ReAct 主循环
- 适用:想快速原型自定义 ReAct 行为的 Agent 项目
-
visit 工具的 LLM-as-Extractor 三段式 JSON 抽取(
inference/tool_visit.py)- Jina 取页 → tiktoken 截断到 95K → 调外部 LLM 按 EXTRACTOR_PROMPT 抽取
{rational, evidence, summary}JSON → 格式化为Evidence in page: ... Summary: ...返回 - 适用:所有 RAG / Deep Research 系统的网页内容理解层
- Jina 取页 → tiktoken 截断到 95K → 调外部 LLM 按 EXTRACTOR_PROMPT 抽取
-
search 工具的 batched multi-query + Serper.dev + 中英文自动分流(
inference/tool_search.py)- 适用:多语言混合搜索场景
-
run_multi_react.py 的 sticky port + 断点续跑
- 同一 question 始终走同一端口(轮询分配 + 粘性映射字典),按 question 跳过已处理
- 适用:大批量 Agent 评估场景
-
file_parser 双路径(本地库 + 云 IDP)+ sha256 缓存(
inference/file_tools/file_parser.py)USE_IDP环境变量切换:True 时走 alibabacloud-docmind-api,False 时走本地 pdfminer/pdfplumber- 适用:多格式文档解析层的可降级设计
-
多 vLLM/sglang 端口轮询 + sticky session(
WebAgentFold/infer.py)- 起 6~8 个 sglang 实例,主循环轮询调度
- 适用:所有大模型高吞吐部署
关键设计决策
-
决策:基于 qwen_agent 框架的 FnCallAgent 基类
- 问题:13 个子项目都需要 ReAct 主循环,重写成本高
- 方案:直接继承
FnCallAgent,重写_run()+ 自定义call_server()+ 自定义custom_call_tool() - Trade-off:获得快速原型能力,但每个子项目都「在框架外缝合」主循环(直接拼接字符串而非走框架的 message schema),代码风格差异大、bug 易发
- 可迁移性:高
-
决策:双推理范式架构(ReAct 评估 + IterResearch Heavy 模式)
- 问题:单一推理范式难以兼顾「内在能力评估」与「测试时扩展上限」
- 方案:ReAct 主循环用于「核心能力压测」(benchmark 公平分数);IterResearch / ReSum 用于「生产上限冲刺」(多次迭代合成新 insight 决定下一步)
- Trade-off:两套架构维护成本高,但 README 自陈这是「首次在综合基准对标 OpenAI Deep Research」的关键
- 可迁移性:中——任何追求 SOTA 又想保公平评估的研究团队都需要这种分离
-
决策:工具失败时返回字符串错误(而非 raise)
- 问题:LLM 不擅长处理 Python 异常,需要可读错误消息让 Agent 自我恢复
- 方案:所有 tool_*.py 在失败时返回
f"[ToolName] Failed to ...: {error}"字符串,由 LLM 决定下一步 - Trade-off:容错性强但容易把「严重错误」淹没在长上下文里
- 可迁移性:高——所有 Agent 工具层都该遵循此原则
-
决策:并发驱动 + 粘性端口分配(
run_multi_react.py)- 问题:同一问题多 rollout 评估时,需均匀分摊到多个 vLLM 端口避免单点瓶颈;同时保证同一 question 始终走同一端口(缓存/复用)
- 方案:
planning_ports = [6001...6008],question_to_ports = {}字典 + 轮询分配 + 粘性映射 - Trade-off:实现简单,天然支持断点续跑
- 可迁移性:高
竞品格局与定位
竞品对比矩阵
| 维度 | Tongyi DeepResearch | bytedance/deer-flow | OpenHands | MetaGPT | Claude Code |
|---|---|---|---|---|---|
| Stars | 19.5K | 73K | 78K | 69K | N/A (产品) |
| 主战场 | 长程信息检索 | 通用 SuperAgent harness | SWE 编程 | 多 Agent SOP | CLI 编码 |
| 模型权重开源 | ✅(30B-A3B MoE) | ❌ | ❌(框架) | ❌ | N/A |
| 训练栈开源 | ✅(CPT→SFT→RL 全部公开) | ❌ | ❌ | ❌ | N/A |
| 学术 benchmark 透明 | ✅(HLE / BrowseComp / GAIA) | ⚠️(部分) | ✅(SWE-Bench) | ⚠️ | N/A |
| Harness 工程化 | ⚠️(research-grade) | ✅(sandbox + memory + subagents) | ✅ | ✅ | ✅ |
| 商业化服务 | ✅(阿里云百炼) | ⚠️(火山引擎) | ⚠️ | ⚠️ | ✅ |
| 教学价值 | ⚠️(论文丰富但代码不友好) | ✅ | ✅ | ✅ | ✅ |
差异化护城河
技术护城河最强:on-policy GRPO + 17 篇论文 + 双推理范式 + 30B-A3B MoE 全栈自研,是开源生态首个对标 OpenAI Deep Research 的完全可复现项目。
信任护城河次之:通义实验室官方组织 + OpenRouter/HF/百炼多层分发 + arXiv 技术报告可追溯 + 半年连续产出节奏。
数据护城河隐含:训练数据不开放(FAQ 显式),是组织最核心壁垒。
竞争风险
最可能被字节 Deer-Flow 替代(harness 生态更厚、产品化更好、star 数 73k vs 19k)。也面临 OpenAI Deep Research 持续迭代(如果其开源的话)。
短期风险:Qwen3 MoE 在 transformers/vLLM 不同版本下兼容性参差(Issue #209 / #206 印证部署痛点),OpenAI-兼容推理路径在 tool-call / 多步规划下的稳定性问题。
生态定位
在「Deep Research Agent 旗舰」赛道扮演「研究型 Agent 基座模型」角色——类似 RAG 时代的 ColBERT / Qwen-Agent 之于 LangChain:不是最大,但学术最完整。
不是「最大」:star 数和 harness 成熟度低于 Deer-Flow / OpenHands / MetaGPT。
是「学术最完整」:唯一开源权重的 SOTA 深度研究 Agent + 完整训练栈(CPT→SFT→RL)+ 自研 on-policy GRPO + IterResearch Heavy 推理范式。
套利机会分析
- 信息差:否。已显著溢价(19.5K stars / HuggingFace 单月下载 10.5 万 + 813 likes / OpenRouter 上架 / 阿里云百炼上线),属于「明星公开项目」而非被低估。但研究/工程价值仍极高,对 Agent RL 研究者是难得的中文开源参考。
- 技术借鉴:核心可迁移模式包括:
- ReSum 周期压缩(直接复用
WebResummer/src/summary_utils.py) - leave-one-out advantage + 选择性负样本过滤(README 显式列出)
- WebShaper 集合论形式化数据合成(训练数据质量保证)
- visit 工具的 LLM-as-Extractor 三段式 JSON 抽取(RAG / Deep Research 通用)
- run_multi_react.py 的 sticky port + 断点续跑(批量评估通用)
- ReSum 周期压缩(直接复用
- 生态位:填补了「开源 SOTA Deep Research Agent」这一空白——之前要么是闭源(OpenAI / 字节豆包)、要么是研究范式(MetaGPT)、要么是 SWE 偏重(OpenHands)。DeepResearch 是首个「学术完整 + 商业落地 + 工程可用」三位一体的开源项目。
- 趋势判断:2025 H2 起 Deep Research Agent 赛道进入红海期(OpenAI / Anthropic / 谷歌 / 字节 / Meta 全部入场),DeepResearch 的后发优势在于「系统性的论文矩阵 + 完整训练栈开源」——后来者要追平需要数年时间。
风险与不足
- 代码工程化程度与学术影响力严重不匹配:Tech Report + 17 篇论文的旗舰项目,但仓库代码质量停留在「论文附录」水平。
inference/*.py出现 8 处except:裸捕获、52 次 print 调试、字符串拼接解析(split/find)替代框架 message schema;commit message 用1101/1109/1217当日期标签、用「Add files via upload」描述 PR 内容。 - 重复代码显著:13 个子项目各自重写 MultiTurnReactAgent 类,prompt.py 几乎一比一复制(search/visit/PythonInterpreter 三工具的 description / parameters 在每个子项目里都写一遍),call_server 几乎一致但参数不同。
- 测试覆盖 = 0:174 个 .py 文件,仅 1 个 test.sh 在 WebSailor/src/scripts 下;无 pytest / unittest 框架;没有 CI workflow(
.github/目录不存在)。 - 训练数据闭源:是组织最核心壁垒,也是「半开放」姿态的争议点(Issue #35 持续追问)。
- Heavy Mode 未完全开源:IterResearch / ReSum Heavy 模式仅部分释放,README 暗示后续开源但时间未定。
- Qwen3 MoE 部署兼容性:Issue #209 / #206 印证 vLLM/SGLang 不同版本下行为不一致,OpenAI-兼容推理路径在 tool-call / 多步规划下有稳定性问题。
- 开发节奏断崖:2025-05~09 五个月爆发 237 commit 冲刺论文(占 79%),2026-02 后断更;典型「论文冲刺期」画像,能用的都发了、无新论文就停手。
行动建议
-
如果你要用它:
- 生产环境首选阿里云百炼「deep-search」商用服务(README banner 强引导),免部署;
- 本地部署选 vLLM + 30B-A3B,3.3B 激活参数单卡可跑;注意 transformers 版本与 Qwen3 MoE 兼容性(关注 Issue #209 / #206);
- 研究复现直接 clone main(无版本号、无 Release,需盯 commit hash);
- 用 OpenRouter API 快速体验(2025-09-20 上架)。
-
如果你要学它:
- 论文矩阵:必读 arXiv:2510.24701(Tongyi DeepResearch Technical Report)+ WebShaper(集合论形式化)+ WebResummer(ReSum 周期压缩)+ AgentFounder(CPT 阶段);
- 代码重点:
inference/react_agent.py(主循环)、WebResummer/src/summary_utils.py(摘要服务)、inference/tool_visit.py(LLM-as-Extractor)、WebWeaver/react_agent_outline_write.py(双智能体写作); - 训练栈:重点看 AgentFounder(CPT)+ WebSailor(GRPO 训练)+ WebLeaper(Hybrid Reward)。
-
如果你要 fork 它:
- 方向一:补全 Heavy Mode(IterResearch + ReSum Heavy 仍未完整开源),是最大改进空间;
- 方向二:提升工程化(补 CI/CD、测试、linter、CHANGELOG),把「论文附录级」代码提升到「生产可用」;
- 方向三:解耦 qwen_agent 依赖(核心依赖为自家 qwen-agent,迁移成本高),便于生态兼容性;
- 方向四:补全数据合成 pipeline 的开源(当前仅方法开源,数据仍闭源)。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 未收录 |
| Zread.ai | 未收录 |
| 关联论文 | Tongyi DeepResearch Technical Report (arXiv:2510.24701)(56 作者,2025-10-28 v1 / 2026-05-18 v3) |
| 在线 Demo | ModelScope Studio / HuggingFace Space / 阿里云百炼 deep-search 商用 / OpenRouter API |
| 官方博客 | Tongyi DeepResearch 介绍 |