BettaFish 深度分析报告
一句话总结
中文开源社区最受关注的多 Agent 舆情分析系统(39.6K Stars),从零自研不依赖任何框架,集成 30+ 平台爬虫、多模型协作和 IR 驱动的专业报告生成。
值得关注的理由
- 舆情赛道绝对领先:39.6K Stars,领先第二名 38 倍,连续两天 GitHub 热榜第一(2025-11),覆盖 30+ 社媒平台
- ForumEngine 创新机制:通过文件日志间接通信 + 主持人模型审核的多 Agent 协作模式,有效解决多模型信息同质化问题
- ReportEngine 的 IR 设计:引入编译器中间表示思想,定义 16 种 Block 类型的 JSON Schema,实现「LLM 生成 IR → 校验 → 多格式渲染」的高可控报告流水线
项目展示
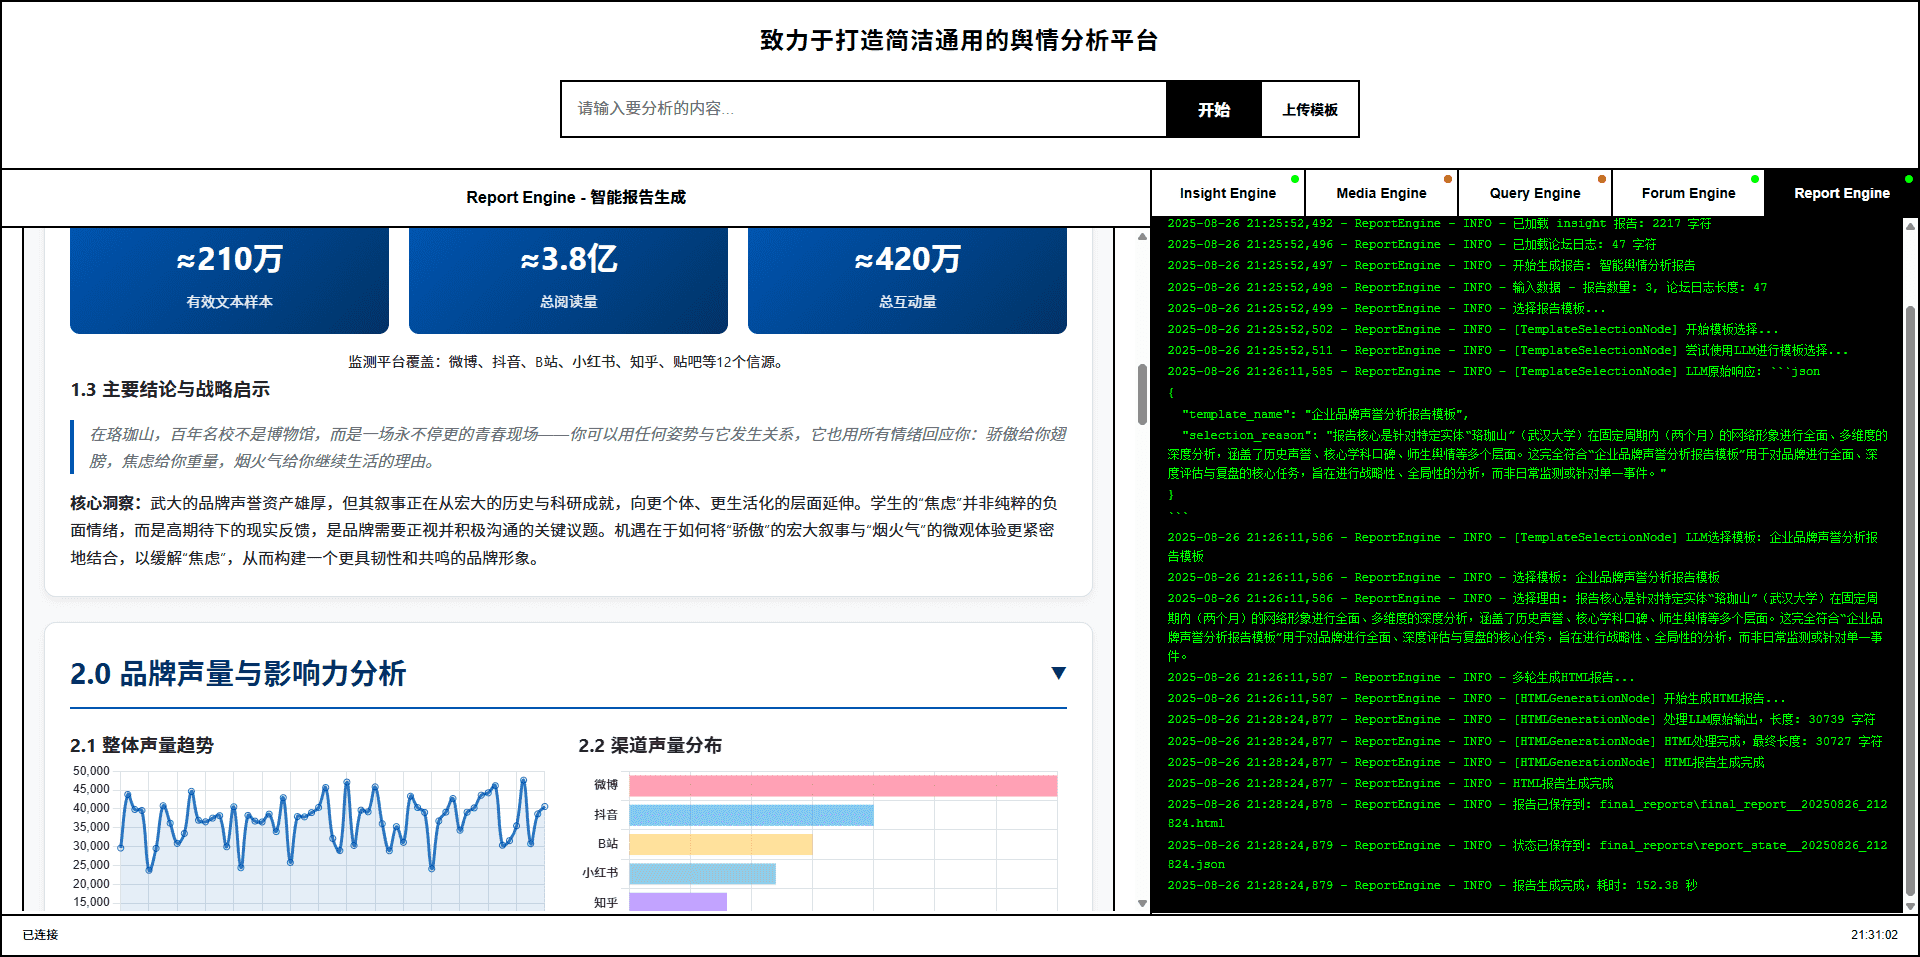
BettaFish 五层架构:用户界面 → 多智能体分析 → 数据采集 → 数据存储 → 报告生成。
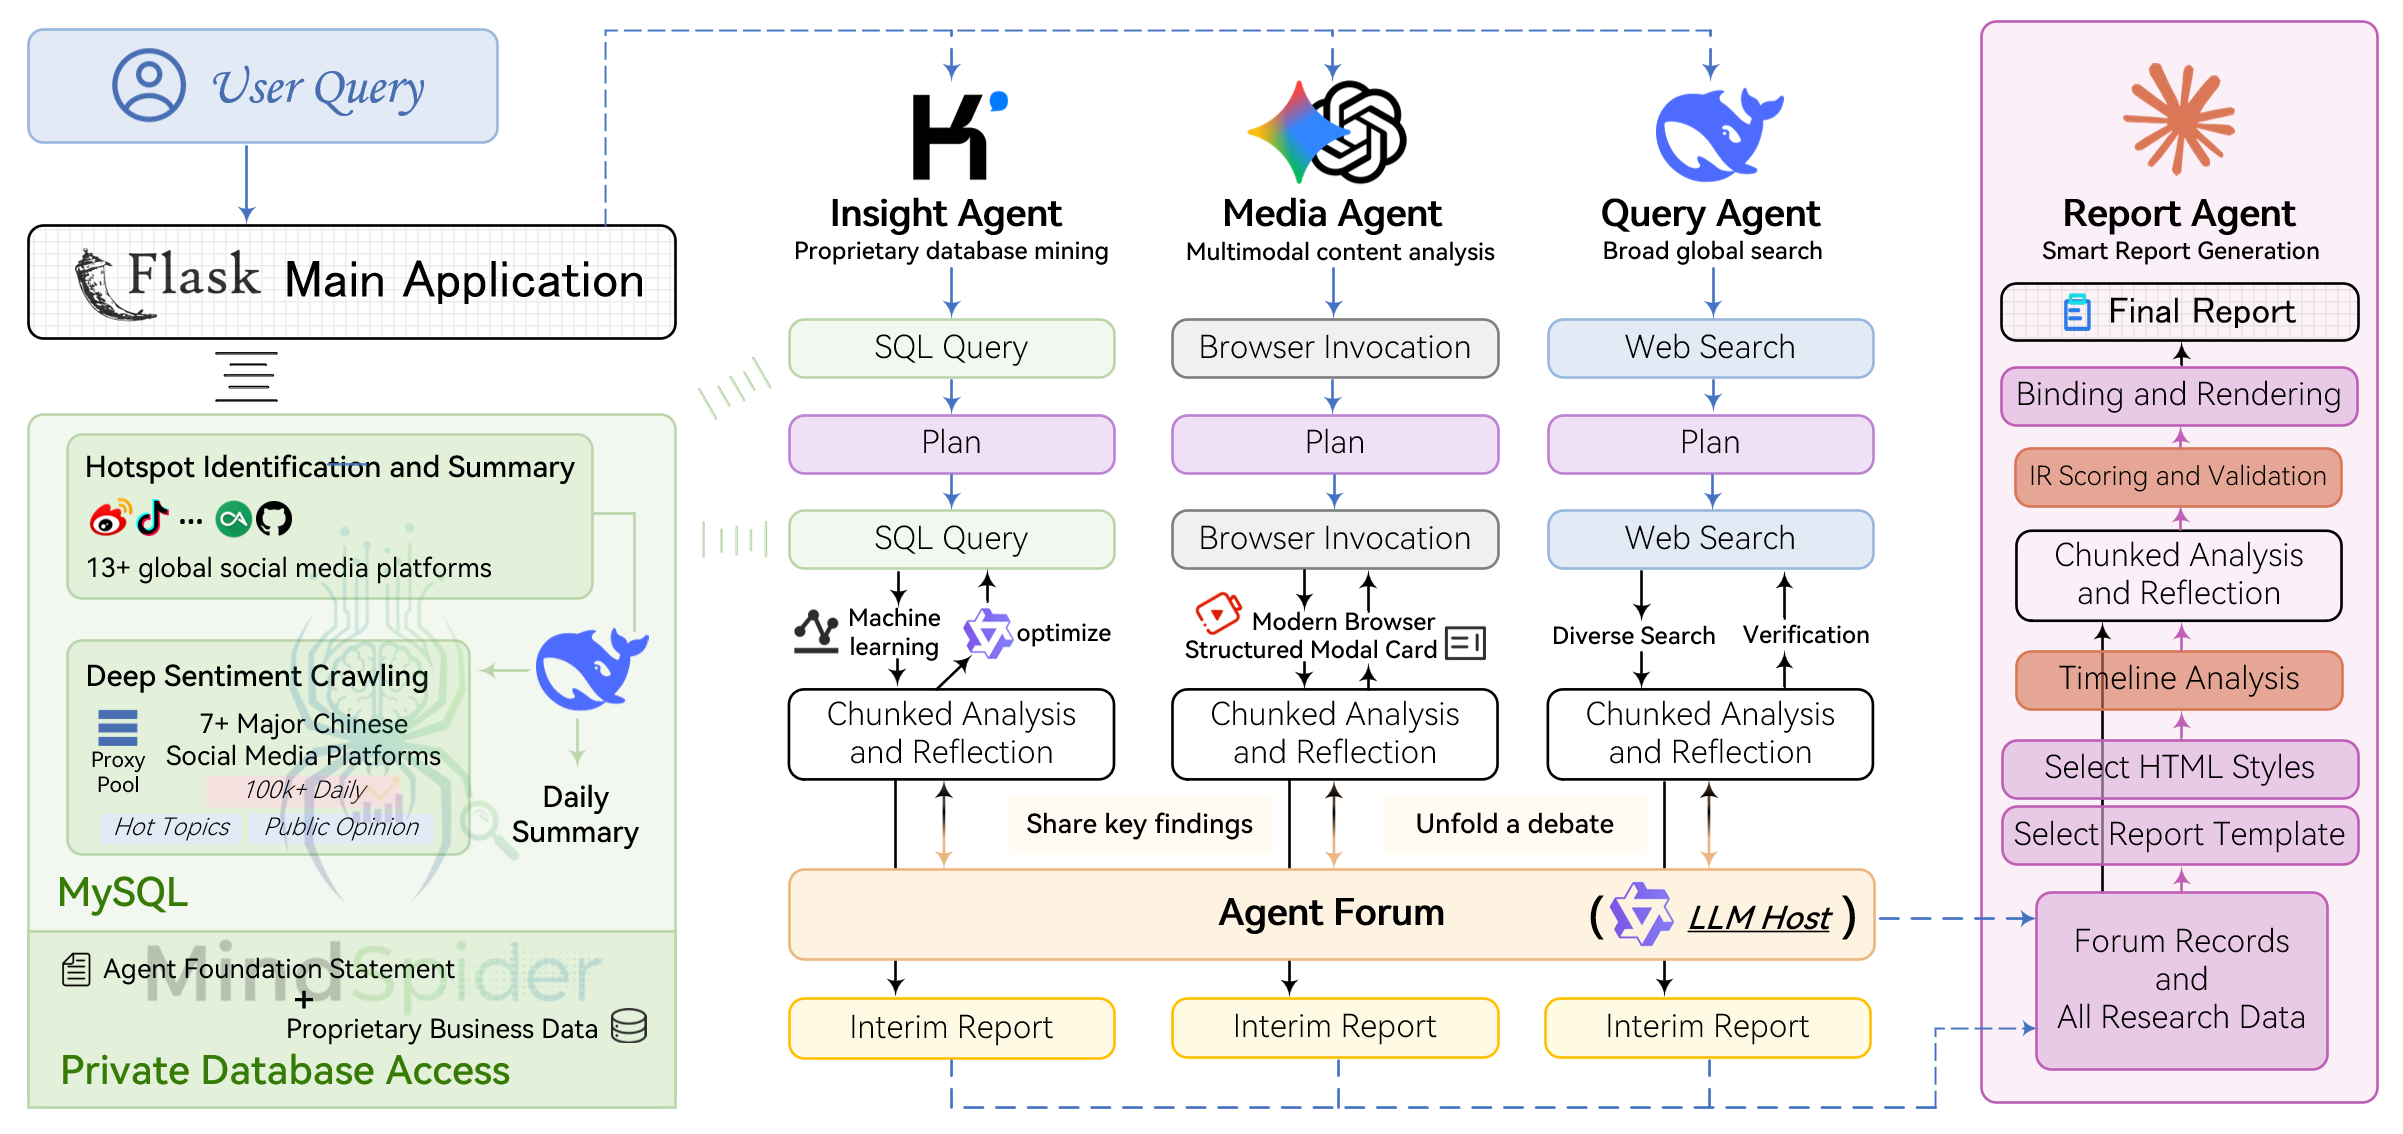
五大引擎(Query/Media/Insight/Report/Forum)协同工作流程。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/666ghj/BettaFish |
| Star / Fork | 39,646 / 7,396 |
| 代码行数 | 56,642 (Python 77.8%, JavaScript/HTML 14%, Markdown 等) |
| 项目年龄 | 20.5 个月(2024-07 首次提交) |
| 开发阶段 | 密集开发(v1.0→v3.0 仅 4 个月,2025-11 月 324 次提交) |
| 贡献模式 | 创始人主导 + 核心团队(666ghj 403 次 + MaYiding 301 次,占 77%) |
| 热度定位 | 大众热门(39.6K Stars,2025-11 单日暴涨 5,000) |
| 质量评级 | 代码[一般] 文档[优秀] 测试[不足] |
作者视角:为什么存在这个项目
创始人/作者背景
BaiFu(@666ghj),北京邮电大学背景,现上海盛大公司。专注 AI Agent 和数据分析领域的年轻开发者。BettaFish(39.6K)+ MiroFish(38.1K)两大项目累计近 8 万 Stars,构成「分析+预测」完整产品矩阵。2,826 名 GitHub 粉丝。
问题判断
作者从三个层面发现了问题空缺:(1) 开源社区缺少专门面向舆情场景的多智能体系统,现有 Agent 框架均为通用框架,无法开箱即用地处理多平台数据采集+分析闭环;(2) 商业舆情产品价格昂贵、以数据看板为主、缺乏深度推理能力;(3) 单一 LLM 做分析容易产生幻觉和同质化,需要多模型协同来提升可靠性。时机上恰逢 LLM Agent 热潮。
解法哲学
「专业分工 + 论坛辩论 + 自研优先」:
- 做:每个 Agent 绑定专属工具集和专属 LLM(Kimi K2 处理长上下文、Gemini 2.5 Pro 处理多模态、DeepSeek 做搜索推理),ForumEngine 通过间接通信避免同质化
- 不做:不依赖 LangChain/LlamaIndex 等框架,完全纯 Python 模块化实现。代价是代码冗余(三个 Engine 重复率 > 90%),收益是完全可控可定制
- 「始于舆情,而不止于舆情」:目标是通过修改 Agent 工具集和 prompt 迁移至金融、医疗等垂直领域
战略意图
BettaFish + MiroFish 构成完整战略闭环:BettaFish 负责数据收集与分析(舆情监测+多智能体分析),MiroFish 负责群体智能预测,从原始数据→智能分析→趋势预测形成完整链路。README 明确对标 Manus/Perplexity 等 AI 深度研究产品,有意将项目置于更高赛道竞争。
核心价值提炼
创新之处
-
ForumEngine 发布-订阅+审核模式(新颖度 4/5 | 实用性 4/5 | 可迁移性 4/5) Agent 通过各自 log 文件发言 → LogMonitor 检测变化提取内容 → 写入 forum.log → 每 5 条触发主持人(Qwen3)总结/纠错 → 各 Agent 下轮读取主持人指导。间接通信+异构模型主持有效避免同质化。
-
ReportEngine IR 驱动报告生成(新颖度 4/5 | 实用性 5/5 | 可迁移性 5/5) 定义 16 种 Block 类型 + 12 种内联标记的 JSON Schema,支持 SWOT/PEST/KPI 等专业商业分析组件。流水线:模板选择→布局设计→篇幅规划→分章节 JSON 生成→IR 校验→装订→HTML/PDF/Markdown 渲染。
-
无框架依赖的纯 Python Agent 实现(新颖度 3/5 | 实用性 4/5 | 可迁移性 3/5) 核心抽象仅 BaseNode + State + LLMClient,代码极易理解。是学习 Agent 系统内部原理的优秀教材。
-
多 LLM 角色分配策略(新颖度 3/5 | 实用性 5/5 | 可迁移性 5/5) 7 种 LLM 角色各配专属模型(长上下文→Kimi K2,多模态→Gemini,推理→DeepSeek,主持→Qwen3),根据任务特点选型而非共用「最强」模型。
可复用的模式与技巧
- 文件日志通信模式:Agent 通过文件系统间接通信 + 主持人中转,轻量级多 Agent 协作方案
- IR 驱动的 LLM 报告生成:Block Schema → LLM 生成 JSON → 校验 → 多格式渲染,比直出 HTML 更可控
- 多 LLM 角色策略:按任务特点分配模型,兼顾效果和成本
- Pydantic Settings + .env 双层配置:类型安全 + 环境变量 + 前端可动态修改
- 指数退避重试装饰器:通用的
with_retry/with_graceful_retry,支持自定义退避参数
关键设计决策
- 五 Engine 独立进程 + 文件系统通信:每个 Engine 运行在独立 Streamlit 端口,Flask 主应用管理生命周期。松耦合易调试,但文件 I/O 成瓶颈。
- 节点链架构:Search→Summary→Reflection×N→Formatting 的固定管线,是 LangGraph 节点概念的朴素实现——无图结构无条件分支,但足够覆盖核心模式。
- 代码复制而非共享基类:三个 Engine 相同代码各自独立维护。保证了独立迭代能力,但重复率超 90%。
竞品格局与定位
竞品对比矩阵
| 维度 | BettaFish | PraisonAI (5.7K) | AG2/AutoGen (4.3K) | 清博大数据(商业) |
|---|---|---|---|---|
| 定位 | 舆情分析专用多 Agent | 通用 AI Agent 框架 | 通用多 Agent 对话框架 | 企业级舆情 SaaS |
| 数据采集 | 内置 MindSpider 爬虫 | 无内置 | 无内置 | 商业数据源 |
| 多模态 | 视频截图分析+结构化卡片 | 有限 | 文本为主 | 文本+图片 |
| 报告生成 | IR 驱动+6 套模板+HTML/PDF | 无 | 无 | 固定模板 |
| 部署难度 | 高(7 个 LLM API+数据库) | 中等 | 中等 | 即开即用 |
| 定制成本 | 低(纯 Python 易改) | 低 | 中等 | 高(闭源 SaaS) |
差异化护城河
- 舆情场景垂直深度:内置爬虫+数据库+情感分析+专业报告模板,通用框架需大量二次开发才能达到同等能力
- ForumEngine 创新协作机制:文件日志间接通信+主持人审核在开源 Agent 生态中独一无二
- 品牌效应:39.6K Stars + BettaFish/MiroFish 矩阵,在中文开发者社区已形成强品牌认知
竞争风险
- 向上:Manus/Perplexity 等 AI 研究产品在报告质量上可能碾压开源方案
- 向下:通用 Agent 框架(AutoGen/PraisonAI)加装舆情插件后可能入侵其领地
- AI 原生替代:随着 LLM 能力提升,单模型可能足以完成全流程分析,多 Agent 协作的必要性下降
生态定位
在「开源舆情分析」赛道占据绝对主导地位,同时有意将自己定位于更广阔的「AI 深度研究」赛道(对标 Manus/Perplexity)。填补了「开源+免费+专业舆情分析」的市场空白。
套利机会分析
- 信息差: 无传统信息差——已是该赛道最高 Stars 项目。但 Fork/Star 比 18.6%(远高于平均水平)说明实际二次开发需求旺盛
- 技术借鉴: (1) ForumEngine 的文件日志间接通信模式可迁移到任何多 Agent 系统;(2) ReportEngine 的 IR 驱动报告生成模式可用于任何 LLM 文档生成场景;(3) 多 LLM 角色分配策略(按任务选型)是成本优化的通用方法
- 生态位: 填补了「开源多 Agent 舆情分析」的完整空白,且「始于舆情不止于舆情」的扩展能力意味着可迁移至金融/医疗等垂直领域
- 趋势判断: 仍在快速增长(月均 2,000-3,000 Stars),MiroFish 姊妹项目势头同样强劲。AI Agent 赛道整体上升,但技术路线可能随 LLM 能力提升而被简化
风险与不足
- 部署门槛极高:需配置 7 个 LLM API Key + PostgreSQL 数据库 + 多个搜索 API(Tavily/Bocha),Issue #44/#49/#561 持续反映此问题
- 三 Engine 代码重复率 > 90%:base_node/summary_node/search_node/formatting_node 几乎完全相同,修一个 bug 需同步三处
- 测试覆盖严重不足:仅 3 个测试文件,无系统性集成测试,CI 仅有 Docker 构建
- LLM 幻觉问题:#132 反映 Agent 在检索失败时生成虚假内容,报告可信度受影响
- html_renderer.py 单文件 6,536 行:职责过重,应按 Block 类型拆分
- GPL-2.0 许可证:强传染性,商业闭源使用受限
- 重量级依赖:torch/transformers/playwright/weasyprint 等使镜像体积庞大
- sys.path.append 硬编码:缺乏正式包管理(pyproject.toml),模块导入靠路径 hack
行动建议
- 如果你要用它: 适用于需要开源舆情监测的中小团队。准备好 7 个 LLM API Key 和 PostgreSQL,推荐使用 Docker Compose 部署。若只需简单搜索分析且不想折腾配置,Perplexity 等商业产品可能更实际
- 如果你要学它: 重点关注 (1)
ForumEngine/monitor.py+llm_host.py— Agent 间接通信机制的创新实现;(2)ReportEngine/ir/schema.py+renderers/html_renderer.py— IR 驱动的报告生成架构;(3)QueryEngine/agent.py+nodes/— 纯 Python Agent 节点链实现(无框架依赖) - 如果你要 fork 它: (1) 提取三个 Engine 的公共代码为 shared 基础包消除重复;(2) 添加集成测试和 CI 质量门控;(3) 简化部署配置(统一 API 代理、内置默认数据库);(4) 拆分 html_renderer.py
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/666ghj/BettaFish |
| Zread.ai | https://zread.ai/666ghj/BettaFish |
| 关联论文 | 无 |
| 在线 Demo | Bilibili 演示视频 |
| 技术评测 | LLM 应用剖析: 舆情分析多智能体-微舆 BettaFish |
| 社区讨论 | Linux.do 对比测评 |