GitHub 推荐:6 个月 35.8K stars:llmfit 用 51 万行 JSON 重写本地 LLM 选型
一句话总结
llmfit 是一个 Rust 全栈的「本地硬件 × LLM 模型」智能匹配器,用 6 个月冷启动冲到 35.8K stars,靠的不是花哨算法,而是把 MoE 主动参数换算、跨 7 运行时统一索引、bench --share 社区基准回灌这三件事做成产品。
值得关注的理由
- 不是推理引擎,却是选型决策中枢:和 Ollama(174k)、llama.cpp(73k)、LM Studio 形成上下游关系——它们负责「跑」,llmfit 负责「该跑哪个」。
- MoE 感知的真实护城河:当业界多数 VRAM 估算器还停留在「总参数 × 字节/参数」时,llmfit 已经在做
active_parameters(激活参数)换算,这是 2025 年后所有 MoE 模型(Mixtral/DeepSeek-V3/gpt-oss)本地化部署的核心痛点。 - 数据驱动胜过算法创新:51 万行 JSON(hf_models.json 11MB)+ 38 个社区硬件 profile +
bench --shareGitHub PR 回灌——把「tok/s 估算」做成可校准、可进化的活系统,而不是写死的查表。
项目展示
README 媒体
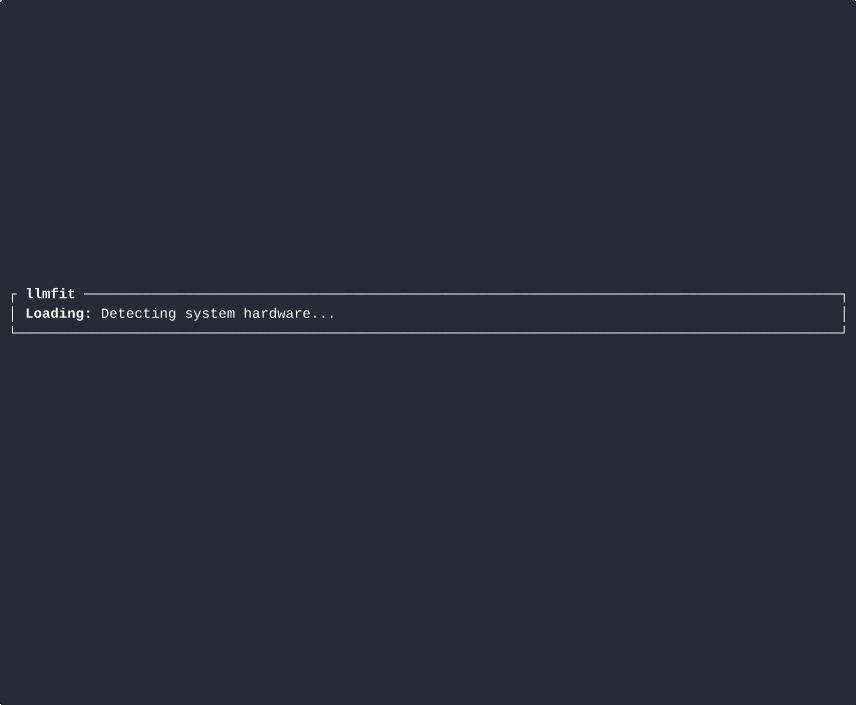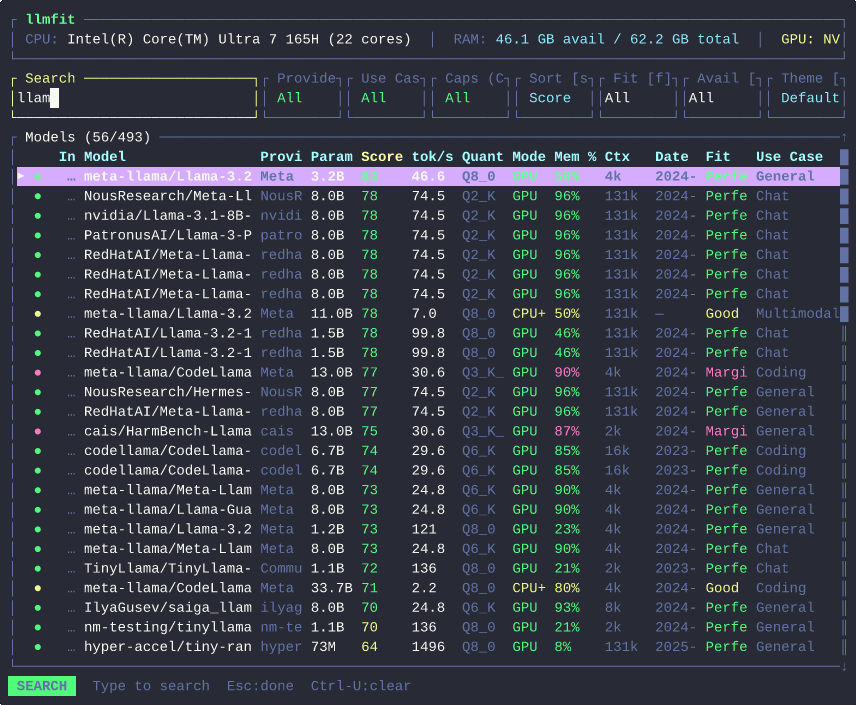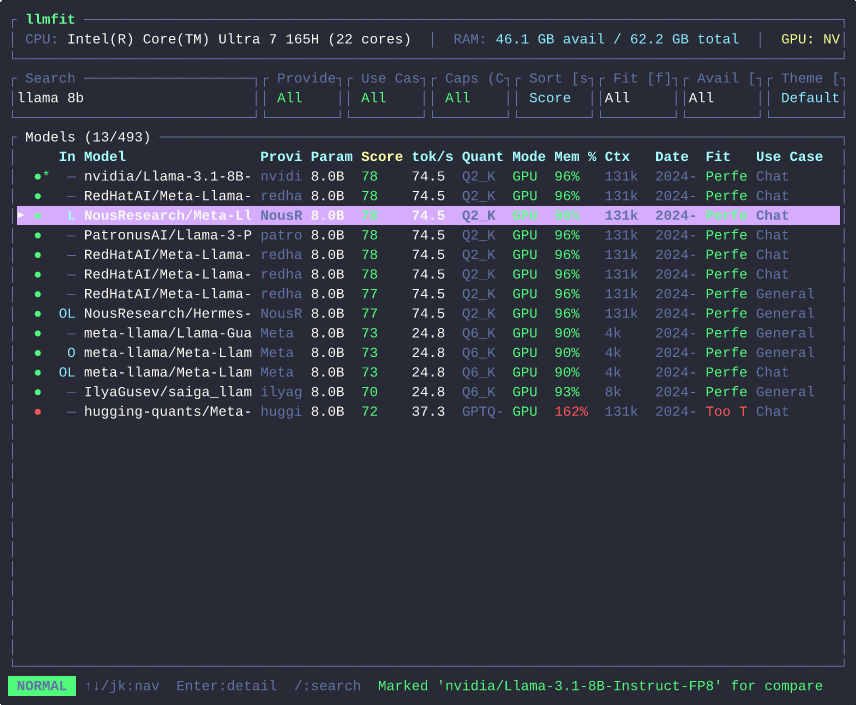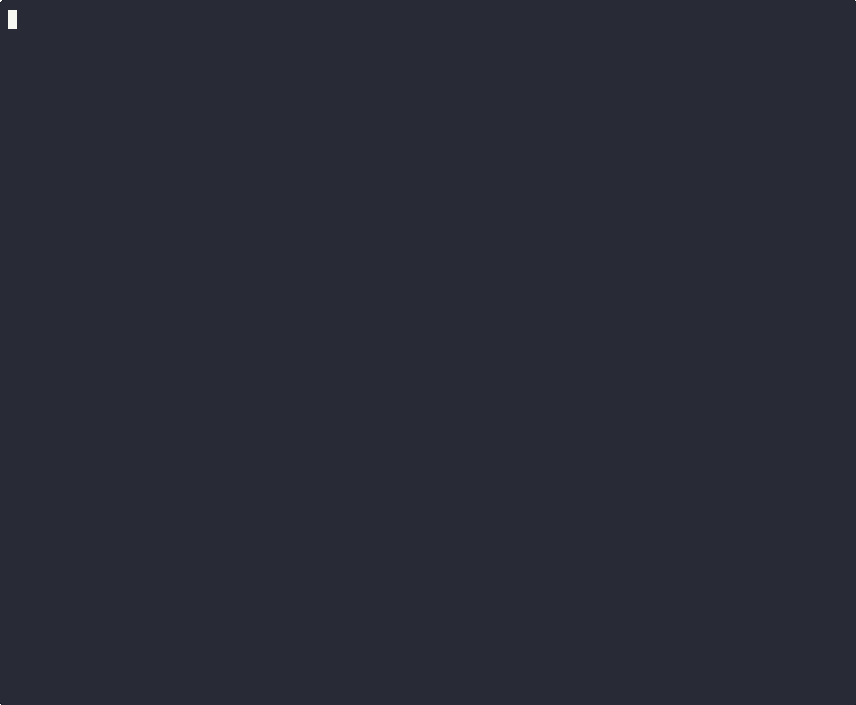 — 类型: demo (TUI 实操)
 — 类型: hero (品牌)
官方站点
llmfit.org返回 403,未补充官网 hero。Zread.ai 镜像有备选 demo GIF。仓库另有 5 个素材未在前端渲染。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/alexsjones/llmfit |
| Star / Fork | 35,835 / 2,270 |
| Watcher | 113 |
| Open Issues / PRs | 41 / 24 |
| 代码行数 | 582,620 总计(含 52 万行 JSON 数据),真实源码 ~5.5 万行 Rust |
| 语言分布 | Rust 84.5% / Python 8.2% / JS 4.9% / CSS 1.4% |
| 项目年龄 | 6.8 个月(2026-02-15 创建,2026-09-10 最近推送) |
| 开发阶段 | 密集开发期(90 天占比 41% commit,未衰减) |
| 贡献模式 | 单人主导(Alex Jones 占 54% commits,Top 5 占 79%)+ dependabot 11% |
| 热度定位 | 大众热门(HN 238 分/55 评论,多次 Trending 上榜) |
| License | MIT |
| 部署形态 | CLI + TUI + Desktop (Tauri) + Web (React) + Python (PyPI) + MCP |
| 质量评级 | 代码[优秀] 文档[优秀] 测试[充分] |
作者视角:为什么存在这个项目
创始人/作者背景
Alex Jones(alexsjones)是伦敦 Principal Engineer,账号 14.8 年,268 个 public repos。其 bio 写「I build infrastructure for the agentic era」——这是关键:他不是来写应用的,是来铺设 agent 时代基础设施的工程师。
证据在他的姐妹项目矩阵:llmfit(选型层)+ llmserve(推理服务层)+ llama-panel(管理面板)+ sympozium(K8s agent 编排)+ repo-steward(仓库自动化)。这是从「用户决策入口」一路铺到「集群编排」的完整栈,每一层都把流量往下一层引——清晰的「流量入口 → 商业化承接」战略路径。
问题判断
作者在 AGENTS.md 里把动机说得很直白:本地 LLM 推理存在「4 轴笛卡尔积爆炸」——模型家族 × 量化格式 × 推理运行时 × 执行路径。一个普通用户面对的是数十万种组合,不可能凭经验判断。
行业现状是:
- Ollama/LM Studio 只告诉你「能不能跑」,不告诉你「跑哪个最划算」
- 现成 VRAM 计算器(Modelfit 类网页工具)停留在总参数估算,2025 年后 MoE 模型(Mixtral 8x7B 只有 ~13B 激活参数)全部误判
- 各家 runtime(Ollama/llama.cpp/MLX/Docker Model Runner/LM Studio)互不联通,已下载的模型对其他 runtime 隐身
llmfit 把「我能不能跑哪个」从经验判断转成数学可解的判定+排序问题,用 SystemSpecs::detect() + build_model_fits() 这两个 API 锚定。
解法哲学
作者的选择有三层「不做什么」值得品味:
- 不做推理引擎——Issue #16 里用户要求「选中模型后自动 install」,作者明确拒绝,保持「推荐者 vs 编排者」的边界
- 不做真机 benchmark——估算而非实测(外部评测共识),用
EstimateConfidence5 档(MeasuredLocal/MeasuredCommunity/Calibrated/Estimated/Unsupported)让每个数字「知道自己有多可信」 - 不做闭源 GUI——LM Studio 是 Electron 闭源;llmfit 选 Tauri + ratatui 路线,CLI/TUI 是 Unix 哲学的第一公民
战略意图
从姐妹项目矩阵反推:llmfit 是流量入口,llmserve/llama-panel 承接企业部署需求。bench --share 已经把「贡献基准 = 用户行为」做成 GitHub PR 闭环——这是把 OSS 用户变成数据贡献者的产品化手法,类似 Homebrew tap 的反向用法。
核心价值提炼
创新之处
-
MoE 主动参数换算算法(新颖度 5/5,实用性 5/5,可迁移性 3/5)
- Tier 1 架构感知:识别 scalable FFN + fixed attention/router/lm_head,用 K=3.2 转带宽等价字节
- Tier 2 metadata-poor fallback
- per-architecture 校准:gpt_oss / deepseek_v3 等
- 这是 2025 年后所有 MoE 模型本地化部署的核心,未见其他开源工具完整实现
-
4 维评分算法 + use_case profile(新颖度 3/5,实用性 5/5,可迁移性 5/5)
- 6 个 use_case × 4 维评分(质量/速度/容量/能耗)的笛卡尔矩阵
pure_ratio_verdict用 0.60/0.85/0.98 阈值(Marginal 在 0.98 留 allocator slack)cap_for_run_mode()限制 Perfect 仅 GPU/TP 路径
-
bench --shareGitHub PR 校准回路(新颖度 4/5,实用性 4/5,可迁移性 5/5)- device flow OAuth + 本地 store_local 兜底(拒绝 share 不丢数据)
- build.rs release 编入 binary
- 把「OSS 用户 → 数据贡献者」做成自然产品行为
-
hf_models.json数据格式设计(新颖度 3/5,实用性 5/5,可迁移性 4/5)- 41.5 万行 / ~11 MB line-delimited JSON
architecture字段决定速度查表、active_parameters决定 MoE 计算- 每周脚本重抓,形成数据飞轮
-
EstimateConfidence5 档显式化(新颖度 3/5,实用性 5/5,可迁移性 5/5)- MeasuredLocal / MeasuredCommunity / Calibrated / Estimated / Unsupported
- 让 tok/s 数字「知道自己有多可信」——这是少见的工程诚信
- 每个魔法常数都有 issue 编号(#292、#449、#621、#919、#969),可追溯
-
GPU 带宽屋顶线物理建模(新颖度 3/5,实用性 4/5,可迁移性 3/5)
tps = bandwidth_GB_s / model_size_GB × 0.55 × run_mode_factor- per-GPU 名称查表(覆盖 RTX 50/40/30/20 + Apple Silicon + 数据中心卡)
- Laptop SKU 显式排除——这是对硬件差异化的尊重
可复用的模式与技巧
- 6 端共享主路径:
build_model_fits()是 CLI/TUI/Web/MCP/Desktop/Python 六端的唯一入口,避免逻辑分叉 analyze_inner()共享:ModelFit::analyze*()四件套都委托给analyze_inner(),API 防 caller 选错路径ModelProvidertrait 窄设计: 4 方法 + PullEvent channel,不过度抽象CalcConfig全显式化: 所有可调参数集中并可序列化,调试友好LLMFIT_DEBUG宏旋钮:macro_rules!避免热路径分配,调试时零开销切换- detect 瀑布 + fallback 矩阵: NVIDIA → AMD → Intel → Apple Silicon → Ascend → Vulkan 兜底
usable_context替代native context: 从内存预算反推真实可用 tokens,#621 修复 silent overpromise
关键设计决策
-
决策: workspace 拓扑 3 Cargo crate(core / tui / desktop)+ llmfit-web 构建产物被 build.rs 嵌入 tui 二进制 + llmfit-python PyPI 转发二进制
- 问题: 单一 crate 编译慢且耦合
- 方案: 业务逻辑在 core,TUI 是消费方,Web/Python 是分发形态
- Trade-off: 跨 crate 重构成本(providers.rs 7575 行、hardware.rs 5767 行仍是 if-ladder,未做 phf 静态表)
- 可迁移性: 高——任何多端 Rust 项目都适用
-
决策: TUI 大文件不分层(tui_app.rs 6081 行 / tui_ui.rs 5961 行 / main.rs 3990 行)
- 问题: 状态机、事件循环、渲染逻辑都在 TUI 内
- 方案: 不分模块,单文件内分节
- Trade-off: 新人上手慢但热点文件集中(Phase 2 显示 tui_app.rs 105 次修改);ratatui 项目惯例
- 可迁移性: 低——是项目特定的工程选择
-
决策: 估算而非实测(拒绝在产品里集成真推理 benchmark)
- 问题: 启动快 vs 准确性
- 方案: 用
EstimateConfidence5 档分级,把不确定性显式化 - Trade-off: 失去「实测保证」换启动速度与跨平台覆盖
- 可迁移性: 高——任何需要在不可信数据上做决策的系统都适用
竞品格局与定位
竞品对比矩阵
| 维度 | llmfit | Ollama | llama.cpp | LM Studio | Modelfit 等网页 |
|---|---|---|---|---|---|
| 核心定位 | 选型推荐 | 推理引擎 | 底层引擎 | GUI 推理 | VRAM 估算 |
| Stars | 35.8k | 174k | 73k | 闭源 | 非开源 |
| MoE 感知 | ✅(核心创新) | ❌ | ❌ | 部分 | ❌ |
| 跨运行时统一索引 | ✅(7 端) | ❌ | ❌ | ❌ | ❌ |
| 真实跑模型 | ❌(估算) | ✅ | ✅ | ✅ | ❌ |
| 多端入口 | ✅(6 端) | CLI/API | CLI/库 | GUI | 网页 |
| 社区基准回灌 | ✅(bench —share) | ❌ | ❌ | ❌ | ❌ |
| 启动到首次结果 | 2 分钟 | 即时 | 即时 | 即时 | 即时 |
差异化护城河
- 数据护城河:51 万行 JSON 周更 + 38 社区硬件 profile + 持续回灌的 benchmark,竞品很难追赶
- 算法护城河:MoE 主动参数换算是论文级算法(Tier 1/2 + per-architecture 校准三层),不是简单查表
- 生态位护城河:6 端共享主路径 + 多 runtime 索引是产品设计层面的差异,竞品重构成本高
- 社区护城河:
bench --shareGitHub PR 闭环形成数据飞轮,越多人用 → 数据越准 → 越多人用
竞争风险
- Ollama 内嵌推荐:Ollama 174k stars 已成事实标准,如果 Ollama 在
ollama pull前集成 llmfit 类似推荐层,llmfit 的核心场景会被截胡 - LM Studio 闭源迭代:LM Studio 团队有 GUI 优势,如果他们补齐 MoE 感知和社区基准,会形成「GUI 选型 + 一键推理」的整合产品
- OpenRouter 类聚合平台:云端 API 路径如果把本地化优势蚕食掉,llmfit 的目标用户会减少
生态定位
llmfit 在生态中是「选型决策层」,与 Ollama/lmstudio/llama.cpp 互补而非替代——这是它 6 个月冷启动到 35.8k stars 的关键。它不抢推理引擎的饭碗,而是解决了所有推理引擎都没解决的「该选哪个」问题。
套利机会分析
- 信息差: 低关注度高质量?——不,已经是大众热门。但深度上多数人只看到 README,没意识到 MoE 主动参数换算是 2025 后所有 MoE 模型本地化的核心痛点,技术选型读者还有内容可挖
- 技术借鉴:
bench --shareGitHub PR 校准回路:任何需要用户贡献数据的 OSS 项目都可借鉴EstimateConfidence5 档显式化:AI 产品常见的「过度自信」问题解法CalcConfig全显式化:调试复杂决策系统的标准做法- detect 瀑布 + fallback 矩阵:跨平台硬件/环境探测的通用模式
- 生态位: 填补了「选型决策层」的空白,在推理引擎和用户之间架桥
- 趋势判断: 增长中。MoE 模型占比持续提升(Mixtral / DeepSeek-V3 / gpt-oss / Qwen3-MoE),llmfit 的算法优势会持续放大。后发优势在于:周更数据飞轮 + 社区基准回灌,越晚起步越难追
风险与不足
- 多 GPU 联合识别仍不完善(Issue #638 open):高端工作站场景会失真
- 集成显卡 / DGX Spark 误识别(Issue #17、#303 closed 但仍有边缘 case):统一内存设备和新形态硬件滞后
- 极旧硬件估算失真:带宽屋顶线查表不覆盖 10 年前硬件
- TUI 大文件未分层:6081 行的 tui_app.rs 是新人上手门槛,也是潜在 bug 温床
- 根目录
src/旧路径残留:Phase 2 显示根目录有src/{tui_ui,fit,hardware,providers}.rs各 12-14 次修改,重构不彻底 - commit message 不规范:fix 28.5% + other 57%,refactor/test 0%,技术债在累积
- 依赖唯一实现者风险:Alex Jones 占 54% commits,bus factor = 1
行动建议
-
如果你要用它:
- 选它的情况:本地部署 MoE 模型(Mixtral / DeepSeek-V3 / gpt-oss / Qwen3-MoE)、跨多 runtime 的混合环境、需要「知道自己跑哪个最划算」而非「能跑就行」
- 不选它的情况:单推理引擎用户(直接用 Ollama/lmstudio)、纯云端 API 用户、只用 CPU 推理的小模型场景
- 替代方案:极简 VRAM 估算 → Modelfit 网页;推理 → Ollama;底层优化 → llama.cpp
-
如果你要学它:
- 必读:
llmfit-core/src/fit.rs(MoE 主动参数换算核心,5207 行 64 次修改) - 必读:
llmfit-core/src/providers.rs(窄 trait 设计 + 7 运行时适配,7575 行 92 次修改) - 必读:
llmfit-core/src/hardware.rs(detect 瀑布 + fallback 矩阵,5767 行 71 次修改) - 值得读:
AGENTS.md(作者给 AI agent 的架构说明,13KB)、MODELS.md(模型 schema 设计)、API.md(6 端 API 契约) - 参考:
scripts/scrape_hf_models.py(数据飞轮的抓取端)
- 必读:
-
如果你要 fork 它:
- 改进方向 1:TUI 大文件拆分(tui_app.rs → 状态机/事件循环/渲染三模块)
- 改进方向 2:多 GPU 联合识别(#638 是 open issue,价值点)
- 改进方向 3:把 phf 静态表引入 providers.rs/hardware.rs 替换部分 if-ladder
- 改进方向 4:补 OpenAPI spec 给 llmfit-web/API 端
- 改进方向 5:CI 引入 commit lint 强制 conventional prefix,缓解技术债累积
- 避开方向:不要重写估算为实测——会失去跨平台覆盖和启动速度优势
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/AlexsJones/llmfit |
| Zread.ai | https://zread.ai/AlexsJones/llmfit |
| 官方文档 | https://llmfit.axjns.dev(含 benchmark/CLI/providers/custom models 文档) |
| 关联论文 | 无(技术本质借鉴既有 LLM systems 文献,未声明原创学术贡献) |
| 在线 Demo | 无官方 playground;Zread.ai 提供 demo GIF 镜像 |