GitHub 推荐:5 个月 4.9K stars:MIT 博士用 REPL 替代上下文窗口,RLM 凭什么重新定义 LM 推理
一句话总结
RLM(Recursive Language Models)把”上下文窗口”重新设计成”REPL 变量”——prompt 不进 LM 上下文、而是变成 LM 编程的对象,模型写 Python 来读自己的输入,并通过递归子调用 + 受训的小模型(RLM-Qwen3-8B) 把有效上下文推到接近无限。
值得关注的理由
- 论文级范式,不是又一个 Agent 框架:作者 Alex Zhang(MIT OASYS PhD、ICML’25 Best Paper DL4C)把 RLM 定位为”inference paradigm”——和 DSPy/LangGraph/Letta 这类 framework 完全正交,是上游抽象;项目里还发了一个真训过的 RLM-Qwen3-8B 检查点,是这个赛道唯一有「论文 + 训好的模型」的项目。
- 三个工程模式可立即搬运:子调用预算沿递归构造器传递(
max_budget - parent_spent)、_AnswerDict回调式完成握手、阈值触发的上下文压缩(原始历史留在 REPL 变量里)——这三招对所有长上下文 Agent 都管用,比 LangGraph 那一套更克制。 - 5.9 个月 4.9K stars,v1.0.0 已发:典型 paper-driven 节奏(1 月论文实现峰值 52 commits,3 月投稿期谷底 5 commits,5 月 v1.0 + 可视化前端二次发力);最近 2 天(6/15→6/17)单日新增 ~192 stars,处于爆发窗口。
项目展示
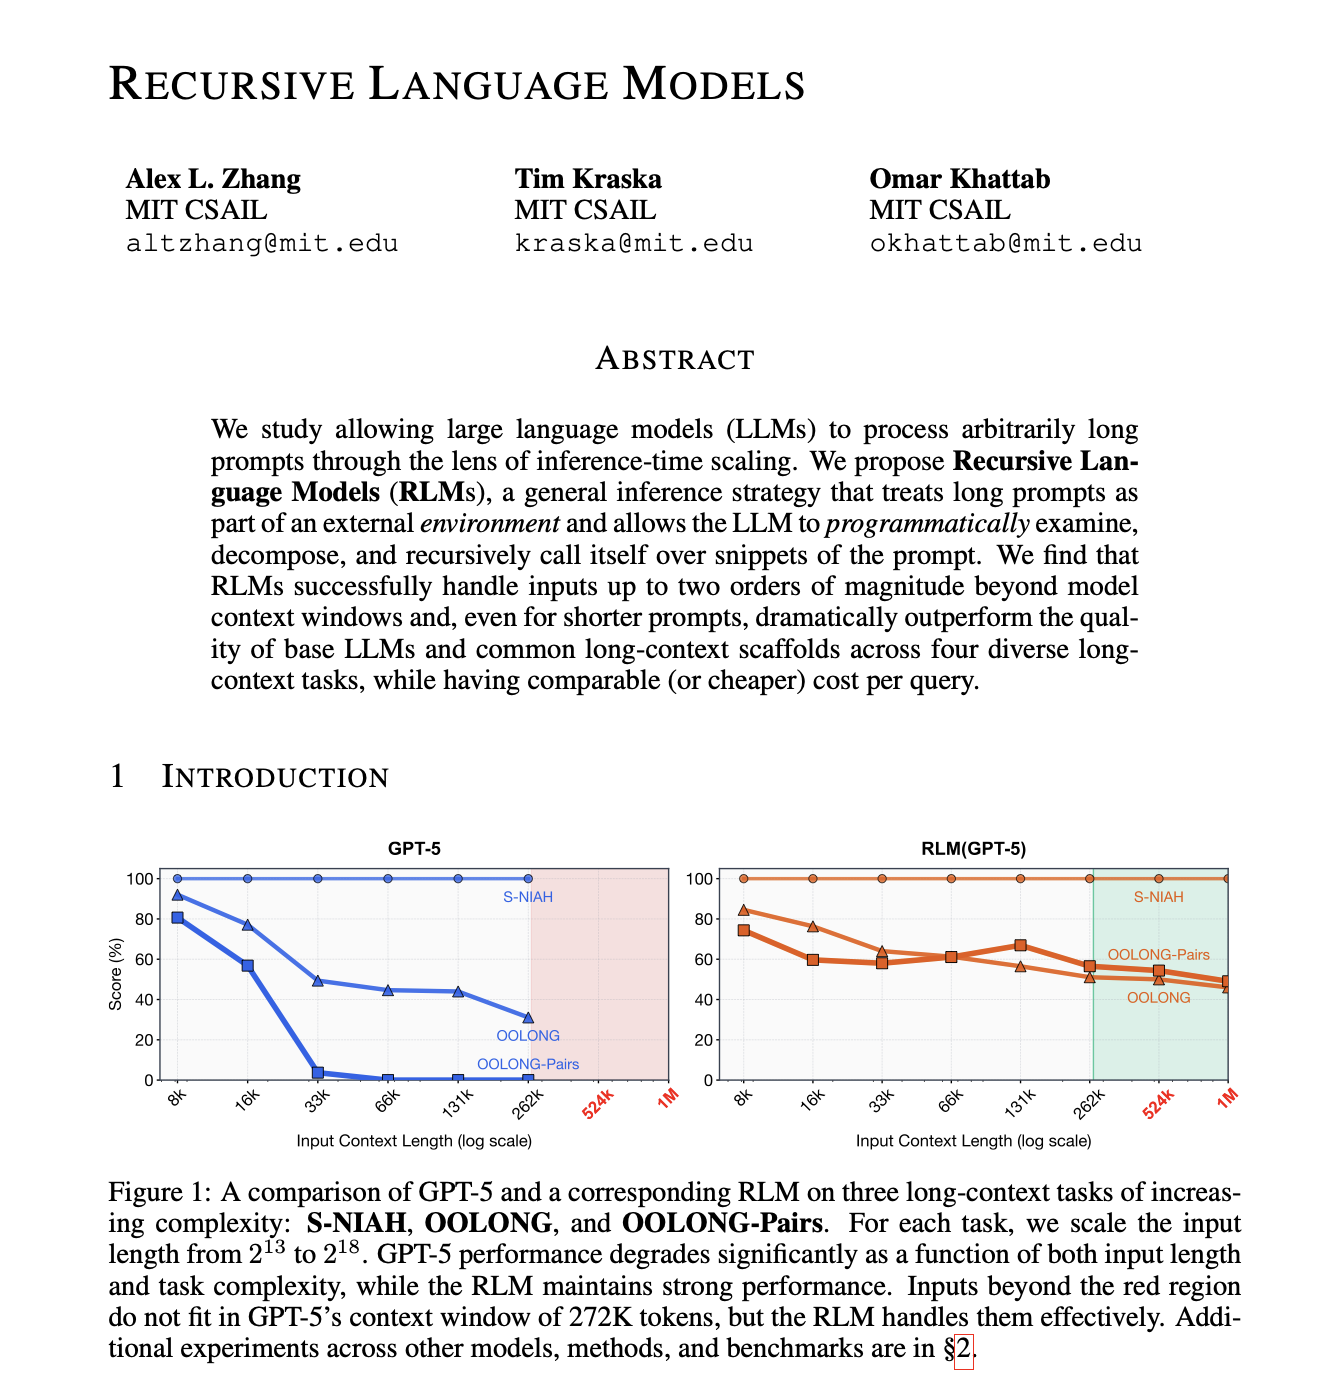
RLM 论文预览图:把”长 prompt → REPL 变量、LM 写 Python 操作自己的输入”作为范式落地。
项目无官方 demo GIF / 在线 playground;本地
make quickstart可跑一个 OpenAI API key 的最小测试。visualizer/是个独立的 Next.js 轨迹回放前端,但 README 没挂图。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/alexzhang13/rlm |
| Star / Fork | 4,893 / 821(5.9 个月内) |
| 代码行数 | 28,723(Python 13,883 / JSON 9,772 from uv.lock / TSX 4,221 from visualizer / 其他 847) |
| 业务代码 | ≈ 18,951 行(去 uv.lock) |
| 注释比 | 7.1%(研究代码常见,含义走 docstring) |
| 项目年龄 | 5.9 个月(2025-12-20 → 2026-06-06) |
| 开发阶段 | 稳定维护(v1.0.0 已发,6 月仅 3 commits 收尾) |
| 贡献模式 | 单作者主导(Alex Zhang 85 commits / 62%,社区 21 人各 ≤2 commits 长尾) |
| 热度定位 | 中等热度 → 正在突破(2 天内 +192 stars) |
| 质量评级 | 代码 [B+] 文档 [A-] 测试 [A-](12 个测试文件 / 4,492 行,覆盖 ~32% 业务代码) |
作者视角:为什么存在这个项目
创始人/作者背景
Alex L. Zhang(alexzhang13),MIT CSAIL PhD,师从 Omar Khattab(DSPy 共同作者)和 Tim Kraska(MIT OASYS Lab 主任、SageDB 缔造者);Princeton CS 2024 届 top of class;NSF GRFP Fellow;前 Sakana AI / VantAI / Snap Research / Apple / Claryo 实习生;现任 Prime Intellect Research Fellow;GPU MODE 核心团队;ICML’25 Best Paper DL4C(KernelBench)、ICML’25 Spotlight(KernelBot)、ICLR’25 SWE-bench Multimodal 三连击。
这个画像决定了两件事:① 导师是 DSPy 的 Khattab,作者天然把 RLM 定位成”DSPy 范式层”(不是替代,是上游);② 师门(OASYS Lab)背景让代码风格明显偏 systems + IPython 传统,REPL 抽象信手拈来。
问题判断
作者看到的是:当代 LM 的”上下文窗口”是被滥用错的接口。100 万 token 不是”模型能力”,是”模型读 100 万字的能力”——而读 ≠ 理解 ≠ 推理。多数长上下文 benchmark 上 LM 的”针在 haystack”成绩表面漂亮,但实际复杂任务(多跳推理、跨段引用、巨量文本聚合)上表现崩塌。
时机为什么是现在:① GPT-5 / Claude 4.5 / Gemini 2.5 之后,LM 自身写代码的能力已经稳定到可以”教它写一段 Python 来读自己的 prompt”;② 同时 GPU + 推理服务降价让”为一段 prompt 派生成百个子调用”在经济上可行;③ LM 研究界刚形成共识:长上下文不是简单把窗口加长就能解决——需要 程序化访问,而不是 线性读取。
解法哲学
作者在博客《Language Models will be Scaffolds》中把答案讲清楚:LM 本身是 substrate,scaffold(脚手架)才是产品。RLM 这个 scaffold 的核心契约是:
- REPL 变量 > 上下文窗口:用户的 prompt 不进 LM 上下文,而是变成 REPL 里的
context变量(必要时版本化成context_0..N)。LM 想看就写context[:1000],想做正则就re.findall(...)——把 Python 整个 stdlib 变成 LM 的”上下文操作工具集”。 - CodeAct > JSON tool-calling:所有子 LM 调用、所有工具调用都表达为
repl块里的 Python。README 明确把这点写成”信念”——未来的 LM 会被训练写 code 块,而不是吐 JSON。 - Defer to the LM:RLM 不替你做智能分块、不替你做摘要、不替你做 RAG。LM 自己写分块策略、自己写过滤逻辑。系统提示只有 20 行,只教协议。
- 递归 + 预算传导:长 prompt → 派 N 个子 LM(每个只看自己分到的那段)→ 聚合。父给子传
max_budget - parent_spent,子的开销回到父的累加 cost——这套预算/超时沿递归构造器传递是整个工程里最值得搬运的一块。
明确不做什么(“so what” 比 feature 列表更有价值):
- ❌ 不做 RAG / 向量检索
- ❌ 不做自动分块 / 智能摘要
- ❌ 不做多 Agent 辩论 / 投票 / 集成
- ❌ 不做 JSON tool-calling(写成信条)
- ❌ 不做 MemGPT 式的 memory 分页
- ❌ 不做 LangGraph 式的显式 state machine
战略意图
在作者更大图景里,RLM 是 “LM 是 substrate” 哲学的第一个可运行 reference implementation,配上 RLM-Qwen3-8B 这个被训练出来专门写 repl 块的小模型(issue #78 关闭已上 Hugging Face)——这是把”范式”和”模型”绑在一起的尝试。商业化路径不明确:PyPI 包名 rlms、MIT 协议、无公司实体;研究 / 学术影响力是主收益。HALO(context-labs/HALO,876 stars)是它的直接下游”使用者”,把 RLM 当构建块做 agent 自我优化。
核心价值提炼
创新之处
按新颖度 × 实用性排序:
- REPL 变量 + 受训的 RLM 端到端范式(5/5 × 3/5):把”prompt 编程化”从一个 prompt 工程变成一个 训练目标。唯一一个有 “论文 + 训好的模型” 的项目。
- 子调用预算/超时沿递归构造器传递(4/5 × 4/5):父给子传
(max_budget - parent_spent, max_timeout - elapsed),子开销回到父累加。这是把”递归 LM”做安全的核心机制——没有它,单次坏调用就能打爆预算。整个仓库工程最值得搬的一块。 _AnswerDict回调式完成握手(4/5 × 5/5):通过dict子类把answer["ready"] = True变成一个事件,harness 同步捕获最终答案。Pythonic、零依赖、零 post-hoc 扫描——__setitem__拦截器是教科书级的事件化模式。- REPL 变量作为完整上下文抽象(3/5 × 5/5):用版本化
context_N/history_N实现”可加性上下文”,配合_restore_scaffold在每个 cell 之后把context/answer/llm_query/SHOW_VARS重新注入到被污染的命名空间里。 - 阈值触发的压缩 + 原始保留(3/5 × 5/5):根 LM 历史到 85% 上限时让 LM 自压缩;压缩掉的原历史作为 REPL 变量保留——“压缩”和”完整”两全。
- CodeAct over JSON tool-calling 作为范式赌注(5/5 × 3/5):把赌注从 prompt 工程推到 训练 阶段——RLM-Qwen3-8B 是 hedging。
可复用的模式与技巧
- Per-call contextmanager 生命周期(
_spawn_completion_context):给有状态的执行器(REPL / 浏览器 / DB 事务)一个”每次调用一个 namespace”的标准模式;persistent=True旁路掉销毁走多轮对话。适用所有多轮 agent 框架。 - Socket 服务作为 LM 路由 broker(
LMHandler+comms_utils):4 字节大端长度前缀 + JSON,Threaded TCP,自动端口。子进程(modal / daytona / e2b)回拨进父进程的 LM 路由——一个进程拥有 N 个 LM 资源、多个 sub-process 调用的清晰范式。 BaseLMABC + 名字+深度路由:4 方法(sync / async / usage / last usage),get_client(model, depth)按 name match → depth=1 → default 三级 fallback。适用任何有”主 vs 子”调用概念的树状 LLM 工作流。- 预算/超时沿递归构造器传递:父给子剩余预算,子开销回写。适用任何有上限的任务图执行。
- REPL scaffold 恢复(
_restore_scaffold):每个 cell 后重注入可信 globals/locals。适用所有沙箱式脚本执行(Jupyter 类、插件系统、DSL 解释器)。 - 轨迹日志作为运行时与工具的接缝(
RLMLogger):默认内存、可选落盘;visualizer 是个独立 Next.js 应用,只读 log 格式。适用任何想配套 UI 的运行时。 - 每个失败模式一个自定义异常(
BudgetExceededError/TimeoutExceededError/TokenLimitExceededError/ErrorThresholdExceededError/CancellationError),每个都带partial_answer让调用方抢救”已得最佳结果”。
关键设计决策
| 决策 | Trade-off | 学到什么 |
|---|---|---|
rlm.py 单类 912 行做所有事 | 配置/生命周期/主循环/递归/预算/压缩/持久化/回退都在一个类 | 短期快、长期债;理想拆 5 个 mixin |
| 6 LLM provider × 7 sandbox 适配 | 表达力强,组合爆炸 42 cell,CI 只测 2 cell | README 卖 feature、CI 不 enforce,是真实工程风险 |
CI 主动 ignore modal_repl + 整个 tests/clients/ | 让矩阵发出去,承诺”用起来” | 业余项目节奏;3rd-party 集成靠用户自己 |
RLM_SYSTEM_PROMPT_OLD / USER_PROMPT_OLD 留在 prompts.py | 与项目自己的”删死代码”原则冲突 | 论文实验性产物常态 |
_normalize_sampling_args 与 verifiers.OpenAIChatCompletionsClient 隐式耦合 | 跨项目重命名会静默断 | 紧耦合的隐性 API 风险 |
包名 rlms ≠ 仓库名 rlm | 避免与已有 PyPI 冲突 | 命名洁癖 vs 实用 |
竞品格局与定位
RLM 是 inference paradigm(inference 范式),不是 framework——它和下面这几个框架正交。
竞品对比矩阵
| 维度 | RLM (rlm) | DSPy (35k) | LangGraph (35k) | Letta (23k) | HALO (876) |
|---|---|---|---|---|---|
| 抽象层级 | Paradigm | Compiler | Framework | Service | Service |
| 上下文处理 | REPL 变量 | 用户自写 | 用户自写 | Memory paging | 用 RLM |
| 递归 | 原生 | Module 嵌套 | 图边 | 通过消息 | 通过 RLM |
| 训好的模型 | RLM-Qwen3-8B | ❌ | ❌ | ❌ | ❌ |
| JSON tool-calling | ❌(CodeAct) | ❌ | ✅ | ✅ | ✅ |
| RAG/检索 | ❌ | ❌ | ❌ | ✅ | ✅ |
| 持久化 | REPL 变量 | 无 | Checkpoint | DB | DB |
| 沙箱后端 | 7 个 | 0 | 0 | 0 | 0 |
| 论文支撑 | arXiv 2512.24601 | NeurIPS’24 / blog | blog | blog | blog |
差异化护城河
- 论文 + 受训模型的组合 moat:arXiv 2512.24601 + RLM-Qwen3-8B 是这个赛道唯一有”范式论文 + 训好模型”的组合。任何人都能写一个 200 行的 REPL harness,几乎没人能复制”论文 + 训练配方 + reference implementation”三件套。这是 research-IP moat 而不是工程 moat。
- 预算/超时沿递归构造器传递:不是任何框架都做了 LangGraph / AutoGen 在长上下文递归上都有”打爆预算就跑飞”的隐患。
_AnswerDict同步完成握手:避免了”事后扫 namespace”的复杂度——一个细节,但好用。
竞争风险
- 被框架吸收:LangGraph 完全可能加一个 “REPL node” 把这个范式标准化进自己。RLM 真正的 hedge 是 RLM-Qwen3-8B——框架不能复制 checkpoint。
- 被基础模型取代:如果 GPT-6 / Claude 5 原生支持 1M+ 上下文且不烂,REPL 这套 scaffold 的吸引力会下降。但作者博客《RLMs on LongCoT》明确表态:长上下文 ≠ 长推理,scaffold 不会被原生能力取代。
生态定位
“REPL 范式”——在一个大多数项目都是 framework(DSPy / LangGraph)或 service(Letta / HALO)的空间里,RLM 是 paradigm 层的 reference implementation。最近邻是 CodeAct(学术 idea,不是 project)和 MemGPT(memory 模式,不是 REPL)。
套利机会分析
- 信息差:✅ 4.9K stars 在 5.9 个月内,2 天内 +192 stars——尚未饱和,处于爆发窗口。同等质量的项目(KernelBench)已经 8K+ stars,RLM 有空间到 8-10K。HALO 是直接的下游”使用者”,说明已经在被其他项目借力。
- 技术借鉴:✅ 上面 7 个可复用模式里至少 3 个(per-call contextmanager、子调用预算传导、阈值压缩)可以无伤搬到任何长上下文 Agent 项目。
- 生态位:✅ “REPL 范式”这个生态位目前只有 RLM 一个项目填,写文章 / 写博客 / 做内部分享都还有红利。
- 趋势判断:✅ LM-as-scaffold 这个 trend 在升温(Khattab 的 DSPy 已经是 NeurIPS’24 oral,Prime Intellect 在投 RLMs on LongCoT)。RLM 站在范式上游,理论上能吃到所有 framework-level 项目的迁移红利——但前提是 RLM-Qwen3-8B 这个训好的模型被社区采纳。
风险与不足
- Bus factor = 1:Alex Zhang 占 62% commits,社区 21 人各 1-2 commit。Alex 离场即停摆。
rlm.py912 行的 maintainability 税:把 lifecycle / recursion / budget / compaction 全装一个类,未来加 feature 必然 push 这个类继续胖。- 6×7 矩阵 CI 不覆盖:modal / e2b / daytona / prime 沙箱 + 整个
tests/clients/被 CI ignore——README 卖 feature,CI 不 enforce。3rd-party sandbox + LLM 集成实际跑起来一定会 rot。 - Issue #42 未解(核心架构债):
ContextWindowExceededError when sub-calls inherit large prompts in RLM——子 RLM 继承父的query_metadata(携带父的完整 prompt 作为context_total_length),实现没有按系统提示的意图剥掉。结果:子任务 “总结这 50K 块” 把父的 1M 上下文也传过去。这是设计异味——把 RLM 既当”算法”又当”模型无关的 LLM client”必然出现这个缝。 - 业余项目节奏:周末 43% + 深夜 23%,主作者是 MIT PhD;3 月只有 5 commits(投稿/上课期)。6 月已经收尾到 3 commits。
- PyPI 包名 / 项目名 / README 版本号错位:项目
rlm、包名rlms、README 写v1.0.0、pyproject 写0.1.2。新用户 onboarding 容易踩坑。 _normalize_sampling_args与verifiers隐式耦合:跨项目重命名会静默断。- 没有 CHANGELOG。
- 视觉化前端是 research toy:2259 行 TSX,0 测试,ThemeToggle 151 行——UI 漂亮不等于工具可用。
- HALO 是直接下游 = 范式已被吸收的前兆:context-labs/HALO 已经在用 RLM 做 agent 自我优化,意味着这个范式开始被吸收进别的项目;如果 HALO 做大,RLM 反而可能变回”reference impl”。
行动建议
- 如果你要用它:用于单次长上下文任务(百万字 PDF / 大代码库 Q&A / 跨文档聚合)时,RLM 比 LangGraph 更轻、比 Letta 更无运维;选
environment="local"+OpenAI起步(CI 覆盖的唯一组合)。不要直接用 modal/e2b/daytona 沙箱 + 冷门 provider——6×7 矩阵里有 40 cell 是没 CI 保障的。 - 如果你要学它:先读
rlm/core/rlm.py的主循环 +environments/local_repl.py的 REPL 抽象;再读core/lm_handler.py+utils/comms_utils.py看 socket broker;最后读core/rlm.py的_subcall看预算传导。三块读完,整个范式就掌握了。 - 如果你要 fork 它:最有价值的方向是 ① 解决 Issue #42(子调用上下文继承);② 把
rlm.py912 行拆 5 个 mixin;③ 给 6×7 矩阵加 matrix CI;④ 把_normalize_sampling_args与verifiers的耦合解掉。 - 如果你要做自媒体:现在 4.9K stars、2 天 +192 stars 是出圈窗口期;写”RLM 为什么放弃 JSON tool-calling”或”递归 LM 的预算怎么不爆”这两个角度的深度文,转化率会比再写一篇 “LangGraph 教程” 高。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/alexzhang13/rlm(已收录,12 节) |
| Zread.ai | 未收录(403) |
| 关联论文 | Recursive Language Models (arXiv 2512.24601) |
| 作者博客 | alexzhang13.github.io — “Language Models will be Scaffolds”(Feb’26)/ “The Mismanaged Geniuses Hypothesis”(Apr’26)/ “RLMs on LongCoT”(Apr’26) |
| 受训模型 | RLM-Qwen3-8B on Hugging Face(issue #78 已关) |
| 在线 Demo | 无(make quickstart 跑本地 OpenAI 最小测试) |