两周零经验自学造 GPU:1300 行 Verilog 讲透 SIMT 的 tiny-gpu
一句话总结
tiny-gpu 用 11 个全注释的 SystemVerilog 文件(约 1300 行)从零造出一个最小可跑的 GPGPU,刻意砍掉图形专用硬件、只保留所有现代加速器(含 ML 加速器)共通的核心——并行(SIMT)、调度、内存带宽,把「GPU 在硬件层面到底如何工作」讲到 RTL 级。它是一位零芯片背景的工程师两周自学的产物,却成了开源 GPU 学习链条的最底层入口。
值得关注的理由
- 填补了一块真实的知识空白:CPU 的「从架构到控制信号」教材遍地都是,但 GPU 因商业竞争,底层细节几乎全是专有的。tiny-gpu 是少有的「为读懂而生」的 GPU 实现——对比 Miaow/VeriGPU 这类「以功能完整与可综合为目标因而复杂」的项目,它把概念讲清就收手,一个下午就能通读整条数据通路。
- 概念与代码的字面同构:SIMT 被直译成「1 份取指/译码/调度 + generate 出 T 份 ALU/LSU/寄存器」的硬件结构,调度器 6 个状态与文档 6 个阶段逐字对应,CUDA 的
blockIdx/blockDim/threadIdx硬连成 3 个只读寄存器——读代码几乎等于读教材。这种「教学优先于工程」的取舍本身就是值得学的设计哲学。 - 一个现象级的传播样本:作者「两周零经验自学造 GPU」的 X thread 约 71 万浏览,被 Tom’s Hardware、PC Gamer 等主流科技媒体报道。它证明了「过程透明 + 文档详尽」可以替代「权威头衔」建立可信度——12.5K star 里很大一部分来自这条叙事而非代码本身。
项目展示
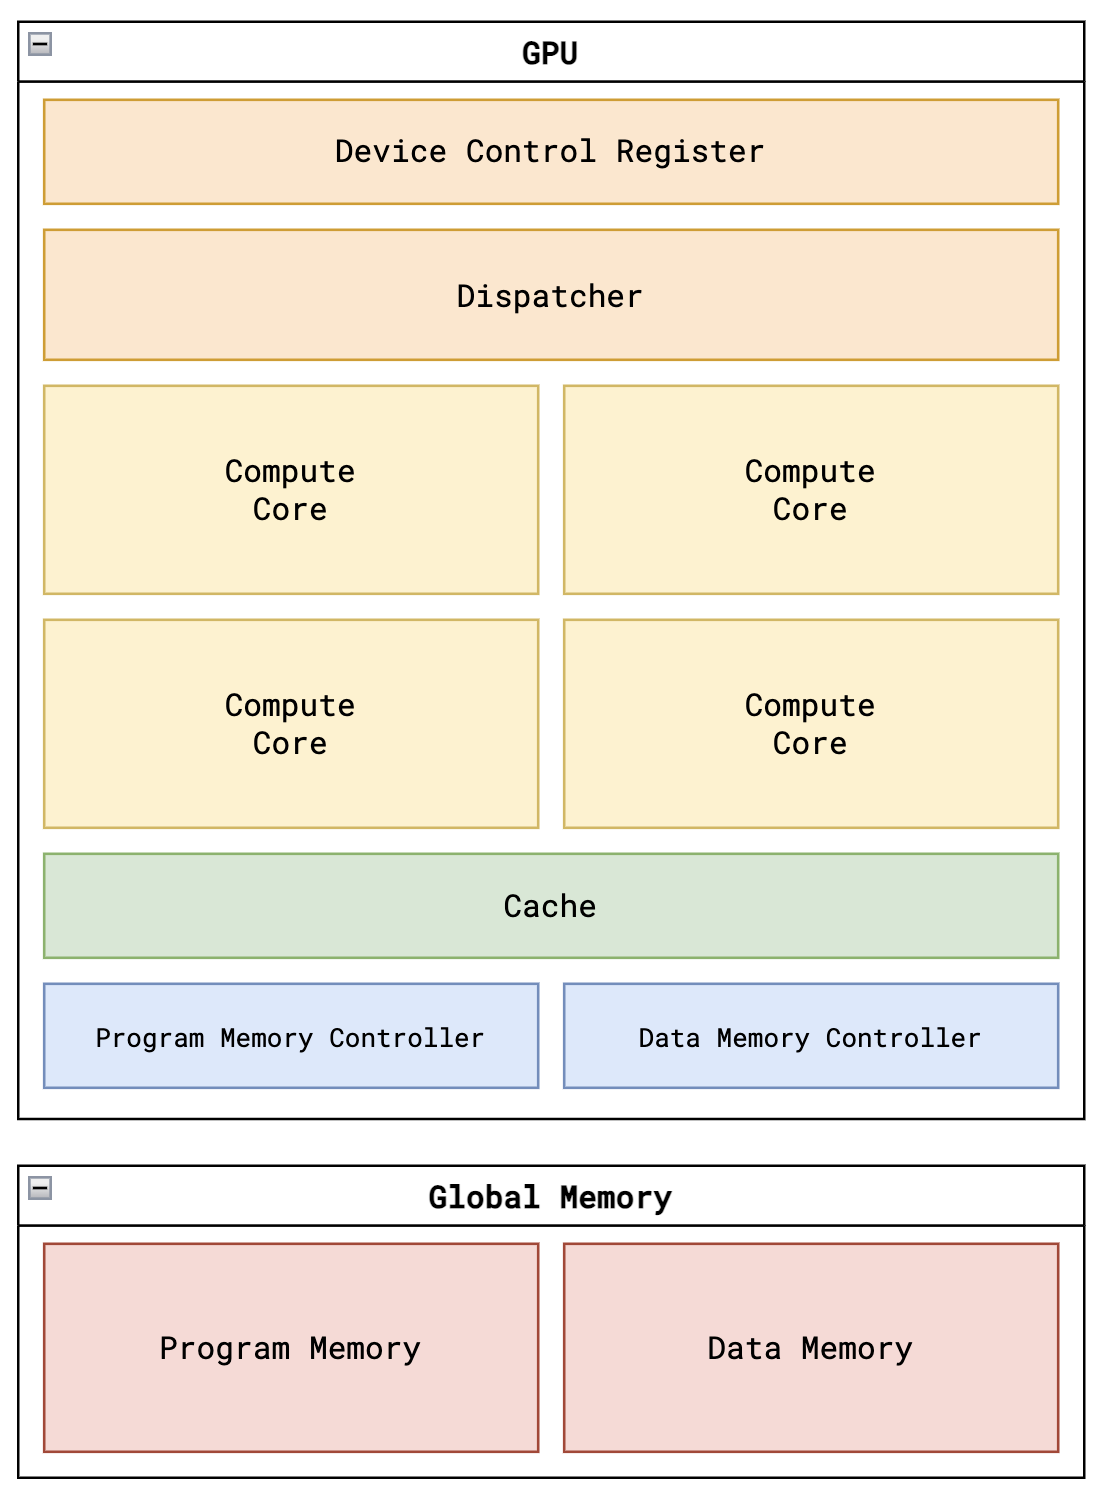
顶层结构:dispatcher 调度多个 core,双内存控制器仲裁数据/程序访存带宽。
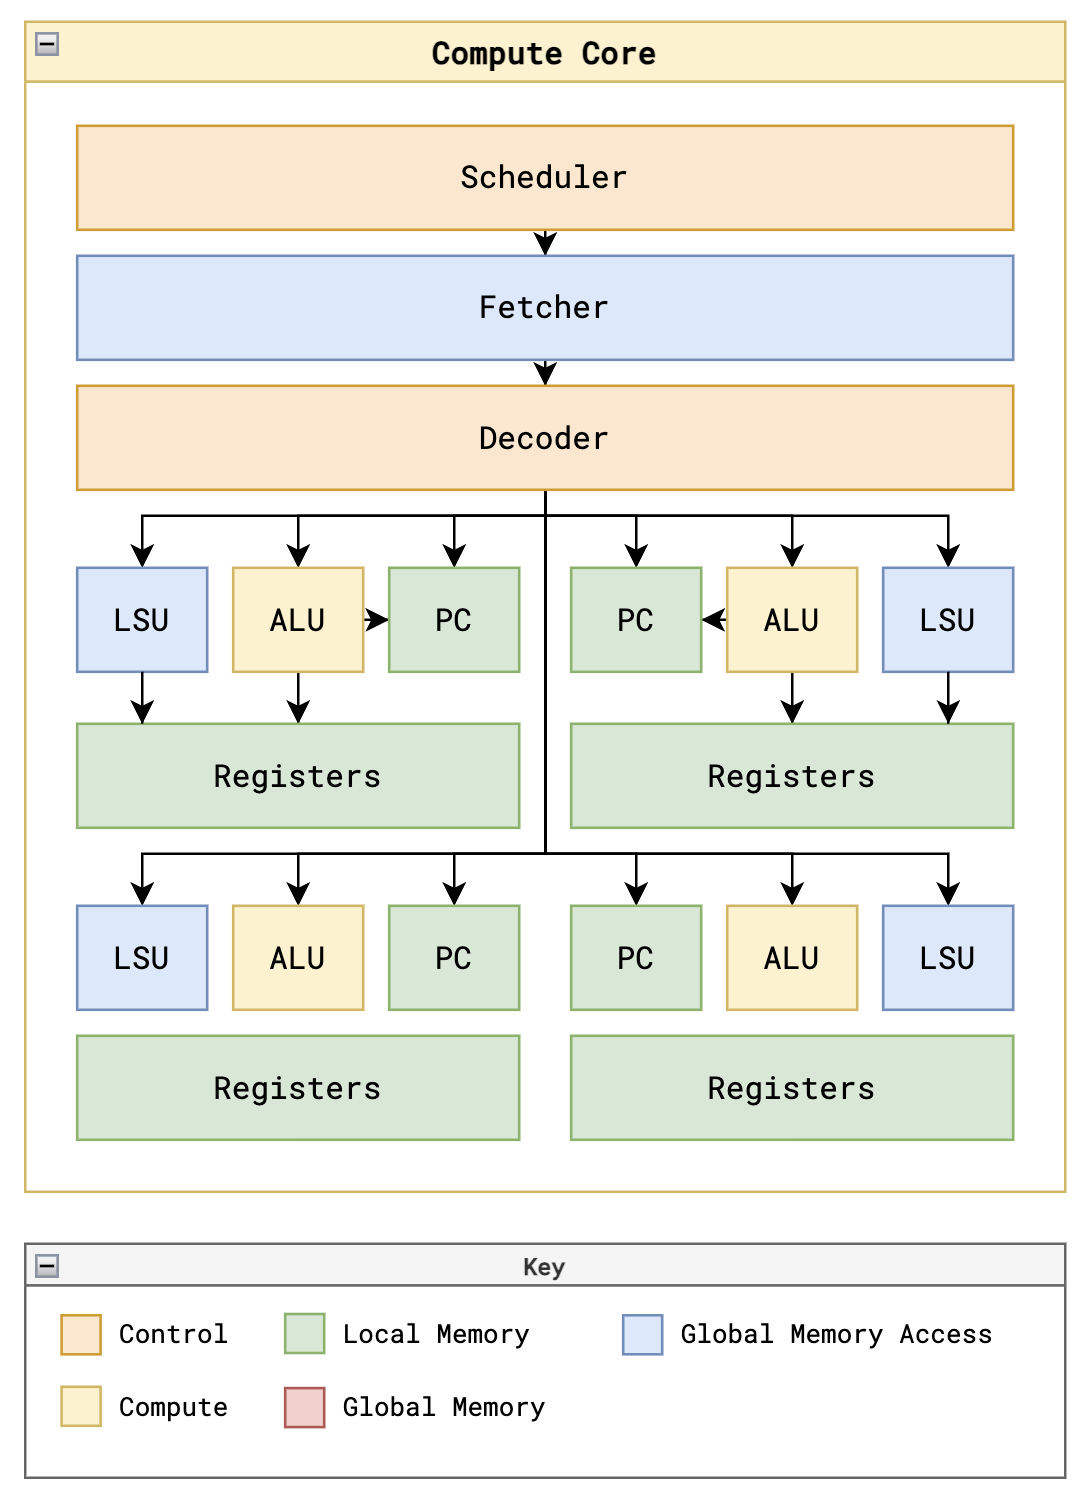
一个 core = 1 份 fetcher/decoder/scheduler(共享前端)+ T 份 ALU/LSU/registers/PC(多后端),这就是 SIMT 的硬件定义。
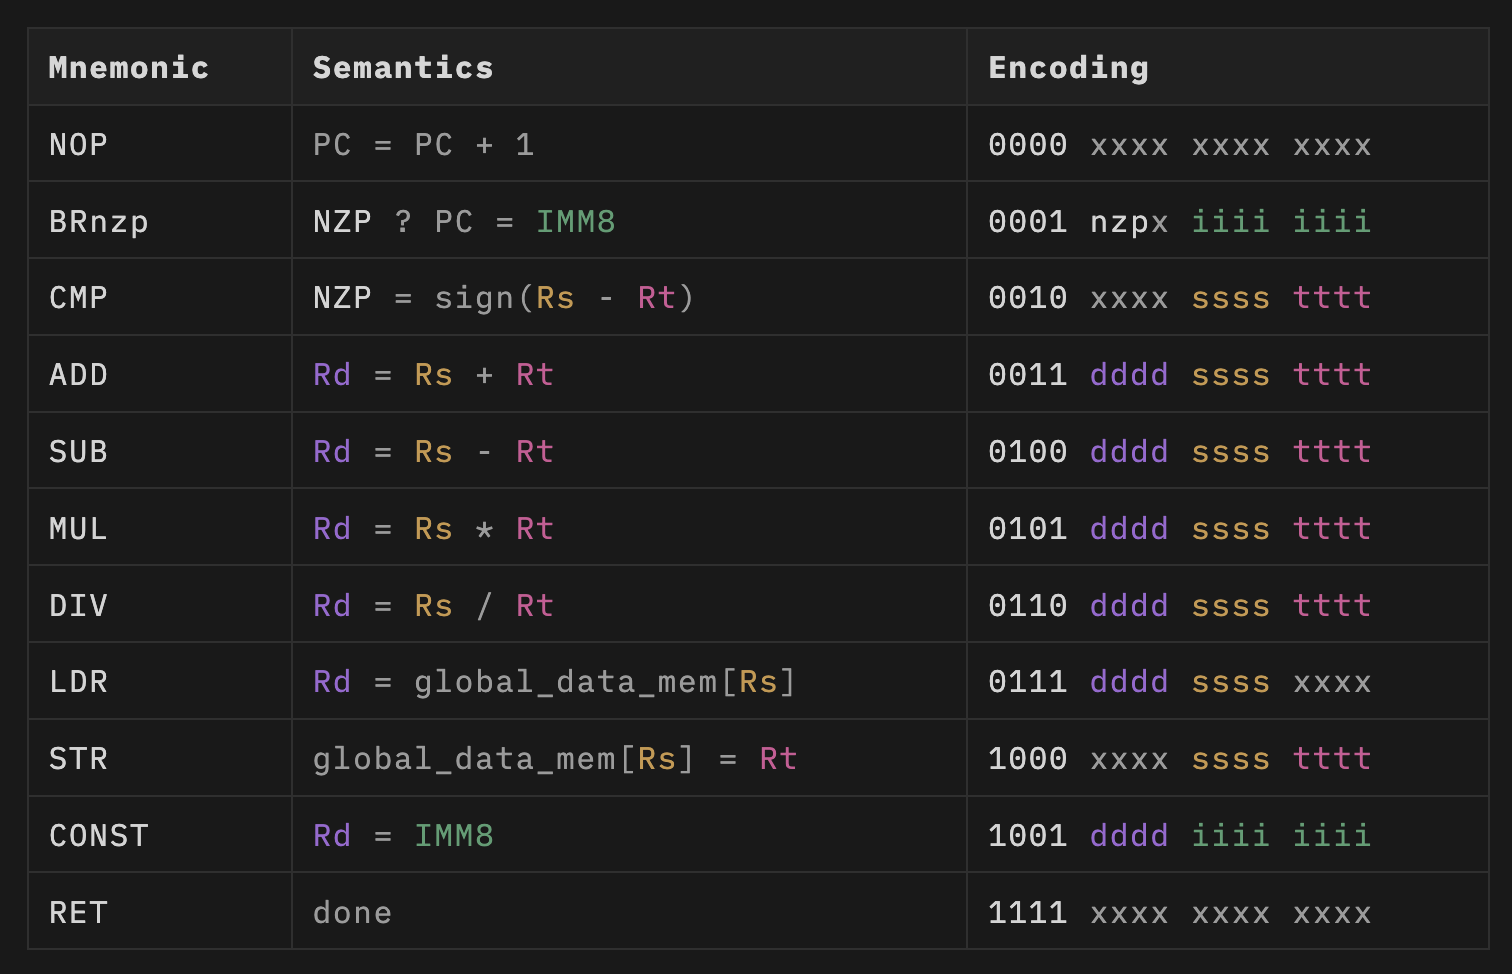
极简指令集:算术、内存读写、LC-3 式 NZP 比较/分支,以及读取线程内建变量的特殊寄存器。
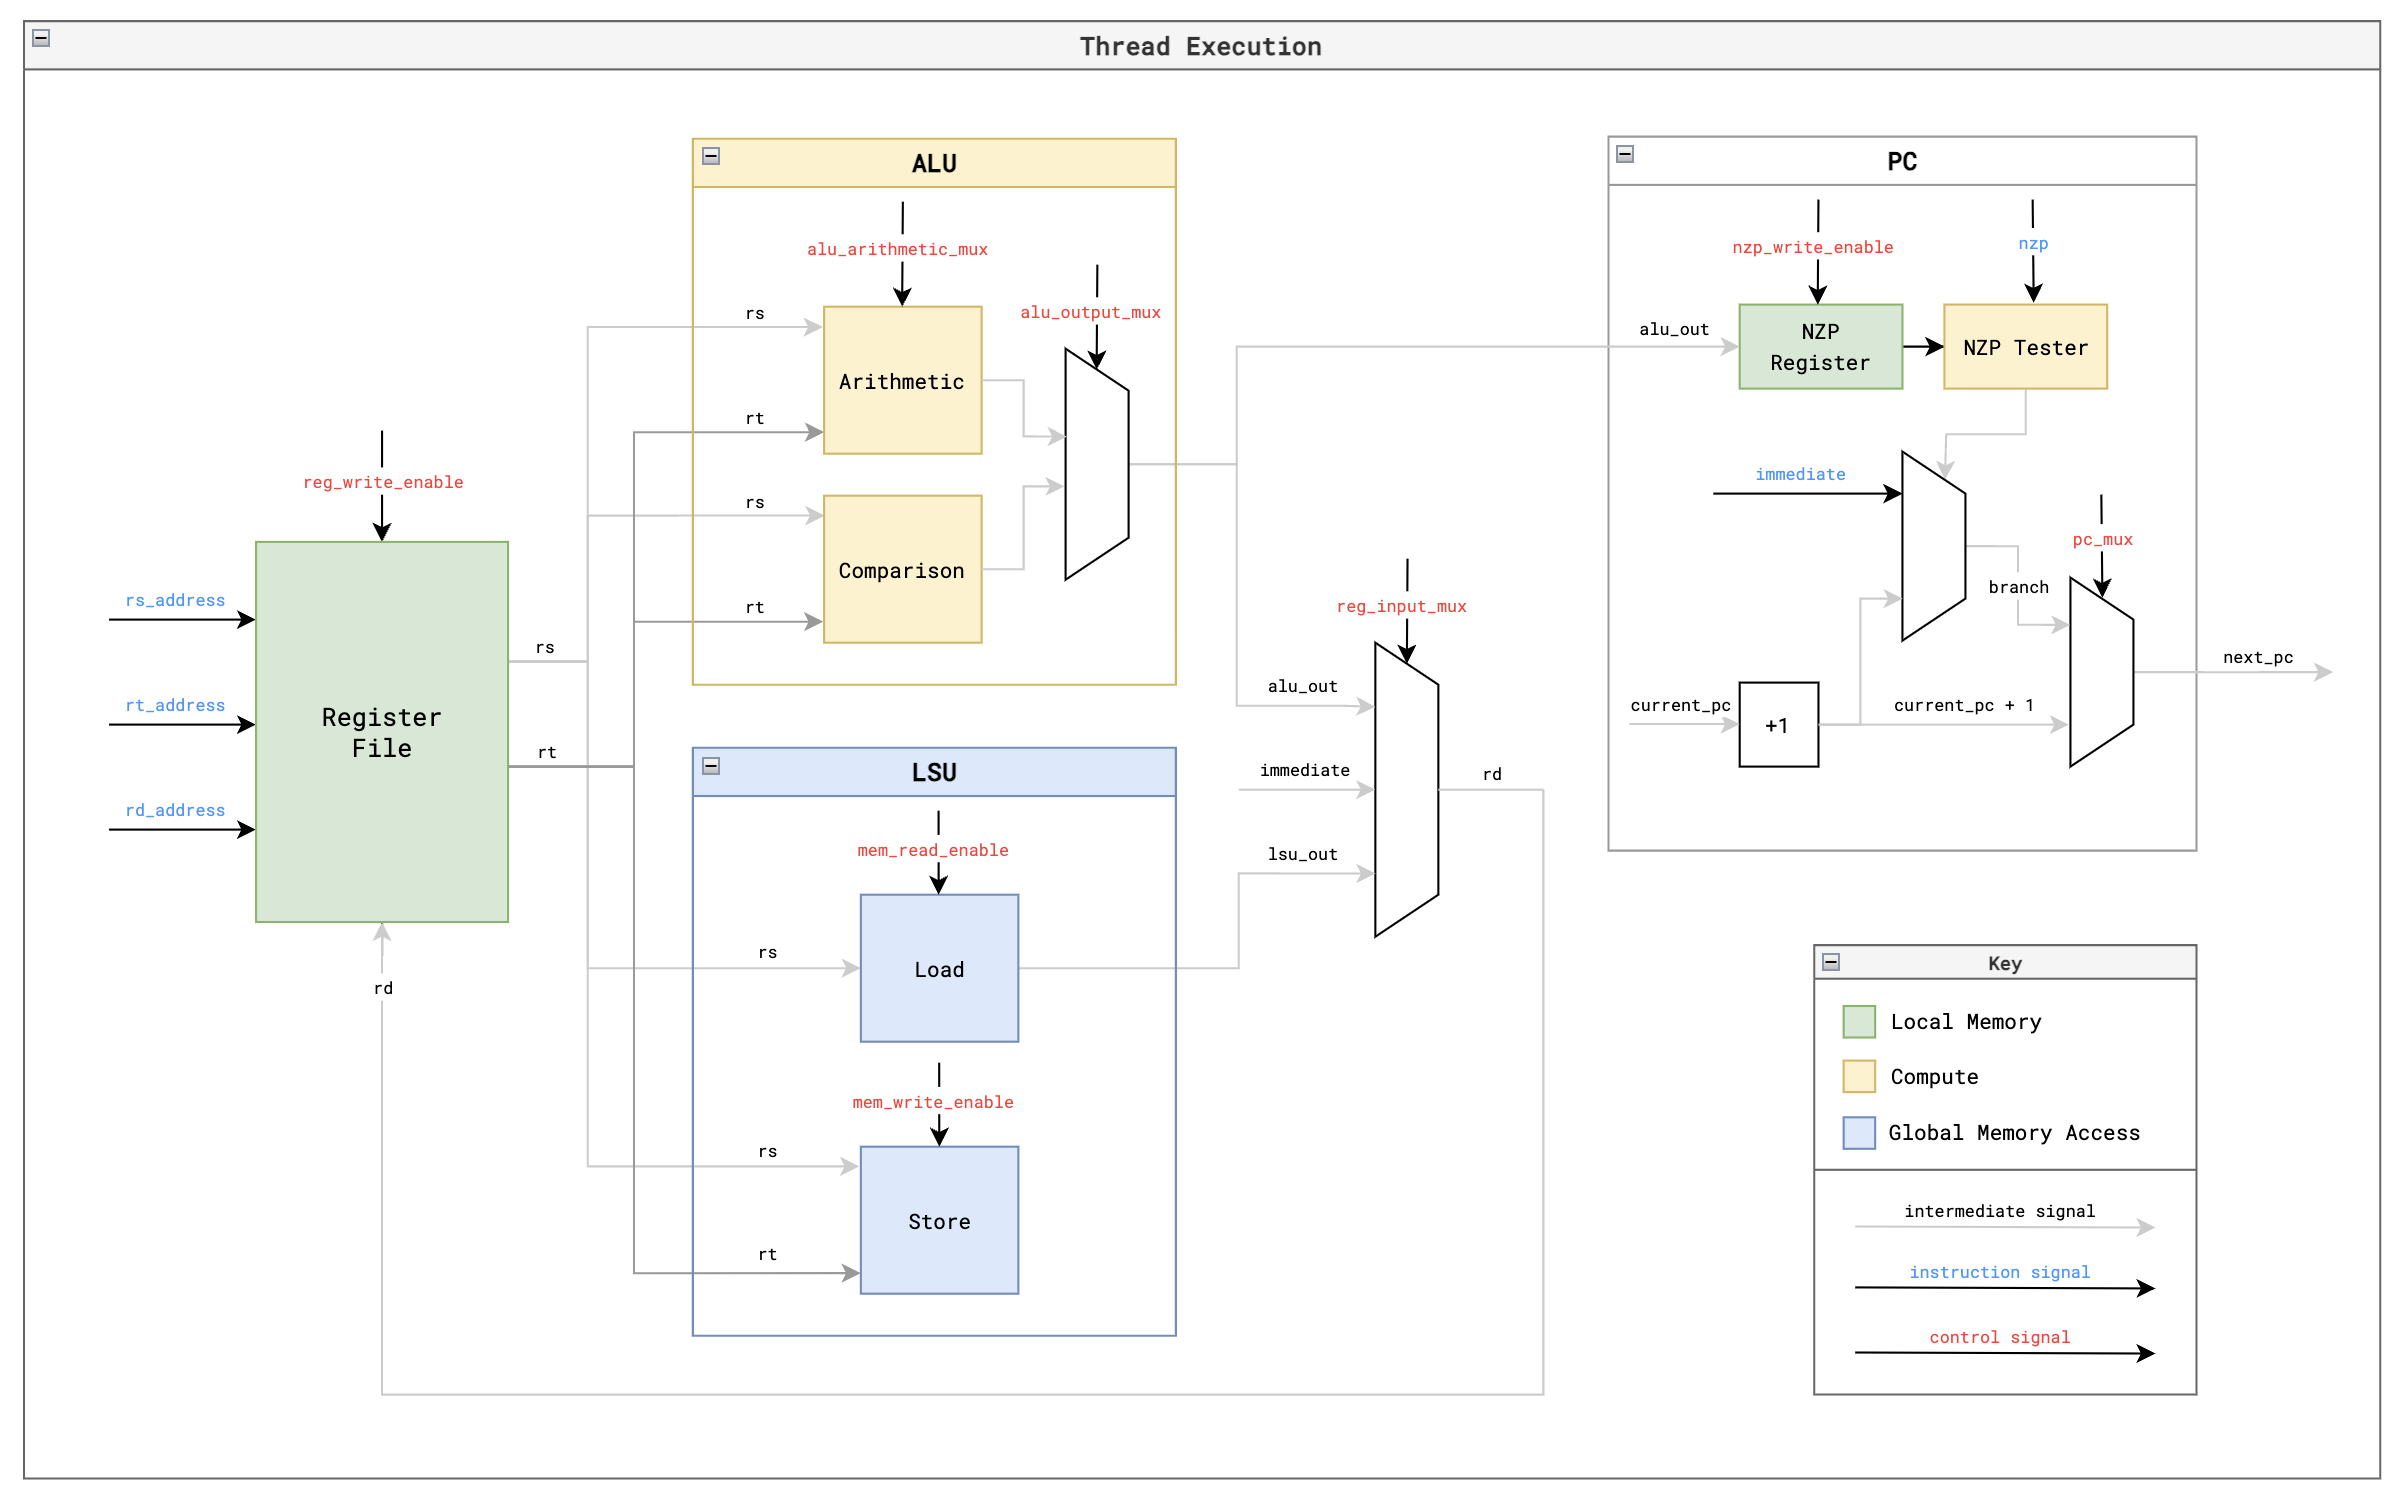
单个线程的执行通路。
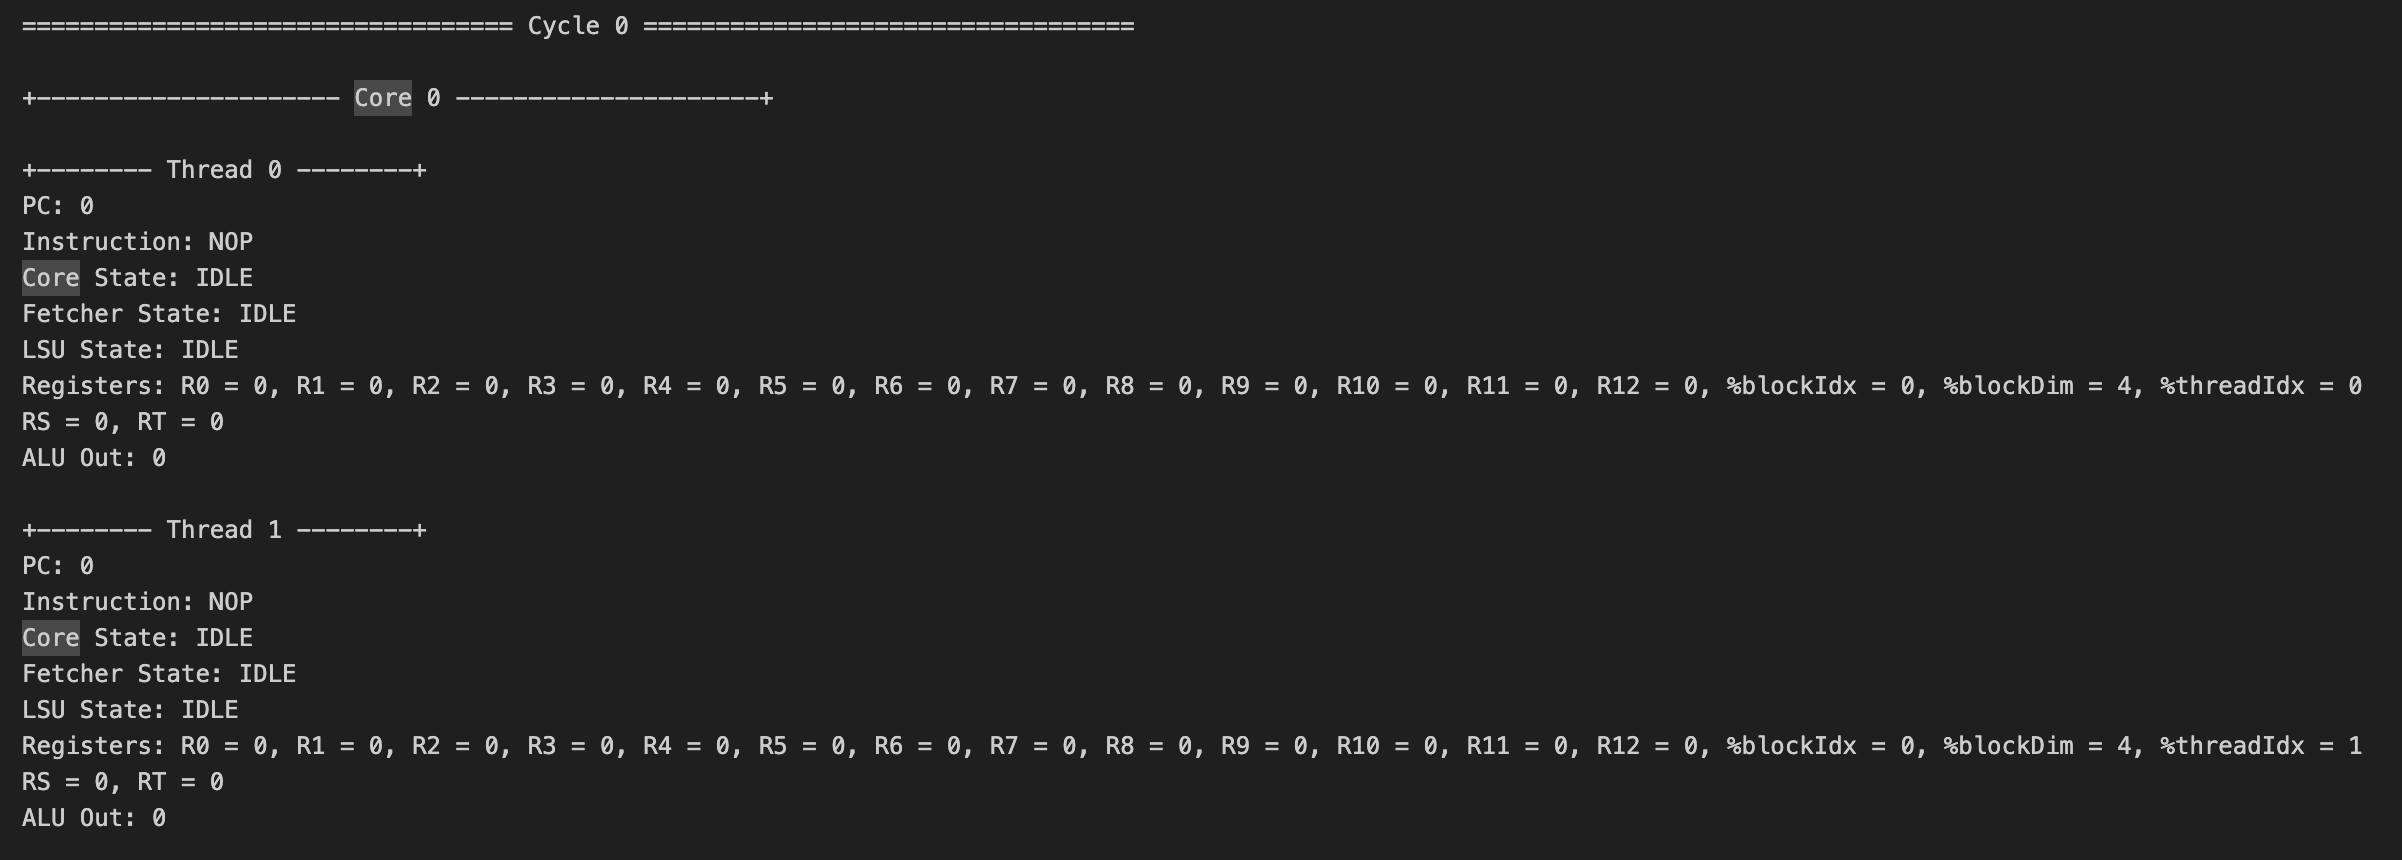
矩阵运算 kernel 的仿真执行追踪。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/adam-maj/tiny-gpu |
| Star / Fork | 12,544 / 1,194 |
| 代码行数 | 1,425 行(SystemVerilog 72.7% / Python 26% 测试脚手架 / Makefile),21 文件 |
| 项目年龄 | 25.9 个月(2024-04 创建);89/90 commit 集中在 2024-04 单月 |
| 开发阶段 | 完结 / 使命达成型(机械分级标「已放弃」实为误读——一次性把概念讲透即定型,停更近两年但 star 仍高速增长) |
| 贡献模式 | 单人主导(Adam Majmudar 占 97.7% commit) |
| 热度定位 | 大众热门 · 常青教学精品 |
| License | 无 ⚠️(issue #7,法律上默认「保留所有权利」,复用前必读) |
| 质量评级 | 代码「良好」 文档「优秀」 测试「基本」 |
作者视角:为什么存在这个项目
创始人/作者背景
Adam Majmudar(@MajmudarAdam)是自学型工程师:UPenn 计算机+神经科学辍学、thirdweb 创始工程师,现就职 OpenAI「Research + special projects」。无芯片设计科班背景——tiny-gpu 是他「两周零经验自学造 GPU」的产物,是其「from-scratch 系列」(deep-learning、mini-evm、robotics、Tiny Tapeout)中 star 最高的代表作。可信度建立在过程透明与文档详尽,而非权威资历。
问题判断
典型 dogfooding——作者本人作为「学习者」亲历了「想搞懂 GPU 硬件却无可读资料」这个痛点(GPU 底层细节因商业竞争多为专有),于是把自己的学习路径产品化。时机踩中 GPGPU/ML 加速器热潮,让「理解 GPU 而非图形卡」成为有需求的命题。
解法哲学
极致的 Unix 式「做一件事」+「教学优先于工程」。每一处都能看到「为讲清概念牺牲真实性/性能」的取舍:单 kernel、单 block 串行、所有线程锁步、6 阶段状态机完全不流水。作者把明确不做的清单(多级缓存、内存合并、流水线、warp 调度、分支发散、屏障同步)写进 README 的「Advanced Functionality」,把「最小集与真实 GPU 的差距」本身变成教材。
战略意图
它是作者个人品牌与内容资产的一环,非商业基础设施。开源意图明确(反复邀请 PR),但无任何 LICENSE 使这个意图在法律上落空。值得注意的是它不止是仿真玩具——已通过 OpenLane 布局并提交 Tiny Tapeout 7 流片,gds/ 目录里有真实 GDSII 产物。
核心价值提炼
创新之处
- SIMT 的「共享前端 / generate 多后端」直译(可迁移性 5/5):
core.sv里fetcher/decoder/scheduler各一份,alu/lsu/registers/pc用for (i=0; i<THREADS_PER_BLOCK)generate 出 T 份,译码出的控制信号作为公共总线广播给所有 lane——一条指令译一次、驱动所有线程,SIMT 概念与 RTL 结构字面同构,且改一个参数即变核宽。 - LC-3 式 NZP 分支模型移植进 GPU(新颖度 4/5):
CMP把两寄存器之差的负/零/正写入 3 bit NZP 寄存器,BRnzp用掩码匹配(nzp & decoded_nzp) != 0实现条件跳转。这套机制来自计算机组成原理课堂(LC-3 教学 CPU),而非任何真实 GPU ISA——是「从教学 CPU 借分支机制」的跨域移植。 - 用「取最后线程 next_pc + TODO 注释」标注简化边界(作为文档手法,新颖度 4/5):每个线程各算自己的
next_pc[i],但调度器直接current_pc <= next_pc[THREADS_PER_BLOCK-1]、丢弃其余并留// TODO: Branch divergence。它不实现分支发散(GPU 调度器最难的部分),而是把「发散该在哪处理、为什么难」可视化——这是教学项目「展示问题边界」的高明手法。 - 内存控制器把访存瓶颈建模成「N 消费者竞争 M 通道」仲裁(可迁移性 5/5):
controller.sv参数化NUM_CONSUMERS(所有 LSU)对NUM_CHANNELS,每通道一个 FSM 线性扫描找 pending 请求,用channel_serving_consumer位向量互斥锁(阻塞赋值保证同周期可见)防止两通道抢同一请求——把「带宽如何成为瓶颈、请求如何排队」讲清楚。
可复用的模式与技巧
- 共享控制 + generate 多数据通路:一份译码总线广播给 N 份数据单元——任何 SIMD/向量单元、张量阵列的参数化 RTL 骨架。
- 概念阶段 1:1 映射 FSM 状态:状态机命名与文档阶段逐字对应,让「代码即文档」——教学型/可审计 RTL 通用。
- valid/ready 四态握手 + 中继 FSM:REQUESTING→WAITING→DONE,由上层 state 复位——任何异步外设(内存/总线/DMA)接入同步核。
- M 通道 N 消费者带宽仲裁器 + 互斥位向量:参数化资源池建模——片上互连、DMA、连接池通用模板。
- 编程模型变量硬连为只读寄存器 + 写回地址守卫:
rd_address < 13物理隔离blockIdx/blockDim/threadIdx——需在硬件暴露不可变上下文(线程 ID/核 ID)时可借鉴。 - 「Advanced Functionality + Next Steps」把省略项写成教材:明确列出「故意没做什么及为什么」——任何最小化教学项目的范围声明范式。
关键设计决策
最值得学的是用 CUDA 编程模型反推硬件 substrate:registers.sv 把 16 个寄存器的后 3 个设为复位时初始化的只读寄存器——reg13=%blockIdx(dispatcher 下发的 block_id)、reg14=%blockDim(编译期参数 THREADS_PER_BLOCK)、reg15=%threadIdx(generate 时每个实例不同的 THREAD_ID),写回逻辑用 decoded_rd_address < 13 物理禁止写这 3 个。于是 kernel 里 i = blockIdx*blockDim + threadIdx 这行 CUDA 惯用法,靠每个 lane 的 reg15 不同算出不同地址——同一份指令流产生不同行为,SIMT 的本质一目了然。
竞品格局与定位
竞品对比矩阵
| 维度 | tiny-gpu | VeriGPU | NyuziProcessor | Miaow |
|---|---|---|---|---|
| 定位 | 最小可读教学 GPGPU | RISC-V GPU,瞄准 ASIC | Larrabee 风格 GPGPU | 学术 compute unit |
| ISA | 11 条自制指令 | RISC-V | 自定义 + LLVM | AMD Southern Islands |
| 体量 | ~1300 行 / 11 文件 | 大 | 大(含编译器+模拟器) | 学术级完整 |
| 工具链 | 仅 cocotb 仿真 | 完整、PyTorch 兼容 | LLVM 端到端 | 研究工具 |
| 适用 | 入门读懂 | 造可用真 GPU | 可用开源 GPGPU | 架构研究 |
差异化护城河
信任护城河(「两周零经验自学造 GPU」的过程透明叙事 + 71 万浏览的传播)+ 教学护城河(在「小到能通读的 GPU 实现」这个维度上无竞品对标)。技术上无护城河——代码刻意简单可复制,这恰是它的目的。
竞争风险
最可能被「同类教学项目 + 配套编译器」替代。当前最大功能缺口是 issue #36 的 ISA 编译器(手写二进制 kernel 门槛高),谁补上「高层代码 → 11 条 ISA」这一环,谁就可能在教学心智上超越。
生态定位
GPU/ML 加速器硬件知识的入门台阶——读懂它之后再去啃 Nyuzi/VeriGPU/Miaow,是整个开源 GPU 学习链条的最底层入口。(注意需澄清:tinygrad 是 ML 框架/软件,常被名字误认作硬件,与 tiny-gpu 无竞争关系。)
套利机会分析
- 信息差:不属于「被低估」(已是头部教学项目),但属于「常青教学资产」——停更 ≠ 失效。它是一次性把「GPU 是什么」讲透的完结型参考,价值在于经典选题 + 持续搜索/star 流量(近 18 天仍采样到 143 个新 star),而非新鲜度。
- 技术借鉴:generate 多数据通路、握手中继 FSM、M:N 带宽仲裁器、只读寄存器守卫——这些 RTL 模式与「GPU」本身无关,可迁移到任何 SIMD 协处理器、DMA、片上互连的设计或教学。
- 生态位:填补「最小、可读、为学习而生」的 GPU 实现空白,与「完整可综合」的重型开源 GPU 错位互补。
- 趋势判断:GPGPU/ML 加速器是上升赛道,「理解 GPU 底层」需求持续;它作为最底层入口的地位稳固,最大变数是是否有人补上编译器一环。
风险与不足
- ⚠️ 无 License(结构性硬伤):项目无任何开源协议(issue #7),法律上默认「保留所有权利」——fork、二次开发、商用、纳入课程材料均无授权依据,与「供学习参考」的定位直接冲突。这是复用前必须知道的缺口。
- 正确性的教学性简化:分支发散未处理(只取
next_pc[T-1]并假设收敛,任何会发散的 kernel 都会算错)、内存仲裁线性扫描会饿死高 index 消费者、DIV未防除零——都是 README 坦诚标注的教学取舍,但意味着它不能当生产硬件用。 - 构建门槛:依赖 cocotb + iverilog + sv2v 工具链,对新手不友好(issue #17/#43),「跑起来」有摩擦。
- 无编译器:kernel 需手写成二进制指令,缺少 ISA 编译器(issue #36),从「读懂」到「自己写 kernel」之间还差一环。
- 工程化缺失:无 CI、无 linter(代码里有拼写错误与残留尾逗号)、无 CHANGELOG、无版本 tag。
行动建议
- 如果你要用它:想搞懂 GPU/ML 加速器在硬件层如何工作——这是当前最易上手的入口,建议对照 README 的架构图通读
src/全部 11 个 .sv,再跑 matadd/matmul 两个 demo。但不要把它当可复用代码(无 License + 教学性简化),它是教材不是库。 - 如果你要学它:重点读
core.sv(SIMT 的 generate 实现)、scheduler.sv(6 阶段锁步 FSM + 分支发散简化)、controller.sv(M:N 带宽仲裁)、registers.sv(CUDA 变量硬连只读寄存器)、pc.sv(NZP 分支)。配合 DeepWiki 的分章架构文档。 - 如果你要 fork 它:最有价值的二次创作是补 issue #36 的 ISA 编译器(高层代码 → 11 条指令),以及实现 README「Advanced Functionality」里列出的分支发散/流水线/缓存——每一项都是一篇现成的进阶教学。但务必先联系作者补一个 LICENSE。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/adam-maj/tiny-gpu(已收录,含架构/硬件模块/ISA/编程模型分章) |
| Zread.ai | 未能验证(返回 403) |
| 关联论文 | 无(非研究型项目) |
| 在线 Demo | 无(已通过 OpenLane 布局并提交 Tiny Tapeout 7 流片) |
| 作者原始 thread | adammaj on X(约 71 万浏览的「两周造 GPU」记录) |