73K stars 反超 Airflow:Apache Superset 凭 50+ 数据库适配稳坐 ASF 数据栈门面
一句话总结
Apache Superset 是一套”对数据库友好的开源数据可视化与探索平台”——同时具备无代码图表构建器、SQL IDE、轻量语义层和嵌入式 Dashboard,并以 50+ 种数据库方言适配作为十年来最深的护城河,是 ASF(Apache 软件基金会)数据栈对外的第一门面。
值得关注的理由
- ASF 数据栈门面担当:73,108 stars 超越同属 Apache 的 ECharts(66.4k)、Airflow(45.6k)、Spark(43.3k),是 Apache 数据生态最显眼的招牌项目。
- 「一人双 TLP」的稀缺起源:创始人 Maxime Beauchemin 同时是 Apache Airflow 和 Apache Superset 的缔造者——罕见的产品哲学连贯性,Preset 商业化反哺开源形成”半公开 PMC”治理。
- AI 时代的早期卡位:2025 年末推出开源 BI 领域首个完整 MCP Service(Model Context Protocol,模型上下文协议),把 dashboard/chart/dataset 暴露给 LLM Agent 消费,是所有 OSS BI 工具里最前卫的 AI-native 尝试。
项目展示
— 官方项目概览视频(来自 README 顶部)
 — 40+ 图表类型一览,体现”Rich visualizations”卖点
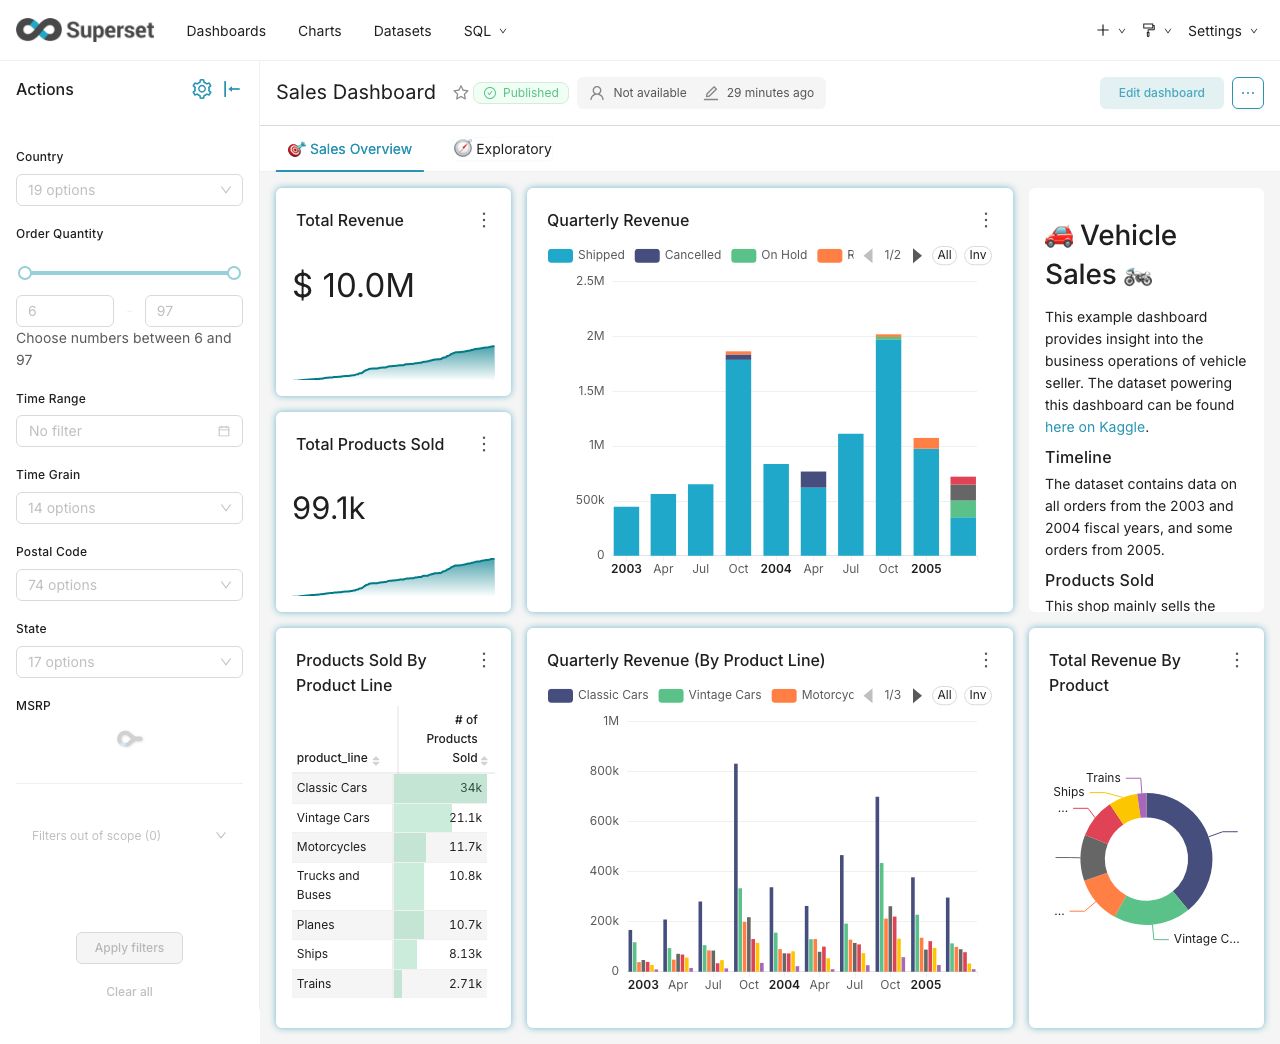 — 仪表盘布局与原生 filter 体验
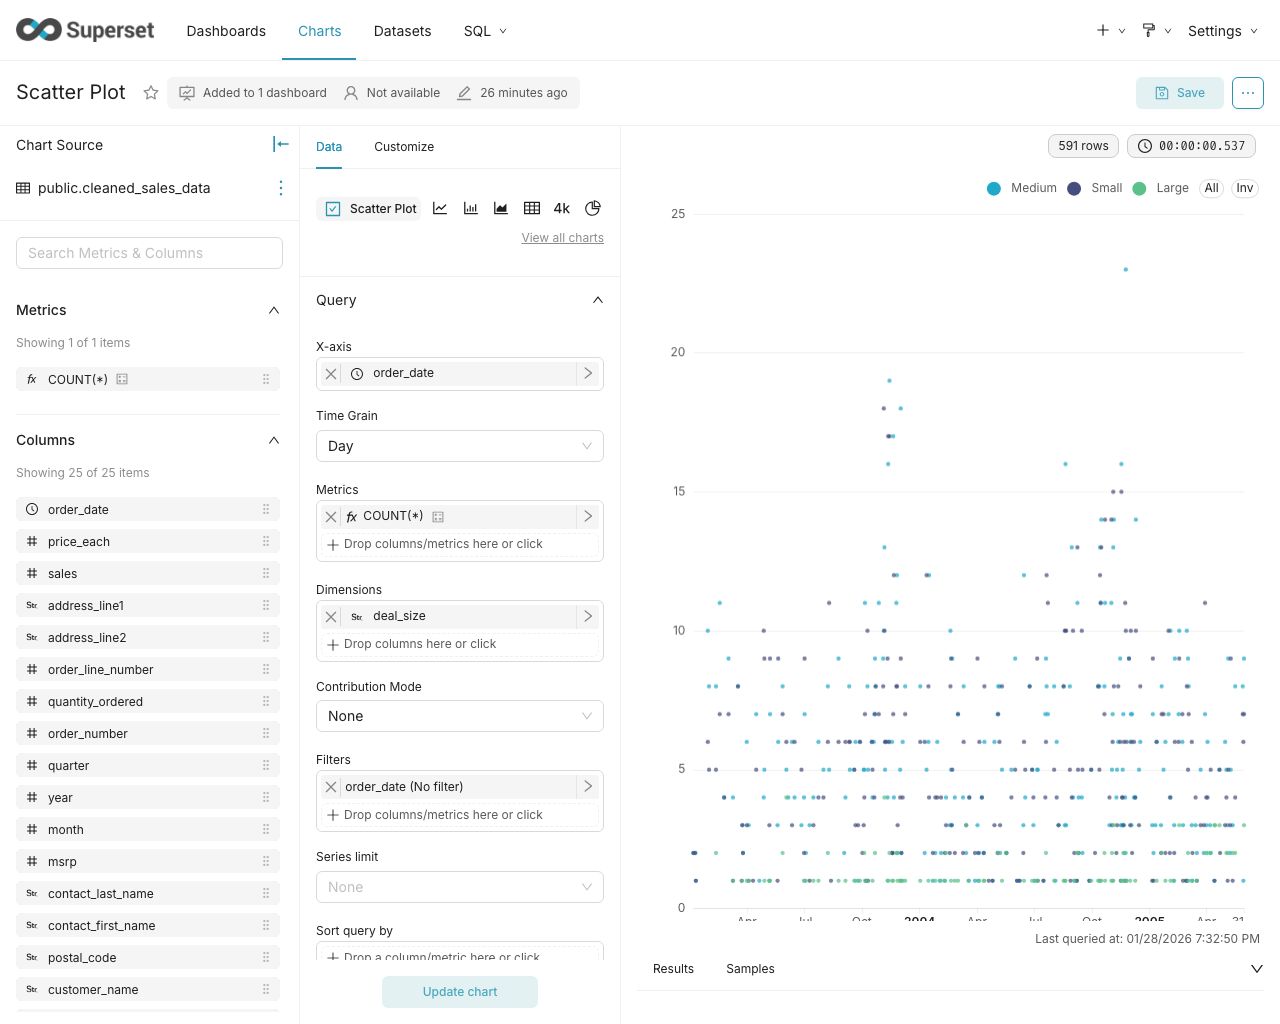 — 拖拽式无代码图表构建
 — Web IDE 风格 SQL 编辑器(异步查询走 Celery + WebSocket)
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/apache/superset |
| Star / Fork | 73,108 / 17,439 |
| Watcher / Open Issues / Open PRs | 1,532 / 641 / 623 |
| 主语言 / 次语言 | TypeScript 50%(含 TSX 27.4%)/ Python 35.2% |
| 真实可维护代码 | ~88 万行(剔除 i18n 与 mdx 后) |
| 文件数 | 8,575 |
| 项目年龄 | 131 个月(2015-07-21 首次 commit) |
| License | Apache-2.0 |
| 开发阶段 | 繁荣期(2026-05 月均 474 commit,当前第 4 个增长高峰) |
| 贡献模式 | 社区驱动 + 商业化公司主导维护(Preset 7 名核心 + dependabot 2,054 次 commit) |
| 热度定位 | 大众热门(ASF 全项目 Star 第一) |
| 质量评级 | 代码 良好 / 文档 优秀 / 测试 基本(0.79 测试/源码比) |
作者视角:为什么存在这个项目
创始人/作者背景
Maxime Beauchemin(GitHub: mistercrunch),2014 年在 Airbnb 担任数据基础设施负责人时,从 0 到 1 设计了内部 BI 工具 panoramix(Superset 前身)。Airbnb 的 PB 级数据栈(Airflow + Druid + Hive + Presto)和分析师协作痛点直接催生了 Superset 的功能集合。Max 的两个关键背景塑造了项目:
- 数据栈消费者的视角——他不是从 BI 厂商侧思考,而是从「我们这种数据团队要怎么消费自己的数据」出发,这决定了 Superset 的「不内嵌查询引擎」原则。
- Airflow 同源哲学——Max 同时是 Apache Airflow 的创始 PMC member(项目管理委员会成员),带来「以代码为配置、Python 优先、plugin 体系」的一致哲学,Superset 的核心抽象(plugin 三件套、Extension SDK)都能看到 Airflow 的影子。
他后来创办了 Preset(preset-io),提供 Superset 商业化 SaaS 托管和企业插件,承担了 50%+ 核心维护量(villebro 856、betodealmeida 786、michael-s-molina 784、rusackas 680 等 Preset 员工)。这种「先开源、后公司」的顺序是 Superset 社区权威的来源。
问题判断
2014 年的 BI 市场被三个选项垄断:Tableau(重客户端、单机部署、价格贵)、Looker(重实施 + LookML 闭源)、Pentaho(老旧 Java 栈)。这些工具对 Airbnb 这种「数据团队 = 数据栈消费者」的场景来说都太重、太贵、定制空间太小。Max 看到的机会窗口是:「用现代 Web 栈自研、Apache 协议开源、把 SQL 当一等公民、把宽数据库适配作为头等卖点」——一个 Tableau 太贵、Looker 太重、Pentaho 太旧的清晰市场缝隙。
解法哲学
做:Python + Flask 全栈自研、无代码 + SQL Lab 双模分析、虚拟数据集 + 轻量语义层、可编程 REST API、云原生横向扩展、插件化图表架构。
明确不做:
- 不内嵌查询引擎(issue #241 在 2016 年就明确表态:Spark SQL backend 不在 Superset 内部跑,而是连出去)。
- 不做 ETL/数据摄入层(不复制 Airflow 的领地)。
- 不做 LookML 那种重量级语义建模语言(语义层是「轻量 Virtual Dataset + Metric + RLS Filter」组合,UI 可视化配置)。
- 不在前端绑定具体图表库(从 NVD3 迁到 ECharts 是一次大型迁移,证明渲染引擎被视为可替换件)。
战略意图
Preset 提供 SaaS 托管 + 企业级插件(高级权限、审计、合规),Superset 主干保持 Apache-2.0 全部开源。这种「Open-core 边界画在 hosted SaaS + 高级权限」是平衡社区活跃度与商业收入的成熟路径。2025 年末推出的 MCP Service 是 AI 时代的卡位动作——把 dashboard/chart/dataset 暴露为 MCP tools,让 LLM Agent(Claude、Cursor 等)能直接调用 Superset 的能力。
核心价值提炼
创新之处
-
Type-Class 数据库方言抽象(
superset/db_engine_specs/base.py2,795 行 + 50+ 子类) 把多态从调用方(if engine == "bigquery")下放到数据(每个 EngineSpec 自带 override),新增数据库 = 新增一个文件,PR diff 小、review 简单。 新颖度 ★★★ · 实用性 ★★★★★ · 可迁移性 ★★★★★ -
插件三件套约定(transformProps + controlPanel + buildQuery)
superset-frontend/plugins/plugin-chart-echarts/下每个图表(Timeseries/Pie/BoxPlot…)都遵循同一约定,复制模板 + 改 transformProps 即可新增图表。 新颖度 ★★★ · 实用性 ★★★★★ · 可迁移性 ★★★★★ -
MCP Service(首个开源 BI 的 AI 时代入场券)
superset/mcp_service/用@mcp.tool把核心资源暴露给 LLM,并采用<UNTRUSTED-CONTENT>信任边界标签、动态 prompt 拼装、0-based 内部 / 1-based 对外等工程化 prompt injection 防御。 新颖度 ★★★★ · 实用性 ★★★★ · 可迁移性 ★★★★★ -
Generic[T] 抽象
ModelListCore把 8 个 MCP list tools(dashboards/charts/datasets/databases/tags/css_templates/annotation_layers/layer_annotations)的通用逻辑(filtering/select_columns/pagination/排序/隐私过滤)抽到 117 行代码。 新颖度 ★★ · 实用性 ★★★★★ · 可迁移性 ★★★★ -
shillelagh 库:把 GSheets/CSV/Athena 暴露为 SQL 已独立成 PyPI 库,用 ADBC(Arrow Database Connectivity)抽象数据源,让”非数据库”也能参与 JOIN。 新颖度 ★★★★ · 实用性 ★★★ · 可迁移性 ★★★★
可复用的模式与技巧
- Type-Class 模式(
db_engine_specs/)→ 多 SDK 适配场景(云厂商、AI 模型、消息队列) - 插件三件套(
plugin-chart-echarts/)→ 配置驱动的可视化/工作流/表单 - 异步查询 + 独立 WebSocket(
superset-websocket/+ Celery)→ 任何”请求-响应 > HTTP 容忍度”的服务 - 嵌入式 SDK + Guest Token(
superset-embedded-sdk/)→ Web 应用变 SaaS - 核心抽象先下沉再开源(
superset-core/)→ 单体应用 → 平台化 - MCP 包装现有 CRUD(
mcp_service/)→ SaaS → AI-Agent 可调用(1-2 人月可复制) 信任边界标签 → 所有 RAG / Agent pipeline_slugify函数专为 LLM 行为特征反向优化 → 工程级 prompt engineering
关键设计决策
决策 1:数据库方言抽象层
- 问题:要支持 50+ 种数据库的 SQL 方言、时间粒度函数、类型映射、认证、错误归一化、SSH tunnel。
- 方案:
db_engine_specs/base.py(2,795 行)定义BaseEngineSpec,把能力拆成可被子类 override 的 method;Presto/Trino/Snowflake/BigQuery/…各实现子类。 - Trade-off:新增数据库成本极低,但 base.py 长期膨胀,使用方需熟悉超长基类的”魔法字段”。
- 可迁移性:高——多后端 / 多方言 / 多 SDK 适配场景都适用。
决策 2:图表插件三件套
- 问题:BI 工具的图表数量会随时间爆炸,NVD3 时代的硬编码 viz.py 已 488 次 commit 改动。
- 方案:每个图表遵循
transformProps.ts(chartProps → ECharts option)+controlPanel.tsx(UI 配置)+buildQuery.ts(formData → 后端请求)三件套。 - Trade-off:配置面板的 schema 写在代码里(不是 JSON Schema),动态行为需在 TSX 里手写。
- 可迁移性:高——「配置面板 + 数据管道 + 渲染管线」解耦是普适模式。
决策 3:异步查询架构(Flask + Celery + 独立 WebSocket)
- 问题:BI 工具经常需要跑数分钟到数小时 SQL,HTTP 长连接容易断、阻塞 Web server 进程。
- 方案:Web 层接收请求、把查询序列化到 Redis、立即返回
query_id;Celery worker 执行 SQL、进度回写;独立superset-websocket/订阅 Redis 推送状态。 - Trade-off:组件多(多一个 worker、多一个 WS 服务、多一个 broker),运维复杂。
- 可迁移性:高——AI 推理(Diffusion / 视频生成)、ETL 触发、报表生成都适用。
决策 4:MCP Service
- 问题:传统 REST API 是为人类 UI 设计的;LLM Agent 调用时参数语义不清、缺少 LLM-friendly 元数据。
- 方案:
superset/mcp_service/是一套独立 FastMCP server(915+841+846+571+142 行),用@mcp.tool暴露核心资源;生成式 system prompt(按disabled_tools动态拼装)、<UNTRUSTED-CONTENT>信任边界、Generic[T] 抽象。 - Trade-off:MCP service 必须和主 Superset 部署并行启动(
superset mcp run),增加部署面。 - 可迁移性:极高——对所有 SaaS 都有价值的”AI 时代打包”模式,1-2 人月可让任意 SaaS 拥有”AI Agent 可调”能力。
决策 5:嵌入式 Dashboard 架构
- 问题:第三方 SaaS 应用希望把 Superset Dashboard 嵌入到自己的页面里,但 Superset 主站是 full-page 体验,直接 iframe 会暴露所有 chrome。
- 方案:独立子仓库
superset-embedded-sdk/(一个embedDashboard()方法)+ 独立打包superset-frontend/src/embedded/(与主站 chunk 分离)+ Guest 角色 + 短期 JWT Token。 - 可迁移性:高——任何”有完整 chrome 的 Web 应用”做嵌入式打包的标准范式。
决策 6:核心抽象下沉到 superset-core 子包
- 问题:从 v5.x/6.x 引入”Extensions”概念(第三方可独立打包 Superset extension 而无需 fork 主仓库)。
- 方案:核心常量、扩展协议、MCP、查询层、REST API 全部移到
superset-core/子包,作为独立 PyPI 包发布;superset-extensions-cli/提供superset-extensions build/publish命令。 - 可迁移性:高——所有”想从应用变平台”的团队都走过这条路(Notion、Linear、Airtable)。
竞品格局与定位
竞品对比矩阵
| 维度 | Apache Superset | Metabase | Redash | Tableau | Looker |
|---|---|---|---|---|---|
| 广数据库适配 | ★★★★★(50+) | ★★★(15+) | ★★★★(30+,偏 SQL) | ★★★(JDBC) | ★★★(专用连接器) |
| 轻量化部署 | ★★★★(Docker 一行) | ★★★★★(最易部署) | ★★★★★(轻量) | ★★(重客户端) | ★★(重服务) |
| 语义层 | ★★★(轻量 Virtual Dataset) | ★★(自建 Model) | ✗ | ★★★(计算字段) | ★★★★★(LookML 重量级) |
| 嵌入式 | ★★★★★(独立 SDK + Guest token) | ★★★(付费 Pro/Enterprise) | ✗ | ★★★(JS API) | ★★★★(Looker Embed) |
| SQL Lab 体验 | ★★★★★(Web IDE + 异步) | ★★(原生查询器) | ★★★★★(SQL Lab 形态) | ✗ | ★★(LookML 优先) |
| AI 集成 | ★★★★★(首个开源 MCP) | ★★(Metabot 实验) | ✗ | ★★★(Tableau GPT) | ★★★(Looker 接入 Gemini) |
| 商业化模型 | Open-core + Preset SaaS | Open-core + Metabase Cloud | OSS(弱维护) | 闭源企业版 | 闭源企业版 |
差异化护城河
- 50+ 数据库方言的十年积累——不是图表功能,不是炫酷 UI,而是「我连得上的数据库比对手多」。
db_engine_specs/50+ 文件就是 10 年沉淀的护城河,竞品短期无法复制。 - Apache 治理 + Preset 商业化反哺——Open-core 边界画在 hosted SaaS + 高级权限,平衡社区活跃度与商业收入。
- AI-MCP 卡位——2025 末是首个开源 BI 的 AI 时代入场券,1-2 人月可让任意 SaaS 复制,但「先发位置」本身有价值。
竞争风险
- Metabase——更易上手、社区同样庞大(38k stars),可能在中型企业市场分食 Superset 的份额;但其数据库适配和可编程性明显落后。
- AI 协议不确定性——MCP 协议 2025 末才标准化,押注的”AI Agent 入口”是否成为主流取决于协议本身的成败。
生态定位
在整个数据技术生态中,Superset 扮演「Apache 数据栈(Kafka → Flink → Druid → Superset)最后一公里的 UI」角色,填补「开源、可商用、宽数据库适配、企业级 RLS/RBAC、嵌入式」五个特性兼具的空白。同 Apache ECharts(66.4k stars,渲染内核)和 Apache Druid/Pinot/Impala/Hive(查询引擎四件套)形成兄弟项目协同。
套利机会分析
- 信息差:Superset 在中文技术社区关注度相对其地位(73k stars、ASF 第一)严重被低估,是「被低估的高质量基础设施」典型。
- 技术借鉴:
- Type-Class 模式可迁移到任何多 SDK 适配场景(云厂商、AI 模型网关、消息队列客户端)
- 插件三件套可迁移到任何配置驱动的可视化/工作流/表单产品
- MCP 包装现有 CRUD 是性价比最高的 SaaS AI 化卡位(1-2 人月)
- 异步查询 + 独立 WebSocket 分离是所有”请求-响应 > HTTP 容忍度”服务的标准解法
- 生态位:填补「开源 + Apache 协议 + 50+ 数据库 + 企业级 RLS + 嵌入式 + AI 友好」六位一体的 BI 工具空白。
- 趋势判断:处于第 4 个增长高峰(2026 年月均 350+ commit,2026-05 达到 474 次峰值),AI 时代 MCP 卡位是显著后发优势,比商业 BI 厂商有 6-12 个月的先发窗口。
风险与不足
- 重构债:
superset/views/core.py769 次 commit 是”接口稳定但内部腐烂”的典型;superset-frontend/webpack.config.js148 次 commit 表明构建系统长期挣扎。 - 前端目录分层混乱:
superset/assets/(旧 Flask-Assets)与superset-frontend/(新 npm workspaces)并存,是历史包袱。 - refactor 占比仅 5.1%——技术债累积偏快,与 Maxime 离开 Lyft 后的”维护驱动”节奏吻合。
- AI 协议不确定性:MCP 协议标准化时间短,是否成为主流取决于生态采纳速度。
- Preset 主导维护的双刃剑:单一公司占主导 PMC 让决策快,但也让社区担忧”是否真的中立”。
行动建议
- 如果你要用它:作为大企业数据平台团队的 BI 基础设施,优势是 Apache 协议可商用、50+ 数据库适配、企业级 RLS/RBAC、嵌入式能力。需要评估团队对 Python 全栈的运维能力(多个独立子服务、依赖管理复杂)。
- 如果你要学它:
- 重点关注
superset/db_engine_specs/base.py2,795 行——Type-Class 模式范本 superset-frontend/plugins/plugin-chart-echarts/——插件三件套范本superset/mcp_service/——AI 时代 MCP 范本superset-core/子包——核心抽象下沉范本
- 重点关注
- 如果你要 fork 它:
- 可以移除 ECharts 依赖改用自研渲染引擎(保留 plugin 三件套接口)
- 可以精简数据库方言(仅保留 Presto/Trino/BigQuery 三件套)
- 可以把 MCP Service 抽出来作为独立 SaaS 的”AI 入口包”
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/apache/superset |
| Zread.ai | https://zread.ai/apache/superset |
| 关联论文 | 无 |
| 在线 Demo | https://superset.apache.org/docs/intro(官方提供的 Demo 部署指引) |
| 官方文档 | https://superset.apache.org/docs/intro |
| 商业化 SaaS | https://preset.io/ |