Unsloth 深度分析报告
一句话总结
LLM 微调加速赛道的性能标杆——通过自研 Triton kernel 实现 2x 训练加速和 70% 显存节省,正从 Python 加速库向「本地 AI 一站式平台」(Unsloth Studio) 转型。
值得关注的理由
- 底层硬核优化:不是简单的 API 封装,而是手写 6 套 Triton kernel 覆盖完整训练路径,手动推导 LoRA 融合反向传播梯度公式——这种数学驱动的优化方式在开源社区极为罕见
- 巧妙的生态策略:通过 monkey-patch 「寄生」而非替代 HuggingFace 生态,用户一行
import unsloth即可获得加速,生态兼容性极好 - 关键转型期:从纯训练库向 Unsloth Studio 全栈平台转型(TypeScript 已占 34% 代码),双许可模式(Apache-2.0 + AGPL-3.0)构建商业壁垒,值得持续观察
项目展示
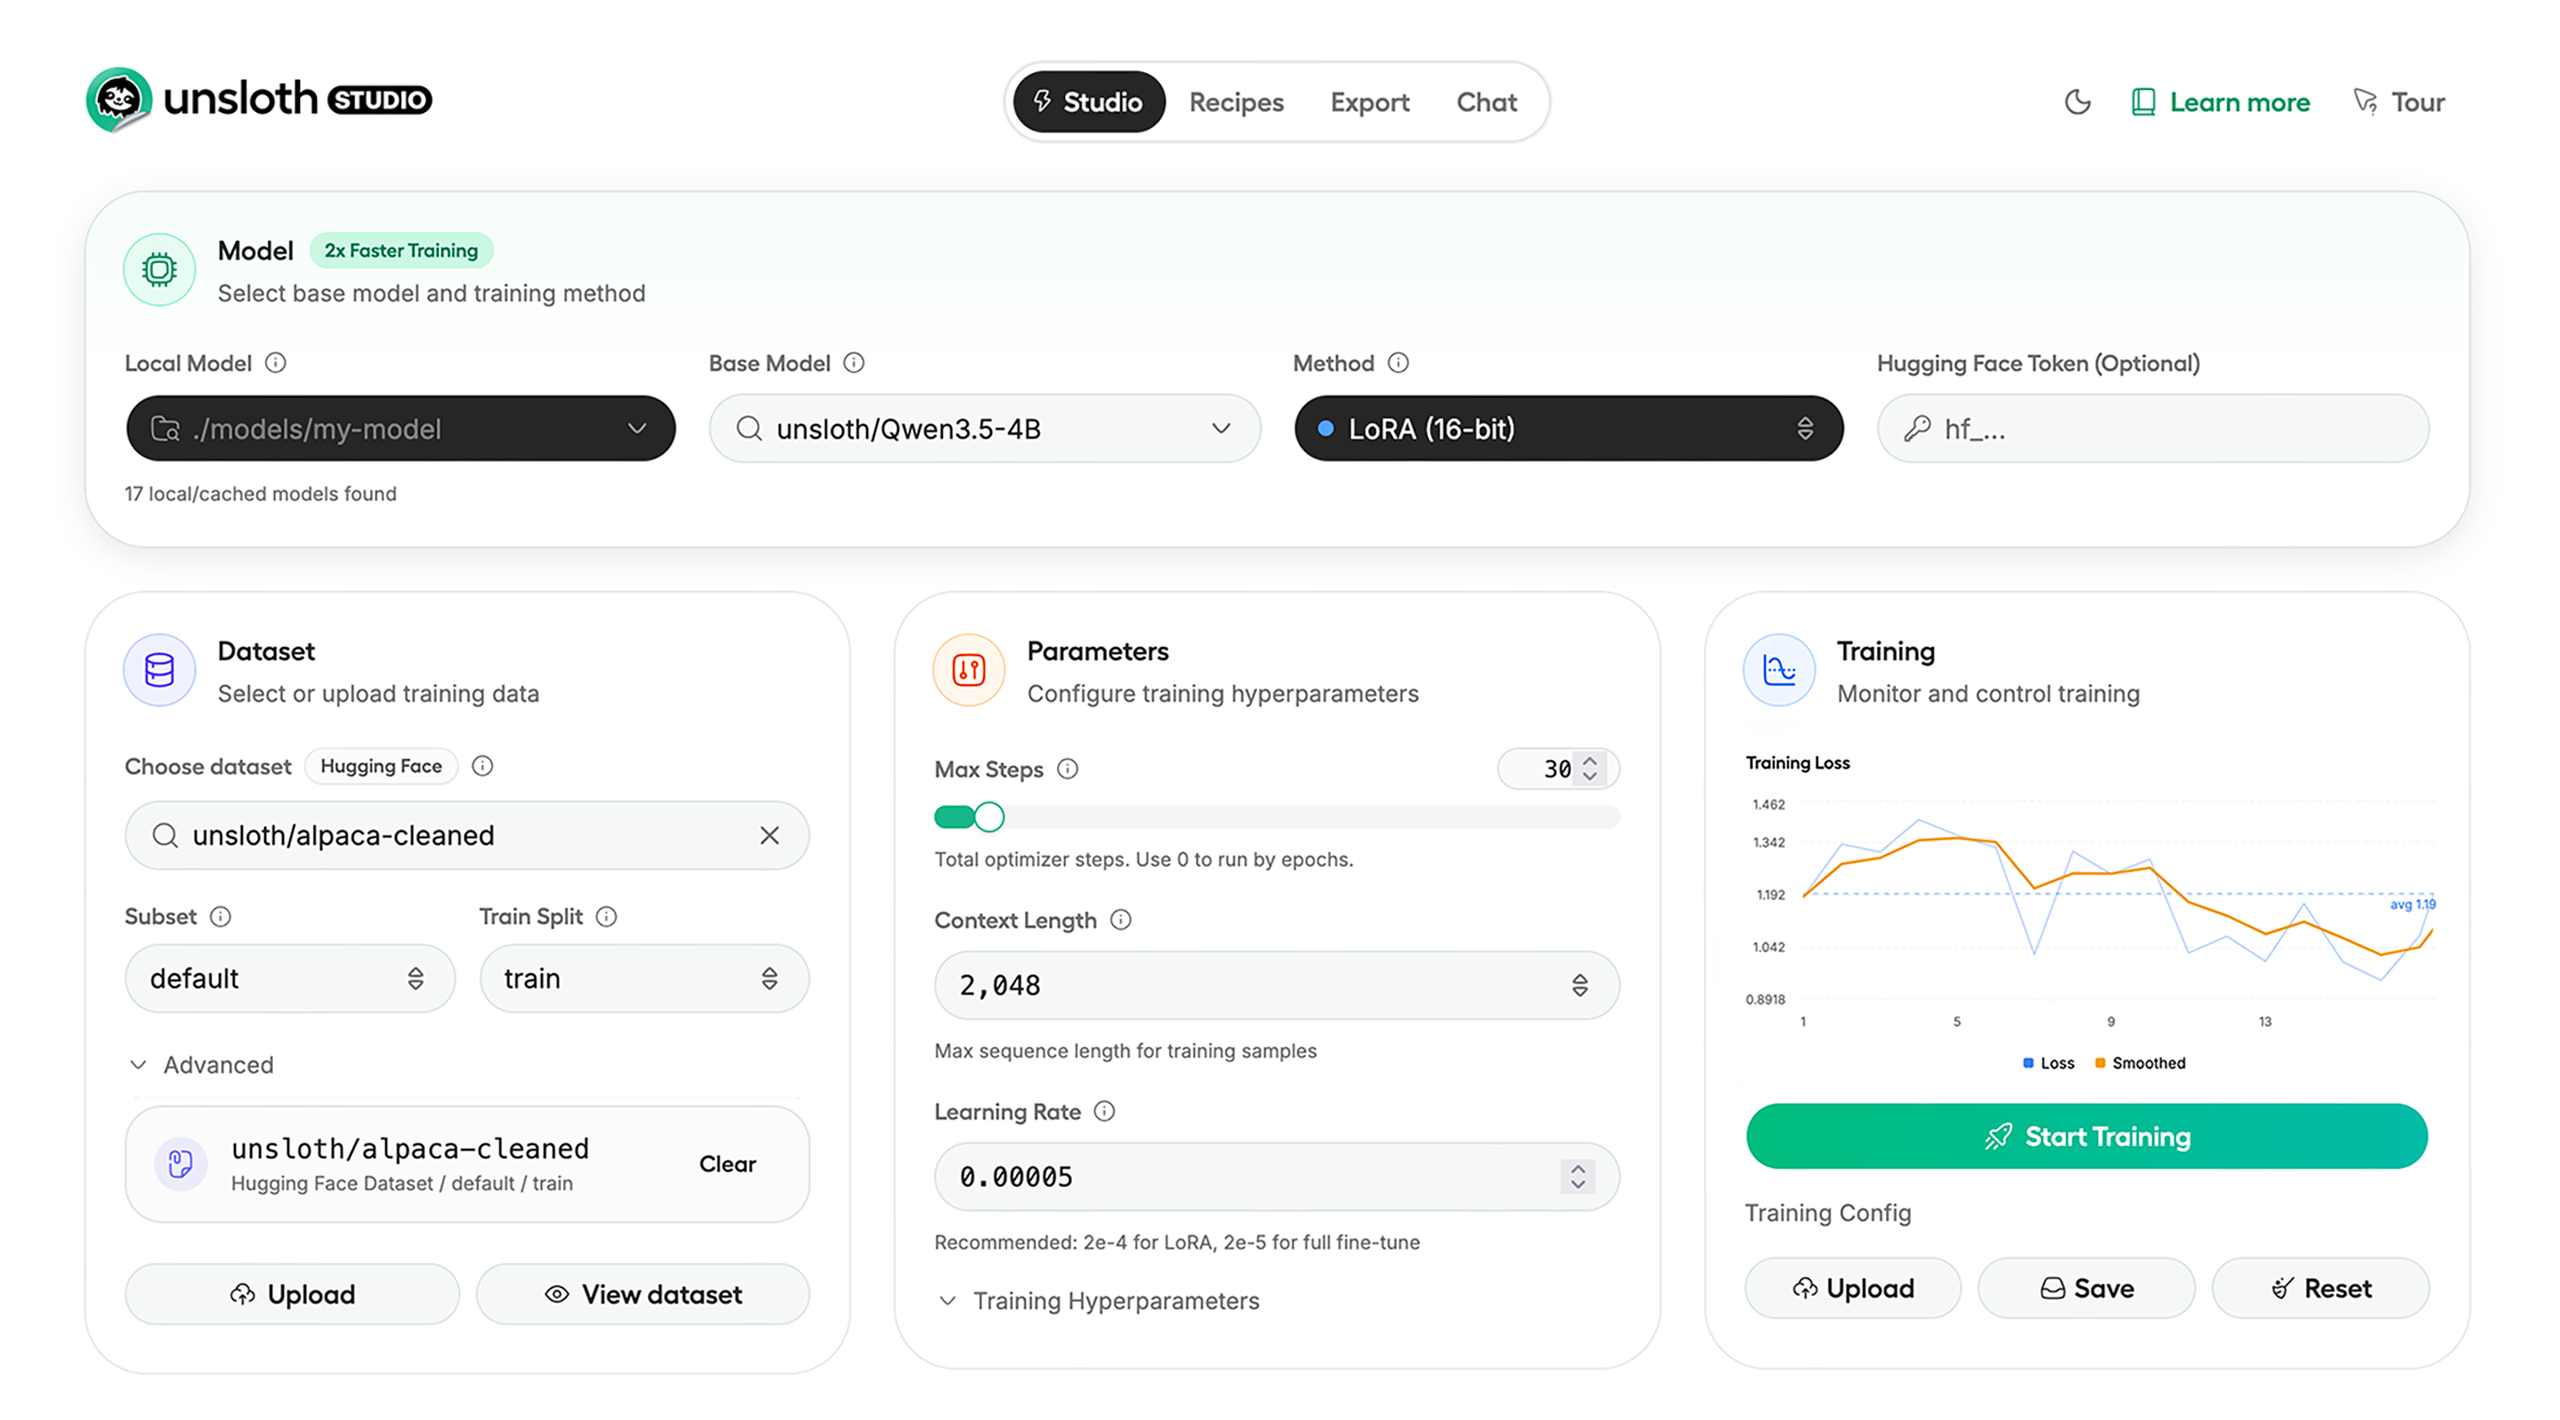 Unsloth Studio Web UI 主界面:训练 + 推理 + 数据准备 + 导出的一站式体验
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/unslothai/unsloth |
| Star / Fork | 59,596 / 5,058 |
| 代码行数 | 175,182(Python 57%, TSX/TS 34%, YAML 3.4%) |
| 项目年龄 | 28 个月(2023-11-29 创建) |
| 开发阶段 | 爆发加速期(近 30 天 675 commits,历史月均 176 的 3.8 倍) |
| 贡献模式 | 创始人驱动(danielhanchen 占 66%,159 位贡献者) |
| 热度定位 | S 级大众热门(微调加速赛道绝对头部,仅次于 LlamaFactory) |
| 质量评级 | 代码[良好] 文档[良好] 测试[基本] |
作者视角:为什么存在这个项目
创始人/作者背景
Daniel Han(@danielhanchen)和 Michael Han 兄弟创业,旧金山。Daniel 有深厚的数学/ML 数值优化背景,早期项目 hyperlearn(2.4K stars)积累了矩阵分解和 GPU 数值计算的底层经验。论文被 ACL 2024 收录,与 PyTorch/HuggingFace/NVIDIA/AMD 均有官方合作关系。
Daniel 贡献了 66% 的 commit(3,022/4,976),是典型的技术创始人驱动型项目。团队目前约 4-5 人核心开发,有明确的商业化路线。
问题判断
2023 年 LLM 微调热潮爆发,但主流训练框架(HuggingFace TRL/transformers)在 kernel 层面几乎没有针对 LoRA/QLoRA 场景的优化。FlashAttention 只解决了注意力计算,而 RoPE、RMSLayerNorm、CrossEntropy、SwiGLU 在小 batch 场景下同样是瓶颈。LlamaFactory/Axolotl 等工具侧重「易用性」,无人触及底层数值优化——这正是 Daniel 的数值优化背景可以发挥的空白地带。
时机选择精准:Triton 编译器成熟(v2.x → v3.0)和 bitsandbytes 量化普及,为自研 kernel 提供了基础设施。
解法哲学
核心理念是「数学优化 > 硬件暴力堆叠」:
- 明确做的:通过 monkey-patch 替换 transformers 关键函数,注入自研 Triton kernel,实现零侵入加速。让一张 RTX 3060 也能微调 Llama 3.1 8B。
- 明确不做的:不重写训练框架,不替换 HuggingFace 生态,不做分布式训练框架(直到近期才开始支持 Multi-GPU)。
- 价值观:民主化 AI 训练,降低碳足迹,从底层 kernel 出发而非简单包装。
战略意图
从 unsloth(微调加速库)到 Unsloth Studio(一站式平台)的转型路径清晰:
- 核心库(Apache-2.0)保持开源吸引社区,Studio UI(AGPL-3.0)构建商业壁垒
- 从训练单点到全链路闭环:推理(llama.cpp 集成)+ 数据准备 + 训练 + 导出 + 可观测性
- 定价分层:Free → Pro → Enterprise,多 GPU/多节点能力锁在付费层
- 跨平台扩张:从 NVIDIA only 到 AMD/Intel/Apple Silicon,争夺「本地 AI」全平台市场
核心价值提炼
创新之处
-
融合 LoRA MLP 反向传播 Kernel(新颖度 4/5 | 实用性 5/5 | 可迁移性 4/5)
fast_lora.py中的LoRA_MLP类将 SwiGLU MLP 的 gate/up/down 三路 LoRA 的前向和反向传播融合为一个torch.autograd.Function,手工推导梯度公式,避免 PyTorch autograd 存储大量中间激活值。这是 70% 显存节省的核心来源,业界首个针对 LoRA+SwiGLU 的融合反向传播实现。 -
MoE Grouped GEMM with TMA(新颖度 4/5 | 实用性 5/5 | 可迁移性 3/5) 在
kernels/moe/grouped_gemm/中实现了支持 Hopper TMA(Tensor Memory Accelerator)的分组 GEMM,用于 DeepSeek/GLM/Qwen MoE 模型的高效训练。TMA 支持的 grouped GEMM 在开源社区极为少见。 -
分块 Triton Cross Entropy Loss(新颖度 3/5 | 实用性 5/5 | 可迁移性 5/5) 利用 logsumexp 数学可分性,将超大词表(256K)的 CE loss 分块计算,支持 softcapping(Gemma 2)和 logit scaling(Cohere)。直接解决大词表模型的 OOM 问题。
-
In-place RoPE Q+K 融合 Kernel(新颖度 3/5 | 实用性 4/5 | 可迁移性 4/5) 在一个 Triton kernel 中同时对 Q 和 K 做旋转位置编码,避免额外内存分配和两次 kernel launch。
-
1823 行 Import Fixes 兼容层(新颖度 2/5 | 实用性 5/5 | 可迁移性 2/5)
import_fixes.py在 import 阶段修复 30+ 上游库的兼容性问题,确保 Unsloth 在各种环境下正常工作。这是 monkey-patch 策略的隐性成本,但也是用户体验的基石。
可复用的模式与技巧
- Monkey-Patching 加速模式:在
__init__.py中替换上游库关键方法,实现零侵入加速。适用于任何不想 fork 上游但需要注入优化的场景。 - Triton Kernel + autograd.Function 融合:为训练热点操作写 Triton kernel,封装为
torch.autograd.Function(手动实现 forward/backward),绕过 PyTorch 自动微分开销。 - 分块 logsumexp 模式:利用数学可分性处理超大张量。适用于词表 > 65536 的任何场景。
- 注意力后端 Dispatch 模式:根据硬件/库可用性自动选择 Flash Attention / xformers / SDPA / Flex Attention。
- 双许可证开源商业化:核心库 Apache-2.0 + 商业 UI 层 AGPL-3.0。经典的开源商业化架构。
关键设计决策
-
Import-time Monkey Patching
- Trade-off:零侵入用户代码,生态完全兼容 HF。但必须在 trl/transformers 之前 import,对上游版本更新极其敏感(1823 行兼容性修复的维护代价)
-
自研 Triton Kernel 覆盖完整训练路径
- 6 个关键操作各写 Triton kernel(CrossEntropy/RoPE/RMSLayerNorm/SwiGLU/LoRA MLP/FP8),覆盖前向+反向
- Trade-off:2x 加速 + 70% 显存节省,但每个新模型架构都需要适配(当前 10+ 适配文件)
-
「寄生」而非「替代」HF 生态
- 通过 monkey-patch 而非 fork,最大限度复用上游生态,降低用户切换成本
- 风险:TRL 的任何 breaking change 都需要快速适配(
trl>=0.18.2,!=0.19.0,<=0.24.0)
竞品格局与定位
竞品对比矩阵
| 维度 | Unsloth | LlamaFactory | Axolotl | TRL (HF) | TorchTune |
|---|---|---|---|---|---|
| Stars | 59.6K | 69.6K | ~8K | ~12K | ~5K |
| 核心价值 | Triton kernel 加速 | 零代码 Web UI | 配置驱动管线 | HF 官方 RL | PyTorch 官方 |
| 单 GPU 性能 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ |
| Multi-GPU | Beta | 完整 | 完整 | 完整 | 完整 |
| 上手门槛 | 低(一行 import) | 极低(Web UI) | 中(YAML 配置) | 中 | 中 |
| 模型覆盖 | 500+ | 100+ | 多 | 多 | 有限 |
| 商业化 | Free/Pro/Enterprise | 开源 | 开源 | 开源 | 开源 |
差异化护城河
Unsloth 的护城河是底层 Triton kernel 优化能力——手推 LoRA 融合梯度公式、分块 CE loss、MoE grouped GEMM with TMA,这些需要深厚的数值分析功底和 GPU 编程经验,是 LlamaFactory/Axolotl 难以快速复制的。同时,「寄生」HF 生态的策略让用户切换成本极低,网络效应很强。
竞争风险
- 最大威胁:LlamaFactory 如果引入底层 kernel 优化(或直接集成 Unsloth kernel),将同时拥有易用性和性能优势
- 学术挑战:Chronicals 论文(arXiv 2601.02609)对 Unsloth benchmark 方法论提出质疑(发现零梯度范数问题),声称修正后吞吐量从 46,000 降至 11,736 tokens/s。此质疑尚未被公开回应。
- 上游风险:HuggingFace 如果在 transformers/TRL 中内置类似的 kernel 优化,Unsloth 的「寄生」策略将失去基础
生态定位
在 LLM 工具链中,Unsloth 是「加速引擎」而非「训练框架」。它与 HF transformers/TRL 是共生关系(官方联合博客推荐),与 LlamaFactory 是「性能型 vs 易用型」的互补关系,与 Axolotl 可以叠加使用。Unsloth Studio 正在尝试从加速引擎扩展为一站式平台,与 LlamaFactory 形成正面竞争。
套利机会分析
- 信息差: 无信息差——59.6K stars,HN/Reddit/HF 官方推荐,已充分曝光。但 Chronicals 论文的 benchmark 质疑值得关注,可能影响其技术声誉。
- 技术借鉴: ① 融合 LoRA 反向传播的手推梯度技巧(
fast_lora.py)可直接迁移;② 分块 logsumexp CE loss 是通用大词表方案;③ Monkey-patch 加速模式适用于任何不想 fork 上游的场景;④ 注意力后端 Dispatch 层设计值得参考。 - 生态位: 填补了「HF 生态中的底层 kernel 优化」空白。但随着 PyTorch 2.x 和 torch.compile 的进步,这个空白可能逐渐缩小。
- 趋势判断: 强增长中。日均 ~65 stars 无衰退迹象,Studio 产品化加速(近 30 天 commit 增 3.8 倍),新模型首发支持(Gemma 4)持续卡位。本地 AI 趋势利好。
风险与不足
- 高度依赖创始人:danielhanchen 贡献 66% commit,核心 Triton kernel 的数学推导能力难以替代
- Monkey-patch 维护代价:1823 行
import_fixes.py+ pyproject.toml 中大量版本排除,每次上游更新都是潜在风险 - 无 CI 测试流水线:仅有
stale.yml(自动关闭过期 issue),核心 kernel 缺乏自动化测试 - Multi-GPU 支持不成熟:社区最大痛点之一(#2435,99 评论),限制了企业级采用
- Apple Silicon 训练缺失:社区最早且评论最多的 Issue(#4,112 评论),仍在路线图中
- Benchmark 方法论争议:Chronicals 论文质疑存在零梯度范数问题,尚未公开回应
- Studio 产品化风险:从库到平台的转型需要完全不同的产品能力,TypeScript 已占 34% 代码量,资源分散风险
行动建议
- 如果你要用它: 单 GPU 微调场景的最优选择,一行
import unsloth即可获得显著加速。如果需要 Multi-GPU 生产管线,搭配 Axolotl 或 LlamaFactory。如果需要零代码体验,先试 Unsloth Studio(Beta)或 LlamaFactory Web UI。 - 如果你要学它: 重点关注三个模块:
unsloth/kernels/fast_lora.py— LoRA 融合反向传播,手推梯度的核心创新unsloth/kernels/cross_entropy_loss.py— 分块 logsumexp CE loss,通用大词表技巧unsloth/__init__.py+import_fixes.py— Monkey-patch 模式的工程实现和维护代价
- 如果你要 fork 它: 优先方向:① 补充 CI 测试流水线(核心 kernel 覆盖);② 实现完整的 Multi-GPU 支持;③ 减少对 import_fixes 的依赖,探索更稳健的上游适配方式
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | deepwiki.com/unslothai/unsloth |
| Zread.ai | 未收录(403) |
| 关联论文 | ACL 2024 收录;Chronicals 质疑论文 arXiv 2601.02609 |
| 在线 Demo | Colab Studio(免费 T4 GPU) |
| 官方文档 | unsloth.ai/docs |
| HF 联合博客 | Unsloth x TRL |
| Kaggle Notebooks | unslothai/notebooks(5,153 stars) |