GitHub推荐:14MB 跑通函数调用:Cactus 用 Walsh-Hadamard 把 LLM 压进 RPi Zero
一句话总结
Cactus Compute 把 Google Gemini 的 function-calling 能力蒸馏到一个 14MB / 27M 参数的端侧模型 里,用完全抛弃 FFN 的 Simple Attention Network 架构 + 字节级 grammar 强制 schema 合规 + 单文件 .cact 部署三件套,把 tool-calling 从云端独占能力变成 RPi Zero 2W 都能跑的本地原语。
值得关注的理由
- 架构反主流假设的实战验证:业界 FFN/MLP 占 transformer 70% 参数是常识,needle 直接拿掉 FFN 用 Walsh-Hadamard + 三条对角向量替代,把 FFN 权重从 O(d²) 砍到 O(d),并在 5.6 个月内拿下 4,148 stars——这是「教科书一定是错的」级证据。
- 工程化端侧栈闭环:单文件
.cact把权重 + tokenizer + codebook 全 bake 进去,配合 ctypes + 预分配 buffer 的 zero-copy C 调用 + LoRA merge→build 一条龙流水线,把「LLM 部署最常见的权重-Tokenizer 错配」问题从产品层面消掉。 - YC 背书 + 学术-工业双轮:Henry Ndubuaku 主导的 7-9 人核心团队,arXiv:2607.18363 已发表学术规范论文,HuggingFace 已发布 needle2 权重,DeepWiki + Zread + 6 篇官方博客全渠道可见——不是实验室 toy,而是正在被工业部署的 reference implementation。
项目展示
 项目主 Banner——Needle 的品牌首印象
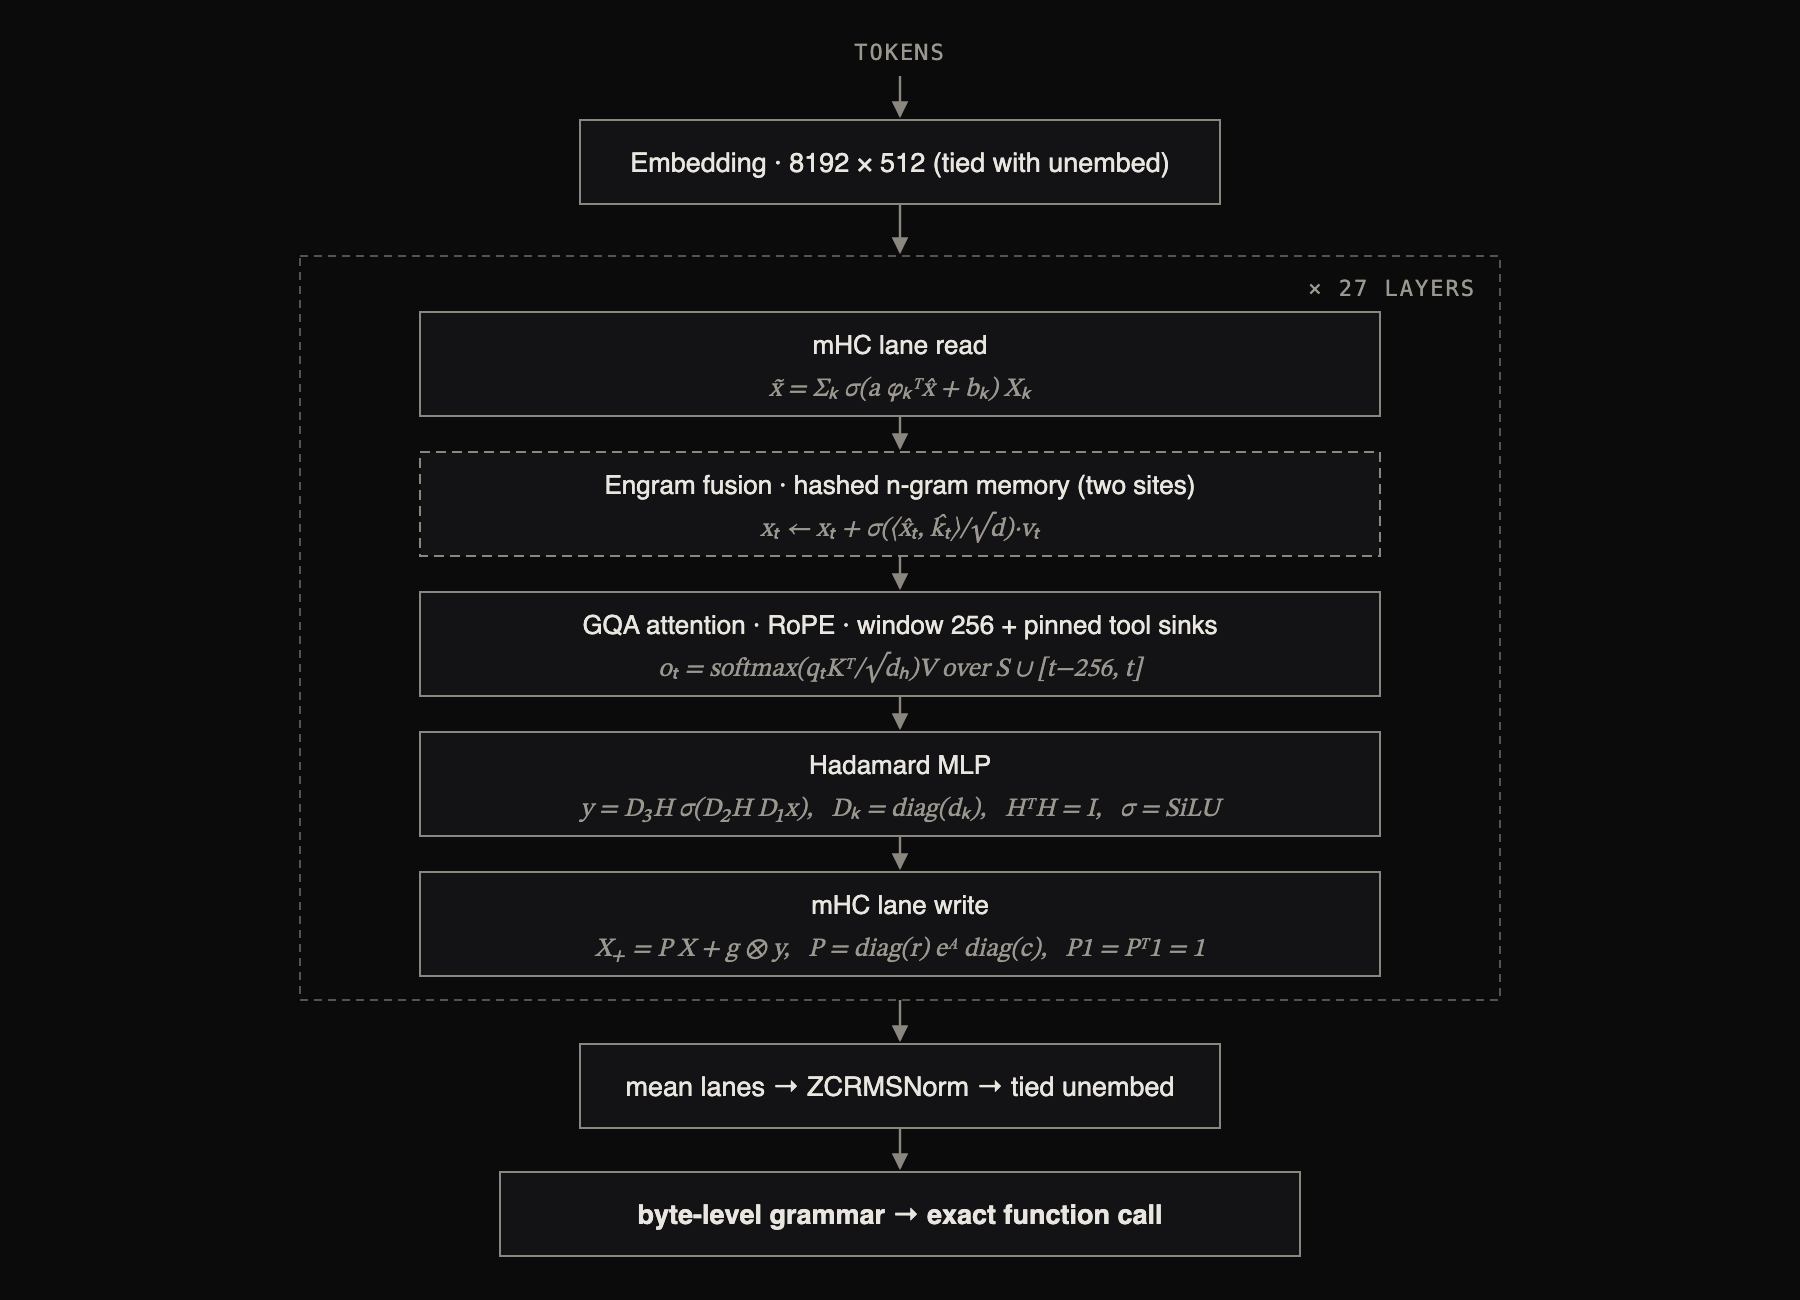 Simple Attention Network 架构示意图——展示 Walsh-Hadamard MLP、Engram KV memory、multi-lane hyper-connections 三大创新组件
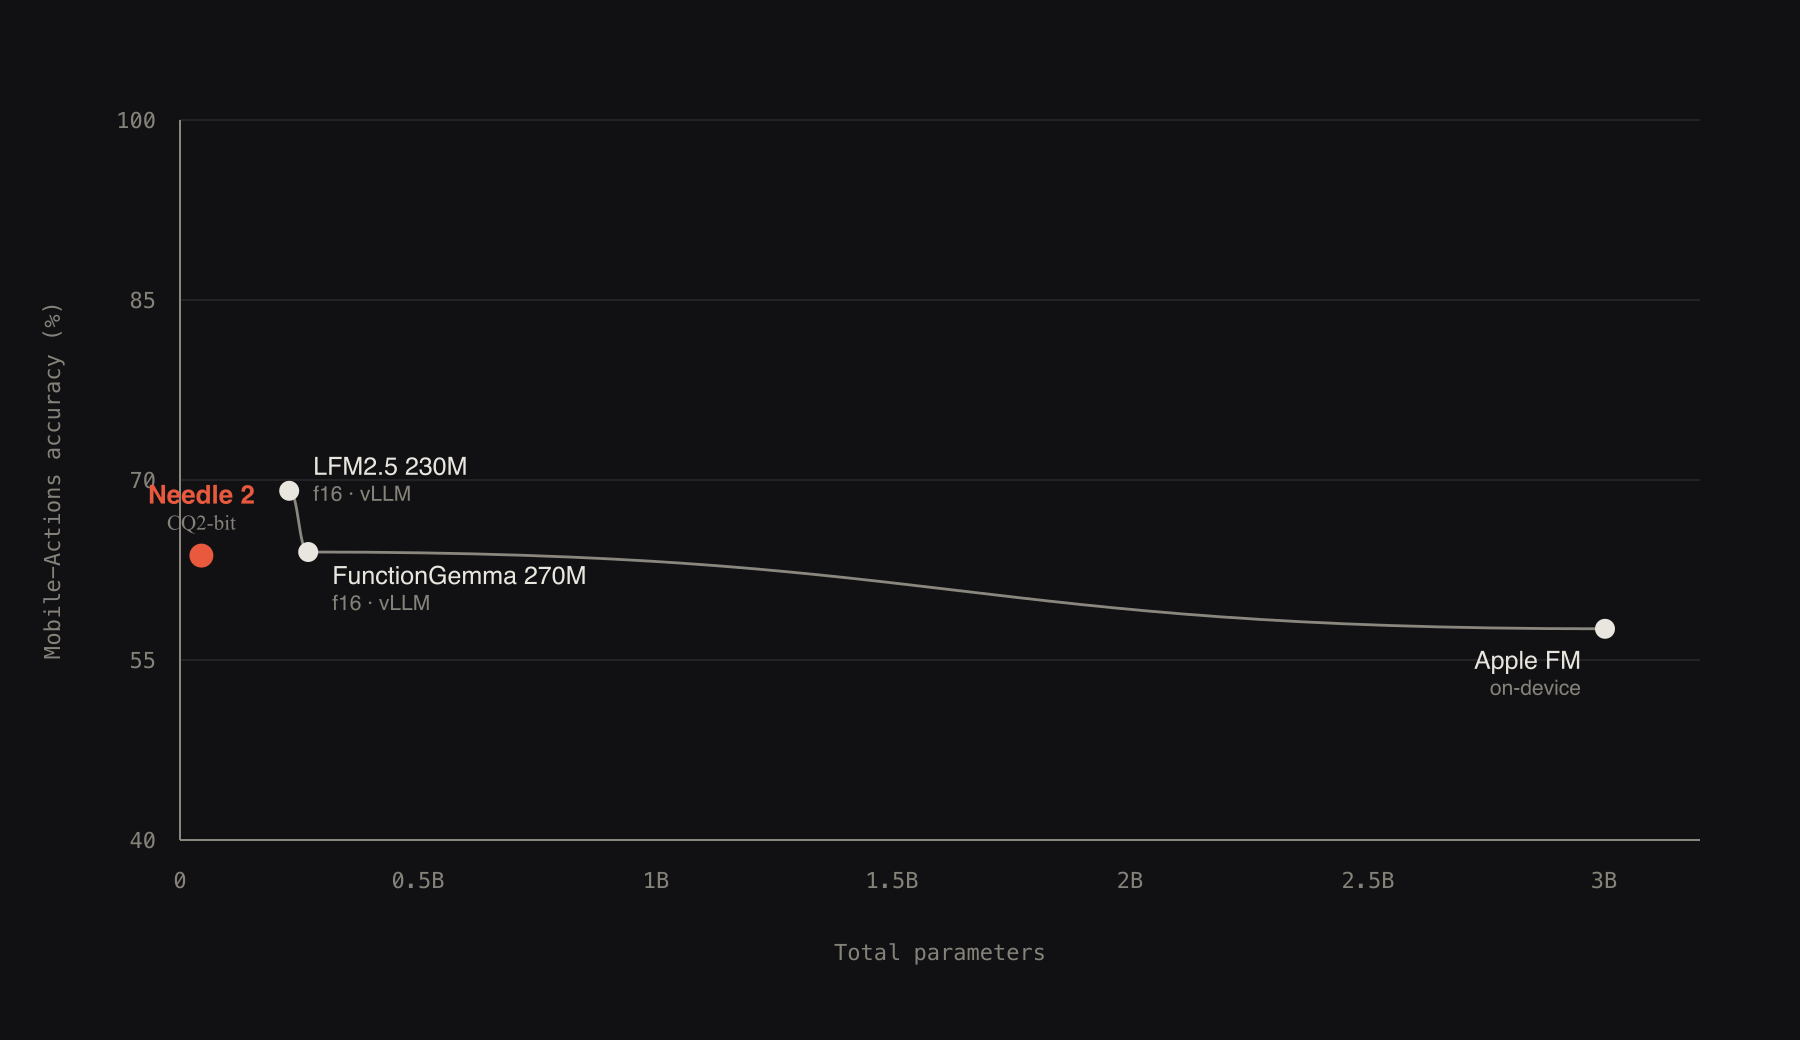 Size-quality frontier benchmark 散点图——把 FunctionGemma/LFM/AFM/Phi-3 一并打点对比,needle 落在「mobile-class and below」区域的极限左下角
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/cactus-compute/needle |
| Star / Fork | 4,148 / 301 |
| 代码行数 | 4,153 行(Python 76.7% / CSS 10.6% / JavaScript 7.2% / HTML 2.6%) |
| 项目年龄 | 5.6 个月(2026-02-23 首次提交) |
| 开发阶段 | 稳定维护(3 月单月爆发 167 commit 后转入低 churn) |
| 贡献模式 | Founder-driven 单核(HenryNdubuaku 占 72.5%),9 人小协作圈 |
| 热度定位 | 中等热度上沿(4148 stars / 5.6 月 ≈ 740 stars/月) |
| 质量评级 | 代码 A / 文档 A / 测试 B / CI B / 错误处理 A |
作者视角:为什么存在这个项目
创始人/作者背景
Cactus Compute, Inc. 是 2025 年初创立的英国 YC 背书边缘 AI 公司,创始人 Henry Ndubuaku 既是 CEO 也是首席研究员——89.1% 的 commit 集中度反映 Founder-driven AI Lab 的典型结构。公司同时运营 5,718 stars 的 C++ 推理引擎 cactus 与本仓库 needle,形成「runtime + model」双旗舰布局。核心团队约 7-9 人(含 CTO Anton Osika),作者列表署名为 Henry Ndubuaku / Karen Mosoyan / Jakub Mroz / Noah Cylich / Satyajit Kumar / Parkirat Sandhu / Roman Shemet / Justin H. Lee——这是学术界 + 工业界复合基因的团队。
问题判断
Henry Ndubuaku 与团队从部署侧反向发现:云端 LLM 解决的是「质量」问题,但 tool-calling 的本质是「约束解码 + 表单填空」——把 reasoning 阶段显式丢掉、用 byte-level grammar 把 token 输出约束在 schema 范围内,可以直接蒸馏成一个 26M-45M 的端侧模型。这是 Sage-2 / FunctionGemma 等「用全尺寸模型硬微调」路线不会主动尝试的视角。
时机选择:为什么是 2026 年?三个窗口同时打开:(1) 自研 CQ2-bit 量化(TurboQuant-H)让 2-bit 推理在 CPU 上首次可行;(2) Walsh-Hadamard 在 NEON/AVX2 已有 fast kernel,FFN 替代方案有了硬件支撑;(3) Function-calling 作为 LLM productization 的标准接口在 2025-2026 年才真正普及。
解法哲学
- 不推理、只检索 + 拼装——把 tool-calling 定位为 schema-constrained decoding,模型只负责从输入证据中挑选 schema 并填值
- 架构上去 FFN/MLP——用 Walsh-Hadamard + 三条对角向量替代,把 FFN 权重从 O(d²) 砍到 O(d)
- Engram key-value memory——hash-n-gram 查表 + 4-tap dilated conv 替代一层 transformer 的位置感知 KV
- mHC (multi-lane hyper-connections)——把单一残差流展为 4 lane 并行流,Sinkhorn doubly-stochastic gating 重新混合
- 工程上的「两个 0」——运行时 0 网络、产物 0 副作用(
.cact单文件)
明确不做什么:不做云端优先、不做 reasoning 段落生成、不做 multi-turn chat 的对话状态管理、不做 LoRA runtime hot-swap(每次微调都重新走 build→.cact 流程)。
战略意图
needle 是 Cactus Compute「模型 + 引擎」绑定战略中的 Python 端旗舰——与 C++ 推理引擎 cactus 一起对外构成一个 AI 中间件 / SDK 产品。商业化路径清晰:(1) 自研量化格式(CQ2-bit)建立技术护城河;(2) Hybrid execution(local-first + 确定性 cloud fallback)打开 SaaS 通道;(3) 端侧覆盖 microcontroller → phone → Android/embedded 扩展设备矩阵。YC 背书 + arXiv 论文 + HF 权重分发让这条路径有了「学术-工业-社区」三重验证。
核心价值提炼
创新之处
- Walsh-Hadamard MLP 取代 FFN — 用
_walsh_matrix(n)固定 1/√n 缩放的 Hadamard 矩阵 + d1/d2/d3 三条对角向量,完成silu(d2 * (d1*z) @ H) @ H → d3·截 d_model。整个 MLP 完全没有矩阵乘法,只有 elementwise 乘 + 两次 Hadamard 变换 + 一个 SiLU。新颖度 4/5 / 实用性 5/5 / 可迁移性 3/5 - Engram hash-n-gram 表 + dilated conv = 显式 N-gram memory — FNV-1a 哈希 + 8192-slot 嵌入表 + 4 个 dilated conv tap 拼接时间维度上下文,等价于「非神经网络层的 lookup-CNN block」。新颖度 5/5 / 实用性 4/5 / 可迁移性 3/5
- mHC 把残差流转成平行 4 lane + Sinkhorn doubly-stochastic mixer — 4 lane reshape + (B,T,n,n)
_sinkhornmixing matrix,lane 跨层相互路由。新颖度 4/5 / 实用性 4/5 / 可迁移性 4/5 - 对比性 head (
contrastive head) 用于 tool retrieval — 4 个 learned probe 做 cell-attention,输出与工具 embedding 同维的归一化向量,每次 query 取 top-5。新颖度 4/5 / 实用性 5/5 / 可迁移性 4/5 confidence = min(post-hoc head, decode token probability)的 dual-signature 校准 — ConfidenceHead 8 个 learned probe → 1 维 logit,同时记录 decode token probability,call 字段返回二者 min。新颖度 4/5 / 实用性 5/5 / 可迁移性 5/5- Cactus Quants (CQ) + Lloyd-Max codebook 内嵌 header —
export.py的 HEADER 段直接携带 cb2[4] | cb3[8] | cb4[16] 单位球 Lloyd-Max 中心。新颖度 3/5 / 实用性 5/5 / 可迁移性 4/5 - CTypes + 预分配 buffer 的同步非流式交互 — 65536 字节 ctypes buffer 一次调 C、同步 JSON 进出。新颖度 3/5 / 实用性 5/5 / 可迁移性 5/5
可复用的模式与技巧
- Python 签名 → JSON schema 自动编译(适用任何 API 客户端、ORM、字段校验场景)——用
inspect.signature+typing.get_type_hints(include_extras=True)+ docstring 解析三件套,5 行装饰器生成可调用函数 - 单文件
.cact部署(离线 agent、嵌入式工具链、Kubernetes init container)——把权重 + tokenizer + bias + gates + codebook 全 bake,nameless positional 字节布局,align-64 - ctypes + 预分配 buffer(CLI、edge inference、low-latency synchronous agent loop)——4 个 C 函数签名固定 + 共享 buffer,零 GIL 烦扰
- Walsh-Hadamard MLP(edge 模型、NEON/AVX-friendly 模型)——FFN 砍 70% 权重又不引入 MoE 复杂度
- mHC lane mixing(SSM/Mamba/RetNet backbone)——以宽度换深度的浅模型设计
- dual-confidence calibration(医疗 AI、风控、agentic escalation)——post-hoc + decode 取 min 比单调 head 更稳健
- byte-level grammar decode-from-schema(API 调用、SQL 生成、JSON 抽取、UDF 调用)——编译 grammar 在 C++ 引擎里,每次 token logit 与 grammar 状态做 mask
- Release train via GitHub Actions + dynamic version bump from git tag(小团队稳定 release、stale tag 检测、自动 hotfix)
关键设计决策
- 让用户的 Python 函数签名 / type / Pydantic 全部收敛到同一份 JSON schema——牺牲自定义能力换来「5 行装饰器」开箱即用
- 双实现策略(JAX Python 推理 + C++ 单 mega-kernel)——避开 ONNX runtime / TVM 兼容性问题,但增加维护负担
- Walsh-Hadamard MLP 取代 FFN——牺牲 in-context 容量换内存与算力双线性下降
- Engram hash-n-gram 表 + dilated conv——静态表项固定容量换固定成本与可解释性
- mHC 4 lane + Sinkhorn——4 倍激活内存换「浅层模拟深层」
confidence = min(post-hoc, decode)——牺牲单调性换 calibration 与优雅 escalate- byte-level grammar 强制 schema 合规——牺牲 reasoning 段落换零后校验
- 单文件
.cact——牺牲灵活更新换「换模型 = 换文件」的运维简单性 - ctypes dlopen 引擎——牺牲 Python streaming 换无 GIL + 各平台 wheel 内实现
- LoRA merge→build→.cact——牺牲「同一份 base 多 LoRA 复用」换「用户调一个 .cact = 一次」产品体验
竞品格局与定位
竞品对比矩阵
| 维度 | Needle 2 | FunctionGemma 270M | LFM2.5 230M | Apple Foundation Model | Phi-3.5-mini |
|---|---|---|---|---|---|
| 参数量 | 27-45M | 270M | 230M | ~3B(估) | 3.8B |
| 二进制体积 | 14MB | ~600MB | ~500MB | 系统私有 | ~2.5GB |
| 内存常驻 | 28MB | ~700MB | ~600MB | 系统级 | ~5GB |
| 部署平台 | ARM/MCU/全平台 CPU | x86 GPU 优先 | x86 GPU | Apple Silicon only | x86 GPU |
| Tool-calling 优化 | byte-level grammar + contrastive head | 标准 function calling template | 标准 | 系统集成 | 标准 |
| 自研量化 | CQ2-bit (TurboQuant-H) | f16/INT4 | f16 | 闭源 | f16 |
| 离线可用 | 是 | 否(需 Transformers 生态) | 否 | 否(云依赖) | 否 |
| 开源 | MIT + Apache-2.0(需核查一致) | Apache-2.0 | 部分 | 否 | MIT |
| 推理延迟 | <150ms(on device) | ~500ms(GPU) | ~400ms | <100ms(Apple Silicon) | ~800ms |
差异化护城河
「端侧极限部署」组合是唯一护城河——14MB 二进制 + 28MB RAM 常驻 + byte-level grammar + .cact 单文件 + ARM/MCU 全平台 CPU + 离线运行 + 自研 2-bit 量化,七项指标同时达成的产品目前没有第二个。竞品 FunctionGemma 在 270M 量级差了 10× 体积,LFM2.5-230M 差了 5-7×,Apple Foundation Model 70× 且封闭。
竞争风险
- (a) 苹果/Google 把端侧模型压到 100M 以下后,生态优势(Gemini Nano、Apple Foundation Model)会从分布式 AI 角度蚕食 needle 的目标场景
- (b) 如果 LLM-on-CPU 的 kernel 优化大幅推进,Walsh-Hadamard MLP 的内存优势可能被 GEMV 充分 SIMD 化的「小 FFN」抵消
- (c) 如果 LoRA-on-device 路线被 MLC-LLM / ONNX runtime 社区补齐,
build → .cact的运维优势会被竞争产品抹平 - (d) 单作者 89% 占比是典型「一人公司」风险,关键决策高度集中
生态定位
needle 是「SaaS / 数据科学 → 本地端」战略中「本地端」那一片的端侧武器。YC 背书 + cactus 推理引擎的绑定让它在 self-hosted mobile inference 方向有独特切入;同时它把「工具调用」显式做成 primary 任务,在 agent SDK 不断成熟的今天有可能成为 Phi-3 / Llama 之外的「小而专」选项。Hugging Face 已发布 needle2 权重(工业级可见度强信号),但还没进入 LangChain / LlamaIndex 等主流 agent 框架的官方推荐——这是渠道生态上的最大缺口。
套利机会分析
- 信息差: 低关注度但高质量——5.6 个月 4,148 stars + YC 背书 + arXiv 论文 + HF 权重,但 LangChain / LlamaIndex 还没收录;中文社区(IoT、SaaS 内嵌助手、辅助老旧 Android 应用)几乎无相关报道
- 技术借鉴: Walsh-Hadamard MLP、Engram hash-n-gram memory、mHC lane mixing、dual-confidence calibration、ctypes+buffer 同步非流式交互——五个模式可直接迁移到任何「端侧 LLM / 嵌入式 AI agent / 离线工具调用」项目
- 生态位: 14MB 端侧 function-calling 模型这个细分赛道目前是 needle 独占;FunctionGemma/LFM2.5/AFM 都还在 200M+ 量级,无法在 RPi Zero 2W / 旧 Android 上运行
- 趋势判断: 端侧 LLM 是 2026 年的明确趋势(Apple Intelligence、Gemini Nano、Phi-3-mini 同向),needle 用「压缩到极致 + 自研量化 + 单文件部署」的组合抢占了「microcontroller-class」这个最极端生态位。后发优势:CQ2-bit 量化 + Walsh-Hadamard 已经在生产环境跑通 6 个月,竞品要复制至少需要 12-18 个月
风险与不足
- v2 稳定性尚未收口——#46 README 示例挂掉、#53 fine-tune 跨 epoch NaN、#34 contrastive head 异常、#51 256-token sliding window 在多轮 tool-calling 中偏紧
- 256-token 滑动窗口约束——README 中「memory stays near 28MB regardless of conversation length」的卖点实际使用时窗口偏紧,多轮工具调用场景需要用户自己管理上下文裁剪
- 单作者 89% 占比——典型 Founder-driven 风险,关键决策集中、bus factor = 1
- License 一致性问题——
pyproject.toml声明 Apache-2.0,LICENSE顶部声明 MIT(外部分发前应统一) - CI 工程债务——CI 仅在 weekly release train 时跑测试,无 PR-trigger;合并前无法验证
- 缺失单元测试覆盖——docs 与 test 在 commit 类型分布中均为 0(
commit_type_distribution) - Android 原生未到——
cactus-react-native(178 stars) 已铺 RN 桥,但原生 Android/.so 还未到
行动建议
- 如果你要用它: 在 Raspberry Pi Zero 2W、旧 Android、嵌入式 MCU 协处理器上跑「本地工具调用 + 结构化抽取」场景时优先选 needle;如果你在 x86 GPU 服务器上做 cloud agent,FunctionGemma/LFM2.5 更合适。
- 如果你要学它: 重点关注
needle/model/architecture.py(619 行 SAN 主架构)、needle/model/export.py(526 行 .cact 字节布局规范)、needle/agent/tools.py(160 行 Python 签名 → JSON schema 自动编译);这三个文件包含了 needle 90% 的差异化设计 - 如果你要 fork 它: 可以改进的方向——(a) 修复 #53 fine-tune NaN 问题(量化 + 训练稳定性);(b) 扩展到 Android 原生 (#17);(c) 把 LoRA 改为 runtime hot-swap(不重新 build .cact);(d) 用 Rust 重写
needle/model/decode.py解耦 Python (JAX) 与 C++ 双实现
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/cactus-compute/needle |
| Zread.ai | https://zread.ai/cactus-compute/needle |
| 关联论文 | Needle 2: A 45M-Parameter Foundation Tool-Calling Model for Tiny Devices |
| HuggingFace 权重 | https://huggingface.co/Cactus-Compute/needle2 |
| 官方博客 | https://cactuscompute.com/blog(核心文章:Needle: Distilled Gemini Tool Calling into a 26M Model) |
| 在线 Demo | 本地 CLI needle playground(http://127.0.0.1:7860) |