一份 ~4500 行代码跑通 LLM 6 阶段:Fareed Khan 怎么教自己写出 PPO/GRPO
GitHub: https://github.com/fareedkhan-dev/train-llm-from-scratch
一句话总结
Fareed Khan 用一份自己手写的 ~400M Transformer,把「预训练 → SFT → Reward Model → DPO/ORPO/KTO → PPO → GRPO/RLVR」6 阶段后训练流水线全跑通了——零 trl/peft/transformers 依赖,是开源里独一份教学价值完整、且数学不被框架吞掉的 LLM 对齐参考实现。
值得关注的理由
- 覆盖度独一份:把 DPO 三种 loss(DPO/ORPO/KTO)、PPO 的 GAE+clip、GRPO 的 k3 KL+group-relative adv 全部写在一个仓库,且共用同一份
Transformer主干——这是 karpathy/nanoGPT、Stanford CS336、HuggingFace TRL 都没单独做的事。 - 依赖极简但工程到位:只用
torch + tiktoken + h5py + tqdm;9 段 MkDocs 文档站 + 9 页 Streamlit 控制面板 + 2×H100 DDP 同一份代码路径——纯 PyTorch 跑出「现代对齐流水线」,适合想读懂 GAE 数学却被 TRL 200k LOC 挡住的人。 - 设计哲学值得抄:「wrap, don’t rewrite」+ rollout 用 free function + 配置 4 层覆盖——这 12 条可复用模式几乎都能整段搬走。
项目展示
README 媒体
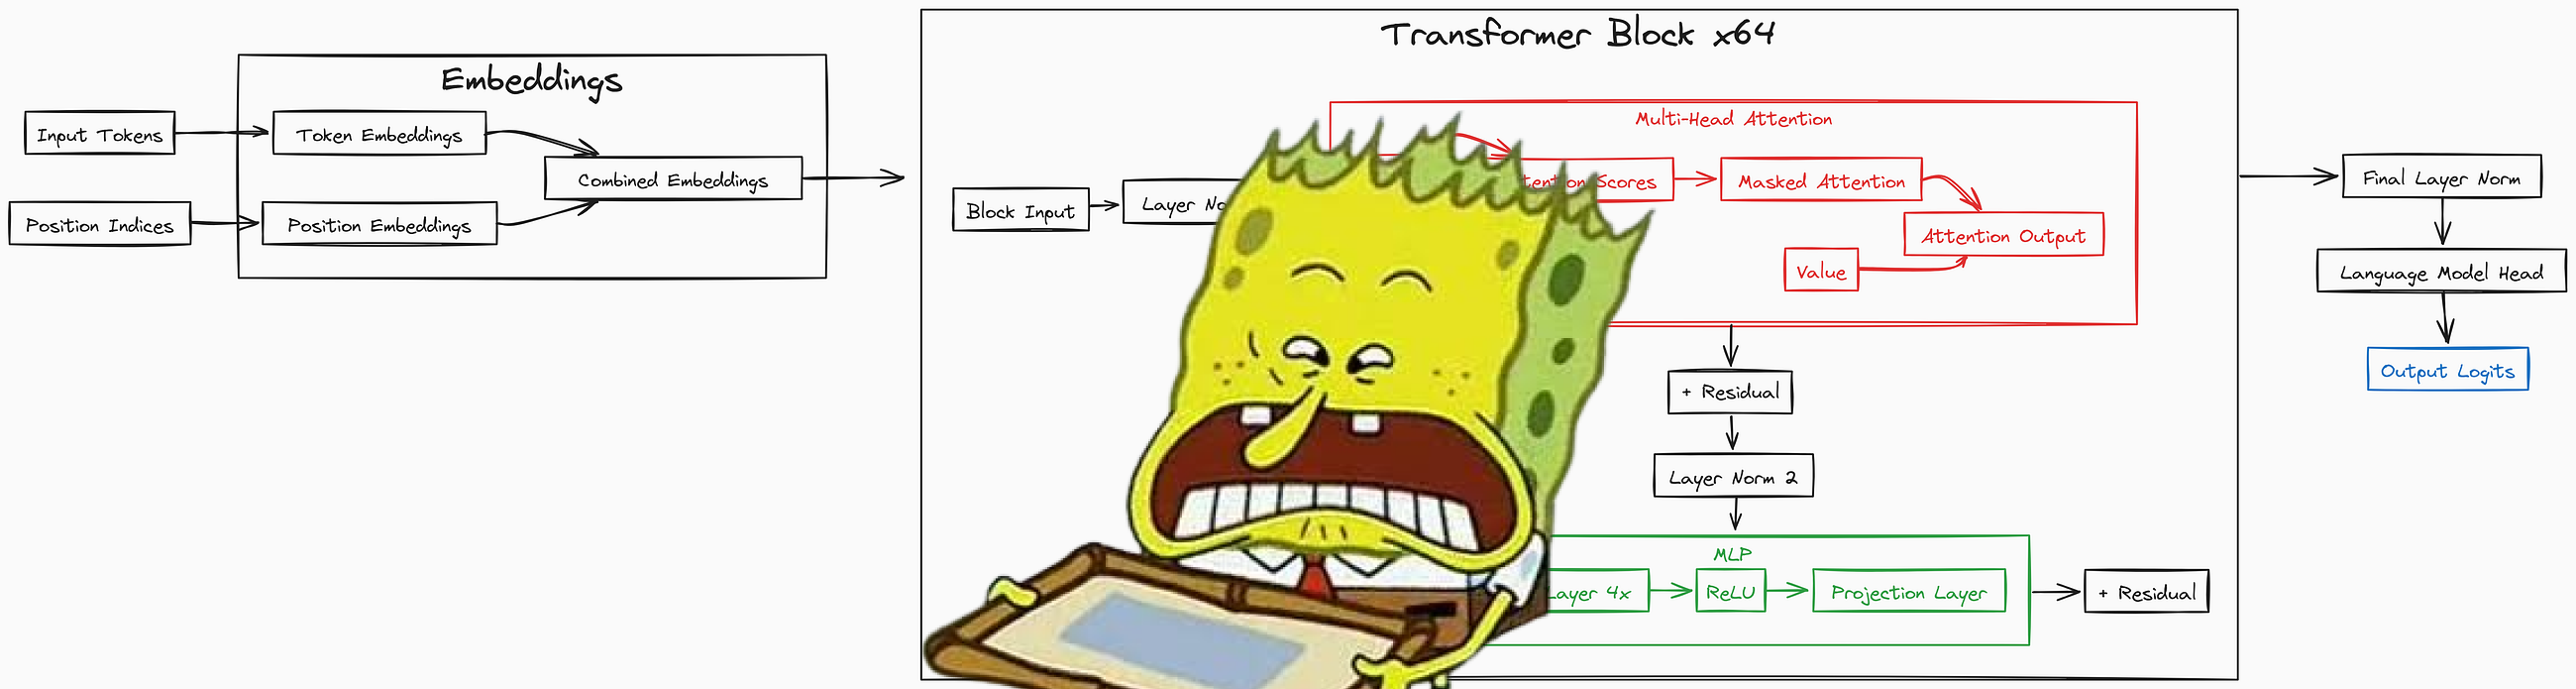 — 类型: hero(Medium 顶部横幅)
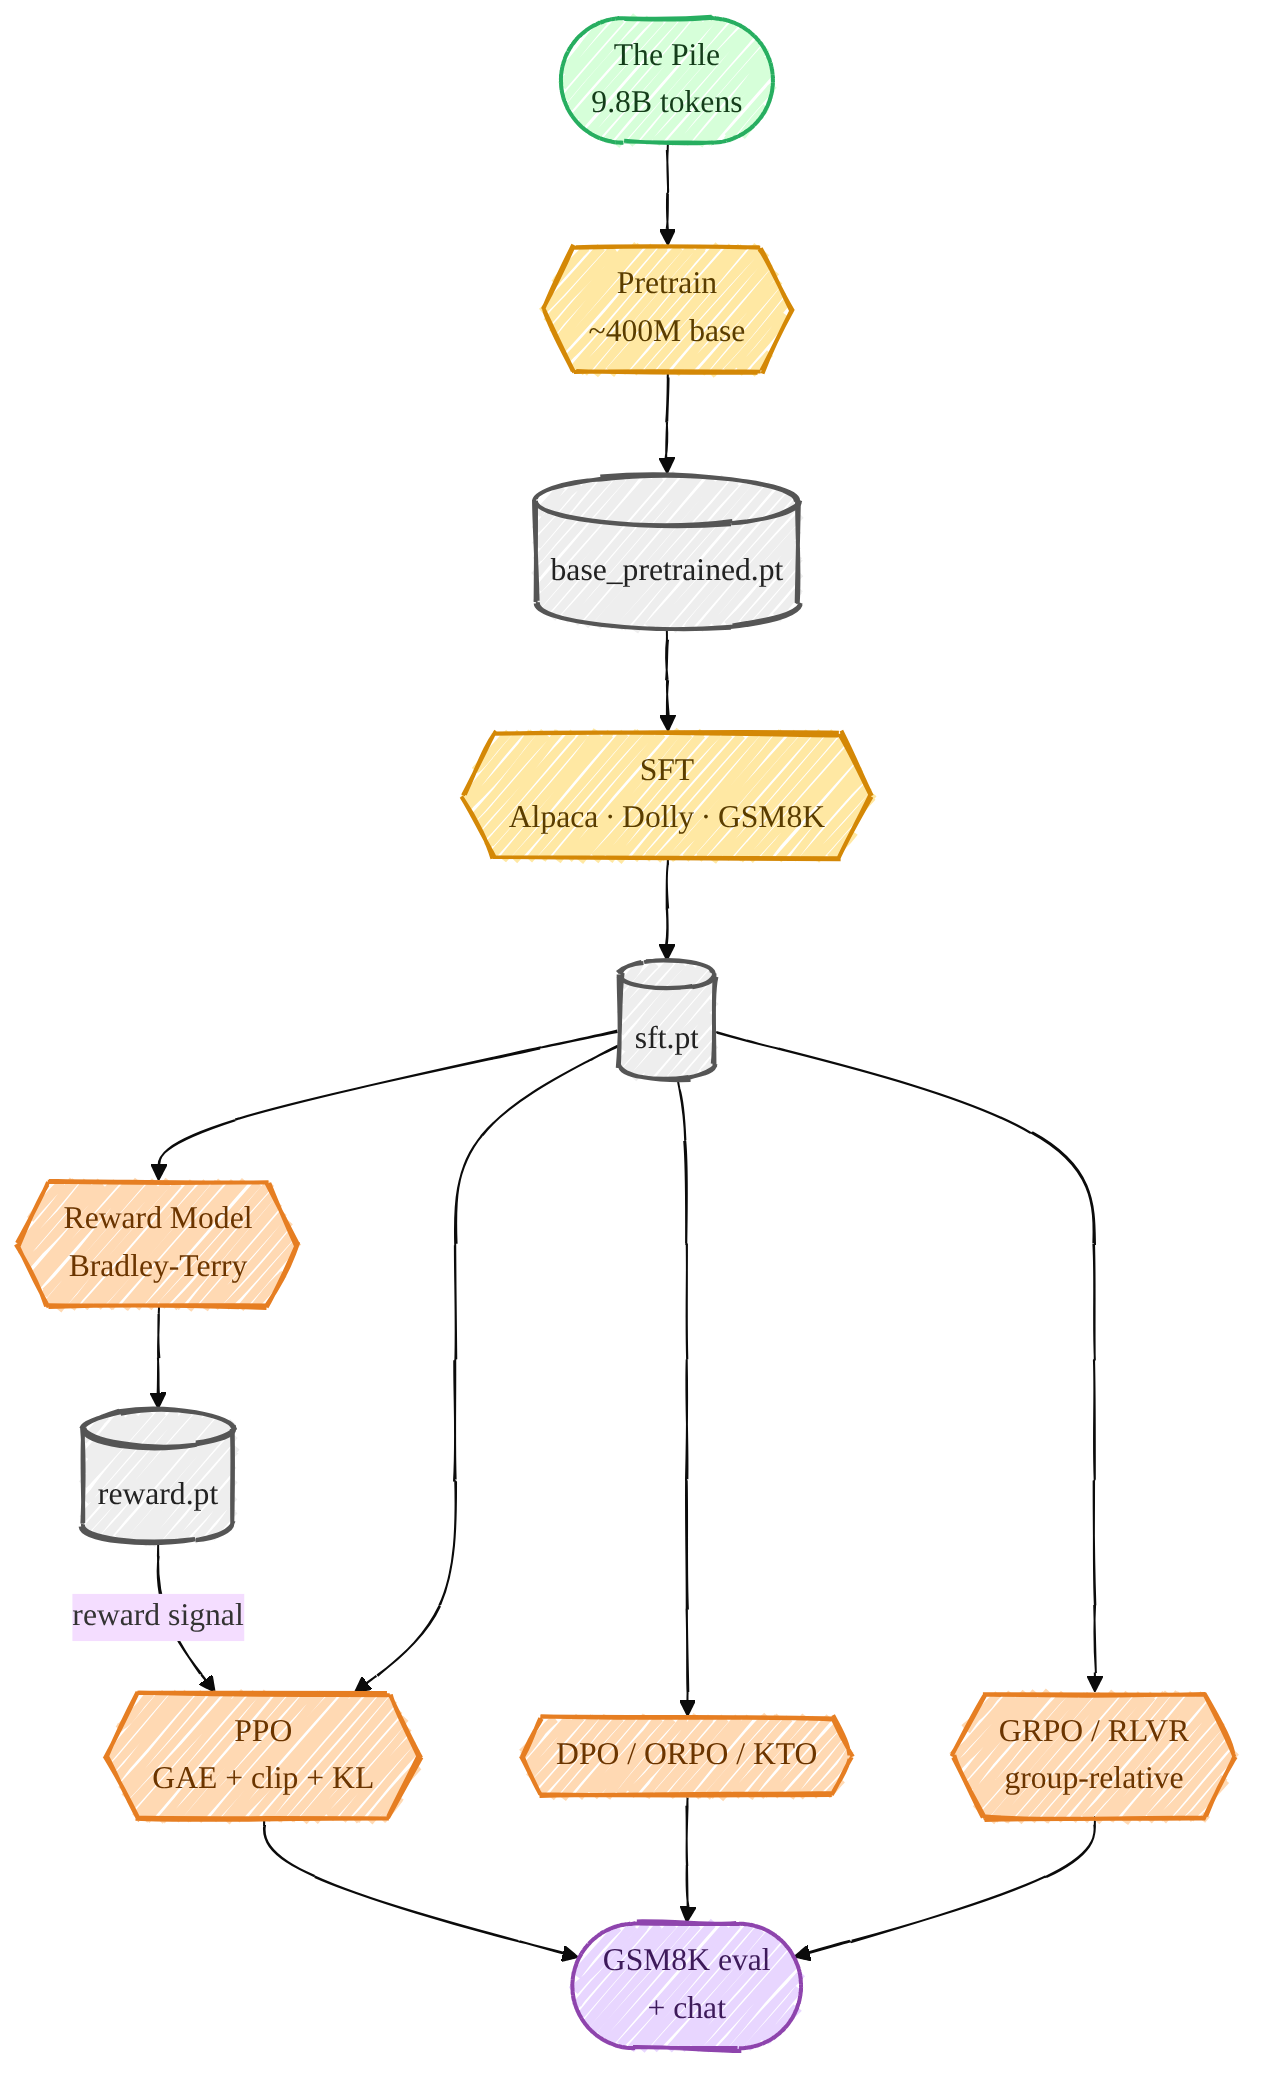 — 类型: architecture(端到端后训练流水线总览)
 — 类型: architecture(Transformer 主架构图)
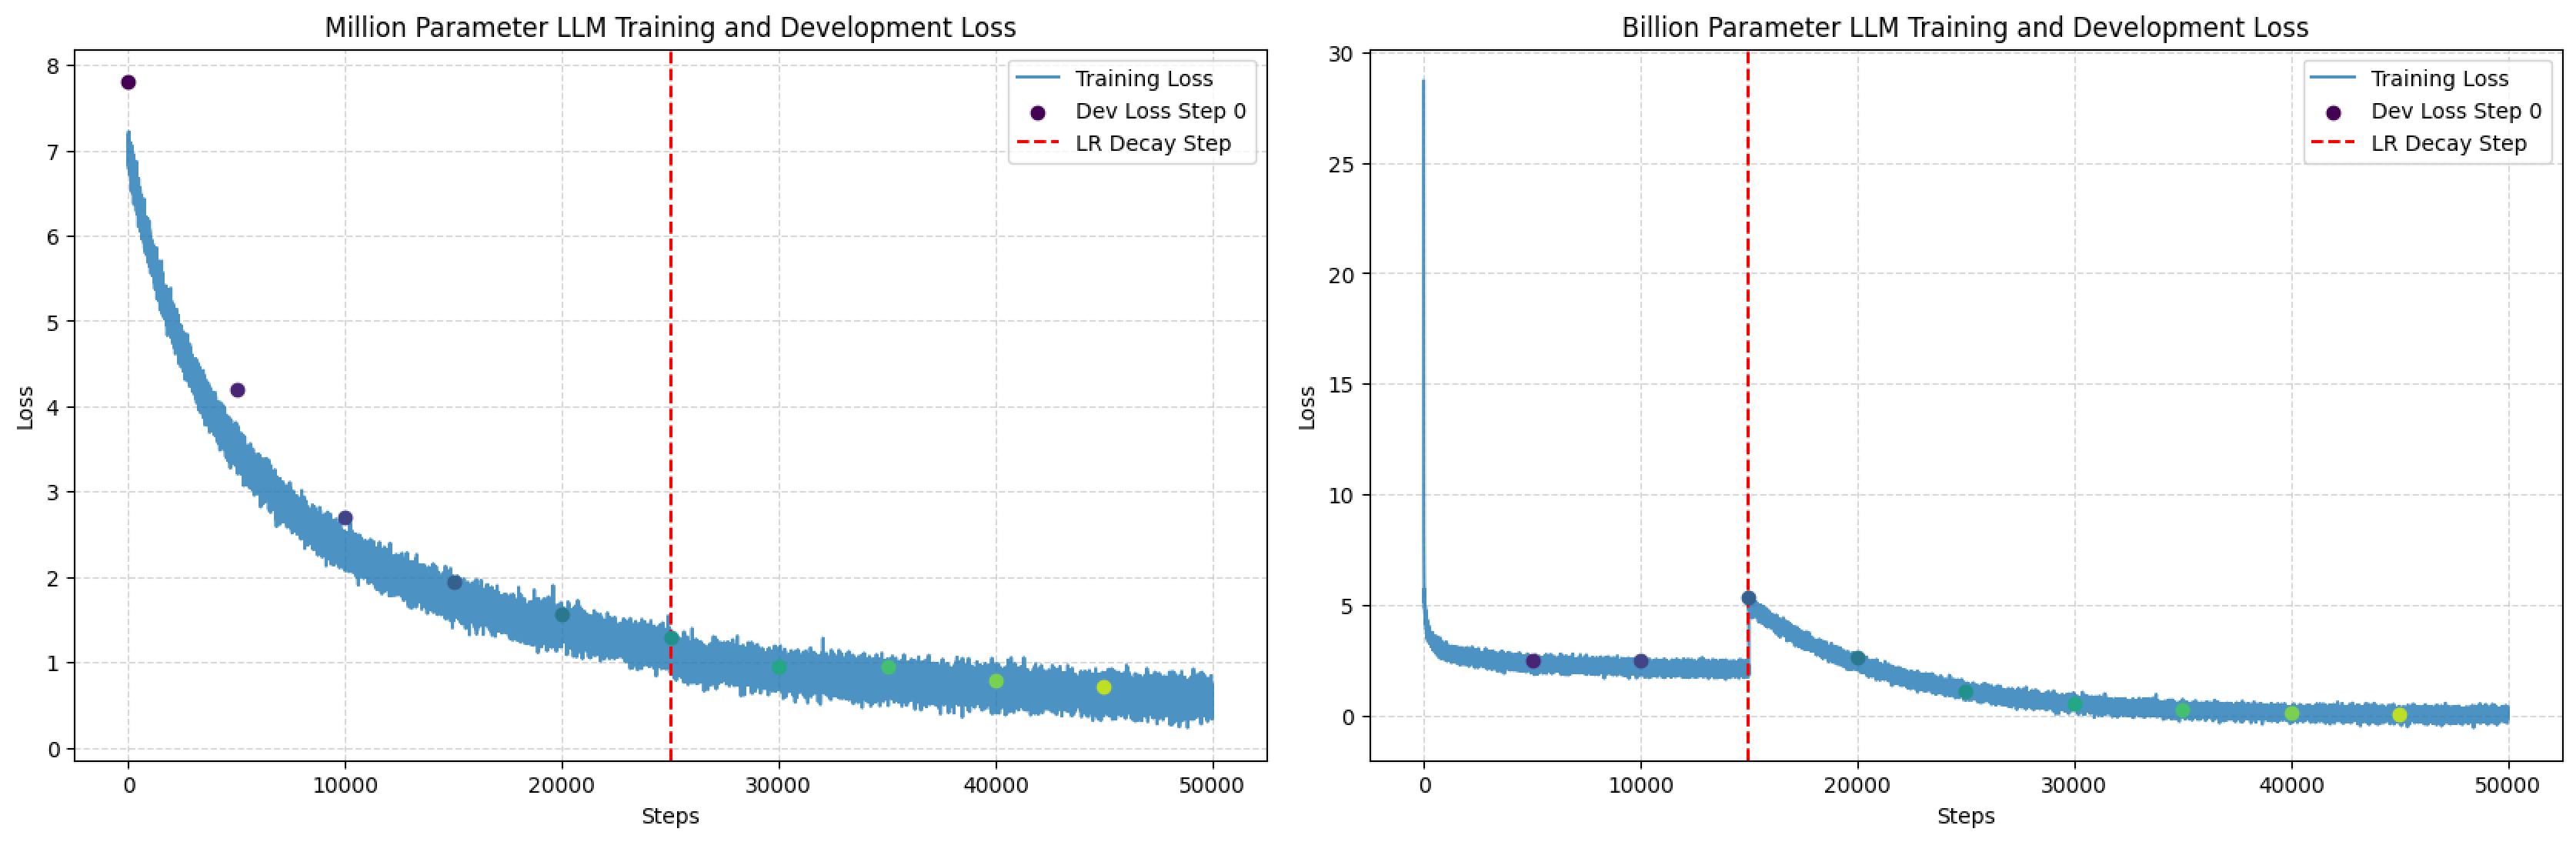 — 类型: screenshot(训练 loss 曲线)
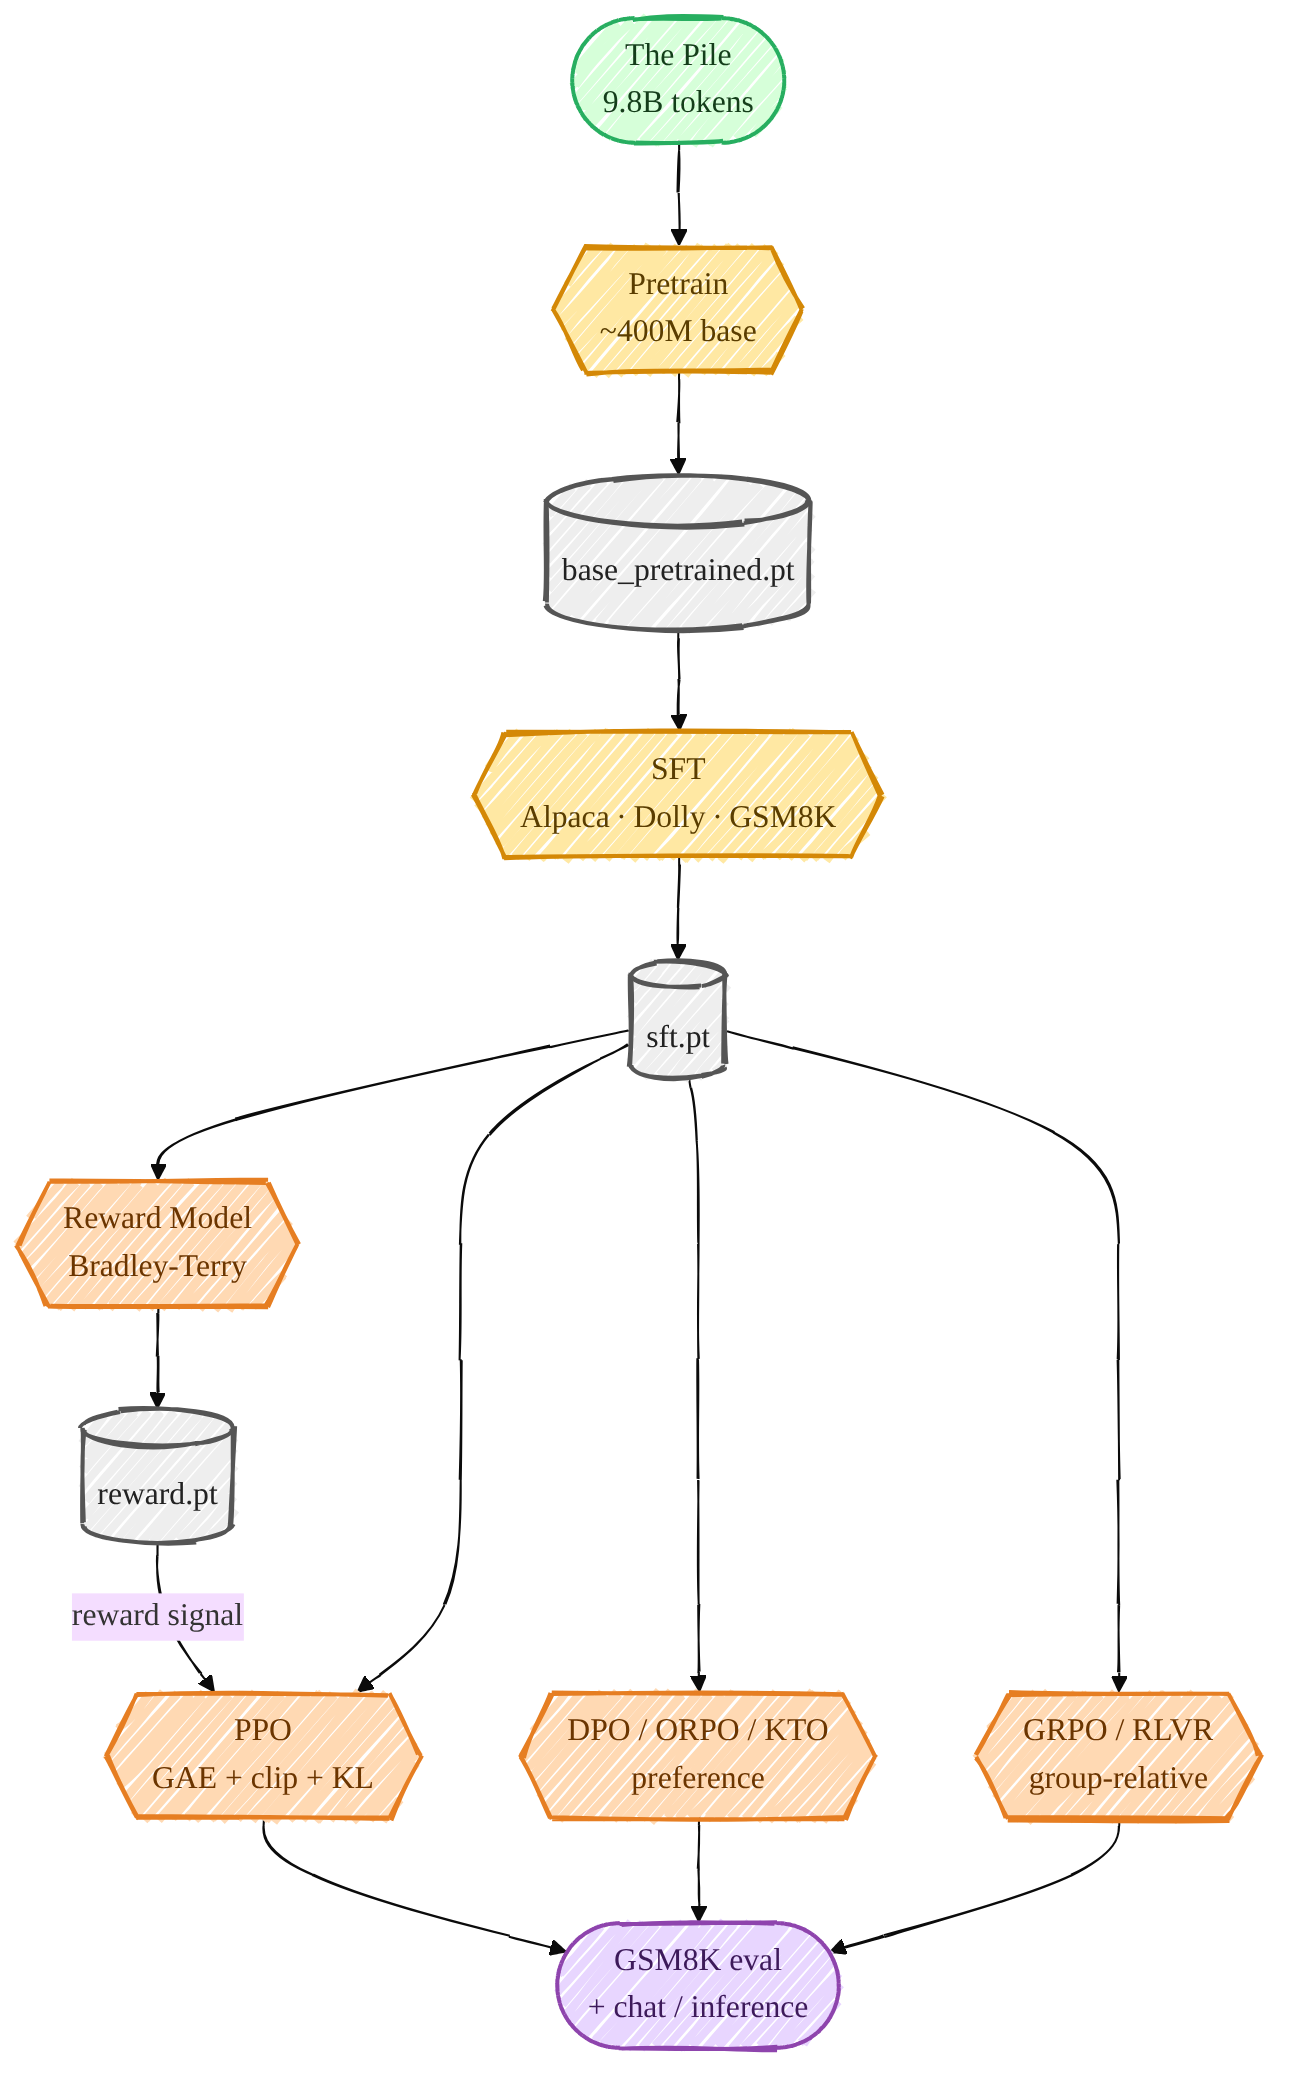 — 类型: architecture(站点 00_overview 阶段图)
官网媒体(docs/diagrams/ 内置 PNG)
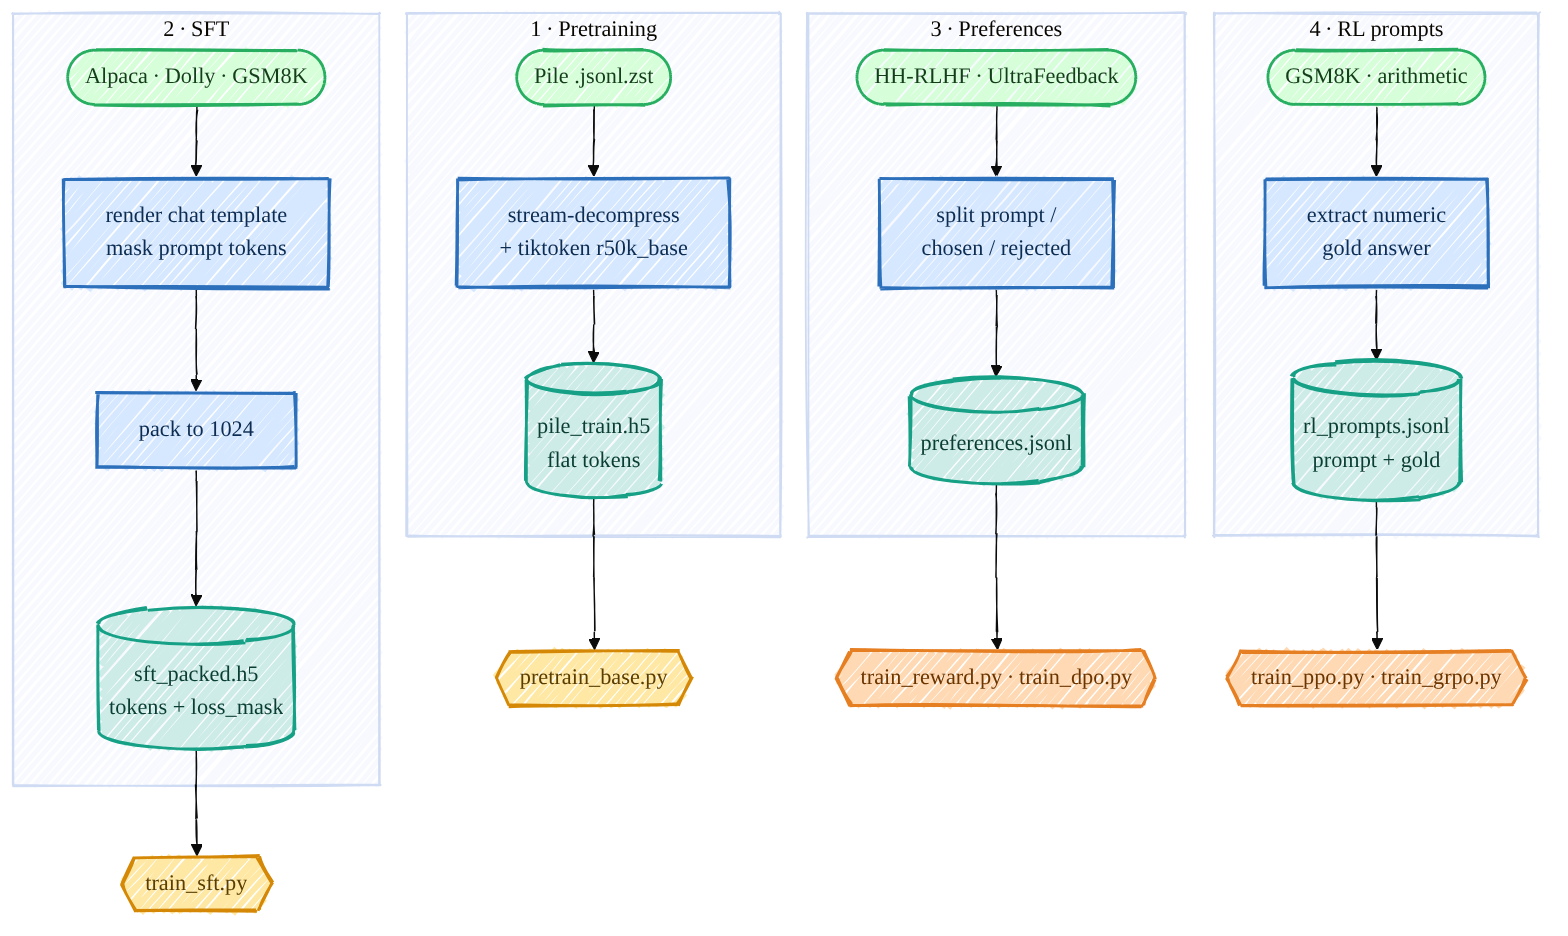 — 类型: architecture
 — 类型: architecture
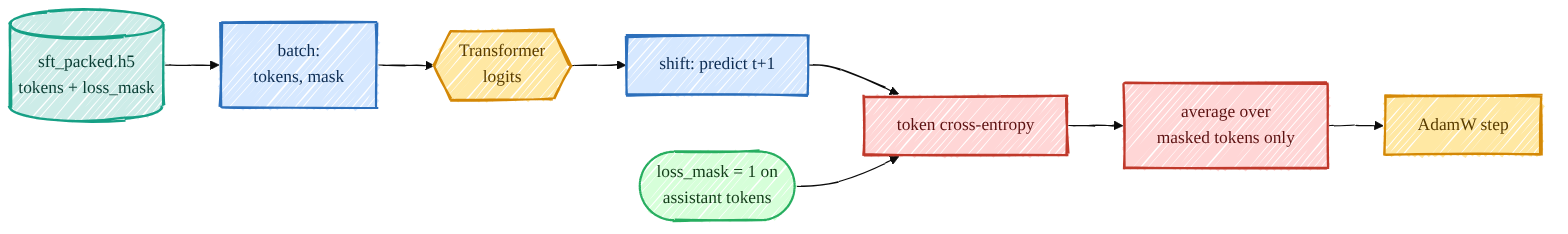 — 类型: architecture(系列,05_dpo / 06_ppo / 07_grpo 同样可链入)
视频
- OOP Python 教程(YouTube) — 前置知识
- Neural Network from Scratch(YouTube) — 前置知识
- Neural Network from Scratch part 2(YouTube) — 前置知识
筛选说明
- 总发现 8+ 媒体元素(1 hero + 6 中型架构图 + 3 教程视频 + 9 文档站阶段图)
- 策展保留 5 README 媒体 + 3 阶段图 + 3 视频,按 hero > 架构图 > 训练曲线 > 视频 排序
- 排除 4 个 badge(Python / License / Contributions / Docs)+ 1 个 star-history SVG
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/fareedkhan-dev/train-llm-from-scratch |
| Star / Fork | 5578 / 737(watcher 40) |
| 代码行数 | 4,888(Python 92.3% / JSON 3.8% / Shell 1.7% / YAML 1.6% / TOML 0.6%);注释占比 30.2% |
| 项目年龄 | 16.9 个月(首次提交 2025-01-12;最近 2026-06-04) |
| 开发阶段 | 低维护(最近 30/90 天 commit 都是 13,呈「双峰 + 静默 + 末期回血」节奏) |
| 贡献模式 | 单人主导(Fareed Khan ~56% commit;外部协作者 TianyiQ ~19% / 其余 ≤5%) |
| 热度定位 | 大众热门(5.5k star 在 LLM training tutorial 赛道中位偏上) |
| 主页 | https://fareedkhan-dev.github.io/train-llm-from-scratch/(MkDocs 静态文档站) |
| 质量评级 | 代码 良好 / 文档 优秀 / 测试 基本(无 pytest 框架) |
作者视角:为什么存在这个项目
创始人/作者背景
Fareed Khan,巴基斯坦 Karachi 的独立学习者/求职 PhD 自学者。账号 6.2 年,2036 粉丝,171 公开仓库。README 顶部直接写明 「I am Looking for a PhD position in AI」——项目本身是 PhD 申请的作品集,方法论主线是「手写 PyTorch + 一图流 + Medium 配图引流」。他在同一时期还有 all-agentic-architectures、building-claude-from-scratch、production-grade-mcp-agentic-system 等系列仓库。
问题判断
作者从 Karpathy 风格的 nanoGPT 教学出发,发现市场存在明显断层:「会 pretrain 不等于会 align」——而所有开源 LLM 教学在 Pretrain → 部署之间,要么直接跳到 TRL 这种 200k LOC 的黑盒框架、要么卡在 SFT 看不到 RM/PPO 内部。POST_TRAINING.md:173-188 的 「Design notes」 是这条断层的可执行对策:用「wrap, don’t rewrite」 把后训练 5 个算法压缩到同一份 ~2500 LOC 上,让 4 个算法的「控制流」和「目标函数」在同一份代码里可对比阅读。
解法哲学
「模型是教学文物,流水线是产品。」 这条线贯穿所有设计选择:
- 模型(
src/models/)保留 nanoGPT 级单文件实现,不动——只在transformer.py:56-75加一个forward_hidden方法。 - 算法(
src/post_training/)以「一文件一算法」+「共享 free function」拆——ppo.py装 GAE/clip,grpo.py装 group_adv/k3_kl,rollout/log-prob 抽到rollout.py作为 free function(明确说「对 4 套参数集跑同一份 math」必须 free 而非 method)。 - 配置(
config/loader.py)以 dataclass + JSON 4 层覆盖(defaults < base < stage < CLI),让 UI 和 CLI 共享同一份 schema。 - 评测(
scripts/eval_post_training.py)把 「Base → SFT → DPO → PPO → GRPO 同一份 GSM8K accuracy 表」 作为唯一 KPI。 - 明确不做什么:不引入
trl/peft/transformers(哪怕只为了省事),不引入 FSDP(2×H100 够用就不上),不写 pytest 框架(if __name__ == "__main__":手跑就够)——这些是「教学清晰优先于工业鲁棒」的明确选择。
战略意图
求职导向的「广而可读」作品集:横向 6 阶段、纵向每阶段 ~100-200 行核心模块 + 1 篇 docs + 1 个 UI 页 + 1 张手绘图 + 1 张 smoke 配置,Medium 配图 → POST_TRAINING.md → 文档站 → 仓库形成完整引流链。这不是抢 TRL 的用户,是抢「想读懂 TRL 之前先看一份 ~4500 行等价实现」的读者。
注:作者本人博客与独立长文未单独立项;架构说明直接嵌在 MkDocs 站点 9 段里;外部社区文章搜索受 Google 反爬阻断未找到。仓库 star 增长主要靠作者 Medium 图文化教程引流。
核心价值提炼
创新之处
按新颖度×实用性排序:
forward_hidden单一接口承载全后训练头(新颖 4 / 实用 5 / 可迁移 5):RM / value head / 隐式 DPO reward 都消费同一方法,教学Transformer一行不改。- rollout / log-prob 用 free function(新颖 4 / 实用 5 / 可迁移 5):PPO 对 4 套参数集(前向/老策略/参考/价值)跑同一份 math,method 绑定反而碍事,配套
_logits_from用isinstance自动 dispatch 两种 forward 形态。 - DPO/ORPO/KTO 三 loss 同文件同输入签名(新颖 3 / 实用 4 / 可迁移 5):
cfg.loss_type一键切换;_log1mexp数值稳定计算 log-odds;KTO 用 batch 估计 KL。 - GRPO 三件套:k3 KL + group-relative adv + arithmetic 暖启动(新颖 4 / 实用 5 / 可迁移 4):把 DeepSeek-R1 核心数学压到 70 行;前 100 步用程序生成的算术题预热——这是教学仓库里少见的实用补充,原论文没提。
- 4 层配置覆盖 + UI/CLI/Docs 三入口同 schema(新颖 3 / 实用 4 / 可迁移 4):dataclass 默认值 < base.json < stage.json < CLI 递归合并;Streamlit/MkDocs/argparse 全部由同一份 dataclass 反射生成。
- 跨阶段单一 KPI(greedy GSM8K accuracy)(新颖 3 / 实用 5 / 可迁移 4):一个
for s in stages: eval + append JSONL脚本把 6 阶段结果串到一张表。 - verifier = correctness 主导 + 0.2 格式 bonus + clip 1.2(新颖 3 / 实用 4 / 可迁移 4):反 reward hacking;原则(形式分 << 内容分)比具体 0.2 数值更值得搬。
- length-bucket 批处理替代 padding mask(新颖 3 / 实用 4 / 可迁移 3):利用 causal mask 的「右 padding 安全」性质 + 同长度一组批处理,attention 层零改动。
可复用的模式与技巧
| 模式 | 出处 | 一句话 |
|---|---|---|
| wrap-not-rewrite | POST_TRAINING.md:175-180 | 教学主干只加一个 forward_hidden;所有头 compose 它 |
| free function for log-prob | rollout.py:52-285 | 不绑 method,方便切 4 套参数集 |
| tuple-returning forward | value_head.py:45-49 | (logits, values) + isinstance 自动 dispatch |
| DDP 上下文 dataclass | distributed.py:20-98 | DDPContext + is_main / enabled + unwrap 让单/多 GPU 同代码 |
| 4 层配置合并 | config/loader.py | defaults < base < stage < CLI,sibling base.json 自动嗅探 |
| SMOKE config | post_training_config.py:171-178 | 固定 SMOKE 字典 + smoke(cls) factory,CPU 秒级跑 |
| JSONL-only metrics | logging_utils.py:46-58 | 先 JSONL(无依赖),wandb 当可选镜像 |
| causal padding safe + length-bucket | POST_TRAINING.md:177-180 | 右 padding + 同长度一组 + response_mask zero 掉 padding |
| k3 KL + group-relative adv | grpo.py:17-70 | exp(diff) - diff - 1 + (r - group_mean) / (group_std + eps) |
| arithmetic curriculum | train_grpo.py:64-65 | RLVR 起步无方差时用程序生成简单题预热 |
| 跨阶段单一 KPI 表 | eval_post_training.py | 一个 for s in stages: eval + append JSONL 脚本 |
| verifier = correctness + bounded format | rewards/verifiers.py | 形式分远小于内容分 + clip 上界 |
关键设计决策
-
决策:在 Transformer 上只加
forward_hidden一个方法- 问题:RM/PPO 都需要 「final hidden state」,但不想为了 RM 改教学代码
- 方案:
transformer.py:56-75加一个forward_hidden(idx) -> (B, T, n_embed),forward内部调它再lm_head - Trade-off:测试
test_forward_hidden_matches_forward用allclose(atol=1e-5)保证不变量;增加「接口多 1 条」的认知成本 - 可迁移性:极高——任何「主干 + 多头」教学仓库都能用
-
决策:rollout / log-prob 用 free function,不用 method
- 问题:PPO 一次需要「同一份输入」对 4 套参数集跑 log-prob;method 绑定到
self不利于 compose - 方案:
rollout.py全部用def f(model, ...) -> ...形式;value_head.py:45-49返(logits, values)元组 - Trade-off:牺牲 OO 直觉;换 4-参数集复用同一段 math
- 可迁移性:高——任何 RL-from-scratch 仓库都建议直接抄
- 问题:PPO 一次需要「同一份输入」对 4 套参数集跑 log-prob;method 绑定到
-
决策:DPO 三个变体塞进 95 行同一个
dpo.py- 问题:DPO/ORPO/KTO 数学相近但 reference/unpaired/paired 不同,教材化讲要放同一处
- 方案:
dpo.py:21-90三函数接受同样的(policy_chosen_logps, policy_rejected_logps, ...)形状;train_dpo.py:46-54用cfg.loss_type切换 - Trade-off:可对比阅读;未来加 IPO/SimPO 要改文件结构
- 可迁移性:高——
_log1mexp+ KTO batch-KL 两点单拎就值得
-
决策:DDP 用 1 个 dataclass 上下文 + 自由函数封装
- 问题:不用 accelerate,又要单/多 GPU 同一份代码;actor-critic + ref + old-policy 哪些 wrap 哪些不 wrap
- 方案:
DDPContext暴露is_main/enabled;ddp_setup读RANK/WORLD_SIZE自动降级;ddp_wrap在enabled=False时直接 return 原 model - Trade-off:无 NCCL/P2P 优化、显式
make_frozen_copy;超 1B param 显存崩 - 可迁移性:中——1-2 张卡、≤1B 参数、≤1024 ctx 教学/研究规模可照搬
-
决策:依赖锁死:tiktoken r50k_base 一个特殊 token = EOT
- 问题:不注册新特殊 token,但 chat 需要 role marker + 推理结构
<answer> - 方案:
chat_template.py:38-49把所有 marker 写成 plain text 模型在 SFT 阶段学会 - Trade-off:节省「为新 token 扩 embedding」工程量;marker 占多 token,SFT 成本增 5-15%
- 可迁移性:中——产品化必然要换 sentencepiece
- 问题:不注册新特殊 token,但 chat 需要 role marker + 推理结构
竞品格局与定位
竞品对比矩阵
| 维度 | nanoGPT (~38k) | LLM101n (~25k) | CS336 spring2025 (~13k) | nanoChat (~5k) | rasbt (~10k+) | 本项目 |
|---|---|---|---|---|---|---|
| 预训练覆盖 | ✔ 13M 教学 | ✔ 课程化 | ✔ 学术前沿 | ✔ 实战 + 真实成本 | ✔ 书籍配套 | ✔ 400M DDP |
| SFT | ✘ | ✘ | ✘ | ✔ 浅尝 | ✔ 单 notebook | ✔ 真 Alpaca/Dolly/GSM8K |
| Reward Model | ✘ | ✘ | ✘ | ✘ | ✘ | ✔ Bradley-Terry |
| DPO/ORPO/KTO | ✘ | ✘ | ✘ | ✘ | ✘ | ✔ 三选一 |
| PPO | ✘ | ✘ | ✘ | ✘ | ✘ | ✔ GAE + clip + value clip |
| GRPO/RLVR | ✘ | ✘ | ✘ | ✘ | ✘ | ✔ k3 KL + group adv + curriculum |
| 真数据集 | ✘ tiny shakespeare | ✔ 教育文本 | ✔ TinyStories | ✔ SmolTalk 等 | ✔ 章节式 | ✔ 5 个公开集 |
| 多卡 DDP | ✘ | ✘ | ✘ | ✘ | ✘ | ✔ torchrun 一行 |
| 真实评测(非 toy) | ✘ | ✘ | ✘ | ✔ CORE | ✘ | ✔ GSM8K 跨阶段 |
| 依赖 | torch | torch | 多 | torch | torch + transformers | torch + tiktoken + h5py(无 trl/peft/transformers) |
| 文档站 | ✘ | ✔ 课程站 | ✔ 视频 | ✘ | ✔ 书 | ✔ MkDocs 9 段 + 手绘图 |
| 控制面板 UI | ✘ | ✘ | ✘ | ✘ | ✘ | ✔ Streamlit 9 页 |
| 单元测试 | ✘ | ✘ | ✘ | ✘ | ✘ | ✔ smoke + RL math |
| LOC(粗算) | ~300 | ~1k+ 课 | 几百/讲 | ~1.5k | ~5k+ | ~4.5k |
差异化护城河
在 post-training 完整度(6 阶段全包)、真数据集(5 个公开集)、真评测(GSM8K 跨阶段)、多卡(DDP 单代码路径)、测试覆盖(smoke + RL math)、依赖极简(不调 trl/peft/transformers)6 个维度上对所有竞品都有优势。这是开源里独一份的「手写 GAE 数学不被框架吞掉」的参考实现。
竞争风险
- TRL 仍是生产环境默认选择——
trl.Trainer把多算法 PPO/DPO/GRPO 集成到一个统一 API;本项目无 industrial-grade checkpoint、FSDP、eval harness,长期看还是教学而非生产。 - Karpathy nanoChat 抢占「真做出一个 chat 模型」 的心智——本项目能教你怎么写 post-training,但教不了你 4 小时训出 500M 可发布模型。
- Stanford CS336 抢占「学术前沿」 心智——FlashAttention / FSDP / 最新论文导读本项目无。
生态定位
在 LLM 教学生态里填补**「端到端后训练 + 纯 PyTorch + 不调大框架」的空白——不是替代品,是阅读 TRL 源码之前的过渡读物。在求职 PhD 作品集赛道里,是中等规模(5.5k star)但广度 + 文档化 + 真实可跑**三者同时做到的稀缺样本。
套利机会分析
- 信息差:5.5k star 在 LLM training 赛道中位偏上,但 Issue #24 已被 phantomstars 标记「Fake engagement detected」,最近 178 个 star 全部集中在 2026-06 一个月内——star 信号打折看。「被低估」窗口已关闭,但「教学参考价值」独立于 star 信号。
- 技术借鉴:12 条可复用模式(见上表)几乎都能整段搬走——其中
wrap-not-rewrite、free function for log-prob、tuple-returning forward、4 层配置合并、k3 KL + group-relative adv、arithmetic curriculum这 6 条在任何 RL-from-scratch 项目都直接可用。 - 生态位:填补「手写 GAE 数学不被框架吞掉」的空白。读者群体:想读懂 TRL 之前先看等价实现的 ML 工程师、求职 PhD 的学生、对齐方向研究者。
- 趋势判断:项目近 90 天 commit 13、最近 30 天 commit 13——典型的「低维护 + 末期回血」,且伴随 #24 假互动信号,不能作为长期投入判断依据;但
POST_TRAINING.md末尾的 「What’s Next」 与 9 段 MkDocs 路线图清晰,作为参考实现的价值独立于项目活跃度。
风险与不足
- #24 phantomstars 标记:社区工具已识别可疑 star 行为,最近 178 star 全部集中在一个月内,star 信号需打折看。
- 没有 lockfile:
pyproject.toml只写torch不写torch==2.6.0;requirements*.txt用--extra-index-url不锁版本——复现性弱,与 Issue #5(默认 3B OOM)可能部分相关。 - 没有 PR CI / 没有 pytest 框架:
tests/test_*.py全是if __name__ == "__main__":,无法pytest tests/、无 coverage;Issue #7(包名config与顶层config/目录冲突)本应被 CI 卡住。 torch.load(weights_only=False)在 4 处出现(inference.py:22/reward_model.py:26/utils.py:82/eval_post_training.py:29)——接受外部 ckpt 有 RCE 风险。- Issue #5:默认 3B 配置 A100 40GB OOM,反映作者倾向展示大模型但对显存/算力门槛的指引不足。
- Issue #16:post-training 阶段缺 checkpoint resume,对一个号称「单 GPU 可跑数小时」的教程项目是关键缺失。
- 没有 FSDP/ZeRO/bucket 调优:上 1B param 显存就崩;长上下文(>1024)失效。
- 没有 Dockerfile / 没有 setup.cfg / 没有 pyrightconfig.json——部署到非 dev 机器有摩擦。
行动建议
- 如果你要用它:≤400M / ≤1024 ctx / 2×H100 范围内快速多算法对比;学习 RLHF/GRPO 算法的可读参考实现。不要作为生产环境基线。
- 如果你要学它:优先读
POST_TRAINING.md:175-188的 「Design notes」(设计哲学)src/models/transformer.py:56-89(forward_hidden单一接口)src/post_training/rollout.py:52-285(free function 模式)src/post_training/{sft,reward_train,dpo,ppo,grpo}.py(一文件一算法 +k3_kl+group_advantages)src/post_training/distributed.py(DDP 上下文 dataclass)config/loader.py(4 层配置合并)docs/02-07_*.md(9 段 MkDocs)
- 如果你要 fork 它:
- 把
torch.load(..., weights_only=False)全部改成weights_only=True(自产 ckpt 无需 pickle) - 引入
uv.lock或poetry.lock锁依赖 - 把
tests/test_*.py改成def test_*()+conftest.py启用 pytest - 补 PR CI:lint + smoke test + docs build
- 加 checkpoint resume(Issue #16)和更细粒度的显存感知默认配置(Issue #5)
- 把 DPO 三 loss 拆分子模块以容纳 IPO/SimPO
- 加 Dockerfile +
pyrightconfig.json提升可移植性
- 把
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 未收录(页面持续 Loading,无索引内容) |
| Zread.ai | 403 Forbidden(推断未收录) |
| 关联论文 | 仓库本身是 Attention is All You Need (Vaswani et al., 2017) 的复现 + 现代 alignment 论文(DPO/GRPO)整合;无仓库专属 arXiv 论文 |
| 在线 Demo | 无独立在线 Demo;MkDocs 文档站 是主要展示窗口 |
| 配套 notebook | sft_rlhf_guide.ipynb(仓库内置 ~150KB 单文件复现指南) |