4.5K stars、89% 单人代码:把 70B 模型塞进 24GB 显卡的 EXL2 量化推理库怎么炼成的
一句话总结
exllamav2 是消费级 NVIDIA 显卡上跑大模型的事实标准推理后端:首创 EXL2 任意平均位宽混合量化,配合 paged KV cache + 内容哈希去重 + Hadamard 旋转缓存,把「24GB 显存跑 70B」从 hack 变成了可调参数。
值得关注的理由
- 量化路线的破局者:在 GPTQ(固定 4 bit)和 AWQ(激活感知 4 bit)之外,开辟了「2-8 bpw 任意平均位宽 + 层级混合 + 重要列高比特」第三条主流量化路线,HF 上 LoneStriker / bartowski / turboderp 三家已分发数千个 EXL2 模型。
- 工程范式的样本:薄 Python 编排 + 厚 CUDA C++ 内核(
exllamav2_ext单目录 893 次修改撑起 60% 改动量)、编译时 kernel 组合 + 运行时 autotune(per-shape IQM 选块大小),是学习 LLM 推理工程的活教材。 - 过渡期的代表作:README 自承「archived for now」,v3 已接续——这是一个「v2 退役、v3 接棒」的完整案例,可观察独立开源项目如何治理代际过渡。
项目展示
README 媒体
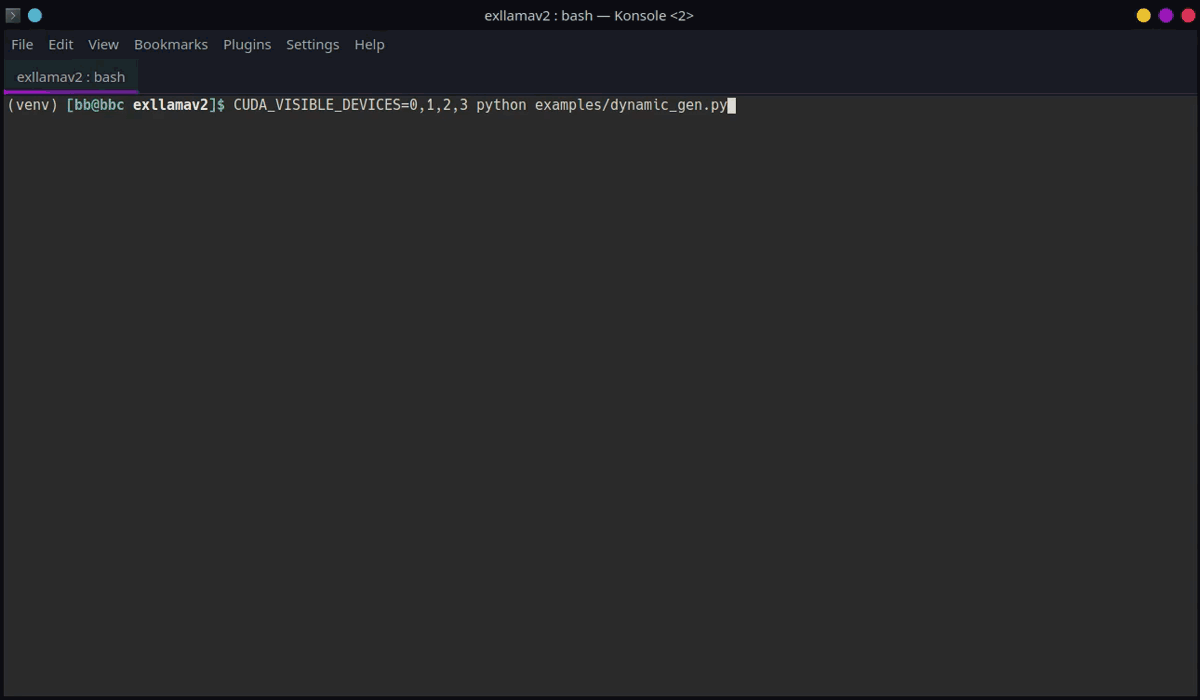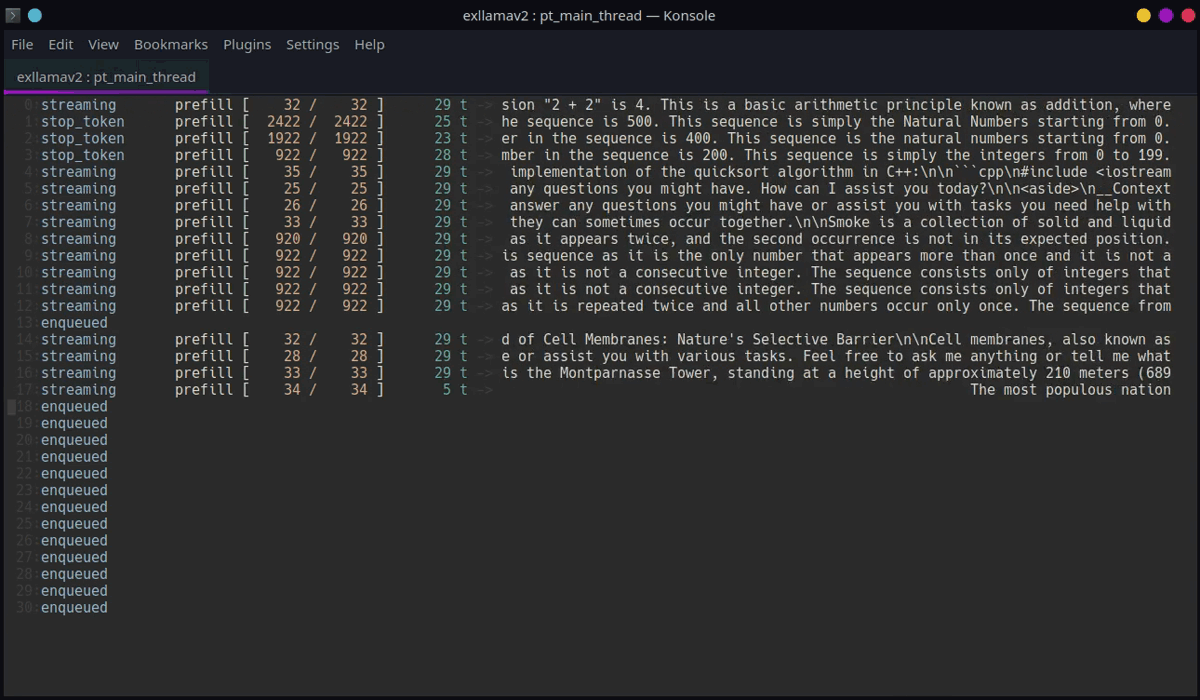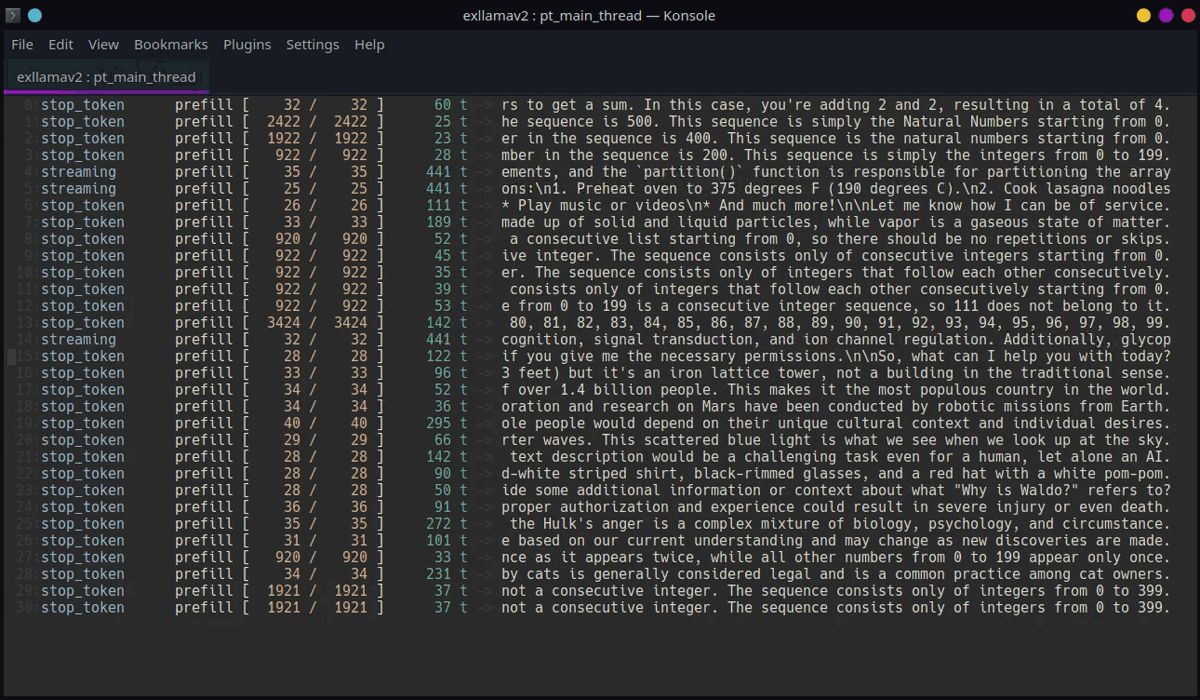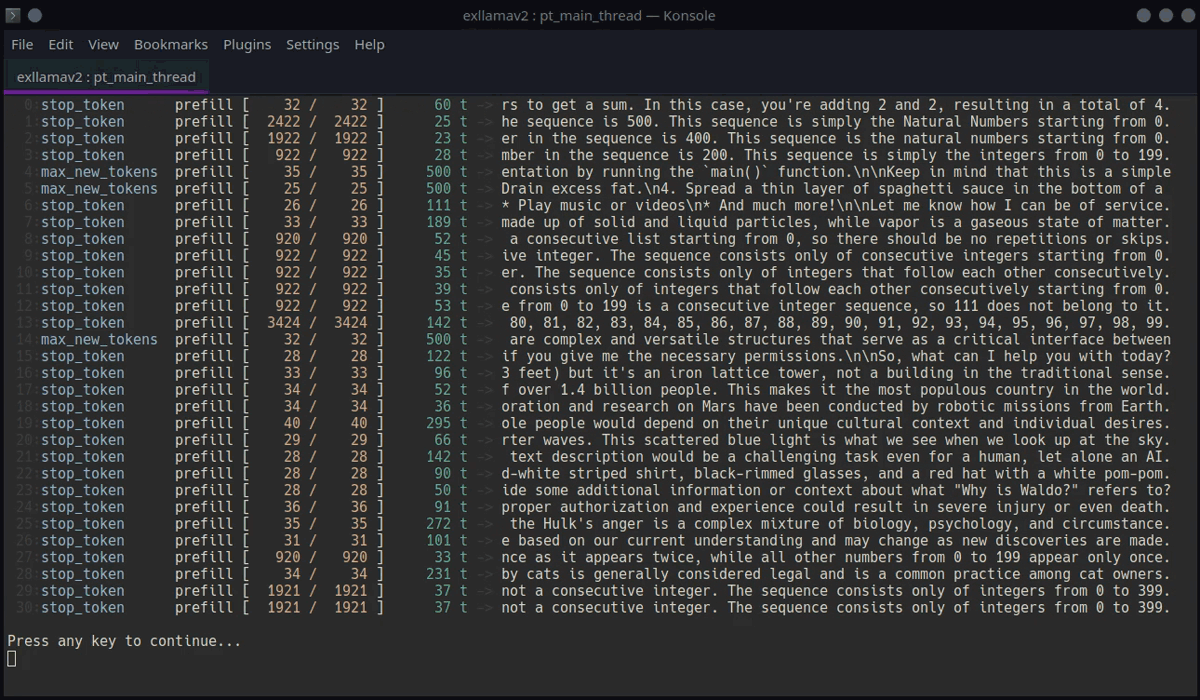 — 类型: demo(动态生成器批处理/缓存演示)
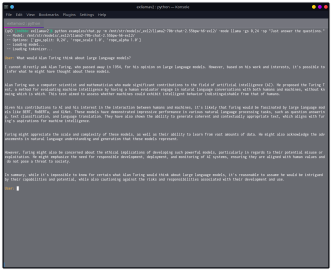 — 类型: screenshot(70B 模型在 24GB 单卡的运行实例)
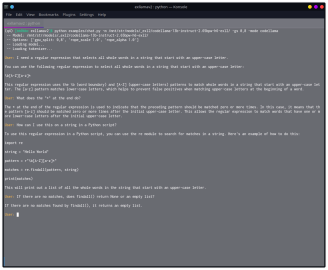 — 类型: screenshot(13B 代码模型在 8GB 显存运行)
筛选说明
- 总共发现 3 个媒体元素,筛选后保留 3 个
- 排除了 0 个 badge/CI 状态图标(仓库干净,无 shiled 噪音)
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/turboderp-org/exllamav2 |
| Star / Fork | 4,544 / 338 |
| Watcher | 33 |
| 代码行数 | 28,376 行(Python 79.7%, C++ 14.6%, C Header 5.7%) |
| 注释占比 | 51.5%(罕见的高注释比,说明作者对算法解释比代码本身更用心) |
| 文件数量 | 182 |
| 项目年龄 | 33.3 个月(首次提交 2023-08-30) |
| 最近推送 | 2026-03-04 |
| 开发阶段 | 低维护(近 365 天 9 commits,近 30/90 天 0 commits) |
| 开发模式 | 业余 Side Project(周末占比 36.7%,深夜占比 33.5%) |
| 贡献模式 | 单人主导(turboderp 占比 87%,60 位贡献者) |
| 热度定位 | 中等热度(4.5K stars,月入 24-43 stars) |
| 质量评级 | 代码[优秀] 文档[优秀] 测试[基本] CI/CD[完善] |
| License | MIT |
| 最新版本 | v0.3.2(共 43 个 tag,语义化版本) |
作者视角:为什么存在这个项目
创始人/作者背景
turboderp 是从 ExLlamaV1 起步的独立开发者,2024-12-30 将账号升级为 turboderp-org 组织。Bio 只有一句「I’m an organization now.」——极简但信号清晰:这是一个把全部精力押在 LLM 量化推理上的实践派。从 EXL2 格式的独创到 ExLlamaV3 的 EXL3(融合 QTIP),技术路线一脉相承,是消费级 GPU 本地 LLM 推理圈的核心人物之一。同组织下另一个 repo exllamav3(931 stars,最近推送 2026-06-06)活跃度远超 v2,说明作者精力已转向 v3。
问题判断
作者在 V1 阶段就把瓶颈拆成两个独立可解的问题:「weights 量化格式」和「KV cache 调度」。v2 是这两个问题的并发解法:
- 现有 GPTQ 路线只支持固定 4 bit 粒度,无法在「降权重位宽」和「保留模型质量」之间连续调节;
- llama.cpp 用统一比特率 + 平台抽象换通用性,不专门优化单卡 24GB 高端消费卡的吞吐;
- vLLM 走「同一张卡服务几十请求」路线,量化路径更多依赖 AWQ/GPTQ 固定格式。
EXL2 的切入点是「任意平均 bitrate + 层级比特率 + 重要列高比特(伪稀疏)」+ 把 paged attention 当成主路径而非生产增强,让「单卡 + 长上下文 + 多会话」这一组合跑得最舒服。
解法哲学
- 极简分层 + 一刀到 GPU:Python 侧只做编排 + 调度 + 校准,几乎所有数值计算密集工作(量化反量化、Q-GEMM、paged attention、cache copy)丢进
exllamav2_extC++/CUDA 扩展。 - 对 spec/serving 的态度:
doc/dynamic.md主动承认「FP8 缓存比 Q4 差,我们不打算支持 FP8」,并直言 Q4 + Hadamard 旋转的 cache 在 perplexity 上反超 FP8——优先选择「在更低位宽下更准」的方案,不为外部标准(FP8 LLM.int8() 那条路)妥协。 - 生态 vs 平台:
architecture.py(ExLlamaV2ArchParams)用一组「keymap + 通用 key 路径模板」把新模型统一接入,但绝不抽象成「模型是 dict」——每个架构仍要明确指出is_moe/fused_qkv/mqa等枚举标记,让优化器/内核选择器能 hardcode 路径,规避运行时多态。 - 对比竞品,作者明确选择了不做什么:不做 OpenAI-API 兼容 server(直接交给 TabbyAPI/exui/TGW 集成),不做多模态之外的视觉塔抽象,不做端到端训练 / 校准数据构建工具。
战略意图
v2 是 v3 的生态护城河——v3 接续(EXL3 格式 + QTIP 衍生路线),v2 进入维护期。两个版本同一作者同一组织,v2 积累的 EXL2 模型生态 + 工具链 + 集成(TabbyAPI、ExUI、text-generation-webui、SillyTavern、lollms-webui)是 v3 商业/社区护城河。没有商业版 / SaaS,genuinely open(MIT),但形成了「准标准」——EXL2 是 2.55~8 bpw 的事实量化格式,因为 auto-gptq/transformers 不能直接消费,反过来锁住了 TabbyAPI / ExUI 的后端选择。
核心价值提炼
创新之处
-
EXL2 任意平均 bitrate 混合量化 + 模拟退火优化器
- 同模型内不同 layer 用不同 bitrate 组合(
qparams.py19×4 + 17×3 候选),用 GPTQ Hessian 逆做按列量化(adaptivegptq.py),用 simulated annealing 选 per-layer 组合满足目标 bpw(ext_quant.cpp::sim_anneal) - 同权重 2-8 bpw 之间连续可调,量化一次要 ~12 轮完整前向
- 新颖度 4/5,实用性 5/5,可迁移性 4/5
- 同模型内不同 layer 用不同 bitrate 组合(
-
paged KV cache + 内容哈希 dedup + LRU + 跨页状态拷贝
exllamav2/generator/dynamic.py::CachePage用 (phash, prev_hash, kv_position, sequence, ref_count, access_serial) 五元组allocate_pages通过 blake2b 链式哈希 +CachePage.update_hash做 O(1) 跨请求前缀复用- 新颖度 4/5,实用性 5/5,可迁移性 5/5
-
per-shape 自调优 CUDA kernel 块大小(IQM + fallback)
q_gemm_autotune.cuh::at_select在第一次见到 (M, K, N) 组合时跑 200 次时序 + 20 次 warmup- 对 32 和 64 block size 取 IQM(5/16 ~ 11/16 分位均值),按 (32/64 选择、fallback) 决策缓存到全局 map
- 新颖度 3/5,实用性 5/5,可迁移性 5/5
-
Hadamard 旋转 K/V + Q4 cache,perplexity 反超 FP8
exllamav2/hadamard/hadamard.py预生成 Paley / Sylvester Hadamard 矩阵- 运行时对 K/V 做正交旋转再 Q4 量化;
qcache_eval.md给出 Mistral 7B 3.0 bpw 下 Q4(13.37) 比 FP8(13.43) 更接近 FP16(13.33) 的实测数据 - 新颖度 4/5,实用性 4/5,可迁移性 4/5
-
N-gram 自推测解码(
iterate_ngram_gen)generator/dynamic.py::NGramTrie用 trie 维护每个 job 自己的「历史 n-gram 频次表」- 草稿阶段从 trie 最高频 child 选下几个 token;零额外模型成本,适合 batching 场景
- 新颖度 3/5,实用性 4/5,可迁移性 4/5
-
声明式架构描述符 + 字符串 keymap 模板
architecture.py把「哪个 norm / QKV 是不是融合 / 是不是 MoE」做成枚举 + 字符串路径模板- 让 model.py 加载、convert.py 量化、quantize.py 打包三处共用同一份 key 路径
- 新颖度 3/5,实用性 5/5,可迁移性 4/5
可复用的模式与技巧
| 模式 | 简述 | 适用场景 |
|---|---|---|
| Paged KV cache + 内容哈希 dedup + LRU | blake2b 链式 hash 做内容寻址、ref_count 做引用计数、access_serial 做 LRU | RAG、多会话 chat、batch 推理、共享 system prompt 复用的服务 |
| Compile-time kernel composition + 运行时 autotune | 编译时把多个 .cu 单元拼到同一个 TU,运行时对每个 shape 跑 IQM 时序 + 异常 fallback | 多种实现(不同位宽/不同分块)共存的高性能 GPU 算子 |
| QParams 字典 + 模拟退火分配 | 预定义候选集合 → 测量一遍 → SA 求解 | 任意「per-block 决策」优化问题(量化位宽分配、KV 压缩预算、模型剪枝等) |
| 薄 Python 调度 + 厚 C++/CUDA 扩展 + 多维 wheel matrix | EXLLAMA_NOCOMPILE + torch.utils.cpp_extension 实现 JIT 兜底,GH Actions 矩阵打 wheel | 任何带 GPU 扩展的 Python ML 库 |
| Hadamard 旋转 + 量化 | 正交旋转把 outlier 摊平,让低位宽量化更准 | KV cache 量化、weight 量化(QuaRot / SpinQuant / FlatQuant 等同思路) |
关键设计决策
-
决策: EXL2 量化格式 = GPTQ Hessian 逆按列量化 + 任意 2-8 bit 混合 + 同一层内多 bitrate 拼接(伪稀疏)+ 模拟退火在权重预算内选最优 per-layer 组合
- 问题: 固定 4 bit 浪费,4 bit 单 bitrate 难满足「质量-体积」曲线的细粒度调节;逐层统一比特率又让低 bpw 模式下「重要层坍缩」
- 方案:
qparams.py预定义候选组合,measure.py在每个矩阵上跑过所有候选并记录「理论误差」,optimize.py调用ext_c.sim_anneal求解 - Trade-off: 量化一次要 ~12 轮完整前向,CPU 求解较慢,换得「在同一 bpw 目标下比 AWQ/GPTQ 更窄的质量损失 + 同一模型不同 bpw 复用同一份 measurement.json」
- 可迁移性: 高
-
决策: 编译时 kernel composition + 运行时 autotune
- 问题: EXL2 每种 (group_size, bits) 组合都要一份专用 CUDA kernel,可执行文件不能动态加载
- 方案:
comp_units/unit_exl2_*.cu和unit_gptq_*.cu作为独立编译单元,由kernel_select.cu总编;运行时q_gemm_autotune.cuh::at_select在第一次见到某个 (M, K, N) 形状时跑 200 次时序,用 IQM 选 block size - Trade-off: 一次 prefill 略慢,换得「之后所有相同 shape 的 forward 都是最优 kernel」;ROCm 上 autotune 直接禁用并强制 fallback 到 64
- 可迁移性: 中-高
-
决策: 动态生成器把「paged attention + 内容哈希 + LRU 替换」绑成一个 KV cache 子系统
- 问题: 单 batch 多请求的 KV cache 浪费(padding 浪费 + 不能跨请求复用 system prompt 公共前缀)
- 方案:
exllamav2/generator/dynamic.py::PAGED_PAGE_SIZE = 256固定分页;CachePage用 blake2b 对每页 token 序列 + 前页 hash 链式哈希做 O(1) 复用查找 - Trade-off: 必须依赖 Flash Attention 2.5.7+ 的 paged attention,且不支持 FP8 缓存(README 自承「performs worse」),换来「任意长度 + 任意并发 + 共享前缀零成本复用」的简洁 API
- 可迁移性: 高
-
决策: 自适应 scale(
AdaptiveQuantizer.find_params)+ 网格搜索最坏 p- 问题: 传统 GPTQ 用单 bit 标量 scale 在 group 内归一化,但在 EXL2 多 bitrate 混合下,每 bit 组合的「最佳 scale 范围」不同
- 方案:
adaptivegptq.py用 4-bit 二次 scale 量化(qscale_t = round(sqrt(base_scale / qscale_max_t) * (scale_maxq+1)));之后调用ext_c.quantize_err在 96 个候选 p 因子下扫描 - Trade-off: 每 layer 多 ~96 次量化评估(GPU CUDA 内核实现,开销可忽略),换来「不需要手工调 scale,在 2/3/4/5/6/8 bit 之间无缝切换」
- 可迁移性: 中
竞品格局与定位
竞品对比矩阵
| 维度 | exllamav2 | exllamav3 | llama.cpp | vLLM | AutoAWQ |
|---|---|---|---|---|---|
| Stars | 4,544 | 931 | 70K+ | 30K+ | 2K+ |
| 核心定位 | NVIDIA 消费卡极限量化推理 | 同作者继任者,EXL3 + QTIP | 跨平台通用推理 | 生产级 LLM serving | AWQ 量化路线 |
| 量化格式 | EXL2(2-8 bpw 任意混合) | EXL3(QTIP 衍生) | k-quants(统一比特率) | AWQ/GPTQ | AWQ(4 bit 固定) |
| 平台覆盖 | NVIDIA CUDA + AMD ROCm | NVIDIA CUDA | CPU/Metal/CUDA/ROCm/Vulkan/SYCL | NVIDIA CUDA | NVIDIA CUDA |
| 多并发 | paged + dedup + continuous batching | tensor/expert parallel | 基础 batching | continuous batching + prefix caching | 无(量化器) |
| KV cache 优化 | Hadamard 旋转 + Q4 cache | 2-8 bit cache | Q8_0 / Q4_0 | PagedAttention | 不涉及 |
| 极低显存 | 2.55 bpw 跑 70B | 实验性 | 1-2 bit Q4_0/Q2_K | 不擅长 | 4 bit 固定 |
| 项目状态 | archived | 活跃维护 | 活跃 | 活跃 | 稳定 |
差异化护城河
- 技术护城河:EXL2 格式 + 模拟退火优化器 + paged dedup 是 v2 时代最强的「消费卡 + 量化 + 多并发」组合
- 生态护城河:EXL2 模型在 HF 上的分发网络(turboderp / LoneStriker / bartowski 三家)已经形成事实标准
- 信任护城河:v3 是同一作者接棒,v2 用户的迁移路径有保障
竞争风险
- v3 自身的替代风险(v2 已 archived,新用户被引向 v3)
- llama.cpp 在 Apple Silicon 市场的绝对优势
- vLLM 在生产 serving 的进一步打磨
生态定位
介于「科研量化器」和「生产服务框架」之间的「本地 LLM 玩家级旗舰」——研究属性强(任意 bpw 混合),但发布形式比 TGI/vLLM 更轻量,是单卡消费级 GPU 上的「速度基线」。
套利机会分析
- 信息差: 4.5K stars + 89% 单人代码 + 1.4 年组织账号的组合,在量化推理这个 30K+ stars 的赛道里属于「作者已小有名气但大众认知度仍偏低」的位置——懂的人用 TabbyAPI/ExUI 都绕不开它,不懂的人可能直接上 llama.cpp/vLLM
- 技术借鉴: paged KV cache + 内容哈希 dedup 模式可直接迁移到任何 RAG / 多会话服务;compile-time kernel composition + runtime autotune 是高性能 GPU 库的通用范式;Hadamard 旋转 + 量化的思路正是 2024-2025 论文热点(QuaRot / SpinQuant / FlatQuant)
- 生态位: 填补了「消费级 GPU + 任意 bpw + 多并发 dedup」这个 llama.cpp 不够专业、vLLM 不够消费、AWQ/GPTQ 没有推理后端的三角空白
- 趋势判断: 增长稳定但已过巅峰(2024-10 起 commit 断崖),建议关注 v3(EXL3 + QTIP 路线)作为长期跟踪对象;v2 适合作为「v2→v3 治理样本」研究
风险与不足
- 维护已停摆:近 30/90 天 0 commits,新架构请求(
#749 Gemma3/#781 Qwen3)被引向 v3,issue 处理速度下降 - 平台单一:核心 CUDA 路径深度优化,ROCm 是「次等公民」(
#33 ROCM: Garbage output长期悬而未决),Apple Silicon / CPU 路径完全空白 - 测试覆盖基本:CUDA 端单元测试成本极高,主流推理库都靠 issue 反馈 + 手工验证而非 CI 覆盖;
tests/仅有少量小测试 + 跨框架 perplexity 对比,无自动化回归 - 架构代码债:
architecture.py用 50+ 个if arch_string == "..."块管理架构差异,加新架构需要改多处 - 量化求解慢:
doc/convert.md自承「the implementation is not very efficient」,12 轮完整前向 + SA 求解对大模型(405B 级别,见#565)是现实挑战 - 无 CHANGELOG / linter / formatter:变更历史在 GitHub Releases,无 flake8/black/ruff 配置
行动建议
- 如果你要用它: 已有 EXL2 模型在跑 → 继续用,关注 v3 迁移窗口;新项目建议直接上 v3。Apple Silicon 用户 → 选 llama.cpp;生产 serving → 选 vLLM
- 如果你要学它: 重点关注以下文件
exllamav2/conversion/quantize.py+optimize.py+qparams.py— 量化器全流程exllamav2/generator/dynamic.py+doc/dynamic.md— paged KV cache 设计(290 行设计稿,写得很透彻)exllamav2/exllamav2_ext/comp_units/+kernel_select.cu+q_gemm_autotune.cuh— 编译时 kernel 组合 + 运行时 autotuneexllamav2/architecture.py— 架构抽象模式exllamav2/hadamard/hadamard.py+doc/qcache_eval.md— Hadamard 旋转 + Q4 cache 实测
- 如果你要 fork 它: 风险较高(v3 已存在并活跃)。若仍想改进,建议方向:
- 给
architecture.py加一层 type-safe 的架构注册表(替代 if-else 链) - 把 SA 求解从 CPU 搬到 GPU(CUDA kernel 实现
sim_anneal) - 接入新的量化路线(FP8 cache / KIVI / KV 量化)的可插拔点
- ROCm 路径的 kernel 等价性测试
- 给
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | deepwiki.com/turboderp-org/exllamav2(2025-04 索引到 v0.2.8,覆盖 Configuration / Architecture / Generator / Quantization / CUDA Extensions / Build) |
| Zread.ai | 未收录 |
| 关联论文 | 无(exllamav2 是工程实现,未单独发表论文;EXL2 格式在 README 文档中有自述) |
| 在线 Demo | 无官方 Demo(依赖本地 GPU 推理,无 cloud playground) |
| 官方文档 | doc/dynamic.md(动态生成器设计稿,290 行)、doc/convert.md(量化参数详解,164 行)、doc/qcache_eval.md(Q4 vs FP8 实测对比,171 行)、doc/eval.md |
| 继任项目 | turboderp-org/exllamav3(EXL3 + QTIP,931 stars,活跃维护) |
| 集成生态 | TabbyAPI(OpenAI 兼容服务端)、text-generation-webui、ExUI(作者自研 Web UI)、SillyTavern、lollms-webui |
| 量化模型分发 | HuggingFace 上 LoneStriker / bartowski / turboderp 三家提供大量 EXL2 模型权重 |