8.8K stars、2 年 1765 次 commit:把 KV cache 抽成 KV「操作系统层」的 LMCache,怎么把 LLM 推理加速 8 倍
一句话总结
LMCache 把 LLM 推理时的 KV cache 从「一次性临时状态」抽成「可持久化、可跨引擎复用、可跨硬件传输」的 vendor-neutral 缓存层,自称为首个开源 Knowledge Delivery Network (KDN),通过多级 offload (CPU→SSD→Redis/Mooncake/S3/NIXL) 把 TTFT 最高压到 1/8、cost 最高压到 1/8。
值得关注的理由
- 生态定位关键——已被 vLLM / SGLang / NVIDIA Dynamo / TensorRT-LLM 四大 serving engine 集成,2025/10 加入 PyTorch Foundation + 同期商业化实体 Tensormesh 成立,正从「研究项目」走成「KV cache 操作系统层」。
- 学术工业双轮驱动——三篇顶会论文 (SIGCOMM CacheGen / EuroSys CacheBlend / LMCache tech report) 与代码同源演进,239 人贡献、Top1 只占 11% 是健康的开源治理结构 (UCSD/Chicago/UChicago/IBM/Bytedance/Tencent/Samsung)。
- 架构正在拐点上——2026/04 发布的分布式多进程 (MP) 模式从「单进程 vLLM 插件」升级为「独立 KV cache daemon」,配合 P2P multi-node CPU 共享 (2026/01 转生产) 和 30+ storage backend,把 KV cache 命运从推理引擎手里夺走。
项目展示
README 媒体
 — 类型: hero
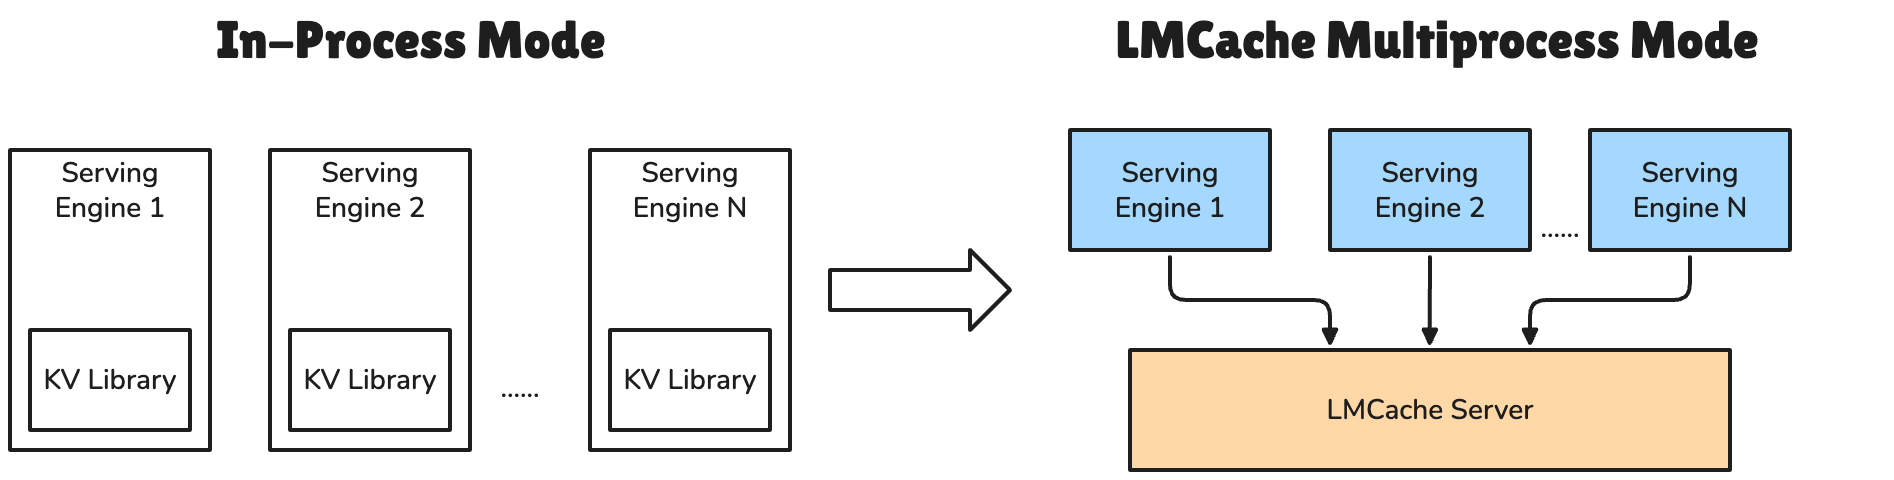 — 类型: architecture(部署模式图,engine-independent daemon 是核心叙事)
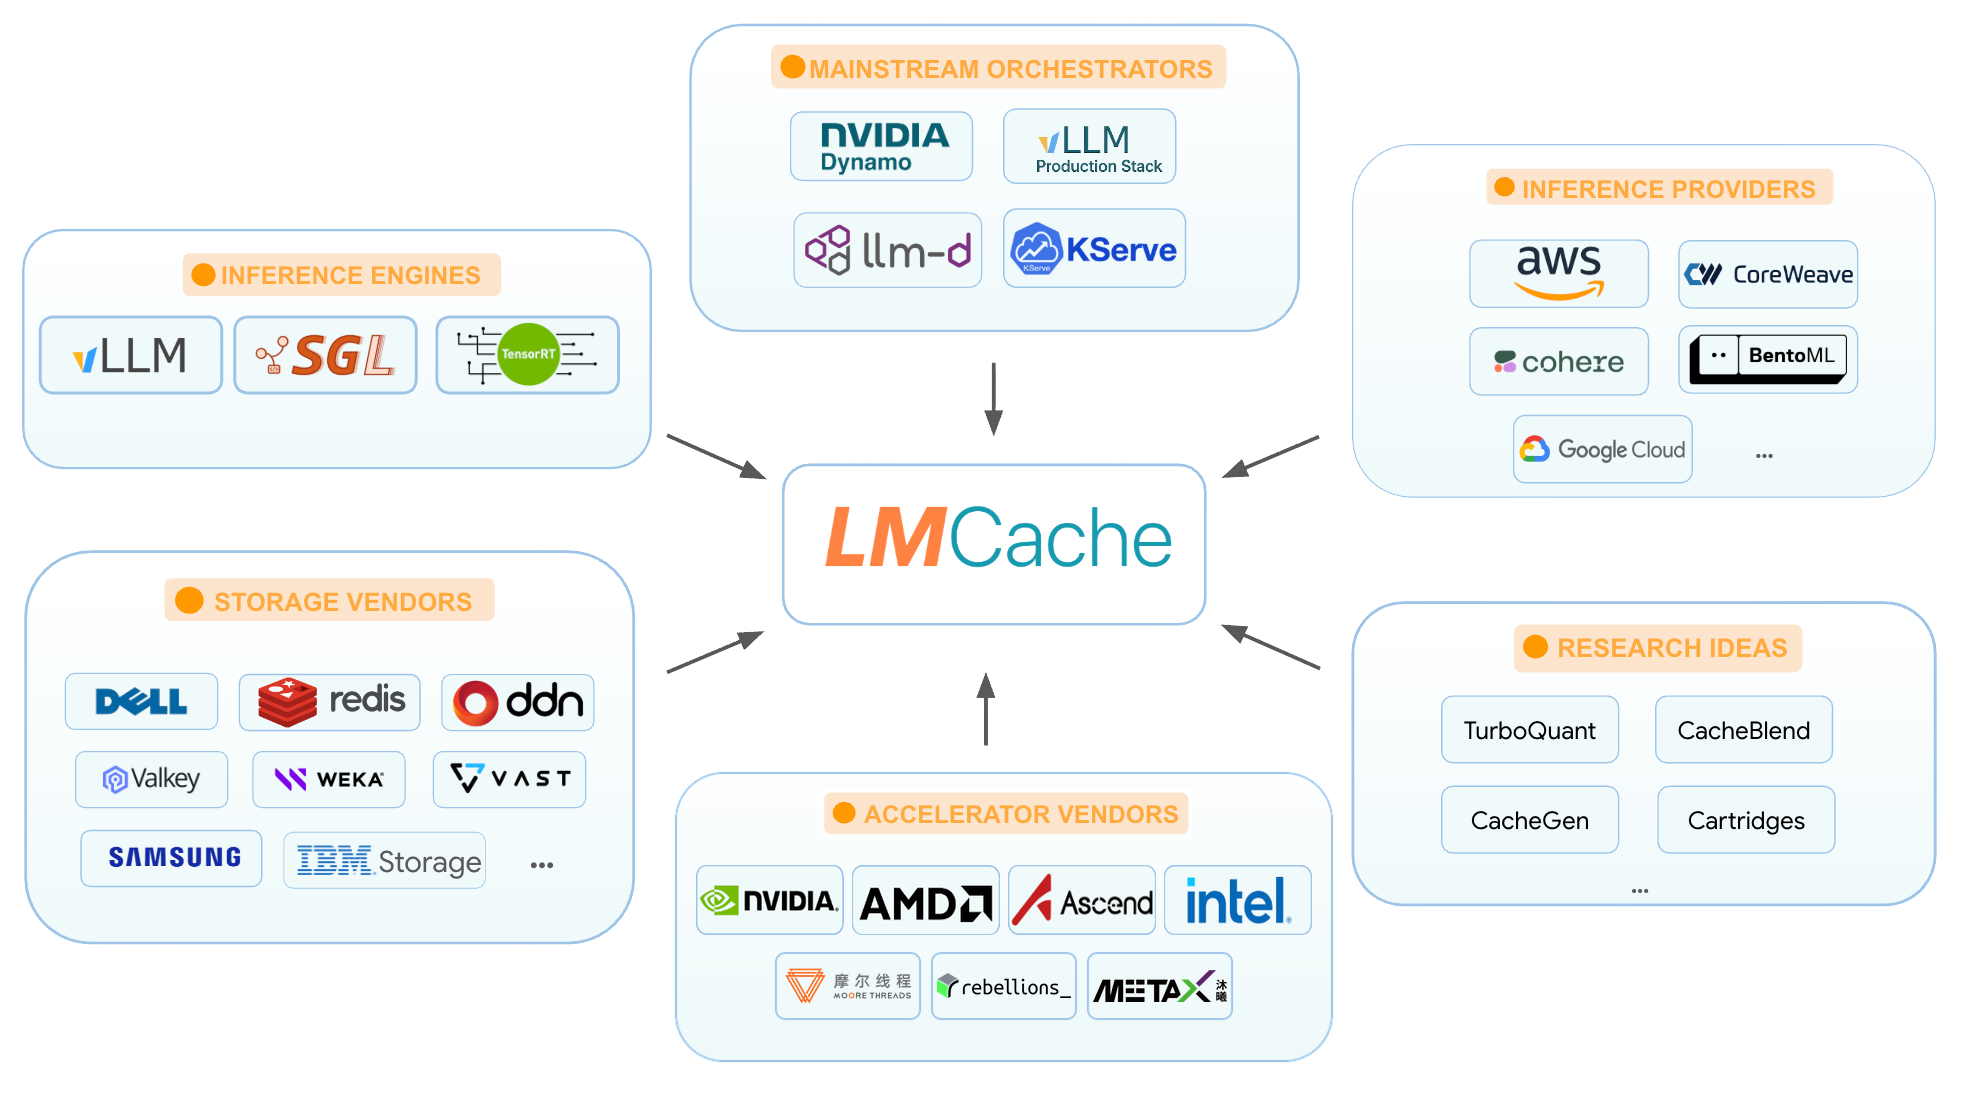 — 类型: architecture(vLLM/SGLang/Dynamo/TRT-LLM + Redis/S3/Mooncake/NIXL 等集成矩阵)
 — 类型: screenshot(合作伙伴矩阵:Cohere/CoreWeave/Redis/PyTorch Foundation 等)
官网媒体
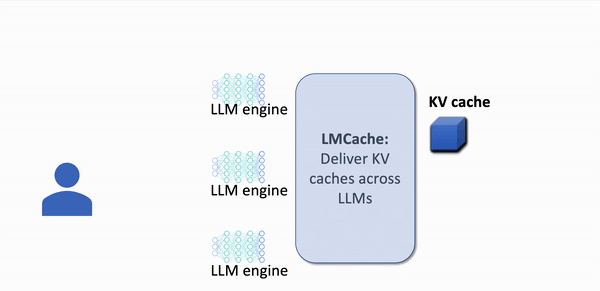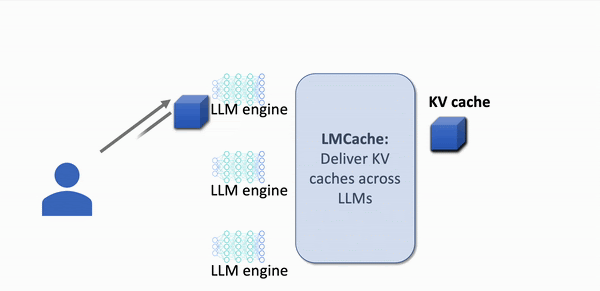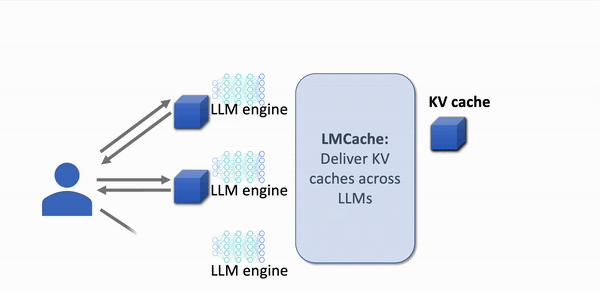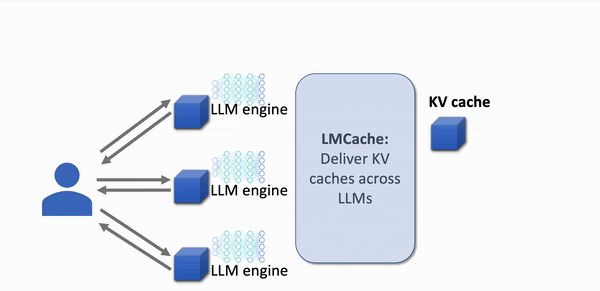 — 类型: demo(开启/关闭 LMCache 前后的 TTFT 对比 GIF)
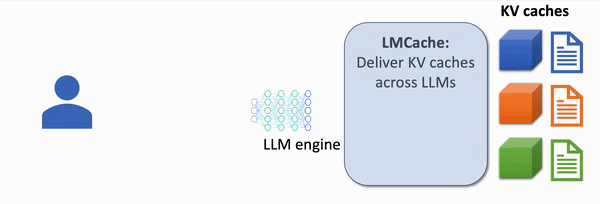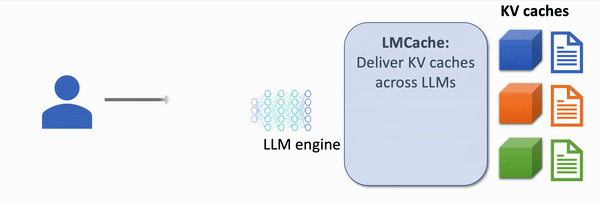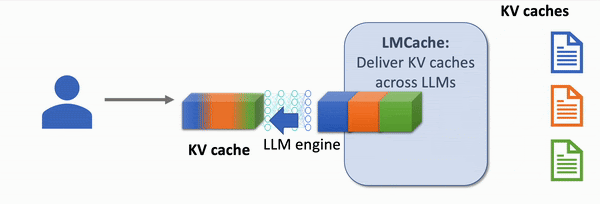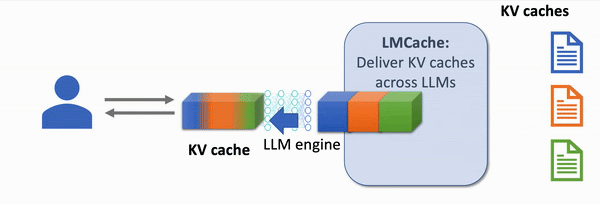 — 类型: demo(RAG 多文档复用 KV 的加速效果 GIF)
筛选说明
- 总共发现 8 个媒体元素,筛选后保留 6 个;排除了 4 个 badge/CI 状态图标。
- README 媒体均已校验 raw 路径存在 (verified=true);官网两张 GIF 是产品最强「before/after」演示。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/lmcache/lmcache |
| Star / Fork | 8,862 / 1,303 (Watcher: 45) |
| 代码行数 | 264,415 行 (Python 80.3% / RST 7.4% / YAML 3.4% / Go 3.0% / C++ 1.6% / Rust 0.9% / CUDA 1.2%) |
| 项目年龄 | 24.5 个月(2024-05-28 创建) |
| 开发阶段 | 密集开发(近 30 天 208 commit,近 90 天 479 commit,近 365 天 1,370 commit 占总量 78%) |
| 贡献模式 | 社区驱动(239 贡献者,Top1 只占 11%,Top5 合计 ~30%) |
| 热度定位 | 大众热门(LLM 推理栈 KV cache 垂直领域事实标准候选) |
| 质量评级 | 代码 优秀 / 文档 优秀 / 测试 充分(255 个 test_*.py + Buildkite K3s 集群) / CI 完善(22 个 GitHub Actions) |
| License | Apache 2.0 |
| 最新版本 | v0.4.7-cu129(共 46 个 tag,语义化版本 + CUDA 变体后缀) |
作者视角:为什么存在这个项目
创始人/作者背景
项目由 UCSD 苏研院 / Chicago 大学 / UChicago/IBM/Bytedance/Tencent/Samsung 的学术-工业混合团队孵化,核心贡献者来自 Yihua Cheng / Yuhan Liu / Jiayi Yao / Kuntai Du / Junchen Jiang 等人,把 SIGCOMM 2024 CacheGen 论文、EuroSys CacheBlend 论文一路工程化落地。GitHub 组织 lmcache 名下还有 19 个衍生仓(LMCache-Ascend、kvcache-view、lmcache_frontend、LMBenchmark、redis connector),呈现「研究→产品化」的完整生态布局。10 位 committer 来自工业界,CONTRIBUTING.md 明列「5 个重要 feature + 3 个月」准入门槛——这是有商业化野心的治理,不是论文刷一拨就走。
问题判断
- 业界缺生产级 KV cache 中间层:vLLM / SGLang / TGI / TensorRT-LLM 自带的 prefix cache 粒度粗、绑单进程 GPU 显存、跨引擎不通用;Mooncake 只做 transfer/commerce 层;Redis 缺 KV 语义;S3/Mooncake 各家协议互不兼容。业界没有把 KV cache 当作持久化、统一接口的「一等公民」来对待。
- 大厂已撞墙:Cohere × CoreWeave 在生产中明确反馈「GPU 显存 KV 容量是瓶颈」(2025/10/29 联合 blog),长上下文推理 + agentic 多轮下「重复 prefill」是隐性大成本。
- 时机刚好:2024 末–2025 LLM serving 走向 vLLM V1 / disaggregated prefill / NIXL 跨节点传输,正好需要外挂 KV 缓存层;LMCache 在 vLLM 生态成熟窗口期切入。
解法哲学
- Vendor-neutral 是头号信条——同一份 KV 在 vLLM / SGLang / TGI / TRT-LLM 之间可移植,绝不绑定单家 serving engine。这是与 vLLM 内建 prefix cache、Mooncake 闭源商业定位最大的差异。
- 分层多级存储 + 跨硬件适配——CPU RAM/SSD/Redis/S3/Mooncake/NIXL/GDS/MarU/Dax/BigTable 全部走统一
StorageBackendInterface+ Connector/SerDe 可插拔抽象;PD 分离、layerwise、P2P、CacheGen/CacheBlend 都是后插功能,核心引擎不感知。 - 不做的事——不重做模型 serving、不做模型并行、不做 tokenizer 调度;明确做的是「vLLM/SGLang 旁的 cache layer」。这种克制让 LMCache 能在不同推理引擎之间当「胶水」。
- 版本策略——v0.4.x 仍在 0.x 阶段快速迭代(46 个 tag / 24 月 ≈ 2 tag/月),tag 后缀
-cu129区分 CUDA 版本,反映「接口尚未稳定,论文先发,生态共建」的学术+工业混合开源路径。
战略意图
- 核心产品 + 基础设施双层定位——主仓是开源基础设施,围绕已衍生 LMCache-Ascend(昇腾适配)、LMBenchmark、kvcache-view、lmcache_frontend,加上 K8s operator(
operator/)管 daemon 生命周期。 - open-core 商业化——开源核心 + 商业化由 Tensormesh(2025/10 成立)兜底;同期加入 PyTorch Foundation(基金会托管 + 商业公司运营双轨)。
- 跨厂商业引擎解耦——战略上希望成为 KV cache 层的「Linux 内核式」事实标准,不被任何一家 serving engine 锁死。
官方文档/博客数据充分(lmcache.ai + blog.lmcache.ai + docs.lmcache.ai + 三篇论文 PDF/tech report 都已链接),本节判断有据可查。
核心价值提炼
创新之处
- Knowledge Delivery Network (KDN) 概念 + vendor-neutral 跨引擎 KV layer——业界首次把 KV cache 抽象成「可跨引擎/跨硬件/跨地域」的统一层,概念上类比 CDN for AI。(新颖度 4/5,实用性 5/5)
- Engine-independent daemon + no fate-sharing with engines——KV cache 不再随 vLLM worker 崩溃而丢失,独立进程管理;vLLM 重启后直接复用 CPU/Remote 上的 KV。(新颖度 4/5,实用性 5/5)
- CacheGen 流式 KV 压缩 + 论文级分层量化——SIGCOMM 2024 论文落地,3.5× 压缩比,模型分 K/V × 分层 bins 量化,跨 WAN 传输 KV 成为可能。(新颖度 4/5,实用性 4/5)
- CacheBlend 非前缀 KV 复用——突破 prefix caching 限制,任意位置 KV chunk 可复用,通过
blend_min_tokens/blend_recompute_ratios控制 quality-cost。(新颖度 5/5,实用性 4/5) - L1Manager TTL lock + L2 adapter 异步 push/pull 三 controller 分离——Store / Prefetch / Eviction 解耦,每对象带 TTLLock,L1 命中快路径不被 L2 阻塞。(新颖度 4/5,实用性 5/5)
- 多硬件抽象(CUDA/ROCm/XPU/Ascend/NPU)+ platform 探测——一次代码同时跑在 NVIDIA / AMD / Intel / 华为昇腾;pre-commit 硬禁直接引
torch.cuda/torch.xpu/torch.hpu。(新颖度 4/5,实用性 5/5) - StoragePluginInterface + Python entry_points 动态加载后端——第三方可通过 pip 包暴露
lmcache_storage_backendsentry point,主仓无需修改即可挂载新后端。(新颖度 3/5,实用性 5/5,可迁移性 5/5) - P2P multi-node CPU memory sharing——多节点 CPU 内存互享,2026/01 从实验转生产,论文 + 工业实现都在 LMCache 内。(新颖度 4/5,实用性 5/5)
可复用的模式与技巧
- 三层后端抽象 (Storage / Allocator / Plugin)——把「能不能存」与「能不能分配内存」分离,配合 Python entry_points 动态加载。任何多后端的可插拔存储系统都能套用。
- 多后端 fan-out + auto-promote write-back——写入按配置 fan-out 多后端;读非本地后端时自动写到 LocalCPU。任何多层缓存 (L1/L2/L3) 都适用。
- WeightedSemaphore 50% 上界防死锁——chunk 同构大小假设下,concurrent = total/2 保证无死锁 (
lmcache/v1/storage_backend/storage_manager.py:121-162)。适用任何同构对象池/内存池。 - 配置中心单点表 + 别名/弃用映射——
_CONFIG_DEFINITIONS+_CONFIG_ALIASES+_DEPRECATED_CONFIGS三表协同。适合任何 0.x → 1.x 演进的 fast-evolving 项目配置层。 - ZMQ + msgspec + pluggable EngineModule——消息队列 + 严格类型编解码 + 协议层模块化 (
multiprocess/mq.py:77-100)。任何「把同步代码拆成 IPC 进程」的场景都适用。 - 独立 daemon + 引擎无 fate-sharing——把有状态部分从主进程剥离,主进程崩溃时状态仍可恢复。任何希望「无状态」的服务都适用(数据库连接池、session 存储)。
- HealthMonitor + BypassedBackends 软降级——单一后端健康检查失败时跳过该后端,整体继续工作 (
storage_manager._bypassed_backends)。任何多后端降级容错场景都适用。
关键设计决策
- 决策:三层抽象
StorageBackendInterface+AllocatorBackendInterface+StoragePluginInterface- 问题:30+ 后端需要零侵入接入,且 Storage Manager 选哪个后端「实际分配内存」需要区分
- 方案:
abstract_backend.py:27-323定义同步/异步 put/get/contains/pin/unpin/remove + 取消请求的细粒度接口;AllocatorBackendInterface在此基础上加initialize_allocator/allocate/batched_allocate/calculate_chunk_budget;StoragePluginInterface走entry_points动态加载 - Trade-off:多一层抽象带来 13 个 abstract method 的样板代码;换来任何后端既能「储存」也能「分配」的正交组合(PD backend 同时做存储+分配,Remote backend 只做存储)
- 可迁移性:高
- 决策:CacheGen 把 KV cache 当作「待流式压缩的 blob」——分 K/V 通道 × 分层 bins 量化
- 问题:KV cache 太大,无法直接网络传输
- 方案:
naive_serde/cachegen_basics.py:26-133CacheGenConfig.from_model_name按模型深度给 K 和 V 各分配分层 bins(Llama-8B: K 前 10 层 32 bins、后 22 层 16 bins;V 前 2 层 32 bins、后 30 层 16 bins);cachegen_encoder.py:42-84把 tensor 视作[nlayers, 2, ntokens, nheads, headsize]走算术编码 + 拼接 - Trade-off:模型 → bins 的硬编码白名单 + fallback(从 HF AutoConfig 读
num_hidden_layers);换来 3.5× 压缩比和可调 quality-cost 平衡 - 可迁移性:中
- 决策:MP 模式下基于 ZMQ + msgspec + pluggable EngineModule 的「消息队列 + 模块化处理器」
- 问题:单进程 → 分布式时需要把 GPU 侧的 lookup/transfer 拆成独立 daemon,既要低延迟又要支持不同传输模式(gpu / non_gpu / blend)
- 方案:
multiprocess/server.py:55-99MPCacheEngine是薄 compositor,持有MPCacheEngineContext+EngineModule列表;multiprocess/mq.py:77-100msgspec.msgpack严格类型编解码 + 自定义 CudaIPCWrapper 编码器走 zero-copy;engine_module.py:43-65用Protocol声明模块契约 - Trade-off:msgspec 的严格类型校验对 bool/int 跨界要 coerce(ZMQ 在 Linux 之外表现一般);换来 worker 模块独立替换 + 跨语言(CudaIPC 走 rust)互通
- 可迁移性:高
竞品格局与定位
竞品对比矩阵
| 维度 | LMCache | vLLM (上游引擎) | SGLang (兄弟项目) | Mooncake | TensorRT-LLM |
|---|---|---|---|---|---|
| 跨引擎 KV 复用 | ✅ vendor-neutral 中间层 | ❌ 单引擎内 prefix cache | ❌ 单引擎 Radix tree | ❌ 仅做 transfer | ❌ 闭源引擎内 |
| 跨硬件 (CUDA/ROCm/XPU/Ascend) | ✅ 全适配 + plugin | ⚠️ 主 CUDA,ROCm 部分 | ⚠️ 主 CUDA | N/A | ⚠️ 仅 NVIDIA |
| 多级存储 (CPU/SSD/Remote) | ✅ 30+ backend | ❌ 仅 GPU + CPU | ❌ 仅 GPU | ⚠️ transfer layer | ⚠️ 内建但封闭 |
| KV 持久化 / 跨实例共享 | ✅ daemon 独立 + P2P | ❌ 进程绑定 | ❌ 进程绑定 | ✅ transfer 强 | ❌ 引擎绑定 |
| 非前缀 KV 复用 (CacheBlend) | ✅ | ❌ | ❌ | ❌ | ❌ |
| KV 流式压缩 (CacheGen) | ✅ 3.5× 压缩 | ❌ | ❌ | ❌ | ⚠️ 商业 quantization |
| 开源协议 + 商业化路径 | Apache 2.0 + Tensormesh | Apache 2.0 | Apache 2.0 | Apache 2.0 | 闭源商业 |
| Stars | 8.8K | 82.7K | ~15K | ~2K | ~11K |
差异化护城河
- 技术护城河:KDN 概念 + vendor-neutral + 三层后端抽象 + 三篇顶会论文 (SIGCOMM/EuroSys/NSDI) 背书 + 多硬件适配——这是单家 serving engine 难以一年内复制的。
- 生态护城河:vLLM/SGLang/TRT-LLM 三大 serving engine 全适配 + 30+ storage backend(Redis/Valkey/S3/Mooncake/NIXL/GDS/HF3FS/BigTable/EIC/SageMaker/Mock/FS/LM/Audit/…) + NVIDIA Dynamo 集成 + PyTorch Foundation 托管 + Cohere/CoreWeave/Redis 联合品牌。
- 信任护城河:学术+工业双轮驱动(UCSD/Chicago + UChicago/IBM/Bytedance/Tencent/Samsung),三篇论文与代码同源演进,239 人社区治理,Apache 2.0 + 商业公司兜底。
竞争风险
- 最大风险:vLLM 1.x 持续内建 prefix cache + 异构硬件能力(vLLM V1 已支持 multimodal),逐步蚕食 LMCache 的「跨引擎」叙事。如果 vLLM 决定自己内建多级 offload,LMCache 的差异化会弱化为「L2/Remote 适配器集合」。
- 次要风险:SGLang RadixAttention 在单进程高 QPS 场景下极简高效,如果用户不上 multi-node / multi-engine,会优先选内建而非外挂。
- 潜在机会:vLLM 团队未必愿意背上 KV cache 持久化/压缩/跨引擎的复杂度包袱,长期可能更愿意让 LMCache 当「KDN 中间层」——这也是 LMCache 战略上争取的「Linux 内核之于发行版」位置。
生态定位
在整个 LLM 推理栈中,serving engine (vLLM/SGLang/TRT-LLM) 在上、模型在更上,LMCache 走 vendor-neutral 路线占住「KV cache 操作系统层」,类似 Linux Kernel 之于发行版——上层随便换(引擎/模型),下层随便换(硬件/存储),KV cache 始终在。
套利机会分析
- 信息差:8.8K stars + 三大 serving engine 集成 + PyTorch Foundation 托管 + NVIDIA Dynamo 集成——「已经被生态接纳,但中文圈独立分析极少」。相比 vLLM 本体(82.7K),LMCache 仍处「垂直领域准事实标准」阶段,适合长尾读者了解。
- 技术借鉴:三层后端抽象 + WeightedSemaphore 防死锁 + ZMQ+msgspec 进程拆分 + 配置中心单点表 + 独立 daemon 解耦 fate-sharing——这五个模式任何做多层缓存/分布式中间件的团队都能直接套。
- 生态位:填补了「KV cache 应当是跨引擎可移植层」的空白——vLLM/SGLang/TRT-LLM 都在做引擎,但 KV cache 这层是 LMCache 第一次用「vendor-neutral 中间层」的方式把它抬出来。
- 趋势判断:2025-08 才 5K stars,2026-06 已 8.8K(一年 +77%);同期从「vLLM 插件」升级到「独立 MP 模式 + PyTorch Foundation + NVIDIA Dynamo」——绝对处于增长期且生态绑定加速,符合 LLM 推理栈长上下文 + agentic 的趋势。
风险与不足
- 0.x API 未稳定:v0.4.7 仍在 0.x,
_CONFIG_ALIASES+_DEPRECATED_CONFIGS已经在做兼容层——生产用户被改名折腾过几次(参考enable_xpyd→enable_pd、nixl_peer_host→pd_peer_host)。1.0 之前的 API 风险是真实存在的。 - commit 集中度 Top1 只 11% 但 Top10 已 ~64%:核心维护者离开会留下大坑;UChicago/IBM/Bytedance/Tencent/Samsung 10 位 committer 看似多,但商业公司调整团队会直接影响项目。
- 测试在 K3s 集群跑(Buildkite):意味着 CI 复杂度高,新贡献者本地不容易复现完整集成测试,门槛劝退潜在 contributor。
- vLLM V1 紧耦合绑定:
lmcache/integration/vllm/vllm_v1_adapter.py单文件 148 次修改(整个仓库修改最多),意味着如果 vLLM 改 KVConnectorBase 协议,LMCache 必须跟改——长期看 vLLM 是 LMCache 的「最重要又最不可控」依赖。 - 「独立 daemon」是双刃剑:好处是 no fate-sharing,坏处是 K8s operator 要管两份生命周期,部署复杂度上升一个量级。
- 国内/中文圈分析稀缺:本文档可能是第一批把 LMCache 架构讲透的中文深度分析——这既是机会(读者稀缺),也说明项目在中文社区认知度还在建设。
行动建议
如果你要用它
- 长上下文 + agentic 多轮 / RAG 场景,首选 LMCache——尤其是 vLLM V1 / SGLang + Redis/Mooncake/NIXL 已部署的团队。官方 deployment docs + k8s operator 是部署入口。
- 单进程高 QPS + 短上下文,优先 SGLang 内建 RadixAttention——LMCache 的多级 offload 价值发挥不出来。
- 强 NVIDIA 单机极致性能,优先 TensorRT-LLM——LMCache 在 NVIDIA 单卡上不占性能优势,只在跨引擎/跨硬件/跨实例场景下值得用。
- 生产前必看:2026/04 MP 模式刚发布,稳定性待验证;先用单进程 vLLM V1 适配器跑通,再考虑升 MP。
如果你要学它
- 重点关注文件(按「改得最频繁 = 真正核心」排序):
lmcache/integration/vllm/vllm_v1_adapter.py(148 次)——vLLM V1 适配器,看如何跟随上游 API 演进lmcache/v1/cache_engine.py(123 次)——核心调度lmcache/v1/multiprocess/server.py(79 次)——MP 模式架构lmcache/v1/memory_management.py(71 次)——KV 显存管理灵魂lmcache/v1/storage_backend/abstract_backend.py——三层后端抽象的范本lmcache/v1/distributed/storage_manager.py——L1Manager + 三 controller 分离的范本lmcache/v1/storage_backend/naive_serde/cachegen_basics.py——CacheGen 分层量化
- 重点关注模式:三层后端抽象 / WeightedSemaphore / ZMQ+msgspec 拆分 / 配置中心单点表 / 独立 daemon 解耦 fate-sharing——这五个模式适合任何做多层缓存/分布式中间件的工程师学。
- 建议路径:先读 README → docs/source/architecture.rst → RFC #3262 (MP) → RFC #1826 (Agentic) → 看 CacheGen/CacheBlend 论文 → 跑 examples/disagg_prefill_mp。
如果你要 fork 它
- 改进方向:
- 加更多 quantization backend(INT4/AWQ/GPTQ 与 CacheGen 的整合)
- 国产硬件后端(寒武纪 / 海光 DCU / 摩尔线程 MUSA)——目前 LMCache 只到昇腾 NPU
- 加 agentic workload tracing(对应 RFC #1826 的 roadmap 方向)
- 把 WeightedSemaphore 抽象成可复用 library
- 多语言 SDK(目前只有 Python,Rust/Go 客户端可以从 IPC 层延伸)
- 不建议 fork 的方向:再做一个 vendor-neutral KV cache 中间层——LMCache 已占住位置,差异化护城河在生态不在技术。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/lmcache/lmcache |
| Zread.ai | 未收录(被 Cloudflare 拦截) |
| 关联论文 | LMCache tech report (2025) · CacheGen: KV Cache Compression and Streaming (SIGCOMM 2024, arXiv:2310.07240) · CacheBlend: Fast LLM Serving for RAG with Cached Knowledge Fusion (EuroSys 2025, arXiv:2405.16444) |
| 在线 Demo | 无在线 playground(README 未提供;官网有两张 before/after GIF 可视化效果) |
| 官方文档 | docs.lmcache.ai · blog.lmcache.ai |
| PyPI | pypi.org/project/lmcache |
| Roadmap | Issue #2923 |