MiniMind 深度分析报告
一句话总结
用 3 块钱 + 2 小时从零训练一个 26M 参数的 GPT——目前最完整的中文 LLM 全流程教学项目,覆盖从 Tokenizer 到 RLHF 的每一步。
值得关注的理由
- LLM 教学的”大道至简”标杆:41.8K stars,将 GPT 训练全流程(Pretrain→SFT→LoRA→DPO→PPO/GRPO→蒸馏)压缩到 3,170 行 Python 代码,所有核心算法从零用 PyTorch 原生实现,不依赖第三方抽象接口
- 极致的可及性:26M 参数(GPT-3 的 1/7000),单张 3090 即可在 2 小时内完成预训练,服务器租用成本仅 3 元人民币
- 完整的生态兼容:同时支持 llama.cpp、vllm、ollama 推理引擎和 Llama-Factory 训练框架,还复现了 DeepSeek-R1 推理模型
项目展示
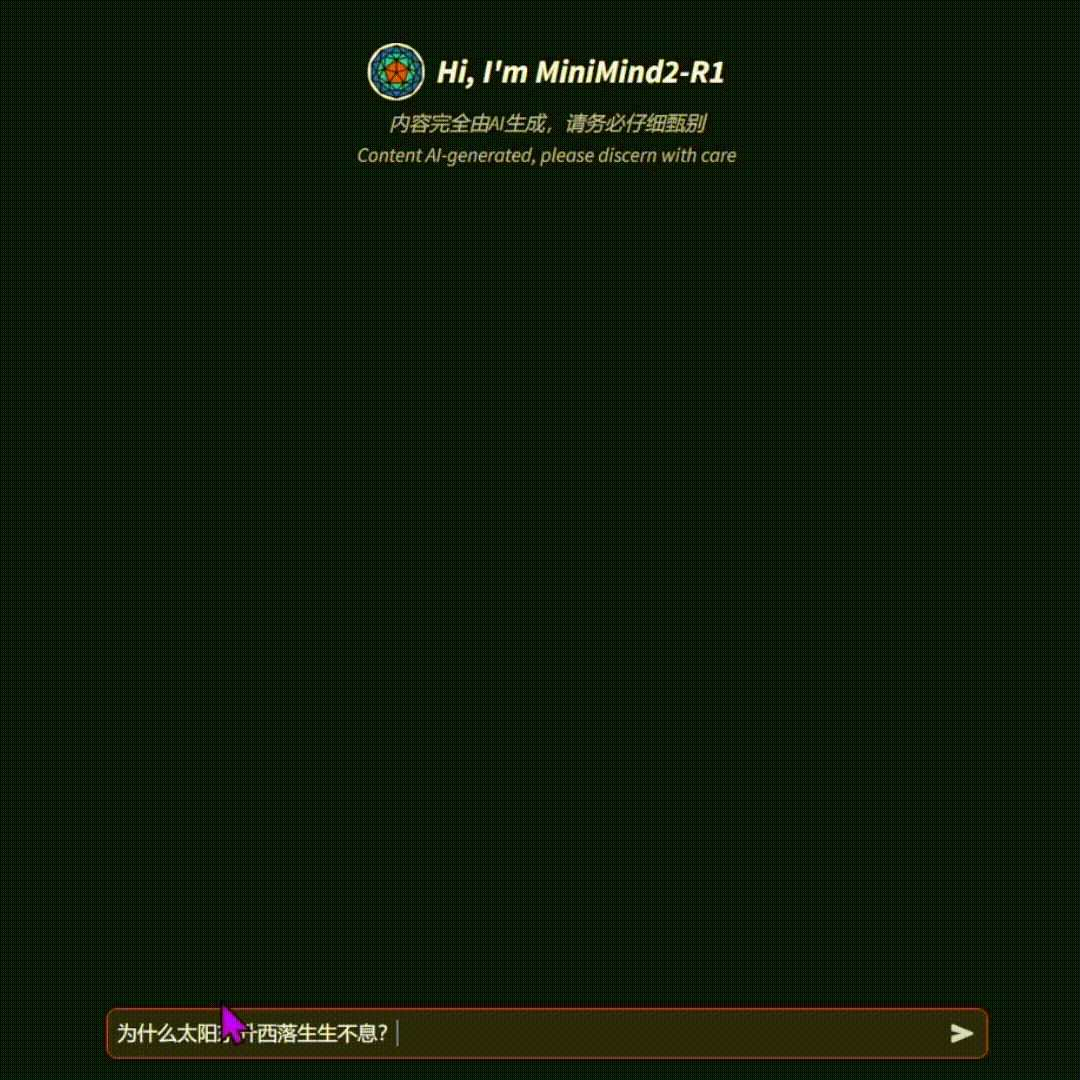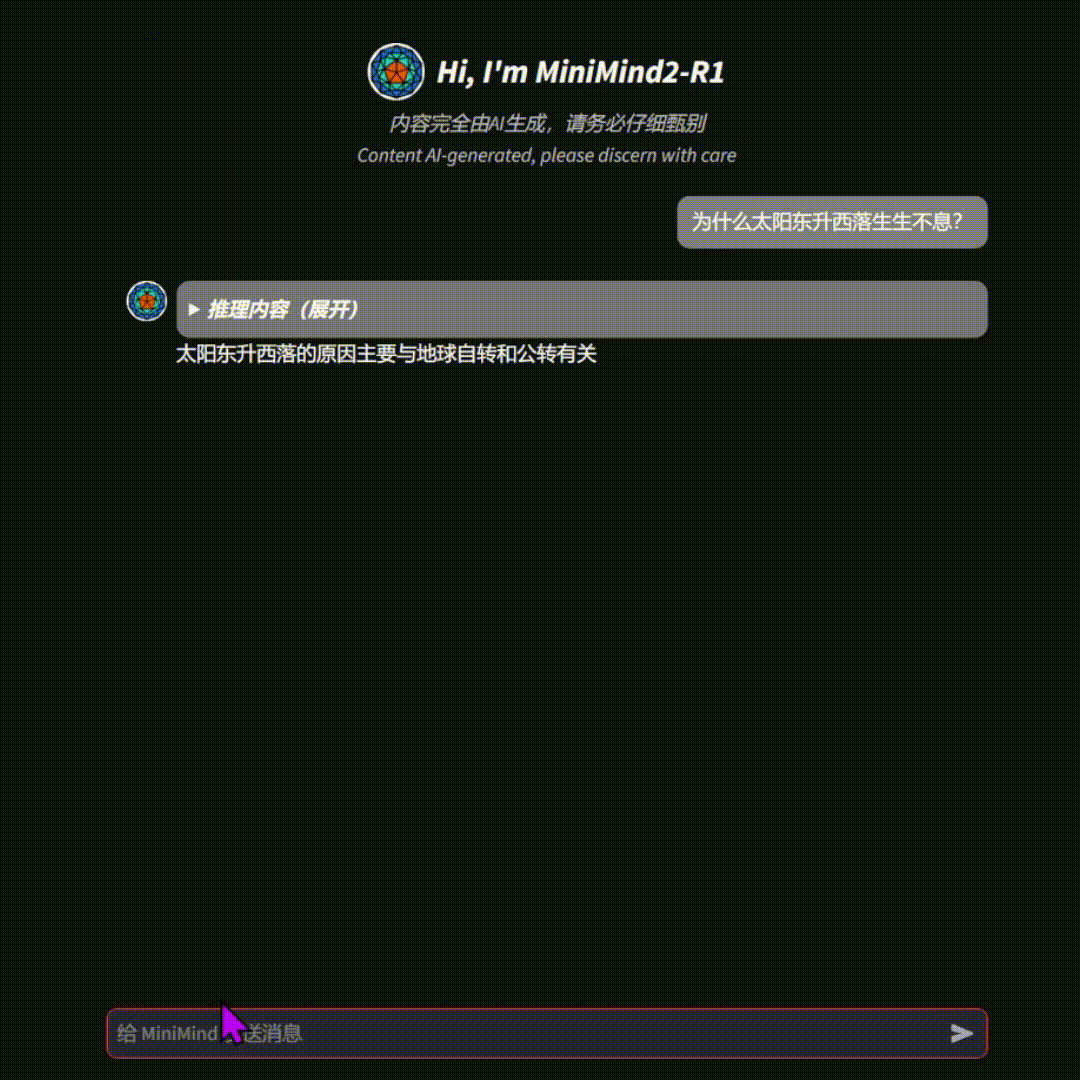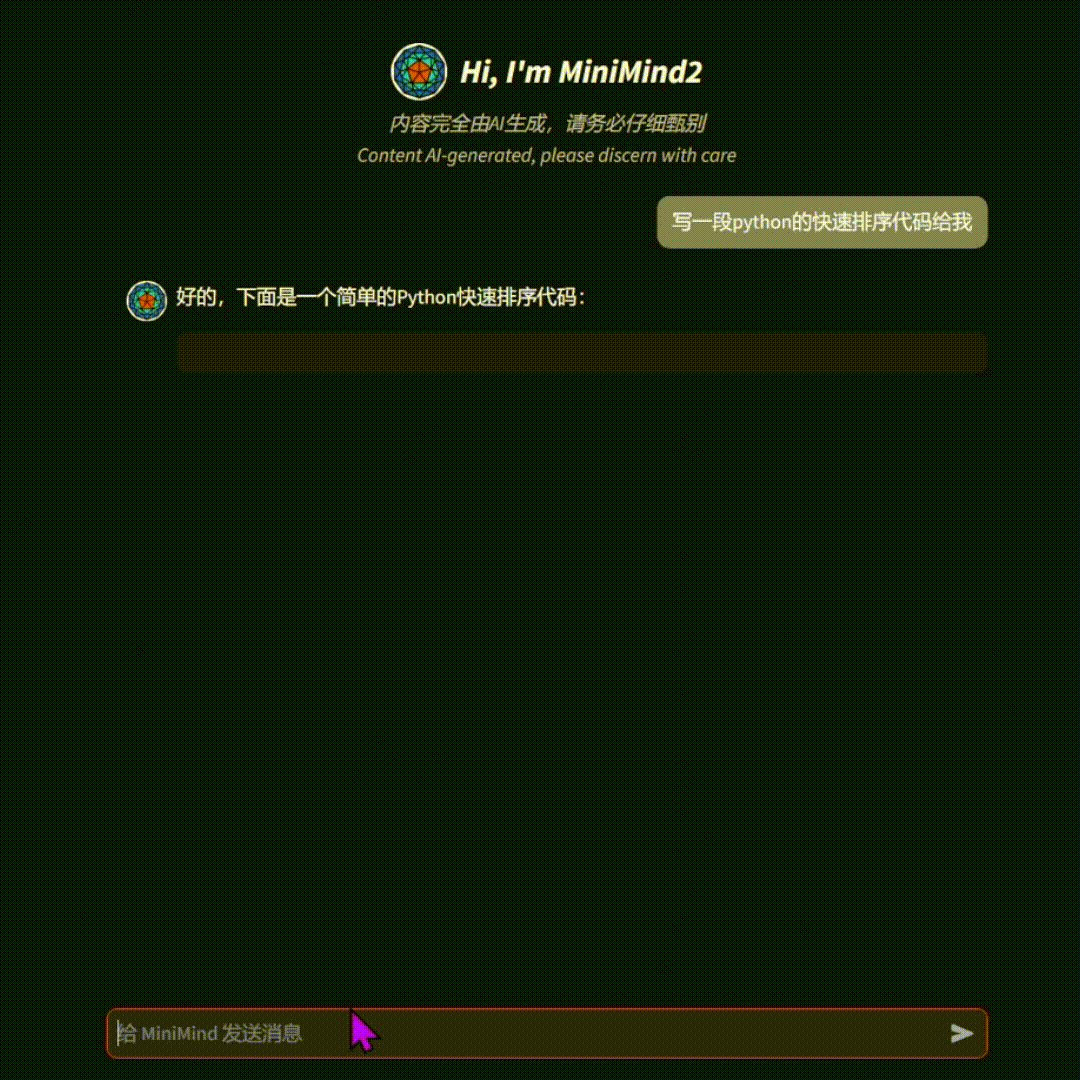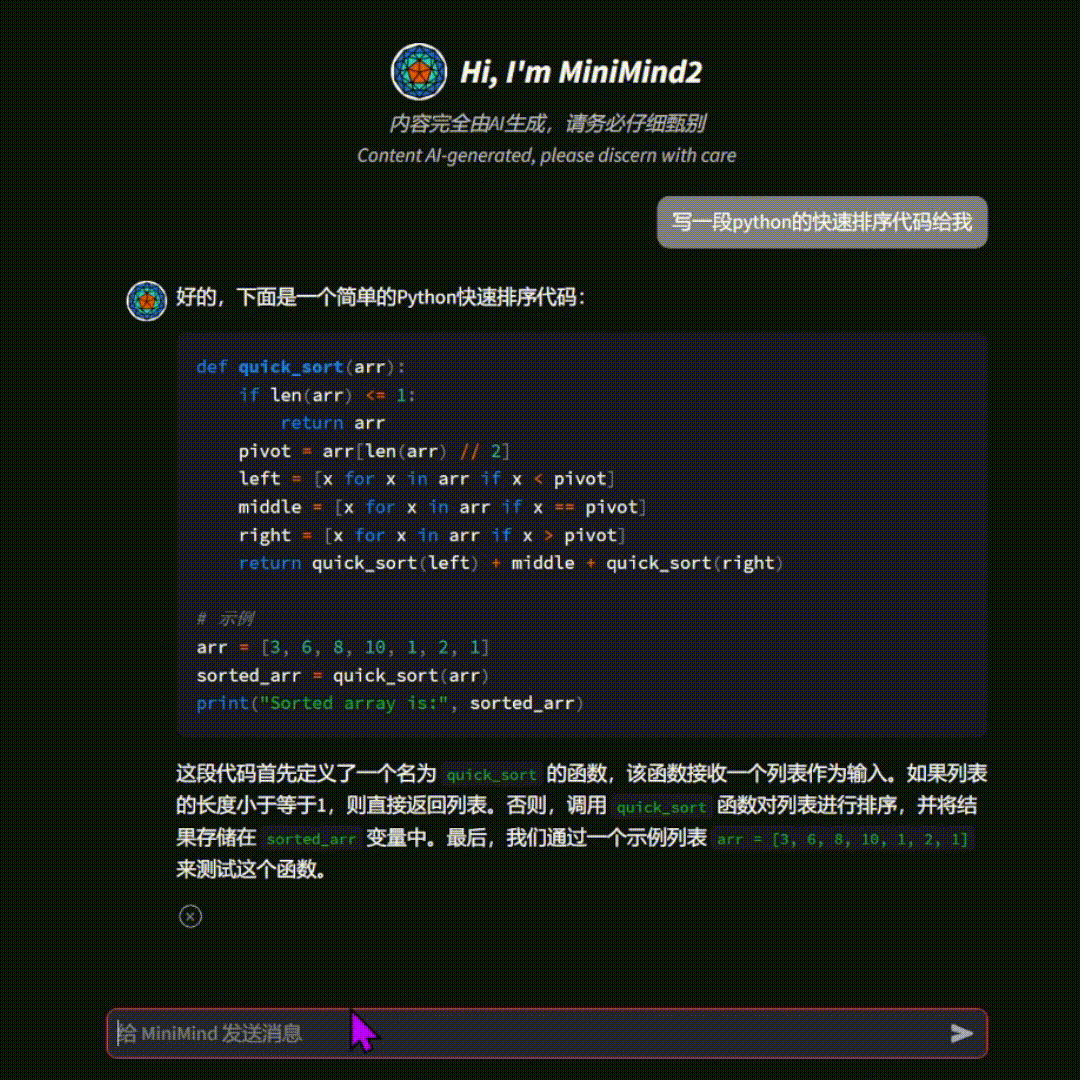
MiniMind 对话演示——26M 参数即可流畅对话
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/jingyaogong/minimind |
| Star / Fork | 41,782 / 5,039 |
| 代码行数 | 3,170 行 Python(+ 31K 行 JSON 配置/数据) |
| 项目年龄 | 20 个月(2024-07-27 创建) |
| 开发阶段 | 活跃迭代(v1→v2,持续添加新训练方法) |
| 贡献模式 | 独立开发(jingyaogong 贡献 299/312 commits,95.8%) |
| 热度定位 | 大众热门(41.8K stars,中文 LLM 教学类第一) |
| 质量评级 | 代码[良好] 文档[优秀] 测试[基本] |
作者视角:为什么存在这个项目
创始人/作者背景
jingyaogong,中国开发者,独立维护此项目。299 次提交占总量 95.8%,是典型的单人教学型开源项目。同时维护 minimind-v(视觉多模态版本)。模型和数据集发布在 HuggingFace 和 ModelScope 上。
问题判断
作者看到了两个关键问题:
- LLM 的”黑盒子”困境:99% 的学习者只能用 LoRA 微调现有模型,无法理解底层训练过程——“教牛顿用智能手机,却完全偏离了理解物理本质的初衷”
- 教育市场的劣币驱逐良币:互联网充斥付费课程和营销号,以”漏洞百出、一知半解的内容推销 AI 教程”
解法哲学
- “用乐高拼飞机,比坐头等舱更兴奋”:从零实现每一行代码,而非调用高度封装的接口
- 极致压缩:26M 参数、3 块钱成本、2 小时训练——将门槛降到最低
- 全流程覆盖:从 Tokenizer 训练到 RLHF(PPO/GRPO/SPO),每个阶段都有可运行的代码
- 生态兼容:虽然从零实现,但同时兼容 transformers/trl/peft 等主流框架,以及 llama.cpp/vllm/ollama 推理引擎
战略意图
纯教育公益项目,Apache-2.0 许可证,无商业化意图。通过 HuggingFace/ModelScope 发布预训练模型和数据集,建立中文 LLM 教学社区影响力。
核心价值提炼
创新之处
-
LLM 全流程极简复现(3,170 行代码)
- 新颖度: 4/5 | 实用性: 5/5 | 可迁移性: 5/5
- 在一个仓库中覆盖 Tokenizer→Pretrain→SFT→LoRA→DPO→PPO/GRPO/SPO→蒸馏的完整流程,所有核心算法从零实现
- 对 LLM 入门学习者价值极高
-
共享混合专家(MoE)的教学级实现
- 新颖度: 3/5 | 实用性: 4/5 | 可迁移性: 4/5
- 在 26M 参数级别实现了 DeepSeek 风格的共享专家 MoE(4 路由专家 + 1 共享专家),含辅助负载均衡损失
- 可能是最小的可运行 MoE 实现
-
DeepSeek-R1 推理模型复现(MiniMind-Reason)
- 新颖度: 3/5 | 实用性: 4/5 | 可迁移性: 3/5
- 在极小参数规模上复现了推理链蒸馏和 RLAIF 训练,支持可选思考链(Adaptive Thinking)
-
YaRN 长文本外推
- 新颖度: 2/5 | 实用性: 4/5 | 可迁移性: 4/5
- 基于 YaRN 算法实现 RoPE 位置编码的长文本外推,从 2048 扩展到 32768 token
可复用的模式与技巧
- MiniMindConfig 类设计:继承 PretrainedConfig,通过一个统一配置类管理 Dense 和 MoE 两种模型架构,use_moe 开关切换
- GQA(Grouped Query Attention)实现:num_key_value_heads=2(8 个注意力头共享 2 组 KV),减少内存占用的标准技巧
- 训练数据全开源:预训练、SFT、DPO、RLAIF 各阶段数据集均开源,含清洗和去重流程
关键设计决策
-
26M 参数 + 6400 词表
- 问题:如何让个人 GPU 能跑完整训练
- 方案:8 层 Transformer、512 维隐藏层、8 头注意力、6400 词表(极小)
- Trade-off:模型能力有限(无法处理复杂推理),但训练成本极低(2 小时 / 3 元)
-
兼容 transformers 但核心从零实现
- 问题:教学目的要求理解底层,但又需要生态兼容性
- 方案:核心训练代码从零 PyTorch 实现,但模型类继承 PretrainedConfig/PreTrainedModel
- Trade-off:代码量增加,但同时获得了教学价值和生态兼容性
竞品格局与定位
竞品对比矩阵
| 维度 | MiniMind | karpathy/nanoGPT | hkproj/pytorch-llama | tatsu-lab/stanford_alpaca |
|---|---|---|---|---|
| Stars | 41.8K | 38K | 6K | 29K |
| 定位 | 中文全流程教学 | 极简 GPT 训练 | LLaMA 复现 | 指令微调 |
| 覆盖阶段 | Tokenizer→RLHF 全流程 | 仅 Pretrain | 仅模型结构 | 仅 SFT |
| MoE 支持 | 有 | 无 | 无 | 无 |
| RLHF | PPO/GRPO/SPO/DPO | 无 | 无 | 无 |
| 语言 | 中文为主 | 英文 | 英文 | 英文 |
| 推理引擎兼容 | llama.cpp/vllm/ollama | 无 | 无 | 无 |
差异化护城河
- 中文 LLM 教学的绝对领先者:41.8K stars 远超同类中文项目
- 全流程覆盖:从 Tokenizer 到 RLHF 的每个阶段都有可运行代码,竞品大多只覆盖部分环节
- 极致低成本:3 块钱 + 2 小时的承诺形成了强大的营销叙事
竞争风险
- karpathy/nanoGPT 在英文社区影响力更大,如果 karpathy 推出全流程版本可能构成威胁
- 大厂(如 DeepSeek)可能推出官方教学项目
生态定位
在 LLM 教育生态中扮演”从零到一的入门教科书”角色,填补了中文社区”完整 LLM 训练全流程教学”的空白。
套利机会分析
- 信息差: 低。41.8K stars 已广为人知,在中文 AI 社区几乎无人不知
- 技术借鉴: MoE 共享专家实现、GRPO/SPO 强化学习算法的教学级代码、YaRN 长文本外推——都是高质量的学习资源
- 生态位: 中文 LLM 入门教学的事实标准,相当于英文社区的 nanoGPT 但覆盖面更广
- 趋势判断: 持续增长。随着 AI 教育需求扩大和新训练方法不断出现(如 GRPO),项目有持续更新的空间
风险与不足
- 单人项目:jingyaogong 贡献 95.8% 的提交,bus factor 极高
- 模型能力有限:26M 参数的模型只能做简单对话,无法处理真实场景的复杂任务
- 代码注释风格不一致:部分代码有详细注释,部分缺失
- 测试覆盖不足:无自动化测试,依赖手动验证
- 最近更新放缓:最近推送是 2026-02-06,距今约 6 周未更新
行动建议
- 如果你要用它: 作为学习 LLM 全流程的教材使用,跟着代码逐步训练。不要期望 26M 模型有实用价值
- 如果你要学它: 建议按顺序阅读:
model/model_minimind.py(模型结构)→ 预训练脚本 → SFT 脚本 → DPO/PPO/GRPO 脚本。配合 README 中的原理说明 - 如果你要 fork 它: 改进方向——添加自动化测试、支持更多语言(日/韩)、增加 benchmark 自动评测流程、构建交互式教学 notebook
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/jingyaogong/minimind |
| Zread.ai | 未收录 |
| 关联论文 | 无(教学项目,非论文配套) |
| 在线 Demo | 推理模型 / 常规模型 |
| HuggingFace | MiniMind Collection |
| 视频介绍 | Bilibili |
| 官网 | jingyaogong.github.io/minimind |
相关报告
万星小镇的 1KB 玄学:a16z × Convex 的 AI Town 凭什么让 8 个 NPC 自己聊出性格
⭐ 10.0k TypeScript AI AgentLLM 框架LLM 推理 已发布
AgentScope
⭐ 18.3k Python AI AgentLLM 框架LLM 训练
Airweave
⭐ 6.0k Python AI AgentLLM 推理开发者工具 已发布
GitHub 推荐:6 个月 35.8K stars:llmfit 用 51 万行 JSON 重写本地 LLM 选型
⭐ 35.8k Rust LLM 推理基础模型IoT / 硬件 已发布
GitHub 推荐:5 个月 4.9K stars:MIT 博士用 REPL 替代上下文窗口,RLM 凭什么重新定义 LM 推理
⭐ 4.9k Python AI Agent基础模型 已发布
GitHub推荐:阿里通义 19.5K stars 旗舰:Tongyi DeepResearch 怎么用 3.3B 激活参数做开源 Deep Research Agent
⭐ 19.5k Python AI AgentLLM 训练基础模型 已发布