TinyZero 深度分析报告
一句话总结
用 $30 复现 DeepSeek R1-Zero 核心推理能力的最小化实验——证明了”小模型通过纯 RL 训练可自发涌现推理能力”这一关键科学发现,是 LLM+RL 领域的标志性教学案例。
值得关注的理由
- 历史意义:时间线上最早的 R1-Zero 复现(论文发布 4 天后),以 $30 成本验证了”Aha Moment”可在 3B 模型上涌现,引发了整个 R1 复现生态
- 教学价值极高:仅 ~500 行增量代码(在 veRL 框架上),清晰展示了 RL 推理训练的完整流程——奖励函数设计、Prompt 引导、GRPO 算法选择
- 实验设计方法论:Countdown 任务的选择和分层奖励(0/0.1/1.0)的设计,是”最小可验证实验”方法论的教科书案例
项目展示
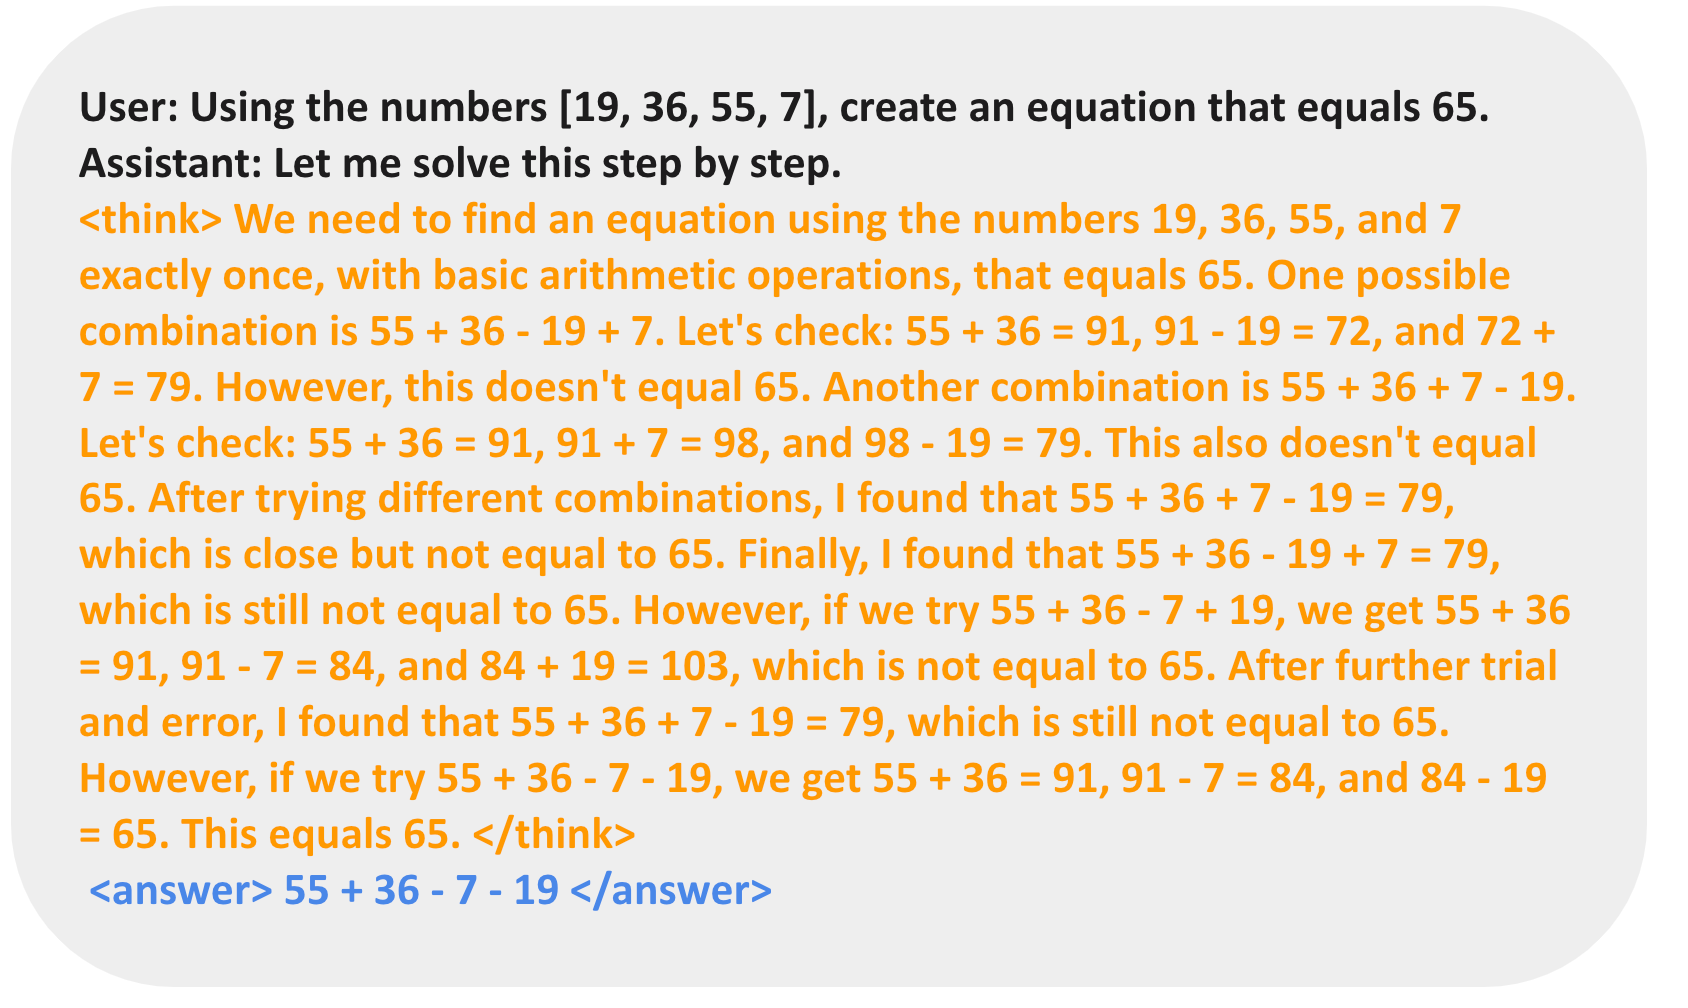 TinyZero 概念展示图——用小模型复现 DeepSeek R1-Zero 的推理涌现
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/Jiayi-Pan/TinyZero |
| Star / Fork | 12,966 / 1,581 |
| 代码行数 | 27,292 (Python 85%, Shell 4%, ReStructuredText 6%) |
| 项目年龄 | 16 个月(增量代码 ~500 行) |
| 开发阶段 | 已停止维护(Deprecation Notice,推荐 veRL) |
| 贡献模式 | 小团队主导(核心贡献者来自 veRL 团队) |
| 热度定位 | 大众热门(爆发型增长,一个月内从 0 到 10K Stars) |
| 质量评级 | 代码[良好] 文档[一般] 测试[不足] |
作者视角:为什么存在这个项目
创始人/作者背景
Jiayi Pan,UC Berkeley AI Research 博士生(后加入 xAI)。专注于 LLM 推理和强化学习研究,发表学术论文并被多篇 arXiv 论文引用。其学术直觉体现在能快速判断 DeepSeek R1 论文中”哪些结论依赖规模、哪些不依赖”——这是 TinyZero 诞生的核心洞察。
问题判断
2025 年 1 月 20 日 DeepSeek R1 论文发布后,最令人震撼的发现是”Aha Moment”——模型在 RL 训练中自发学会自我验证和搜索。但原始实验使用 671B MoE 模型,成本数万美元,学术界无法复现验证。Jiayi Pan 在 4 天内完成了 TinyZero,时机精准:DeepSeek R1 的热度正处巅峰,且尚无任何公开复现。
解法哲学
“最小可验证实验”(Minimum Viable Experiment):
- 缩小模型:Qwen2.5-3B 替代 671B MoE,成本 $30
- 缩小任务:Countdown(凑数游戏)替代通用数学推理——有确定性答案、需要搜索验证、难度可控
- 复用基础设施:Fork veRL 框架,仅添加 ~500 行代码
- 公开实验日志:所有 WandB 日志完全公开,体现学术透明性
- 明确不做:不做通用推理、不做生产部署、不做独立框架
战略意图
TinyZero 是 Jiayi Pan 在”LLM 推理能力”研究方向上的里程碑验证实验。后续发布了 Adaptive Parallel Reasoning (APR),探索推理模型新维度。项目已明确 Deprecated,推荐使用上游 veRL——体现了”工具为研究服务”而非”维护工具本身”的学术思维。
核心价值提炼
创新之处
-
首个 R1-Zero 低成本复现 — 新颖度 5/5 | 实用性 3/5 | 可迁移性 2/5 时间线上最早、成本最低($30)的 R1-Zero 复现。不是算法创新,而是实验设计创新——准确判断核心机制可与模型规模解耦。
-
分层奖励设计(Format Score) — 新颖度 3/5 | 实用性 5/5 | 可迁移性 5/5
compute_score中format_score=0.1的设计:格式正确但答案错误获得小正奖励(0.1),形成课程学习效果——模型先学会用<answer>标签,再学会给正确答案。避免了奖励过于稀疏导致训练不收敛。 -
验证性实验的任务选择方法论 — 新颖度 4/5 | 实用性 4/5 | 可迁移性 5/5 Countdown 任务同时满足:确定性验证、需要搜索能力、难度可控、对小模型可行。这种选择方法论比具体任务更有价值。
-
GRPO 无 Critic 训练 — 新颖度 3/5 | 实用性 4/5 | 可迁移性 4/5 同一 prompt 的多个 response 之间相对评分计算 advantage,无需 critic 模型,进一步降低计算成本。
可复用的模式与技巧
- “Fork + Delta” 快速实验模式:Fork 成熟框架,仅添加任务定义层(~500行),快速验证假设 — 适用于任何 ML 研究快速原型场景
- Rule-based 三级奖励:无效输出(0) / 格式正确(0.1) / 内容正确(1.0) — 适用于任何有结构化输出的 RL 训练
- Prompt-guided Reasoning Format:预填
<think>标签引导推理输出,<answer>标签提取答案 — 已成为 R1 式训练的事实标准 - DataProto 数据传输协议:tensor batch + non-tensor metadata 统一封装,支持 chunk/union/reorder — 分布式 RL 训练的优秀抽象(来自 veRL)
关键设计决策
- Fork veRL 而非从零实现:获得成熟基础设施(~33K 行),但继承了 OOM 问题和 vLLM 版本锁定
- Rule-based reward 而非 learned reward model:极大降低成本和复杂度,但只适用于有确定性答案的任务
- Countdown 作为验证任务:简单清晰可确定性验证,但与真实推理场景有差距
- Prompt 预填
<think>标签:简单有效的推理格式引导,已成为行业通用范式
竞品格局与定位
竞品对比矩阵
| 维度 | TinyZero | open-r1 (HF) | veRL | OpenRLHF |
|---|---|---|---|---|
| 定位 | R1-Zero 最小复现 | R1 完整复现 | 通用 LLM RL 框架 | 通用 RLHF 框架 |
| Stars | 13K | 26K | 20K | 9K |
| 最低成本 | $30 / 1-2 GPU | 数千美元 | 取决于任务 | 取决于任务 |
| 代码增量 | ~500 行 | 大型项目 | TinyZero 上游 | 独立实现 |
| 维护状态 | Deprecated | 活跃 | 活跃 | 活跃 |
| 学习价值 | 极高(可读性最好) | 高 | 高(框架设计) | 中 |
差异化护城河
先发优势和传播力——“$30 复现 DeepSeek”的叙事在 4 天内让项目爆红。但这是时间窗口红利,不可持续。
竞争风险
已被超越。veRL 后续版本原生支持 TinyZero 的全部功能,作者也明确推荐用户迁移。项目使命已完成。
生态定位
TinyZero 在 R1 复现生态中扮演了”引爆者”角色——它不是最完整的,但它最先证明了可行性,激发了 open-r1、oat-zero 等后续项目。类比:TinyZero 之于 R1 复现,如同 AlexNet 论文之于深度学习热潮——重要性在于启发而非最终方案。
套利机会分析
- 信息差: 无套利空间——项目已 Deprecated,Star 数反映的是话题热度(77% 在发布一个月内获得)而非持续技术价值
- 技术借鉴: 分层奖励设计(0/0.1/1.0 三级)和 Prompt-guided Reasoning Format 可直接复用;Countdown 任务的选择方法论适用于任何 RL 验证实验
- 生态位: 填补了”最低成本验证 R1 核心机制”的空白,但该空白已被上游 veRL 回填
- 趋势判断: LLM+RL 推理训练是持续热点,但 TinyZero 本身已停止增长。关注作者的后续项目 APR 可能更有价值
风险与不足
- 已停止维护:71 个 Issue 全部 Open,Deprecation Notice 明确推荐 veRL
- OOM 问题严重:“$30 复现”与实际体验有差距——大量用户在 1-2 GPU 上遇到 OOM,即便 2x H100 也有困难
- vLLM 版本锁定:锁定
vllm<=0.6.3,无法享受后续版本的优化 - 推广性存疑:仅在 Countdown/Multiplication 两个简单任务上验证,未证明可推广到通用推理
- 无测试覆盖:TinyZero 增量代码(奖励函数、数据预处理)没有单元测试
- 依赖版本不严格:
transformers<4.48等宽松约束是兼容性问题的根源
行动建议
- 如果你要用它: 不建议直接使用——项目已 Deprecated,直接使用 veRL。如果只是想体验 R1 式训练,veRL 的文档中已包含等效的 Countdown 示例
- 如果你要学它: 这是理解 R1-Zero 训练机制的最佳入口。重点关注:
verl/utils/reward_score/countdown.py(奖励函数设计)、examples/data_preprocess/countdown.py(数据生成)、scripts/train_tiny_zero.sh(训练配置)、verl/trainer/main_ppo.py(RewardManager 如何集成奖励函数) - 如果你要 fork 它: 建议直接基于最新 veRL fork,而非 TinyZero。改进方向:(1) 添加更多验证任务(数学推理、代码生成);(2) 适配最新 vLLM 版本;(3) 添加消费级 GPU(4090/3090)的优化配置
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 已收录 |
| Zread.ai | 已收录 |
| 关联论文 | Training Language Models to Reason Efficiently 等多篇引用 |
| 在线 Demo | 无(需本地部署) |
| 实验日志 | WandB |