字节 Dolphin 文档解析:单 VLM 两阶段拆 PDF,9K star 背后代码 MIT 模型却非商业
一句话总结
字节跳动 ACL 2025 论文「Dolphin: Document Image Parsing via Heterogeneous Anchor Prompting」的官方仓库——用单一视觉语言模型、通过「先分析版面、再按元素类型批量解析」的两阶段 anchor prompting,把 PDF/扫描件解析成结构化 Markdown/JSON 喂给 LLM。GitHub 仓库只有 1326 行 demo/推理代码,真正的产物是 HuggingFace 上的模型权重与论文方法;它学术 benchmark 漂亮(OmniDocBench v2 89.78),但企业实测短板明显,且有个易被忽视的坑——代码是 MIT,模型权重却是 Qwen 非商业研究许可。
值得关注的理由
- 一个值得讲透的方法创新:「Heterogeneous Anchor Prompting」——用一个 VLM 配不同 prompt 充当多个专家,先让它按阅读顺序吐出版面元素锚点序列,再把异构元素(表格/公式/代码/正文)裁块、配任务专属 prompt 批量喂回同一模型解析。相比端到端 OCR-VLM(GOT-OCR,易丢阅读顺序)和多模型 pipeline(早期 MinerU,链路重),它用「prompt 即任务选择器」把流水线压成单模型两遍调用。这是 LLM 时代「单模型多任务」范式在文档解析的落地样本。
- 一次清醒的工程取舍样本(v1→v2):v1/v1.5 是自研 Swin+MBart(0.3B)架构,主打极致轻量,但 vLLM/TensorRT-LLM 不原生支持(issue #93),团队被迫自写部署插件(
deployment/目录成了改动热点)。v2 直接换 Qwen2.5-VL(3B)现成基座——deployment/目录在 v2 被整个删掉、部署摩擦自然消失,代价是体量翻 10 倍 + 继承 Qwen 非商业许可。这是「自研架构 vs 站在主流基座上」权衡的活案例。 - 「排行榜数字 ≠ 开箱即用」的诚实警示:独立评测(Pulse AI)显示,学术分漂亮的 Dolphin 在企业场景字符级准确率仅 84.7%(远低于金融 >99% 门槛)、图表近乎全失败(成功率 7.7%)、无网格线表格 TEDS 从 0.71 暴跌到 0.28,且其流水线还反向复用了头号对手 MinerU。它是观察「文档解析喂 LLM」这个 2024-2025 最卷赛道的好窗口。
项目展示
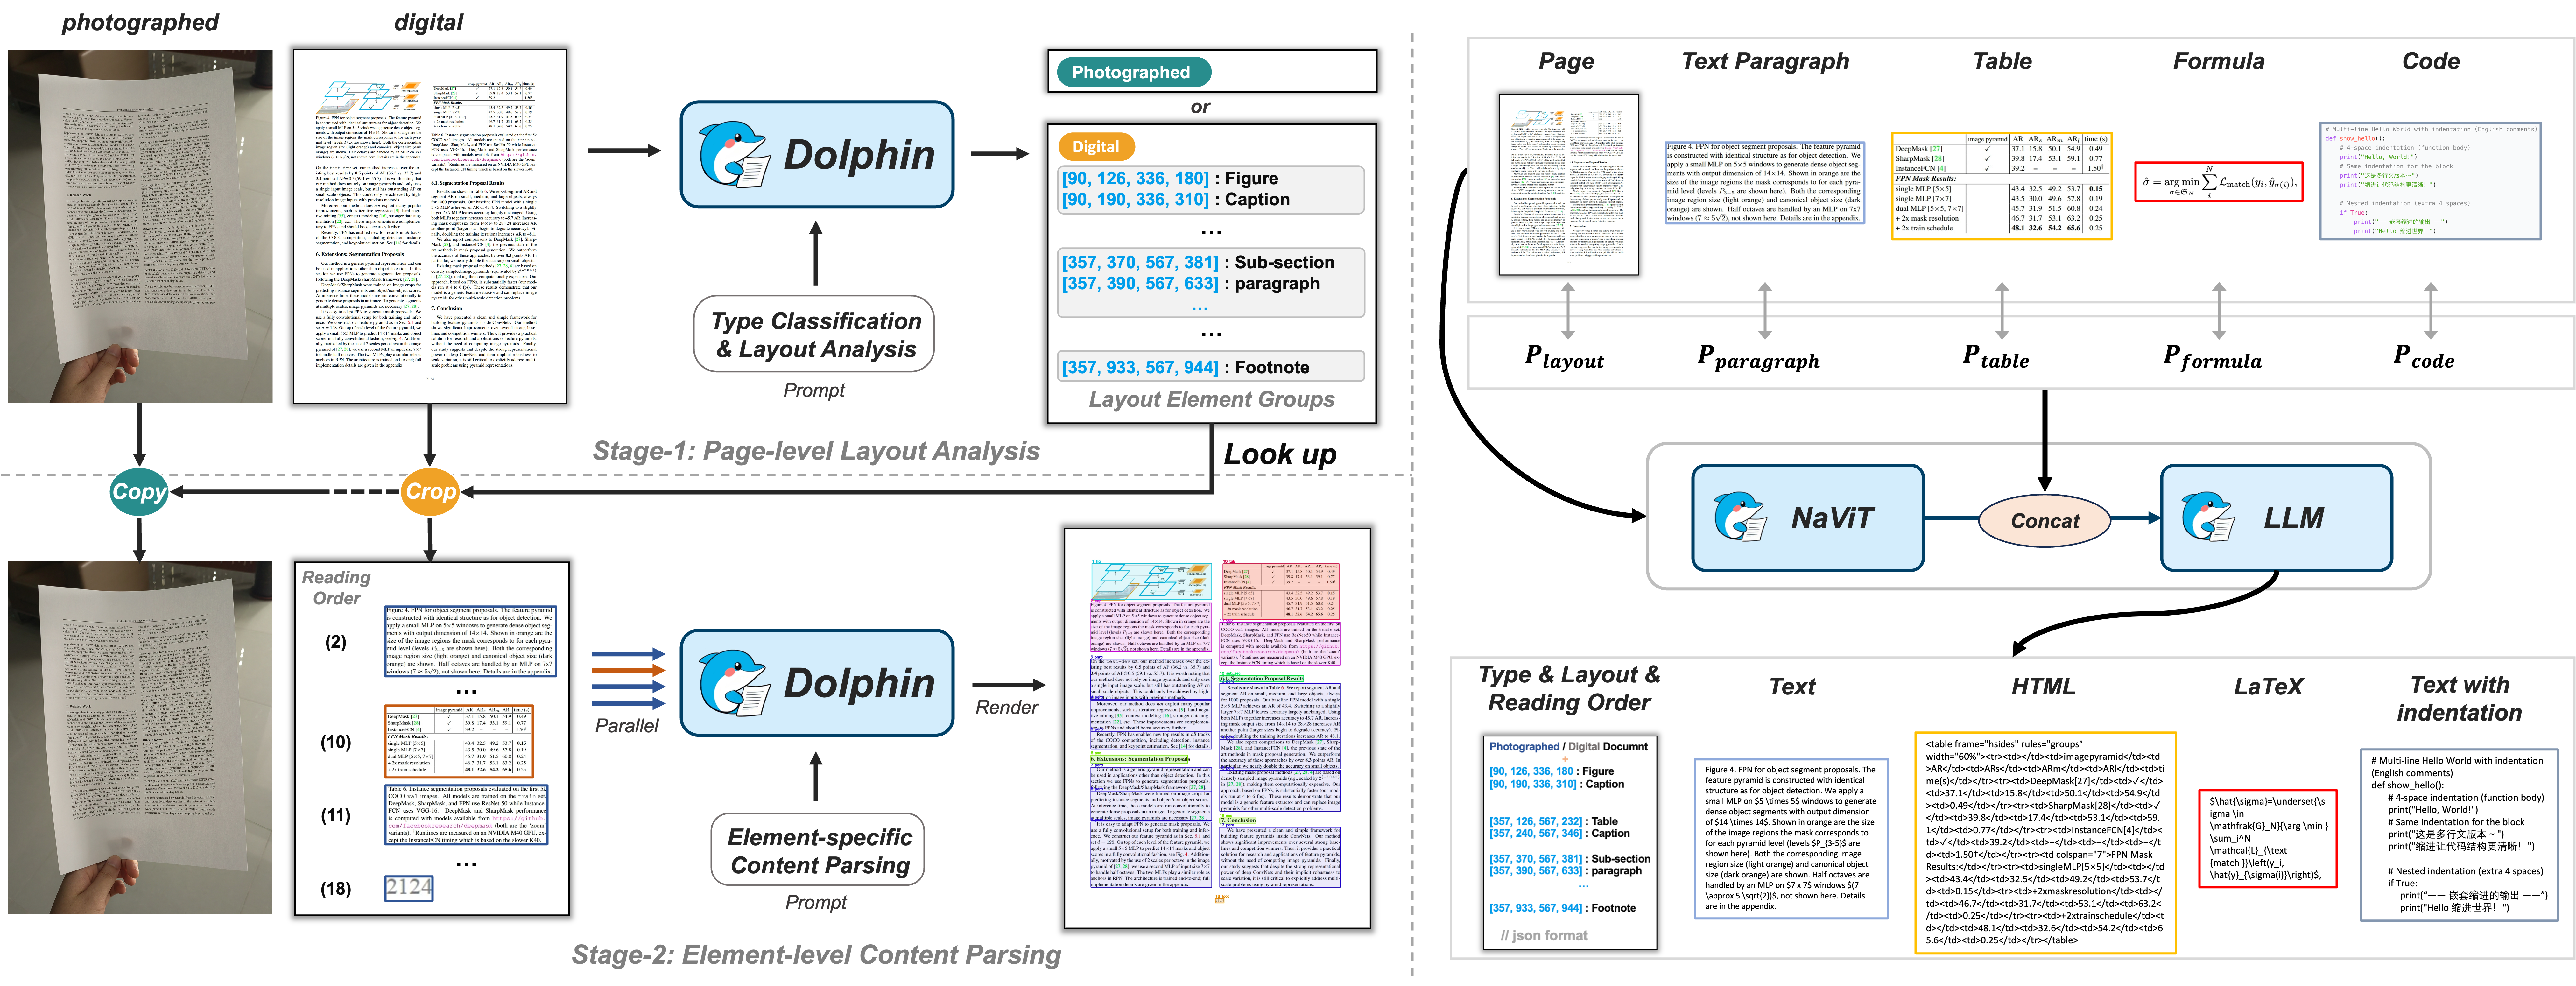
两阶段 analyze-then-parse 流程:Stage 1 按阅读顺序生成版面元素锚点,Stage 2 按元素类型配专属 prompt 并行解析。
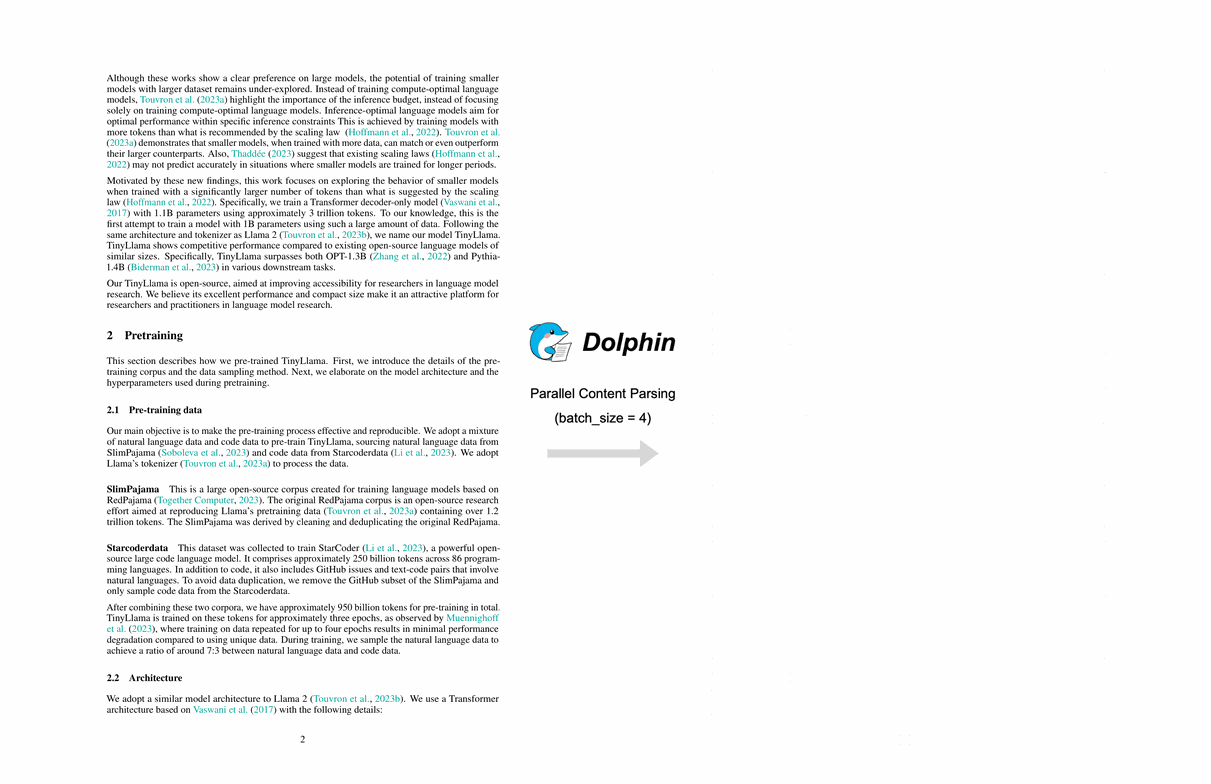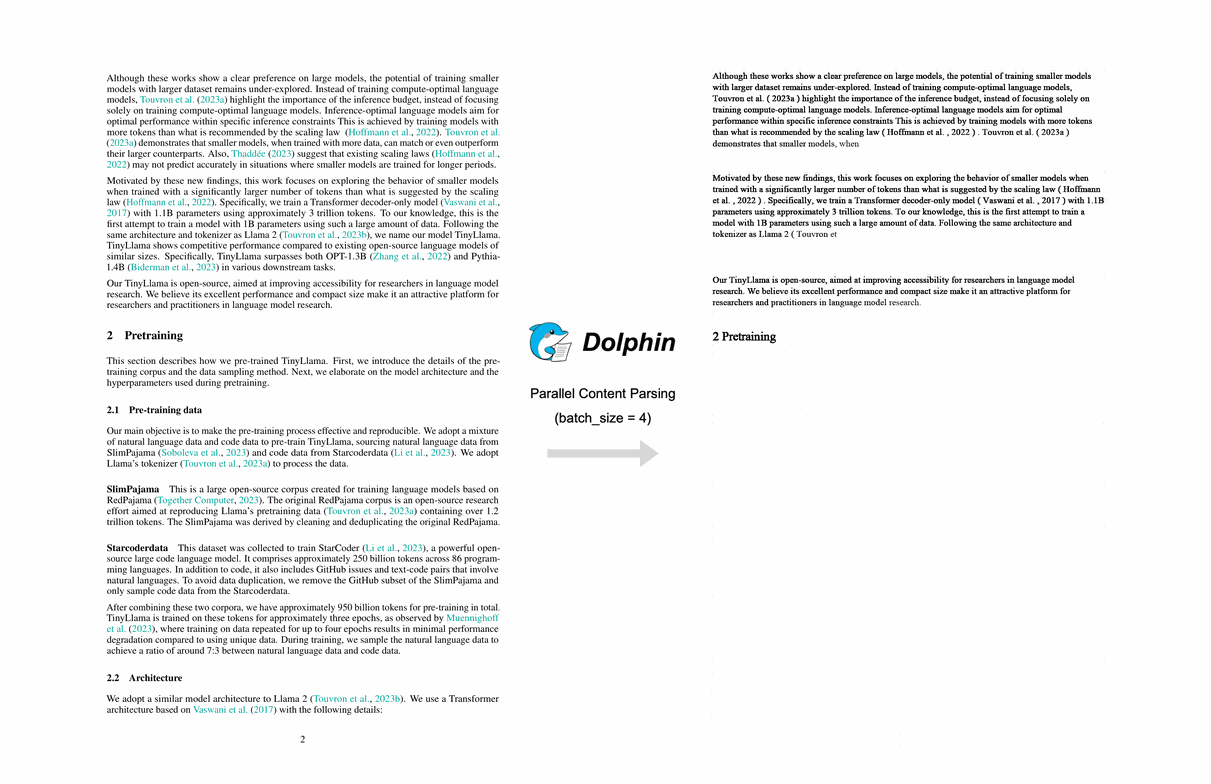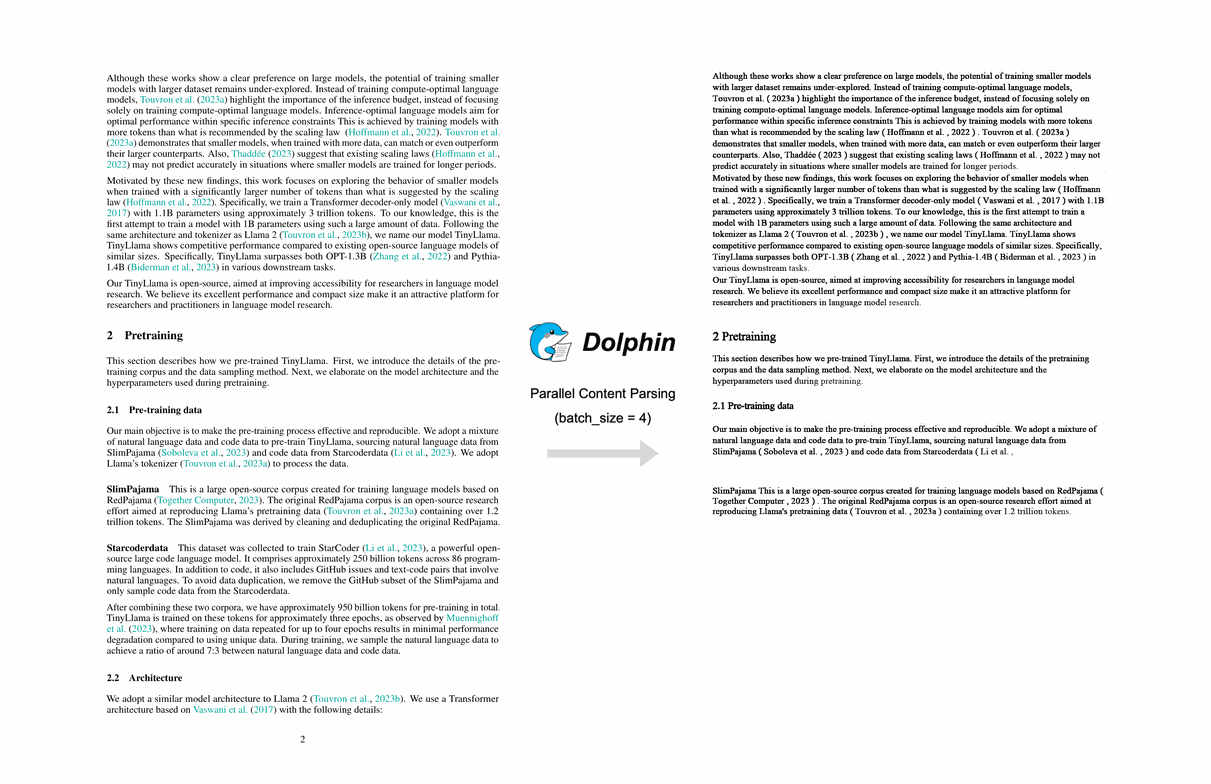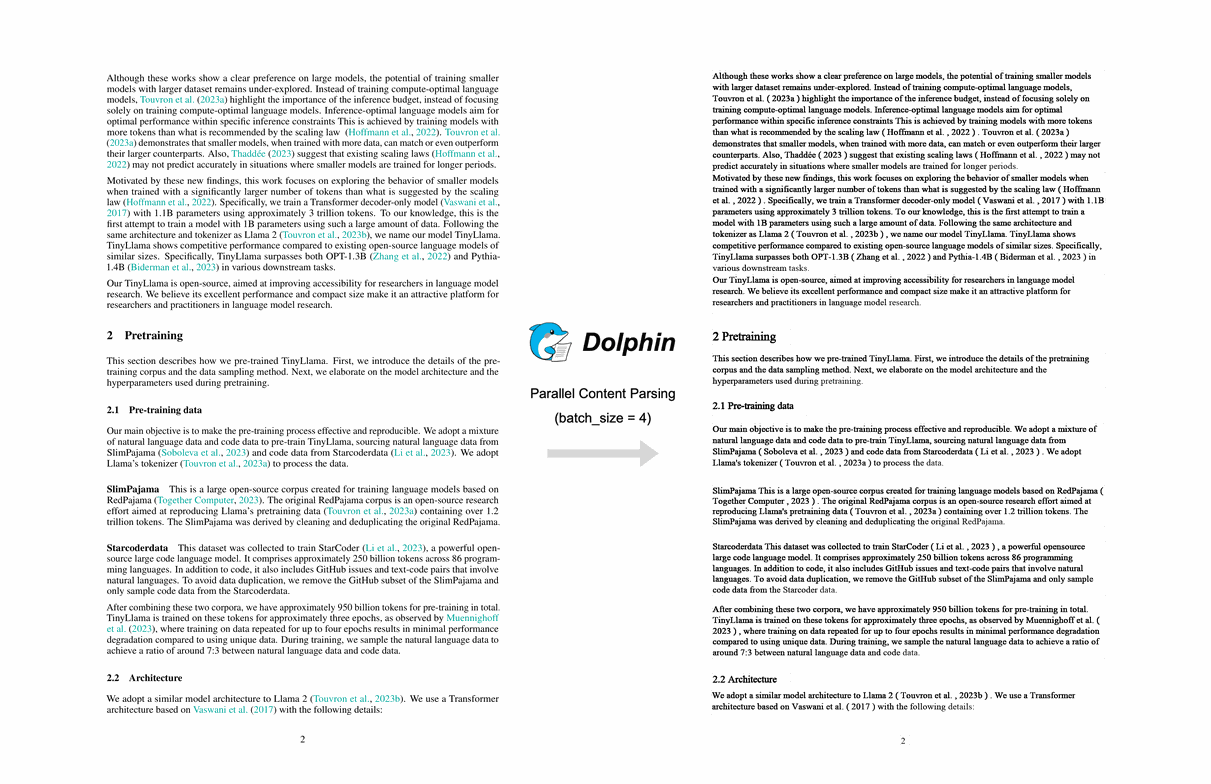
文档解析效果演示。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/bytedance/Dolphin |
| Star / Fork | 9,007 / 764 |
| 代码行数 | 1,326 行(Python 98.8% / TOML,9 文件)—— 模型发布仓库,价值在模型/论文而非代码量 |
| 项目年龄 | 7.6 个月(2025-10「Initial release」起算;GitHub 建库 2025-05,ACL 论文期) |
| 开发阶段 | 低维护(近 30 天 0 commit、近 90 天 2,发布后趋静) |
| 贡献模式 | 字节研究团队 · 单人主导(主作者 fh2019ustc / Hao Feng 占 82.9%) |
| 热度定位 | 大众热门 · 论文/模型发布型(稳步增长,约 2-3 star/天) |
| 质量评级 | 代码[一般] 文档[良好] 测试[无] |
License 关键坑:README 徽章 + 所有 .py 文件头都是 MIT(即代码 MIT),但仓库根
LICENSE文件实为 Qwen RESEARCH LICENSE(阿里云,仅限非商业研究)——因 v2 基于 Qwen2.5-VL 基座、权重继承非商业许可。真正有价值的产物(权重)受限于 research-only,商用须另向阿里云申请。这是「代码 MIT、模型非商业」的割裂,极易被 MIT 徽章误导。
作者视角:为什么存在这个项目
创始人/作者背景
仓库挂在字节跳动(@bytedance,org 17982 followers)名下,实际主导者是 fh2019ustc(Hao Feng/冯浩)——论文第一作者,中科大 USTC 文档 AI 背景、字节研究员,此前有 DocTr(文档去畸变)/Fox 等工作。单人主导(占 82.9%)。这是典型「学术研究者 + 大厂资源」组合:作者长期深耕文档图像理解这条线,字节提供规模化训练(30M+ 样本)与多轮迭代的土壤。
问题判断
把任意文档图像(数字原生 PDF / 拍照扫描件)解析为「保留阅读顺序 + 版面结构」的 JSON/Markdown,作为喂给 LLM/RAG 的前置清洗层。作者看到现有方案两条路都不够好:① 端到端 OCR-VLM(GOT-OCR2.0)把整页当一个序列直接吐,长文档易丢阅读顺序、易陷入自回归重复退化;② 多模型 pipeline(早期 MinerU)要拼装版面检测器 + 公式识别器 + 表格识别器 + OCR 多个独立模型,链路重、误差累积。Dolphin 想用单一 VLM 既做版面分析又做内容解析。
解法哲学
核心价值观是「用一个模型 + 不同 prompt 复用,换掉一堆专用模型」——从 instruction-following VLM 范式借来的信条:与其训 N 个专家模型,不如训一个能按 prompt 切换任务的通才 VLM。配套偏好是效率优先(v1/v1.5 坚持 0.3B 轻量,靠同类元素批量并行解码压延迟)。明确选择不做的:不做端到端「一次吐整页」(保留显式版面分析阶段以锁定阅读顺序);不放训练/微调代码(只发权重 + 推理 demo,issue #62 求微调脚本未果)。
战略意图
对字节是研究影响力 + 基础设施储备双重定位,不是直接商业产品:ACL 论文打学术声量,开源权重 + 排行榜成绩建技术品牌,沉淀的文档解析能力反哺内部内容理解/RAG。开源策略是「open-weights 但 research-only」——代码 MIT,但权重继承 Qwen 非商业许可,属「可研究、不可商用」的半开放。
核心价值提炼
「Heterogeneous Anchor Prompting」两阶段方法(从代码坐实)
- Stage 1(分析版面):用固定 prompt
"Parse the reading order of this document."让 VLM 按阅读顺序吐出一串锚点,格式形如[x1,y1,x2,y2][label][tag][PAIR_SEP]...(parse_layout_string解析,label 是元素类型、后续方括号是 author/abstract/watermark 等属性)。 - Stage 2(解析元素):按 label 把 bbox 裁出的图块按类型分组,每组配任务专属 prompt 喂回同一 VLM——表格
"Parse the table in the image."、公式"Read formula in the image."、代码"Read code in the image."、文本"Read text in the image."。「异构锚点」= Stage 1 产出的裁块作锚点,「异构」= 每类配不同 prompt。 - 注意:所谓「并行解析」其实是同类元素的批量解码(
process_element_batch把同类型裁块攒成一个 batch、同 prompt 一次model.generate、左填充对齐),是 GPU 上的 batch 并行,不是多线程并发。
创新之处
- Heterogeneous Anchor Prompting(单 VLM + 两阶段 + 按元素类型 prompt 复用)(新颖度 4/5):用「prompt 即任务选择器」把传统「版面检测 + 多个专用识别模型」的流水线压成单模型两遍调用。真正的创新在方法,不在工程代码。适用于任何「先结构化定位、再分类型抽取」的多模态解析任务(票据、网页截图、表单)。
- 同类元素分桶批量解码做吞吐优化(新颖度 2/5,实用性 5/5):按 label 分组、同 prompt 攒批一次前向,左填充最小化 padding 浪费——LLM/VLM 推理服务的通用优化。
- 文档类型感知的 IoU 重叠率降级(新颖度 3/5):
check_bbox_overlap对 Stage 1 预测 bbox 算 IoU 矩阵,若大比例框互相重叠 ⇒ 判为畸变/拍照页,回退到distorted_page整页 holistic 解析。这是作者拍照文档/去畸变研究经验的迁移。 - 对抗自回归重复退化的尾部截断(实用性高):
truncate_repeated_tail检测并截断尾部周期性重复,配 LaTeX 规整——任何裸用生成模型的后处理层可直接搬走。
可复用的模式与技巧
- 单模型 prompt 路由(Prompt-as-Task-Router):一个 VLM/LLM 靠不同 prompt 充当多个专家,避免多模型拼装——垂直多任务抽取、想压缩模型运维数量时。
- 同质请求分桶批处理:把相同 prompt/相近输出长度的请求攒成一批解码,最小化 padding 浪费。
- 几何启发式做质量门控/降级开关:用便宜的 IoU 重叠率判定输入质量并切换处理路径——输入质量不可控的 pipeline 兜底。
- 对抗 LLM 重复退化的尾部截断:检测周期性重复模式并截断。
关键设计决策
| 决策 | 解决的问题 | Trade-off | 可迁移性 |
|---|---|---|---|
| 单 VLM + 异构 anchor prompt 两阶段 | 一页内异构元素各自最优解析方式不同,又不想拼装多模型 | 裁块后元素失去周边语境,换阅读顺序可控 + 每类用最优 prompt + 只维护一个模型 | 高 |
| v2 弃自研 Swin+MBart(0.3B) 改投 Qwen2.5-VL(3B) | 自研架构不被 vLLM/TRT-LLM 原生支持(#93),需自写部署插件 | 用「合规自由度 + 模型体量(0.3B→3B)」换「生态原生部署 + 性能(89.78) + 零部署维护」(v2 直接删掉 deployment/ 目录);代价是继承 Qwen 非商业许可 | 中 |
| 同类元素批量解码(非多线程并发) | 逐元素串行解码延迟随元素数线性爆炸 | GPU batch 并行,显存随 batch 上升 | 高 |
| 文档类型感知 IoU 降级 | 拍照/畸变文档上版面框检测会乱、裁块切坏 | 便宜的几何启发式兜底,降级后丢失细粒度结构 | 中 |
竞品格局与定位
竞品对比矩阵
| 维度 | Dolphin | MinerU | GOT-OCR2.0 | docling / marker |
|---|---|---|---|---|
| 路线 | 单 VLM 两阶段 | pipeline 式 | 端到端 OCR-VLM | 规则+模型 / PDF→md |
| Stars | 9k | ~66.7k | ~7k | ~30k / ~25k |
| OmniDocBench | v2 89.78 | 2.5-Pro 90+ | 较低 | — |
| 商用许可 | ❌ 模型非商业(Qwen) | 友好 | 友好 | ✅ Apache 可商用 |
| 部署 | GPU 跑 3B | 重 | 轻 | 轻(无 GPU 重依赖) |
| 定位 | 研究模型 | 生产全家桶 | 极简端到端 | 工程师友好可商用 |
差异化护城河
方法护城河(Heterogeneous Anchor Prompting 单模型范式)+ 信任护城河(字节 + ACL 2025)。但技术护城河正在被侵蚀——OmniDocBench 头部已被 MinerU2.5-Pro / GLM-OCR 推到 90~95,Dolphin 的 89.78 不再领先。
竞争风险
最可能被 MinerU 替代——后者社区(66.7k vs Dolphin 量级小)、84 语种覆盖、迭代速度全面占优,且据 Pulse AI 评测 Dolphin 流水线本身复用了 MinerU(在某些环节反而依赖对手组件)。商用场景则被 docling/marker 的宽松 Apache 许可直接截胡(Dolphin 模型非商业 + 需 GPU 跑 3B)。
生态定位
「文档解析喂 LLM」红海赛道(2024-2025 最卷开源方向之一)里的学术标杆 + 方法参考实现,不是生产首选。需诚实校准官方 benchmark 与企业实测的落差:Pulse AI 实测显示标准版面 ANLS 0.87 但字符级准确率仅 84.7%、图表成功率 7.7%、无网格线表格 TEDS 0.71→0.28、多级层级保留仅 31%,配合 issue #84「复现不出 Fox-Page-En 结果」,「排行榜数字 ≠ 开箱即用效果」的张力必须明示。
套利机会分析
- 信息差:未被低估,属合理估值(字节 + ACL + HF 模型,知名度充分)。但近 30 天 0 commit、低维护,价值已沉淀到「模型权重 + 论文方法」,仓库工程演进空间不大。适合写「方法解读 + 文档解析赛道格局」深度文,不适合当「读源码学架构」素材。
- 技术借鉴:单模型 prompt 路由、同质请求分桶批处理、IoU 几何降级、重复退化尾部截断——这些与「文档解析」本身解耦的模式可迁到其他多模态/生成式任务。方法层面「两阶段 analyze-then-parse」对做垂直 VLM 的团队有参考价值。
- 生态位:填补「单模型两阶段 anchor prompting 文档解析」的方法空白;但生产/商用生态位已被 MinerU(开源全家桶)与 docling/marker(可商用)占据。
- 趋势判断:文档解析喂 LLM 是真需求且持续火热,但 Dolphin 的后发劣势已现——benchmark 被反超、商用受许可限制、企业实测短板明显。其价值更多在「方法被引用/借鉴」而非「被直接采用」。
风险与不足
- License 割裂、商用受限:代码 MIT 但模型权重 Qwen 非商业研究许可,README 徽章易误导,企业落地需另申请授权。
- 企业实测短板:字符级准确率 84.7%、图表近乎全失败、无网格线表格暴跌、多级层级保留低——学术 benchmark 与生产效果落差大。
- 低维护 + 不放训练代码:发布后趋静(c30=0),只发权重不放微调脚本(#62),用户难用自有数据适配。
- 代码 demo 级:
DOLPHIN类在三个入口逐字复制三遍、check_bbox_overlap阈值默认值(0.25)与 docstring(60%)不一致、满屏 try/except 吞错、requirements.txt 夹带训练栈污染推理仓库。无测试、无 CI。 - 反向依赖对手:流水线复用 MinerU,竞争上已非领跑者。
行动建议
- 如果你要用它:做文档解析研究/评估、能接受非商业许可 + GPU 跑 3B——可用 v2(
ByteDance/Dolphin-v2)。商用场景请改用 docling/marker(Apache 可商用)或 MinerU;要金融级字符准确率/复杂表格,Dolphin 当前达不到。务必看清是代码 MIT 而非模型 MIT。 - 如果你要学它:重点不是读这 1326 行 demo,而是读论文(arXiv:2505.14059)+ 代码里的方法落地——
demo_page.py(两阶段管线 + 批量解码)、utils/utils.py(parse_layout_string锚点解析 +check_bbox_overlapIoU 降级)、utils/markdown_utils.py(重复退化截断 + LaTeX 规整)。 - 如果你要 fork 它:低价值(模型非商业 + benchmark 被反超)。真正该抄的是方法范式(单 VLM 两阶段 anchor prompting)与可复用后处理(重复退化截断、同类批量解码),迁到自己的多模态解析任务。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/bytedance/Dolphin(已收录) |
| Zread.ai | 未验证(返回 403) |
| 关联论文 | Dolphin: Document Image Parsing via Heterogeneous Anchor Prompting (ACL 2025 Findings, arXiv:2505.14059) · Dolphin-v2 [arXiv:2602.05384] |
| HuggingFace 模型 | ByteDance/Dolphin-v2(v1.0/v1.5 在对应分支) |
| 在线 Demo | HF Space huggingface.co/spaces/ByteDance/Dolphin(README 中部分链接可能失效) |
| 关键独立评测 | Reality Check: ByteDance’s Dolphin Evaluated For Enterprise Workloads (Pulse AI)(学术 benchmark vs 企业实测的鲜明对照) |