PyTorch 凭什么赢下研究界 85%:100K star、330 万行背后的 Dispatcher 与 torch.compile
一句话总结
PyTorch 是当今 AI 时代的基础设施事实标准:一个让研究者用纯 Python 就能写出可自动微分、跑 GPU、还够快的神经网络的框架。它靠「动态图 + Pythonic」的易用性从 TensorFlow 手里抢下了研究界(顶会论文约 80–85% 用它),又用 torch.compile 补上编译性能这块唯一短板,把整条 LLM 训练/推理栈(Hugging Face、vLLM、DeepSpeed)都变成了自己的下游。
值得关注的理由
- 它是「下游全都依赖你」的网络效应护城河范本:几乎每一篇新论文的开源实现、每一个主流 LLM 训练框架都建在 PyTorch 之上。这种壁垒不是某个 feature,而是整个生态的引力——值得任何想做平台型项目的人研究。
- 两个可迁移性极高的架构内核:① Dispatcher 用一个 64-bit bitset 把「后端(CPU/CUDA/MPS…)× 功能(Autograd/Autocast/量化…)」的二次组合爆炸压成 N+M 的可穿透分层;② 一份声明式
native_functions.yaml(2584 个算子)+ torchgen 代码生成扇出全套 C++/Python/autograd 胶水。这两套设计是「正交策略动态组合」与「单一声明源多目标代码生成」的教科书。 - 一次教科书级的「eager → 编译」战略转向:
torch.compile(2.0)在 Python 字节码层把 eager 程序「偷」成图(TorchDynamo 走 CPython PEP 523 帧钩子),搞不定就 graph break 优雅退回 eager——在不要求用户改一行代码、不破坏 Python 灵活性的前提下补回图优化,是对 JAX「全程必须可 trace」的差异化回应。
项目展示
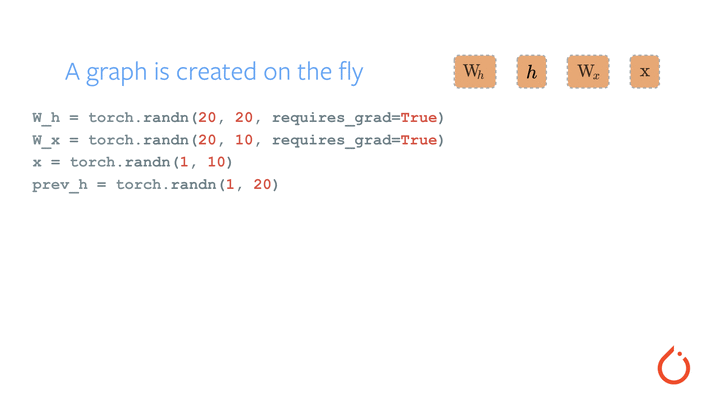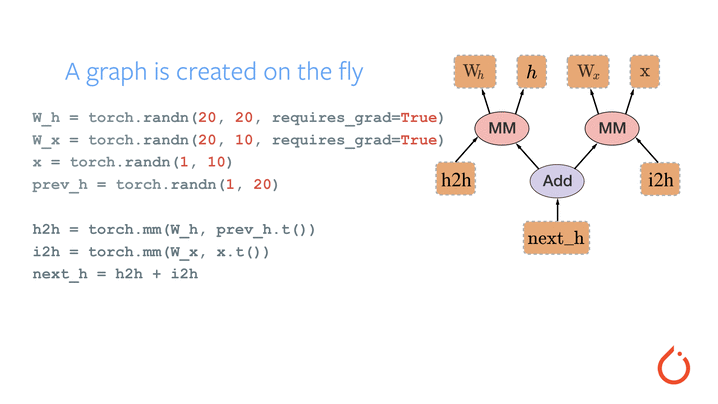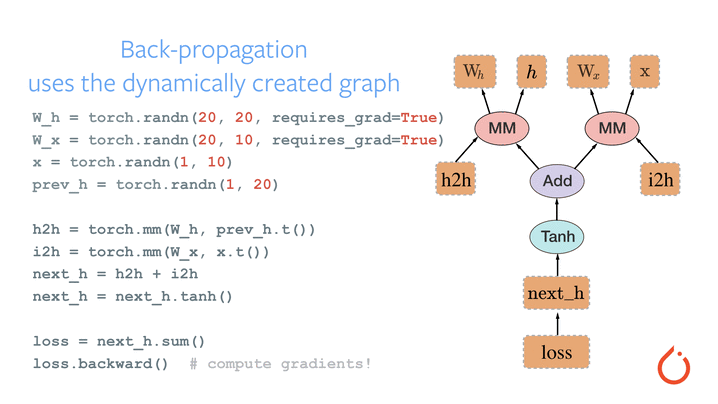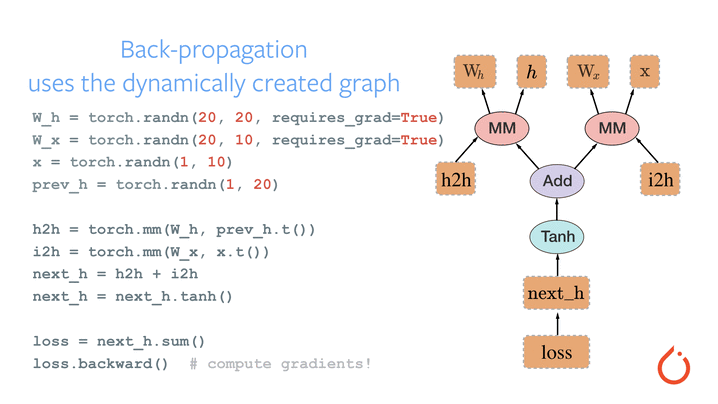
招牌的动态计算图(define-by-run)——网络结构可随任意 Python 控制流即时改变、所见即所得,这正是它从静态图框架手里赢得研究界的根本:
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/pytorch/pytorch |
| Star / Fork | 100,582 / 27,956 |
| 代码行数 | 330 万行(Python 62% 前端 + C++ 21.6% / CUDA 2.2% / C Header 8.7% 后端,10,965 文件) |
| 项目年龄 | 约 10 年(2016-08-13 创建) |
| 开发阶段 | 密集开发(近 52 周 16,921 commit,周均 325 且仍在加速;近 4 周折算周速率 398 > 全年 325) |
| 贡献模式 | 基金会式分布式协作(322+ 人,合并机器人 pytorchmergebot 居首,最高产人类 Edward Yang) |
| 热度定位 | 大众热门 / AI 基础设施事实标准 |
| 质量评级 | 代码「优」 文档「优」 测试「优」 CI「优」 |
注:本仓库 10 万+ commit、1.3GB,用 depth-1 浅 clone 读码 + gh api 补全提交历史(共 105,663 commit)。
作者视角:为什么存在这个项目
创始人/作者背景
owner 是 GitHub 组织 pytorch(13,144 followers)。项目 2016 年由 Meta/FAIR 发起,联合创建者 Soumith Chintala 是事实上的精神领袖(独立带队约 8 年,2025-11 在长信《Leaving Meta and PyTorch》中宣布离开 Meta);Adam Paszke(实习生身份写下早期 autograd,后转投 Google JAX)、Sam Gross、Gregory Chanan 共同打造。核心架构师 Edward Yang(ezyang) 是 autograd/dispatcher 的灵魂人物(3,501 commit,人类第一)。
最值得点出的治理事件:2022 年 Meta 把 PyTorch 捐给 Linux 基金会,成立中立的 PyTorch Foundation(理事会 + 技术咨询委员会,成员含 AWS/Google/微软/Meta/英伟达/AMD)。Meta 从「拥有者」变为「最大贡献者之一」——去单一公司化,是它能被全行业当作公共底座采纳的关键一步。贡献者结构呈「机器人 + 厂商核心 + 全球社区」三层,Top 贡献者份额仅约 15.6%,无单点依赖。
问题判断
源头是 Torch(Lua) 的张量/autograd 内核成熟但 Lua 生态边缘化,而 Python 科学计算生态(NumPy)已成事实标准。README 直接点名 TensorFlow/Theano/Caffe 的「静态图世界观」——网络结构必须先构建再复用,改行为要从头来。PyTorch 的反命题是 reverse-mode 自动微分的 define-by-run:「以零延迟任意改变网络行为」,执行即求值、stack trace 精确指向用户代码行。FAIR 的研究迭代节奏需要「写代码即调试」的即时反馈,这正是它的设计起点。
解法哲学
清晰的两阶段取舍:
- 第一阶段(2016–2022)押注 eager:动态图牺牲静态图的全局优化机会,换来调试性与表达力(任意 Python 控制流、数据依赖的网络形状)。把「性能」下沉到 C++ 内核(MKL/cuDNN/NCCL + 自研 GPU caching allocator)而非图编译,从而在不牺牲 eager 的前提下保住单算子性能。
- 第二阶段(2.0/2023 起)用 torch.compile 补回图优化:关键洞察是不要求用户改代码,而是在 Python 字节码层把 eager 程序「偷」成图——默认动态、热点编译、失败优雅降级。这是「鱼与熊掌兼得」。
战略意图
Meta → 基金会的去单一公司化巩固「中立 AI 基础设施」地位,下游整条训练栈建其上形成网络效应护城河。torch.compile 是向工业部署渗透的战略楔子:用「不改代码就提速」把已锁定的研究用户平滑带入生产,堵住 JAX/XLA 在大规模训练上的编译优势缺口;多后端(CUDA/MPS/HIP/XPU/MTIA)则是争取硬件厂商生态的接口。
核心价值提炼
创新之处
- 多维可组合 Dispatcher(新颖度 5/5,实用性 5/5,可迁移性 4/5):一个算子要支持 N 个后端 × M 种正交功能(Autograd/Autocast/Functionalize/量化…),若每个组合一个 key,分派表会二次膨胀。PyTorch 在
c10/core/DispatchKey.h把 key 拆成两个正交维度——BackendComponent(~16 个后端 bit)和 functionality bit,打包进 64-bitDispatchKeySet,分派时对 keyset 做 count-leading-zeros 取最高优先级 O(1) 跳到 kernel,kernel 内可redispatch抹掉该 bit 落到下一层。N×M 二次表压成 N+M 的 building-block 组合,且功能层层可穿透。 - 声明式算子注册表 + 代码生成(新颖度 4/5,实用性 5/5,可迁移性 5/5):
aten/src/ATen/native/native_functions.yaml(2584 个算子 schema,15788 行)+tools/autograd/derivatives.yaml(687 条导数公式),由torchgen/(3 个文件 6848 行)读取生成 C++/Python binding/autograd 包装/functionalize/序列化 schema 全套样板。「加一个算子只改 yaml + 写 kernel」,跨语言/跨后端强一致;别名与可变性注解Tensor(a!)还是机器可验证的元信息。 - TorchDynamo 字节码 JIT 捕获 + graph break 优雅降级(新颖度 5/5,实用性 5/5,可迁移性 2/5):走 CPython PEP 523 帧求值钩子,
InstructionTranslator逐条符号执行字节码、把张量运算记进 FX 图、把来源记进Source以生成 guards(运行时校验 dtype/device/shape,编译成 C++ 做 O(1) 缓存命中);遇到搞不定的 Python 构造触发 graph break,编译已捕获部分、resume 函数接管其余。装饰一行@torch.compile即提速、搞不定退回 eager,零迁移成本。 - define-by-run 动态 autograd(新颖度 4/5,实用性 5/5):前向每个可微算子在 Dispatcher 的 Autograd 层「录磁带」建反向 DAG,
torch/csrc/autograd/engine.cpp用拓扑计数 + 每设备 ReadyQueue + 工作线程并发逆序执行。无与伦比的灵活性(条件分支、循环、数据依赖形状),代价是每次前向重建图、难做全局 fusion——正是 torch.compile 要补的洞。
可复用的模式与技巧
- 正交维度 bitset + 前导零优先级:多维分派打包进定长 bitset、各维占独立区段、优先级靠 clz——避免组合爆炸。适用于策略链、中间件、权限矩阵、渲染管线。
- 声明式 SoR + 多目标 codegen:一份 DSL 注册表生成所有派生胶水,保跨语言一致性(与 gRPC/protobuf 同源思想)。
- 可穿透的功能分层(redispatch):每个横切关注点(autograd/autocast/tracing)做成可剥离的一层,处理完抹掉自己的 key 落到下一层——洋葱式中间件。
- JIT 捕获 + guard 缓存 + 优雅降级:动态拦截、用 guard 缓存编译产物、命中失败回退解释执行——任何「热点编译、其余解释」的混合执行引擎适用。
__torch_function__/__torch_dispatch__扩展点:用户在 Python 层即可拦截/重定义整个张量语义(子类张量、量化、日志、单位制),FX 自身就是其消费者。
关键设计决策
最能体现 PyTorch 工程哲学的是 Dispatcher 这个运行时中枢:一次 add 调用并不是简单的函数调用,而是按当前张量的 DispatchKeySet(融合了它在哪个后端、是否需要追踪梯度、是否在 autocast/编译模式下)动态路由——Autograd 是一层、Autocast 是一层、各后端是底层,层层穿透。这套设计让「多后端 + 自动微分 + 各种 mode」彻底正交可组合,是 PyTorch 能同时服务研究灵活性与工程扩展性的底层原因。算子作者优先写 CompositeImplicitAutograd kernel(用更底层算子组合,自动跨所有后端 + 自动微分),只有真正需要硬件特化的才落具体 kernel(yaml 里 CUDA 506 个 vs MPS 293 个的差距,就是多后端覆盖这笔长期债务的明证)。
竞品格局与定位
竞品对比矩阵
| 维度 | PyTorch | TensorFlow(Google) | JAX(Google) | MLX(Apple)/ tinygrad |
|---|---|---|---|---|
| Stars | 100K | ~187K | ~30K | ~17K / ~64K |
| 范式 | 命令式 + 渐进式编译 | 静态图(早期) | 函数式 + 全程编译 | 数组框架 / 极简 |
| 研究界份额 | ~80–85% 论文 | 个位数~15%,流失 | 科研新贵,TPU | 边缘/单平台 |
| 强项 | eager 易用 + 下游生态 | 部署链 TF Serving/Lite | jit/grad/vmap + TPU | Apple 统一内存 / 教学 |
差异化护城河
三重叠加:① eager 易用与调试体验的先发心智占领;② 下游整条 AI 训练/推理栈(HF/vLLM/DeepSpeed/Lightning)建其上的网络效应,几乎不可替代;③ torch.compile 补上的编译性能,把曾经唯一的短板(图优化)堵住。真正难复制的不是某个 feature,而是「整个生态依赖你」的引力。
竞争风险
JAX 在超大规模训练/TPU 与函数式可组合变换(vmap/pmap)上仍有范式优势;「编译范式之争」未定——若未来工作负载更偏静态可编译,JAX/XLA 路线可能反扑。多后端(尤其 Apple MPS)算子覆盖是持续维护负债(issue #77764,1793 评论)。此外 Soumith 2025-11 离开 Meta,象征意义上是一个时代节点(但基金会治理已降低单点依赖)。
生态定位
事实标准的「AI 基础设施层」,经 PyTorch Foundation 中立治理后从「Meta 框架」升格为「行业公共底座」。TensorFlow 守企业存量、JAX 占 TPU/大规模、MLX 占 Apple 端侧、tinygrad 走极简——PyTorch 是绝对中心,其余各据细分。
套利机会分析
- 信息差:无任何「早期套利」空间——它是研究界与 LLM 训练栈的默认底座。价值在于解读「它为何赢、护城河在哪、torch.compile 这条从 eager 走向编译的路线意味着什么」这条经典叙事,科普与决策参考价值极高。
- 技术借鉴:Dispatcher 的正交 bitset 分派、声明式算子 + codegen、redispatch 可穿透分层、JIT 字节码捕获 + guard 缓存——这四套设计可迁移到中间件框架、多后端编译器、大型多语言 API、动态语言 JIT 等完全不同的领域。
- 生态位:它定义了「深度学习框架」这一品类的形态;后来者(MLX/tinygrad)大多模仿其 API。
- 趋势判断:在 LLM 浪潮推动下不仅没有十年老项目的疲态,提交速率反而单调递增;torch.compile 正把它从研究底座推向工业生产底座。
风险与不足
- 认知复杂度极高:Dispatcher(64-bit key、5 类 key + alias key、上百行注释)、torchgen 的 DSL「方言」、TorchDynamo(~12 万行 Python + 一整套 C++ 帧操作,甚至 copy 了 CPython 内部)——这套强大抽象的学习与维护门槛非常高,不是普通项目能照搬的。
- torch.compile 的固有代价:guard 失效会触发重编译,动态 shape 需 PGO 缓解;graph break 多时加速有限。
- 多后端覆盖是长期债:MPS/XPU 等新后端算子覆盖滞后于 CUDA,是反复出现的社区诉求。
- 64-bit DispatchKeySet 是硬上限:后端/功能数量逼近天花板时要不断「省 bit」,是架构的远期约束。
行动建议
- 如果你要用它:它是深度学习/LLM 开发的默认起点,无需犹豫;追求极致编译性能用
torch.compile,大规模分布式用 FSDP/torch.distributed。只有在 TPU 大规模训练或偏好函数式范式时才考虑 JAX。 - 如果你要学它(架构):直奔
c10/core/DispatchKey.h+DispatchKeySet.h(分派 bitset 设计的灵魂注释)、aten/src/ATen/core/dispatch/Dispatcher.h(redispatch)、aten/src/ATen/native/native_functions.yaml+torchgen/(声明式算子 + codegen)、torch/csrc/autograd/engine.cpp(动态反向引擎)、torch/_dynamo/CLAUDE.md(最完整的 Dynamo 架构文档)。这五处是整个框架最高价值的浓缩。 - 如果你要借鉴它:Dispatcher 的「正交维度 bitset + 优先级穿透」和「声明式 SoR + 多目标 codegen」是两套可直接迁移到非 AI 领域的工程范式。
知识入口
| 资源 | 链接 |
|---|---|
| 官方文档 | https://pytorch.org (含 /blog、/tutorials 的 60-Minute Blitz) |
| DeepWiki | https://deepwiki.com/pytorch/pytorch(已收录,覆盖编译系统/调度/分布式/codegen) |
| 关联论文 | PyTorch: An Imperative Style…(NeurIPS 2019) ;PyTorch 2: …Dynamic Python Bytecode Transformation and Graph Compilation(ASPLOS 2024) |
| 在线 Demo | 官方 60-Minute Blitz 教程 + Colab notebooks(pytorch.org/tutorials) |