GitHub 推荐:2.3 月 27K stars:Colibrì 怎么用纯 C + 三层磁盘流式把 744B MoE 跑在消费级硬件上
一句话总结
Colibrì 是一个纯 C / 零运行时依赖的 MoE 推理引擎,把 VRAM / RAM / NVMe 当作同一个权重驻留层级,配合路由热度驱动的 LRU prefetch,让 744B–2.8T 的前沿 MoE 模型能在消费级硬件(甚至 32GB 内存)上 token-exact 地跑出来。
值得关注的理由
- 现象级早期红利:2.3 个月、27,453 stars / 3,009 forks,6 个模型族(GLM-5.x / DeepSeek V4 Flash / Kimi K3 / Qwen3.x / OLMoE / Inkling)token-exact 跑通——单 binary + family registry 的工程哲学明显受 llama.cpp 启发,但 MoE 三层驻留 + 自研 fmt1-5 容器是它独有的护城河。
- 把”权重”重新定义成”流式数据”:口号 “Weights are not state to hold. They are data to stage.” 贯穿整个项目;CPU 默认路径仅依赖 libc + pthreads + OpenMP,CUDA / Metal / Vulkan / HIP 全是 opt-in 编译开关——在最小 docker 镜像里也能编译跑通。
- 严肃的工程纪律:自研 JSON / GBNF grammar / 熵编码容器(CFSE + 256-stream rANS),token-exact oracle 矩阵覆盖 7 个模型族,CI 跨 4 平台(Linux / macOS-arm64 / Windows-UCRT64 + ARM NEON)+ Vulkan(Lavapipe) + ASan/UBSan——“优化不会偷偷改语义”是硬保证。
项目展示
 项目 hero logo——致敬 llama.cpp 的 “tiny llama, immense model”,colibrì(蜂鸟)是意大利语,呼应 README 的意大利语版本
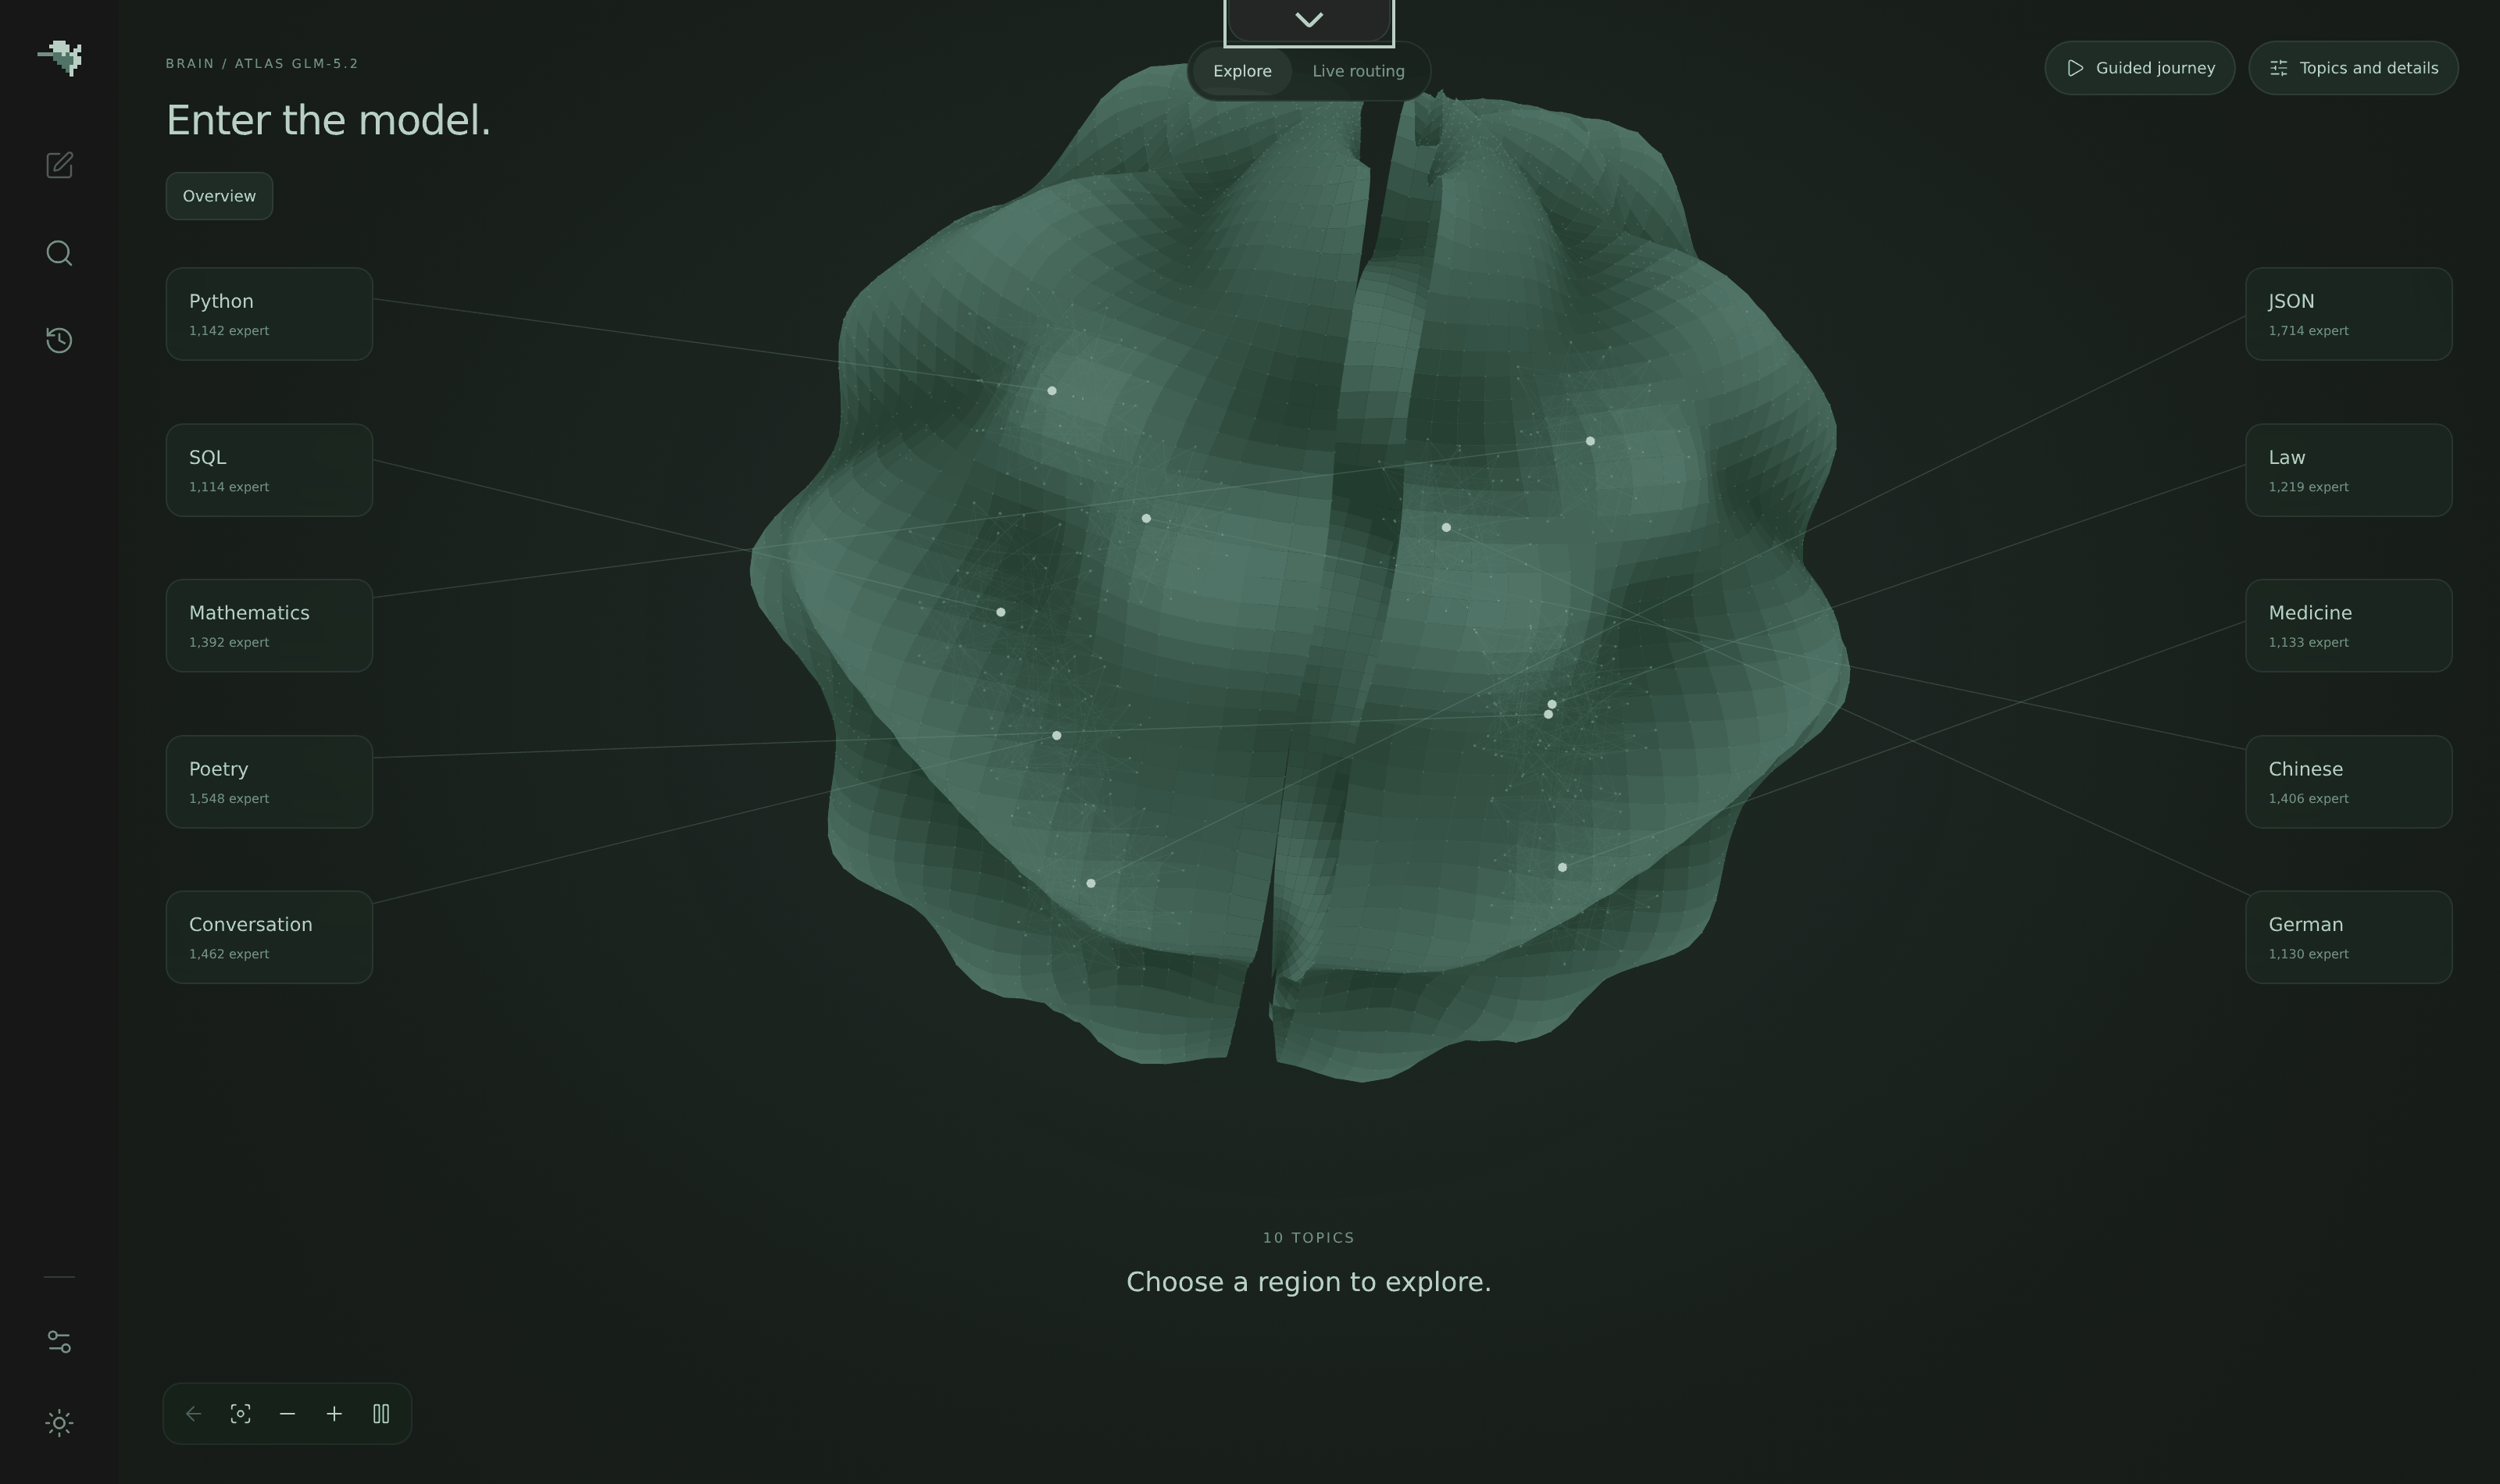 Web dashboard 的 Brain 页:把 GLM-5.2 的 19,456 个 expert 渲染成一颗活体大脑皮层,颜色代表存储层级(VRAM/RAM/NVMe),亮度代表路由热度
 3D 专家图谱(Expert Atlas):13,260 个被实测过的 expert 按”路由亲和度”自然聚类,1,041 个 replicated specialist 按主题(诗歌/法律/中文/SQL)聚成”星系”——这是 issue #175 公开招募社区探针的成果
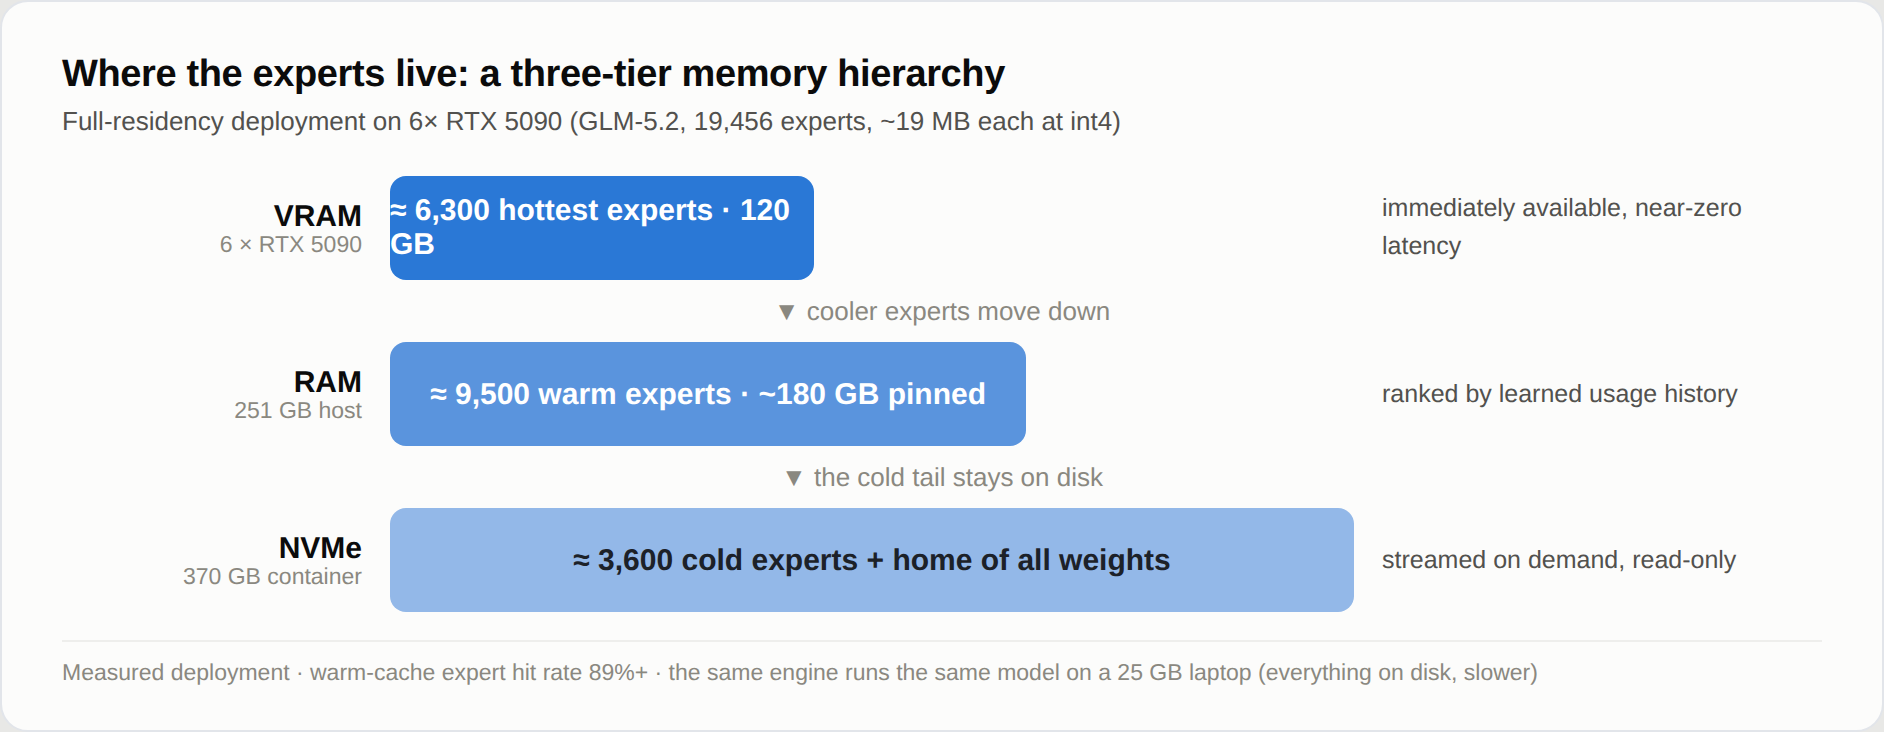 三层驻留架构示意:MoE expert 按”路由热度”在 VRAM(hot)/ RAM(warm)/ NVMe(cold)三层动态升降——这正是 colibri 的核心创新
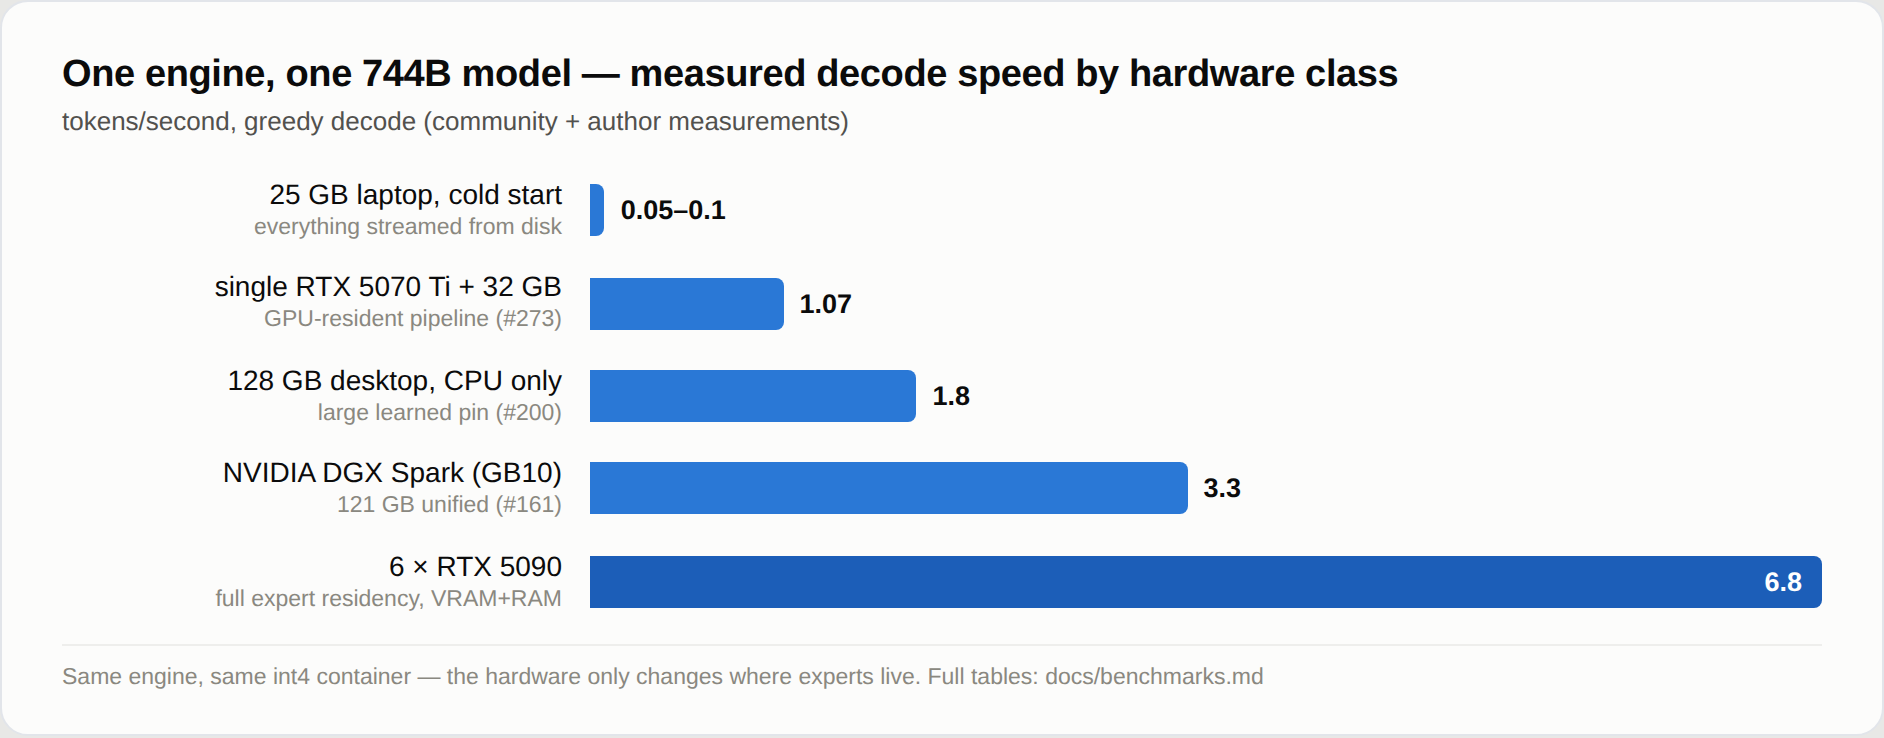 实测解码速度硬件阶梯图——展示了 colibri 在不同硬件档次上的真实吞吐,不是合成 benchmark
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/justvugg/colibri |
| Star / Fork | 27,453 / 3,009(fork 占比 10.96%,显著高于典型 5-8%,说明开发者级社区) |
| 代码行数 | 154,854 行(583 文件;C 41.8% 64.7k + C Header 20.3% 31.4k + Python 29.7% 46k) |
| 项目年龄 | 2.3 个月(first commit 2026-07-01 → latest 2026-09-06) |
| 开发阶段 | 密集开发期(2,057 commit,月均近千,739 commit/30 天,16 个 release tag,平均 4.4 天一个版本) |
| 贡献模式 | 创始人全职 + 核心少数 + 社区贡献者(JustVugg 19.4%,Top 3 占 32.6%,Top 10 占 44.3%,154 名独立贡献者) |
| 热度定位 | 大众热门里的细分蓝海(2.3 月 27k stars 属于”现象级新项目”) |
| 质量评级 | 代码 4/5(LLVM clang-format + 模块化头 + 多平台 CI + ASan/UBSan,但 refactor 仅 1% 累积技术债)· 文档 5/5(44 个 .md / 10,628 行 + 4 语种 README + 24K CHANGELOG + 8 张 README 媒体素材)· 测试 5/5(c/tests 790 次修改 + token-exact oracle 矩阵 + 跨平台 + ARM NEON oracle + Vulkan(Lavapipe)) |
| License | Apache-2.0 |
| 最新版本 | v1.10.2(2026-09-06,Patch release) |
作者视角:为什么存在这个项目
创始人/作者背景
Vincenzo Fornaro(GitHub JustVugg),11.2 年老账号、独立开发者、无公司背景、AI infra 连续创业者。除了 colibri,他还有同思路的 P2P 变体 lumabri(“Run huge MoE models from a swarm of peers, with the colibri engine. Pure C.”),再之前是 nanoeuler(手写 GPT-2 + CUDA)、loomabase(Rust CRDT)、gonk(Go 网关)、judicex(Legal AI)、distillery(dataset distillation)——典型的多领域通才型独立开发者,跨度从底层硬件一路写到分布式协议。
colibri 之前,他在 nanoeuler 时代就已经在做显式 VRAM/RAM 双层 residency;colibri 是把这条经验产品化到 MoE 三层驻留的产物。
问题判断
作者看到的问题:硬件贵 = 推理贵 = 前沿模型只能跑在云上 = 个人和研究者被锁在 API 后面。
现有推理引擎不够用的原因:
- vLLM / EXLlamaV2:GPU-only,缺消费级路径;
- llama.cpp:单 binary + GGUF(100+ 模型族生态强),但 MoE 只支持”全 mmap”——未把 expert 当可流式数据;
- KTransformers:异构 + CPU offload 思路近,但依赖 PyTorch + CUDA toolchain,违反”可在任何机器编译”的可达性。
时机:2026 上半年 GLM-5.2 / DeepSeek V4 Flash / Qwen3.x 大量发布,MoE 总参数爆炸但激活率不变——这是把”权重当作流式数据”的工程化窗口。
解法哲学
- Unix 哲学优先:“We treat an optimization as a hypothesis until a controlled end-to-end A/B shows otherwise”——和 llama.cpp “small + portable” 同源,但加了 MoE 三层驻留这个明确设计点。
- 明确不做什么(CONTRIBUTING.md 原文):“Keep changes focused and preserve Colibri’s dependency-free default CPU path”——不引入 BLAS / GPU 框架 / Python 框架依赖。CUDA toolkit / Metal / Vulkan / HIP 全部做成
CUDA=1/VK=1/METAL=1/HIP=1编译期开关,默认 CPU 路径完全 zero-deps。 - 精度不可静默退化:v1.10.0 changelog 明示 expert tier 不静默改精度——issue #1331 “CUDA VRAM expert tier silently no-ops on int8 checkpoints” 就是这条约束的体现。这是和 llama.cpp 哲学的重要差异:colibri 把”语义不变”做成硬保证。
战略意图
- 产品 + 研究双轨:README 自述 “an inference engine you can run today, and an open research platform”——产品侧
coli chat/serve/web/doctor/tune,研究侧Expert Atlas(#175)、CACHE_ROUTE实验 (#119 反向 profile-guided layout)、int4-rans256-g0离线编码 (#671); - 商业化:无(Apache-2.0),和同思路的 FareedKhan/kimi-k3-in-c 一样属于 founder 路线;
- 生态策略:genuinely open(不是 open-core)。CONTRIBUTING.md 明示 PR 对
dev,main永远过 token-exact oracle。作者在 README 主动列出 “Open hypotheses and experiments” 6 行表——把研究空白以可证伪命题形式公开。
核心价值提炼
创新之处
按新颖度×实用性排序:
- MoE 三层驻留 + 路由驱动 LRU prefetch(JIT for weights)—— 把 llama.cpp 的 mmap 思路推到 MoE 多专家场景。
expert_store.h用 vtable(ColiExpertStoreOps)暴露lookup/release/prefetch/stats/destroy,lease 契约显式(“After a successful lookup(), the caller must call release() exactly once”),CUDA tier 用可选void *gpu镜像字段挂在主 store 上。 - fmt=5 E8-lattice grouped int3 量化(#452)—— 在 int3 下追平甚至超过 int4 质量。这是 colibri 在「量化即研究」上的护城河。
- Expert Atlas(19,456 个 GLM-5.2 expert 实测图谱,issue #175)—— 把 MoE 从”黑盒路由”推向”可解释路由”。
- byte-arithmetic format inference + optional stamp(
docs/FORMATS.md体系)—— 用 O(1) 数学算 format identity,stamp 仅在歧义时兜底;避免”每个格式抢一个编号”的协调成本。 - edge_runtime.h(
COLI_EDGE_ABI_VERSION=2,iOS/Android/WASM 边缘运行时 ABI)—— 提前布局端侧推理,是 roadmap 信号。 - delta_attention + hyper_connections + hybrid_split(纯 C 重写 DeltaNet / 超连接 / Qwen3.x 混合)—— 避开 PyTorch 依赖。
可复用的模式与技巧
- vtable + lease 契约抽象资源池(
ColiExpertStoreOps模式):lookup/release/prefetch/stats/destroy+ 显式 “exactly once” 契约 + 线程安全由实现声明。适用:任何”资源借用 → 归还 → 统计”语义(连接池、文件描述符池、GPU 内存池)。 - byte arithmetic inference + optional stamp(
docs/FORMATS.md):用 O(1) 数学算 format identity,stamp 仅在歧义时兜底;避免”每个格式抢一个编号”的协调成本。适用:容器 / 文件格式 / 协议版本演化。 - conditional
#ifdef+ zero-deps 默认路径(CUDA=1 / VK=1 / METAL=1 / HIP=1):核心功能编译期可完全屏蔽。适用:任何”既要扩展性又要 baseline 可达性”的库。 - token-exact oracle 矩阵(ref_*.json + CI):用上游 transformers 生成 reference,token id 完全一致才算通过。适用:任何”语义不可退化”的 ML 系统(量化、剪枝、编译器优化、kernel 重写)。
- PDA with set-of-stacks walker(
grammar.hGrState):GBNF 子集按字节评估;多栈并行跟踪歧义,深度上限(GR_MAX_STACKS=64)触发 fail-safe 关闭。适用:任何 context-free grammar 评估(JSON-Schema、模板引擎、配置文件校验)。 - AVX2 量化 + 双累加链 IDOT(
fused_simd.hdot_i8idot_avx2_v2):通过cvtepi8_epi16 + madd_epi16 + fmadd一次拉两条累加链节省调度开销;输出与标量路径逐字节相同。适用:任何对数值一致性敏感的 SIMD kernel 加速场景。
关键设计决策
| # | 决策 | Trade-off |
|---|---|---|
| 1 | 三层驻留(VRAM/RAM/NVMe)+ 路由驱动 LRU prefetch vs llama.cpp 的全 mmap | 命中延迟抖动 vs 节省成本;colibri 用 per-layer LRU + learned pinned hot-store + one-layer-ahead prefetch(PILOT)把抖动藏起来 |
| 2 | 单文件 amalgamation(colibri.c 12k + deepseek_v4.c 18k)vs 多 TU | 单 TU 编译快 + 跨平台后端 #ifdef 零成本切换 / 代价是 12k/18k 行巨型文件 + refactor 难 + 新人阅读门槛高;docs/ 44 文件做架构补偿 |
| 3 | 自研容器 fmt1-5 + cfse_pack(熵编码) vs llama.cpp GGUF | fmt 编号冲突风险高(docs/FORMATS.md 顶部专门讲 #465 与 fp8-passthrough 分支争用 fmt=6 的过程教训);容器识别不再依赖编号,靠 byte arithmetic inference + 可选 stamp |
| 4 | 零依赖(仅 libc + pthreads + OpenMP) vs 引入 BLAS / CUDA toolkit as compile-time | 作者把 CUDA toolkit 做成 CUDA=1 可选编译开关,默认 CPU 路径完全 zero-deps——把”可在任何机器上编译”的可达性做成了强制约束 |
| 5 | Token-exact oracle 测试矩阵 vs 仅单元测试 | 每个模型族都有 pinned requirements 文件 + reference transformers 对照,每次 PR 跑 token-exact diff——这是 llama.cpp / vLLM 都没做到的事 |
竞品格局与定位
竞品对比矩阵
| 维度 | colibri | llama.cpp | ktransformers | vllm | ollama | FareedKhan/kimi-k3-in-c |
|---|---|---|---|---|---|---|
| 主语言 | C 41.8% + Python 29.7% | C/C++ | Python + C++/CUDA | Python + CUDA | Go 壳 + C++ 内核 | C99 |
| 默认运行时依赖 | libc + pthreads + OpenMP(CPU) | BLAS + GGML | PyTorch + CUDA | PyTorch + CUDA | llama.cpp 内核 | 仅 libc |
| 容器格式 | fmt1-5 自研 + int4-rans256g0 | GGUF | safetensors / HF | HF | GGUF | 自定义 |
| MoE 三层驻留 | ✅ VRAM/RAM/NVMe | ❌(全 mmap) | ✅(CPU offload) | ❌(GPU only) | ❌(依赖 llama.cpp) | 仅 Kimi K3 |
| 后端 | CPU / CUDA / Vulkan / Metal / HIP | CPU / CUDA / Metal / Vulkan | CPU + CUDA | CUDA only | llama.cpp 内核 | 仅 CPU |
| 模型族覆盖 | 6 大族 | 100+(GGUF 生态) | DeepSeek/Llama/Qwen 等 | 50+ | 100+ | 仅 Kimi K3 |
| Token-exact oracle | ✅ 7 族 | 部分 | 部分 | 部分 | ❌ | ❌ |
| Edge runtime(WASM/iOS/Android) | ✅ edge_runtime.h v2 | 部分(ggml-wasm) | ❌ | ❌ | ❌ | ❌ |
| Star 数(2026-09) | 27,453 | 127,752 | 19,490 | 91,442 | 180,598 | 7,530 |
| 项目年龄 | 2.3 月 | 3+ 年 | 1.5 年 | 4+ 年 | 2+ 年 | < 1 年 |
差异化护城河
5 项组合拳,2026 年仍无第二项目做到:
- fmt1-5 + int4-rans256g0 自研容器(量化即研究)
- MoE 三层驻留 + 路由驱动 LRU prefetch(JIT for weights)
- Token-exact oracle 矩阵(语义不退化硬保证)
- Edge runtime ABI(iOS/Android/WASM)
- 零依赖 CPU 路径 + opt-in 编译开关(CUDA/Metal/Vulkan/HIP)
colibri 是当前唯一一个把”MoE 推理在消费级硬件”完整实现的引擎——KTransformers 思路近但工程哲学相反(依赖 PyTorch),llama.cpp 路线不同(接受 BLAS + GGUF 生态)。
竞争风险
- 最可能被 llama.cpp 替代(如果 llama.cpp 认真做 MoE expert tier + MoE 量化研究):llama.cpp 用户基数大 + GGUF 生态深,但短期内不会快速切换——llama.cpp 哲学是”接受 BLAS + GGUF 生态”,与 colibri “零依赖 + 自研格式” 的工程哲学不同;
- 最可能被 ktransformers 替代(在”异构 + CPU offload”这一具体场景):ktransformers 走 PyTorch 路线对研究者更友好,但同样受 PyTorch 依赖拖累;
- ollama 不会替代:它是分发层不是引擎层;
- vLLM 不会替代:不同层(数据中心 vs 消费级)。
生态定位
在 vLLM(数据中心)/ llama.cpp(通用消费级)/ ktransformers(异构 PyTorch)/ ollama(分发)四者之间,唯一同时满足”前沿 MoE + 消费级 + 研究开放”的项目。
单 binary + family registry dispatch 的工程哲学对比 llama.cpp
- llama.cpp:单 binary 加载任意 GGUF 文件(格式统一 + 算子统一)。优点是生态浅、一份 binary 跑 100+ 模型;缺点是新模型族要被 GGUF 接纳才能进。
- colibri:单族单 binary(每个族一个 .c)+
c/family_registry.py(65k 行 Python)分发到正确 binary。优点是每个族可以独立做架构特定优化(Qwen3.6 的 hybrid split / DeepSeek V4 的 dsv4_mhc 混合头压缩 / Kimi K3 的 MXFP4 Vulkan 路径),不需要 GGUF 委员会同意;缺点是 6 个 binary 要分别构建 + 测试。
这条路线对应 “exotic 架构 + 研究平台” 的定位——llama.cpp 是 “通用消费级分发”,colibri 是 “前沿 MoE 实验场”。
套利机会分析
- 信息差:colibri 在 2.3 月即冲到 27k stars,但 fmt=5 E8-lattice int3 / 三层驻留 prefetch / token-exact oracle 矩阵这些技术细节绝大多数中文技术社区还没消化。相对于 llama.cpp 的中文资料密度,colibri 的中文介绍几乎是空白——这是明确的信息差红利期。
- 技术借鉴:
expert_store.h的 vtable + lease 契约模式可直接套用到任何资源池抽象;fused_simd.h的双累加链 IDOT 是 AVX2 量化 kernel 的可复用范式;grammar.h的 PDA + set-of-stacks walker 是 GBNF / JSON-Schema 评估的工业级实现;docs/FORMATS.md的 byte-arithmetic inference + optional stamp 是容器格式演化的通用模式;- token-exact oracle 矩阵是任何”语义不可静默退化”的 ML 系统都该有的工程纪律。
- 生态位:colibri 填补了”前沿 MoE 在消费级硬件”这个空白——KTransformers 思路近但工程哲学相反,llama.cpp 是不同路线。
- 趋势判断:2026 上半年 GLM-5.x / DeepSeek V4 Flash / Kimi K3 大量发布,MoE 总参数爆炸但激活率不变;colibri 的”JIT for weights + 零依赖 + 三层驻留”是这个趋势的最强解法之一;比 llama.cpp 后发但有差异化(自研 fmt + 三层驻留 + 量化研究)。
风险与不足
- bus factor = 1:JustVugg 个人 commit 占 ~19-59%(统计口径不同),关键路径几乎无 backup maintainer;作者同时维护 lumabri(同思路 P2P 变体)/ nanoeuler / loomabase 等多个项目,精力分散风险显著。
- refactor 仅 1%(2,057 commit 中只有 2 次显式 refactor):单文件 12k/18k 行技术债累积;新人阅读门槛陡峭(虽然 docs/ 44 文件做了补偿,但仍是冷启动阻碍)。
- desktop/ Tauri 壳 MVP 阶段(Rust 仅 14 行):多端交付尚未实质化——
edge_runtime.h暗示了 roadmap 但落地还早。 - colibri/ Python 包空壳(58 行 PEP 621 占位):包结构 vs 实际 CLI 入口(
c/coli113 次修改的 Python 启动器)不一致,新人困惑。 - commit 颗粒度小但 fix:feature = 41.5%:21.0%:暗示 bug 累积期(成熟期密集 patch 阶段);fmt 编号协调脆弱(
docs/FORMATS.md顶部专门讲 #465 与 fp8-passthrough 分支争用 fmt=6 的过程教训,#524 讨论维持 3 周才落定 ID 分配规则)。 - 无 Discord / 社区论坛:所有对话都沉在 GitHub issues,不利长期知识沉淀;CHANGELOG/issue 是社区交流的唯一载体。
- 27k stars 留存待观察:相当比例是”被 README 打动但未跑通”——MoE 模型 744B-2.8T 下载动辄 TB 级,普通用户的”初体验”门槛不低。
行动建议
如果你要用它
- colibri 适合:(1) 个人研究者想本地跑前沿 MoE;(2) 量化研究社区想探索 fmt1-5 / cfse_pack;(3) 想把 MoE 推理部署到消费级硬件(32GB RAM 跑 Kimi K3 已有 issue 反馈);(4) 需要 iOS/Android/WASM 边缘推理(edge_runtime.h v2 ABI 已就位)。
- 对比竞品:需要 100+ 模型族选 llama.cpp;需要数据中心高吞吐选 vLLM;研究者想要 PyTorch 工具链选 KTransformers;分发/UX 层选 ollama;colibri 是”前沿 MoE 特定场景下的最优解”。
如果你要学它
重点关注这些文件(按优先级):
| 优先级 | 文件 | 行数 | 阅读目的 |
|---|---|---|---|
| 1 | c/colibri.c | 12,082 | GLM-5.2 主引擎;理解 MoE 三层驻留 + 路由驱动 prefetch(PILOT)的最佳入口;含 OpenAI serve loop + MLA attention + sigmoid router + per-expert 流式 |
| 2 | c/expert_store.h | 103 | 三层驻留抽象的全部秘密——vtable(lookup/release/prefetch/stats/destroy)+ lease 契约注释 + CUDA tier 镜像字段 |
| 3 | c/fused_simd.h | 156 | FUSED3 AVX2 内核:双累加链 IDOT + AVX2 量化 + gate/up 共享输入;bit-identical 注释 + 数值证明 |
| 4 | c/deepseek_v4.c | 18,346 | 最大的引擎;DeepSeek V4 Flash 特定优化(含 MLA + mHC);配合 dsv4_quant.h / dsv4_mhc.h 阅读 |
| 5 | c/family_registry.py | 65,533 | 整个项目最大单文件;模型族分发逻辑 + engine_for();每个 FamilyDescriptor 是 frozen dataclass |
| 6 | c/openai_server.py | 4,336 | 完整 OpenAI 兼容 HTTP 网关;可独立学习的服务框架(tool calling / streaming / logprobs / function calling) |
| 7 | c/grammar.h | 364 | GBNF 字节级 grammar 约束解码——PDA with set-of-stacks walker;可直接学到 JSON-mode function calling 加速原理 |
| 8 | c/json.h | 198 | 自研极简 JSON 解析;含 GHSA-2qrj fail-closed 修复历史 + UTF-8 处理 + 堆增长字符串策略 |
| 9 | c/backend_cuda.cu | 2,835 | CUDA 后端实现参考;含 routed expert tier 镜像(与 expert_store.h::gpu 字段配合) |
| 10 | c/edge_runtime.h + c/edge_runtime.c | 200 | Edge runtime ABI(COLI_EDGE_ABI_VERSION=2);iOS/Android/WASM 边缘运行时契约——roadmap 信号 |
如果你要 fork 它
可改进的方向:
- Multi-tenant 三层驻留:当前
ColiExpertStoreOps是单机抽象;引入 P2P 节点资源调度(作者已经在 lumabri 项目里做了),把 colibri 从”单机引擎”扩展到”去中心化推理集群”; - fmt 编号自动化分配:目前
docs/FORMATS.md顶部讲了 #465 与 fp8-passthrough 争用 fmt=6 的过程教训;引入 registry 服务或 git submodule 分仓管理 fmt 编号; - Edge runtime 落地:
edge_runtime.hv2 ABI 已就位但实测还早;iOS / Android / WASM 三端的真实部署 + benchmark 是空白; - 桌面端 Tauri 壳:当前 Rust 仅 14 行;可以补一个 native OpenAI 客户端壳 + 系统托盘 + 自动更新;
- 量化研究可视化:fmt1-5 的量化误差分布、Expert Atlas 的交互式聚类分析还没有图形化工具——这是社区贡献的低垂果实;
- 重命名统一:消除
docs/fmt2.old(60 次修改的旧格式兼容层)+c/glm.c(已被 colibri.c 取代的旧实现,124 次修改)等遗留路径; - 增加 refactor commit:把 colibri.c 12k + deepseek_v4.c 18k 的单文件按模块拆分(虽然破坏了 amalgamation,但提升新贡献者参与度)。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 未收录 |
| Zread.ai | 未收录 |
| 官网 | https://justvugg.github.io/colibri(含交互式 3D Expert Atlas) |
| 关联论文 | 无(pure engineering 项目,但 fmt=5 E8-lattice 是量化研究参考) |
| Discord | 无(社区对话主要在 GitHub issues) |
| 在线 Demo | https://justvugg.github.io/colibri(交互式 3D 专家可视化;无 Playground chat 演示) |