Yuxi-Know 深度分析报告
一句话总结
一个由 NLP 博士生驱动的「RAG + 知识图谱 + 多智能体」三合一开发平台,将学术界的知识图谱研究与工程界的 RAG 实践在架构层面原生融合。
值得关注的理由
- 细分赛道无直接竞品:在「知识图谱原生集成 + Agent 编排」的组合定位上,开源社区中竞争者极少,RAGFlow/Dify 均未提供图谱的一等支持
- 增长势头强劲:近 6 个月月均 300+ stars,2025-12 单月超千星,4,800+ stars 仍在加速增长
- 学术背景塑造差异化:作者的知识图谱博士研究背景,让图谱不是后期追加功能,而是从架构层面就作为一等公民设计
项目展示
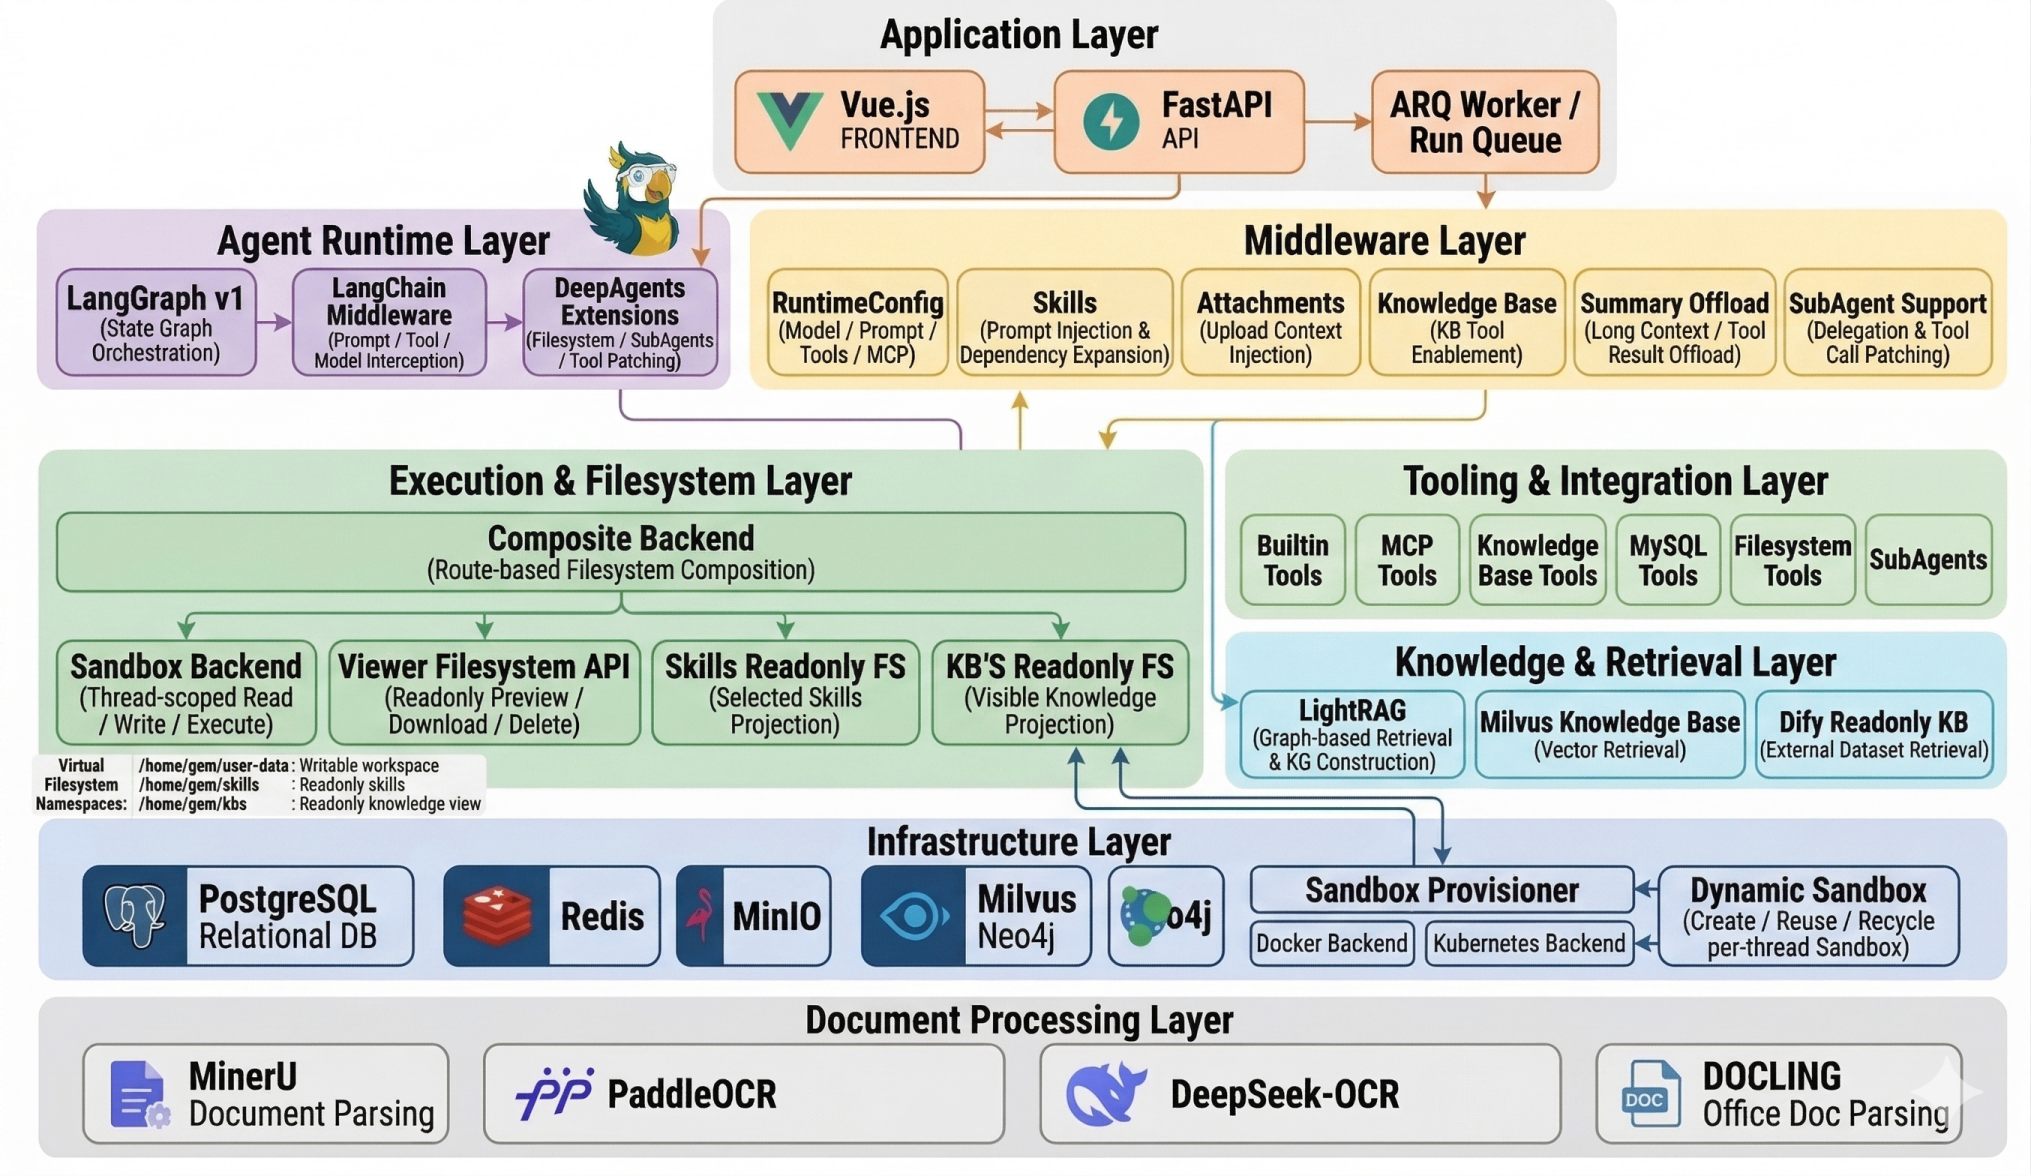 系统架构总览:三层解耦微服务架构,应用层 / 任务执行层 / 持久化层
 主界面聊天效果,含知识图谱可视化交互
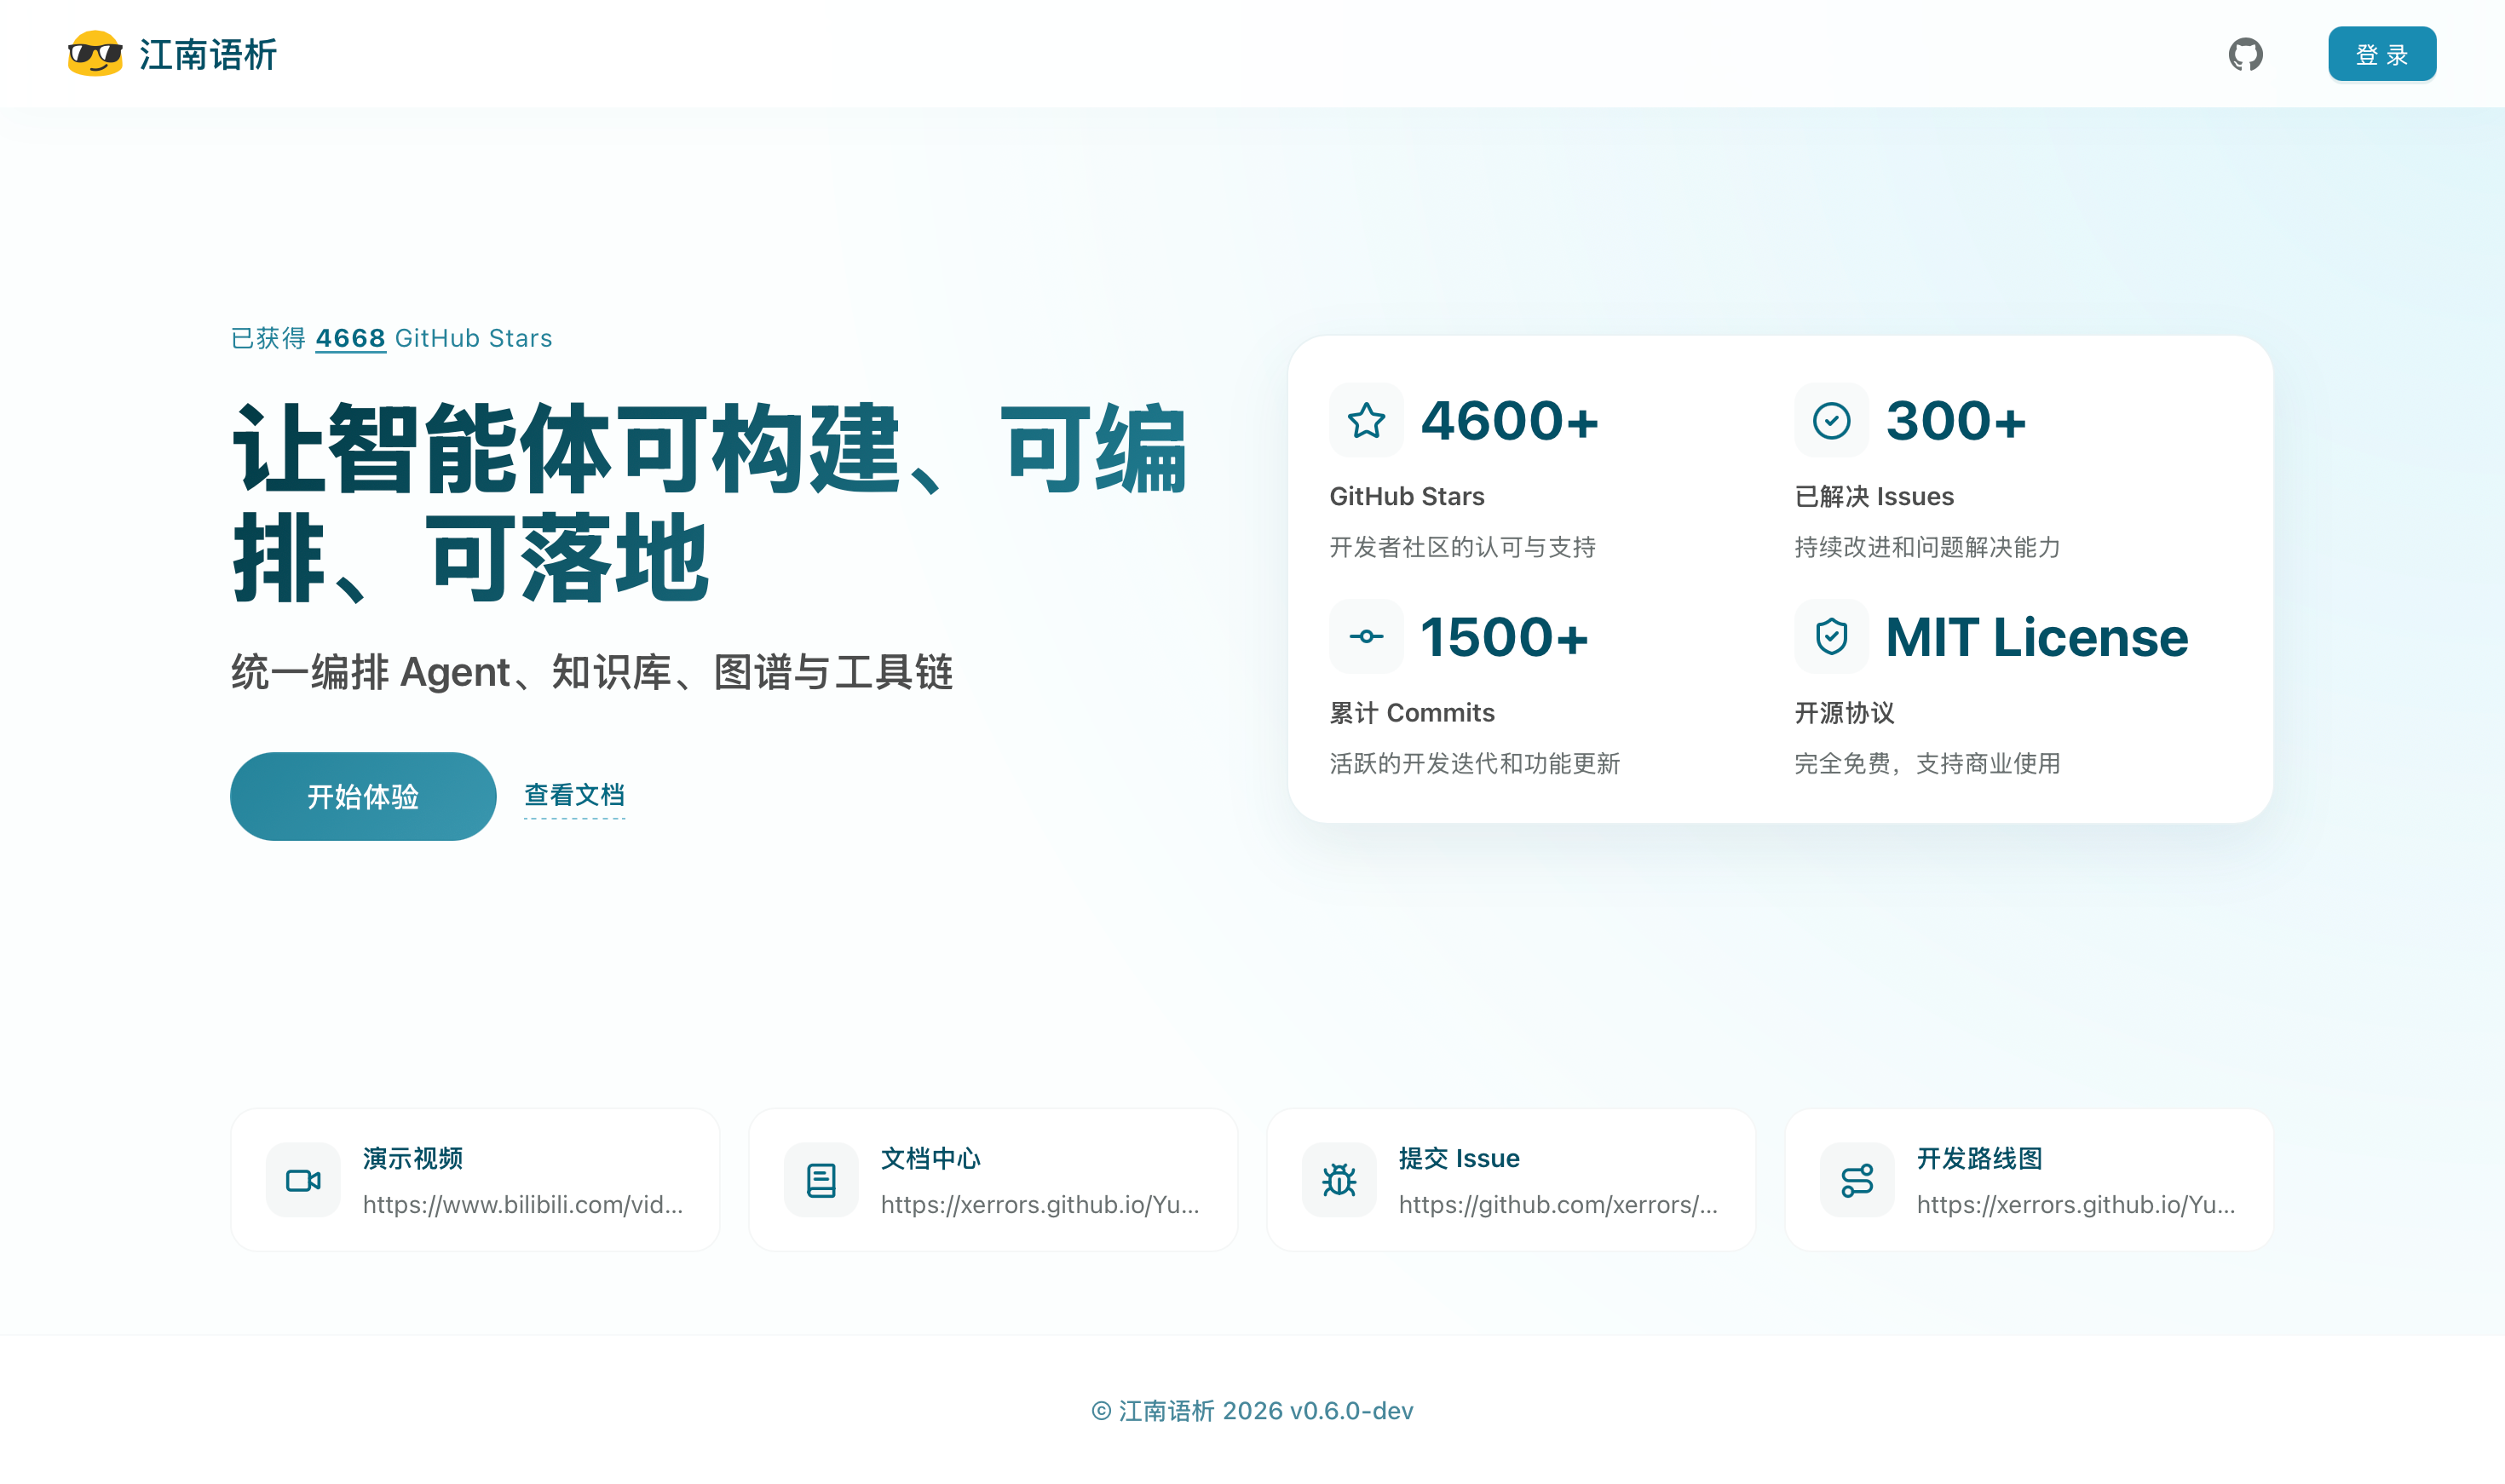 产品首页展示,体现 UI 设计成熟度
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/xerrors/Yuxi-Know |
| Star / Fork | 4,819 / 657 |
| 代码行数 | 91,818 行(Python 42%, Vue/JS 35%, YAML 5%) |
| 项目年龄 | 21 个月 |
| 开发阶段 | 密集开发(近 30 天 250 commits,历史峰值) |
| 贡献模式 | 单人主导(xerrors 贡献 89%,15 位贡献者) |
| 热度定位 | 中等热度 / 细分市场头部 |
| 质量评级 | 代码[B+] 文档[B+] 测试[B-] |
作者视角:为什么存在这个项目
创始人/作者背景
张文杰(xerrors),江南大学计算机科学与技术 2023 级博士在读,研究方向为 NLP/知识图谱。曾发表关系分类论文 LabelPrompt(arXiv:2302.08068)。GitHub 账号注册 8 年,Yuxi-Know 是其核心投入项目(4,819 stars,远超第二名 mvllm 的 15 stars),1,545 次提交展现了极高的个人投入度。典型夜间开发者,22:00-02:00 为编码高峰,周末与工作日投入几乎均等。
问题判断
在博士研究中发现,单纯的向量检索在处理实体关系、因果链等结构化知识时表现不佳——这恰恰是知识图谱的强项。然而学术界的图谱工具和工程界的 RAG 平台之间存在鸿沟:学术论文给出了理论框架(如 LightRAG 的图增强检索),但缺乏一个可以让研究者「即用」的全栈平台来验证这些想法。时机上,2024 年 RAG 技术日趋成熟但「RAG + 知识图谱」的工程化实践仍处于空白期。
解法哲学
「集成而非重造」——核心策略是将业界最佳组件以中间件模式编排在一起:
- 图谱构建直接引入 LightRAG 包
- 多智能体编排基于 LangGraph v1
- 文本分块参考 RAGFlow 的 chunking 策略
- 沙盒架构借鉴字节 DeerFlow 的 provisioner 模式
明确不做的事:不做通用 Agent 平台(那是 Dify 的赛道),不做纯 RAG 引擎(那是 RAGFlow 的领地),聚焦于「知识密集型智能体」这个细分场景。
战略意图
从版本演化看,项目正沿着清晰路径发展:v0.3 以前是「RAG + 知识图谱核心闭环」,v0.4-v0.5 引入 LangGraph/MCP 转向平台化,v0.6.0 完成沙盒/Skills/SubAgents 的平台化形态。这反映了从「学术验证工具」到「面向生产的智能体开发平台」的战略升级。目标用户群扩展为中小型政企单位和科研团队。
核心价值提炼
创新之处
-
RAG + 知识图谱原生融合(新颖度 4/5,实用性 4/5) 将 LightRAG 图谱构建与 Milvus 向量检索在架构层面并列为知识库的两种一等实现。知识图谱可直接参与 Agent 推理(通过
query_knowledge_graph工具),前端提供交互式图谱可视化组件。在开源 RAG 平台中较为罕见。 -
中间件驱动的智能体能力编排(新颖度 3/5,实用性 5/5) 将「一个大 Agent 配所有能力」拆解为 10 个可组合中间件:知识库、Skills、MCP、摘要卸载、子智能体、文件系统等。特别是
SummaryOffloadMiddleware同时处理上下文压缩和大型工具结果卸载,解决长对话的 context window 瓶颈。 -
CompositeBackend 虚拟文件系统(新颖度 4/5,实用性 4/5) 借鉴 Unix VFS 思想,将沙盒、知识库、Skills 三种异构存储统一为虚拟文件系统,Agent 通过标准文件操作访问所有资源。路径前缀自动路由到对应后端。
-
Skills 系统:提示词即能力(新颖度 3/5,实用性 4/5) 将结构化提示词封装为可安装、可版本化、可依赖展开的 Skills。「提示词工程的包管理」思路,将离散的 prompt engineering 规范化为可复用组件。
-
Context 即配置(新颖度 3/5,实用性 4/5) 利用 Python
dataclass+Annotated类型注解,每个字段通过 metadata 声明 UI 名称和选项列表,自动反射生成前端配置 schema。
可复用的模式与技巧
- TOML 差分配置持久化:只将用户修改过的字段写入配置文件,未修改项使用代码默认值
- Checkpointer 三级降级:PostgreSQL → SQLite → InMemory,确保 LangGraph state 持久化在任何环境都能工作
- LITE 模式启动:通过环境变量跳过重量级组件加载,降低开发门槛
- 工具注册装饰器:
@tool(category="buildin", display_name="计算器")同时完成 LangChain tool 注册和 UI 元数据注册 - 沙盒知识库只读映射:按「用户可访问 ∩ Agent 已启用」的交集暴露文件,平衡安全性与可用性
关键设计决策
- 中间件管道 vs God Class:将 Agent 能力拆为正交中间件,代价是中间件顺序的隐式依赖关系
- 知识库工厂 + ABC:统一接口支持 Milvus/LightRAG/Dify 三种异构实现,但 DifyKB 只读实现违反了 ISP
- ARQ + Redis 异步任务:Agent 运行提交为后台任务,SSE 推送实时进度,代价是 Redis 成为关键依赖
- RAGFlow-like 分块策略:naive/qa/book/laws 四种模式覆盖常见文档类型,「一切转 Markdown」在复杂格式上有信息损失
- Provisioner 微服务:独立沙盒调度支持 memory/docker/kubernetes 三种后端,增加部署复杂度但换来安全隔离
竞品格局与定位
竞品对比矩阵
| 维度 | Yuxi-Know | RAGFlow | Dify | MaxKB |
|---|---|---|---|---|
| 知识图谱原生集成 | 原生一等支持 | 无 | 无 | 无 |
| 多智能体编排 | LangGraph v1 | 无 | 可视化工作流 | 基础 |
| 沙盒代码执行 | Docker/K8s | 无 | 有 | 无 |
| 文档解析能力 | 良好(参考 RAGFlow) | 优秀(DeepDoc) | 良好 | 良好 |
| 社区规模 | 4.8k stars | 77k stars | 136k stars | 20k stars |
| 部署复杂度 | 高(10+ 服务) | 中 | 中 | 低 |
| 中文社区亲和力 | 高 | 高 | 中 | 高 |
差异化护城河
知识图谱的原生集成不是简单的功能添加,而是贯穿架构的设计决策(知识库工厂的 LightRAG 实现、图谱可视化前端组件、图谱参与 Agent 推理的工具链)。竞品想要复制需要大幅重构知识库层。作者的 NLP/知识图谱学术背景为这种深度集成提供了持续的技术判断力。
竞争风险
最大风险来自 Dify 和 RAGFlow 添加图谱支持——如果它们在未来版本中集成知识图谱,凭借数十倍的社区规模优势,可能快速侵蚀 Yuxi 的差异化。另一个风险是 GraphRAG 等微软开源项目的成熟,可能使图谱 + RAG 的实现门槛大幅降低。
生态定位
在 RAG 生态中填补了「知识图谱 + Agent 平台」的空白。不与 RAGFlow(纯 RAG 引擎)或 Dify(通用 Agent 平台)正面竞争,而是在两者交叉的细分赛道上建立地位。特别适合需要结构化知识推理的场景:学术研究、法律文档分析、医疗知识库、企业知识管理。
套利机会分析
- 信息差: 4,800 stars 的中等热度项目,但在「RAG + 图谱」细分赛道无直接竞品,属于细分市场的头部。增长势头(月均 300+ stars)表明市场认知正在形成
- 技术借鉴: 中间件管道模式、CompositeBackend VFS、Skills 系统、TOML 差分配置、Checkpointer 降级策略均可直接移植到其他 LLM 应用
- 生态位: 填补了「知识图谱参与 Agent 推理」的开源工具空白,尤其在中文学术和教育市场有独特价值
- 趋势判断: 知识图谱 + RAG 是 2025-2026 年的明确技术趋势(NeurIPS’24 HippoRAG、微软 GraphRAG 等),Yuxi 在工程化平台层面有先发优势
风险与不足
- Bus Factor = 1:90% commit 来自单人(xerrors),项目的持续性高度依赖一位博士生的投入
- 部署复杂度高:需要 PostgreSQL + Milvus + Neo4j + MinIO + Redis 等 10+ 服务,远高于竞品的部署门槛
- 测试覆盖不足:虽有 56 个测试文件和分层结构,但无覆盖率报告,代码/注释比 8:1 文档化程度偏低
- 并发稳定性:Issue #279 揭示的多对话并发问题至今未关闭,生产级可靠性有待验证
- 知识图谱实效性:Issue #50、#153 显示图谱在早期版本中「看得到但用不了」,虽已修复但反映了图谱集成的工程难度
- 社区规模差距:与 RAGFlow(77k)、Dify(136k)差距明显,企业采用信心需要时间积累
行动建议
- 如果你要用它: 适合需要知识图谱参与推理的场景(法律、医疗、学术)。如果只需要纯 RAG 问答,RAGFlow 更成熟;如果需要通用 Agent 工作流,Dify 生态更丰富。建议先用 LITE 模式评估核心功能,再逐步启用图谱和沙盒
- 如果你要学它: 重点关注
backend/package/yuxi/agents/middlewares/(中间件管道模式)、backend/package/yuxi/knowledge/(知识库工厂 + 图谱集成)、backend/package/yuxi/agents/backends/(CompositeBackend VFS) - 如果你要 fork 它: 可改进方向包括:分离 ReadableKB/WritableKB 接口(解决 DifyKB 的 ISP 违反)、增加中间件依赖声明机制、添加测试覆盖率报告和性能基准测试、简化部署(考虑 SQLite 替代 PostgreSQL 的轻量模式)
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | deepwiki.com/xerrors/Yuxi |
| Zread.ai | 已收录(需登录访问) |
| 关联论文 | LabelPrompt(作者发表,关系分类方向) |
| 在线 Demo | B 站演示视频 |