GitHub推荐:90 天 4.2K stars:一个人 + Claude Code 复刻巴菲特投研团队,这套 Skills 怎么跑出 +69% 收益
一句话总结
把巴菲特/芒格/段永平/李录四大师方法论做成 18 个 Claude Code Skill 入口 + 4 Agent 并行对抗 + Python Decimal 工具链,用一台笔记本 + 一个 AI CLI 跑出 2024 年 +69.29% / 2025 年 +66.38% 的可审计研报。
值得关注的理由
- 方法论产品化范本:不是又一个「让 AI 帮你分析股票」的玩具 prompt 包,而是把四大师方法论变成可复用、可审计的 18 个 Skill,且同时跑在 Claude Code 与 OpenAI Codex 两个 CLI 上。
- 反 LLM 幻觉的工程化纪律:不信任 LLM 心算——所有 PE/市值/三情景估值都强制走 Python
decimal.Decimal工具;15% 报告数据抽检 + 1% 容差判决,可挂 CI。 - 真实 dogfooding 留痕:作者把从 ❌ 改 ✅ 的「美团挑战」完整记录在
ai_CLAUDE.md,比 +69% 收益数字更可信——这是真实迭代的证据,不是事后包装。
项目展示
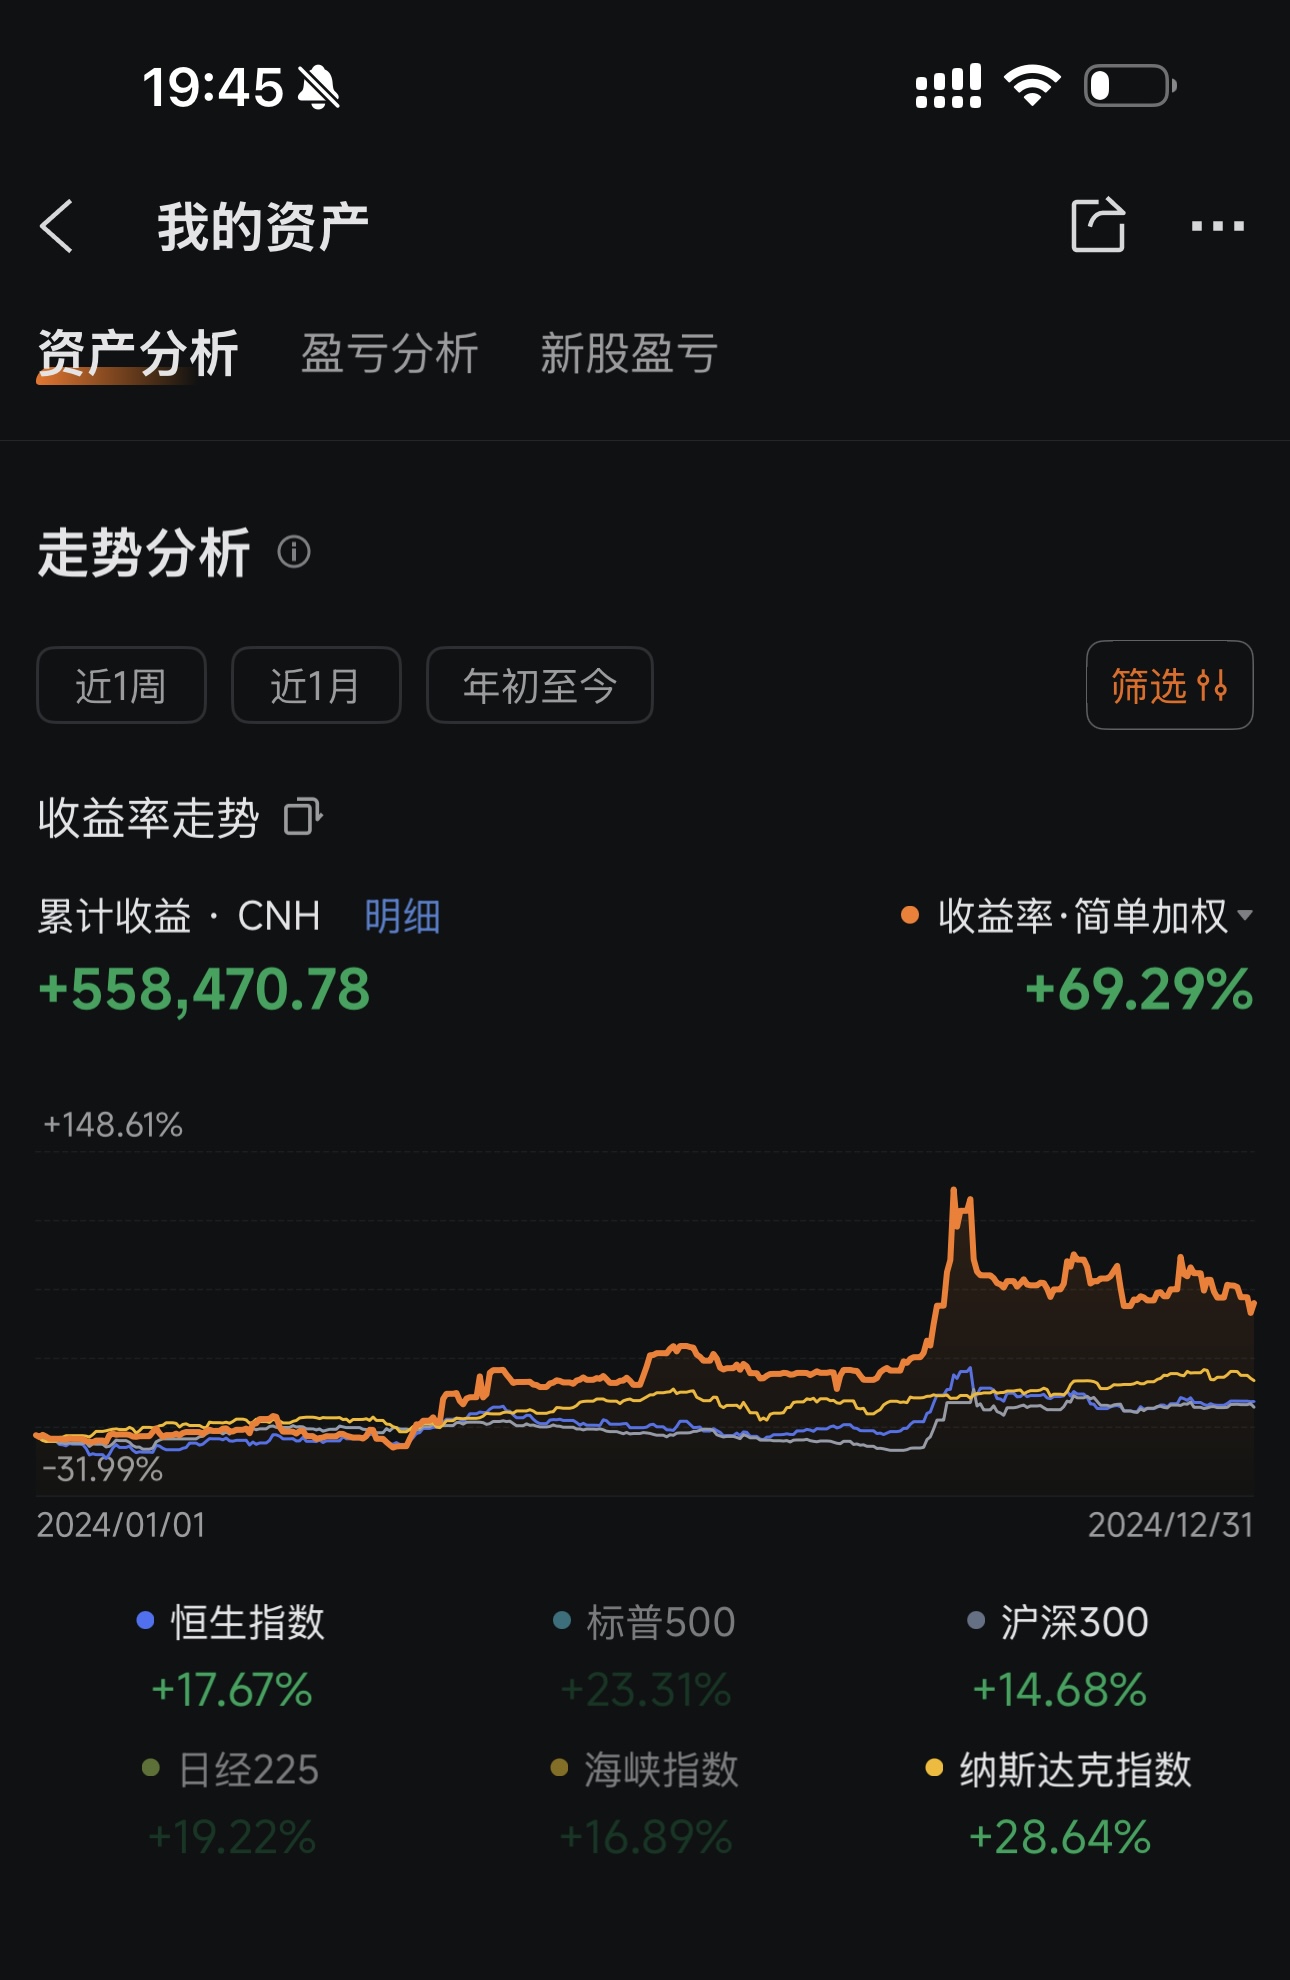 — 类型: hero(富途账户截图,2024 年跑赢标普 500 约 46pp)
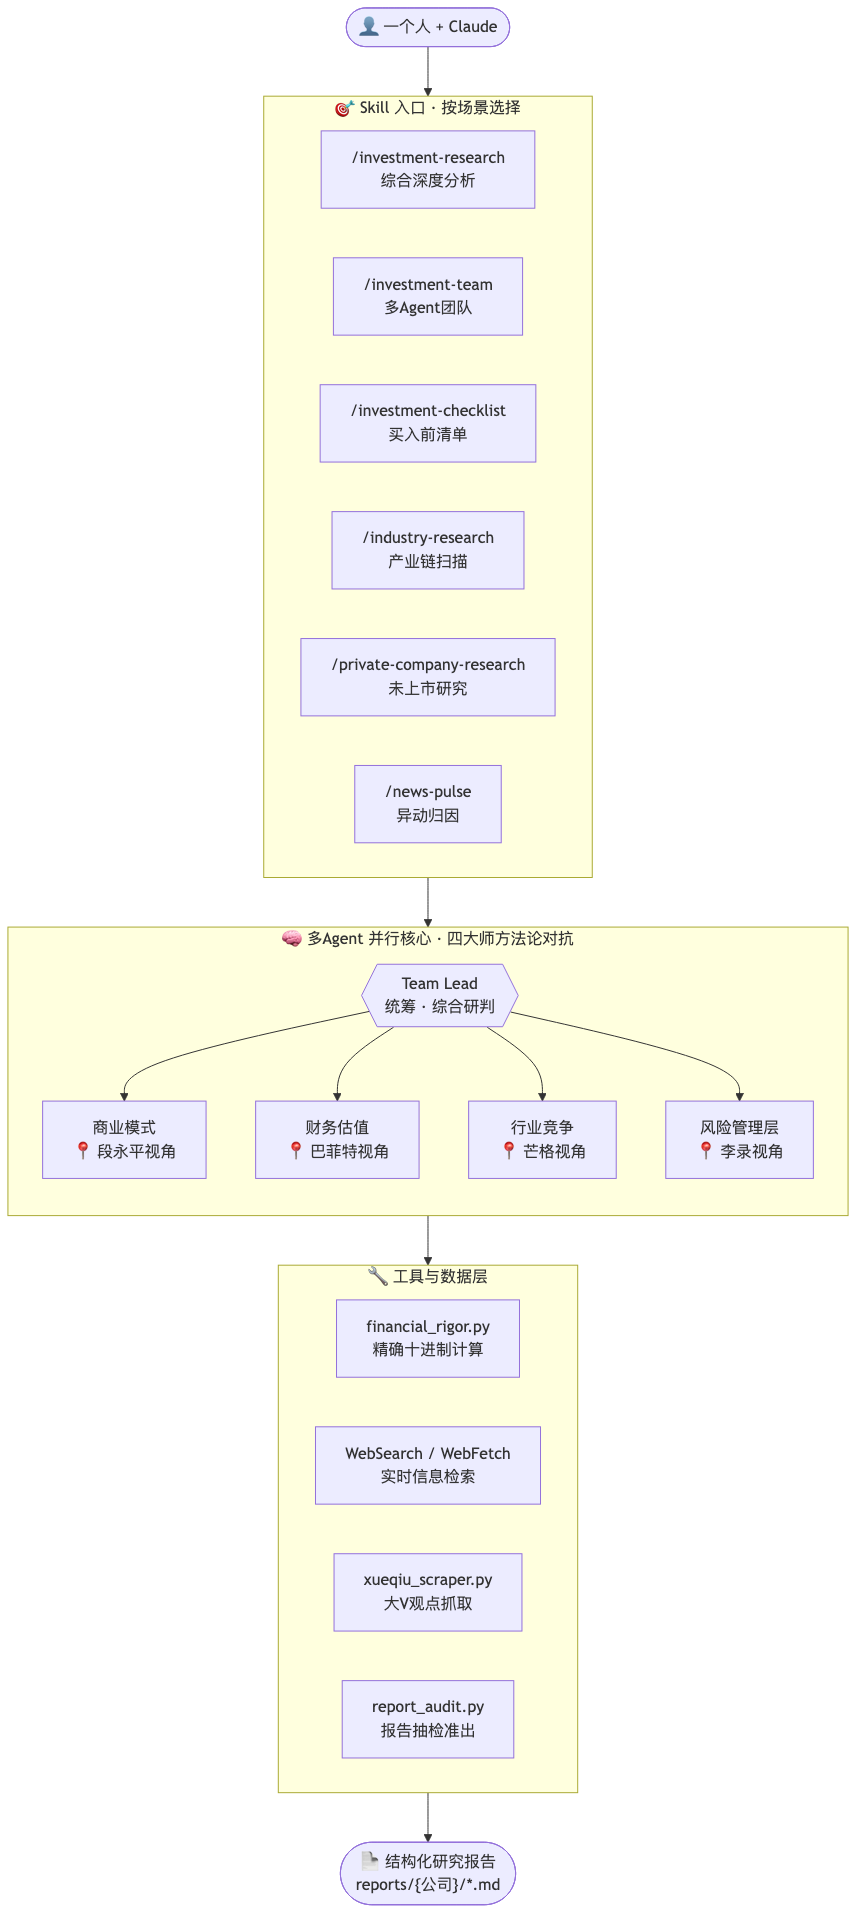 — 类型: architecture(Skill 层 → Agent 层 → Tool 层 三层架构图)
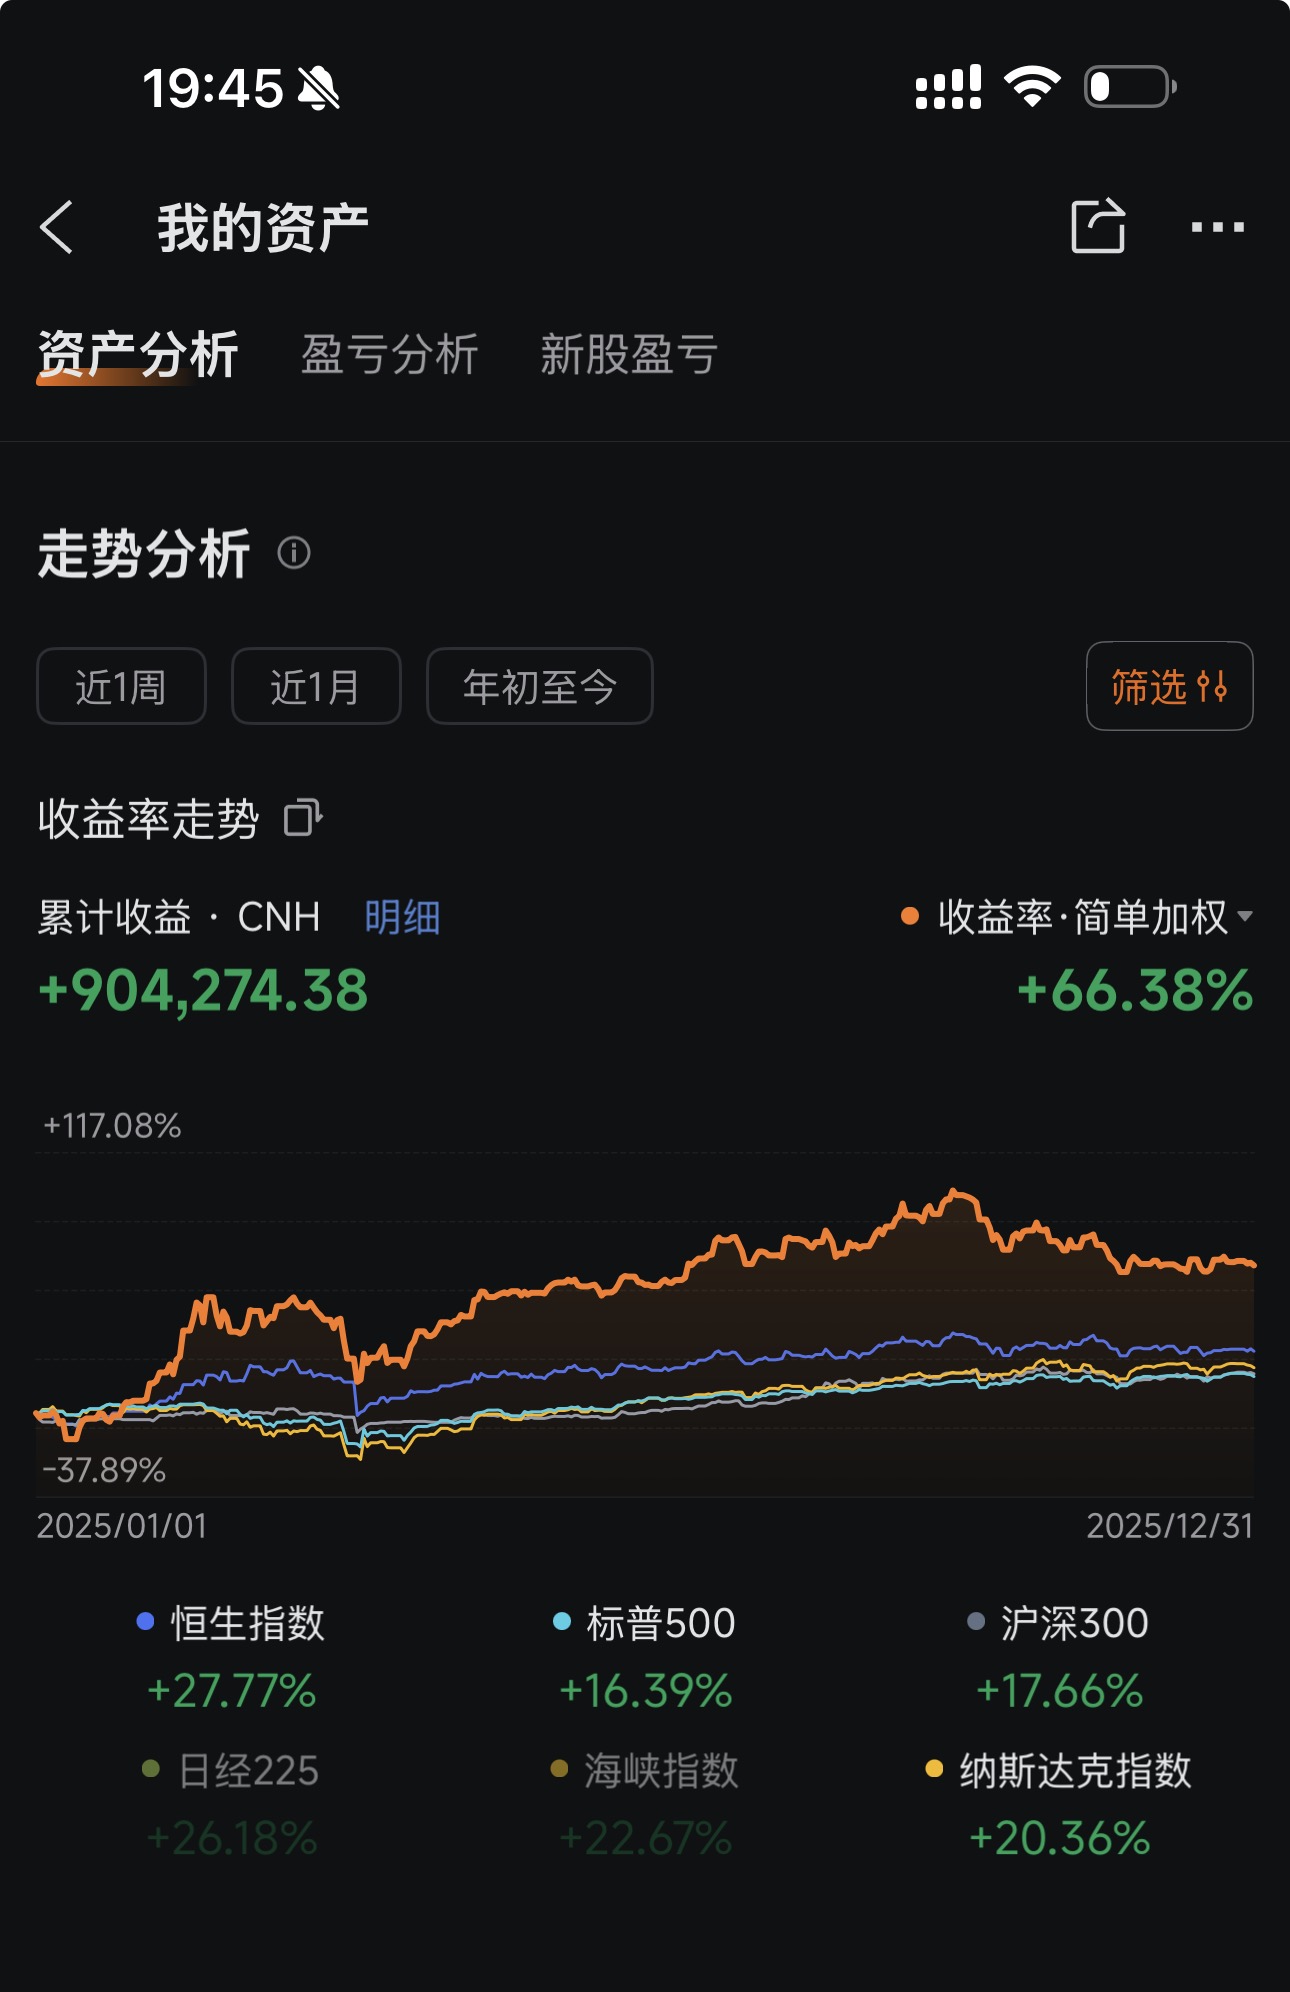 — 类型: screenshot(2025 收益证明,与 2024 一起构成 track record)
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/xbtlin/ai-berkshire |
| Star / Fork | 4,217 / 586 |
| Watcher | 12 |
| 代码行数 | 2,637 行 Python(vs ~30 万行 Markdown 报告) |
| 语言分布 | Python 95.2% / JSON 2.8% / Shell 1.9% / YAML 0.2% |
| 文件数量 | 2,195(含 18 个 Skill + 200+ 研报) |
| 项目年龄 | 2.7 个月(2026-04-07 创建) |
| 开发阶段 | 密集开发(30 天 752 commit,仍在加速) |
| 开发模式 | 职业项目(周末 29% / 深夜 37% 被 cron 推高) |
| 贡献模式 | Claude bot 53% + xbtlin 36% + linxuan 8% ≈ 97%,典型「人 + AI Agent」协作 |
| 热度定位 | 中等热度,爆发型增长(117 star 集中在 24h 采样窗口) |
| 质量评级 | 代码良好 / 文档优秀 / 测试不足 / 无 CI |
作者视角:为什么存在这个项目
创始人/作者背景
Xbt Lin(xbtlin),12.3 年 GitHub 账号,2026 年才押注「LLM × 价值投资」垂直赛道。Bio 写「Exploring LLMs × value investing」,从账号内 fork 列表看(buffett-chinese、claude-code-source-code、cv-arxiv-daily),是价值投资长期读者 + 认真消化过 Claude Code 上游代码的工程化用户。中文母语,定位大中华区散户+专业投资者。
问题判断
作者看到三个别人没解决透的问题:
- LLM 心算不可靠——PE 算错、港币/人民币混淆、小数点漂移
- 「资料多=确定性高」的幻觉——LLM 拿一堆资料自动补完一个伪精确结论
- 单视角分析无法制造真实方法论对抗——巴菲特说「够便宜」时,没人追问「10 年后还在吗」
时机选择:押注 2024-2026 LLM 编程能力跃迁 + Code CLI 普及,单兵 + AI Agent 能达到过去小型投研团队的产能,垂直整合「投研方法论+LLM 工具」窗口期到来。
解法哲学
- 反「AI 即结论」:明确反对「AI 给我一篇漂亮的分析」,强制四视角对抗 + 强制结论(通过/不通过/灰色)+ 强制价格区间 + 强制镜子测试(5 句话说不完整=不买)
- Unix 哲学 vs 瑞士军刀的折中:18 个 Skill 各管一段,但每个 Skill 内部都是同一套「信息丰富度评级 + 工具验算 + 多 Agent 并行 + 数据抽检」流程
- 明确不做什么:不接实时数据(Wind/Bloomberg/MCP 是路线图 P1)、不做回测、不做量化交易(定位是「拿来做决策的研报」而非 alpha 引擎)、不用 LLM 心算
战略意图
项目是作者的核心产品而非基础设施,开源策略是 genuinely open(MIT),不打算做 SaaS/托管版。商业化路径是作者自己公众号 + 实盘业绩(README 称「两年 146 万收益」),把项目作为引流 + 个人品牌建设。单作者 12.3 年账号垂直押注「LLM × 价值投资」,不像 augur / valinvest 那种「AI for finance」通用型,而是把「中国散户 + 四大师方法论 + Claude/Codex CLI」这三个 niche 焊死。
核心价值提炼
创新之处
-
A/B/C 信息丰富度评级 + 三套研究策略 — 不是给所有公司套同一个框架,而是先按信息丰富度分级,每级对应不同研究策略:A 级警惕共识陷阱、B 级强制置信度标注、C 级切换到第一性原理模式(聚焦 4 个底层问题)。
ai_CLAUDE.md里有「信息丰富度 ≠ 投资确定性」的元认知提醒。新颖度 4/5,实用性 4/5,可迁移性 5/5。 -
Python Decimal + 三情景估值的「工具外包心算」模式 — 不信任 LLM 做金融心算,把 PE/PB/ROE/FCF Yield/三情景估值/Benford 检测写成 6 个 CLI 子命令(
tools/financial_rigor.py),Skill 文档里嵌入 Bash 调用片段强制 LLM 调用。零外部依赖(仅 Python stdlib)。新颖度 3/5,实用性 5/5,可迁移性 5/5。 -
四大师方法论对抗(Buffett-Munger-Duan-Li Lu as adversarial agents) — 不是把四个大师的视角并列展示(分工),而是让他们「互为质询」:巴菲特说「够便宜」,李录追问「10 年后还在吗」;段永平说「好生意」,芒格追问「怎么会死」。这种对抗制造真实张力,避免「四份报告拼贴」。新颖度 4/5,实用性 3/5,可迁移性 3/5。
-
report_audit.py自动从 Markdown 提取数字 + 15% 抽样 + CI 化 PASS/FAIL 判决 — 借鉴软件测试覆盖率思想,从 markdown 报告自动提取所有数字+单位(5 种正则模式:百分数/亿元/x 倍数/万亿/表格行),随机抽 15%,输出 JSON 模板让人工回填独立信源值,最后输出 PASS/FAIL 判决和 FAIL 时非零退出码——可挂 CI。新颖度 4/5,实用性 5/5,可迁移性 4/5。 -
Claude Code + Codex 双客户端单源派生(skills/ → codex-skills/ 通过 sync-codex-skills.py) —
skills/*.md作为 canonical source,scripts/sync-codex-skills.py自动生成 Codex 端codex-skills/*/SKILL.md,每份生成的 Codex skill 头部带「Codex adapter note」翻译 Claude-only 概念到 Codex 等价物。AGENTS.md是 Codex 端的宪法文件,独立于 Claude Code 的CLAUDE.md。新颖度 4/5,实用性 5/5,可迁移性 4/5。
可复用的模式与技巧
-
三段式 Skill 模板(前置评估 → 主流程 → 数据抽检) — 18 个 Skill 几乎都遵循这个结构:开头强制「AI 研究偏见自觉」(A/B/C 评级),中间是「4 Agent 并行 + 工具校验 + 大师追问」主流程,结尾是「数据抽检 PASS/FAIL」。任何「LLM 做分析+判断」的项目都可套用。
-
Skill-as-Markdown-as-Service — 把 Skill 写成 markdown 而不是代码(不是 Python decorator 也不是 JSON Schema),方便人编辑、版本控制、跨 LLM CLI 移植。
-
Tool-as-CLI-with-Argparse — 工具全部 CLI 化(
financial_rigor.py verify-market-cap等子命令),Bash 可调用、LLM 可调用、CI 可调用(verdict 命令非零退出码)。 -
canonical-source 单源派生 — 双客户端场景下维护一份 canonical markdown + 自动派生 + adapter note,比双份手工维护更可靠。可推广到 Claude Code + Codex、Cursor + 其他 CLI 等组合。
-
Benford 定律 CLI 化 — 把「首位数字分布异常=可能造假」这个审计技巧做成 CLI 工具,让 LLM 在处理财报时自动跑一遍。
关键设计决策
-
决策: 三层 Skill → Agent → Tool 架构,而不是单 Agent + Function Calling
- 问题: LLM Agent 在长 prompt 下会「疲劳」——前半段推理严谨、后半段开始偷懒拼凑结论
- 方案: Skill 文件只声明流程,Agent 层强制并行(不是 chain),Tool 层把「必须用 Python 计算」的部分完全外包
- Trade-off: 牺牲响应速度(4 Agent 并行可能 2-3 分钟)和 token 成本(Issue #11 「太费 token 了」),换四视角独立性 + 数据可审计性
- 可迁移性: 高
-
决策: Python
decimal.Decimal强制替代 LLM 心算,工具调用嵌入 Skill 文本- 问题: LLM 心算 PE/市值有约 5-15% 的错误率
- 方案:
tools/financial_rigor.py提供 6 个子命令,全部使用decimal.Context(prec=28, ROUND_HALF_EVEN)精确十进制计算 - Trade-off: 多一道 Bash 调用的延迟;放弃了 LLM 直接回答的「丝滑感」
- 可迁移性: 高
-
决策: A/B/C 信息丰富度评级 + 镜子测试 + 8 条快速否决清单的「反偏见三件套」
- 问题: LLM 最危险的失败模式不是「答错」而是「用推测填满确定性」
- 方案: ①每个 Skill 开头强制信息丰富度评级;②镜子测试(5 句话说不完整=不买);③8 条快速否决清单作为硬性红线
- Trade-off: 牺牲了「看起来专业」的报告完整度(C 级公司可能只产 1 页核心问题清单)
- 可迁移性: 高
-
决策: 双客户端兼容(Claude Code + Codex)通过
sync-codex-skills.py单向派生- 问题: Claude Code 和 OpenAI Codex 是两个并行的 Code CLI,方法论和子命令体系完全不同
- 方案:
skills/*.md作为 canonical source,Codex 端用脚本自动生成codex-skills/*/SKILL.md,每份生成文件头部加「Codex adapter note」 - Trade-off: 牺牲了 Codex 端的「原生体验」(必须依赖适配层)
- 可迁移性: 中
-
决策: 报告审计门借鉴软件 CI,把「研报准出」流程化
- 问题: 主观类报告没有编译器和测试可以兜底
- 方案:
tools/report_audit.py用正则从 markdown 报告里自动提取数字,随机抽 15%,输出 JSON 模板要求用户填回核验值,FAIL 时非零退出码可用于 CI - Trade-off: 牺牲了「发布效率」(每份报告多一道人工核验步骤)
- 可迁移性: 高
竞品格局与定位
竞品对比矩阵
| 维度 | ai-berkshire | augur | valinvest | buffett-letters-skill | Value-Investing-Agent |
|---|---|---|---|---|---|
| Stars | 4,217 | 227 | 193 | 43 | 19 |
| 方法论 | 四大师对抗 | 多 Agent 加权共识 | Buffett/Piotroski/Graham 指标库 | 巴菲特 60 年信源蒸馏 | Graham + Buffett 风格 |
| 数据严谨性 | Python Decimal 强制 | LLM 心算 | 指标计算 | 蒸馏 | LLM 推理 |
| 客户端 | Claude Code + Codex | 自有 UI | Python 库 | Claude Skill | MCP/TypeScript |
| 反偏见机制 | A/B/C + 镜子测试 + 8 否决 | 无 | 无 | 无 | 无 |
| 语言/市场 | 中文/港美 A | 英文 | 英文 | 英文 | 英文 |
| 实盘背书 | +69%/+66% | 无 | 无 | 无 | 无 |
差异化护城河
- 方法论护城河:四大师对抗 + 反偏见三件套 + 镜子测试,这些是行业稀缺的「软」资产
- 工程纪律护城河:Python Decimal 强制 + 数据抽检 CI 化 + 多源交叉验证
- 生态护城河弱:主要是 dogfooding 验证而非 community 飞轮
竞争风险
最可能被 augur 替代(如果 augur 增加中文 + 对抗式方法论)或被 super-hedge-fund-skill 替代(如果其多 Agent 路线成熟到机构可用)。valinvest / buffett-letters-skill 是错位竞争而非直接对手。
生态定位
在「AI for finance」赛道上,AI Berkshire 处于「中文散户 + 个人投研深度」 niche 的领先位置;不是工具/库型项目,而是「个人方法论产品化」路线,竞品更像「独立分析框架」而非「工具」。
套利机会分析
- 信息差: 同 topic 第二名 augur 仅 227 stars(5% 体量),细分赛道事实头部,仍有信息差红利
- 技术借鉴: 三层 Skill → Agent → Tool 架构 + Python Decimal 工具链 + report_audit.py 是高度可迁移的范式,可直接套到法律分析、医学文献综述、尽调报告等「LLM 做主观判断」场景
- 生态位: 填补了「AI 编程 CLI × 垂直领域方法论 × 中文市场」三角的空白——augur/valinvest 是英文通用型,没有中国散户视角
- 趋势判断: 2024-2026 是 LLM 编程能力跃迁期,Claude Code + Codex 推动「单兵+Agent 达到团队产能」范式,项目在加速期(6 月 commit 数是 4 月的 4.1 倍),符合技术趋势且比通用型竞品有先发优势
风险与不足
- 测试覆盖为 0:0 个单元测试,ROADMAP 列为 P2 长期项;
tools/financial_rigor.py等核心工具没有自动化验证 - 无 CI/CD:没有
.github/workflows/、无 lint 配置、无 pre-commit;作者 dogfooding 即验证 - 保守性偏见(Issue #15):芒格式「8 条红线一票否决」+ 段永平「能力圈」天然把模型推向保守,可能错过机会
- Token 成本(Issue #11):4 Agent + Team Lead 综合 = 单次跑完烧大量 token,且每步需人工确认(Issue #9 「点了几百次了,不能默认 yes 吗」)
- 过度拟合四位大师(Issue #16):四大师的合成 ≠ 最优,可能是「用 prompt 工程制造的一种新权威」
- 生态护城河弱:<50 stars 来自国际用户,社区小,无 Discord/Discussion;如果作者停止维护,社区接手困难
- 实时数据缺失:未接 Wind/Bloomberg/Yahoo Finance MCP 实时数据,研报依赖历史财报+人工输入
行动建议
- 如果你要用它: 适合中文散户 + 严肃个人投资者,港美 A 三市覆盖;不适合需要实时数据 + 量化回测的机构用户。安装
skills/*.md到~/.claude/commands/,跑/investment-research即可。注意:每份研报依赖大量 token 预算(Issue #11),建议先用小标的试水。 - 如果你要学它: 重点关注四个文件:
skills/investment-research.md(Skill 模板的范本)tools/financial_rigor.py(工具链纪律的范本)tools/report_audit.py(研报 CI 化的范本)CLAUDE.md+AGENTS.md(AI Agent 工作宪法的写法)- 以及一份旗舰报告
reports/拼多多/看输出格式
- 如果你要 fork 它: 可改进方向:
- 加单元测试(ROADMAP P2)
- 接实时数据(ROADMAP P1:Wind/Bloomberg/Yahoo Finance MCP)
- 加宏观周期框架(ROADMAP P0 未完成)
- 加历史回测(ROADMAP P0 未完成)
- 引入「反大师」agent(索罗斯/达里奥)做对照(Issue #16 提议)
- 实现 Investment Thesis Drift Detection(Issue #19 提议)
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/xbtlin/ai-berkshire |
| Zread.ai | 未收录 |
| 关联论文 | 无(应用层 skill 合集,非研究项目) |
| 在线 Demo | 无(Skill 形态,无 web playground;CLI 内调用为唯一入口) |