GitHub推荐:11 个月 28K stars:Vectorize 开源的 Agent 记忆系统 Hindsight 拿下 LongMemEval 第一
一句话总结
Hindsight 是 Vectorize 开源的「会学习的」Agent 记忆系统——用仿生的世界/经验/观察/心智模型四类记忆,配合语义/BM25/图/时序四臂并行检索,在 LongMemEval 上稳居第一,把 Agent Memory 从「向量 RAG + 知识图谱」二元对立推进到「四类型记忆 + 多通路融合」的新范式。
值得关注的理由
- 赛道卡位: 直接对位 mem0 / Zep / Letta / Cognee,主打「biomimetic 四网络记忆」+「TEMPR 四臂并行检索」,差异化护城河清晰。
- 产品形态: MIT 开源 + 25+ LLM provider + 60+ 集成(Claude Code、Cursor、Codex、LangGraph、LlamaIndex 等)+ 闭源 Hindsight Cloud 托管,构成「开源引擎 → 企业 SaaS」完整闭环。
- 工程背书: 11 个月 70 个 release、268 tag、3,179 commits、260 位贡献者;arXiv 2512.12818 论文 + Virginia Tech / Washington Post 独立复现,是少有的「学术背书 + 生产部署」双轨项目。
- 采用信号: 自报 Fortune 500 多家进入生产;live benchmark 页
https://benchmarks.hindsight.vectorize.io/持续公开 LongMemEval 成绩,透明度高于多数竞品。 - 市场窗口: AI Agent 记忆层赛道是 2026 年最拥挤的新领域之一,star-history 周榜 +2,992(#18)说明增长动能仍在加速。
项目展示
 官方项目横幅 hero 图
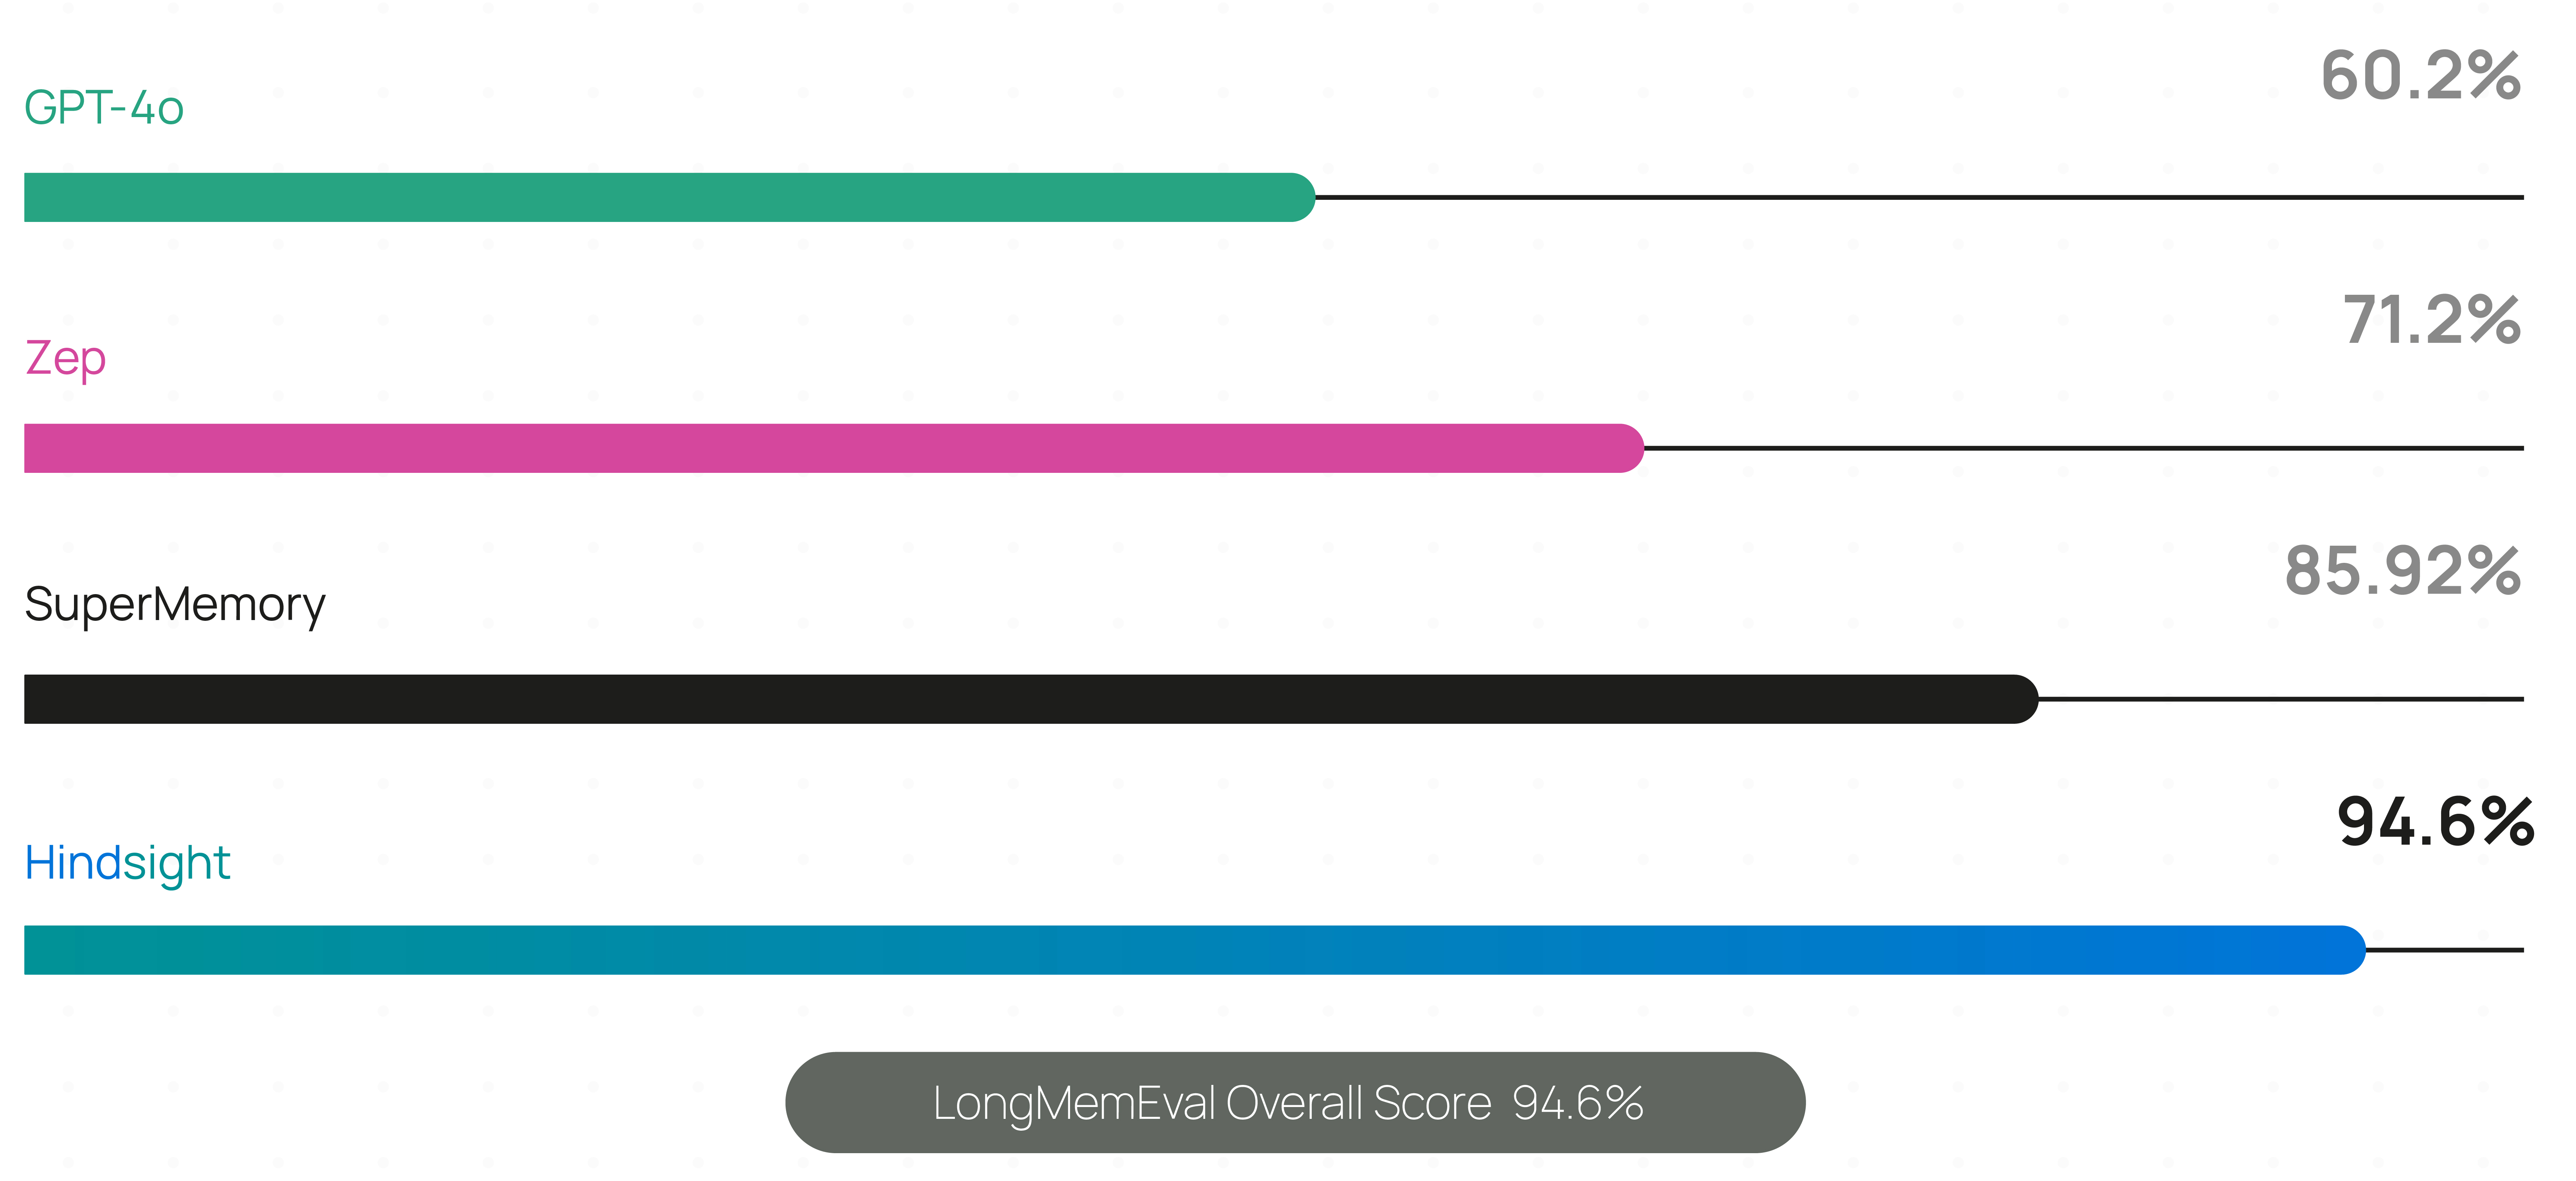 LongMemEval 等 benchmark 对比截图,Hindsight 居首
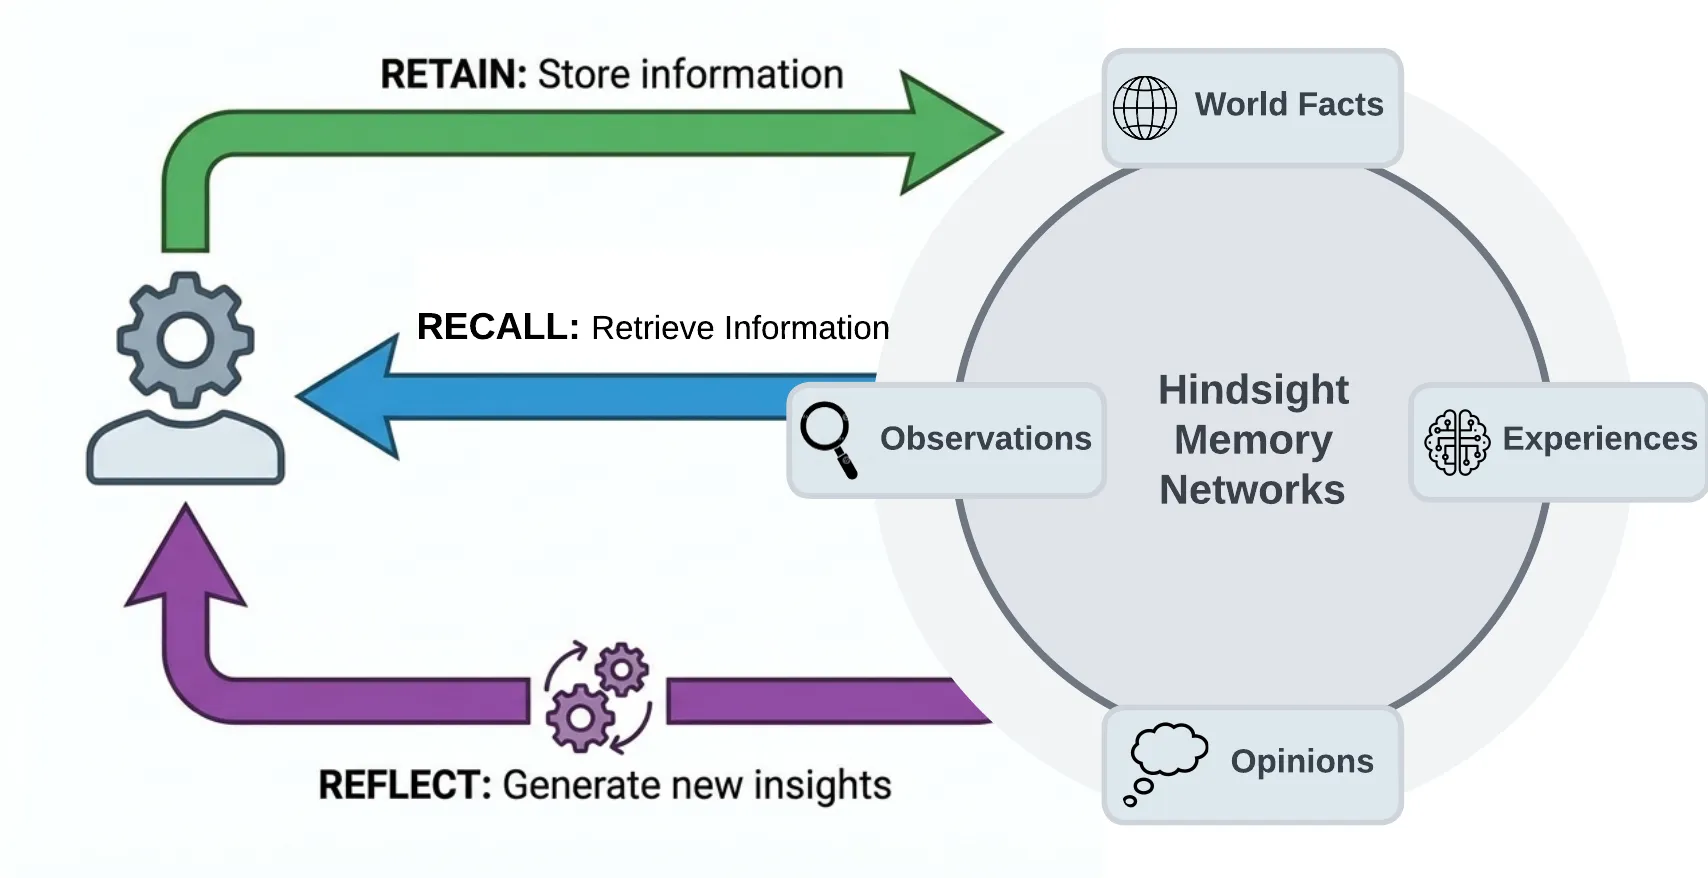 Hindsight 架构/记忆类型总览示意图
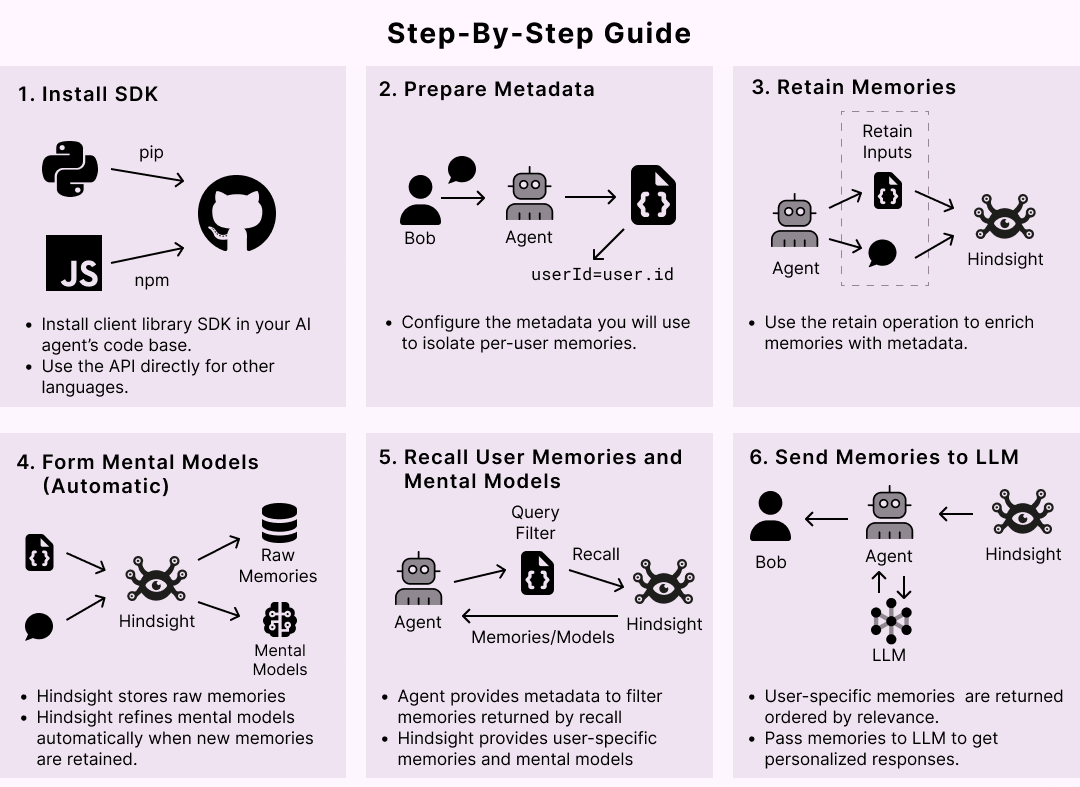 Per-user memories 在 Hindsight 中的实现流程
README 还附带 4 个 github user-attachments 演示视频,公众号发布时可挑一段作为 demo 链接。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/vectorize-io/hindsight |
| Star / Fork | 28,119 / 2,754 |
| 项目年龄 | 11 个月(首 commit 2025-10-30,最近 2026-09-24) |
| 代码规模 | 816,996 LOC,但分布在 7+ 个独立子项目;最大 hindsight-api-slim 287K(Python) |
| 子项目分布 | Python 主(核心引擎 + 集成),Go(130K 生成 SDK),TS(控制台 + 文档 100K+),Rust(CLI 14K),MDX(文档 39K) |
| 文件总数 | 4,193 |
| 测试 LOC | 258K(约 1:3.2 测试-代码比) |
| Release / Tag | 70 / 268,semver 节奏 v0.5.5 → v0.10.1 |
| 贡献者 | 260 位,外部贡献占比可观 |
| Bus Factor | 1(Nicolò Boschi 占 61%;前 3 名合计 75%) |
| 开发阶段 | 密集开发(最近 30 天 520 commits;最近 90 天 1,238 commits) |
| 热度定位 | 大众热门 |
| 质量评级 | 代码 exceptional / 文档 exceptional / 测试 high |
作者视角:为什么存在这个项目
创始人/作者背景
vectorize-io 是位于美国 Boulder/Dover 的 AI 初创公司,2024 年 1 月成立,2024 年 10 月完成 True Ventures 领投的 3.6M 美元种子轮。两位联合创始人 Chris Latimer(CEO)与 Chris Bartholomew(CTO)此前都在企业数据基础设施领域深耕:Latimer 曾在 DataStax 负责云与向量数据库业务,更早任 Google API Gateway 产品经理;Bartholomew 长期主导大规模数据平台架构。两人都从企业做向量索引的痛点中看到了机会,先做了闭源「Vectorize RAG」再于 2025 年底开源 Hindsight 切入 Agent 内存赛道。
这种「闭源平台 → 开源基础模型」的演化路径与 LangChain(LangSmith 商业化)、LlamaIndex(企业版)一致,体现一类典型的「从基础设施 SaaS 后向开源做生态」打法——先做付费的客户,再开放同源代码吸引长尾。
问题判断
两位 Chris 看到的企业痛点是:传统 RAG 仅用「向量相似度 + 上下文拼接」无法处理 Agent 场景的复杂记忆需求。Agent 需要的不是「文档检索」,而是一套分层记忆:
- 世界知识(不会变的背景事实)
- 亲身经验(用户偏好、过往对话)
- 观察归纳(自动从经验中提炼的可信结论)
- 心智模型(对人对事的总结性认知,类似「Alice 是个挑剔的架构师」)
更进一步,时间维度的检索(「Alice 上个季度说了什么」)是多数纯向量方案的弱项,知识图谱(如 Zep、Cognee)能解决但成本高且难以维护。这正是 Hindsight 四网络记忆 + TEMPR 四臂检索要同时解决的命题。
解法哲学
作者的取舍明显:
- 显式建模而非向量相似度——把记忆类型编码到数据模型(
fact_type枚举)而不是依靠 embedding 隐式表达。代价:schema 复杂;收益:可追溯、可解释、可干预(删除/置顶心智模型)。 - 借仿生学而非认知科学符号体系——与 Cognee(认知图谱)形成对比——保持工程化、可落地。
- 多通路融合而非单一检索器——TEMPR 把「语义 + BM25 + 图 + 时序」视为同等重要的检索臂,而非让一种方法兜底。
- 生成式反思带文档强制引用——reflect 不是简单 prompt 调用,而是 agent loop + 引用校验。
- 省略手写 SDK、采用 OpenAPI 自动生成——避免 4 语言 4 维护团队的开销(已有 130K Go + 多语言 SDK)。
明确不做:
- 不内置 KG 构建器(Cognee ECL 派)
- 不做完整的 agent orchestration(LangChain / LlamaIndex 派)
- 不锁定 PostgreSQL——同时支持 Oracle 23ai(面向企业客户)。
- 不锁单一 embedding 模型:5 种 BM25 后端 + 25+ LLM provider 可插拔。
战略意图
Hindsight 是 Vectorize「开源引擎 + 托管 SaaS」双轨商业化战略的核心:开源核心卖给开发者打造生态,Hindsight Cloud 卖给需要 SLA 的企业。hindsight-control-plane(Next.js 后台)就是为 SaaS 形态设计的,README 自述已有 Fortune 500 与多家 AI 创业公司进入生产。
核心价值提炼
创新之处
按新颖度 × 实用性排序:
-
TEMPR 四臂并行检索(novelty 中 / practicality 高)
在
hindsight-api-slim/hindsight_api/engine/search/fusion.py:29实现——RRF 融合前每个臂先按 cap 截断,避免一个稠密方法淹没其他;时序被当作「一等公民臂」而非后置过滤。 -
证据化的 Observation 合并(novelty 中 / practicality 高)
自动化 LLM 合并 = dedup +
proof_count+source_memory_ids+historyJSONB 累加,而不是覆盖。新观察可标记为 stale 让 reflect 自动校验。 -
Disposition + Directives + Mission 的银行人格(novelty 中 / practicality 高)
每银行 5 项性格向量 + 自由 mission + 标签域硬规则;只影响 reflect 不污染 recall——既保证回复一致性,又保留检索保真度用于 eval(可观察性)。
-
心智模型知识页面(mountable FS)(novelty 高 / practicality 中)
LLM 合成出来的「对某人某事的总结」可以挂载为只读文件系统(
hindsight fs mount)供 IDE/离线工具读取——把 memory-of-memory 重塑为文件。 -
跨方言的 Alembic 迁移派发器(novelty 中 / practicality 高)
通过
_dialect.run_for_dialect+tests/test_migration_shape.pylint 保证 Postgres 和 Oracle 23ai 同步演进。 -
Token 预算驱动 recall 而非 top-k(novelty 低 / practicality 高)
默认 4096 tokens 就停,匹配 Agent 上下文窗口;
include_chunks是独立的源文本预算。
可复用的模式与技巧
| 模式 | 适用场景 |
|---|---|
contextvars 传递租户身份(memory_engine.py:92) | 多租户异步服务中免除 prop-drilling |
| Alembic run_for_dialect 派发器 | 需要跨 Postgres + 非 PG RDBMS 同步演进的项目 |
RRF + per-arm cap(engine/search/fusion.py:29) | 任何混合搜索存在「某臂过于热情」时的兜底 |
env-var 点路径扩展加载(extensions/loader.py) | 想让用户提供纵切特性(认证/审计)而不编译期耦合时 |
| OpenAPI → 多语言 SDK 自动生成 | 任何 ≥3 个第一方 SDK 的服务都该采用 |
单表多类型 + history JSONB(memory_engine.py:3826) | 需要审计线索的「信念存储」系统 |
关键设计决策
| 决策 | 推断的权衡 |
|---|---|
单表存 4 种 fact_type 而非拆表 | 简单跨类型 join;代价:所有 query 都要带 fact_type 过滤 |
| 四臂而非单向量检索 | 召回完整度大幅提升;代价:跨臂调度的复杂度 |
| 性格仅作用于 reflect | 检索保真度优先于个性化;副作用:性格化场景必须走 reflect(更慢) |
| 闭源 SaaS + 开源基础模型 | 阿里/TiDB 式「先商业后开源」打法;对维护承诺有反向激励 |
| 异步合并 worker 而非 retain 内联 | retain 延迟稳定;副作用:freshness window(issue #1842 已暴露) |
| Memory Defense 拦截 retain 而非 recall | 合规要在存储前完成;副作用:被拦截后重试成本不为零 |
竞品格局与定位
竞品对比矩阵
| 维度 | Hindsight | mem0 | Zep | Letta (MemGPT) | Cognee |
|---|---|---|---|---|---|
| 记忆模型 | 四类型(world/experience/observation/mental_model) | 通用 LLM 长期记忆层 | GraphRAG + 时序 | sleep-time consolidation + memory blocks | 知识图谱 + ECL 流水线 |
| 检索臂 | 语义 + BM25 + 图 + 时序(4) | 单一向量 | 图 + 时序 | 向量 + 摘要 | 知识图谱 |
| 后端存储 | PG / Oracle 23ai + pgvector | 多后端(自有托管) | 文档 DB + 图 | 自带 | 多后端 |
| LLM provider | 25+ | 主流 | 主流 | 主流 | 主流 |
| 集成数量 | 60+ | 数十种 | 较少 | 较少 | 较少 |
| 学术/独立复现 | arXiv 2512.12818 + 2 独立复现 | 自报告 | 较成熟生产案例 | MemGPT 论文 | 部分 |
| Bus factor 风险 | 高(61% 单人) | 较低 | 较低 | 中 | 中 |
| 开源协议 | MIT | Apache 2.0 | Apache 2.0 | Apache 2.0 | Apache 2.0 |
| 多模态 | 路线图上(issue #1801) | 实验性 | 不 | 不 | 不 |
差异化护城河
- TEMPR 把时序当一等臂:其他家多把时间作为后置过滤,Hindsight 把 T 放在 E (embedding)/M (BM25)/P (graph)/R (relational) 同等位置,专门解决「时间窗口偏置」(检索/资源/合成页 #96)。
- 四类型记忆 + 单表 schema:比 Zep(graph + temporal 双表)/Letta(memory blocks 抽象)有更清晰的存储一致性,比 Cognee ECL 更少 schema-fluidity 风险。
- 证据化的 Observation:proof_count + source_memory_ids + history JSONB 是 Hindsight 原创设计,让「Agent 何时改变结论」可追溯。
- 学术 + 独立复现双背书:arXiv 论文 + Virginia Tech + Washington Post,相对 mem0/Letta 主打自评,这是更可信的外部信号。
- 心智模型可挂载 FS:差异化产品形态,让 IDE/离线工具能直接读取。
竞争风险
- 被 Zep 替代的场景:已经在用 GraphRAG 的企业客户,迁移成本相对更低。
- 被 mem0 替代的场景:希望 API 简单的中小团队,mem0 LLM-call-only 抽象学习成本更低。
- 被 Letta 替代的场景:对 sleep-time consolidation 心智模型偏好者(MemGPT 学术派)。
- 被 Cognee 替代的场景:希望自定义图 schema 的研究性项目。
- 最大风险来自 OpenAI / Anthropic 自研内嵌记忆层:当记忆作为 OS-level 能力嵌入模型 API 时,第三方记忆层会被边缘化。
生态定位
Hindsight 在 AI Agent 技术栈中扮演「AI 应用 ↔ 长期记忆 ↔ 多源检索」的中介层,下接模型与数据库,上承 LangGraph / LlamaIndex / Claude Code 等 agent 框架。它的存在说明:2025–2026 年业界共识到「Agent 不能没有记忆,但向量检索不够」这一点。Hindsight 是较早把「证据化的多类型记忆」工程化落地的项目,比多数竞品更靠近 production-ready。
套利机会分析
- 信息差:Hindsight 在 28K stars 阶段仍是「中型热门」,相对 MemGPT、Zep 的成熟度有更好的增长曲线,长尾采用尚未饱和;同时学术复现 + live benchmark 让其说服力高于多数自评项目。
- 技术借鉴:可借鉴「RRF + per-arm cap 融合」直接用到任何混合搜索系统;「Alembic 跨方言派发器」对要支持多 RDBMS 的项目(向量 + 关系 + 图)是开箱即用模式;「单表多 fact_type + history JSONB」可重用到任何需要审计线索的「信念存储」场景。
- 生态位:AI Agent 基础设施工具链的重要一环,特别适合「想给 Coding Agent 加记忆」但不想自研 consolidation 的团队。
- 趋势判断:Agent Memory 赛道是 2026 最拥挤方向,Hindsight 整体趋势向上(11 月从 6 commits 到 9 月 436 commits,每季度抬升);后发优势:在「证据化的多类型记忆」上抢跑学术 + 开源双背书。
风险与不足
- Bus factor 1(最高优先级):Nicolò Boschi 占 61% commits,前 3 名合计 75%——如果离职或精力转移,项目可能进入维护态。
- Mental model refresh OOM(issue #3355):40K 节点 / 815K 链接场景下,refresh 单次 17.7GB RSS——架构级瓶颈未解。
- Token 成本失控(issue #1573):单用户场景 30 分钟 3M tokens 消耗——reflect agent loop 在某些配置下无界。
- Consolidation backpressure(issue #1842):大批量未及时 drain;worker 并发槽衰减到 1——异步编排器的可靠性边界。
- 多模态缺口(issue #1801):images/audio/video 仍在路线图,对比 mem0 等已有部分实验性支持的竞品是劣势。
- 评估方法论缺失(issue #2347):vendor-reported LongMemEval 分数是主要成绩背书,「第三方独立测评脚本」尚未公开。
- 三次品牌重塑(2025-11-03 memory→memora;2025-11-25 memora→hindsight;2026-01-30 openclawd→openclaw):scoping churn 信号;既有第三方文档/教程可能已失效。
- 多语 monorepo 复杂度(Python/TS/Go/Rust/MDX/Deno/bun):4193 文件,对贡献者门槛偏高。
行动建议
- 如果你要用它:在你已经有 PG 团队、需要多租户隔离(TenantExtension)、且目标场景是「coding agent 长期记忆 / 跨会话一致性 / 时间窗口检索」时,Hindsight 是 2026 年最完整的选择之一。先用
hindsight-all容器跑通,再视需要切到 Helm/SaaS。提防 reflect token 成本与心智模型 refresh 的 OOM 问题,规模化前先做小规模 pilot。 - 如果你要学它:精读
hindsight-api-slim/hindsight_api/engine/memory_engine.py、engine/search/fusion.py、engine/consolidation/consolidator.py、engine/reflect/agent.py、engine/mental_model_refresh.py,配合hindsight-docs/docs/developer/retrieval.md:55-67。理解「单表多类型」「四臂融合」「证据化合并」三件套即可拿走最核心的设计收益。 - 如果你要 fork 它:改造方向优先级——
- 缩小 bus factor:把 mental_model_refresh 的核心函数与检索调度解耦出来交给第二人维护;
- 解决 #3355 OOM:mental_model_refresh 加入 streaming / 增量更新;
- 加回多模态:参考其既有的 memory_units 表结构扩展
modality字段; - 提供公开的 eval harness(响应 #2347):让社区可复算 LongMemEval。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 未收录 |
| Zread.ai | 未收录 |
| 关联论文 | Hindsight (arXiv:2512.12818) |
| 在线 Demo | Hindsight Cloud 注册 / Live benchmark / Cookbook |
| 官方文档 | https://hindsight.vectorize.io/ |
| 官方博客 | https://hindsight.vectorize.io/blog |