给每个 AI agent 一个云桌面:17K star 的 cua 如何做跨 OS Computer-Use 底座
GitHub: https://github.com/trycua/cua
一句话总结
YC X25 创业公司 Cua 开源的 Computer-Use Agent 基础设施——用「一套 SDK 抽象任意 VM/容器镜像 × 跨 macOS/Linux/Windows/Android 全桌面」做 agent 操控计算机的底座,配 lume(Apple 虚拟化 + 把 VM 镜像当 OCI 制品分发)、cua-driver(Rust 写的后台不抢焦点驱动)和 cua-bench(Gym 式训练评估闭环),自我定位为「Computer-Use Agent 的 Docker」。
值得关注的理由
- 押中风口的「底座」卡位:在 OpenAI Operator、Anthropic Computer Use 这些闭源模型层之下,缺一个标准化的「跑环境 + 统一操控 + 产出训练数据」底座。cua 明确选择不做 agent 模型本身,而做下面那一层——这个卡位让它在「全桌面跨 OS + 训练评估闭环 + MIT 全开源」的交集上几乎没有直接对手。
- 罕见的工程深度:16 个月、团队同时驾驭 Swift(lume 调 Apple Virtualization.framework)、Rust(cua-driver 后台驱动)、Python(SDK/agent/bench)。从「把 VM 镜像当容器镜像 push/pull」到「用无障碍树元素寻址实现后台不抢焦点操控」,多处是把成熟领域的方案跨域移植到 computer-use 场景的真创新。
- 一套可直接抄的架构范式:能力下沉的客户端/服务端分层、抽象基类+工厂的多 VM 后端、正则装饰器模型路由、装饰器声明任务生命周期+事件流即数据集、PARITY.md 跨语言移植审计——这些与「你是否做 agent」无关,是任何跨平台/多后端/插件化系统能借走的工程财富。
项目展示
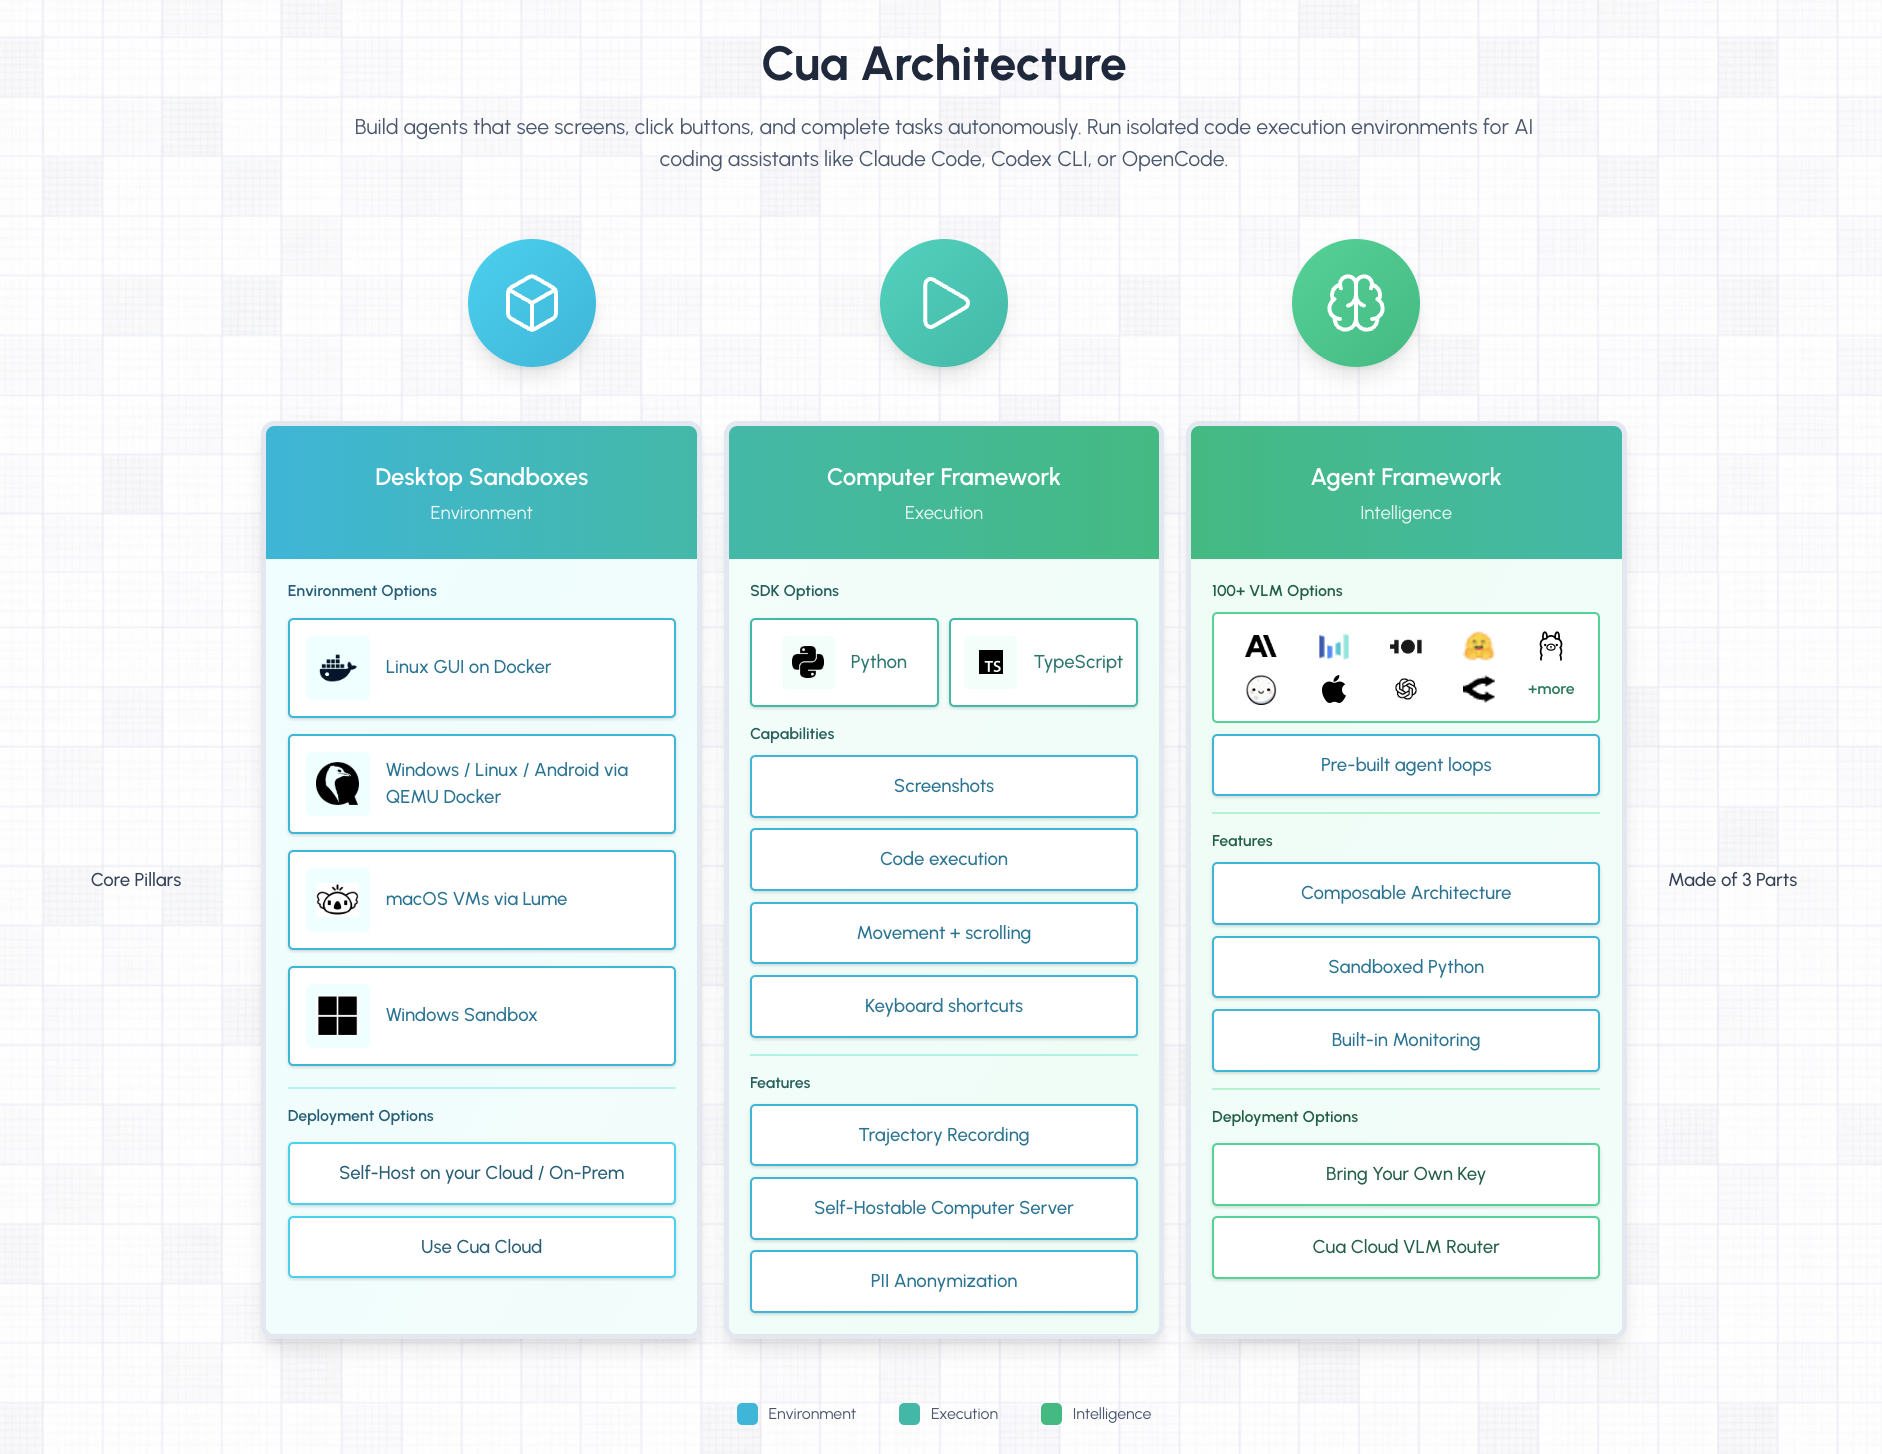
Cua 整体架构:统一 SDK 之下抽象任意运行时与跨 OS 沙箱。
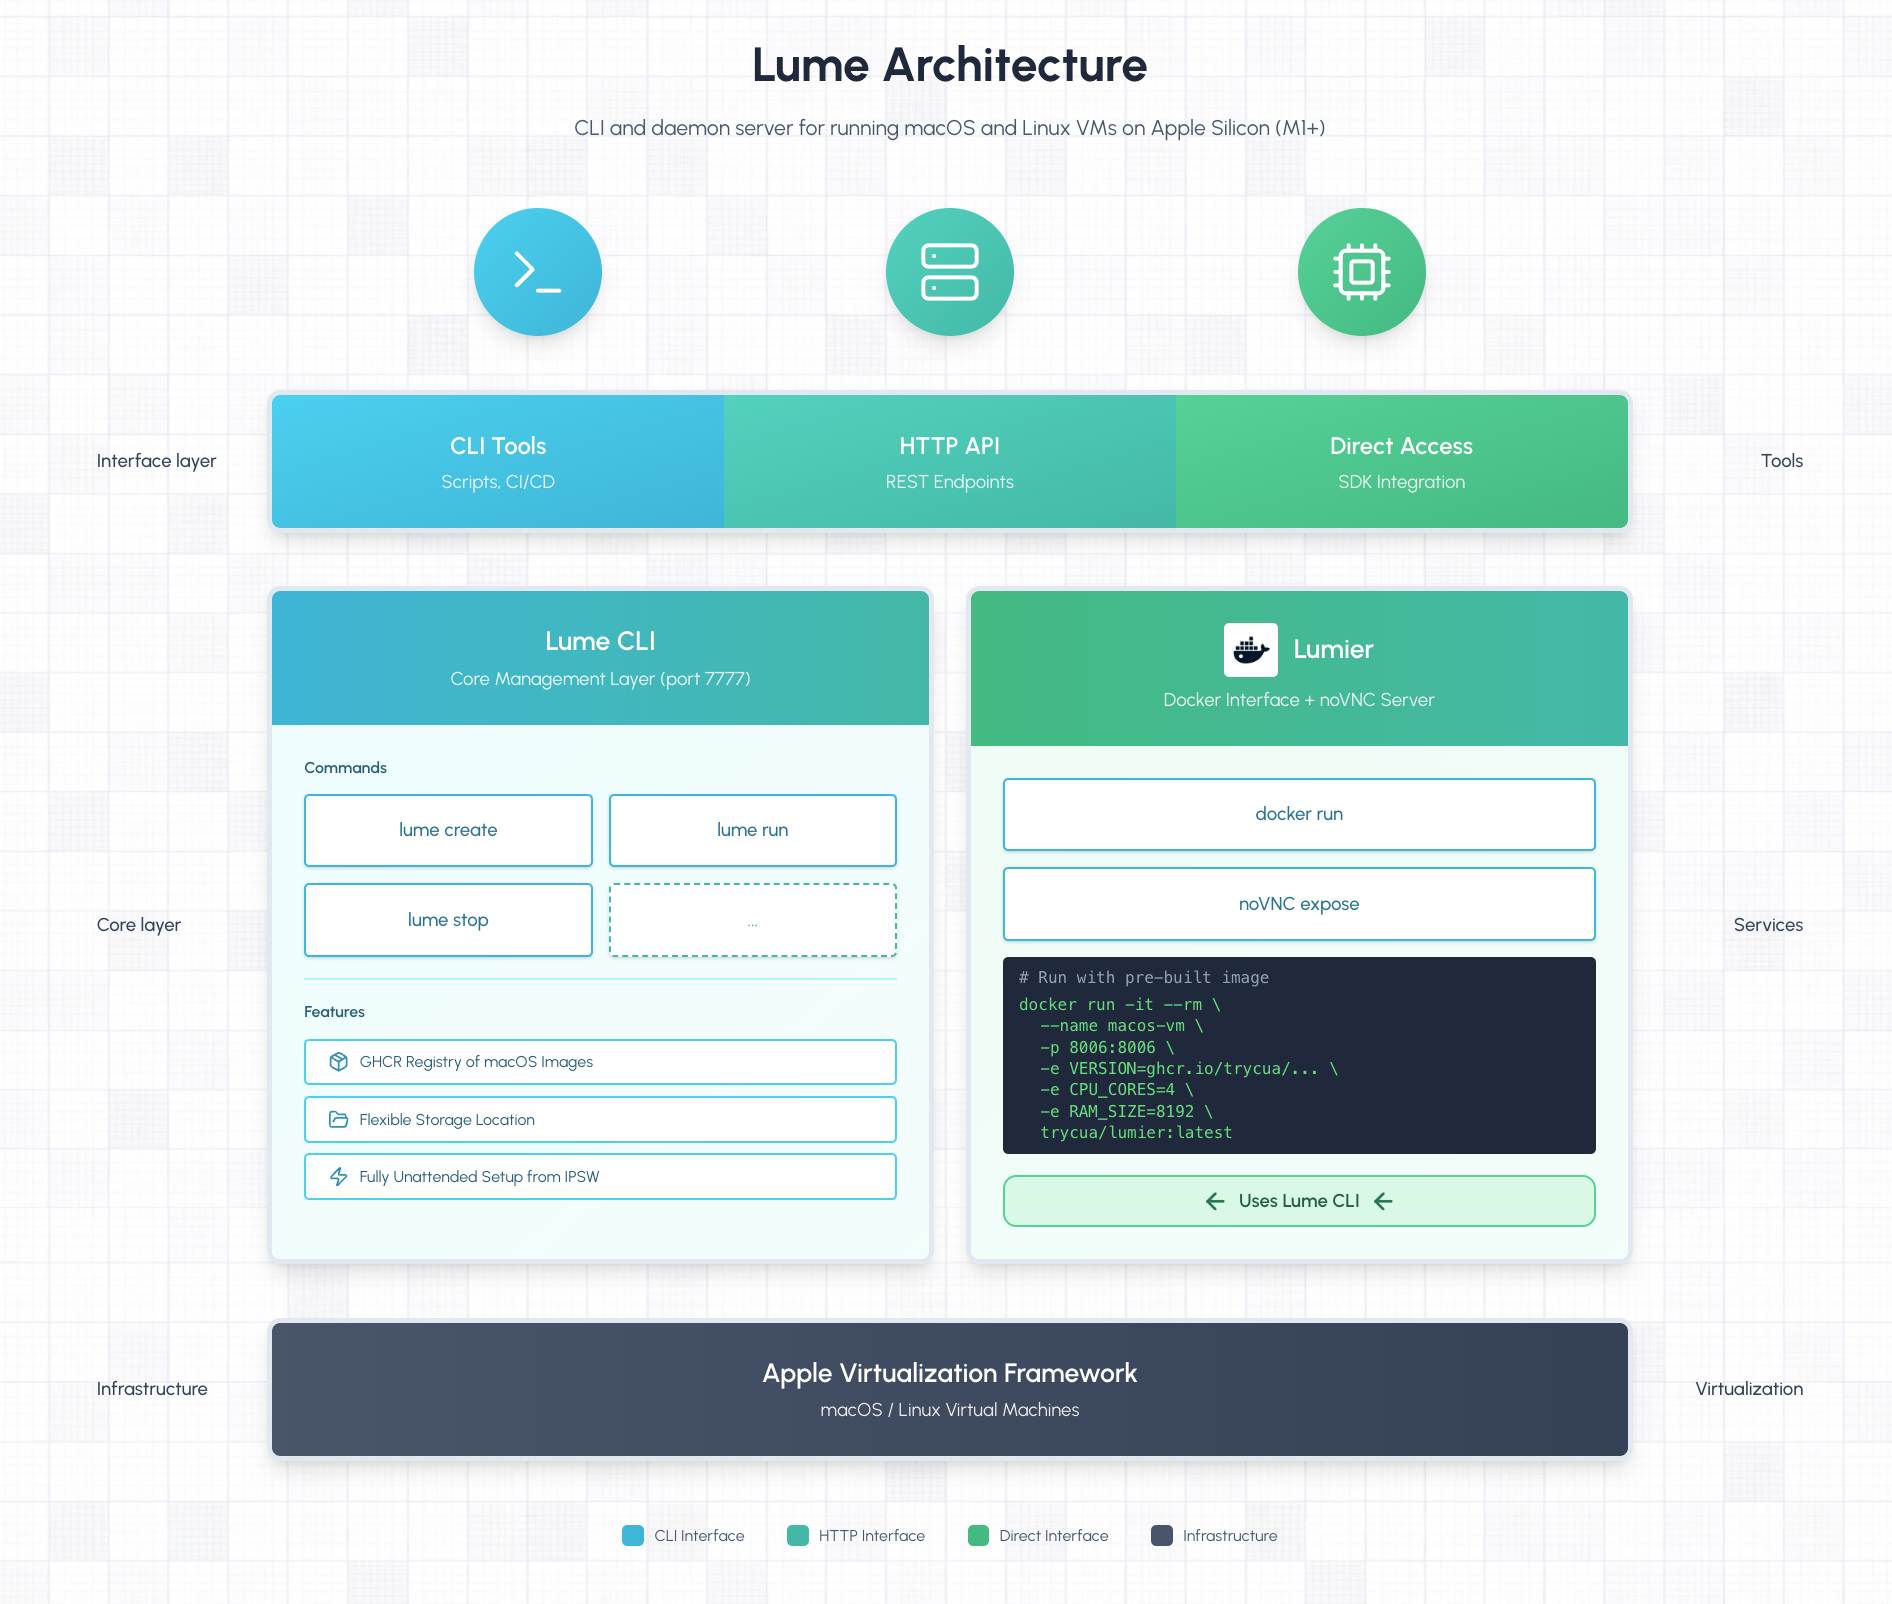
lume:在 Apple Silicon 上基于 Virtualization.framework 起 macOS/Linux VM,镜像走 OCI 分发。
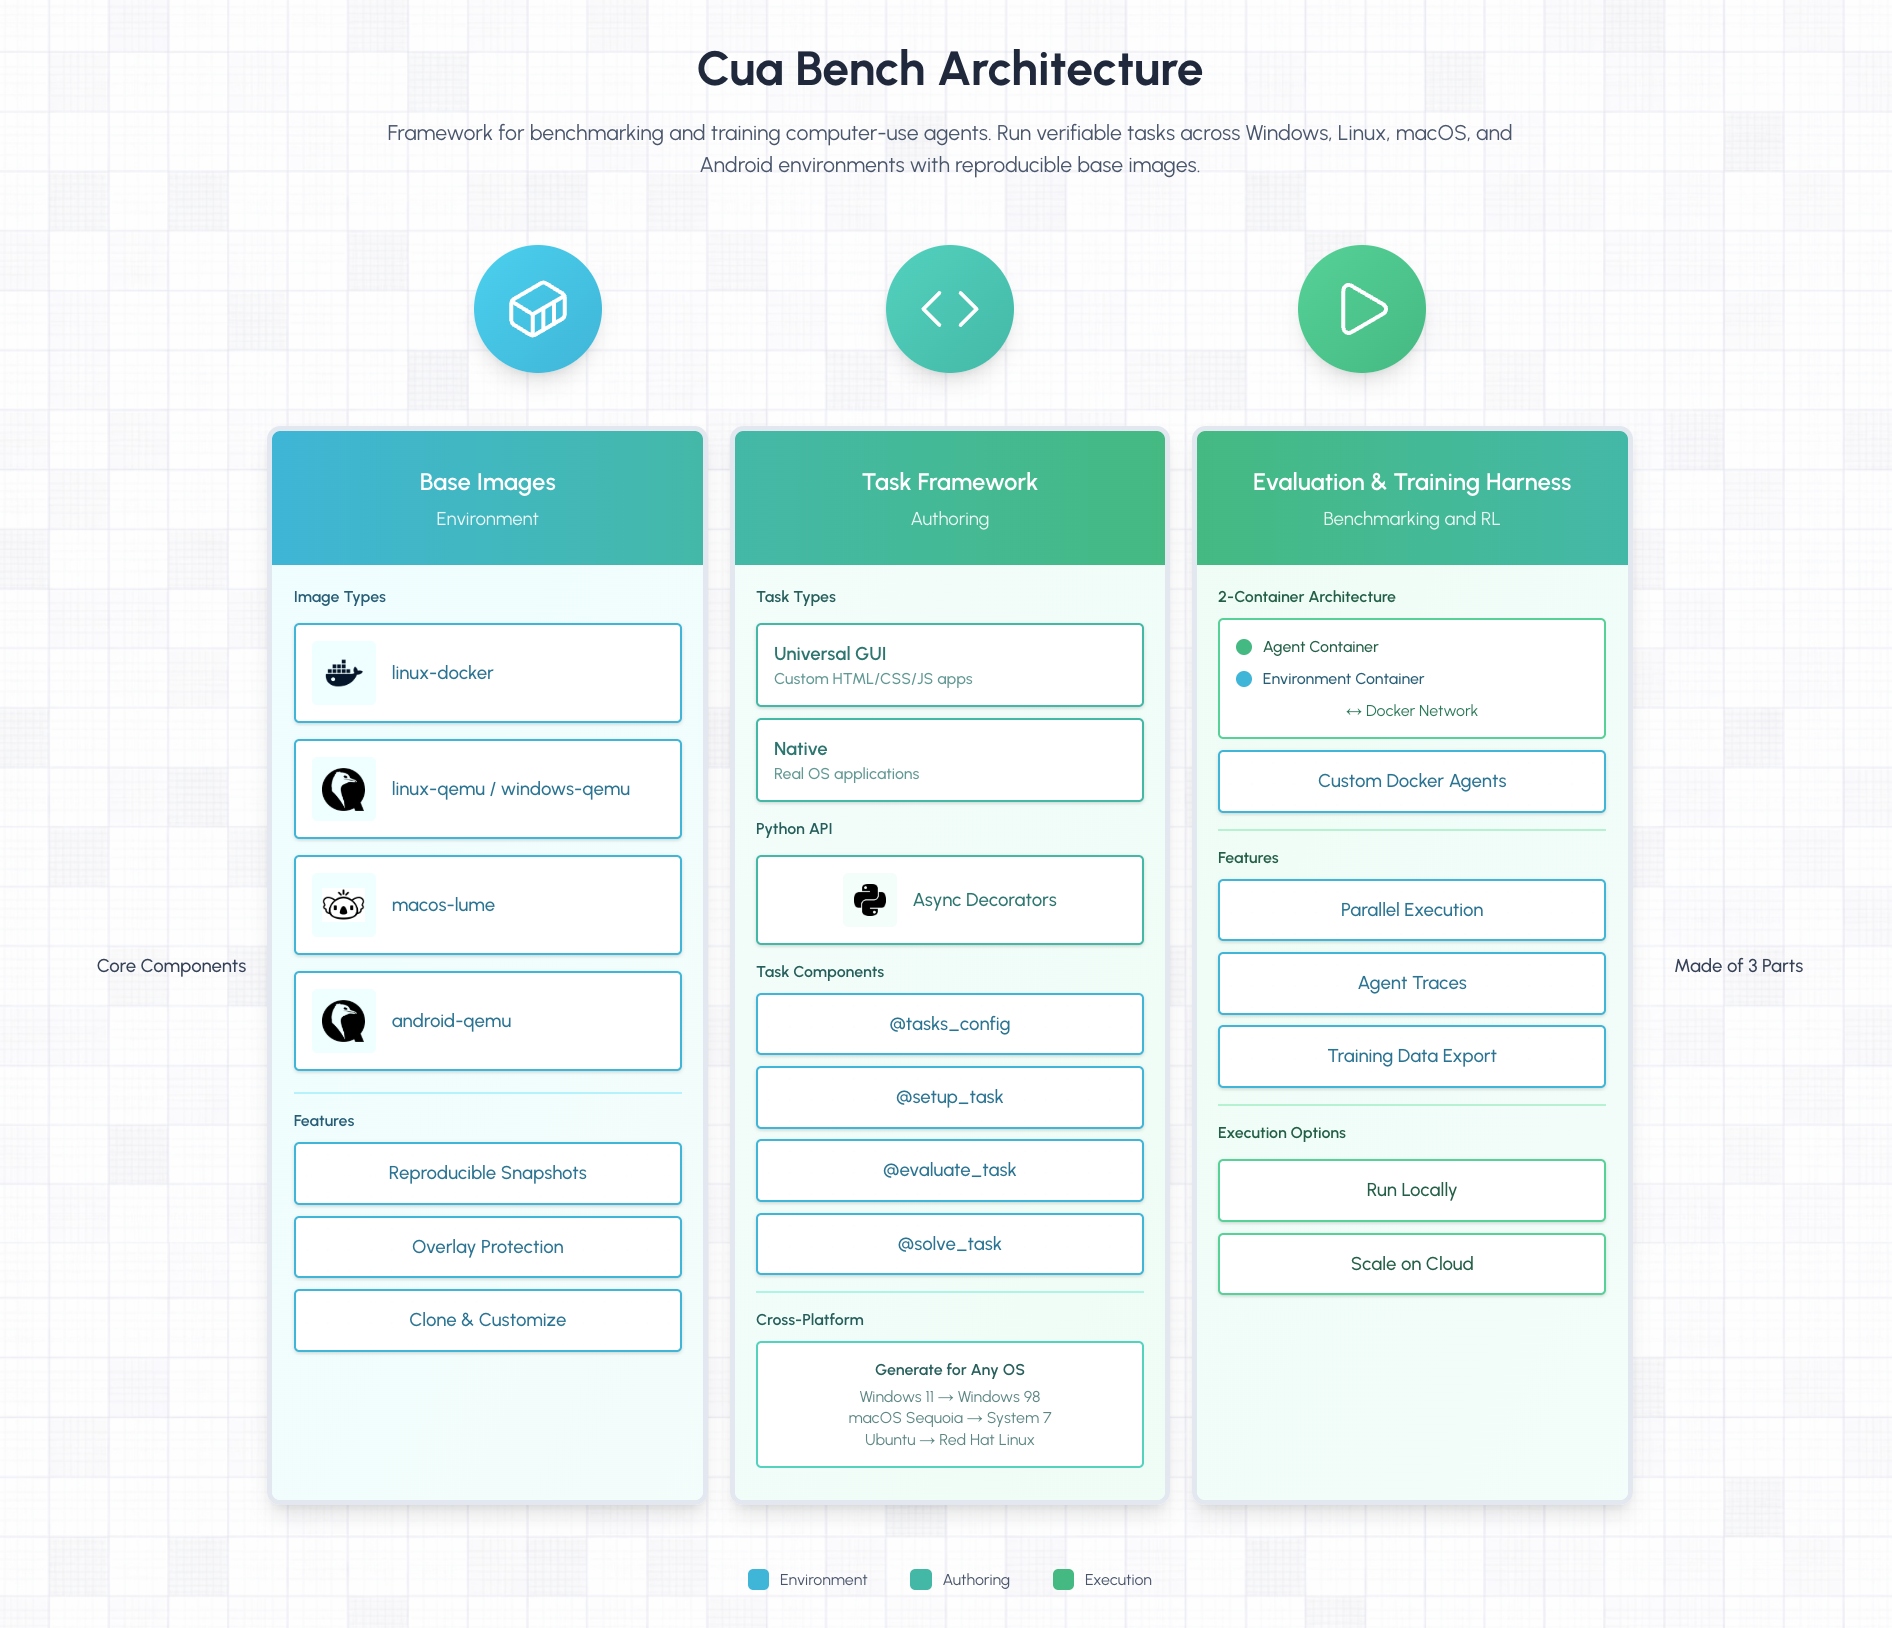
cua-bench:可验证任务 + 可编程奖励 + 轨迹导出的训练评估闭环。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/trycua/cua |
| Star / Fork | 17,725 / 1,138 |
| 代码行数 | 真实业务代码约 25 万行(Python 13.9 万 + Rust 5 万 + Swift 3.7 万 + TS 2.8 万);标称 100 万行被 JSON(61%)拉高,勿误读 |
| 项目年龄 | 16 个月(首次提交 2025-01-31) |
| 开发阶段 | 密集开发(近 30 天 264 commit,全程高位无沉寂) |
| 贡献模式 | 团队 · YC X25 公司(30 贡献者,最活跃者占比仅 29.1%,核心团队 + 社区协作) |
| 热度定位 | 大众热门 · 爆发型(约 1300+ star/周,细分赛道领跑者) |
| 质量评级 | 代码[优秀] 文档[优秀] 测试[基本] |
作者视角:为什么存在这个项目
创始人/作者背景
trycua(组织 “Cua”)是 YC X25 批次创业公司,专注 Computer-Use Agent 基础设施。核心团队 f-trycua(917 commit)、Dillon DuPont(ddupont808,810)、jamesmurdza(266)等,1.5 年密集开发、3486 commit。团队工程能力突出——同时驾驭 Swift(Apple 虚拟化)、Rust(系统驱动)、Python(SDK/RL)三栈。一个鲜明选择:作为商业公司却坚持核心全 MIT 开源,这本身是其叙事卖点。
问题判断
典型的 dogfooding + 时机押注。团队自己要训练/评估 computer-use agent,发现「跑环境的底座」是反复造轮子的痛点:每换一个 OS/云就要重写一遍操控层,且无法批量并行、无法把交互录成可训练轨迹。他们看到几个现有方案的缺口——① E2B/Daytona 强在 Linux/代码执行,但 macOS/Windows 原生桌面能力弱;② Browserbase 只覆盖 web;③ pyautogui/CGEvent 这类通用输入注入会抢焦点、动用户真实光标,无法后台运行和多 agent 并行;④ 缺少「可验证任务 + 可编程奖励 + 轨迹导出」的训练评估管线。时机上押注 2024–2026 这波 computer-use 模型爆发——模型能力刚到「能用但不够准」(OSWorld 30–50%),正缺一个能大规模产出训练数据 + 标准化评估的底座。
解法哲学
- 做底座,不做 agent 本身:明确不训练自己的旗舰模型,而是 BYO-model(litellm 接 Claude/Gemini/Qwen/UI-TARS/本地 MLX/HF),卡位下面那一层。
- 统一抽象优先于单点性能:宁可牺牲单后端的极致启动速度(E2B Firecracker <200ms),也要先把「任意 OS × 任意运行时」收敛成一套 API。
- 可观测/可复现是一等公民:到处埋 telemetry、callback、tracing、轨迹导出——因为最终目的是产出训练数据。
- genuinely open + managed 双轨:核心全 MIT,靠 cua.ai 托管云变现,是 open-core 中「open」一侧做得很厚的类型。
战略意图
基础设施 + 平台型布局,强商业化意图(托管云 cua.ai、cuabench.ai 注册表、“Partner With Us”)。开源仓库是获客与生态入口。最近新增的 cua-driver/cuabot 这条「本地后台 agent」线是增长抓手,直接对接 Claude Code/Cursor/Codex 等 MCP 客户端。核心叙事一句话:「EC2 wasn’t built for agents」——通用云算力不是为 agent 设计的,cua 要做 Computer-Use Agent 的 Docker。
核心价值提炼
创新之处
- composed_grounded:grounding + thinking 模型组合循环(新颖度 5/5):用
"GTA1-7B+gemini-1.5-pro"这样的+模型串,把规划与视觉定位解耦——thinking 模型只产出元素的自然语言描述(“red submit button”),grounding 模型把描述转成 (x,y),中间用desc2xy字典做双向转换。让任意「会推理但不会点」的 LLM + 任意「会点但不会推理」的视觉模型自由配对,正则注册即生效。这是用强推理闭源模型 + 廉价开源 grounding 模型压成本/提准确率的巧解。 - cua-driver 后台操控:AX 元素寻址 + agent cursor 叠加层 + 焦点守卫(新颖度 5/5):用 macOS 无障碍树(Accessibility)的元素级 action(
AXPress)替代全局输入注入,实现「不抢焦点、不动用户真实光标、可操控后台/最小化/跨 Space 窗口、可多 agent 并行」;agent 有独立的可视虚拟光标,FocusGuard反应式复位 app 自激活。把「辅助技术 API」当自动化总线用,是相对所有竞品的硬差异。 - lume:把 VM 磁盘镜像当 OCI 制品分发(新颖度 4/5):几十 GB 的稀疏 macOS/Linux VM 镜像,用自定义 media type(
application/vnd.trycua.lume.disk.v1)走标准 OCI manifest/blob/digest,复用 GHCR/GCS 像拉容器一样 push/pull VM,并用 annotation 记录未压缩尺寸/分块元数据以重建稀疏空洞。 - lume Unattended:用 Claude+OCR+VNC 自动完成 OS 安装(新颖度 5/5):让 LLM 通过 OCR「看」图形化安装界面、经 VNC 驱动鼠键,无人值守跑完 macOS/Linux 的安装流程,批量制备 golden image。
- Callback 全生命周期钩子做横切关注点(新颖度 3/5,可迁移性 5/5):
on_run_start/end、on_llm_start/end、on_computer_call_start/end、on_usage、on_screenshot等 hook,把轨迹保存、预算管控、PII 脱敏、遥测、操作校验全实现为可组合插件而非塞进核心循环。
可复用的模式与技巧
- 能力下沉的客户端/服务端分层:把 OS/平台差异封进「跑在被控 VM/容器内的服务」(computer-server,FastAPI/WebSocket + 按 OS 选 handler),控制端只发 OS 无关的命令名——新增一个 OS 只需加一组 guest handler。
- 抽象基类 + 类型枚举 + 工厂选型:
BaseVMProvider/Runtime让云/Apple VZ/lumier/Docker/Windows Sandbox/QEMU 等异构后端热插拔。 - 正则装饰器注册表 + 模型字符串路由:
@register_agent(models=正则, priority)把每个模型循环注册进全局表,按正则匹配选 loop——加一个新模型 = 加一个文件 + 一行装饰器。 - 装饰器声明任务生命周期 + 事件流即数据集:cua-bench 用
@setup_task/@solve_task/@evaluate_task(奖励即 evaluate 的可编程返回值)+ reset/step 事件直接喂 RL processors。 - 跨语言移植的「线级 PARITY 审计 + 双二进制同一套测试」:Rust 移植 Swift 时用
PARITY.md逐 surface 标注 VERIFIED/INTENTIONAL_DIVERGENCE/OPEN,用 222 个参数化测试对两个二进制跑同一套断言保证行为等价。
关键设计决策
| 决策 | 解决的问题 | Trade-off | 可迁移性 |
|---|---|---|---|
| 客户端/服务端分离 + 服务端跑在 guest 内 + OS 专属 handler 工厂 | 用一套 API 操控四种 OS 而不在客户端写满分支 | 每个镜像要预装 computer-server,换客户端协议完全 OS 无关 | 高 |
VM 后端 BaseVMProvider/Runtime 抽象 + 工厂选型 | 云/Apple VZ/Docker/Windows Sandbox/QEMU 异构后端热插拔 | 新旧两代 SDK 并存增加维护面,换平滑重构 + 向后兼容 | 高 |
| agent loop 正则注册表 + litellm + 模型字符串路由 | 统一调度全能模型与十几种专用 grounding/VLM | 全局可变注册表有隐式耦合,换极低的新模型接入成本 | 高 |
| lume 把 VM 镜像当 OCI 制品分发 | 几十 GB 稀疏 VM 镜像如何像容器一样 push/pull/去重 | 自定义 media type 牺牲与通用 registry 工具的语义互通,换复用现成 registry | 中 |
| cua-driver 用 AX 元素寻址而非全局输入注入 | 后台/不抢焦点/多 agent 并行操控 | 依赖目标 app 的 AX 树质量,换真正的后台并行操控 | 中 |
竞品格局与定位
竞品对比矩阵
| 维度 | cua | E2B (Desktop) | Browserbase | OpenAI Operator / Claude CU |
|---|---|---|---|---|
| 层级 | 基础设施底座 | 云沙箱 | 浏览器即服务 | 模型/agent 能力层 |
| OS 覆盖 | macOS/Linux/Win/Android 全桌面 | 强 Linux/代码执行 | 仅 web | 取决于接入环境 |
| 冷启动 | hot-start <1s | <200ms(Firecracker) | 快 | — |
| 训练评估闭环 | ✅ cua-bench(Gym + RL) | ❌ | ❌ | ❌ |
| 开源 | ✅ MIT 全开源 | 开源 | 闭源商业 | 闭源 |
| 关系 | 底座 | 同层(窄域) | 同层(web-only) | 互补(跑在 cua 之上) |
差异化护城河
技术护城河(lume 的 Apple-VZ 虚拟化 + OCI 分发、cua-driver 的后台 AX 操控、composed_grounded 模型组合)叠加生态护城河(统一 SDK + benchmark/RL 闭环 + MIT 全开源 + MCP 接入 Claude Code/Cursor)。在「全桌面跨 OS + 训练评估闭环 + 后台不抢焦点 + MIT 开源」这个交集上几乎无直接对手。
竞争风险
单点(云 Linux 沙箱)最可能被 E2B/Daytona 以更快冷启动、更成熟生态蚕食;macOS/Windows provider 成熟度参差(issue #368:Windows Sandbox provider 下 Agent UI 无法用)是「全桌面覆盖」叙事与工程现实的张力点;最根本的天花板来自底层模型准确率上限(OSWorld 仅 30–50%),这非自身可控——基础设施再好也受限于模型能力。
生态定位
computer-use agent 的「基础设施/底座层」——做 sandbox/VM + 统一 SDK + benchmark + 虚拟化 + 后台驱动,不做 agent 模型本身。上有闭源模型层(Operator/Computer Use),旁有窄域沙箱(E2B 偏代码、Browserbase 偏浏览器),cua 独占「全桌面跨 OS 基础设施 + benchmark」生态位。
套利机会分析
- 信息差:17725 stars 已是大众热门,谈不上「被低估的冷门」;但赛道正逢风口、增长尚未见顶,且作为该细分赛道唯一覆盖全桌面、MIT 开源的底座,相对竞品(多为闭源模型层或仅浏览器层)仍有认知差,技术解读价值高。
- 技术借鉴:能力下沉的客户端/服务端分层、多后端工厂、正则模型路由、Gym 式任务+事件流数据集、PARITY 跨语言审计、lume 的「OCI 分发非容器大制品」——这些都与「是否做 agent」无关,可直接迁移。lume 单独也是 Apple Silicon 上跑 VM 的优秀工具。
- 生态位:填补了「为 computer-use agent 提供标准化、可训练、跨 OS 的运行环境」的空白。
- 趋势判断:computer-use / agent 操控计算机是明确上升趋势,cua 卡在「底座」位置后发优势明显(模型层激烈竞争,底座层格局未定)。主要变数是模型能力何时突破 OSWorld 准确率瓶颈——一旦突破,底座需求会指数级放大。
风险与不足
- 受制于模型能力上限:OSWorld SOTA 仅 30–50%,computer-use agent 离生产可用尚远,基础设施的价值短期受限于上层模型。
- 多 OS provider 成熟度参差:macOS 强制要求 Apple Silicon、Windows Sandbox provider 仍有缺口(#368),跨架构 OS 镜像分发是核心工程难点(#353 缺 arm64 构建)。
- 资源开销大:VM 镜像约 50GB,磁盘/带宽开销大、初次安装慢。
- 高速迭代的 API 不稳定:约 1300+ star/周、234 个 open PR、644 tag,主线仍在 0.1.x,需 pin 版本盯 changelog。
- 测试以核心路径为主:桌面操控真机 E2E 天然难全覆盖,部分镜像/OS provider 仍偏手测。
行动建议
- 如果你要用它:需要训练/评估 computer-use agent、需要跨 OS(尤其 macOS/Windows 原生)桌面环境、或想在本机后台跑 agent 而不打断使用——cua 是目前最完整的开源底座;只要云端 Linux 代码沙箱、追求极速冷启动,E2B/Daytona 更轻;只做 web agent 用 Browserbase。建议 pin 版本。
- 如果你要学它:重点读
libs/lume(Swift 调 Apple VZ + OCI 镜像分发)、libs/cua-driver(Rust 后台 AX 操控 + PARITY.md 移植审计)、libs/python/computer+computer-server(能力下沉的客户端/服务端分层)、libs/python/agent的loops/(composed_grounded 模型组合 + 正则注册表)、libs/cua-bench(Gym 式训练评估闭环)。 - 如果你要 fork 它:lume 可单独抽出作为 Apple Silicon 的 VM 工具;cua-driver 的「AX 寻址 + agent cursor 叠加 + 焦点守卫」是后台桌面自动化的可独立复用内核;cua-bench 的「装饰器任务 + 事件流数据集」适合作任何 agent eval/RL 框架的起点。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/trycua/cua(已收录,含 OSWorld and Benchmarks 专章) |
| Zread.ai | 未验证(返回 403) |
| 关联论文 | cua 本身无论文;最相关为其 cua-bench 集成的 OSWorld (arXiv:2404.07972)、OSWorld-Human (arXiv:2506.16042) |
| 在线 Demo | cua.ai(托管 Cua Cloud Sandbox,单命令启动云桌面);仓库 notebooks/agent_nb.ipynb 可跑示例 |
| 外部深度视角 | trycua/cua Review (andrew.ooo) |