cognee 深度分析报告
一句话总结
柏林 AI 初创公司打造的 LLM 知识记忆引擎,通过本体驱动的实体规范化 + 三层数据库分离 + 14 种检索策略,将传统 RAG 从「语义搜索」升级为「结构化理解」,定位为 Agent 架构中的标准记忆层。
值得关注的理由
- 独特的认知科学视角:将本体论(OWL/RDF)与 LLM 实体抽取结合,通过三层数据库分离(关系型/向量/图)模拟人类记忆的关系网络结构,这在 GraphRAG 领域中独树一帜
- 企业级生产就绪:多租户隔离、ACL 权限控制、OTEL 追踪、43 个 CI workflow,是该赛道唯一可直接用于企业生产的开源方案
- 融资背书 + 学术根基:$7.5M 种子轮(OpenAI/FAIR 创始人参投)+ arXiv 论文,开源核心 + 云服务的商业模式清晰
项目展示
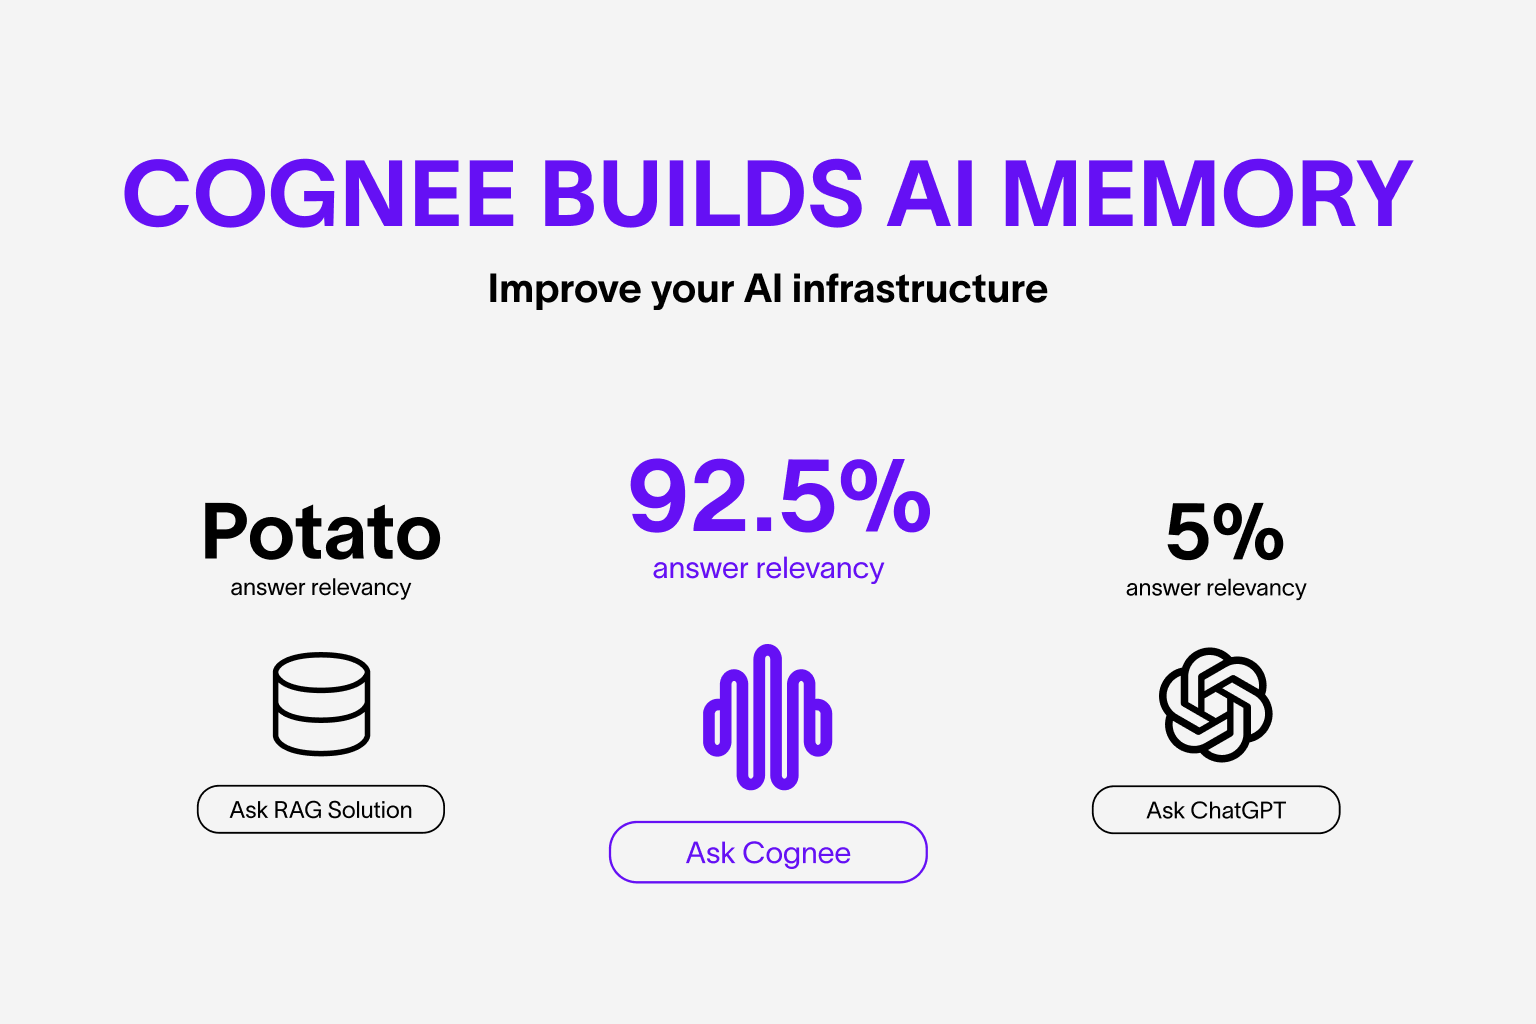 cognee 与传统 RAG 的对比——从「检索拼接」到「结构化理解」
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/topoteretes/cognee |
| Star / Fork | 14,964 / 1,518 |
| 代码行数 | 154,571(Python 66.2%, JSON 15.8%, SQL 10.2%, TypeScript 4%) |
| 项目年龄 | 32 个月(首次提交 2023-08-16) |
| 开发阶段 | 密集开发(月均 commit 从 50 增长到 600+,12 倍增长) |
| 贡献模式 | 小团队(30+ 贡献者,前 4 人贡献 80%) |
| 热度定位 | 大众热门(15K stars,GraphRAG 领域第 4) |
| 质量评级 | 代码[良好] 文档[优秀] 测试[良好] |
作者视角:为什么存在这个项目
创始人/作者背景
Topoteretes UG 是注册于柏林的 AI 初创公司,核心创始人 Vasilije Markovic 拥有认知科学和图数据库背景。公司已完成 $7.5M 种子轮融资(Pebblebed 领投,OpenAI 和 Facebook AI Research 创始人参投),团队在 CET 时区全职开发,月均 400-700 commits 的节奏反映了风投驱动的高速迭代。
问题判断
Markovic 的认知科学背景让他从根本上质疑了 RAG 的范式:传统 RAG 只是「向量空间中的语义搜索」,而人类记忆是关系网络——我们通过概念间的关联来理解信息,而非通过余弦相似度。这意味着 Agent 需要的不是「记忆」(recall),而是「理解」(comprehension)。时机上,2023-2024 年 RAG 的局限性已被广泛认知(多跳推理弱、幻觉难控制),但市场上缺少将认知科学理论工程化落地的方案。
解法哲学
ECL(Extract, Cognify, Load)管道架构是对传统 ETL 的认知科学改造:
- Extract ≠ Understand:需要通过 LLM 进行实体/关系抽取,而非简单切块
- Store ≠ Remember:需要三层数据库分离——关系型存元数据、向量库存语义、图数据库存关系
- Retrieve ≠ Reason:需要图遍历 + 向量检索 + LLM 补全的混合检索,14 种策略覆盖不同场景
明确选择不做什么:不做端到端 RAG(那是 ragflow 的赛道),不做简单对话记忆(那是 mem0 的赛道),专注「结构化知识引擎」这个中间层。
战略意图
从「6 行代码」极简 API 切入开发者,通过企业级特性(多租户、OTEL、ACL)渗透企业客户。MCP 协议支持指向 Agent 生态集成,分布式执行(Modal)指向大规模部署。$7.5M 融资 + Cognee Cloud SaaS 指向明确的商业化路径:开源核心免费,云服务收费。投资人阵容(OpenAI/FAIR 创始人)暗示其目标是成为 Agent 基础设施的标准组件。
核心价值提炼
创新之处
-
本体驱动的实体规范化(新颖度 4/5 | 实用性 4/5 | 可迁移性 4/5) 通过 RDFLib 解析 OWL 本体文件,使用模糊匹配 + BFS 遍历将 LLM 提取的实体映射到标准化本体。将语义网技术(OWL/RDF)与 LLM 实体抽取结合,在 GraphRAG 领域中极为少见。适用于任何需要实体标准化的 NLP 系统。
-
Feedback Weight 自适应图谱(新颖度 4/5 | 实用性 4/5 | 可迁移性 3/5) DataPoint 和 Edge 都有
feedback_weight字段,memify管道的apply_feedback_weights可根据用户反馈动态调整节点/边权重,实现「使用越多越准确」的自我改进记忆。 -
Chain-of-Thought 图检索(新颖度 4/5 | 实用性 3/5 | 可迁移性 3/5)
GraphCompletionCotRetriever在首次检索后自动生成验证问题和追加问题,实现基于图上下文的多轮推理链。14 种检索模式的丰富度在 AI 记忆框架中业内领先。 -
Triplet Embedding + Distance Penalty(新颖度 3/5 | 实用性 4/5 | 可迁移性 4/5) 将图的三元组拼接为文本嵌入,检索时通过
triplet_distance_penalty参数控制图距离对相似度的衰减,融合向量距离和图拓扑距离。 -
时序知识图谱管道(新颖度 3/5 | 实用性 3/5 | 可迁移性 3/5) 独立的
temporal_cognify模式从文本中提取事件和时间戳,构建时序知识图谱,适合新闻、日志等时序数据场景。
可复用的模式与技巧
- 三层数据库门面 + Capability Flags:
UnifiedStoreEngine用 capability flags 统一独立后端和混合后端(如 Neptune Analytics),GraphDBInterface/VectorDBInterfaceABC 保证可替换性——适合任何多存储后端系统 - Task 编排模式:
Task类自动检测 4 种执行类型(async/sync/generator/async_generator),通过batch_size控制吞吐,@task_summary提供可观测性——比 Airflow 轻量,比手写管道灵活 - DataPoint 溯源链:通过
source_pipeline、source_task、source_node_set字段 +_stamp_provenance_deep递归标记实现全链路数据血缘追踪 - 声明式嵌入索引:DataPoint 的
metadata.index_fields声明哪些字段需要嵌入,index_data_points自动处理,将「什么需要索引」与「如何索引」分离 - Retriever 策略模式:14 种 SearchType 对应 14 种 Retriever 实现,共享
BaseRetriever接口,新增检索策略只需添加一个类 + 一个枚举值
关键设计决策
- 三层数据库分离:关系型(SQLAlchemy/SQLite/PostgreSQL)存元数据、向量(LanceDB/ChromaDB/PGVector)存语义、图(Kuzu/Neo4j/Neptune)存关系。Kuzu+LanceDB 零依赖本地开发,Neo4j+PGVector 生产部署,一行配置切换。代价是架构复杂度高。
- Instructor + LiteLLM 双层 LLM 抽象:LiteLLM 统一多 Provider API,Instructor 确保 Pydantic 结构化输出。依赖两个外部库增加供应链风险,但避免了为每个 Provider 写适配器。这是当前 Python LLM 结构化输出的最佳实践组合。
- ECL 管道而非 DAG 编排:选择线性 Task 管道而非 Airflow 式 DAG,足够满足知识处理的线性/批量需求,换来更简单的编排模型和更低的学习曲线。
竞品格局与定位
竞品对比矩阵
| 维度 | cognee | mem0 | GraphRAG | LightRAG | ragflow |
|---|---|---|---|---|---|
| Stars | 15K | 48K | 32K | 32K | 77K |
| 核心定位 | AI Agent 知识引擎 | Agent 个性化记忆 | 图 RAG 参考实现 | 轻量图 RAG | 端到端 RAG |
| 图谱能力 | 强(本体 + 多后端 + 时序图) | 弱 | 强(社区摘要) | 中 | 弱 |
| 企业级特性 | 强(多租户/ACL/OTEL) | 弱 | 弱 | 无 | 中 |
| 检索模式 | 14 种 | 基础向量 | 社区摘要 | 图检索 | RAG |
| 部署灵活性 | 极高(9+ 后端组合) | 中 | 低 | 低 | 中 |
差异化护城河
- 三层数据库分离 + 14 种检索策略组合的深度远超竞品,技术护城河明显
- 本体驱动的实体规范化(OWL/RDF)是独特技术壁垒,竞品无类似实现
- 企业级特性使其成为唯一可直接用于企业生产的方案
- memify 反馈循环实现「自我改进」,形成使用数据壁垒
竞争风险
- mem0 在 Agent 记忆赛道的品牌认知更强(48K vs 15K stars),可能在简单场景中胜出
- microsoft/graphrag 有微软品牌加持,研究型用户可能直接选择
- ragflow 在纯 RAG 场景的开箱即用体验更好,77K stars 的社区规模优势明显
生态定位
Cognee 定位在 RAG 和 Agent Memory 之间的「知识引擎」层——既非简单记忆也非简单检索,而是结构化知识基础设施。这是一个尚未被明确定义的新兴市场空间,cognee 正在率先定义这个品类。
套利机会分析
- 信息差: 15K stars 已有一定知名度,但相比 mem0(48K)和 ragflow(77K)仍被低估。cognee 在多跳推理基准测试上领先(HotPotQA 人类评估正确率 0.93),但市场对此认知不足
- 技术借鉴: 三层数据库门面模式、Task 编排器、DataPoint 溯源链、声明式嵌入索引、本体驱动的实体规范化——均可直接迁移到其他项目
- 生态位: 填补了「简单向量 RAG」与「完整知识图谱平台」之间的空白,是 Agent 架构中「理解层」的唯一开源选择
- 趋势判断: 月均 commit 12 倍增长,版本发布加速至每 1-2 周。Agent 记忆是 2025-2026 年的明确趋势,cognee 有先发优势。$7.5M 融资保证了至少 18 个月的跑道
风险与不足
- 核心依赖链复杂:40+ 直接依赖 + 20+ optional extras 组,版本兼容性管理是持续挑战(pyproject.toml 修改 382 次,是最常改的文件)
- 代码注释比偏低(11.9:1),部分 except 块缺少具体异常类型,新贡献者理解成本高
- 缺少 CHANGELOG.md,版本间的变更缺乏系统记录
- Gemini 兼容性的权宜之计(data_models.py 中的模块级条件分支)暴露了多 Provider 适配层的脆弱性
- v0.5.x 尚未到 1.0,API 可能有不兼容变更,生产采用需承担升级风险
- 竞品品牌压力大:mem0(48K)、graphrag(32K)在社区认知上领先,cognee 需要更强的市场声量
行动建议
- 如果你要用它: 当需求超越简单 RAG(需要多跳推理、实体关系、知识演化),且面向企业级场景(多租户、审计、权限),cognee 是最佳选择。如果只需简单的对话记忆,mem0 更轻量;如果只做文档检索,ragflow 开箱即用更好
- 如果你要学它: 重点关注
cognee/infrastructure/databases/的三层抽象设计、cognee/modules/retrieval/的 14 种检索策略实现、cognee/modules/ontology/的本体解析机制、以及cognee/modules/pipelines/tasks/Task.py的轻量编排模式 - 如果你要 fork 它: 可改进方向包括:补充 CHANGELOG、优化 Gemini 兼容层(消除条件分支)、增加 DAG 编排能力(当前仅线性管道)、开发更多本体模板
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/topoteretes/cognee |
| Zread.ai | 未收录 |
| 关联论文 | Optimizing the Interface Between Knowledge Graphs and LLMs for Complex Reasoning |
| 在线 Demo | YouTube Demo / Colab Notebook |