GLM-4.5 到 GLM-5 都用它训:slime 怎么靠 SGLang 原生把强化学习后训练做到生产级
GitHub: https://github.com/THUDM/slime
一句话总结
slime 是清华 KEG / 智谱(GLM 团队)开源的 LLM 强化学习后训练框架,专为「RL Scaling」设计:它把训练(Megatron)和数据生成(SGLang)焊在同一条 Data Buffer 数据通路上,让二者互相增强,而不是堆一堆互不连通的 trainer + rollout + agent 框架。它是 GLM-4.5、4.6、4.7、5、5.1 背后真实的 RL 训练基础设施——这份「被前沿模型训练实战检验过」的信用,是大多数开源 RL 框架给不出的。
值得关注的理由
- 一条与字节 veRL 相反的架构路线:veRL 走 HybridEngine 共置单体(rollout 塞进训练进程内做 in-memory NCCL 权重搬运 + SPMD rollout);slime 反过来保留 server 边界——每个 SGLang 引擎是独立 HTTP server,rollout 纯用 asyncio + httpx 调用,靠 router 做负载均衡和一致性哈希(multi-turn session 亲和)。这个分野直接决定了谁更适合 agentic / multi-turn / 长尾生成的 RL。
- 一组高水准的 RL 系统工程:训练与推理共置同批 GPU 的显存腾挪(
torch_memory_saver释放物理页保留虚拟地址 + NCCL 进程组可销毁重建)、三态权重同步(共置 IPC / 分布式 NCCL / Delta 逐字节 diff + 稀疏编码,把 Qwen3-30B-A3B 权重传输压到约 7 秒)、Data Buffer 靠「ray.get摆放位置」在同一份代码里切同步/异步/全异步——每一个都是可读到的工程教科书。 - 一个 multi-turn agentic RL 都会踩的正确性坑的标准答案:coding agent RL 的「string-in / token-out 轨迹契约」——保存采样时的精确 token 流,后续轮重新 tokenize 若与早先采样输出对不上就丢弃失配后缀、甚至把整轮降为不反传。绝不对「来源已无法证明」的 token 做反向传播,这是 RL 正确性的底线。
项目展示
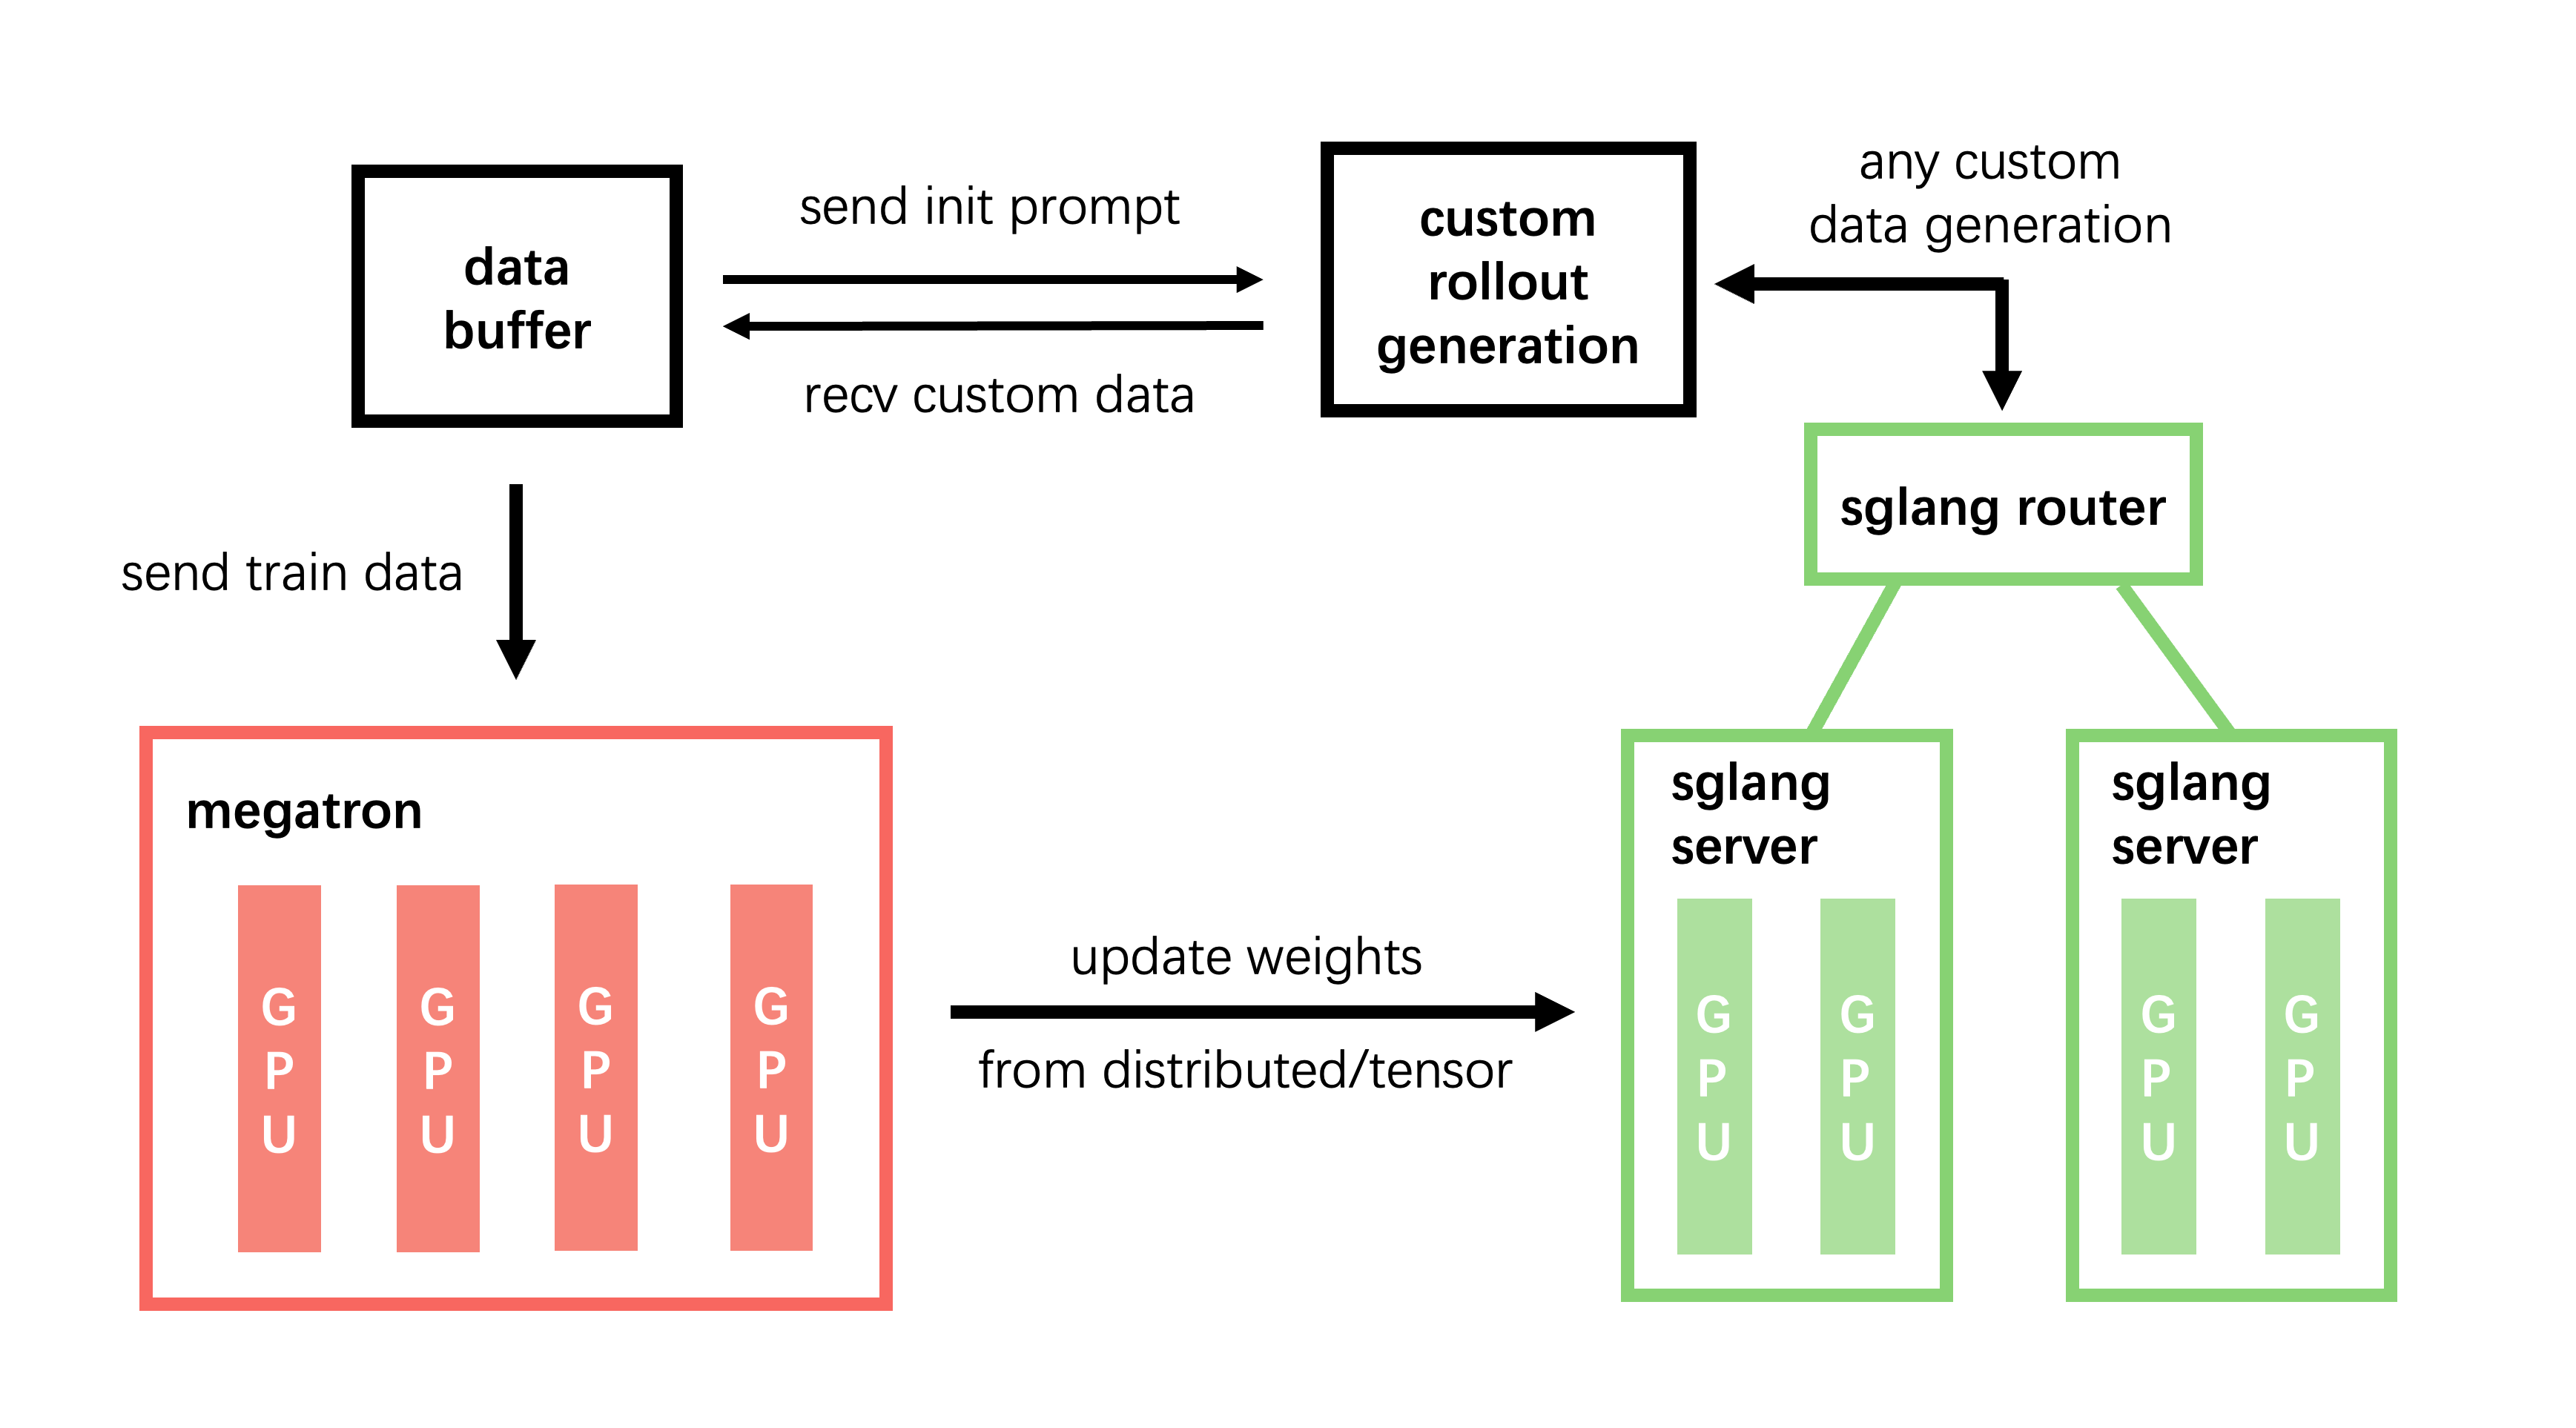
三模块数据流:training(Megatron 读 Data Buffer 训练后同步权重)↔ Data Buffer(桥梁)↔ rollout(SGLang + router 生成数据/reward 写回)。共置 vs 解耦由 --colocate 单 flag 切换,同步 vs 异步由训练循环里 ray.get 的位置决定。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/THUDM/slime |
| Star / Fork | 6,015 / 873 |
| 代码行数 | 52,799 行(Python 84.5% 核心 + Shell 13.8% 多机多卡训练脚本,CUDA 0.6%;内核极薄,复杂度让给用户 pipeline) |
| 项目年龄 | 11.6 个月(2025-06-18「init」) |
| 开发阶段 | 密集开发(12 个月 1490 commit,周末 21.5% / 深夜 23.6% 的学术研究节律) |
| 贡献模式 | 核心少数 + 社区(169 人,主作者 Zilin Zhu 约占 55%) |
| 热度定位 | 大众热门 / LLM RL 后训练赛道头部 |
| 质量评级 | 代码「优」 文档「优」(中英双语) 测试「优」 CI「优」 |
作者视角:为什么存在这个项目
创始人/作者背景
owner 是 THUDM(清华大学知识工程组 KEG / 智谱 AI Z.ai,GLM 大模型团队,代表作 ChatGLM/GLM-4/GLM-4.5/CogVLM/CodeGeeX,11,868 followers)。主作者 Zilin Zhu(@zhuzilin) 绝对主导(两个 handle 合计约 825 commits、占约 55%),现在智谱做 RL+LLM 训练框架(MLSys 方向),此前在微信大模型团队做过从零预训练/SFT/RLHF 及训练框架,是 PyTorch 贡献者。关键第二贡献者 @fzyzcjy 是 SGLang/RL 生态的高产者,印证 slime 与 SGLang 社区的深度绑定。这是从「为 GLM 真正跑通完整 RL 后训练循环」这个生产需求倒推出来的框架,而非 demo。
问题判断
要解决「RL Scaling」里两个本质矛盾能力的统一:① 大模型高性能训练(Megatron);② 任意形态的数据生成(math/code/search/tool/sandbox/multi-agent/long-horizon agentic)。现有方案不够在于:
- 多后端框架(同时支持 vLLM/SGLang/TRT)被迫抽象到「多引擎最小公共子集」,把 SGLang 的 router/cache/PD 分离/weight-sync 等强项埋没;
- 共置单体(veRL HybridEngine)灵活性不足,难承载「rollout 当带 server 边界的 IO 服务」的 agentic 形态;
- RL bug 往往是静默的,所以需要「显式数据流 + rollout-only/train-only 分离调试 + CI 数值复现」当一等工程目标。
解法哲学
「轻量内核,复杂度让给用户 pipeline」。证据是训练主控 train.py 仅 107 行、train_async.py 85 行,整个同步/异步训练循环可一眼读完。内核只负责「training ↔ Data Buffer ↔ rollout」三段编排,所有领域复杂度(reward/verifier/sandbox/multi-turn/multi-agent)通过十余个 --*-path 插桩点注入,不 fork 训练内核。另一条哲学是「不做 wrapper 抽象、直接吃上游」:Megatron 参数直读、SGLang 参数 --sglang- 前缀直通、甚至直接 import SGLang 内部类——只有深度绑定 SGLang 社区的人才敢这么押注。
战略意图
slime 是「SGLang-Native」战略的一部分:通过只押注 SGLang 单后端,直接复用其 router 负载均衡、PD 分离、prefix cache、deterministic inference、delta weight sync,反过来也驱动这些特性演进。商业上它是智谱 GLM 系列的 RL 生产引擎,被 z.ai 多代模型 release 验证;同时已成为 7+ 个下游系统(Relax、P1、RLVE、TritonForge 等)的 RL 基座。Apache-2.0。
核心价值提炼
创新之处
诚实区分:第 1/5/6 项是可被广泛借鉴的设计模式;第 3/4 项是高水准但与 Megatron+SGLang 强耦合的系统工程(迁移成本高);第 2 项是路线选择(与 veRL 的明确分野,非绝对优劣)。
- SGLang 参数零维护直通(新颖度 4/5,可迁移性 4/5):
add_sglang_arguments临时把parser.add_argument替换成包裹函数、再调上游ServerArgs.add_cli_args,每个 SGLang flag 自动加--sglang-前缀,冲突项进黑名单。SGLang 升级即免费拿到新参数,零维护。这个「monkeypatch 上游 parser 自动加前缀」可直接搬到任何薄封装带 CLI 子系统的项目。 - 保留 server 边界的异步 rollout(新颖度 4/5,实用性 5/5):每个 SGLang 引擎是独立 HTTP server,rollout 纯 asyncio + httpx POST
/generate,router 做负载均衡 + 一致性哈希(X-SMG-Routing-Key: session_id实现 multi-turn 亲和)。换来 rollout 可任意复杂(per-request 控制、abort、partial rollout 回收、PD 分离、external engine),且能独立扩缩与调试。 - 三态权重同步(含 Delta 逐字节 diff)(新颖度 5/5,可迁移性 3/5):共置走
UpdateWeightFromTensor(FlattenedTensorBucket拍平张量 + Ray IPC 句柄零拷贝直传,Qwen3-30B-A3B ~7 秒);解耦走 NCCL 分桶广播;Delta 走逐字节 diff——对上次广播快照做view(int_dtype)逐元素比较、只发改变的位置+值(indices/gap/zstd 三种编码),receiver 无算术直接覆写保证零漂移,transport 可 nccl 或 disk(跨数据中心),还用双 side-stream 把搬运 overlap 到计算后面。 - torch_memory_saver 共置显存时分复用(新颖度 4/5):
--colocate下训练态(Megatron 优化器/激活)与推理态(SGLang 权重/KV/CUDA graph)抢同批 GPU,靠torch_memory_saver.pause/resume释放物理页但保留虚拟地址、SGLang 按 WEIGHTS/KV_CACHE/CUDA_GRAPH 三档分阶段释放、NCCL 进程组可销毁重建。榨干单卡利用率(issue #537 OOM 正是这块的实战痛点)。 - string-in/token-out 轨迹契约 + token provenance 守卫(新颖度 5/5,可迁移性 5/5):每轮用
return_logprob=True记录精确 token 流,tool observation 拼接为loss_mask=0、模型新输出loss_mask=1;若后续 prompt 与早先采样输出 token 对不上,丢弃失配后缀,漂移切穿模型输出中段则整轮降为不反传——绝不对来源不可证的 token 反传。这是所有 multi-turn/tool-use/multi-agent RL 都会踩的正确性坑的标准答案。 - 统一 Data Buffer +
ray.get位置切并发模式(新颖度 4/5,可迁移性 5/5):同步循环阻塞ray.get(generate.remote())等生成完才训练;异步循环把下一个 generate 提前.remote()发出去、训练当前时它在后台跑;fully-async 用常驻线程维持并发池、ABORTED 样本回灌。一份数据通路,靠ray.get摆放位置切三种并发。
可复用的模式与技巧
- Parser-wrapper 自动前缀直通:薄封装任何带 argparse/dataclass CLI 的子系统。
ray.get位置即并发模型:把工作单元做成 ObjectRef,靠在循环里何处ray.get切同步/流水线/全异步——任何 producer-consumer 流水线。- 字符串路径动态插桩(
--xxx-path+load_function):内核稳定、扩展点开放的插件式框架。 - 逐字节 diff + 稀疏增量同步:任何「大状态周期性小改动」的同步场景(不限 RL)。
- token provenance 守卫(string-in/token-out):所有 multi-turn agentic RL 训练数据构造。
- side-stream H2D/D2H 计算-传输重叠:任何 GPU 上「算一块、搬一块」的流水线。
关键设计决策
最能体现 slime 哲学的是**「轻量内核 + 十余个插桩点」让 agentic RL 不 fork 内核**。train.py 只有 107 行,所有领域复杂度通过 --rollout-function-path(整体替换生成函数,multi_agent/fully_async 走这条)和 --custom-generate-function-path(只替换单样本 generate,search-r1/coding_agent 走这条、复用框架的并发/reward/buffer)注入,运行时 load_function 动态 import。配合 string-in/token-out 的 token provenance 守卫,用户能写任意复杂的 agent 循环(多轮、工具、沙箱),而训练内核完全不变、RL 正确性还有保证。这套「内核极薄 + 扩展点开放 + 正确性守卫」的组合,是 slime 区别于「把 agentic 模板硬塞进框架」的同类项目的根本(关键文件 slime/agent/trajectory.py 的 merge_turns、slime/rollout/ 各 rollout 实现)。
竞品格局与定位
竞品对比矩阵
| 维度 | slime | veRL(字节) | OpenRLHF | TRL(HF) |
|---|---|---|---|---|
| Stars | 6K | ~21.8K | ~9.6K | ~18.6K |
| rollout 架构 | server 边界(HTTP + router) | HybridEngine 共置单体 | Ray + vLLM | 进程内 |
| 推理后端 | SGLang 原生(单一) | 多后端(vLLM/SGLang) | vLLM | transformers |
| 定位 | 前沿模型 + agentic 生产 RL | 算法最全、产业最广 | 开箱即用 RLHF | 易用、中小规模 |
| 生产验证 | GLM-4.5→5.1 实战 | 字节及广泛产业 | 社区 | HF 生态 |
差异化护城河
① SGLang-Native 单后端深度绑定(直接 import SGLang 内部类 DeltaSpec/FlattenedTensorBucket,别家做不到这个耦合深度);② GLM-4.5→5.1 多代生产验证(最强的「battle-tested」背书);③ 轻量内核 + 十余个插桩点带来的 agentic 灵活性;④ weight-sync / 显存腾挪的系统工程深度。
竞争风险
- star 落后 veRL(21.8K vs 6K,生态/心智份额劣势);
- SGLang 单点绑定:SGLang 出问题或换代时 slime 直接受冲击(docker/patch 下覆盖 SGLang v0.5.0rc0→latest 的 patch 矩阵已是明证);
- Megatron 门槛高,劝退中小团队;
- bus factor 风险:主作者一人占约 55% commits,关键系统工程知识高度集中。
生态定位
「前沿大模型 + agentic RL 的生产级 SGLang-Native 后训练基座」。不争 TRL 的易用心智,正面对标 veRL 但用「server 边界 + SGLang 原生 + 轻量灵活」打差异化,已成为 7+ 下游系统的 RL 底座。与 veRL 的「共置单体 vs server 边界」之争,本质是「极致吞吐 vs agentic 灵活」的路线选择。
套利机会分析
- 信息差:LLM RL 后训练 infra 是 2025-2026 最热的赛道之一,而 slime 是其中唯一「SGLang 原生 + 真实 SOTA 模型(GLM)训练验证」的开源框架;中文圈对「slime vs veRL 路线分野」「Delta 权重同步」「共置显存腾挪」「token provenance 守卫」这些技术细节的系统梳理稀缺,深度解读价值高。
- 技术借鉴:parser-wrapper 直通、
ray.get位置切并发、字符串路径插桩、逐字节 diff 增量同步、token provenance 守卫、side-stream 计算传输重叠——这六个可迁移到任何分布式系统/流水线/agentic 训练,远超 RL 本身。 - 生态位:填补「为前沿 reasoning/agentic 模型做大规模 RL」的生产级开源空白,与 veRL 形成路线分野。
- 趋势判断:踩在「RL 是通往 AGI 最后一块拼图」与「agentic RL」两大趋势核心;SGLang 生态共生是助力也是单点风险。
风险与不足
- 门槛高:必须接受 Megatron(生产级但重)+ SGLang + Ray 这一固定组合,中小团队上手成本远高于 TRL/OpenRLHF。
- SGLang 强耦合:直接 import SGLang 内部类 + 全版本 docker patch 矩阵,上游换代维护税真实(虽用 patch + fallback 系统化管理)。
- bus factor:核心系统工程高度集中在主作者一人,知识传承有风险。
- research-style 发版:8 个 release(v0.3.0),主要靠 main 滚动,生产使用需自行钉 commit。
- 共置开销:每个 rollout 边界要做一次「offload→onload」+ 进程组重建,对显存碎片极敏感。
行动建议
- 如果你要用它:适合「做前沿大模型 / reasoning / agentic 模型大规模 RL 后训练」的团队,尤其已用 SGLang + Megatron 的;先跑
examples/里的 GRPO/coding_agent_rl/search-r1。中小规模或求易用选 TRL/OpenRLHF;要多推理后端选 veRL。注意 SGLang 版本对齐(用官方 docker patch)。 - 如果你要学它:直奔
train.py/train_async.py(107 行轻量内核)、slime/ray/placement_group.py(共置/解耦开关)、slime/backends/megatron_utils/update_weight/(三态权重同步,尤其 delta 逐字节 diff)、slime/utils/memory_utils.py(torch_memory_saver 显存腾挪)、slime/agent/trajectory.py(token provenance 守卫)。这五处是系统工程精华。 - 如果你要 fork / 借鉴它:parser-wrapper 直通、
ray.get位置切并发、token provenance 守卫是可直接迁移的三套设计;但 weight-sync/显存腾挪与 Megatron+SGLang 强绑定,迁移成本高。注意 Apache-2.0。
知识入口
| 资源 | 链接 |
|---|---|
| 官方文档 | https://thudm.github.io/slime(中英双语,含架构/SGLang Config/PD 分离/Delta Weight Sync) |
| DeepWiki | https://deepwiki.com/THUDM/slime(已收录,15 章覆盖架构/Ray 编排/权重同步/容错/自定义插件) |
| 设计博客 | slime: An SGLang-Native Post-Training Framework for RL Scaling(LMSYS) |
| 关联论文 | GLM-4.5: Agentic, Reasoning, and Coding Foundation Models(arXiv:2508.06471)(slime 即其 RL 后训练基础设施) |