GitHub推荐:腾讯云 TencentDB Agent Memory: 10K stars 的 L0–L3 蒸馏,把 Agent 记忆从「聊天日志」变成「可治理资产」
GitHub: https://github.com/tencentcloud/tencentdb-agent-memory
一句话总结
腾讯云首个面向多 Agent 协作的「结构化记忆平台」——把对话、Skill、文档、代码沉淀为可治理、可共享的四类资产,以 L0→L3 异步蒸馏管线分层抽象,在 Mem0/Letta/Cognee/Zep 都没碰的「团队级资产治理」赛道上卡位。
值得关注的理由
- 错位竞争: Mem0(45K+)、Letta(15K+)、Cognee(8K+)、Zep(4K+) 在「团队治理 / 多类资产 / 按需工具调用 / CodeGraph 影响分析」四点同时成立的几乎没有,这是它最深的护城河。
- 工程成熟度对标企业级 SaaS: 12.5 万行代码 / 732 文件 / 4 大模块( MemoryCore + MemoryKnowledge + MemoryPanel + MemoryProxy ),内部已迭代成熟的工业级系统首次 dump 公开,自带
start-all.sh三件套一键拉起。 - 数据已背书: PersonaMem 基准从 48% 提升到 76%(+59%),CSDN 报道 61.38% Token 节省、51.52% 任务通过率提升,公开后 60 天内冲到 10K+ stars。
项目展示
 — 类型: hero
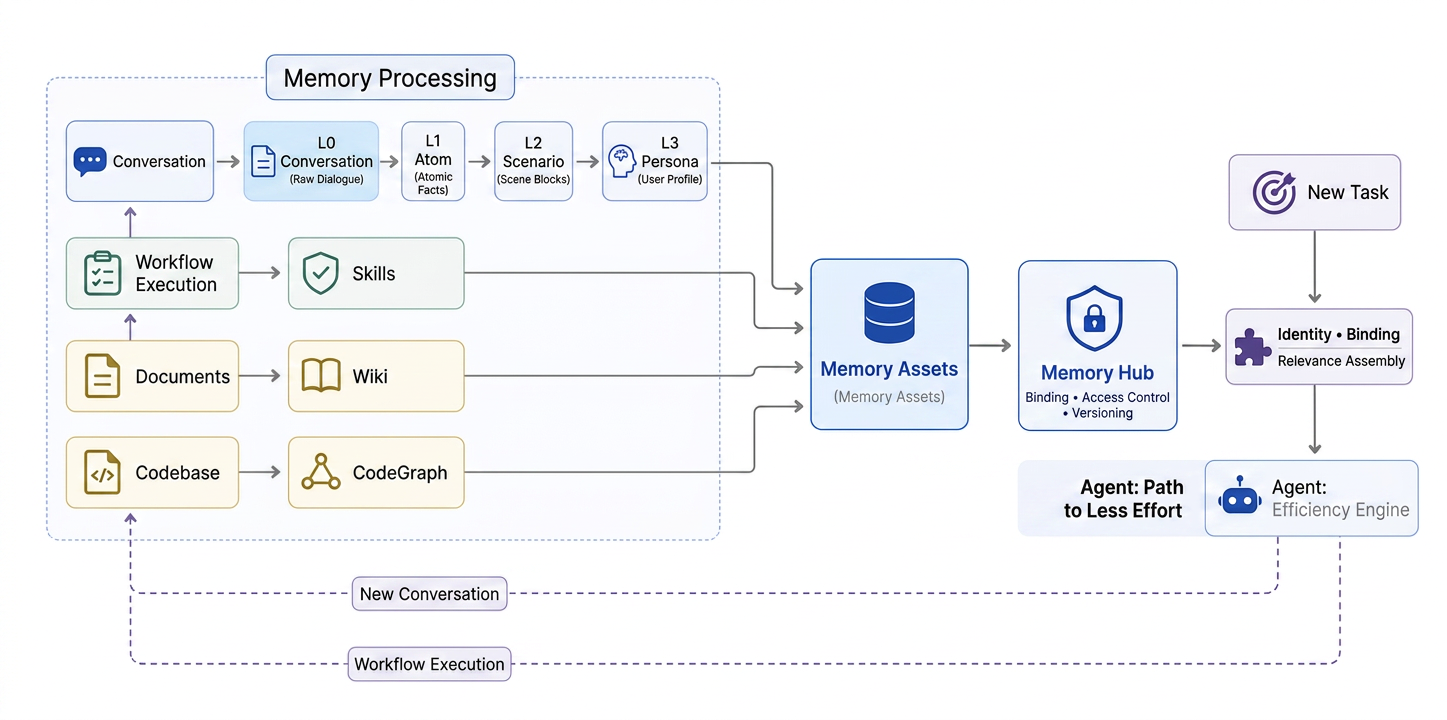 — 类型: architecture(技术总览: 分层 + Hub + 资产 + 装配)
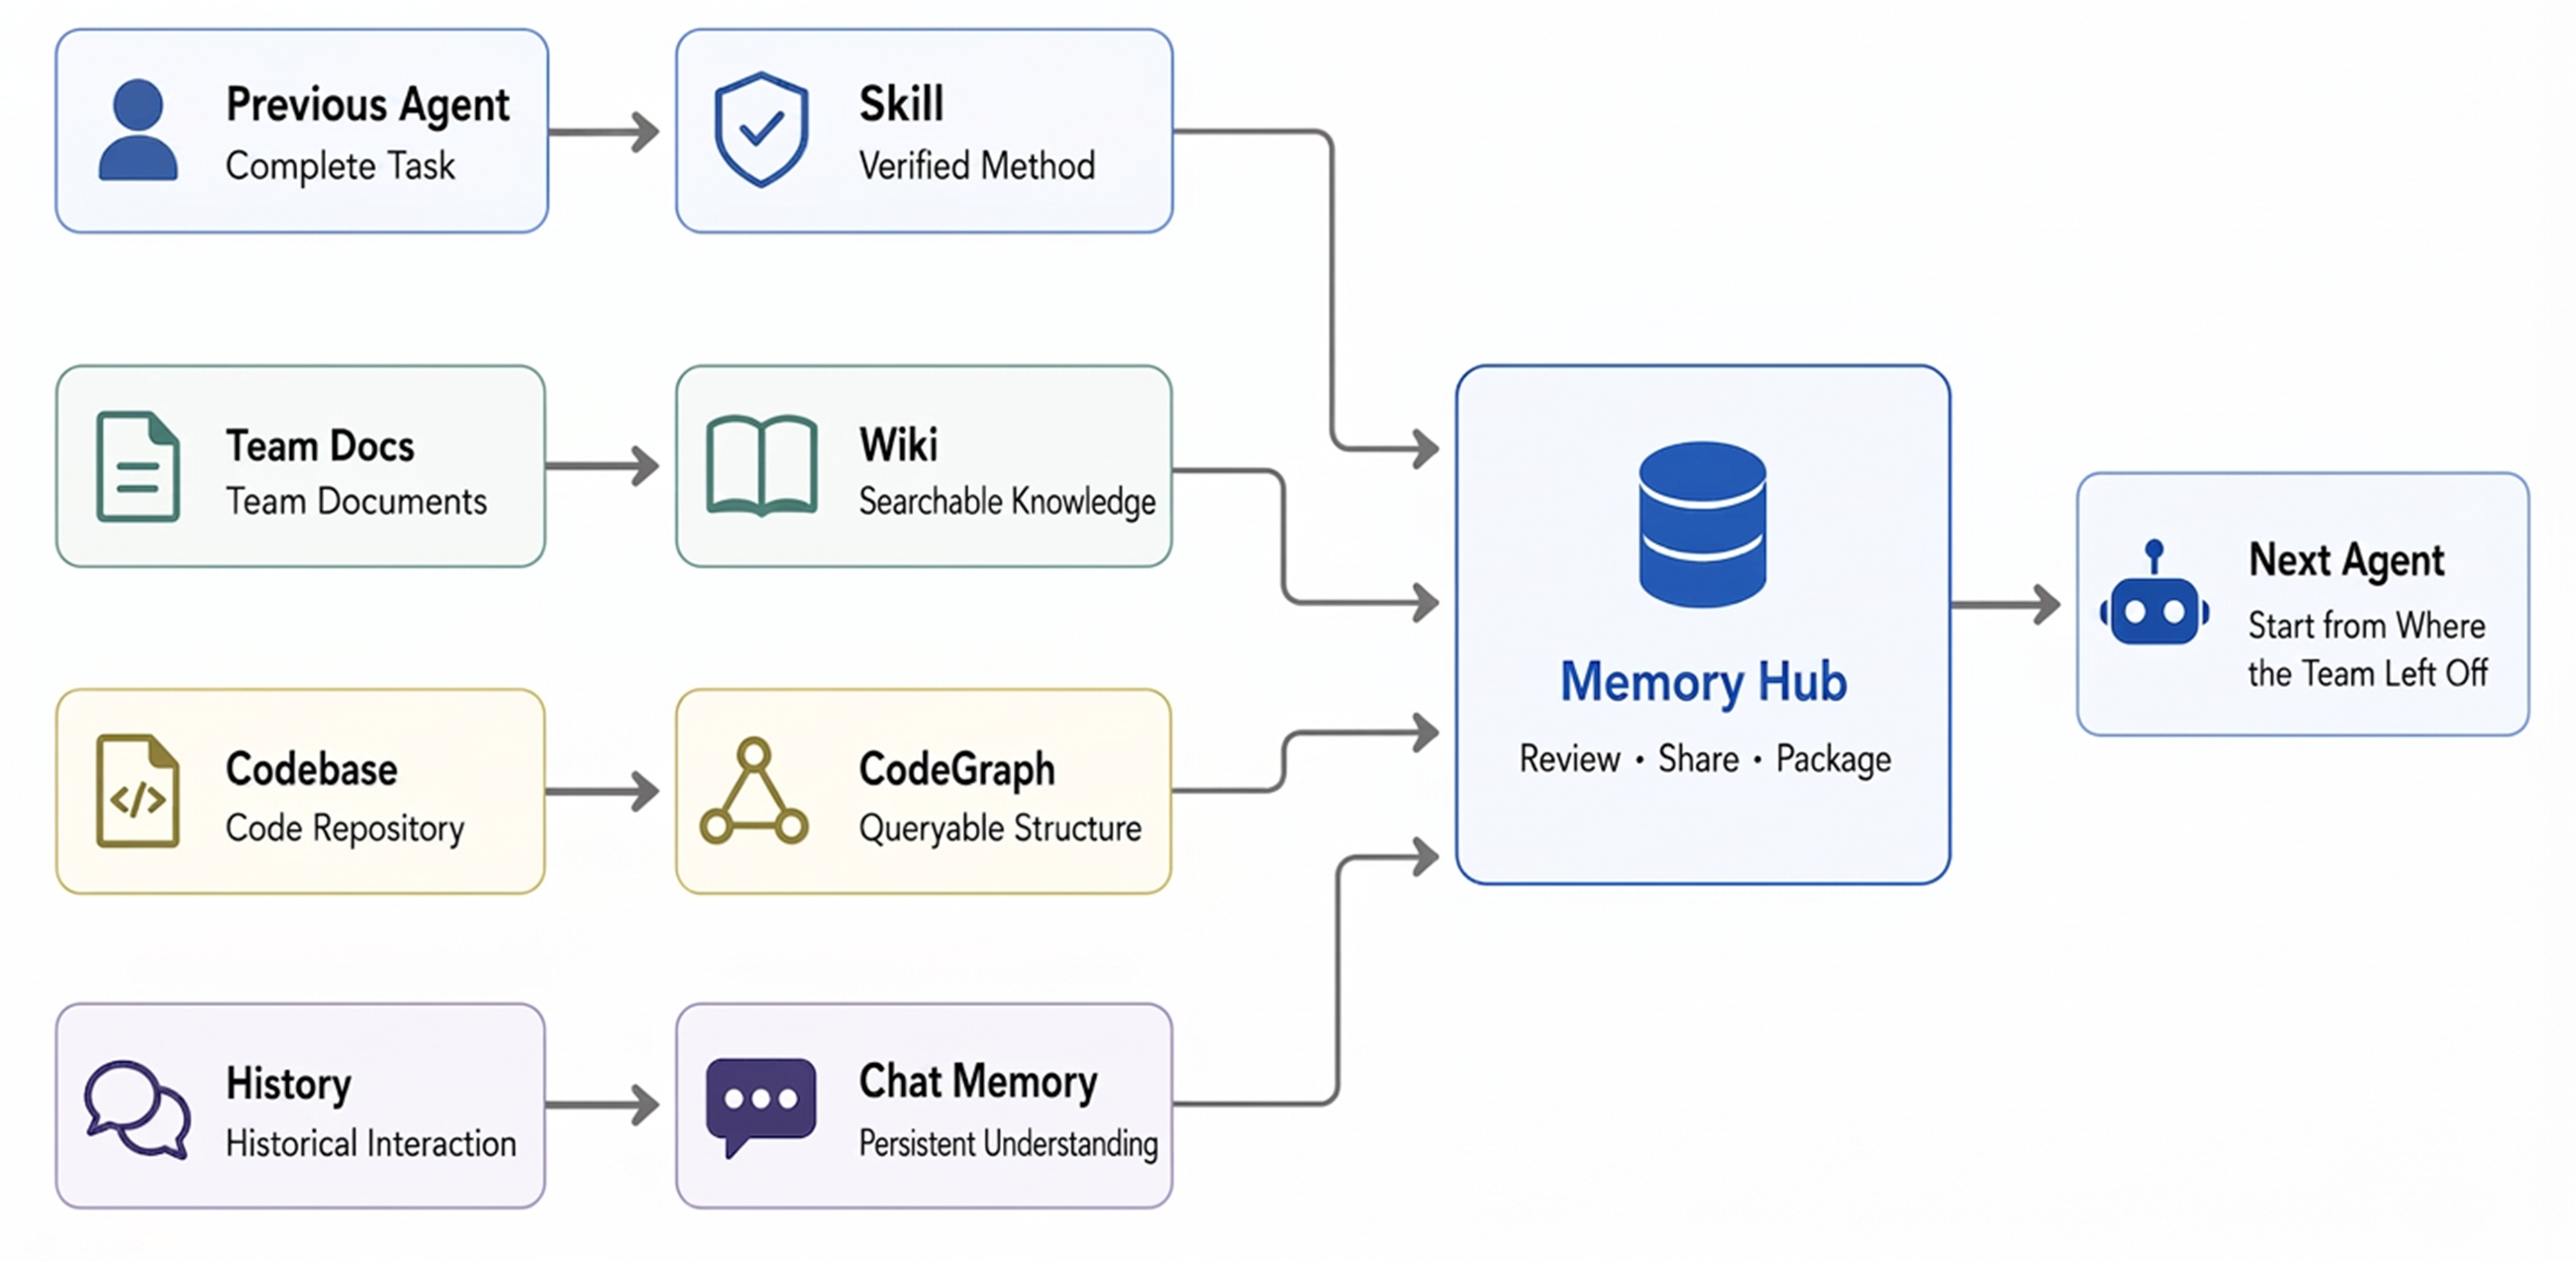 — 类型: architecture(冷启动导入流程)
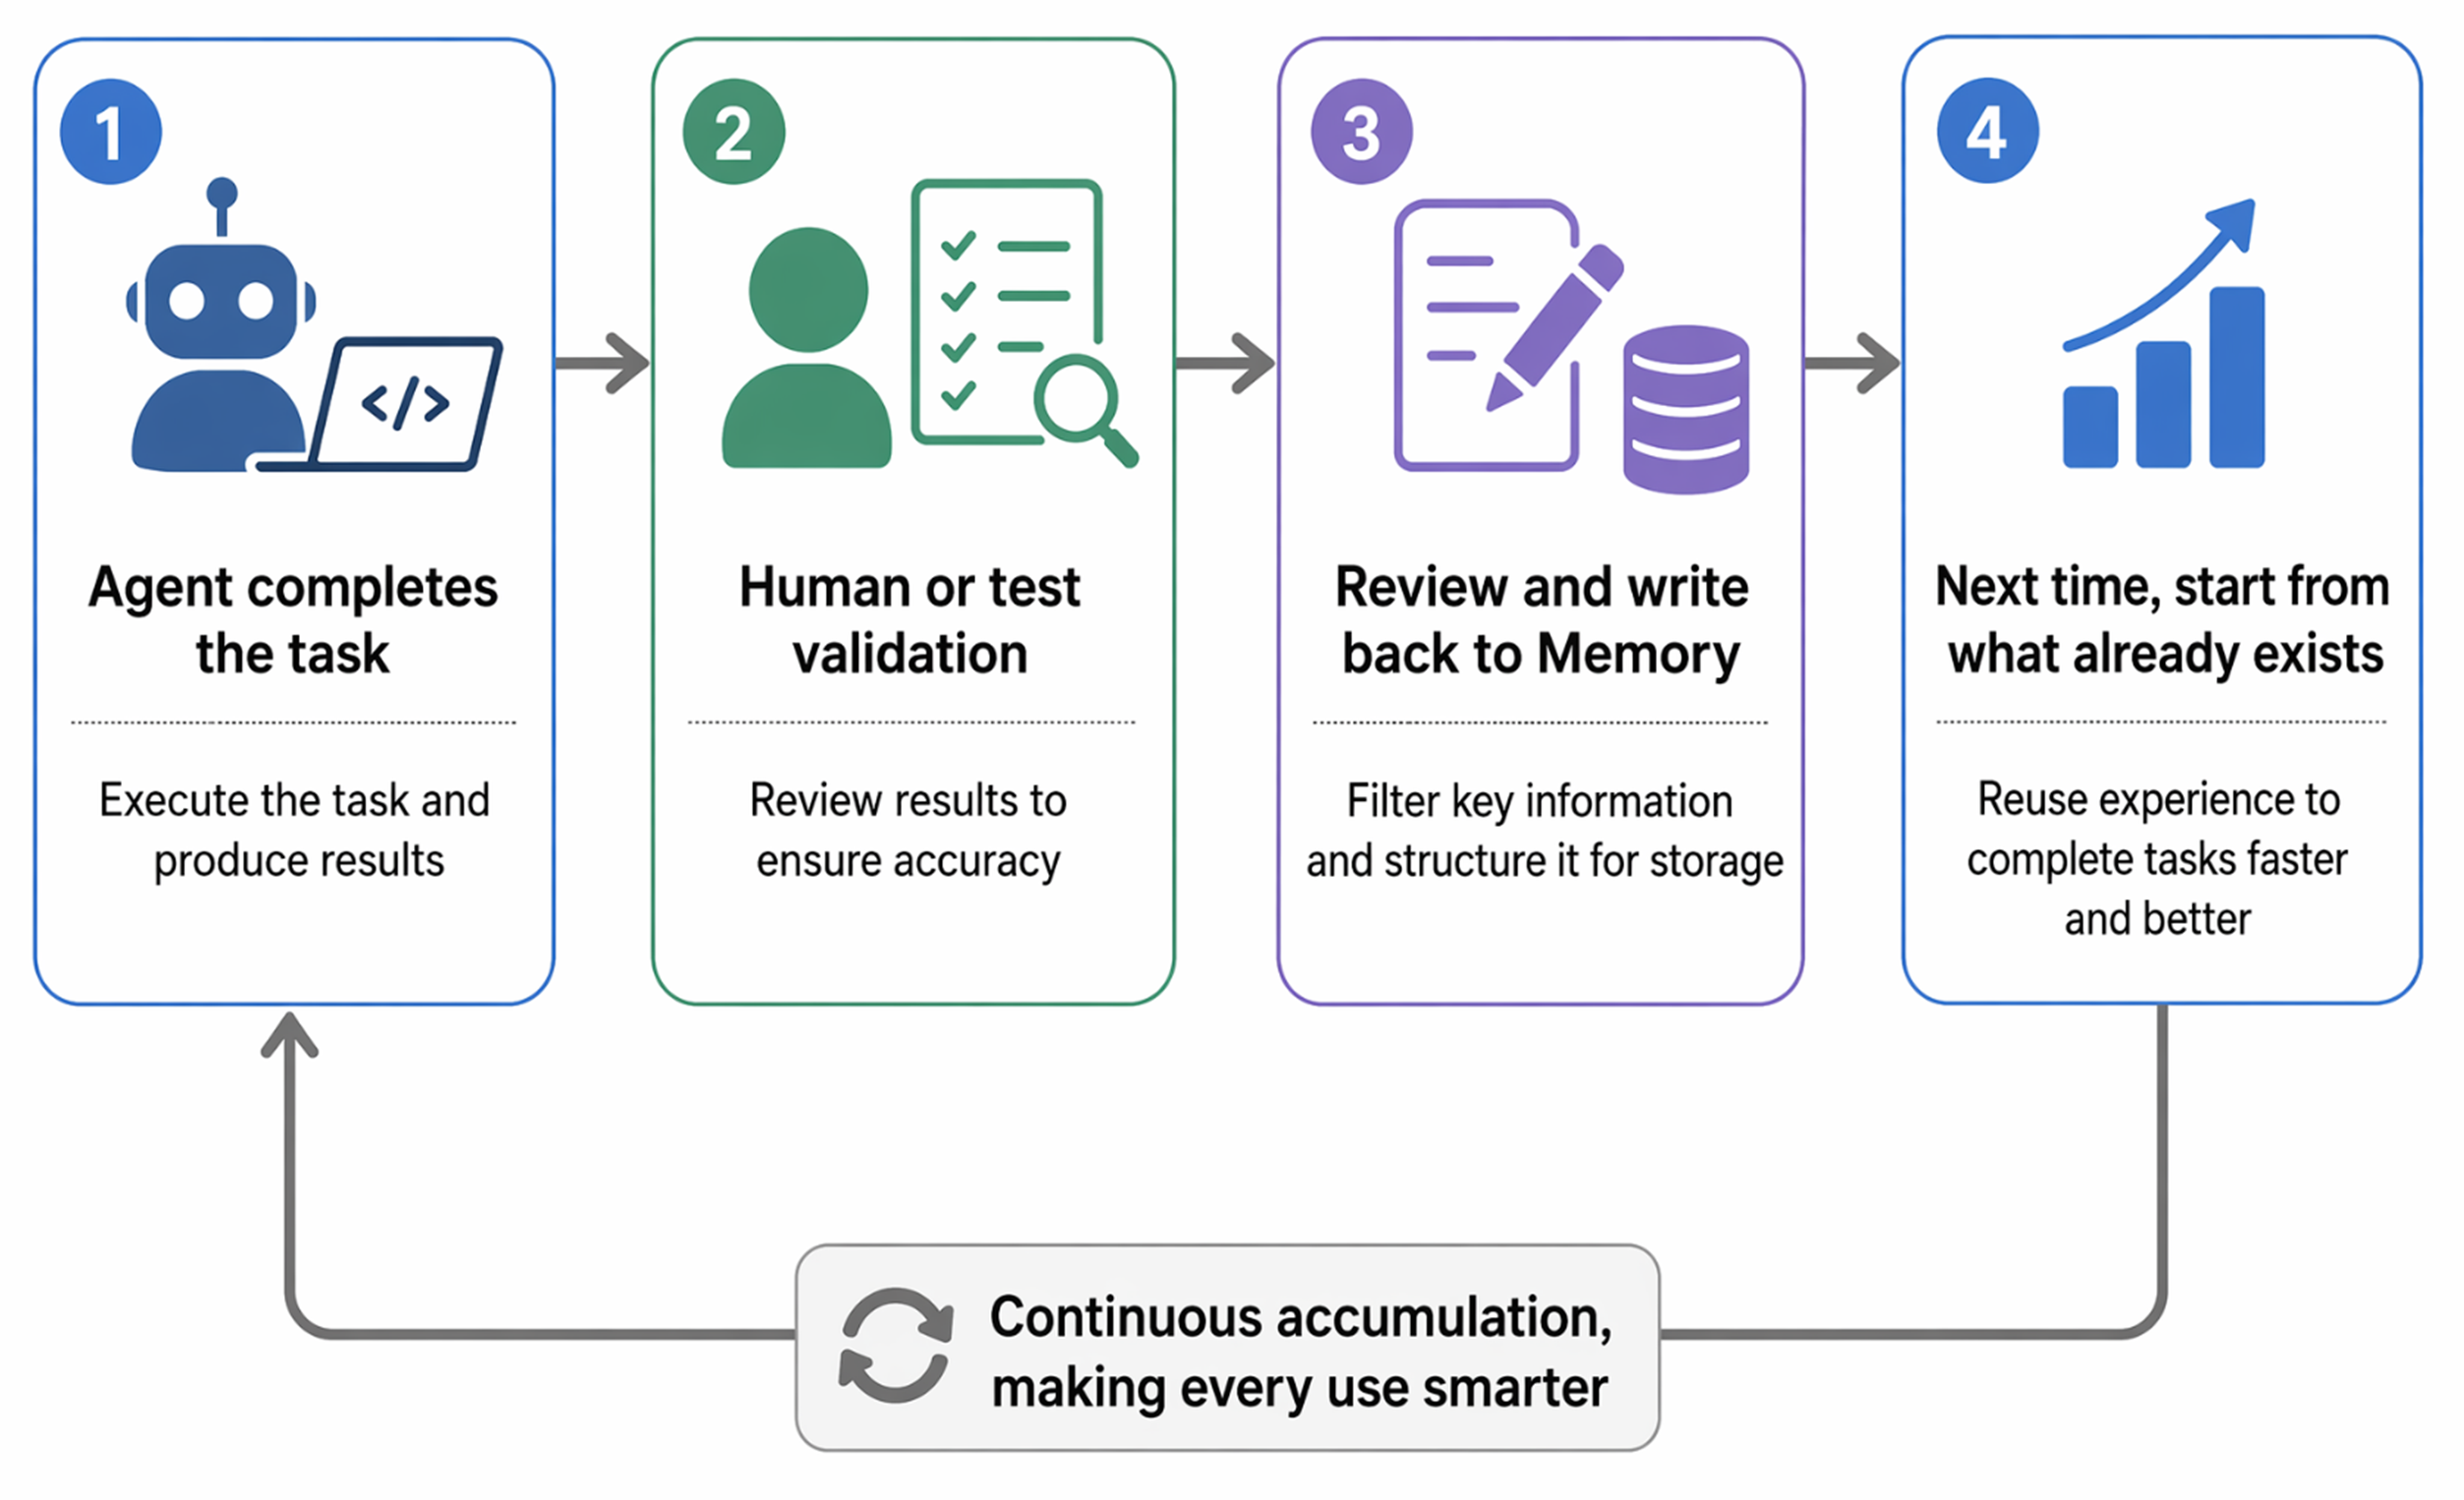 — 类型: demo(每轮循环沉淀经验)
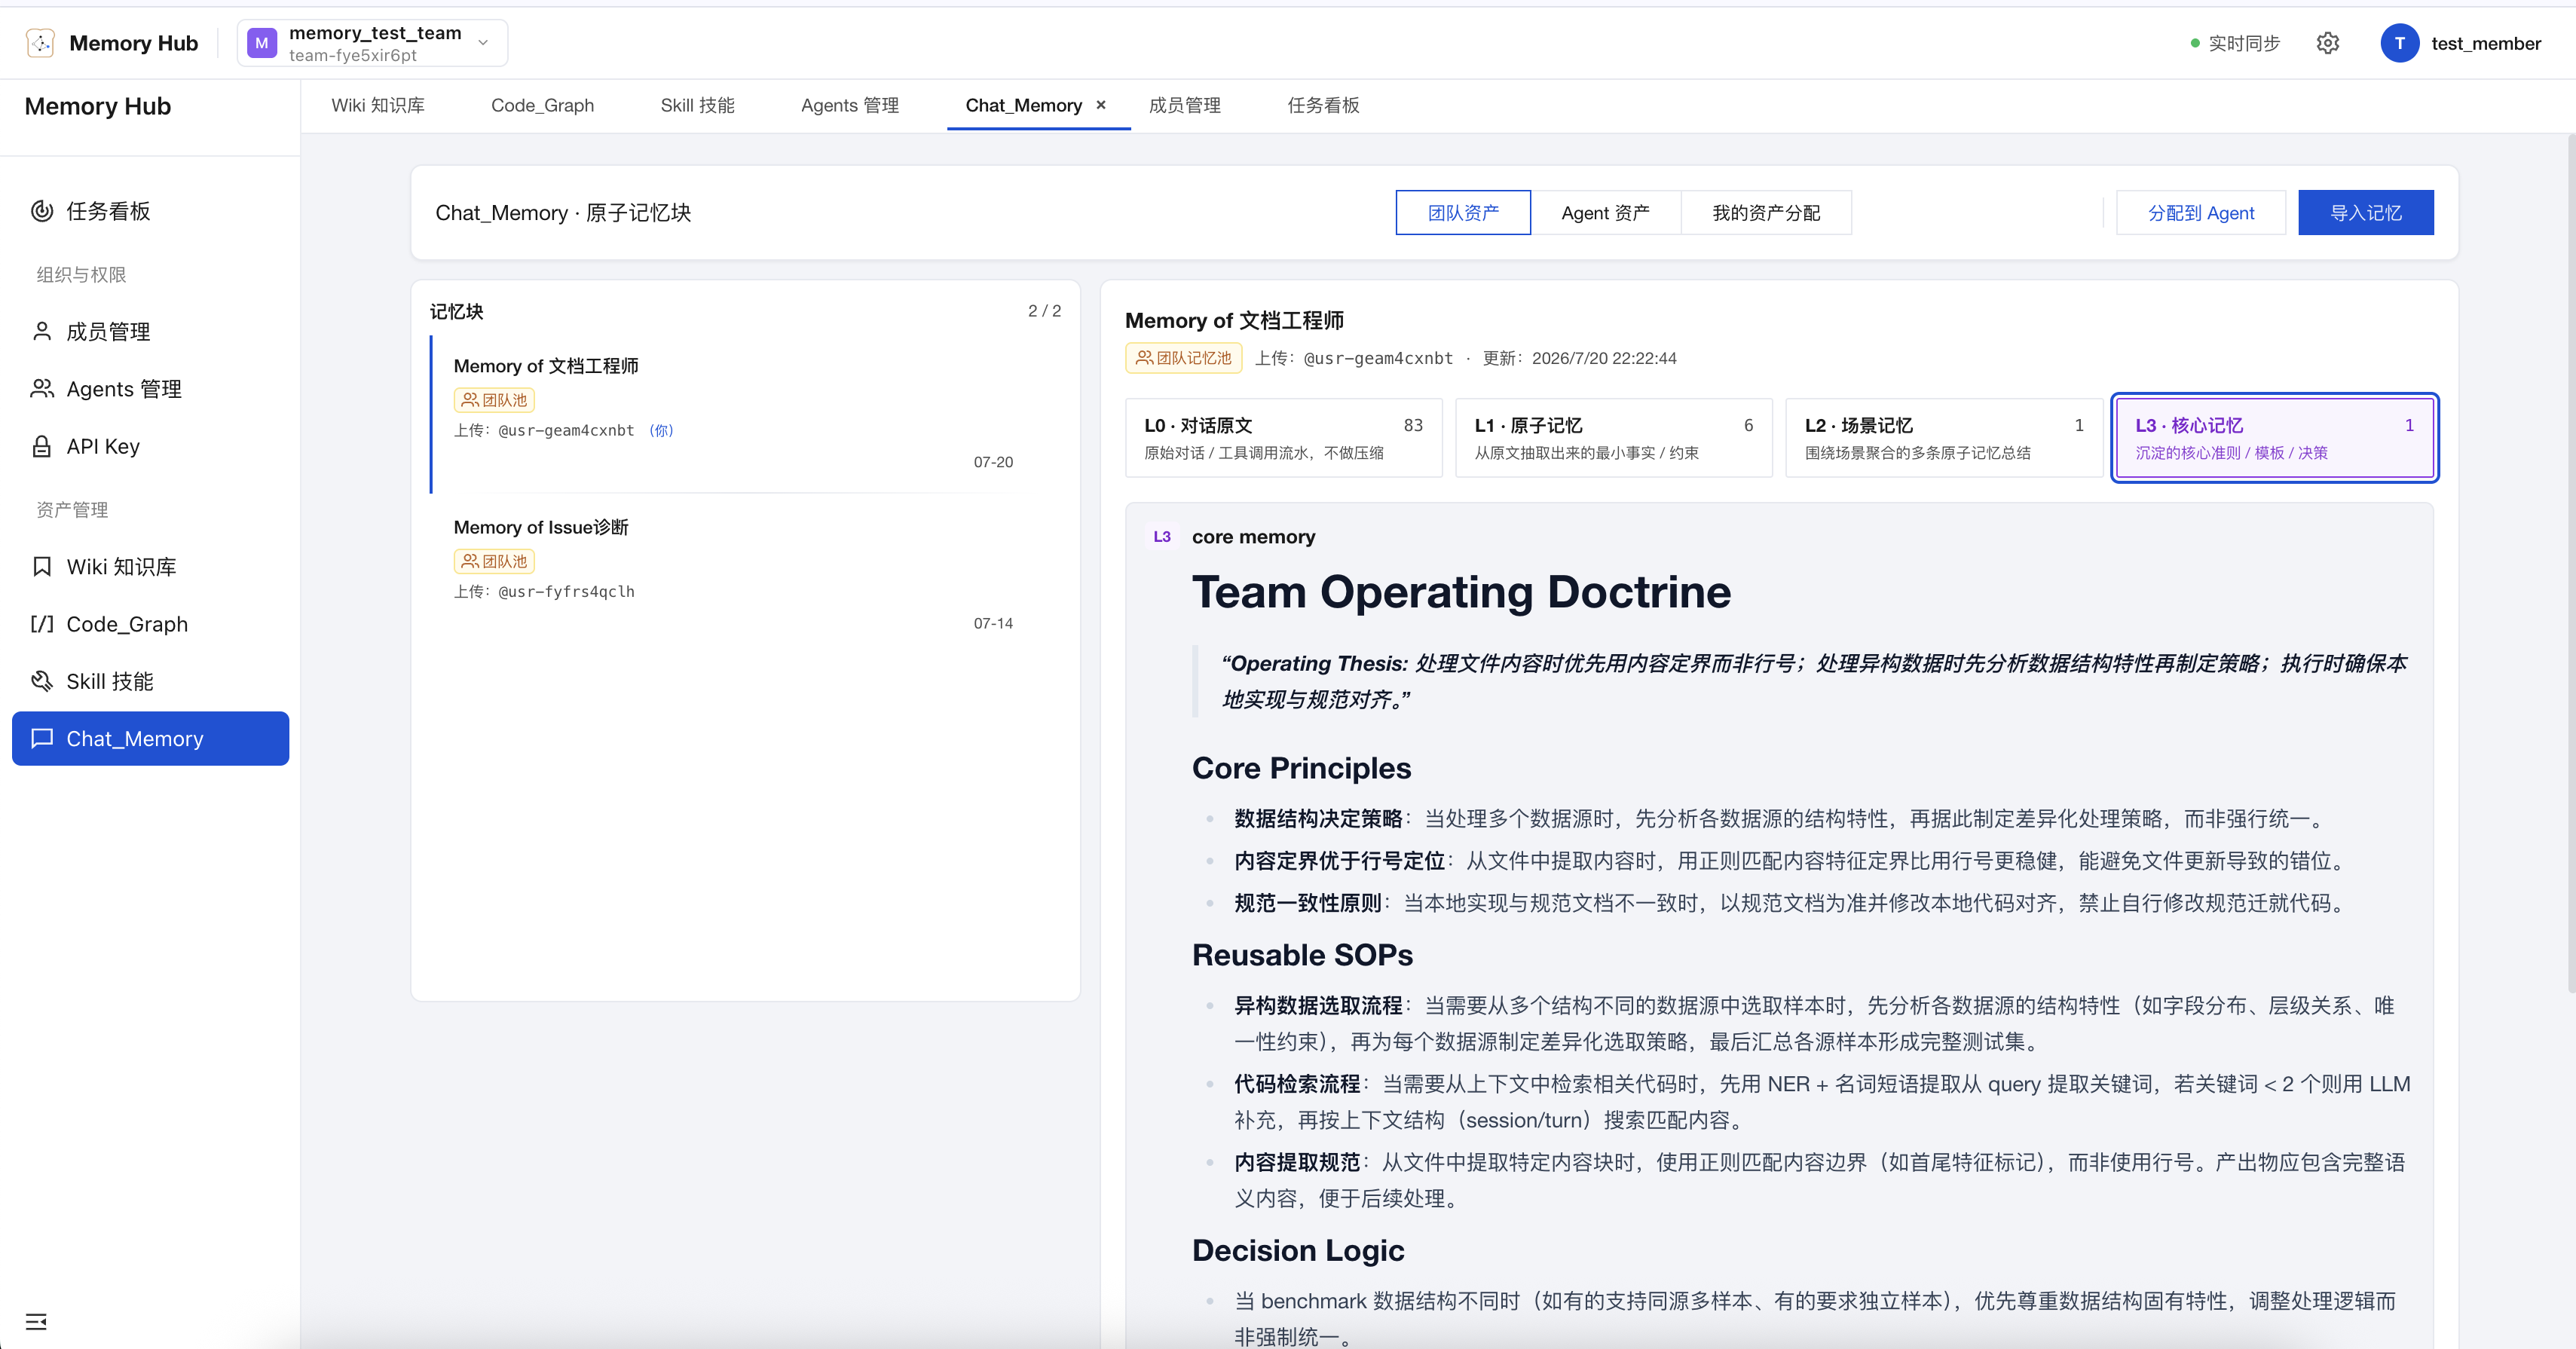 — 类型: screenshot
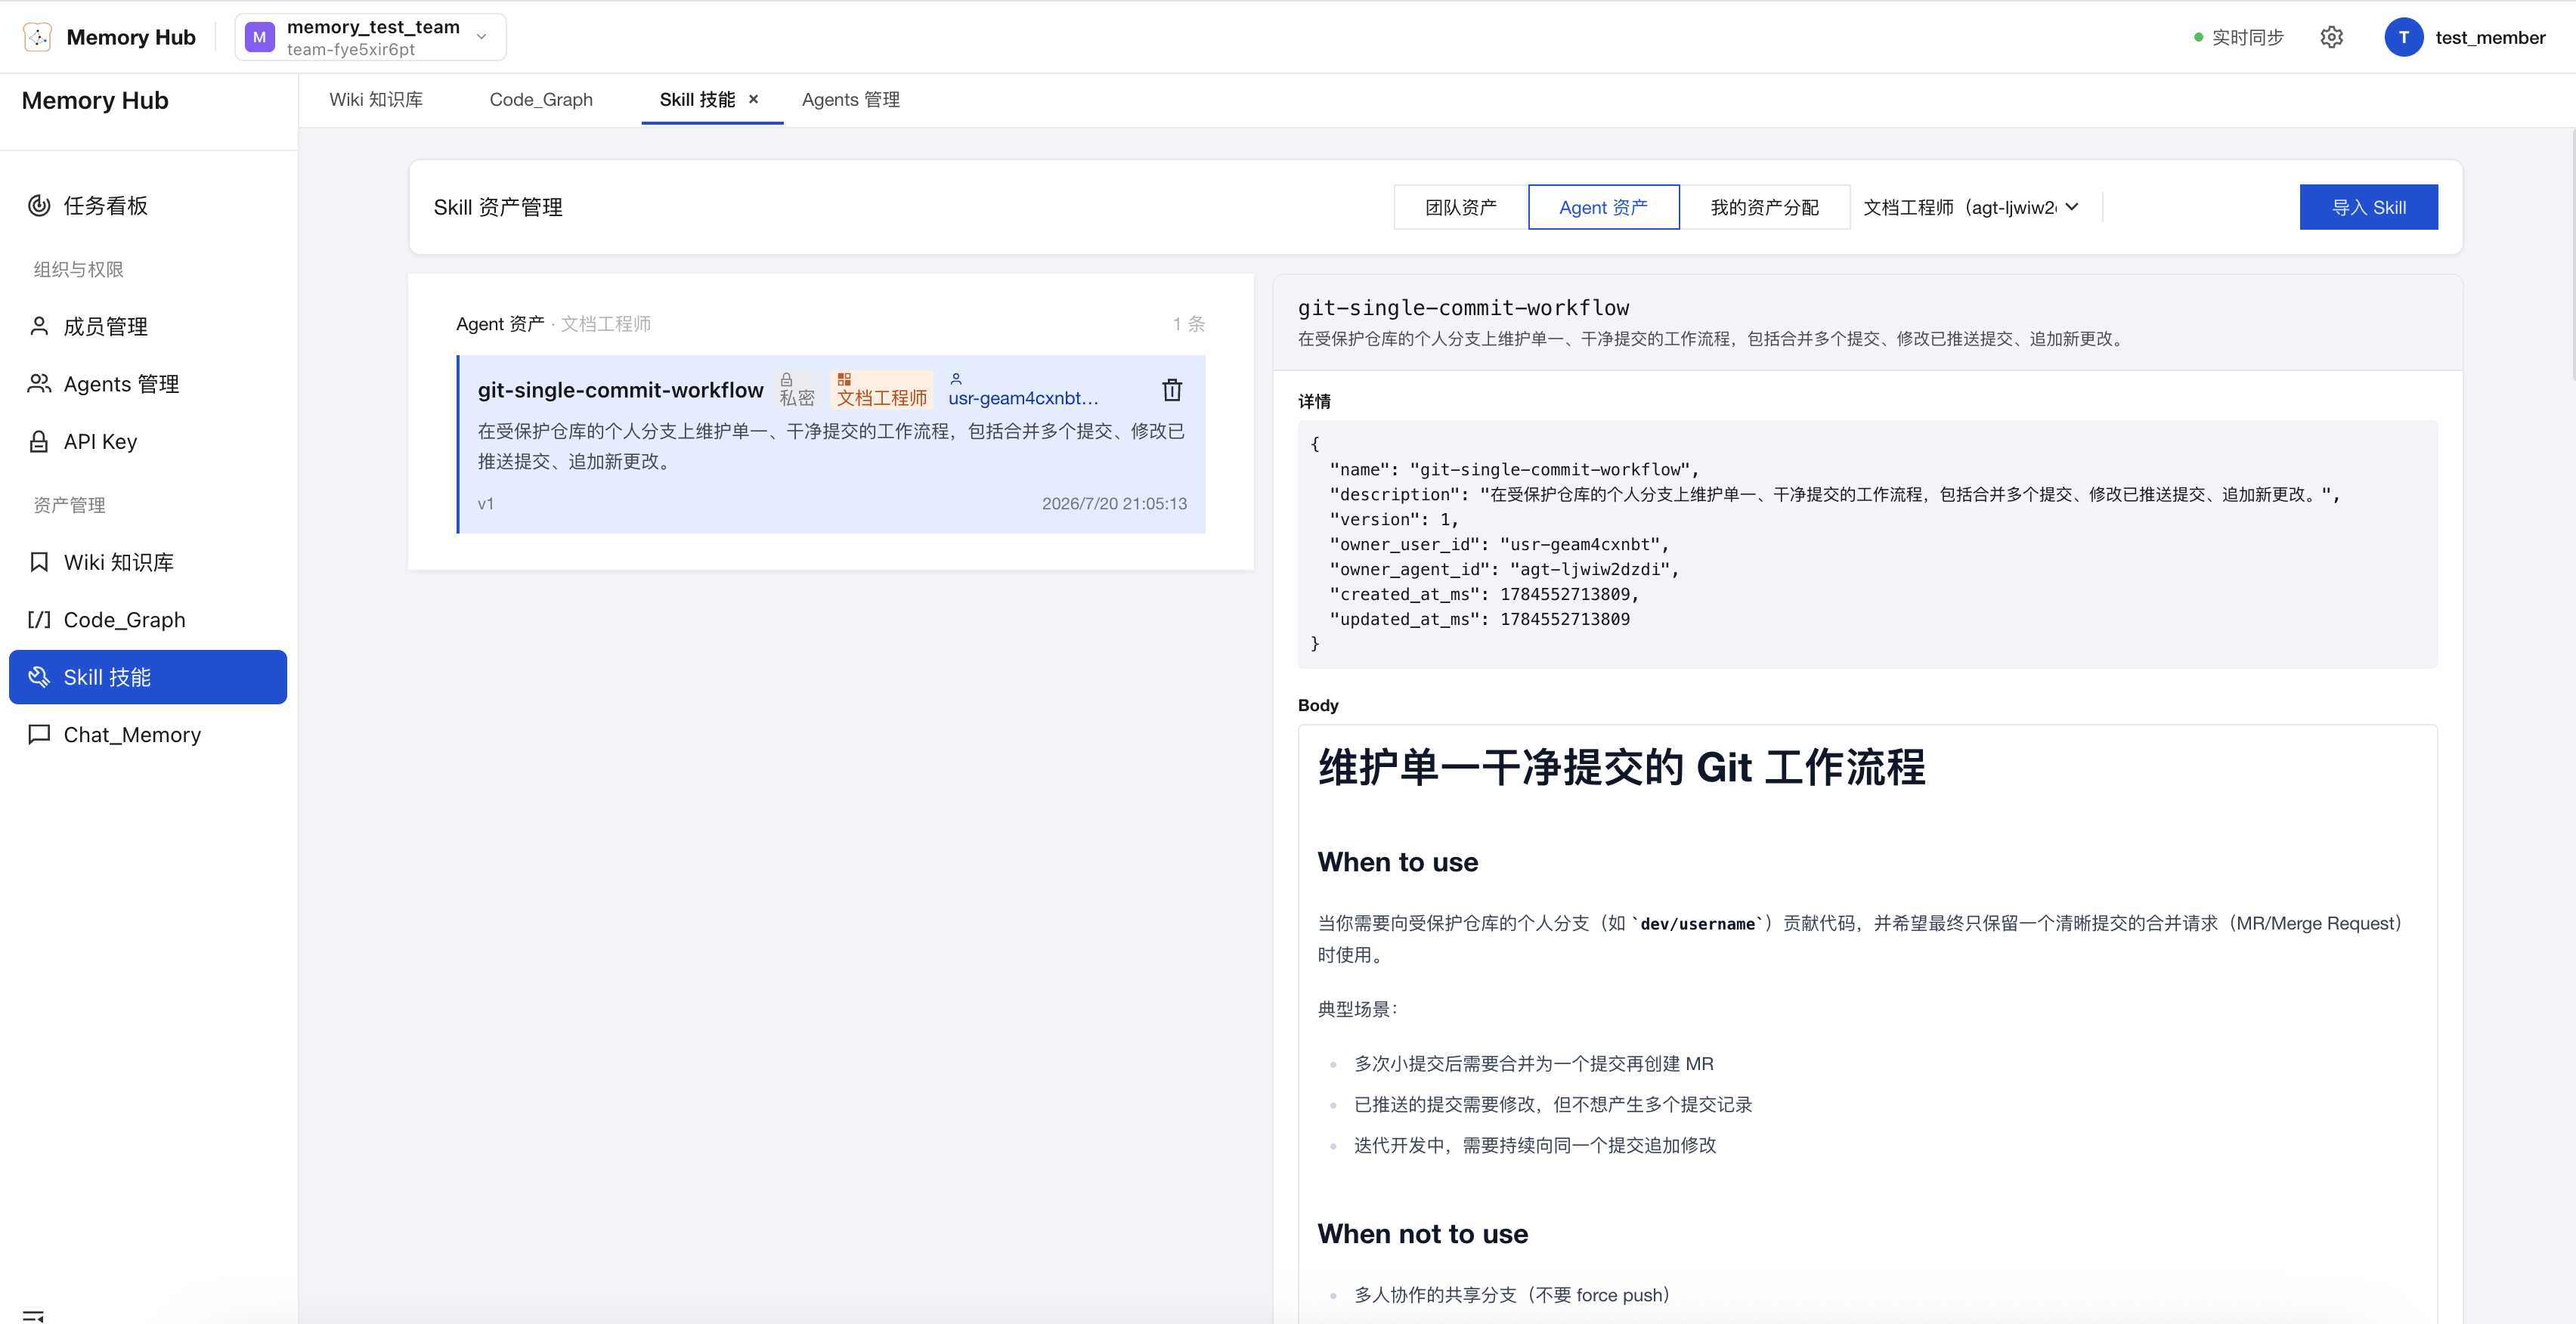 — 类型: screenshot
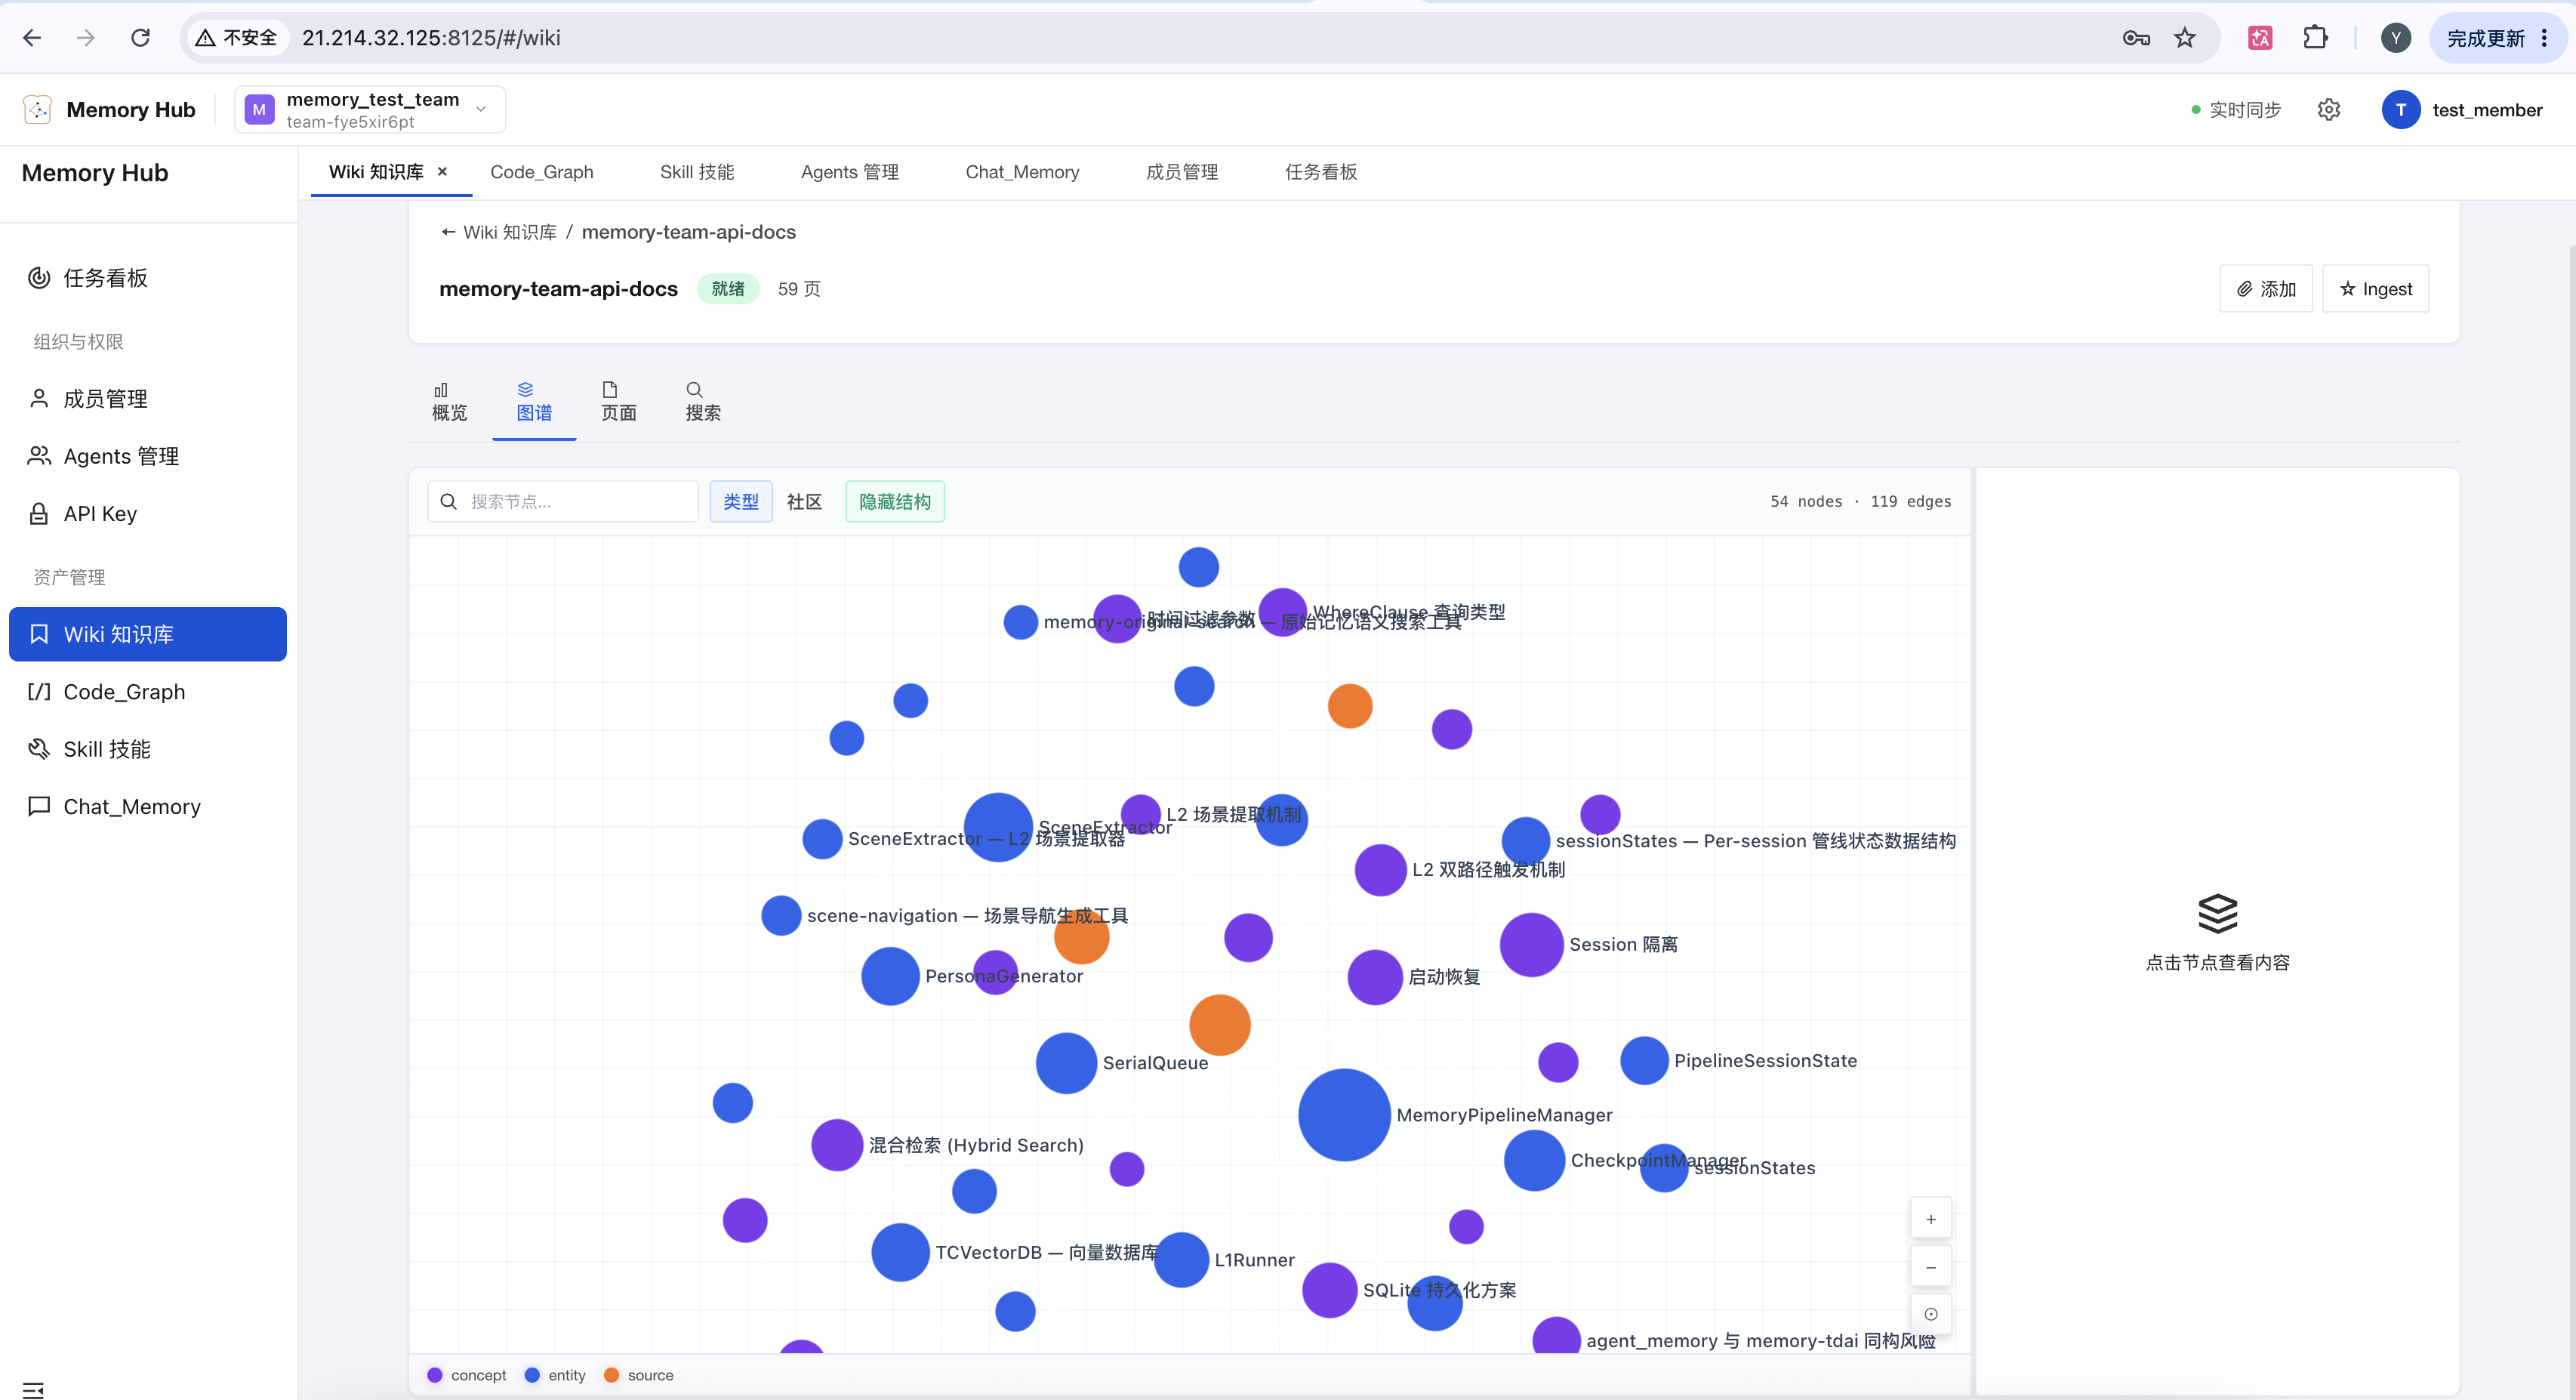 — 类型: screenshot
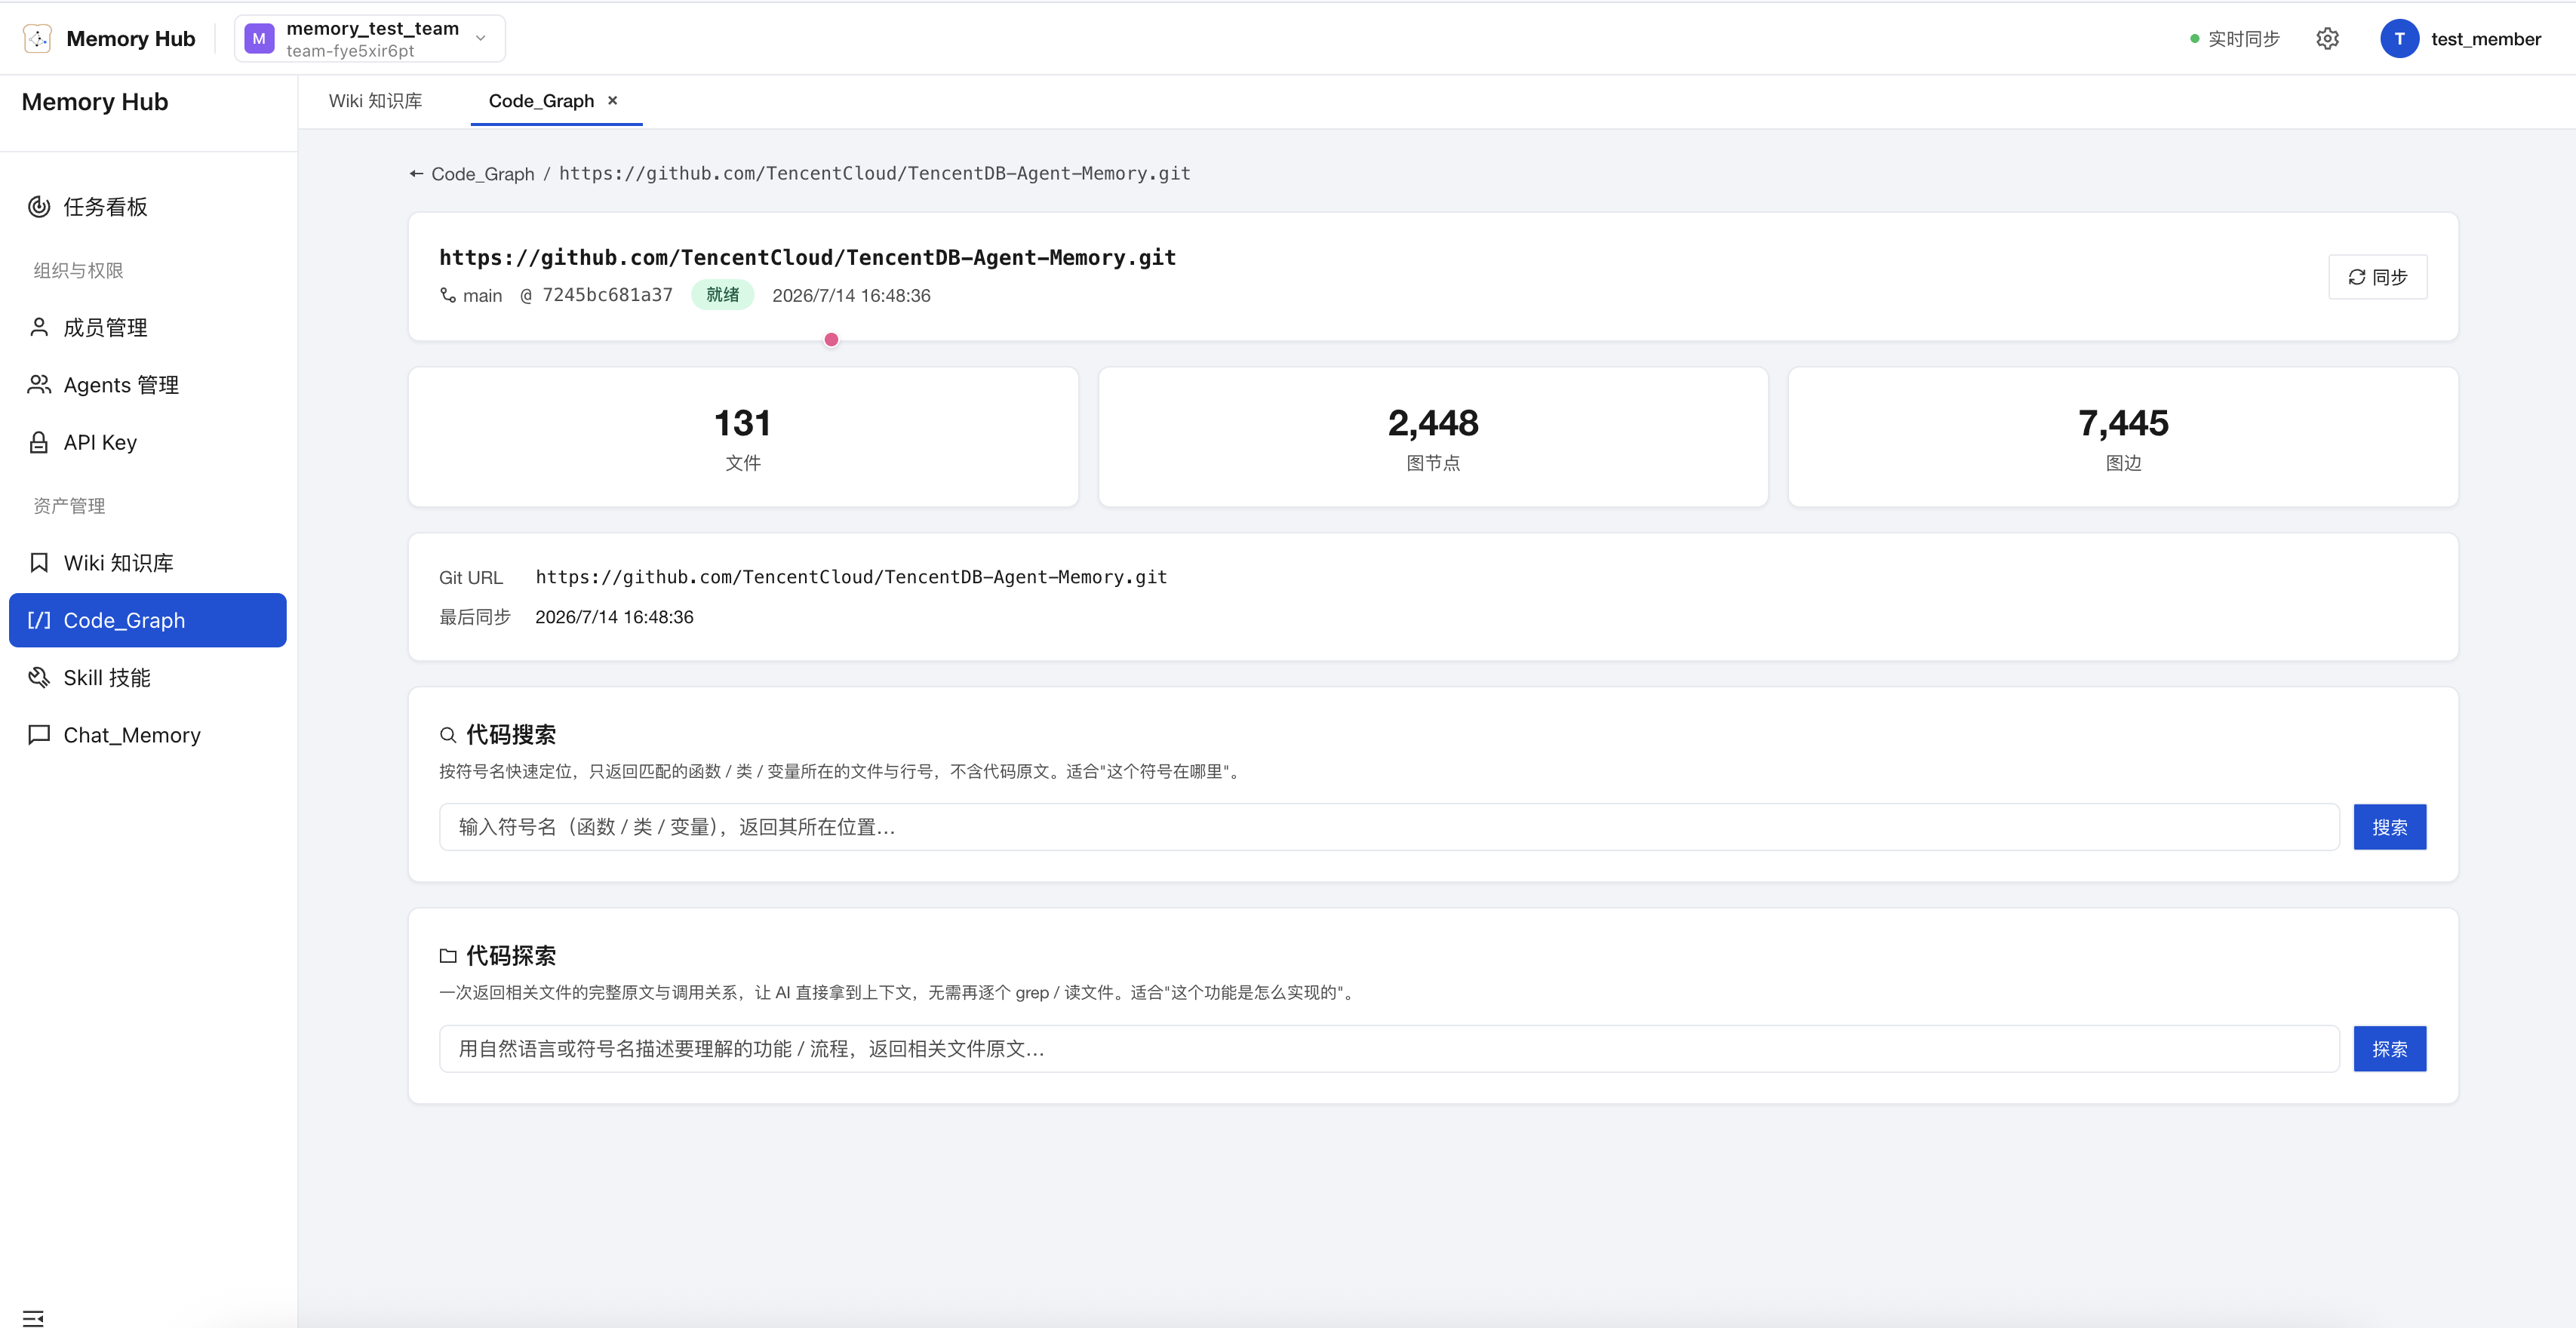 — 类型: screenshot
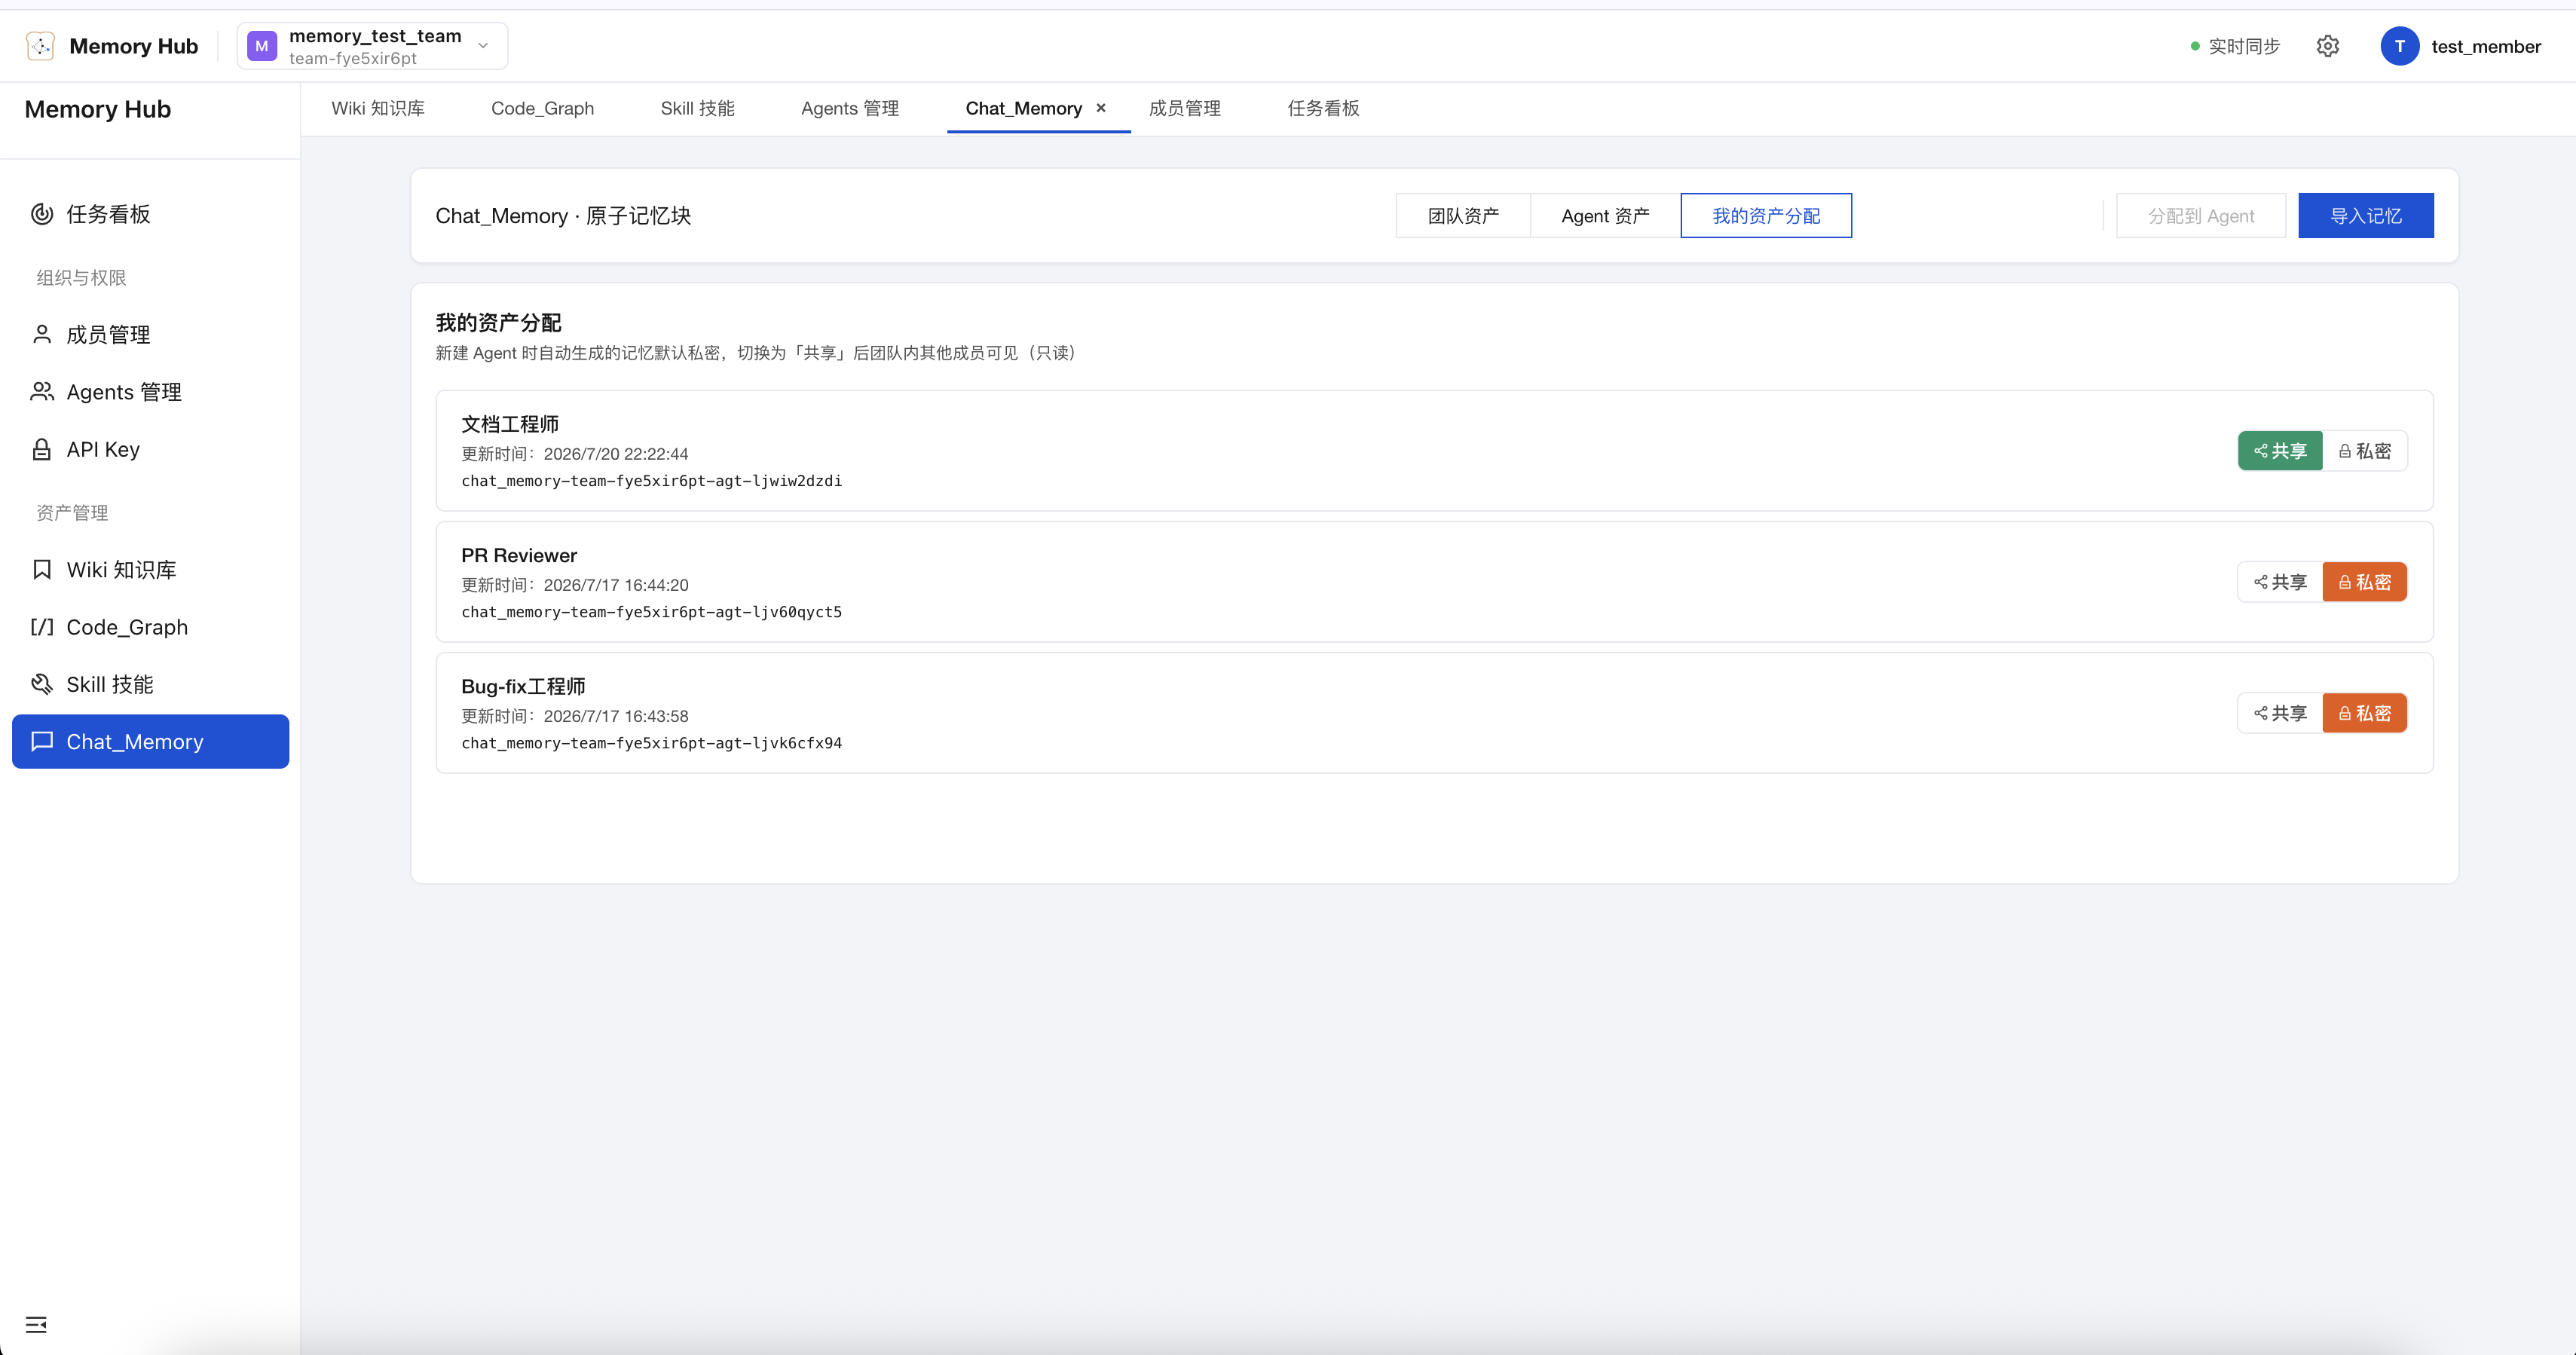 — 类型: screenshot
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/tencentcloud/tencentdb-agent-memory |
| Star / Fork | 10,255 / 987 |
| 代码行数 | 125,162( TypeScript 80% / TSX 7.9% / Python 4.2% / CSS 3.1% / Shell 1.8% / YAML 1.7% ) |
| 项目年龄 | 0.3 个月 git 公开史( 仓库 2026-04-07 创建,首次 commit 2026-07-22 );实际为公司级单次 dump,内部开发更早 |
| 开发阶段 | 内部已成熟 + 刚对外公开( 按 commit 数判定为「低维护」,但 60 open issues / 175 issue comments / 345 open PRs 反映真实活跃度 ) |
| 贡献模式 | 腾讯云数据库/AI 团队 + 腾讯犀牛鸟社区协作( issue 标签含「犀牛鸟-中/低难度」) |
| 热度定位 | 大众热门( 10K+ stars / 60+ issues / 345+ PRs,公开后热度持续 ) |
| 质量评级 | 代码 优秀 / 文档 优秀 / 测试 基本( vitest 配置完备但仓库 0 个测试文件,PR CI 不跑测试 ) |
作者视角:为什么存在这个项目
创始人/作者背景
腾讯云 Organization 官方账号( 10.1 年历史 / 200 公开仓库 / 1048 followers ),背后是腾讯云数据库/AI 团队。License 标注为「Other」( README 声明 MIT,GitHub API 误判,双许可或 repo metadata 未同步,非阻塞但需关注 )。从拓扑看,与自家 VectorDB( vgate )、tRPC-Agent-Go、Youtu-Agent 形成栈式布局——Memory 层是这一栈的「经验沉淀」中段,向上接 Agent runtime,向下接存储。
问题判断
Agent 跑过几轮后,经验会丢——你告诉它「这个项目里我倾向用 X」,下一轮它要么忘、要么把「这个项目里」泛化为「我永远用」。当多 Agent 协作( 侦察/构建/审阅多角色 )时,这个问题在团队维度被放大:对话日志、偏好、文档、代码知识散落各处,下一个 Agent 接不到前一个 Agent 的”档案”。
作者看到的关键机会窗: 2025-2026 是 LLM 应用从「单 Agent demo」向「多 Agent 协作 + 长记忆」跃迁的窗口。Karpathy 提的「LLM Wiki」思路让「把文档变可链接结构」变得可工程化;colbymchenry 的 codegraph 让「冷启动导入既有代码库」变得可工程化;Hermes Agent 的 SKILL.md 让「SOP 资产」有了先例。三件事恰好都在 2025-2026 成熟,腾讯云把它们组装到一套 L0→L3 蒸馏管线里。
解法哲学
- 「Memory is an asset, not a log」: 不把记忆当 RAG 上下文塞 prompt,而是把它当可发现、可调用的资产。
- 分层即降维: L0 原始对话 → L1 原子事实 → L2 场景 → L3 画像,每一层都是对上一层的语义抽象 + 时间衰减,存储代价递增、查询命中递增。明显借鉴人类记忆的「短/中/长期」模型。
- 「先验证、再写库」: L1 提取器对每条候选记忆都跑
priority分数 + 类型白名单 + dedup,宁缺毋滥。 - 「知识按需调用,而非全量注入」:
/v3/tools/list+/v3/tools/call让 Agent 先列工具再选调,避免在 system prompt 里塞 16 个工具描述破坏 KV cache。
战略意图
- 与自家 VectorDB( vgate ):
storeBackend=tcvdb时直连,向量/全文检索沉淀到产品链。 - 与自家 tRPC-Agent-Go / Youtu-Agent: 通过 OpenClaw plugin + Hermes plugin 把 Memory 当 framework-agnostic 的 runtime 配件。
- 商业化路径几乎确定:
agentmemory命名空间已在 DockerHub 准备好,未来是 Tencent Cloud 上的 Agent Memory 服务。「企业级 + 国内合规 + 多 Agent 协作」是 SaaS 化的天然叙事。 - 开源策略: 走 open-core 但核心 MemoryCore + MemoryKnowledge 全部 MIT,商业化空间在 cloud-hosted 版本与 enterprise SLA。
核心价值提炼
创新之处
- L0→L3 异步蒸馏管线(新颖度 4/5,实用性 5/5,可迁移性 4/5): L1 立即( 每 N 次对话触发 )、L2 延迟 X 秒( 默认 30s )、L3 每 triggerEveryN 次场景更新后触发——每个层级都有自己的 checkpoint cursor( 毫秒级时间戳 + 同毫秒兄弟行边界对齐 ) + scoped storage( profile 维度隔离 ) + dedup( 向量近邻 + BM25 + RRF 融合 )。mem0/letta/cognee 要么只有单层 LLM 提取,要么只在写入时做单一 transform,分层异步 + 增量可恢复的设计都不存在。
- 跨 profile scope 的隔离模型(新颖度 4/5,实用性 5/5,可迁移性 4/5):
buildProfileIsolationScope()把teamId/userId/agentId/sessionId编成一个 scope,每个 scope 有独立的scopedDataDir+scopedStorage+scopedProfileOptions。真正的多租户 + 多 agent 内存隔离,而非简单的where user_id=?SQL 过滤。 - Context offload with L1.5 + L3 hooks(新颖度 3/5,实用性 5/5,可迁移性 3/5):
offload/index.ts2310 行虽过度臃肿,但语义上是 Context engineering 的成熟实现——hooks/after-tool-call.ts异步调度 L1.5 摘要、hooks/before-prompt-build.ts做压缩决策、hooks/llm-input-l3.tscascade 压缩。对标 Anthropic 的 context engineering 思路。 - 工具调用渐进暴露(新颖度 4/5,实用性 5/5,可迁移性 5/5):
/v3/tools/list+/v3/tools/call模式——先列工具 → 再选调工具 → 命中调用。MCP 之外真正面向 LLM 工作流的「tool catalog」模式,对 KV cache 友好得多。 - 注入 hook 的 anchor + point 双层落点系统(新颖度 3/5,实用性 4/5,可迁移性 4/5): hook 既可声明
point粗粒度( 9 个固定注入位 ),也可声明anchor: { slot, relation }由 AgentProfile 解析 system prompt 的语义片段( 如<available_skills>槽 )做精确落点。落点失败自动 fallback,不静默丢弃。
可复用的模式与技巧
- Once-async store init + cached Promise per dataDir: 解决并发竞争,避免同一
dataDir多份 store。 - In-flight promise as mutex(
tdai-core.tsschedulerStartPromise+skillWiringPromise): 详细注释解释为何if (flag) return不够安全,教科书级别的并发安全模式。 - Millisecond-boundary alignment(
pipeline-factory.ts:481-500): L1 batch slice 在同一毫秒边界扩展,避免「agent_end 在同一Date.now()下写多条 L0 时的丢消息」。 - Background-task drain with timeout(
tdai-core.ts:295-345): destroy 时不丢 fire-and-forget 的 L0 嵌入写入。 - CleanContextRunner 沙箱化 LLM 写入: 限制 LLM 只能读
scene_blocks/目录下的.mdscene 文件,checkpoint/scene_index/persona.md 都不可见。文件级权限分离是真正的安全设计。 - StorageAdapter + 6 后端工厂: 抽象出 StorageAdapter,让同样代码可在 fs / sqlite / COS / proxy / memory / per-key-mutex 六种后端间切换。
- Optimistic locking on skill version(
SkillVersioning): 用version + contentMd5防御并发覆盖。 - Plugin isolation + Host adapter pattern:
TdaiCore只依赖HostAdapter接口,把 OpenClaw/Hermes 特定代码挡在 adapter 层,教科书级别的「宿主中性」架构。
关键设计决策
| 决策 | 问题 | 方案 | Trade-off | 可迁移性 |
|---|---|---|---|---|
| L0→L3 分层异步蒸馏 | LLM 提取成本高,实时写 L1/L2/L3 不经济 | 异步管线 + 边界对齐 + checkpoint cursor | 实时性降级,需自愈恢复 | 高 |
| 按需工具调用替代全量注入 | system prompt 灌 16 个工具破坏 KV cache | /v3/tools/list + /v3/tools/call 渐进暴露 | Agent 需多一轮 tool call | 高 |
| Profile scope 隔离 | 多租户 + 多 agent 内存不可混 | buildProfileIsolationScope() 串起 team/user/agent/session | 存储路径设计复杂 | 中 |
| 沙箱化 LLM 写入 | LLM 写文件时可能改 checkpoint | CleanContextRunner 限制在 scene_blocks/ | LLM 灵活性受限 | 高 |
| Plugin 双形态( in-proc + 远端 ) | 既要本地化也要 SaaS 化 | OpenClaw 同时支持内嵌 + 远端 plugin | 维护成本 ×2 | 中 |
| Skill review agent + tool-calling loop | 被动 LLM 提取质量低 | StandaloneLLMRunner.enableTools: true 走 tool-call 循环 | token 消耗高 | 高 |
竞品格局与定位
竞品对比矩阵
| 维度 | mem0 (45K+) | letta (15K+) | cognee (8K+) | zep (4K+) | TencentDB Agent Memory |
|---|---|---|---|---|---|
| 核心抽象 | Memory + MemoryRecord | Stateful agent + archival memory | Knowledge graph + datasets | Memory + Fact | 4 类资产( Chat/Skill/Wiki/CodeGraph ) |
| 团队治理 | 无( 个人级 SDK ) | 无( agent 级 ) | 无( dataset 级 ) | 简( user_id ) | team + agent + ACL + visibility + binding |
| 冷启动导入 | 仅手动 | 无 | 仅手动 | 仅手动 | 代码库 + 文档 + 对话历史 3 类导入 |
| 检索 | 向量 + 关键词双路 | 全量 conversation | 知识图谱遍历 | 事实摘要 | L0/L1/L2/L3 分层 + BM25+向量 RRF + 多跳图扩展 |
| Agent 框架集成 | LangChain / LlamaIndex | 自家平台 | 通用 SDK | LangChain | OpenClaw / Hermes / SDK / Proxy( Claude Code 等 )4 路 |
| 按需工具调用 | 无( 全量注入 prompt ) | 无 | 无 | 无 | /v3/tools/list + /v3/tools/call |
| Skill / SOP 资产 | 无 | 无 | 无 | 无 | Skill v2( 版本化 + 资源 + 触发边界 + 验证规则 ) |
| CodeGraph / 影响分析 | 无 | 无 | 无 | 无 | 集成 @colbymchenry/codegraph( 符号 + 调用 + 影响 ) |
| Wiki / 文档结构化 | 无 | 无 | 无 | 无 | 受 Karpathy LLM Wiki 启发的链接图谱 + BM25 |
| License | Apache 2.0 | Apache 2.0 | Apache 2.0 | Apache 2.0 | MIT( gh API 误判为 Other ) |
差异化护城河
「团队级资产治理 + 四类结构化资产 + 跨框架可移植 + 按需工具调用」四点同时成立——这是 mem0/letta/cognee/zep 都没碰的领域。Skill 资产独立、CodeGraph 集成、WIKI 链接图谱——三点都是其他竞品的盲区。腾讯云 + 国内合规 + 企业级部署 三个非技术因素进一步加固护城河。
竞争风险
- Mem0 在「开发心智」上仍是事实标准: Mem0 的「5 分钟 SDK 集成」心智极重,如果未来 Mem0 也补齐 team/agent/ACL 层,差异化会被快速磨平。
- Cursor/Claude Code/Windsurf 等主流 IDE 适配缺失( issue #235 ): 决定是否能进入主流 IDE Agent 生态的卡口,需尽快推进。
- 复杂度高: 5 commits + 12.5 万行 + 4 大模块 + 双 plugin 形态,对外部贡献者的理解门槛陡。60 open issues + 345 open PRs 说明开发者之外的「我要怎么用」心智模型还没建立。
生态定位
面向 enterprise 团队的多 Agent 协作平台,而非面向个人开发者的轻量 SDK。竞争对手更接近 Atlassian Confluence + Notion + Zep Cloud 的组合,而非单纯的 mem0/letta/cognee。腾讯云在「国内企业级 Agent 记忆」的卡位清晰,未来与阿里 Agentic Memory / LangChain LangMem 在同一张牌桌上。
套利机会分析
- 信息差: 已被腾讯官方背书 + 媒体报道( CSDN/搜狐/腾讯云官方稿都给了 61% Token 节省、51% 任务通过率提升的基准 ),信息已被充分挖掘。价值在于「国内/腾讯生态首套结构化 Agent 记忆」卡位,而非「低关注度被低估」。
- 技术借鉴: L0→L3 异步蒸馏管线、profile scope 隔离、CleanContextRunner 沙箱化、StorageAdapter 6 后端抽象、in-flight promise as mutex、millisecond-boundary alignment——这套工程实践可直接迁移到任何「长记忆 + 多 agent」类项目。
- 生态位: 填补了「团队级 + 多资产 + 治理 + 跨框架」这条差异化路线在开源生态中的空白,与 mem0( 个人 SDK )/letta( 学术平台 )/cognee( 知识图谱 )/zep( 商业 SaaS )错位。
- 趋势判断: 2026 年是 LLM 应用从「单 Agent demo」向「多 Agent 协作 + 长记忆」跃迁的窗口,TencentDB 站位正确。问题是 Mem0 / Letta 也在补齐团队治理,需用「企业级 + 国内合规 + Tencent 生态」三张牌守住。
风险与不足
- 测试覆盖 = 0: 尽管 vitest 配置完备( MemoryCore/MemoryProxy/MemoryPanel/sdk 全部就位 ),但仓库 0 个
*.test.ts,PR CI 也不跑测试(.github/workflows/pr-ci.yml只跑 install / pack / manifest / size guard / skill isolation guard )。对工业级产品来说,公开后「测试重写」是从内部成熟到社区成熟的最大鸿沟。 - offload/index.ts 单文件 2310 行: 单一入口管整个 context offload,
hooks/、pipelines/、local-llm/子模块都已在,但主入口仍做大量编排、调度、状态机逻辑。建议按controller / scheduler / executor拆。 - Plugin 双形态( OpenClaw in-proc vs 远端 ): 走的是不同的 SDK 调用路径,长期维护成本 ×2。
- v2/v3 router 并存: 缺少 deprecation 时间表,渐进式重构的副产物需要收敛。
- 已知安全风险( issue #160 ): FTS5 查询未做操作符转义,用户输入可直接改查询语义,175 评论说明社区已把「安全」作为采纳门槛。
- 已知体验痛点( issue #120 ): prependContext 破坏 OpenAI-compatible provider 的前缀缓存命中率,proxy 注入相关性的代价。
- 已知 L1 提取痛点( issue #48 ): 缺少场景限定机制,「这个项目里我倾向 X」被泛化为「我永远用 X」。
行动建议
如果你要用它
- 先验证宿主: 自家有没有 OpenClaw 或 Hermes 运行时? 没有就只能走 SDK + MemoryPanel web UI,或用 MemoryProxy 反向代理 Claude Code / CodeBuddy。
- 再确认 LLM 配额: 双 LLM( memory 组 + proxy 组 )的 token 消耗,需提前规划。
- 最后用
deploy/global-images/start-all.sh三件套 10 分钟拉起: 冷启动导入既有代码库走 CodeGraph + Wiki 工坊即可,这是相对于 mem0/letta/cognee 不可替代的能力。 - 对比 mem0/letta/cognee 选它的场景: 团队多 Agent 协作 + 需要 Skill 资产治理 + 需要冷启动导入既有代码库 + 国内合规;否则 mem0 仍是更轻的心智。
如果你要学它
| 想学什么 | 看哪里 |
|---|---|
| L0–L3 分层蒸馏 | MemoryCore/src/pipeline-factory.ts( 1200 行全注释 )+ pipeline-manager.ts |
| Host adapter pattern | MemoryCore/src/core/tdai-core.ts + adapters/openclaw/host-adapter.ts |
| Agent framework 注入 | MemoryProxy/src/injection/pipeline.ts + injectors/tdai-tools-injector.ts |
| 团队级资产治理 | MemoryCore/src/metadata/service/permission-checker.ts + metadata/store/sqlite-adapter.ts |
| 按需工具调用 | MemoryKnowledge/src/routes/tools.ts |
| Wiki 摄取 | MemoryKnowledge/src/engines/wiki/ingest-v2/ 13 个文件 |
| 异步管线 + 边界对齐 | MemoryCore/src/pipeline-factory.ts:481-500( 毫秒级边界对齐 )+ tdai-core.ts:295-345( 后台任务 drain ) |
如果你要 fork 它
- 降低外部贡献者门槛: 补单元测试( vitest 配置已就位,只差
*.test.ts)+ 写 deprecation 时间表收敛 v2/v3 router。 - 拆分 offload/index.ts( 2310 行 ): 按
state / hooks / pipeline / reclaimer拆,降低维护成本。 - 推进 IDE 适配( issue #235 ): Cursor / Claude Code / Windsurf plugin 是打开主流 IDE Agent 生态的卡口。
- 修复 FTS5 注入( issue #160 ): 加 escape 路径或换用预编译查询模板。
- 统一 plugin 形态: OpenClaw 远端 + 本地缓存统一,长期收敛「in-proc + 远端」双形态。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 未收录 |
| Zread.ai | 未收录 |
| 关联论文 | 无( 项目本身无对应 arXiv;学术对位看 Letta/MemGPT 论文 ) |
| 在线 Demo | 无官方 Playground;本地 ./start-all.sh + Panel UI http://localhost:8125 是一键试玩 |
| 外部深度分析 | CSDN: 腾讯云开源 TencentDB Agent Memory — 61.38% Token 节省、51.52% 任务通过率提升 — 独立观点: 置于「国内云厂 Agent 基建卡位战」叙事,腾讯版 vs 阿里 Agentic Memory / LangChain LangMem 同台对标 |
| 外部深度分析 | CSDN: 腾讯云 TencentDB Agent Memory — AI Agent 本地长记忆管理方案解析 — 独立观点: 提出「Context Offloading + Mermaid Task Canvas」视角,把完整上下文卸载到外存,agent 上下文仅保留带 node_id 的轻量 Mermaid 任务图 |
中间产物
本报告的三阶段分析中间产物( Phase 1 网络分析、Phase 2 元分析、Phase 3 内容分析 )存放于:
tmp/tencentdb-agent-memory-phase-1-analysis.md— Phase 1 网络分析tmp/tencentdb-agent-memory-phase-2-analysis.md— Phase 2 元分析tmp/tencentdb-agent-memory-phase-3-analysis.md— Phase 3 内容分析tmp/repo-facts-tencentdb-agent-memory.json— 确定性采集 JSON( gh api + git + tokei 一次性输出 )