GitHub推荐:AutoGPT:3 年 8800 commits,AI Agent 鼻祖如何从一条推文变成 SaaS 平台
一句话总结
AutoGPT 是 2023 年 ChatGPT API 公布当周诞生的 AI Agent 鼻祖,3 年 8,880 commits 从「自治循环 demo」演化到「可编排、可中断、可计费的 agent 平台」,同时在「Block Graph + 分层错误模型 + OpenAPI 协议即护城河」三件套上沉淀出值得每个 agent 框架学习的工程化范式。
值得关注的理由
- AI Agent 范式起点:2023-03 创始人 Toran Bruce Richards 一条 90 秒演示视频引爆 AI 圈,仓库首月 1,731 commits,是 LangChain/CrewAI/smolagents 几乎所有 Agent 框架的共同灵感来源
- 产品化转型的完整样本:从
classic/单体 CLI(2023)→autogpt_platform/平台化重写(2024 v0.4 → v0.6 跳号)→ AutoGPT Platform SaaS(2025-2026),3 年走完「开源 demo → 商业产品」的全链路 - 工程化深度被低估:Block Graph(Pydantic → JSON Schema → React Flow 三段反射)、BlockError 分层错误模型、OpenAPI diff-as-CI check、SDK 子进程 + 自有 WebSocket 协议四件套,单拿出来都是各自领域的工程最佳实践
项目展示
 — hero 图,展示产品品牌
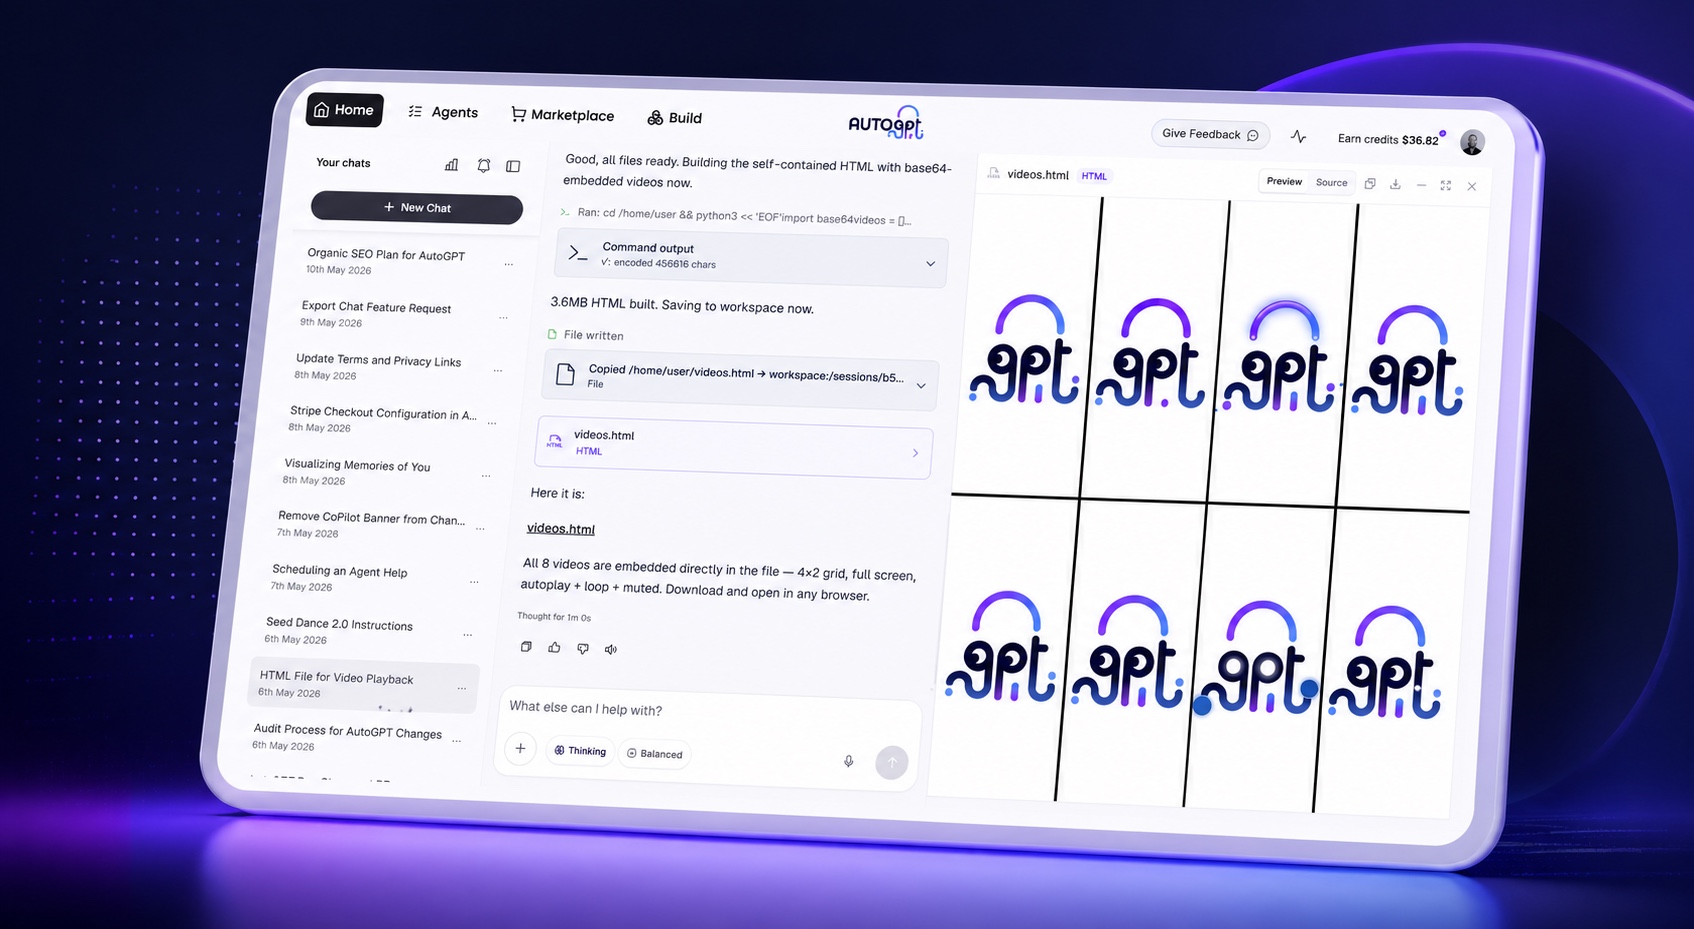 — 产品核心入口,自然语言造 agent
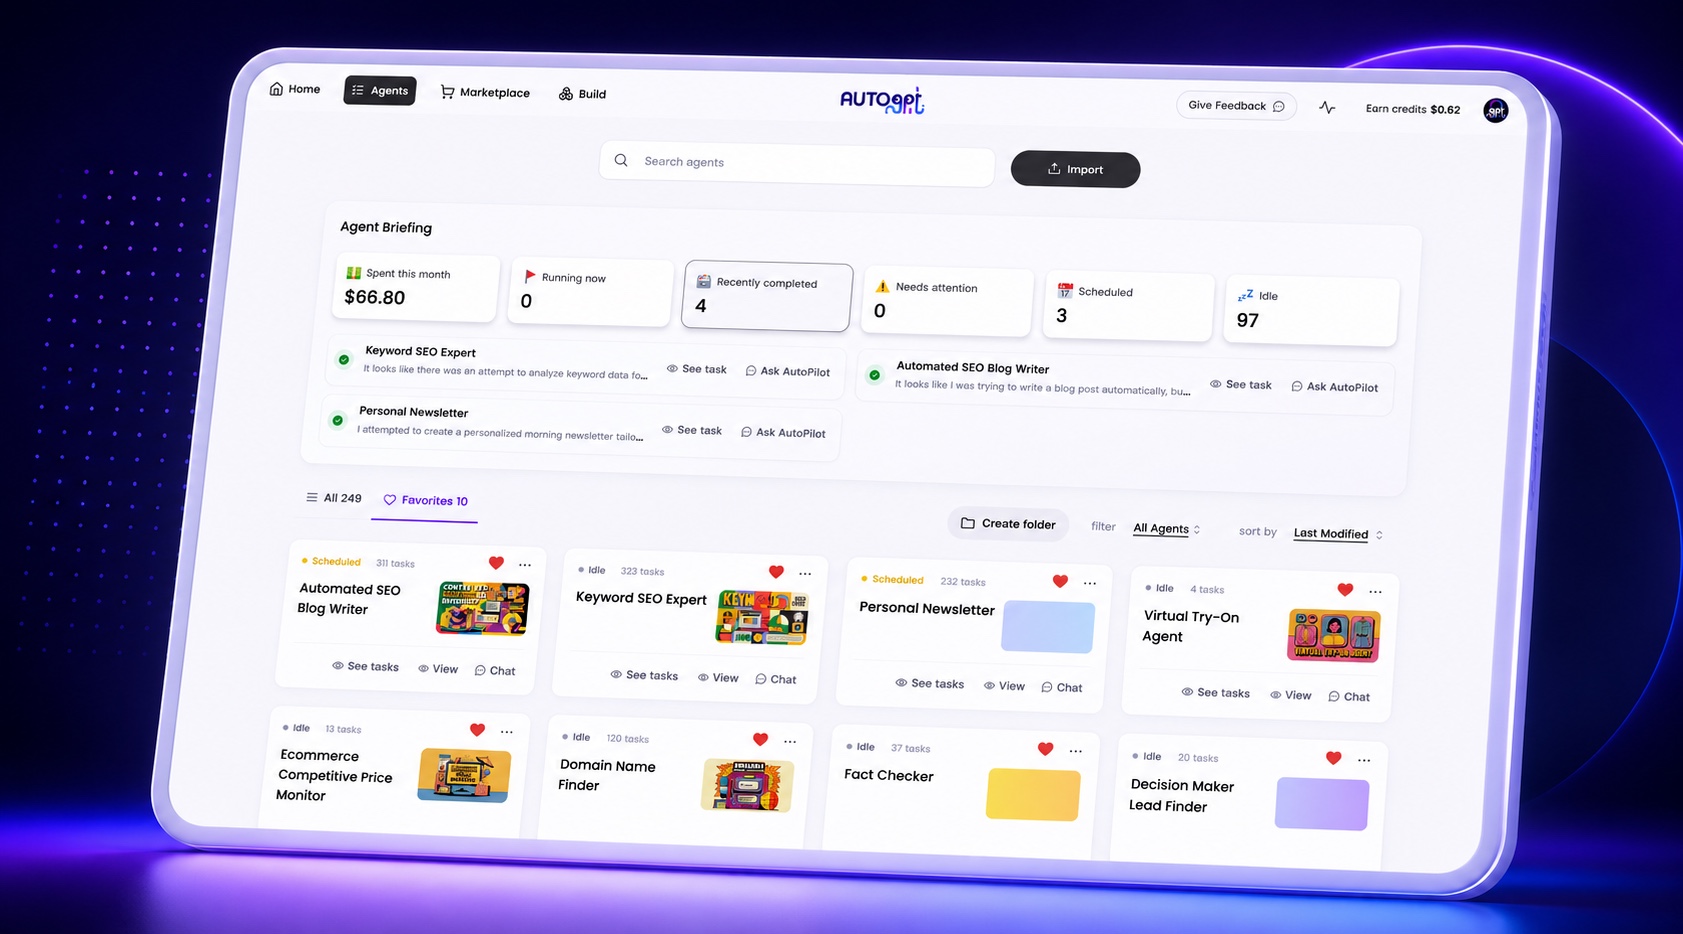 — 运营仪表盘,运行时可观测、可中断
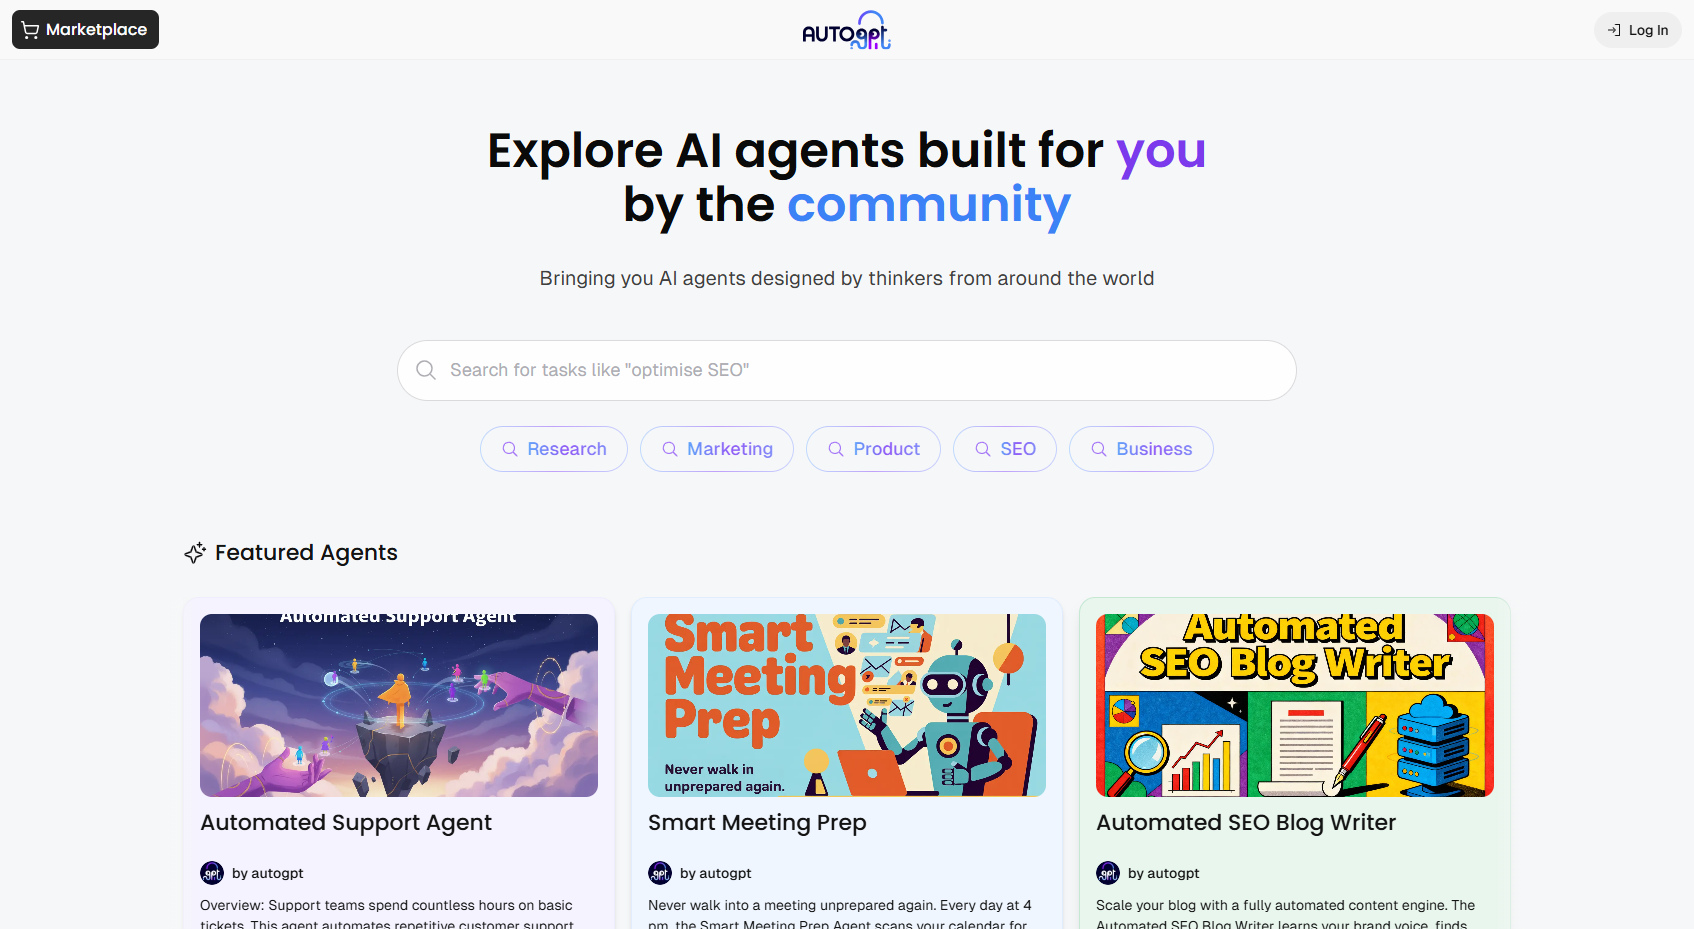 — 生态/分发,社区 agent 模板市场
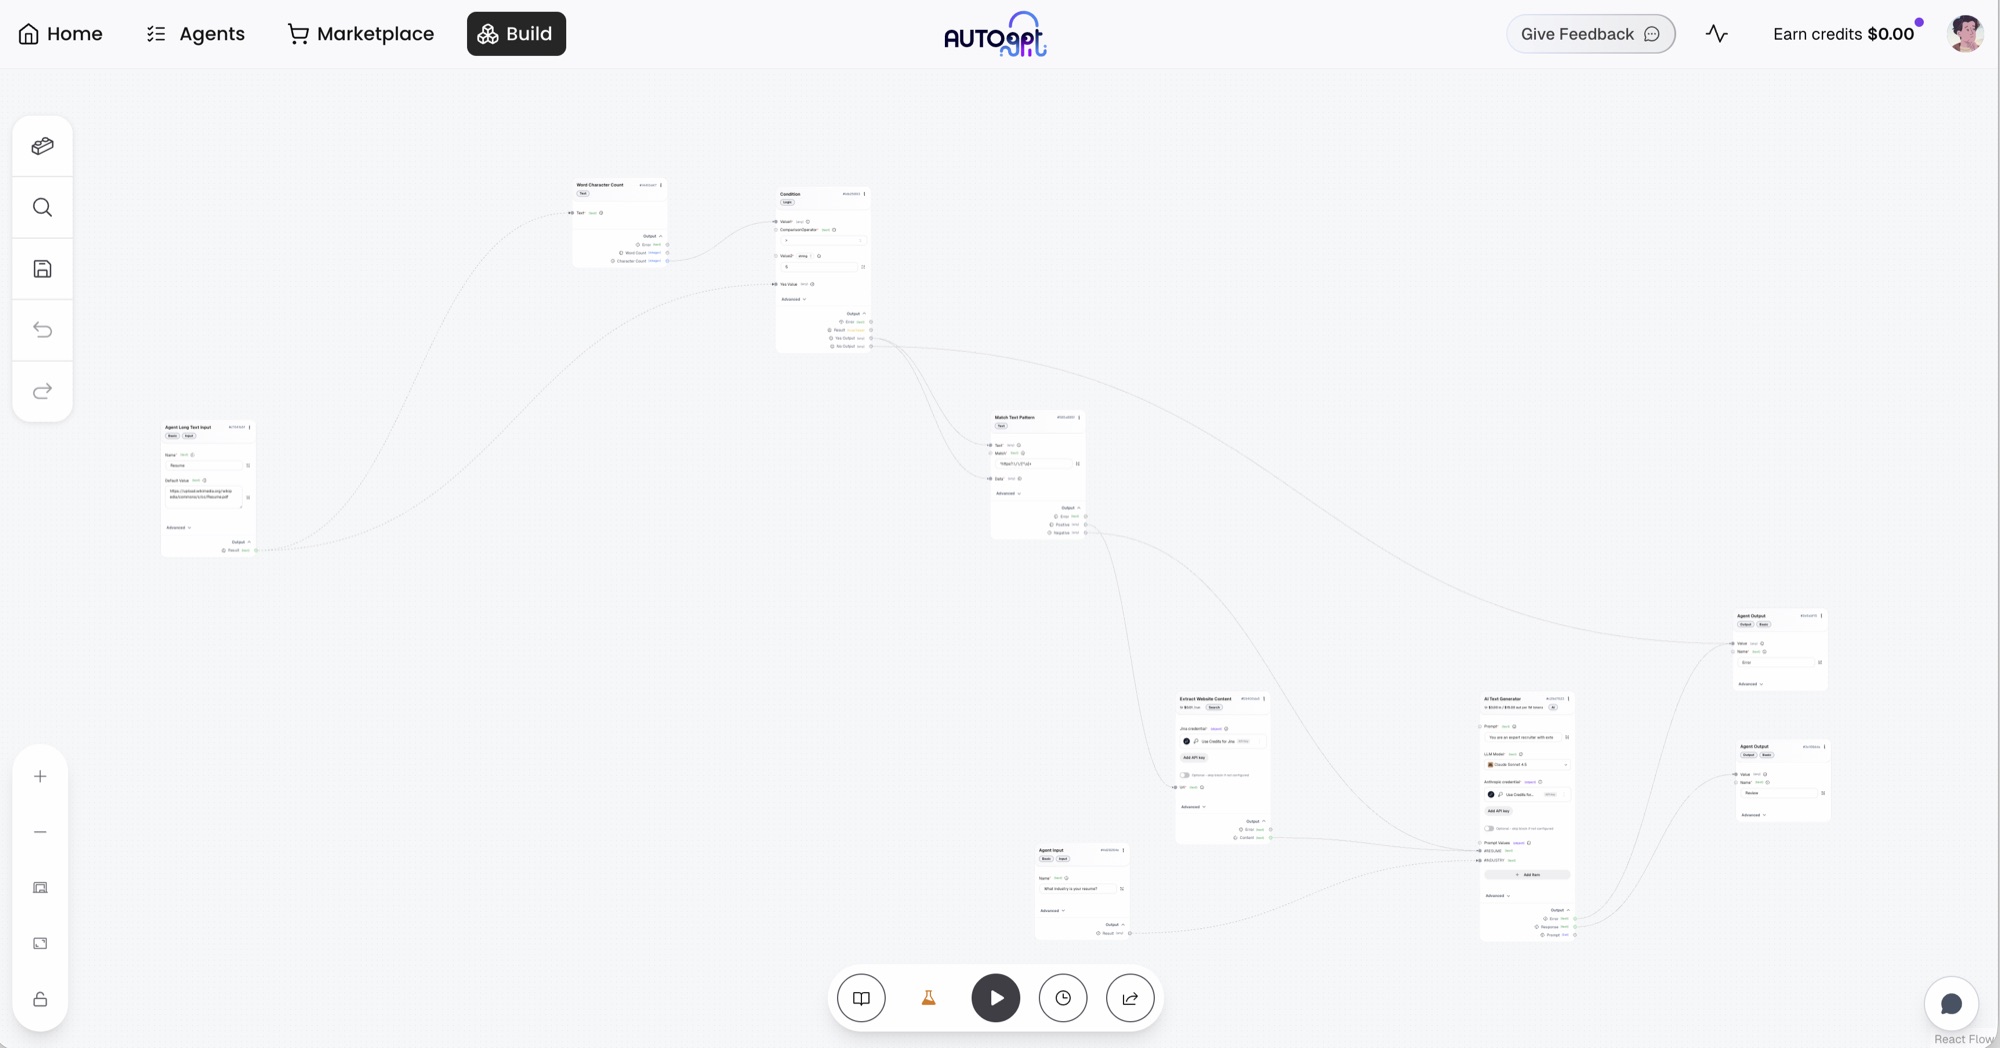 — 架构可视化,Block Graph 编辑器
在线 Demo:agpt.co — AutoPilot chat 即时试用,无需部署
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/significant-gravitas/autogpt |
| Star / Fork | 186,441 / 46,066 |
| Watcher | 1,550 |
| Open Issue / PR | 300 / 201 |
| 代码行数 | 775,014 行(4404 文件) |
| 语言分布 | Python 56.3% / TSX 20.9% / TypeScript 10.4% / JSON 8.6% / YAML 2.3% |
| 项目年龄 | 40.8 个月(2023-03-16 首次提交) |
| 开发阶段 | 密集开发(近 90 天 321 commit,近 365 天 1,805 commit) |
| 贡献模式 | 核心 4 人 + 长尾社区(875 名独立贡献者;剔除 6 类 bot 后真人核心 ≤5 人,Top 真实贡献者 Zamil Majdy 2,252 / Nicholas Tindle 1,494 / Reinier van der Leer 1,080 / SwiftyOS 1,019) |
| 热度定位 | 大众热门(AI Agent 鼻祖级锁定位置) |
| 质量评级 | 代码 一般 / 文档 较差 / 测试 基本 / CI 完善 |
| License | PolyForm Free Trial(禁止商业化转售,非 OSI 认证开源) |
作者视角:为什么存在这个项目
创始人/作者背景
创始人 Toran Bruce Richards,2023-03 凭一条 90 秒 Twitter 演示视频(AutoGPT 自己写代码、自己跑、自己迭代 prompt)引爆 AI 圈,仓库首月就冲上 GitHub Trending 第一,3 个月后(2023-04)注册实体公司「Significant Gravitas」(英国)做产品化。组织从个人项目转型为有托管平台 + 商业订阅(agpt.co)的商业实体,目前 28 个公开仓库 80% 是 Python/TS 工具与平台代码,明显的 AI Agent 产品工程团队配置。
问题判断
2023 年初作者看到的核心问题是:AI Agent 框架当时都是「同步 LLM 调用 + 图编排」的实验室玩具,能 demo 不能 production。具体三个未被解决的问题:
- 无统一 agent 定义规范——LangChain、LlamaIndex、CrewAI 各搞一套 graph schema,互不兼容,agent 不能跨工具复用
- 长任务一旦启动就是黑盒——失败需要从头跑、不可观测、不可中断;30 分钟到 8 小时的 agent 任务在当时没有任何工程化运行时
- 缺协议层——业务想接入只能改业务代码,无法「不改业务」把同一个 agent 跑在 CLI、UI、平台三种环境
时机选择:2023 Q4 正好赶上 LLM function calling 稳定 + Anthropic / OpenAI 都开放 streaming 与 tool use,「工具调用」从 hack 变成 API 原语,让「统一 block schema + 可中断长任务」有了实现基础。早 6 个月做不出来,晚 6 个月就晚了。
解法哲学
- 显式优于隐式:所有 agent 用
Block(Pydantic schema + JSON Schema 反射)描述,UI/RPC/SDK/SDK-Server 共享一份 schema。拒绝 LangChain 那种「dynamic prompt + duck-typed tool」的隐式哲学 - 协议优于框架:把
AutoGPT SDK设计成独立子进程 + 自有流式协议(WebSocket + JSON),CLI/UI/Platform 共享同一个 SDK 客户端。拒绝「框架就是你的一切」的中心化设计 - 工程化优于学术化:完整 CI 矩阵(32 个 workflow)、contract diff check、token 后置计费、cancellation first——每一处都是「凌晨 3 点能不能救火」导向
- 明确选择不做的事:不做 OpenAI-only(multi-provider 改造是项目第二大架构动作)、不绑单一 vector DB、不内置 RAG(留给 SuperMemory 等专用工具)、不强行统一 agent 范式(classic 和 platform 两套执行路径共存)
战略意图
- 核心产品 vs 基础设施双层定位:对 AutoGPT Platform 团队是「核心产品」(平台自己就是最大客户),对外部开发者是「基础设施」(agent 运行时 + SDK)
- 商业化路径明确:AutoGPT Platform 是 SaaS,open-core 模式(核心 runtime/blocks/scheduler 开源,平台 UI/编排器/计费闭源),License 收紧为 PolyForm Free Trial 防止白嫖转售
- 生态打法:通过
autogpt-platform-backend(Pydantic + FastAPI)拉外部开发者,再用 SDK 协议让第三方 client(CLI、UI、IDE 插件)接入——「协议层即护城河」
核心价值提炼
创新之处
按新颖度 × 实用性排序:
- Block Graph 统一模型(新颖度 3/5,实用性 5/5,可迁移性 5/5):每个 Block 声明 Pydantic IO schema,自动反射生成 JSON Schema(用于协议),再反射生成 React Flow node spec(用于 UI 编辑器)。一份 schema 同时驱动「运行时校验 + 协议定义 + 可视化编辑」,这是任何 low-code 平台都梦寐以求的设计
- 期望 vs 非期望错误的分层模型(BlockError + 自动重试策略表)(新颖度 3/5,实用性 5/5,可迁移性 5/5):把 Block 抛出的错误显式分成「期望错误」(输入不合规、依赖暂时不可用、可重试)和「非期望错误」(代码 bug、不该重试),每类对应不同 retry / alert / 计费策略
- 后置 token 计费表(新颖度 4/5,实用性 4/5,可迁移性 3/5):每个 Block 预检配额 + 执行后查 cost 表记账,让 agent 平台能精确计量每个 block 的 token 消耗并 fail-fast 配额耗尽
- SDK 子进程 + 自有 WebSocket 协议(新颖度 3/5,实用性 4/5,可迁移性 4/5):把 SDK 拆成独立子进程 + 自定义流式协议,让同一份业务代码「不改业务」跑在 CLI / UI / Platform
- codegen-from-OpenAPI + diff-as-CI-check(新颖度 2/5,实用性 5/5,可迁移性 5/5):SDK 协议变更走 OpenAPI 单一事实源,CI 把「OpenAPI diff vs 上版」作为 blocking check,防止 client SDK 静默失配
- Pydantic discriminated union 表示 prompt 策略集合(新颖度 3/5,实用性 4/5,可迁移性 4/5):用
Union[ZeroShot, FewShot, ChainOfThought, ReAct]+ discriminator 字段在序列化层做多态,替代运行时 if/else 调度
可复用的模式与技巧
- Schema-driven UI 三段反射(Pydantic → JSON Schema → UI node spec):适用任何 low-code / workflow 编辑器 / API playground
- Typed error taxonomy + retry strategy table(显式错误分类 + 策略表替代 try/except + flag):适用任何需要 fail-fast + 智能重试的 worker / API
- Subprocess SDK + 自有协议(把 SDK 拆子进程 + 自定协议,业务逻辑零修改跨端运行):适用 IDE 插件、独立 CLI、宿主嵌入
- Preflight + post-execution metering(入口校验 + 出口计量 fail-fast + 精确计费):适用 LLM 应用、SaaS 配额管理、API 网关
- OpenAPI as contract + diff-as-CI(OpenAPI 单源 + CI diff check 防止协议静默破坏):适用任何跨语言 SDK、公开 API、移动端后端
关键设计决策
决策 1:Block Graph 统一模型——所有 agent / workflow 用一张 Block 节点 + 边组成的有向图描述
- 问题:不同框架 graph schema 互不兼容,agent 不能跨工具复用
- 方案:Pydantic IO schema(每个 Block 的 input/output 是 typed schema)→ 通过反射生成 JSON Schema → 再反射到 React Flow UI 节点
- Trade-off:引入三层反射开销(schema 校验 + 反射 + 渲染),换来「一份 schema 跨所有界面/协议」;Block 必须显式声明 IO,失去「dynamic tool」灵活性
- 可迁移性:高——任何需要「schema-driven UI」的场景(workflow 编辑器、API playground、low-code 平台)都能复用
决策 2:RabbitMQ + thread-pool + ClusterLock 做可取消的长任务调度
- 问题:agent 任务可能跑 30 分钟到 8 小时,需要可中断、可恢复、可观察
- 方案:任务入 RabbitMQ 队列 → executor 用 thread-pool 消费 → ClusterLock 保证同任务多副本不重复执行 → cancellation token 广播取消信号
- Trade-off:引入 RabbitMQ + Zookeeper 依赖(运维成本高),换来「分布式 + 可中断」;thread-pool 不适合 CPU 密集(但 agent 任务主要是 IO bound)
- 可迁移性:中——模式可复用,但 RabbitMQ 重,迁移前需要确认有没有更轻替代(Redis Stream、Celery)
决策 3:子进程 SDK + 自有流式协议
- 问题:业务代码要能「不改业务」跑在 CLI / UI / Platform 三种环境
- 方案:把 SDK 拆成独立子进程(
autogpt-sdk-server),用 WebSocket + JSON 自定义协议通信,CLI/UI 客户端调子进程而非直接 import - Trade-off:引入进程间通信开销 + 调试复杂度,换来「业务代码不动,三种环境可跑」;跨进程调试比 in-process 调用难得多
- 可迁移性:高——任何需要「同一份代码多端运行」的场景(CLI 工具、IDE 插件、独立服务)都适用
决策 4:期望 vs 非期望错误的分层错误模型(BlockError 分类)
- 问题:agent 失败时,开发者无法判断「这是 bug 还是用户输入问题」——所有异常一锅炖
- 方案:显式分类
BlockError(input 错误、依赖错误、内部错误、限流错误)+ 重试策略表 + 「非期望错误」单独告警路径 - Trade-off:要求每个 Block 显式 raise typed error,写错分类会被错误重试;换来「可观测的失败语义」+「自动重试决策」
- 可迁移性:高——任何「需要区分错误原因做决策」的系统都适用(HTTP middleware、worker retry、cron scheduler)
决策 5:Pydantic discriminated union 表示 prompt 策略集合
- 问题:一个 agent 可能要在多种 prompt 策略之间切换(zero-shot / few-shot / CoT / ReAct),用 if/else 维护会失控
- 方案:
PromptStrategy = Union[ZeroShot, FewShot, ChainOfThought, ReAct]用 Pydantic 的discriminator字段在 JSON 里多态序列化 - Trade-off:失去动态注册新策略的能力(必须改 schema),换来「静态可校验 + IDE 自动补全 + 自动文档」
- 可迁移性:高——任何「有限枚举 + 多态序列化」场景都适用(事件总线、消息协议、配置 schema)
决策 6:classic + platform 双轨执行路径
- 问题:旧用户(classic,单体脚本风格)要兼容,新平台用户(multi-agent 协同)要新功能
- 方案:仓库里同时保留
classic/和platform/两个执行路径,公用 schema/block,但调度器和 UI 各自一套 - Trade-off:显著的双轨维护负担——bug 要修两遍、新功能要 port、CI 要双倍测试;换来「老用户不流失 + 新平台独立演进」
- 可迁移性:低——典型「历史包袱」反例,迁移前要先想清楚「是不是该 deprecate 老路径」
竞品格局与定位
竞品对比矩阵
| 维度 | AutoGPT | LangChain / LangGraph | CrewAI | smolagents (HF) | BabyAGI |
|---|---|---|---|---|---|
| 定位 | 应用 + 平台 | LLM 应用框架 | 多 Agent 协作 | 轻量 Agent 框架 | 任务驱动最小化 Agent |
| Stars | 186K | 143K | ~35K | ~20K | ~10K |
| 核心抽象 | Block Graph(Pydantic schema) | Chain / LCEL / Graph | Role + Task | CodeAct(代码即工具调用) | Task list loop |
| 可视化编辑 | React Flow 内建 | LangGraph Studio | 无 | 无 | 无 |
| 长任务可中断 | 一等公民 | 弱 | 弱 | 弱 | 弱 |
| Token 精确计费 | 一等公民 | 无 | 无 | 无 | 无 |
| 多端协议 | 自有 SDK + WebSocket | Python 单端 | Python 单端 | Python 单端 | Python 单端 |
| License | PolyForm Free Trial | MIT | MIT | Apache 2.0 | MIT |
| 商业模式 | SaaS(agpt.co) | LangSmith 闭源工具 | 暂未明确 | HF 生态 | 无 |
差异化护城河
协议护城河 + 平台护城河——SDK Server + 自有协议让「同一份 agent 跨 CLI/UI/Platform」是 AutoGPT 独有;AutoGPT Platform 是任何竞品都没有的现成 SaaS 落地。Block Graph 的 schema-first 哲学也是 AutoGPT 最难被快速复制的能力,因为重写不是新增代码而是改整个架构范式。
竞争风险
- LangChain 生态扩张风险最高——LangSmith / LangServe / templates 形成正循环,AutoGPT 在「开发者日常工具」层面打不赢
- 新晋竞品(如 Hugging Face Transformers Agents 2.0、各家云厂商 agent 平台)——巨头下场做平台后,独立协议的吸引力会下降
- Babysit 自己生态——PolyForm Free Trial 阻止了商业化转售,但也限制了企业集成商的采用意愿
生态定位
「agent 运行时 + 协议」的中间层——不上不下,既不是底层 LLM SDK(输给 OpenAI / Anthropic 原生),也不是上层应用(输给垂直 SaaS)。定位尴尬但护城河深,扛得住「生态小众」但扛不住「巨头直接抄协议」。AutoGPT 的真正威胁不是技术追赶,而是 OpenAI / Anthropic / Google 自己下场做 agent 平台(事实上 OpenAI Assistants API 已经做了)。
套利机会分析
- 信息差: 极低。AutoGPT 是明星项目,每篇分析都被读过无数遍——但「3 年演化轨迹 + 平台化转型决策史 + Block Graph 工程实践」这条线鲜有人完整写过
- 技术借鉴: 极高。Block Graph 三段反射、BlockError 分层模型、OpenAPI diff-as-CI 是任何 agent 框架 / low-code 平台都能直接套用的设计模式
- 生态位: 中等。「agent 运行时 + 协议」中间层定位独特,但夹在 LangChain 生态与云厂商平台之间,向上向下都难扩张
- 趋势判断: 稳态。AI Agent 仍在高速演进,但 AutoGPT 已从「引领趋势」变成「跟随趋势」,增长曲线明显放缓(2023 月均 1000+ commit → 2025 月均 100+ commit)
风险与不足
- 超大文件问题严重:
copilot/sdk/service.py5,676 行单文件单类、executor/manager.py1,997 行——是项目继续演化的最大障碍,重构必要性极高 - 依赖硬钉版本:
kysely ≤0.28.x(小版本都钉)、claude-agent-sdk 0.1.64(单 patch 版本锁定),升一个 minor 都要手改,拖累了上游安全补丁的吸收速度 - GitBook 文档严重落后于代码:README 与 docs 经常对不上,changelog 不完整,新人上手成本被显著拉高
- License 收紧的双刃剑:PolyForm Free Trial 阻止了商业化转售,但同时阻碍了企业集成商采用,反向推动了「fork 后改 license」的分裂风险
- classic + platform 双轨负担:bug 要修两遍、新功能要 port、CI 要双倍测试,是项目继续快跑的结构性瓶颈
- 真实人类核心团队 ≤5 人:剔除 6 类 bot 后真人核心团队很小,bus factor 风险高
行动建议
如果你要用它
- 做产品 PoC:推荐 AutoGPT Platform(SaaS),45+ 平台零 API key 集成、按调用 wallet 计费,自托管技术用户用
autogpt_platform/docker-compose - 做底座定制:不建议直接 fork classic/——优先在
autogpt_platform/上做二次开发,受益于 Block Graph + React Flow 编辑器 - 生产环境:注意长任务必须用 ClusterLock 部署单实例,RabbitMQ + Zookeeper 是必需依赖
如果你要学它
重点关注这些文件/模块:
| 模块 | 文件路径 | 学习价值 |
|---|---|---|
| Block 基类 | autogpt_platform/backend/backend/blocks/_base.py | Pydantic IO schema + JSON Schema 反射范式 |
| Block 调度 | autogpt_platform/backend/backend/executor/manager.py | RabbitMQ + thread-pool + ClusterLock 可取消长任务 |
| Copilot SDK | autogpt_platform/backend/backend/copilot/sdk/service.py | 子进程 + 自有 WebSocket 协议(注意单文件 5,676 行超大) |
| 前端 API 类型 | autogpt_platform/frontend/src/lib/autogpt-server-api/types.ts | codegen-from-OpenAPI 客户端类型生成 |
| 数据库 schema | autogpt_platform/backend/schema.prisma | Prisma 演化最佳实践(291 次修改) |
| 原 CLI 自治循环 | classic/original_autogpt/autogpt/agents/agent.py | AI Agent 范式起点范本 |
如果你要 fork 它
值得改进的方向:
- 拆分超大文件:把
copilot/sdk/service.py按 Block 类型拆分(每个 Block 一个文件),同时把executor/manager.py按职责拆分(调度 / 取消 / 重试) - deprecate classic/:把 classic/ 标记为 deprecated,引导用户迁移到 platform/,释放双轨维护负担
- 依赖解钉:把
kysely ≤0.28.x、claude-agent-sdk 0.1.64这类硬钉依赖升级,做兼容性测试矩阵 - 文档同步机制:用 codegen 把 Block 的 Pydantic schema 反射到 GitBook 文档(自动生成 API reference),根治文档落后问题
- 增强 open-core 边界:把 platform/ 的开源部分与闭源部分用更清晰的路径分离(如
platform-core/+platform-ee/),让贡献者更容易理解哪些代码可以改
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 未收录(fetch 返回”loading/未索引”) |
| Zread.ai | 未收录(403 拒绝) |
| 关联论文 | 无(AutoGPT 是产品而非论文,#15 递归自我改进有过讨论但未发表) |
| 在线 Demo | agpt.co(AutoPilot chat 即时试用) |
| 关键 Issue | #15 Recursive Self Improvement / #25 Support using other/local LLMs / #21 Invalid JSON |