GitHub 推荐:「开源版 Palantir」semantica 登顶 Trending:4000 star 与 4542 月下载之间差了什么
一句话总结
一个印巴小团队用 10 个月写出 25 万行代码,把 2000 年代的 W3C 语义网技术栈(RDF/OWL/SHACL/PROV-O)整体搬进 LLM Agent 场景,做成「监管行业可审计的上下文与决策层」——工程投入是真的,Datalog 与 provenance 子系统扎实到值得单独拆解,但 Rete 引擎的核心匹配函数直接 return True,CI 根本不跑 Python 测试,而 4007 star 对应的 PyPI 月下载只有 4542。
值得关注的理由
- 一个罕见的「橱窗热度 vs 装机量」极端样本:2026-08-10 冲上 GitHub Trending 日榜第 1,star 三天涨 69%,但 PyPI 月下载 4,542——比同赛道最小的 microsoft/graphrag 还低一个数量级,比 graphiti 低约 338 倍。这个背离本身就是值得研究的行业标本。
- 跨域移植的教科书案例:把 W3C 语义网那套「本体约束 + 溯源模型 + 规则推理」搬到 Agent memory 赛道,正面占住了「合规可审计 + 不依赖 LLM 的确定性推理」这条无人竞争的缝隙——GraphRAG/agent-memory 前五名合计 19.7 万 star,却没人做这件事。
- 两个真值得抄的子系统 + 一个真该警惕的坑:provenance 的哈希链 + lineage BFS、Datalog 的半朴素 fixpoint 求值,都是可以直接迁移的实现;而 Rete 引擎的占位实现则是「宽 API 表面掩盖未完成内核」的绝佳反面教材。
项目展示
(项目 Logo)
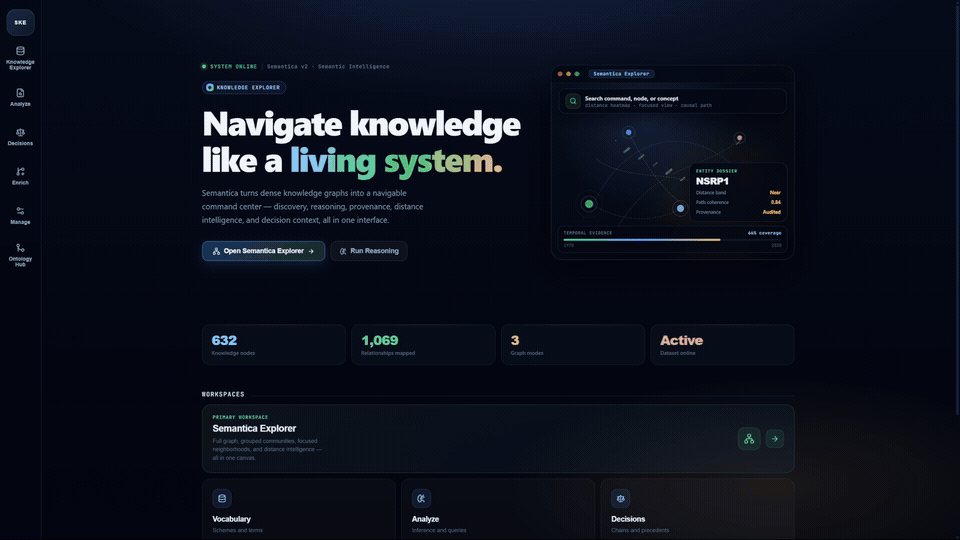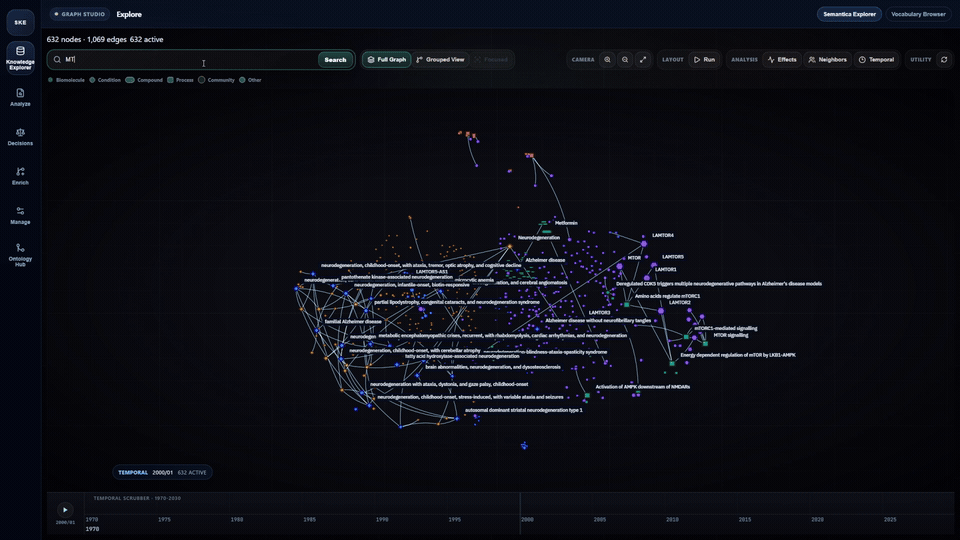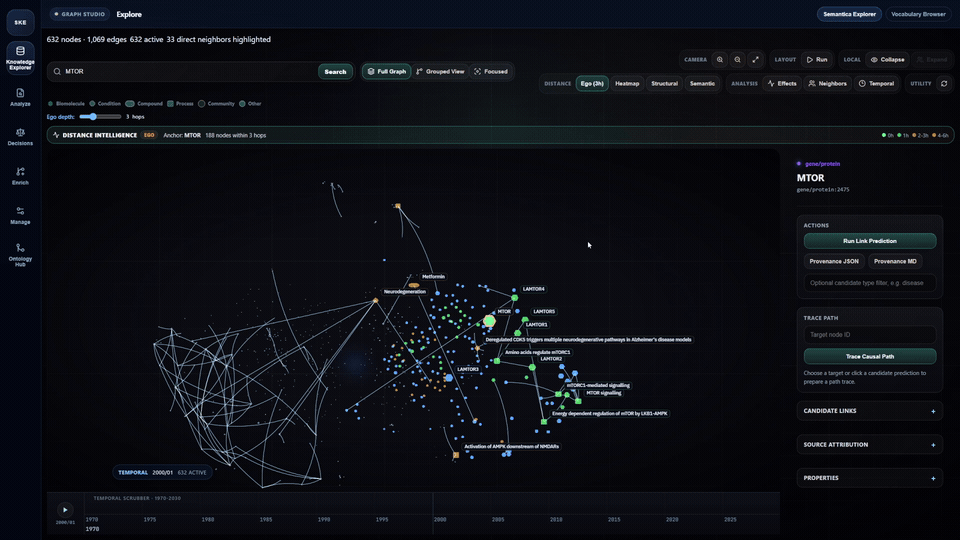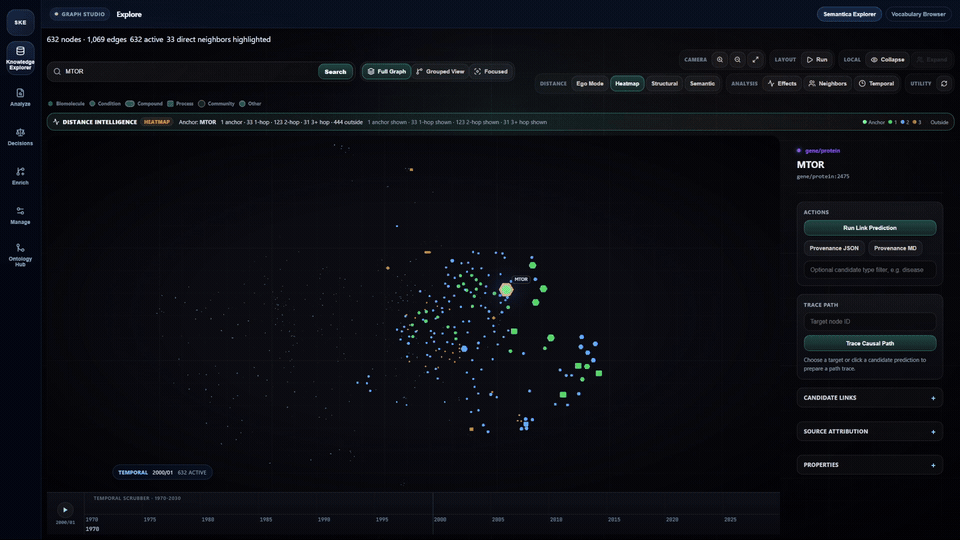
(Knowledge Explorer:实时图谱、决策记录、实体消歧、本体中心——README 首屏主视觉)
- 平台完整走查视频(YouTube)
README 共 21 个媒体元素,其中 16 个是 shields.io / Trendshift 徽章,已排除。官网 getsemantica.ai 直连返回 403,无法提取图片资源。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/semantica-agi/semantica |
| Star / Fork | 4,007 / 478(8.4:1,属该品类常态区间,详见下方核查) |
| 代码行数 | 253,156 行(Python 85.9% / TSX 7.7% / TypeScript 3.5%),934 文件 |
| 项目年龄 | 13.5 个月(首 commit 2025-06-25,但真正代码首版是 2025-10-22,实际约 10 个月) |
| 开发阶段 | 密集开发(近 30 天 271 commits,近 90 天 643,无衰减) |
| 贡献模式 | 单人主导的小团队(28 位贡献者,主作者占 58%,前 5 占 87%) |
| 热度定位 | 中等热度 / 橱窗热度远高于装机量 |
| 质量评级 | 代码[良好] 文档[丰富但宣传超前] 测试[数量充分但 CI 无门禁] |
作者视角:为什么存在这个项目
创始人/作者背景
semantica-agi 是个组织账号,实际主导者是 KaifAhmad1(Mohd Kaif),bio 明写「Founder & Core Maintainer @semantica-agi」,团队分布在印度 Pune 与巴基斯坦 Sargodha。组织下 3 个仓库里另两个(.github、semantica-grant)都是 0 star,本项目是唯一实体——投入权重极高。
开发节奏(近 30 天 271 commits、工作日占 78.6%)符合全职创业而非业余投入。官网未披露任何融资、投资人或创始团队信息,而 org 下 semantica-grant 仓库里的 funding.json 指向 FLOSS 类开源资助申请——这更像是一个尚未拿到 VC、靠资助与开源声量起步的早期团队。
问题判断
作者的切入点不是某个算法,而是一个行业观察:向量 RAG 能回答「像什么」,回答不了「为什么这么决定、依据是什么、谁改过」。README 把场景直接钉在贷款审批、医疗决策、合规审计上——都是事后必须被监管追问的高风险工作流。
时机判断上,2025-2026 恰好是 Agent 从 demo 走向企业落地、而「AI 决策不可解释」开始成为采购阻碍的窗口。作者赌的是:合规压力会先于性能需求,成为企业 AI 基础设施的选型门槛。
解法哲学
作者选择了大而全的平台路线,而非 Unix 式小工具:
- 确定性优先:图构建、规则推理、溯源全部不强制依赖 LLM——这是最核心的立场,直接反对了 GraphRAG 那套「用 LLM 抽实体建图」的主流做法(后者成本高、不可复现、无法审计)
- 标准优先于自研:全盘采用 W3C 既有标准(RDF/OWL/SHACL/PROV-O),而不是发明私有格式
- 零锁定:MIT + 全自托管 + 多存储后端可换,明确不做 SaaS 数据外流
明确不做的:不做托管服务,不做私有格式,不把推理黑箱化。README 的原话是「No proprietary format, no closed pipeline, no black box」。
战略意图
商业化路径清晰且传统:MIT 开源核心 → 自托管团队版 → 企业定制部署,全部跑在客户自有基础设施上。这套打法完全对准监管行业的采购逻辑(数据不能出境/出内网)。
自称「The Open Source Palantir for AI Agents」是个精准但危险的定位——精准在于它一句话讲清了「给高风险决策做可审计的数据底座」,危险在于 Palantir 的核心竞争力是交付与集成能力,而这恰恰是一个 28 人贡献者的开源项目最难兑现的部分。
核心价值提炼
创新之处
按「新颖度 × 实用性」排序:
-
把 Agent 决策建模为可查询的图对象(新颖度 4/5 · 实用性 5/5 · 可迁移性 5/5) 决策不是日志行,而是带场景、理由、置信度、因果链、影响范围和历史先例的一等图节点。可以直接查「和这次审批相似的历史决策有哪些」「这个决策依赖的事实后来被推翻了吗」。适用于信贷审批、临床辅助、风控策略执行。
-
语义网治理技术栈迁移到 Agent 基础设施(新颖度 4/5 · 实用性 4/5 · 可迁移性 4/5) 底层标准(RDF/OWL/SHACL/PROV-O)一个都不新,都是 2000 年代的老东西;但把它们与 Context Graph、Agent memory、决策智能组合起来面向 LLM 场景,目前确实没有第二家。这是旧技术找到新场景的典型,而非旧技术套新概念——判断依据是它真的用 SHACL 做约束校验、真的用 PROV-O 建模来源,不是只借了个名词。
-
Provenance 存储抽象 + lineage BFS + 哈希链(新颖度 3/5 · 实用性 5/5 · 可迁移性 5/5)
ProvenanceStorage(ABC)统一内存/SQLite/自定义持久层,配合上下游血缘图遍历和 SHA-256 链式校验。这套东西可以整体搬到任何数据血缘、审计日志、可追责工作流系统里。 -
原生 Datalog 半朴素求值(新颖度 3/5 · 实用性 4/5 · 可迁移性 4/5)
datalog_reasoner.py有事实索引、Horn 规则解析、变量统一和 semi-naive fixpoint evaluation,支持递归多跳推理。这是全仓库最值得单独拿出来学的模块——不是 LLM prompt 包装,是正经算法实现。 -
确定性边身份与时态规范化(新颖度 3/5 · 实用性 4/5 · 可迁移性 4/5)
context_graph.py用规范化 JSON + UUID5 生成边 ID,统一处理日期/时间戳/时区输入。解决幂等导入与去重,小而实用。
可复用的模式与技巧
- 懒加载模块代理:模块级
__getattr__+_ModuleProxy推迟重型子模块导入(semantica/__init__.py:47-67)——适合大型 Python SDK,但必须搭配真正的 optional extras,否则只解决了导入时机,没解决安装体积(semantica 自己就掉进了这个坑,见下) - 内容寻址的稳定边身份:端点+类型+权重+时间+元数据规范化后生成 UUID5——幂等导入的通用解法
- 确定性路径优先 + 模型路径可选:正则/规则/传统 NLP 先处理,Transformer/LLM 作为可选增强,用 registry 分发——适合成本敏感、隐私敏感、审计要求高的流水线
- 链式完整性校验:每条记录存
current_checksum+previous_checksum——能发现普通数据库里的记录篡改和中间删除,成本极低 - 图上决策生命周期:record → link → query → govern → audit 设计成连贯工作流——把审计要求前置到业务模型,而不是事后补日志
关键设计决策
决策一:用统一抽象适配多种图后端
- 问题:企业已有 Neo4j / FalkorDB / Neptune / Apache AGE,不能被单一数据库锁定
- 方案:
GraphStore+NodeManager+RelationshipManager+QueryEngine组合成统一访问层,extras 管理各后端客户端依赖 - Trade-off:统一 CRUD 有利迁移,但 Cypher / OpenCypher / 事务 / 索引 / RDF 语义并不等价,最低公分母 API 会掩盖后端差异
- 可迁移性:中高——但必须配套逐能力 feature matrix,否则就是 issue #888 的下场
决策二:provenance 作为每条事实和决策的一等数据
- 问题:Agent 输出无法回答来源、处理过程、依赖关系
- 方案:统一实体/活动/代理/父子版本/来源/使用实体建模,支持 SQLite 与内存存储,lineage 用 BFS 查询
- Trade-off:写入、存储、查询成本显著增加;且若上游抽取质量不高,审计链只能证明「系统如何记录」,不能证明「记录内容真实」——这是所有 provenance 系统的共同天花板
- 可迁移性:高
决策三:哈希链做完整性
- 方案:保存
current_checksum、sequence_id、previous_checksum,新记录链到插入顺序上一条 - Trade-off:是 tamper-evident,不是 tamper-proof。没有数字签名、密钥管理、Merkle 树或外部可信锚点,因此不提供不可抵赖性,也拦不住有数据库写权限的攻击者重写整条链
- 可迁移性:高(内部审计增强够用;要满足强监管证据要求还得加签名和外部锚定)
竞品格局与定位
竞品对比矩阵
| 维度 | semantica | mem0 | graphiti | cognee | graphrag |
|---|---|---|---|---|---|
| Stars | 4,007 | 62,951 | 29,752 | 29,930 | 35,390 |
| PyPI 月下载 | 4,542 | 3,930,787 | 1,537,764 | 173,628 | 70,829 |
| 核心定位 | 可审计知识+决策层 | 通用记忆层 | 实时双时态图谱 | AI memory 平台 | 图 RAG 参考实现 |
| 图构建是否依赖 LLM | 否(规则/NLP 路径) | 部分 | 部分 | 是 | 重度依赖 |
| 本体治理(OWL/SHACL) | ✅ | ❌ | 弱 | ❌ | ❌ |
| PROV-O 溯源 | ✅ | ❌ | ❌ | ❌ | ❌ |
| 多图后端可换 | 4 个适配器 | — | 偏绑 Neo4j | 有限 | 弱 |
差异化护城河
真正的护城河不是 Rete 或向量检索算法本身(那部分反而是短板),而是数据模型层面的组合:PROV-O + SHACL + 决策生命周期 + 企业工作流集成。竞品要补齐这套,得改的是数据模型而非加个功能——迁移成本高,这是它唯一站得住的地方。
竞争风险
最大风险是 cognee 或 graphiti 顺手加上 provenance 和时态治理能力。 如果它们用更简单的 API 覆盖 80% 的需求,semantica 的「大平台」优势会瞬间反转为采用障碍——用户不会为了 20% 的合规能力吞下 214 个 runtime 依赖。
从当前 338 倍的下载量差距看,这个风险不是未来时,而是正在发生。
生态定位
定位在 LLM / 向量库 / Agent 框架之下的基础设施层:向上声明可接 LangGraph、CrewAI、LlamaIndex、AutoGen、Claude Code,对外提供 MCP server;向下支持 Neo4j / FalkorDB / Apache AGE / Neptune + FAISS / Pinecone / Weaviate / Qdrant / Milvus / PgVector,以及 Snowflake / Databricks Unity Catalog。
它想当的是「监管行业 AI 的地基」,目前实际是「一个功能很宽的开源工具箱」。
套利机会分析
- 信息差:反向的——这个项目不是被低估,是被高估。4007 star / 4542 月下载意味着绝大多数 star 是「围观收藏」而非「打算用」(watchers 仅 31,star/watch 比 129:1,同行是 175~288:1)。真正的信息差在于:大多数人会因为它上了 Trending 而高估它,读过代码的人才知道哪几块能用。
- 技术借鉴:这是本项目最大价值所在。
provenance/(3,770 行)和reasoning/datalog_reasoner.py可以直接抄;决策对象化建模思路可以整体迁移。不需要引入这个库,读代码就够了。 - 生态位:「监管行业可审计上下文层」这个缝隙确实没人正面占据——GraphRAG/agent-memory 前五名合计 19.7 万 star,没有一家做 PROV-O 溯源。如果你要做企业 AI 治理产品,这是个真实的市场空白。
- 趋势判断:赛道方向(AI 可解释性、决策审计)符合监管趋势,但本项目能否守住取决于三件当前都是短板的事:基准测试、后端能力矩阵、大图性能。叙事已经跑到了实现前面,接下来是还债期。
风险与不足
1. README 的架构声称有实质水分(按代码逐条核实)
| 声称 | 核实结论 | 代码证据 |
|---|---|---|
_ModuleProxy 惰性加载 | 属实但效果有限 | pyproject.toml 仍把大量重型库放 core dependencies,只解决导入时机不解决安装体积 |
| 五套推理引擎 | 部分属实,夸大 | Datalog 扎实;Rete 的 AlphaNode._matches() 和 BetaNode._can_join() 直接 return True;SPARQL 是字符串拼接的 basic implementation;时序推理只是 re-export |
| PROV-O + 哈希链 | 部分属实 | 机制真实,但 tamper-evident ≠ tamper-proof,无签名/Merkle/外部锚定 |
| 多图后端「all swappable」 | 部分属实 | 实测 4 个适配器(Neo4j/FalkorDB/AGE/Neptune),但 README 还列了 Oxigraph/Blazegraph/Jena/RDF4J,无能力矩阵,issue #888 的质疑成立 |
| 不依赖 LLM 的确定性抽取 | 部分属实 | 确有规则/NLP 路径,但 core 依赖已含 spaCy/transformers/torch;准确表述应是「核心流程不强制调 LLM」而非「no LLM required」 |
2. 生产规模承载力存疑
issue #430 揭示 ContextGraph.find_nodes 在 50k 节点 / 100k 边下先全量物化再分页,直接 502 超时。对一个自称「企业级 / 监管级基础设施」的项目,这是原型量级的实现。
3. 测试数量没有转化为质量门禁
221 个测试文件、9,758 条断言、无 assert True 占位——数量和质量都不错。但 CI 根本不跑 pytest:workflow 只做包构建和 Explorer 前端检查,无 coverage 门槛、无 mypy、无 ruff/flake8。benchmark workflow 仅手动触发且 baseline 比较被注释掉。issue #231 中官方自陈「No benchmarking infrastructure exists」——一个主打确定性推理与性能的项目缺基准测试,性能主张就没有公开可验证的支撑。
4. 依赖过重 214 个 runtime 依赖,spaCy / transformers / torch 全在 core。对「装来试一下」的用户,这是极高的第一道门槛,也部分解释了下载量为何上不去。
5. 安全细节
默认图存储配置里带开发用密码 password;semantic_extract/methods.py 存在裸 except: 路径。
6. 单文件职责过重
context_graph.py 单文件 3,432 行,同时承担图操作、时间处理、决策记录、因果分析、图算法——已经是维护负担。
7. 关于「刷量」嫌疑的澄清(重要)
分析启动时我预设了三条怀疑,逐条被数据推翻,在此如实更正:
- ❌「star/fork 8.4:1 异常低」→ 前提错误。实测同赛道:LightRAG 7.1:1、mem0 8.6:1、graphrag 9.5:1、graphiti 9.9:1、cognee 10.3:1。8.4:1 完全落在这类「fork 下来跑 notebook」的重实操库常态区间。
- ⚠️「疑似空投农场刷 fork」→ 确有 bot fork 潮,但非项目方所为。抽查最近 100 个 forker,37 个注册于 2026-08 且 followers 为 0,用户名为「形容词+名词+数字」模式;但它们同时 fork 了当日 trending #2/#3/#4 的其他项目,且与
msitarzewski/agency-agents的 forker 列表高度重合——是扫榜的通用农场机器人,semantica 因冲上 #1 被顺带扫到,属被动污染。另外 fork 曲线未脱离 star 曲线(08-07→08-10:fork 294→412,star 2169→3664,同比例),若是刷 fork 则 fork 会显著跑赢 star。 - ❌「疑似 crypto/token 营销」→ 零证据。1613 行 README grep
airdrop|token reward|crypto|web3|presale|whitelist命中 0;官网无 token/积分/waitlist;semantica-grant里的funding.json是标准开源资助格式。「agi」只是组织命名风格。
代码侧同样干净:无 vendoring、无第三方 LICENSE 头、TODO/NotImplementedError 仅 48 处(0.022%)、最高单日 25 commits(无 dump 特征)、主作者是真人 Gmail 账号。看似 5 万行的 commit 是纯 rename(similarity 100%),最大 commit 是 d3fend.ttl 数据文件而非源码。
结论:热度是有机的,工程投入是真的,问题不在诚信而在「宣称超前于实现」。
行动建议
-
如果你要用它:先别在生产用。只建议明确需要「合规知识图谱 + 决策审计 + 自托管」且愿意做 PoC 的团队小规模验证,优先压测四件事——分页性能(对照 #430)、你需要的后端到底支持到什么程度(README 没有能力矩阵)、规则路径的抽取质量、214 个依赖能否装进你的环境。如果你只是想改善 RAG 召回,用 LightRAG 或 graphrag;只要 Agent 记忆,用 mem0 或 graphiti——迁移和试错成本低一个数量级。
-
如果你要学它:这是本项目的最佳用法。重点读三处:
semantica/reasoning/datalog_reasoner.py— 事实索引 + 变量统一 + 半朴素 fixpoint,全仓库算法密度最高semantica/provenance/(manager.py + integrity.py,3,770 行)— PROV-O 建模 + 存储抽象 + lineage BFS + 哈希链,可整体迁移semantica/context/context_graph.py— 决策对象化与时态规范化的建模思路(读思路,别抄结构,3,432 行单文件是反面教材)- 另外
reasoning/rete_engine.py值得作为反面教材读:完整的网络结构骨架 + 核心匹配函数return True,是「宽 API 表面掩盖未完成内核」的标本
-
如果你要 fork 它:最高性价比的三个改进方向——① 把分页/过滤/聚合下推到存储层(修 #430 的根因);② 补后端能力矩阵文档(#888,这是当前用户流失的主因);③ 把 core dependencies 拆进 optional extras,让最小安装真正轻量。这三件事做完,下载量的天花板会明显不一样。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 已收录(2026-08-08 索引,含完整四层架构剖析) |
| Zread.ai | 无法判定(返回 403 而非 404,可能存在但拒绝抓取) |
| 关联论文 | 无(注意:搜索「Semantica」会命中同名但无关的 arXiv 论文,勿误引) |
| 在线 Demo | 无托管 playground;有 YouTube 平台走查视频 与 Trendshift 榜单页 |