给 Claude Code 装上记忆:3.5 个月 21.7K star 的 agentmemory,护城河不是 benchmark 第一
一句话总结
agentmemory 是给 AI 编程 agent(Claude Code、Cursor、Copilot CLI、Codex 等 20+ 个)外挂的持久记忆层:用 12 个生命周期 hook 自动捕获每次工具调用/会话,零外部数据库(全跑在作者自家的 iii engine 上),跨 session 帮 agent 记住项目上下文。它由 Google GDE / CNCF Ambassador、DevRel 出身的 Rohit Ghumare 单人主导,3.5 个月冲到 21.7K star。但它真正站得住的护城河是「集成广度 + 真零配置」,而非营销主打的「#1 benchmark」——后者经核实是自评的 retrieval-only 数字、跨竞品口径不一。
值得关注的理由
- 一套可复用的混合检索工程:召回用 Reciprocal Rank Fusion 融合 BM25 词法 + 向量语义 + 知识图谱三路(只用排名不用原始分,解决三路量纲不可加),关键巧思是缺流自动重归一化——本地无 embedding 就优雅退化为纯 BM25、未开图谱就退化为 BM25+vector。这套「RRF + 缺流归一 + session 多样化」是任何多源检索系统的教科书骨架。
- 一个值得对照的「营销 vs 工程真相」案例:深读代码会发现不少营销话术与默认实现的落差——「会在下次 session 注入正确上下文」但
AGENTMEMORY_INJECT_CONTEXT默认false(注入烧 token);「Ebbinghaus 遗忘曲线」实为离散阶梯衰减strength × 0.9^periods而非连续指数;「免 API key」只覆盖捕获 + 检索,真正的「记忆升华」(语义/程序性巩固)强依赖 LLM、默认关闭。这种「默认保守、强项 opt-in」其实是被生产事故(137GB 日志反馈环、OOM)教育出来的工程成熟度,但与「开箱即魔法」的文案有落差。 - 一个 DevRel 驱动的病毒增长样本:作者是 2x Google GDE、3x CNCF Ambassador、2x Docker Captain,同时还做了 ai-engineering-from-scratch(30K star 课程)。agentmemory 既是产品、也是其公司 iii.dev 的旗舰 showcase。「连续爆款制造者 + benchmark 营销 + 多语言 README」是研究 AI 时代开源增长机制的活样本。
项目展示
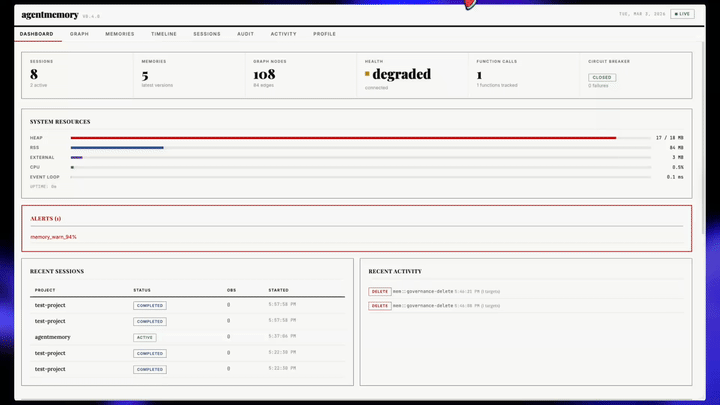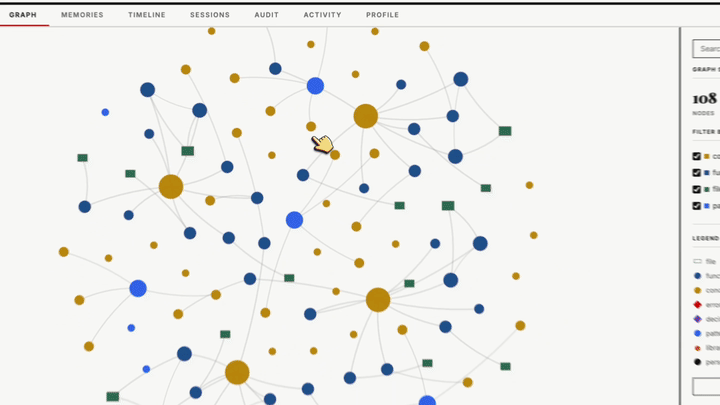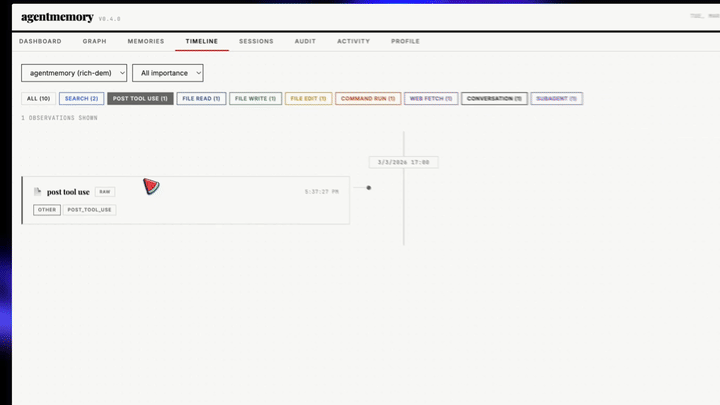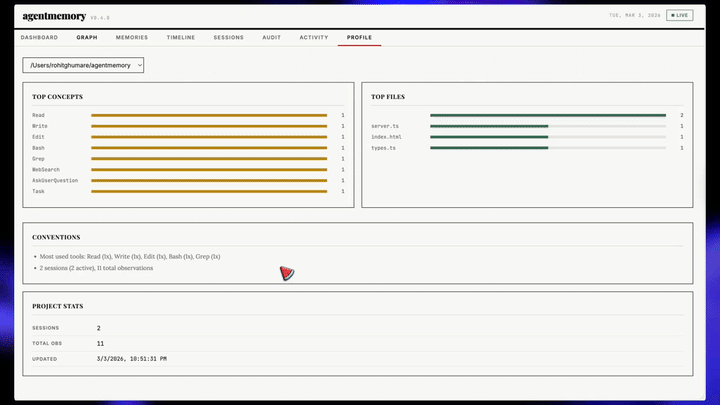
核心是「一条命令,跨 agent 工作」——hook 自动捕获、跨 session 召回,无需手动 add()。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/rohitg00/agentmemory |
| Star / Fork | 21,723 / 1,788 |
| 代码行数 | 73,804 行(TypeScript 86.8%,注释比 0.252;运行时依赖仅 6 个、0 外部数据库) |
| 项目年龄 | 3.4 个月(2026-02-25 v0.1.0) |
| 开发阶段 | 密集开发 / 冲刺打磨(近 30 天 192 commit,fix 占 56.5%,v0.9.27 逼近 1.0) |
| 贡献模式 | 单人主导(40 人,Rohit Ghumare 占 84.3%) |
| 热度定位 | 大众热门 / 爆发型(3.5 个月 21.7K star,DevRel 驱动) |
| 质量评级 | 代码组织「优」 可靠性工程「优」 文档「优(营销重)」 安全「中」 iii 耦合「高」 |
作者视角:为什么存在这个项目
创始人/作者背景
作者 Rohit Ghumare(rohitg00)——2x Google Developer Expert(Cloud & AI)、3x CNCF Ambassador、2x Docker Captain、AWS Community Builder,4061 followers,典型的强背景技术布道者(DevRel)。单人主导(452 commit 中本人 391,84.3%)。关键利益相关披露:他的 GitHub company 字段是 iii.dev,agentmemory 构建在 iii engine(iii-hq/iii,~17.7K star)之上,既是产品也是 iii 的旗舰 reference app——这是理解其「强营销 + benchmark 话术」的背景,benchmark 声明应按厂商自评读。他还有 ai-engineering-from-scratch(30K star 课程)等多个爆款,是稳定输出的「DevRel 增长机器」。
问题判断
要解决编程 agent 每个 session 结束即「失忆」、用户反复重新解释的痛点。README 直接对标静态记忆:「内置记忆(CLAUDE.md / .cursorrules)200 行就封顶且会过期」。批判分两类:静态文件(手动、易过期、无检索)+ 通用记忆库(mem0 等需手动 add()、需外接向量库、非编程 agent 专用)。agentmemory 卡位「编程 agent 专用 + 自动捕获 + 零外部依赖」三者交集。作者把它描述为 Karpathy「LLM Wiki」模式的工程化(加 confidence scoring、lifecycle、知识图谱、混合检索)。
解法哲学
「Silent capture, on-demand recall」——捕获零摩擦(hook 自动拦截、用户无感),但注入克制。反直觉的是:尽管文案说「自动注入上下文」,默认配置其实把注入、自动压缩、图谱抽取都关掉了(各有 issue 编号记录原因:注入烧 Claude Pro token、压缩烧 LLM)。这套「默认保守、强项 opt-in、boot log 明示开启代价」是被生产事故教育出来的——iii-config.yaml 注释自曝 #519(可观测性日志正反馈环数日写出 137GB)、#221(OOM)。
战略意图
双重定位:① 产品——编程 agent 记忆层;② iii engine 的旗舰 showcase——「零外部 DB」不是不需要数据库,而是 iii 自带 KV/queue/pubsub/cron/stream/OTEL(iii-config.yaml 列了 8 个 worker),整个 agentmemory 就是「一个跑着的 iii 实例」,给 iii 引流。DevRel 营销密度极高(Trendshift 徽章、star-history、benchmark 数据墙),「#1」「remembers everything」是厂商自评话术。
核心价值提炼
客观提示:本节区分「站得住的工程」与「被夸大的营销」。Phase 核实结论——95.2% R@5 来自 LongMemEval-S 的 retrieval-only(仓库
benchmark/LONGMEMEVAL.md自己声明「不是 LongMemEval 端到端分数」);与竞品对比跨 benchmark 口径不一(agentmemory/MemPalace 测 LongMemEval-S,Letta/Mem0 测 LoCoMo);同 benchmark 上 MemPalace 96.6% 反而更高;官网数字比仓库更激进且对不上。可复现性做得不错(提供数据集 + 一键复跑)。
创新之处
- 12 hook 全生命周期自动捕获 + 默认零 LLM 合成压缩(新颖度 3/5,实用性 5/5):每个 hook 编译成自包含
.mjs,仅做 stdin 解析 + 一个带超时的fetch(fire-and-forget,不 await、崩了也不阻塞 agent),真正逻辑全在中心化 iii function(mem::observe)侧;compress-synthetic.ts用纯启发式(工具名正则推断 observation 类型、抽文件路径)零 token 完成捕获索引,LLM 压缩降级为 opt-in。 - 缺流自动归一的三路 RRF 混合检索(新颖度 3/5,可迁移性 5/5):
hybrid-search.ts用score = Σ wᵢ × 1/(RRF_K + rankᵢ)(BM25 0.4 / vector 0.6 / graph 0.3,RRF_K=60)融合三路,某路无结果则权重置 0 并把剩余权重重新归一——本地无 embedding 优雅退化纯 BM25、未开图谱退化 BM25+vector;diversifyBySession每 session 最多 3 条防霸榜。 - 全本地化检索栈(免 API key 的捕获+检索)(新颖度 2/5,实用性 5/5):
LocalEmbeddingProvider用@xenova/transformers在 Node 端跑all-MiniLM-L6-v2(384 维),reranker 用量化版 cross-encoder;embedding 是 7 选 1 可插拔,withDimensionGuard在边界拦截维度错配。 - 一份逻辑、四种集成出口 + per-agent 模板(新颖度 4/5,可迁移性 3/5):同一套 iii function 通过 hooks / MCP server(53 工具)/ Claude·Codex plugin / REST(~128 endpoint)同时暴露,再用
hooks.{copilot,codex}.json、integrations/*适配 20+ agent。这是单人项目里罕见的覆盖面铺设量。
可复用的模式与技巧
- 薄 hook + fire-and-forget 遥测:宿主生命周期事件 → 极薄客户端 → 紧超时非阻塞 POST → 中心 daemon 处理——侵入式埋点但不拖慢宿主。
- RRF + 缺流归一 + session 多样化:任意多源混合检索的骨架。
- 维度守卫包装器(
withDimensionGuard):在 provider 边界把「错维度向量静默污染索引」转成显式抛错——任何可插拔 embedding 的系统。 - XML 结构化 LLM 输出 + 正则解析:consolidation 用
<fact confidence=>/<procedure>让 LLM 产出可解析结构。 - 「默认保守、强项 opt-in」配置哲学:烧 token/磁盘的能力默认关、boot log 明示代价与 issue 编号——能力强但有资源副作用的工具通用。
- provider 弹性链(circuit-breaker + fallback-chain):多 LLM 后端容灾。
关键设计决策
最值得记录的是 「零外部 DB = 把持久化全外包给 iii engine」 的双刃取舍。竞品(mem0/Zep)都要用户自备 Postgres/向量库,安装即劝退;agentmemory 把 KV/queue/pubsub/cron/OTEL 全走 iii 内置 worker(file-based 落 ./data/state_store.db),BM25 倒排与向量索引则是纯内存 Map + 序列化落盘,于是 npx 即用、不要外部 DB。优势是安装零摩擦、单机自洽;代价有二:① 命运绑死在 iii 这个相对小众 runtime 上(iii-sdk 是唯一核心运行时依赖,脱离 iii 不可运行);② 向量检索是 O(n) 暴力线性扫描(vector-index.ts 逐条 cosine,无 ANN/HNSW),10 万级以上 recall 延迟线性恶化(benchmark/load-100k.ts 的存在说明作者知道这个门槛)。这是「用强耦合换零配置」的典型权衡(关键文件 src/index.ts + src/state/ + iii-config.yaml)。
竞品格局与定位
竞品对比矩阵
| 维度 | agentmemory | mem0 | claude-mem | Letta/MemGPT |
|---|---|---|---|---|
| Stars | 21.7K | ~48K | ~46K | ~22K |
| 定位 | 编程 agent 记忆层 | 通用记忆 SDK | Claude 专用记忆 | 带记忆的 agent runtime |
| 捕获 | 12 hook 自动 | 手动 add() | Claude hook | agent 自编辑 |
| 存储 | 零外部 DB(iii) | 需外接向量库 | 本地 SQLite+FTS5 | 需 Postgres+向量 |
| agent 覆盖 | 20+(hooks/MCP/plugin/REST) | 框架无关 | 仅 Claude | 自有 runtime |
差异化护城河(客观,非 benchmark)
① 集成广度——12 hook × 4 出口 × 20+ agent 的工程铺设量,单人项目罕见、复制成本高;② 真零配置——本地 embed + iii 内置存储,npx 即用、不要 API key 也不要外部 DB(仅限捕获+检索);③ 编程 agent 垂直语义(observation 类型、四层巩固贴合 coding session)。护城河是「工程铺设广度 + 安装摩擦极低」,不是 一个经第三方核实的 benchmark 冠军。
竞争风险
- benchmark 营销激进:retrieval-only 当端到端宣传、跨竞品口径不一、官网与仓库数字不符——信任成本高;
- 强绑 iii 小众 runtime:单点战略风险,无替代后端;
- 核心强项默认关(注入/巩固/图谱):「开箱即魔法」与实际默认体验有落差,真正升华还要花 token;
- 向量 O(n) 线性扫描:限制大规模;
- 巴士因子≈1(作者 84% 提交);
- 安全:plugin 用明文 HTTP 传
AGENTMEMORY_SECRET,远程部署需自套 TLS。
生态定位
在「编程 agent 记忆层」细分里靠广度 + 低摩擦卡位,与 claude-mem(Claude 专精)、mem0(通用 SDK)、Letta(runtime)、Zep(时序图谱)形成错位竞争;同时承担 iii engine 的获客入口。
套利机会分析
- 信息差:发现型套利已关闭(已家喻户晓),但内容型套利仍开——多数报道停留在复述营销话术,少有人客观拆解「benchmark 真实性 + iii engine 架构 + DevRel 增长机制 + 营销 vs 默认实现的落差」,这正是差异化切入点。
- 技术借鉴:薄 hook fire-and-forget 遥测、RRF + 缺流归一、维度守卫、XML 结构化 LLM 抽取、provider 弹性链、默认保守配置哲学——这些可迁移到任何埋点 / 混合检索 / 可插拔 embedding / 多 LLM 容灾系统。
- 生态位:填补「编程 agent 专用 + 自动捕获 + 零配置」的交集;与通用记忆 SDK(mem0)错位。
- 趋势判断:agent 记忆是刚需且红海(mem0 48K / claude-mem 46K / Khoj 34K / Zep 24K);agentmemory 靠 DevRel 增长 + 集成广度抢心智,但要警惕「营销透支信任」与「强绑 iii」两个长期风险。
风险与不足
- 营销与证据的落差:「#1 benchmark」超出证据所能支撑(自评 retrieval-only、口径不一、官网数字更激进且对不上仓库),引用需中立标注口径。
- 认知科学命名 vs 实现:「Ebbinghaus 遗忘曲线」是离散阶梯衰减的近似;「四层巩固」的语义/程序性升华强依赖 LLM、默认关闭——「免 API key」只覆盖捕获+检索。
- 强耦合 iii engine:唯一核心运行时依赖,脱离不可运行,绑小众 runtime 的单点风险。
- 大规模向量检索:O(n) 线性扫描,无 ANN,10 万级以上延迟恶化。
- 安全:远程模式 secret 明文 HTTP,依赖用户自套 TLS。
- 巴士因子 + 高速迭代代价:单人 84%、fix 占 56.5%、曾出 137GB 日志/OOM 事故(已修复并加守卫,但反映狂飙速度的稳定性代价)。
行动建议
- 如果你要用它:适合「重度跨 session/多项目使用 Claude Code/Cursor/Codex 等、想要零配置自动记忆」的个人开发者;
npx即用,本地 embed 免 API key 即可跑捕获+检索。想要「记忆升华/图谱」需配 LLP provider(会花 token)、AGENTMEMORY_INJECT_CONTEXT等强项要手动开。远程部署务必自套 TLS。要通用框架无关记忆用 mem0,只用 Claude 且求轻量用 claude-mem。 - 如果你要学它:直奔
src/state/hybrid-search.ts(RRF + 缺流归一)、src/hooks/(薄 hook fire-and-forget 自动捕获)、src/functions/consolidation-pipeline.ts(四层巩固 + 阶梯衰减)、src/providers/embedding/local.ts(本地嵌入)、iii-config.yaml(iii engine 集成 + 事故注释)。这五处是工程精华。 - 如果你要 fork / 借鉴它:RRF 混合检索、薄 hook 遥测、维度守卫、默认保守配置是可直接迁移的设计;但「绑 iii engine 换零配置」是高耦合赌注,不建议盲目照搬——可把存储层换成标准向量库 + ANN 以支撑规模。注意 Apache-2.0。
知识入口
| 资源 | 链接 |
|---|---|
| 官网 | https://agent-memory.dev |
| DeepWiki | https://deepwiki.com/rohitg00/agentmemory(已收录,含 Architecture/Memory Pipeline/Search/Multi-Agent 章节) |
| 底层引擎 | iii engine https://github.com/iii-hq/iii(三原语 worker/function/trigger 运行时,agentmemory 的地基) |
| benchmark | 仓库内 benchmark/LONGMEMEVAL.md / benchmark/COMPARISON.md(含作者自己的口径 caveat,评估前必读) |