LLMs-from-scratch 深度分析报告
一句话总结
用纯 PyTorch 从零实现一个 ChatGPT 级别的大语言模型——从 tokenizer 到预训练到指令微调到 DPO 对齐——配套 Manning 出版实体书,是 LLM 底层原理教育的事实标准。
值得关注的理由
- LLM 教育赛道的绝对王者:90K stars,是唯一同时满足「从零手写 + 完整流程 + 多架构覆盖 + 配套书籍 + 持续更新」五个条件的项目
- 活的 LLM 架构百科:2024 年出版的书在 2026 年仍持续追踪最新架构(Qwen3.5、Gemma 3、OLMo 3、DeltaNet),保持高度相关性
- 作者是 AI 教育领域最知名的人物之一:Sebastian Raschka,37K GitHub 粉丝,多本畅销书作者,PhD,从学术到工业的完整履历
项目展示
《Build a Large Language Model (From Scratch)》,Manning Publications 2024 年出版。
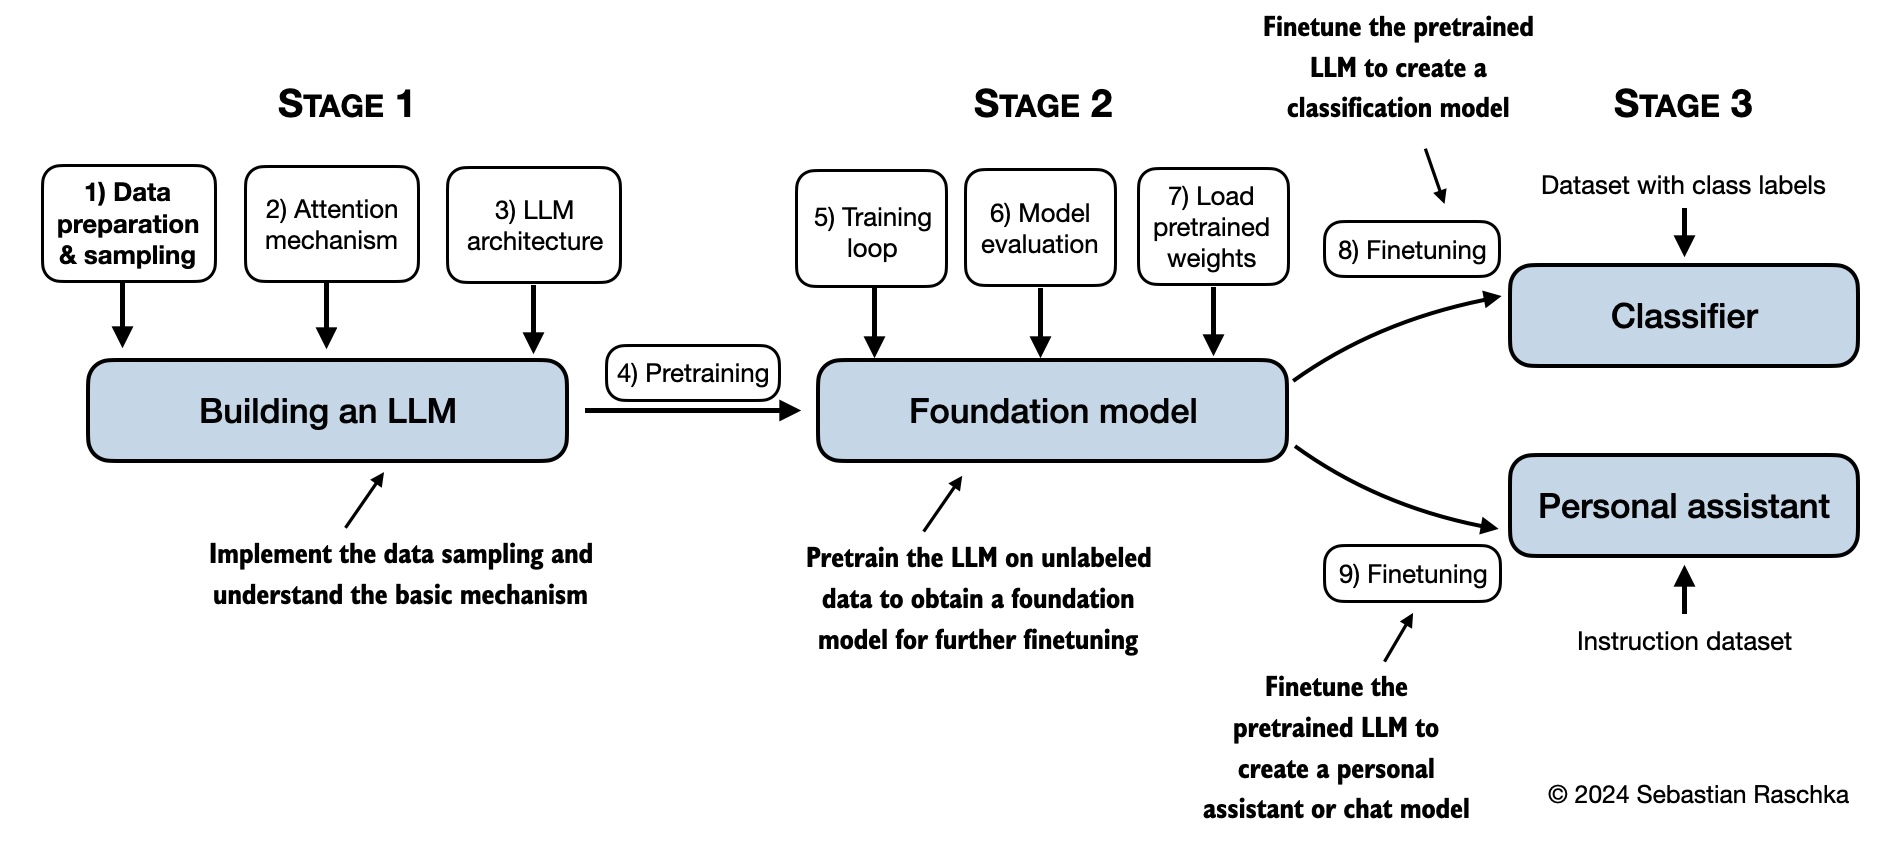
全书知识结构概览:从文本数据处理到注意力机制到模型实现到预训练到微调的完整路径。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/rasbt/LLMs-from-scratch |
| Star / Fork | 90,076 / 13,789 |
| 代码行数 | 68,892 行(Jupyter Notebook 38.6%, Python 28.8%, JSON 22.6%) |
| 项目年龄 | 33 个月(2023-07-23 创建) |
| 开发阶段 | 成熟维护(核心内容完整,持续扩展新架构) |
| 贡献模式 | 单人主导(Sebastian Raschka 贡献 83.7%) |
| 热度定位 | 超级热门(GitHub 全站前 0.01%,LLM 教育类头部) |
| 质量评级 | 代码「优秀」 文档「优秀」 测试「充分」 |
作者视角:为什么存在这个项目
创始人/作者背景
Sebastian Raschka 是机器学习领域最知名的教育者之一。PhD 学位,曾任威斯康星大学麦迪逊分校助理教授,后任 Lightning AI 研究工程师。著有《Python Machine Learning》《Machine Learning with PyTorch and Scikit-Learn》等多本畅销书,GitHub 37K 粉丝,12.5 年活跃历史,148 个公开仓库。
他的教学方法论核心是「从零实现」——通过编码每一个组件来理解复杂系统。这本 LLM 书籍是他将这一方法论应用于最热门 AI 领域的自然延伸。
问题判断
Raschka 作为 AI 教育者和研究者,长期观察到开发者对 LLM 的理解停留在 API 调用层面。市面上的资源要么太简略(只给代码不讲原理),要么太学术(只讲理论不写代码),缺少「代码即教材」的中间地带。
时机精准:2023 年下半年 ChatGPT 热潮使 LLM 教育需求爆发,而他在前两本书中积累的「从零实现」教学方法论可以直接迁移。
解法哲学
- 教育清晰度优先于生产优化:每个组件(GELU、LayerNorm、MultiHeadAttention)都手写而非调用内置函数,让读者看到数学公式如何变成代码
- 纯 PyTorch,零高层依赖:不依赖 HuggingFace Transformers 等库,确保每一行代码都可理解
- 小模型 + 小数据集:GPT-2 124M + 短篇小说数据集,确保在普通笔记本上可运行
- 增量变异教学法:从 GPT 出发,每次只替换 1-2 个组件(LayerNorm→RMSNorm、绝对位置编码→RoPE),渐进引导到 Llama、Qwen3、Gemma 等架构
战略意图
这本书是 Raschka 教育版图的核心支柱:
- 多层产品矩阵:实体书 → 代码仓库 → PyPI 包 → 17 小时视频课程 → 170 页测试题册
- 续作衔接:reasoning-from-scratch(4K stars)直接从本书的预训练模型出发,实现推理能力增强,形成「LLM 基础→推理增强」的完整学习路径
- 品牌延伸:通过持续高质量输出巩固 AI 教育领域意见领袖地位
核心价值提炼
创新之处
-
「增量变异」架构教学法(新颖度 4/5 | 实用性 5/5) 不是分别介绍 GPT、Llama、Qwen、Gemma,而是从一个基础 GPT 出发,每次只替换 1-2 个组件。ch05/07_gpt_to_llama 提供「GPT→Llama 2→Llama 3→Llama 3.2」的步进式 notebook,让读者精确感知每个变体的设计动机。
-
「活百科」持续扩展模式(新颖度 4/5 | 实用性 5/5) 书籍出版后仓库持续新增最新架构(Qwen3、Qwen3.5、Gemma 3、OLMo 3、Tiny Aya、Gated DeltaNet),每个都是自包含的 standalone notebook + 测试。一本 2024 年的书在 2026 年仍保持高度相关性。
-
三层代码抽象(Notebook→Script→Package)(新颖度 3/5 | 实用性 5/5) 同一逻辑提供三种形态:notebook(教学叙事)、独立脚本(直接执行)、PyPI 包模块(
from llms_from_scratch.ch04 import GPTModel)。满足学习、实验、集成三种需求。 -
Drop-in Replacement 设计(新颖度 3/5 | 实用性 5/5) Qwen3Model、Llama3Model 与 GPTModel 具有相同接口,可直接替换用于预训练和微调流程。
Llama3ModelFast是Llama3Model的 drop-in 替换,仅将手写注意力换成 FlashAttention。
可复用的模式与技巧
- 累积快照模式(
previous_chapters.py):每章包含前序章节代码汇总文件,保证独立可运行——适用于任何渐进式教程 - Bonus 扩展模式:核心内容固定,通过编号目录持续添加扩展,不修改主干——适用于书籍配套仓库长期维护
- 增量对比教学法:从基础实现出发,每次只改一个组件,用 diff 视角教架构差异
- 教学代码→PyPI 包升级路径:先在 notebook 中教学,再提取为模块化包配备单元测试
关键设计决策
- 手写所有底层组件:使用
nn.GELU()会隐藏实现细节,手写展示数学公式到代码的完整映射。牺牲代码简洁度,换来教学透明度 - 小模型策略:选择 GPT-2 124M 而非更大模型,确保在普通笔记本上可运行。牺牲真实世界规模感,换来可达性
- Notebook + Script 双轨制:维护成本高(同一逻辑三个版本),但满足学习/实验/集成三种场景
竞品格局与定位
竞品对比矩阵
| 维度 | LLMs-from-scratch | karpathy/nanoGPT | nn-zero-to-hero | ai-engineering-hub |
|---|---|---|---|---|
| Stars | 90K | ~38K | ~35K | 33K |
| 媒介 | 书+代码+视频 | 纯代码 | 视频为主 | 代码+文章 |
| 深度 | 7 章完整流程 | ~300 行核心代码 | 到 GPT 为止 | 偏应用层 |
| 架构覆盖 | GPT+Llama+Qwen3+Gemma3+OLMo3 | 仅 GPT-2 | 仅 GPT | RAG/Agent |
| 微调/对齐 | 分类+指令+DPO+LoRA | 无 | 无 | 部分 |
| 持续更新 | 追踪最新架构 | 相对静止 | 系列已完成 | 活跃 |
| 可运行门槛 | 笔记本即可 | 需要 GPU | 跟视频敲 | 视场景 |
差异化护城河
- 体系化护城河:教科书级的渐进叙事是极难复制的——需要深厚的教学经验和持续投入
- 多层产品矩阵:实体书+代码+视频+测试题册的组合形成互相引流的闭环
- 持续更新承诺:不断追踪最新架构使项目保持长期相关性
竞争风险
- 与 Karpathy 系列互补而非竞争:nanoGPT 是「给懂的人看的极简参考」,LLMs-from-scratch 是「带你从零成为懂的人的系统教程」
- 主要风险是作者个人精力:83.7% 的提交来自 Raschka 一人,项目质量高度依赖个人投入
生态定位
LLM 底层原理教育的「事实标准教科书」——在「从零实现 LLM 全流程 + 配套书籍」这一精确赛道中无同量级对手。
套利机会分析
- 信息差: 无——已是该领域最知名的教育资源。但「活百科」模式(持续追踪最新架构)的价值被低估,可作为公众号选题角度
- 技术借鉴: 「增量变异教学法」可迁移到任何对比多种方案的教学场景;「累积快照模式」可用于所有渐进式教程项目
- 生态位: 填补了 LLM 教育的「代码即教材」空白——太简略和太学术之间的中间地带
- 趋势判断: 持续强增长(8 个月从零到 10K,33 个月到 90K)。只要 LLM 技术持续演进,这个仓库就有持续扩展的空间
风险与不足
- 单人依赖风险:83.7% 的提交来自 Raschka,如果作者精力转移,项目质量可能下降
- 自定义许可证:非标准开源许可,商业使用前需仔细审查
- 高级主题覆盖较浅:top-p sampling、RLHF 等高级主题在书中覆盖有限(外部评论指出)
- 可复现性挑战:不同设备(特别是 Apple Silicon)上的运行结果可能与书中不一致
- 非生产级代码:手写底层组件的教学导向意味着代码不适合直接用于生产环境
行动建议
- 如果你要用它: 按照 ch01 的五步学习法(离线通读→上机编码→做练习→回顾→实际项目)系统学习。如果有 GPU,优先在 Linux 环境运行以获得最佳可复现性
- 如果你要学它: 重点关注 ch04(GPT 模型实现)和 ch05/07_gpt_to_llama(增量变异教学法的精华),以及 pkg/ 目录了解教学代码如何工程化
- 如果你要 fork 它: 可以考虑新增中文翻译版本(现有中文版社区规模小)、或扩展 RLHF/PPO 等高级对齐技术的从零实现
知识入口
| 资源 | 链接 |
|---|---|
| 官方文档 | README + 各章 README |
| DeepWiki | https://deepwiki.com/rasbt/LLMs-from-scratch |
| 关联论文 | 无 |
| 在线 Demo | 无(Jupyter Notebook 本地运行) |
| 配套书籍 | Build a Large Language Model (From Scratch) — Manning, 2024 |
| 配套视频 | Manning LiveVideo 课程(17 小时) |
| 续作 | reasoning-from-scratch(4K stars) |