不训练就超过 XGBoost:上 Nature 的表格基础模型
一句话总结
TabPFN 是表格数据的「基础模型」——它在约 1.3 亿个合成数据集上预训练好一个 Transformer,使用时把你的训练数据当「上下文」喂进去、一次前向传播(in-context learning)就直接出预测,不在你的数据上做任何梯度训练、不调参,几秒内追平甚至超过精调 4 小时的 XGBoost/CatBoost/AutoGluon。它的 v2 登上了《Nature》正刊,背后公司 Prior Labs 刚被 SAP 以超 10 亿欧元体量收购。
值得关注的理由
- 范式级创新:它颠覆了表格 ML 十年的「在你的数据上 train,再 predict」范式。
TabPFNClassifier.fit()体内没有 optimizer、没有 backward、没有 loss、没有训练循环——它只是把训练数据存为上下文;真正的「学习」发生在.predict()的单次前向传播里。这是把 LLM 的 in-context few-shot 搬到了结构化表格。 - 顶级权威 + 资本背书:TabPFN v2 是表格 ML 方法首次登上《Nature》正刊(2025-01);最新 TabPFN-3(2026-05)单次前向登顶 TabArena 基准、规模上限推到 100 万行;2026-05 SAP 宣布收购 Prior Labs、承诺 4 年投入超 10 亿欧元打造欧洲前沿 AI 实验室。
- 工程成熟度高:4 年迭代到包版本 v8,73 位贡献者,CI 完善,并且有少见的「黄金参考预测回归测试」——把模型在固定输入上的数值输出冻结成文件,防止重构悄悄改变浮点结果。这是从「研究代码」升级为「可信赖产品库」的标志。
项目展示
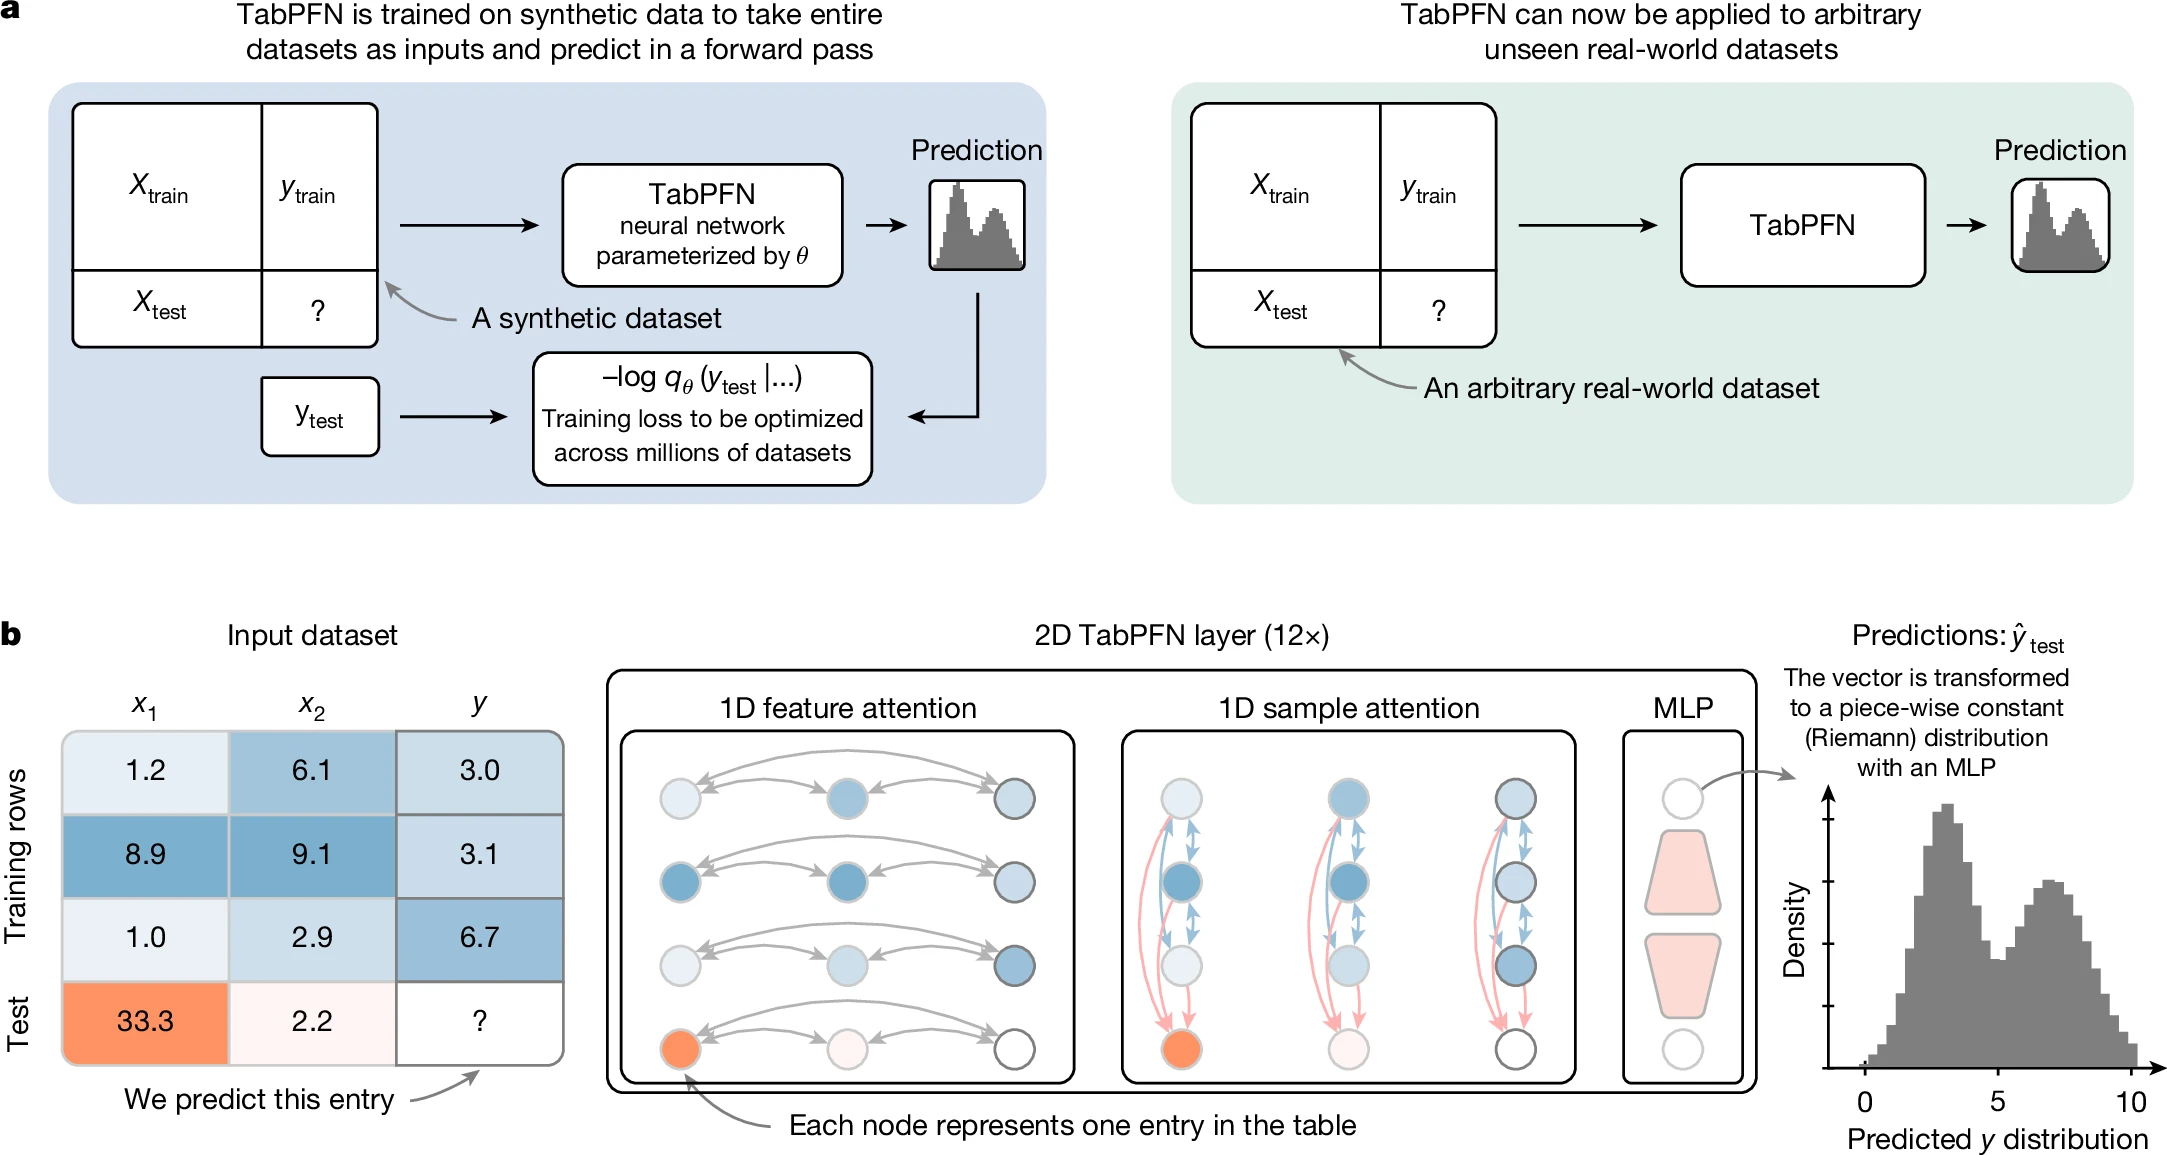
官方总览图(README 顶部展示图)。在线体验:ux.priorlabs.ai 无代码 Playground | 官方 Colab Demo。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/PriorLabs/TabPFN |
| Star / Fork | 7296 / 730(大众热门,近 18 天高速增长 196 star) |
| 代码行数 | 66K(业务 ≈45K Python;JSON 30% 是 tests/reference_predictions 黄金回归 fixture,非业务代码) |
| 项目年龄 | 48.5 个月(约 4 年,2022-05 起) |
| 开发阶段 | 密集开发(近 90 天 126 commit,4 年学术原型 → 公司化产品库) |
| 贡献模式 | 核心少数 + 社区(Benjamin Jaeger 工程 650 + Noah Hollmann 研究 525 + Léo Grinsztajn 191 + 70 人社区) |
| 热度定位 | 大众热门 + 范式开创者(表格基础模型 TFM 赛道的品类定义者) |
| 质量评级 | 代码[优·sklearn 兼容工程] 文档[优·Nature 论文 + 技术报告] 测试[强·黄金回归测试,10/15 热点目录为 tests/] |
| ⚠️ License | 代码 = Prior Labs License(Apache-2.0 + 署名条款,可商用);但默认模型权重 v2.5/2.6/3 为非商用许可,商用需走 Enterprise(见风险节) |
作者视角:为什么存在这个项目
创始人/作者背景
背后是 Prior Labs(priorlabs.ai,德国弗莱堡/柏林)——把 TabPFN 学术原型产品化的创业公司。创始团队顶级学术血统:Frank Hutter(弗莱堡大学/ELLIS,AutoML 与 TabPFN 学术带头人)、Noah Hollmann(TabPFN 论文一作,noahho,前 Google/BCG)。工程主力 Benjamin Jaeger(650 commit),研究侧还有 Léo Grinsztajn(LeoGrin,著名表格 ML 研究者,「为何树模型在表格数据上胜过深度学习」论文作者、TabPFN-2.5 一作)。2025-02 拿 Balderton 领投的 €9M pre-seed(投资人含 HuggingFace 的 Thomas Wolf、Black Forest Labs 的 Robin Rombach),2026-05 SAP 宣布收购。作者可信度极高。
问题判断
表格数据是企业里最普遍的数据形态(金融风控、医疗、工业、需求预测),但十年来这个领域的王者是梯度提升树(XGBoost/LightGBM/CatBoost)——它们强,但需要特征工程、需要调参、每个新数据集都要从头训练。团队看到的判断是:深度学习的「预训练 + 迁移」范式还没真正攻克表格数据,而如果能在海量合成数据集上预训练一个「学会了如何学习表格」的模型,就能让用户跳过训练与调参、开箱即得 SOTA。时机上,2025 年随着公司化与 Nature 背书、2026 年 v3 把规模上限从约 1 万样本推到 100 万行,这个范式才真正从「小数据玩具」走向「生产可用」。
解法哲学
- 明确选择 in-context learning 取代 train-then-predict:
.fit()不训练、.predict()一次前向出结果。 - 明确选择「Simplification-first」:消灭预处理瓶颈、跳过手工调参,README 甚至明确「不要做缩放/独热编码」,喂原始数据即得预测。
- 明确选择伪装成 sklearn estimator:
TabPFNClassifier(ClassifierMixin, BaseEstimator)完整实现fit/predict/predict_proba,无缝接入 sklearn 生态——把范式创新藏在熟悉的 API 后面,降低采用门槛。 - 明确选择 open-weights 引流 + Enterprise 变现:代码与部分权重开放,默认强权重非商用,企业版(蒸馏低延迟模型 + 多云部署)收费。
战略意图
TabPFN 是 Prior Labs 的旗舰,周边卫星仓库(tabpfn-extensions 可解释/异常检测、tabpfn-client 云 API、tabpfn-time-series 时序、R 绑定、无代码 UX)环绕它构建生态。商业模式是「开放权重建立学术权威与社区 → Enterprise Edition(蒸馏成紧凑模型做实时推理 + SageMaker/Databricks/Azure 多云部署)变现」。SAP 的收购把它推向「欧洲前沿 AI 实验室」的国家级叙事。
核心价值提炼
创新之处
- PFN(Prior-data Fitted Networks)+ in-context 表格预测(范式核心):在约 1.3 亿合成表格数据集上预训练,让模型「学会如何从上下文学习」,推理时单次前向即出预测,零训练零调参。
- 「把基础模型包装成 sklearn estimator」的五层工程:sklearn 接口层(classifier/regressor)+ 架构层(v2.5/v2.6/v3 多代 Transformer 共存)+ 预处理/集成层 + 推理引擎 + 权重加载(HF Hub)。范式创新藏在熟悉 API 后。
- 预处理集成提升鲁棒性:对多种特征变换/排列做集成(
preprocessing/ensemble.py),原生处理缺失值/离群点/类别特征,是 TabPFN 精度的关键工程手段。 - 黄金参考预测回归测试:把数值输出冻结成 fixture 纳入 CI,守住「重构不改变模型数值」——ML 库特有的、从研究代码到产品库的工程跃迁。
可复用的模式与技巧
- 把新范式藏在熟悉 API 后:用 sklearn
fit/predict契约包装一个完全不同的底层机制,最大化降低采用门槛——任何想推广新范式的库都可借鉴。 - 黄金数值回归测试:对任何数值敏感的库(ML、科学计算),把输出冻结成参考 fixture 防漂移。
- 多版本模型权重共存切换:同一库内并存多代架构(
architectures/tabpfn_v*.py)+ 从 HF Hub 按需加载权重,区分「包版本」与「模型架构版本」两个维度。 - 合成数据预训练:用程序化生成的海量合成任务训练「元学习」能力,绕开真实标注数据稀缺。
关键设计决策
.fit()故意不训练:把训练数据存为上下文、算好 ensemble 配置,真正计算在.predict()的前向传播——这是 in-context 范式的工程落地,也是它「秒级、无需 GPU 训练」易用性的命门。- 默认权重非商用的授权设计:代码宽松(Apache+条款)、强权重收紧(非商用)——用开放建立社区与权威,用权重许可保留商业护城河。这是「开放权重」公司的典型博弈。
- 版本辨析:包已到 v8(发布成熟度),源码里
tabpfn_v3.py是模型架构版本——两者独立,一个 v8 包内可装载多代权重。
竞品格局与定位
竞品对比矩阵
| 维度 | TabPFN | XGBoost/LightGBM/CatBoost | AutoGluon | TabICL/TabDPT/CARTE 等 TFM |
|---|---|---|---|---|
| 范式 | 预训练 + in-context | 每数据集从头训练 | AutoML 集成调优 | 同类预训练 TFM |
| 训练/调参 | 零训练零调参 | 需调参/特征工程 | 自动但耗时数小时 | 零/少训练 |
| 速度 | 秒级前向 | 训练分钟~小时 | 精调数小时 | 不一 |
| 数据规模 | v3 上限 100 万行 | 任意规模 | 任意规模 | 各有上限 |
| 成熟度/背书 | Nature + SAP + v8 | 十年生态、最成熟 | 成熟 AutoML | 多为研究原型 |
| 商用 | 默认权重非商用 | 完全自由 | Apache 自由 | 不一 |
差异化护城河
护城河 =「预训练 + in-context 的零训练零调参 + 中小数据 SOTA + Nature 学术权威 + SAP 资本 + 成熟工程与生态」。在「表格基础模型(TFM)」这一新赛道,TabPFN 是事实标杆与品类定义者;对传统 GBDT 则是正面挑战者。默认权重非商用既是商业护城河也是争议点。
竞争风险
- GBDT 在大规模/任意规模上仍不可替代:TabPFN 受 in-context 上下文长度制约,独立学术研究(arXiv 2502.17361)指出 v2 在高维、多类别、大规模数据集上吃力(v2 约 1 万样本上限,v3 推到 100 万但仍有边界)。
- 新 TFM 追兵涌现:TabICL(可扩到约 50 万样本、更开放)、TabDPT、CARTE、LimiX、TabSTAR(带文本字段)等正在形成赛道,精度领先窗口随版本博弈。
- 授权门槛:默认权重非商用,限制了「直接拿来商用」的场景,可能把对成本敏感的用户推回完全自由的 XGBoost。
生态定位
它是「非 LLM 的基础模型」赛道(表格基础模型 TFM)的事实标杆与品类定义者,正面挑战 GBDT 在中小数据上的统治,并以 Nature + SAP 把「表格 AI」推上主流视野。
套利机会分析
- 信息差:不算被低估,而是「权威(Nature)+ 资本(SAP 10 亿欧元)+ 新版本(v3)」三重共振的爆发窗口——做内容是顶级热点选题,且范式新颖、值得深度科普。
- 技术借鉴:「新范式藏在 sklearn API 后」「黄金数值回归测试」「合成数据预训练元学习」「多代权重共存」四套模式可迁移。
- 生态位:有中小型表格数据(<100 万行)、想跳过调参快速拿到强 baseline 的团队,这是几秒出结果的利器(注意权重商用授权);想理解「非 LLM 基础模型怎么落地」的人,这是最佳样本。
- 趋势判断:表格基础模型是 2025-2026 明确升温的新赛道,TabPFN 凭权威 + 资本 + 工程暂居头部;但 GBDT 的规模优势与新 TFM 追兵是需观察的变量。
风险与不足
- ⚠️ 默认权重非商用(最需注意):代码是 Prior Labs License(Apache+署名,可商用),但默认即用的 TabPFN-2.5/2.6/3 模型权重是非商用许可,托管在 HF
Prior-Labs/tabpfn_3。商用需联系 sales@priorlabs.ai 走 Enterprise——切勿当作「开源可商用」直接上生产。 - 数据规模与维度边界:受 in-context 上下文制约,超大规模、超高维、多类别场景仍是短板,独立学术研究已实证 v2 的边界(v3 改善但未消除)。
- 黑箱与可解释性:单次前向的基础模型不如 GBDT 的特征重要性/SHAP 工具链成熟(需配 tabpfn-extensions)。
- 依赖预训练权重 + GPU:默认从 HF Hub 下载 checkpoint,推理建议 GPU;离线/受限环境需额外配置。
- 被收购后的不确定性:SAP 收购后开放策略是否延续、社区版能力是否收紧,需观察。
行动建议
- 如果你要用它:你有中小型表格数据(分类/回归,<100 万行)、想跳过特征工程与调参、几秒拿到强 baseline——它是利器(
pip install tabpfn后.fit().predict()即用)。但商用前务必确认权重许可(默认非商用,商用走 Enterprise)。要任意规模、完全自由授权、最成熟生态,仍用 XGBoost/LightGBM/CatBoost。 - 如果你要学它:重点读
src/tabpfn/classifier.py(看fit()如何「不训练」只存上下文)、src/tabpfn/inference.py(单次前向出预测)、src/tabpfn/architectures/tabpfn_v3.py(Transformer 架构)、src/tabpfn/preprocessing/ensemble.py(预处理集成),以及tests/reference_predictions(黄金回归测试范式)。配合 Nature 论文理解 PFN 原理。 - 如果你要 fork/扩展它:最有价值的方向是基于
tabpfn-extensions做领域适配(可解释、异常检测、合成数据)、探索更大规模/更高维的扩展,或在权限允许下做蒸馏低延迟推理。注意默认权重许可对再分发的约束。