GitHub推荐:NVIDIA Model-Optimizer: NVFP4 + QAD 把 550B 模型压缩出 5.9× decode
一句话总结
NVIDIA 官方维护的一站式模型压缩工具旗舰,覆盖 PTQ/QAT/QAD/剪枝/NAS/稀疏化/推测解码 6 大类优化技术,输出统一 HuggingFace checkpoint,可一键分发到 TensorRT-LLM/TensorRT/vLLM/SGLang——核心杀手锏是 NVFP4 块级 Local-Hessian 校准 + QAD(量化感知蒸馏),前者把 4-bit 的精度损耗砍掉近一半,后者能在 NVFP4 下让 550B 模型恢复回 BF16 级精度。
值得关注的理由
- NVFP4 是独占赛道:Blackwell 才有 FP4 tensor core,而 NVFP4 的”两段式 scale”(E2M1 data + E4M3 block scale)目前没有任何开源框架原生支持——这是 NVIDIA 自家硬件配套自家软件栈的闭环。
- AutoQuantize 用 ILP 重新定义混合精度搜索:把”每层选 NVFP4/FP8/FP16”建模成整数线性规划,52× 快于 KL 散度搜索,Aumann-Shapley attribution 让”敏感度打分”有理论完整性指标——比手动调精度方案靠工程师经验猜靠谱得多。
- QAD 解决”压到 4-bit 一定掉精度”的常识陷阱:在 NVFP4 极端低精度下用 KD loss 反向恢复精度,Nemotron 3 Ultra 550B 已经测出 BF16 级效果 + 5.9× decode 提升——大厂”工程化论文级算法”的标准做法。
项目展示
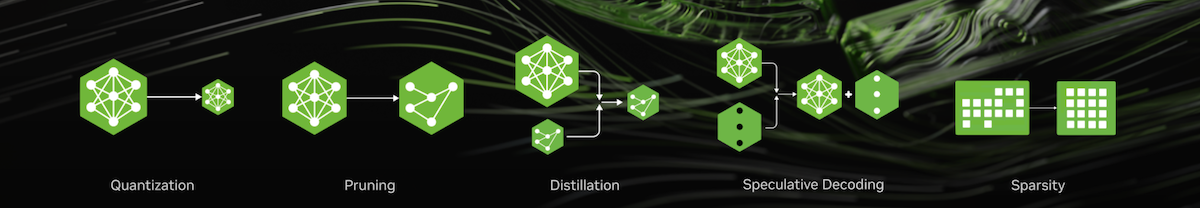 项目官方 banner——NVIDIA AI Enterprise 体系下”压缩中台”的视觉锚点
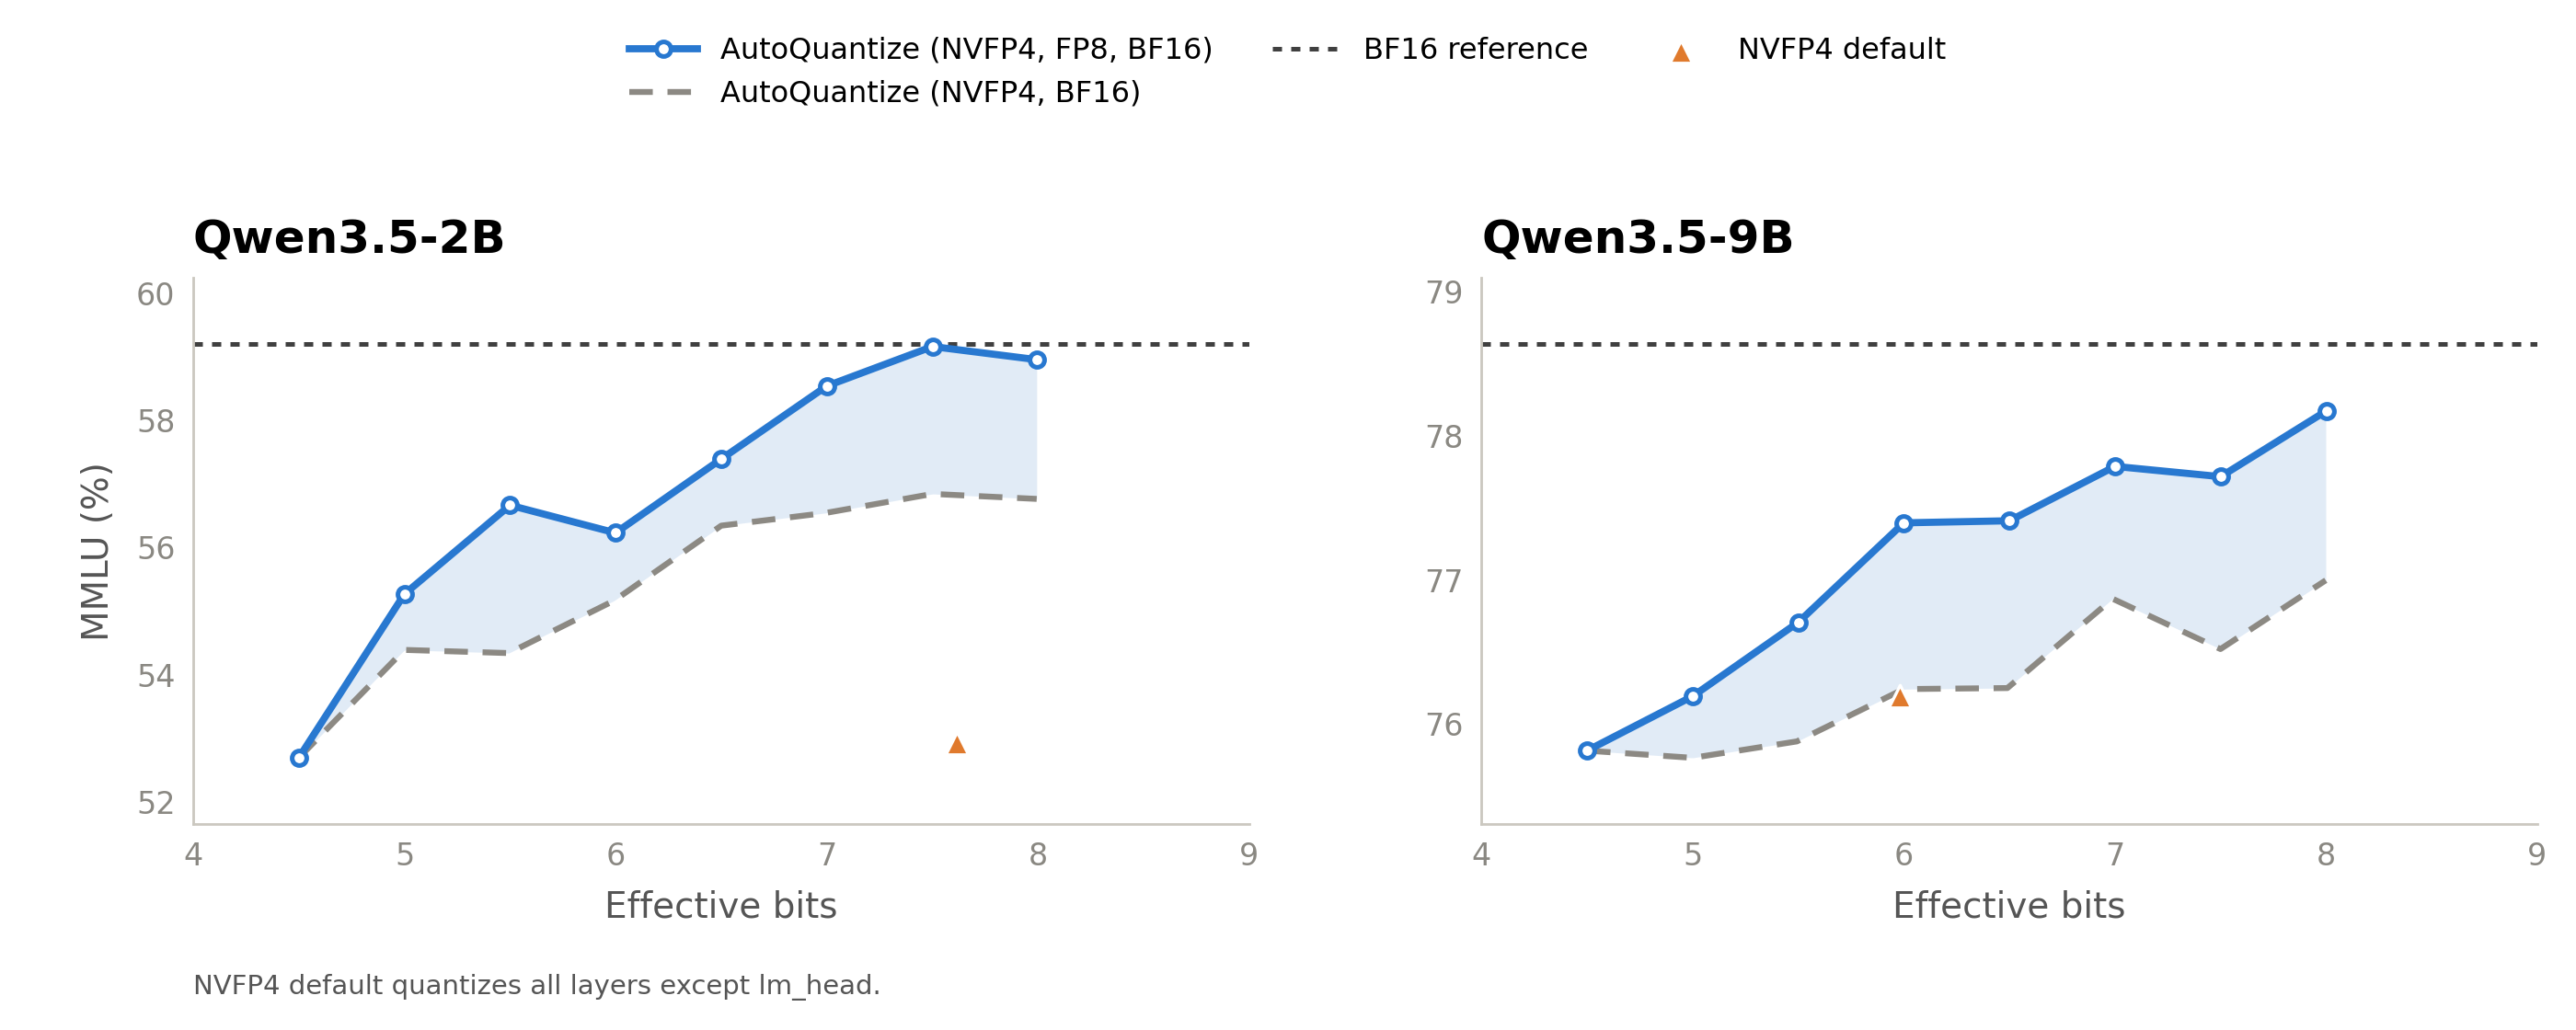 AutoQuantize 在 Qwen3.5-2B/9B 上用 ILP 自动选精度的帕累托前沿——比手工指定精度的 Pareto 优势可视化
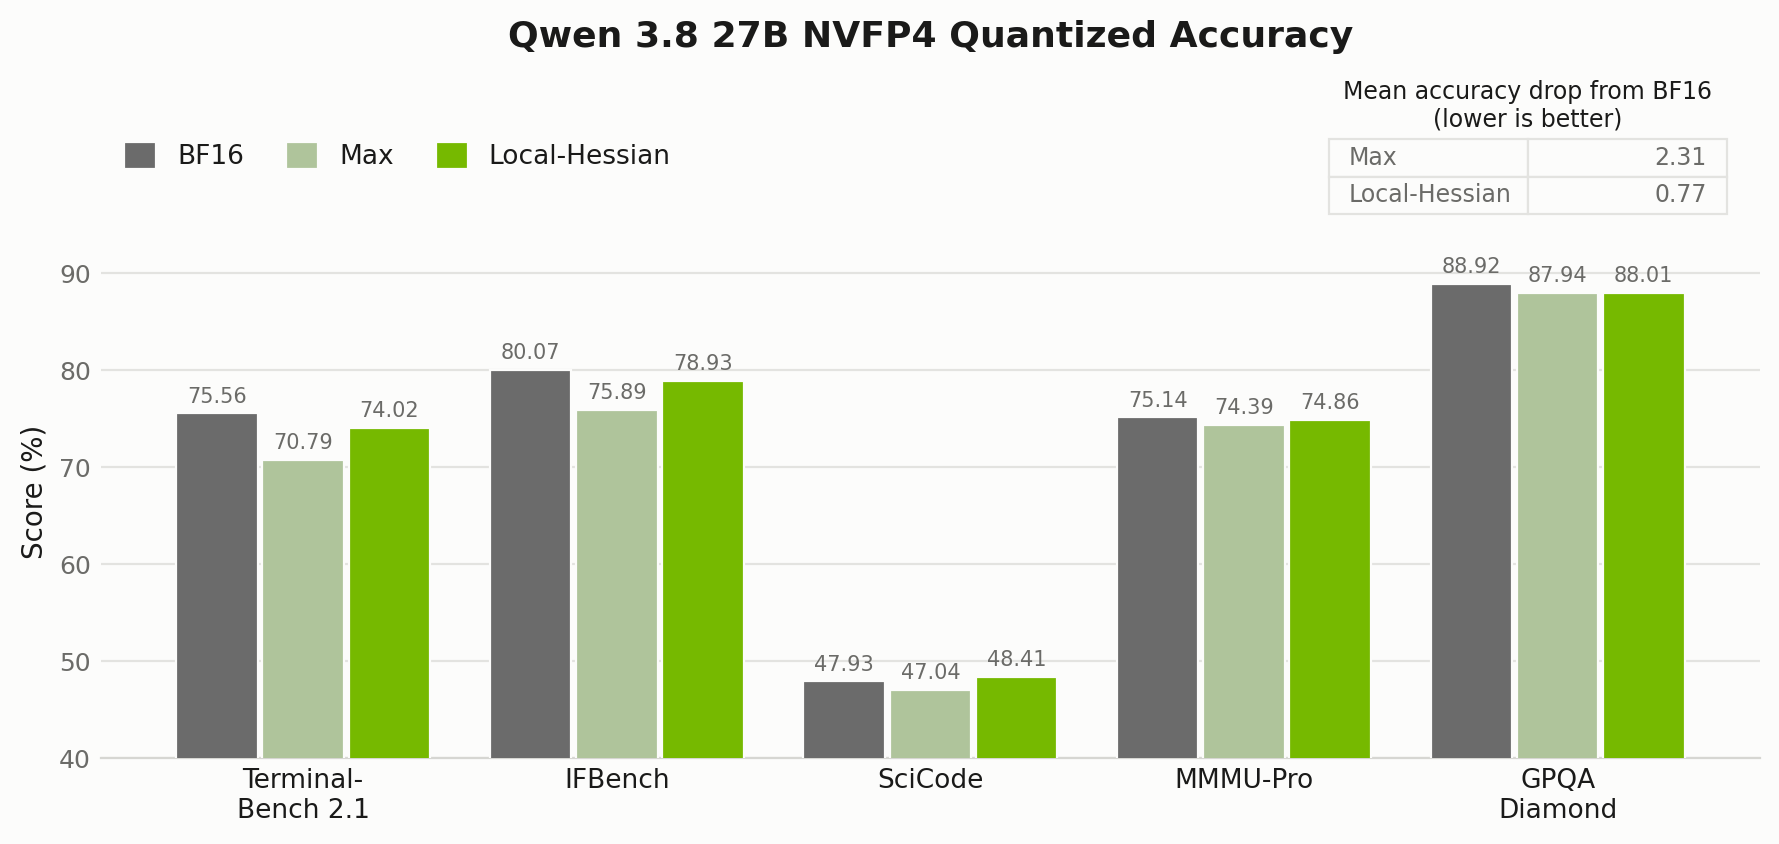 Local-Hessian 在 Qwen3.8-27B 上把 NVFP4 W4A4 的精度损耗压到 3.10,对比 MSE/Four-over-six 等基线(数据来自官方 announcements/local-hessian 页面)
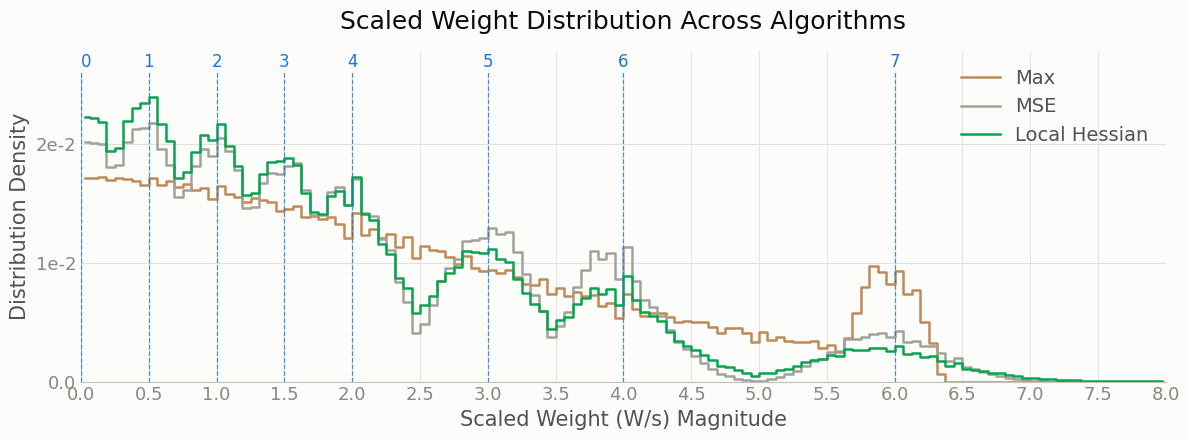 Local-Hessian 与 max/MSE 的 weight distribution 对比——直观看到 Hessian-aware 校准为何在 FP4 块级 scale 上优于纯统计方法
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/nvidia/model-optimizer |
| Star / Fork / Watcher | 4,740 / 667 / 38 |
| 代码行数 | 307,724 行(Python 91.6% / YAML 4.1% / ReST 2.2% / Shell 1.4% / C++ 0.2%) |
| 项目年龄 | ~29 个月(GitHub created_at: 2024-04-23;2025-01-28 正式开源;2025-12 改名 Model-Optimizer) |
| 开发阶段 | 密集开发(近 30 天 100 commit,频次约每 2-3 周一版) |
| 贡献模式 | 公司员工为主 + 社区协作(NVIDIA 官方组织账号;30 位贡献者,Top1 占 25.5%,Top10 平均 ~10%) |
| 热度定位 | 中等热度(对 NVIDIA 公司项目而言属”上升期”,未到 TensorRT/Triton 级别) |
| 质量评级 | 代码[优秀] / 文档[优秀] / 测试[充分] / CI/CD[完善](14 个 workflow,441 个 test 文件,Apache-2.0 + per-file header 100% 覆盖) |
作者视角:为什么存在这个项目
创始人/作者背景
维护方是 NVIDIA Corporation 官方组织账号(非个人开发者)——14.4 年的 GitHub 账号、30,474 粉丝、808 个公开仓库。account_age 上比绝大多数 AI 框架(PyTorch、TensorRT)都老。
这意味着三层属性叠加:
- NVIDIA AI Enterprise 软件栈的实际组件:ModelOpt 是 NeMo + Megatron-LM + TRT-LLM + NIM 全家桶的「压缩中台」。每个 NVIDIA 自家模型发布(Nemotron 1/2/3、DeepSeek-R1-FP4 等)都必须过 ModelOpt 这把刀。
- dogfooding 驱动:Nemotron 3 Super/Ultra 量产过程中,“剪枝+蒸馏+NVFP4+推测解码”组合没人能跑通——必须造工具。Issue #1308(Kimi-K2.6 NVFP4 + EAGLE3 离线推测解码)显示 NVIDIA 内部产品线直接驱动 roadmap。
- 开放而非封闭:输入侧收 HF/PyTorch/ONNX/Megatron-Core,输出侧接 TRT-LLM/TRT/vLLM/SGLang,中间自家内核——不绑任何单一推理后端。这是 2025-12 改名 + 从闭源 TensorRT Model Optimizer 转开源时的战略性选择。
问题判断
NVIDIA 团队看到了四个具体可量化的问题:
- 跨技术不互通:
llm-compressor只做 PTQ、AutoGPTQ/AWQ只做单算法、FastGen只做扩散。模型一旦需要”剪枝+蒸馏+量化+推测解码”组合,只能在 5 个工具间搬运 state dict。 - 跨硬件不对齐:INT8/INT4 在 ONNX Runtime、TensorRT、vLLM 上数值不一致(Issue #869)。Llama-3.1-405B 用同一份 scale 在 TRT 和 vLLM 输出 logits 差到 1e-2 级别——量化产物的可分发性是开放问题。
- NVFP4 等新硬件格式生态空白:Blackwell 才有 FP4 tensor core,没有任何已有框架原生支持 NVFP4 的”两段式 scale”(E2M1 data + E4M3 block scale)。
- Megatron-Core 训练栈与 HF 推理栈 checkpoint 不能互转:Nemotron 团队必须自己写 PTQ 脚本(Issue #1308),无法复用 HF QuantConfig 的 export pipeline。
时机选择的关键:Blackwell 硬件上市 + Nemotron 3 / DeepSeek-R1 等千万级用户模型集中在 2025-2026 上线,对 NVFP4 + QAD 的需求是产业级而非学术级——所以这个工具必须在 2025 年内成熟到能扛生产流量。
解法哲学
- 大而全,但插件化:覆盖 6 类优化技术,但通过
ModeDescriptor抽象 + 9 个独立 sub-package(quantization/distill/nas/prune/sparsity/speculative/peft/opt/utils)实现内部分层,避免用户感知到「这是大而全」。mto.convert(model, mode=[...])是单入口门面。 - 算法工程化:不只把论文 GPTQ/AWQ/SmoothQuant 复现,而是把它们包装成可序列化、可回放的
ModeDescriptor,并把论文里没说清的”哪些层要 freeze、scale 共享粒度、forward pre-hook 时机”全部用 YAML recipe 固化。 - 明确不做什么:不做模型训练(依赖 Megatron/HF Trainer);不做推理引擎(只 export,不 run)。这是边界清晰的工具定位。
战略意图
- 核心产品而非基础设施:ModelOpt 是 NVIDIA AI Enterprise 软件栈的”压缩中台”。
- 商业化意图明确:开源版本只到”checkpoint + Python API”;企业级 NIM 部署、性能 SLA、TensorRT-LLM 集成都在 NVIDIA AI Enterprise 商业产品线。这是典型的 open core——开源拉用户、商业卖部署。
- 路线图管理产品化:README 顶部”Roadmap”链接到 issue #1699(issue 跟踪而非文档页面),公告博客矩阵 + 客户案例 + HuggingFace 上预量化 checkpoint 矩阵(Llama-3.1-FP8、DeepSeek-R1-FP4、Qwen3.6-NVFP4)——有产品经理在管的开源项目,不是单纯技术输出。
核心价值提炼
创新之处
-
Aumann-Shapley 路径积分式混合精度 attribution(算法创新)
- 在
unquantized→quantized路径的多个中点测量 KL 散度,对每个 (group, format) 计算<dL/dy, Q(y) - y>,最后拟合到damage = c * (1 - exp(-sum(b)))coverage form。completeness指标衡量 attribution 还原实测 damage 的比例。 - 新颖度: 5/5 | 实用性: 4/5 | 可迁移性: 3/5
- 在
-
NVFP4 Local-Hessian 块级 scale 优化(算法+硬件栈创新)
- 每个 weight block 用 activation-derived
H = Σ XᵀX加权搜索 FP8 scale 候选,从 126 个 E4M3 值里挑最优;Qwen3.5-9B 上 W4A4 精度损耗从 5.10 降到 3.10。 - 新颖度: 4/5 | 实用性: 5/5 | 可迁移性: 3/5
- 每个 weight block 用 activation-derived
-
Triton fused 126-candidate scale sweep kernel(工程实现创新)
- 把 NVFP4 calibration 的 126 步 Python 循环压成单个 Triton kernel,编译期
tl.static_range展开候选,per-block argmin 在寄存器内完成——比传统”Python 循环 + 126 次 kernel launch”的微秒级开销直接抹平。 - 新颖度: 3/5 | 实用性: 5/5 | 可迁移性: 5/5
- 把 NVFP4 calibration 的 126 步 Python 循环压成单个 Triton kernel,编译期
-
__class__in-place patching 实现对 monkey-patched 模型的兼容(接口设计创新)- 不创建包装器,直接
module.__class__ = DynamicModule,让模块同时是原类和动态类的实例,配合_forward_pre_dm在 export 时还原。专治 HuggingFace/accelerate 到处改 module 类的”框架邪招”。 - 新颖度: 3/5 | 实用性: 5/5 | 可迁移性: 2/5
- 不创建包装器,直接
-
QAD(Quantization-Aware Distillation)训练范式(算法工程化创新)
- 量化模型 + teacher 共同 forward,KD loss 让 student (quantized) 模仿 teacher (BF16) 的输出和中间激活,绕过 QAT 的”假量化噪声”问题。Nemotron 3 Ultra 550B NVFP4 达到 BF16 精度 + 5.9× decode 提升。
- 新颖度: 4/5 | 实用性: 5/5 | 可迁移性: 3/5
-
PULP-based 自动混合精度求解器(ILP)(数学优化创新)
- 把”每层选哪个量化格式”建模成 0/1 ILP:
Σ z_li = 1(one-hot)+Σ cost_li z_li ≤ budget(effective-bits 约束),CBC 求解器秒级出全局最优。比 KL 散度贪心搜索快 52 倍。 - 新颖度: 4/5 | 实用性: 5/5 | 可迁移性: 5/5
- 把”每层选哪个量化格式”建模成 0/1 ILP:
可复用的模式与技巧
-
Mode Descriptor 模式:算法插件化 + 顺序约束(next_modes / next_prohibited_modes)+ 可序列化 + checkpoint 内嵌算法身份。任何”多算法可组合”框架(编译器优化管线、数据库 migration 链路、CI/CD stage chain)都可套用。
-
LPS Wrapper on PuLP:把”分层离散决策 + 总预算”建模成 ILP。AutoML、硬件分配、网络路由、NAS 离散配置搜索都适用——表达力远超贪心。
-
QTensor 子类化:把量化元数据封装进
torch.Tensor子类而非外部 dict。__tensor_flatten__/__tensor_unflatten__让原生torch.Tensor算子分发照常工作。适用任何”张量携带元数据”的场景(稀疏化张量、MoE 路由权重、混合精度训练时同一 buffer 多版本)。 -
YAML Recipe +
$import+ Pydantic schema:用 schema-tagged YAML + 模块化导入表达配置组合空间 + dotlist CLI override。# modelopt-schema:注释指定 schema class,类似 K8s/Argo/Terraform 的”配置即代码”思路。 -
Triton autotune + static_range:把候选集合在编译期展开,省掉 Python 循环 + 多次 kernel launch。任何”小离散搜索 + tensor core 友好”的 kernel 都可套。
-
Per-block lazy accumulator:
_LocalHessianAccumulator只在模块真的用上时才分配 buffer,配合 never-routed MoE expert 零开销。MoE 训练、稀疏模型、按 condition 触发的统计量都适用。
关键设计决策
-
决策:
ModeDescriptor+_ModeRegistryCls作为算法插件化的统一抽象- 问题: PTQ/AWQ/GPTQ/QAT/QAD/NAS/剪枝/导出全是不同算法,但都需要
convert(model, config) → 修改模型 + 返回 metadata,且能”序列化成 state_dict 重新载入” - 方案: 每个算法一个
@DistillModeRegistry.register_mode类描述符;next_modes/next_prohibited_modes/export_mode/is_export_mode显式声明依赖图;modelopt_state序列化所有 mode - Trade-off: 学习曲线较陡(用户需理解”mode”概念),但换来”任意算法栈可声明式组合 + checkpoint 内嵌算法身份”
- 可迁移性: 高
- 问题: PTQ/AWQ/GPTQ/QAT/QAD/NAS/剪枝/导出全是不同算法,但都需要
-
决策:
DynamicModule用__class__替换做原地类升级而非装饰器包裹- 问题: HF transformers 用
model.half()、accelerate 用bind_forward_method直接修改 module 类;标准包装器模式会破坏这些 monkey patch - 方案:
module.__class__ = cls,让模块在运行时同时是原类(LlamaForCausalLM)和动态类(DistillationModel)的实例 - Trade-off: 比
__getattr__代理快(方法查找走 MRO),但语义脆弱(任何对type(module)的检查都被绕过) - 可迁移性: 中(仅在”框架到处 monkey patch”的场景下必要)
- 问题: HF transformers 用
-
决策: 自定义 QTensor 子类(qtensor/)取代”量化参数和权重放 dict 里”
- 问题: 8B+ 模型量化参数(scale、zero_point、block_size、format 标记)散落在多个 buffer 里,state_dict 加载/对齐/导出极容易出错
- 方案:
NVFP4QTensor/MXFP8QTensor/QTensorWrapper继承torch.Tensor,重载__tensor_flatten__/__tensor_unflatten__ - Trade-off: 享受原生
torch.Tensor算子分发,但失去”dtype 明确”的语义——必须在每个算子里显式判断.format字段 - 可迁移性: 高
竞品格局与定位
竞品对比矩阵
| 维度 | NVIDIA Model-Optimizer | llm-compressor | AutoGPTQ/AutoAWQ | llama.cpp/GGUF | ONNX Runtime |
|---|---|---|---|---|---|
| 覆盖技术广度 | 6 大类(PTQ/QAT/QAD/剪枝/NAS/稀疏化/推测解码) | PTQ/QAT 为主 | 单算法(GPTQ / AWQ) | 量化 + 推理一体 | INT8/INT4 PTQ |
| NVFP4 / Blackwell | 原生支持 + Local-Hessian 优化 | 无 | 无 | 无 | 无(仅 ONNX 基本算子) |
| QAD 恢复精度 | 原生(Nemotron 3 Ultra 已验证) | 无 | 无 | 无 | 无 |
| 跨引擎部署输出 | HF/TRT/TRT-LLM/vLLM/SGLang | vLLM/TRT-LLM(偏 PyTorch 生态) | HF Transformers | GGUF(自家) | ONNX(跨厂商) |
| 跨硬件支持 | 仅 NVIDIA GPU | NVIDIA + Intel + CPU | 仅 NVIDIA GPU | CPU/Apple/Edge | 跨 CPU/GPU/Edge |
| Megatron 训练栈集成 | 原生(mcore_minitron) | 无 | 无 | 无 | 无 |
| Stars | 4.7k | ~2k+ | 4k / 2k | 80k+ | 16k+ |
| 维护模式 | NVIDIA 官方组织 | Red Hat | 社区 | 社区 | 社区 + 微软 |
差异化护城河
- 生态护城河(最深):NVIDIA 自家 Nemotron/Megatron/TRT-LLM/NIM 全栈唯一接口。从训练到部署的模型”必须过 ModelOpt 这把刀”——类似 CUDA 在 NVIDIA GPU 计算中的位置,不是用户主动选,是”用了 NVIDIA AI 就被自动用”。
- 硬件格式护城河:NVFP4 是 NVIDIA 独占,竞争对手必须等开放标准(比如 MXFP 在 OCP 标准化后才能动手)。这是 6-12 个月的时间差。
- 信任护城河:Nemotron 3 Ultra 550B 是公开可验证的 reference——“NVIDIA 自己都在用”比单纯 benchmark 数据更具说服力。
- 工程化深度:6 类优化组合能力 + Mode Descriptor 抽象,让”剪枝+蒸馏+量化+推测解码”组合成为产品级能力而非 hack。
竞争风险
- 最可能被 vLLM 生态替代:
llm-compressor + vLLM已形成”开源替代”叙事。如果 vLLM 抢先把 NVFP4 集成做深,ModelOpt 在”非 NVIDIA 部署”场景下会被边缘化。 - SGLang 生态变量:推理引擎新兴搅局者,技术派支持者增速快,如果其量化 pipeline 集成度追上来会削弱 ModelOpt 的”出口”垄断。
- 直接单点算法库的”够用就行”风险:对仅需 GPTQ/AWQ 而不需要 QAD/NAS/剪枝的开发者,AutoGPTQ 一行 pip install 的便利度仍是竞争壁垒。
生态定位
NVIDIA AI 软件栈的”压缩中台”——所有从训练到部署的模型必须经过。在生态层级里:
- 上游:
Megatron-Core/NeMo/Hugging Face Transformers(模型来源) - 本项目:
Model-Optimizer(压缩这一刀) - 下游:
TensorRT-LLM/TensorRT/vLLM/SGLang(推理分发)
类似 CUDA 在 NVIDIA GPU 计算中的位置——不是用户主动选的,是在 NVIDIA AI 栈里”被自动用上”的。
套利机会分析
- 信息差: NVIDIA 自家模型(Nemotron 3 Ultra 550B、DeepSeek-R1-FP4)预量化 checkpoint 矩阵已发布到 HuggingFace,但绝大多数中文开发者社区对”Model-Optimizer 已经替代 TensorRT-Model-Optimizer”的认知更新滞后——很多人还在用老文档,存在认知套利窗口(6-12 个月)。
- 技术借鉴: ① PuLP ILP 包装模式:AutoQuantize 的”分层离散决策 + 总预算”求解器可平移到 NAS、AutoML、量化调度等场景;② Mode Descriptor + next_modes 显式顺序约束:通用”多算法可组合管道”抽象;③ Local-Hessian 块级校准:hessian-aware quantization 的具体落地路径。
- 生态位: 填补了”跨技术压缩工具栈”的空白(PTQ+剪枝+蒸馏+NAS+推测解码组合)、“跨引擎 checkpoint 一致性”工具的空白、“NVFP4 块级优化”的空白。
- 趋势判断: 符合”模型压缩 → 部署”工程化的主流趋势;Blackwell 上量期正好是 NVFP4 普及期,先发优势显著;比竞品有 6-12 个月领先——但要注意 vLLM 生态圈和 ACME 标准的 NVFP4 规范(如 OCP MX 后续扩展)是否追赶。
风险与不足
- 跨引擎数值一致性是开放问题:Issue #869 显示同一份 scale 在 TRT 和 vLLM 输出 logits 差 1e-2——这对生产部署是隐患,需要用户自己做精度对齐测试。
- quantization ≠ acceleration 的常识陷阱:Issue #80 揭露 INT8 quantized model 在特定 GPU 上反而比 FP16 慢(Snack on AI 指出 INT4 AWQ 在 Llama-3.1-8B batch=64 反而比 BF16 慢 17%)。Local-Hessian 的 sensitive 搜索用 effective-bits 当成本代理 ≠ 实测 latency,下游部署仍需做性能回归。
- 生态绑定极深:仅 NVIDIA GPU。AMD/Intel/Apple 用户完全无法受益——商业上是合理选择,技术上是受众限制。
- window of commits 偏短:项目真实年龄 29 个月,但当前采集窗口仅覆盖最近 30 天(commit 数 100),无法展现 2024-2025 的完整演化轨迹。若要严谨建模需放宽
--max-commits重跑。 - Docker 依赖:必须配合
nvcr.io/nvidia容器才能完整用——AutoGPTQpip install一行的便利度优势仍在,对研究者入门门槛偏高。
行动建议
如果你要用它
适用场景:
- 在 NVIDIA GPU(H100/B100+)上部署 LLM/VLM/Diffusion,尤其是需要 Blackwell NVFP4 W4A4、QAD 精度恢复、Megatron 训练-推理联合优化的场景。
- 团队规模≥5 人、有可量化精度损失预算(e.g. < 5% MMLU drop)。
- 模型规模≥8B,组合使用 ≥2 种优化技术(仅 PTQ 反而 AutoGPTQ 更轻便)。
对比竞品的选型建议:
- 部署目标是 TRT-LLM / TRT / NIM → 选 ModelOpt
- 部署目标是 vLLM / OpenShift → 考虑 llm-compressor
- 部署目标是 CPU / Apple Silicon / Edge → 选 llama.cpp / GGUF
- 仅研究、不部署 → AutoGPTQ/AutoAWQ 更快上手
如果你要学它
重点关注这些文件(按学习价值排序):
modelopt/torch/opt/mode.py—ModeDescriptor抽象核心(约 350 行)modelopt/torch/opt/searcher.py:312-408— LPS PuLP 包装器(约 100 行,绝对精华)modelopt/torch/opt/dynamic.py:593-655—DynamicModule__class__patching(仅 60 行但概念精妙)modelopt/torch/quantization/algorithms.py— AutoQuantize 主算法(1370 行)modelopt/torch/quantization/model_calib.py:1011-1132— Local-Hessian accumulatormodelopt/torch/kernels/quantization/gemm/nvfp4_fp8_sweep.py:57-107— Triton fused kernel(约 50 行)modelopt/recipe/loader.py— YAML recipe loader +$import+ dotlist override
学习路径推荐:
- 先读
_AutoQuantizeBaseSearcher理解 ILP 思想 → 再读algorithms.py:1093-1121看三步法的代码落地 → 最后读model_calib.py:1011-1132看 Local-Hessian 的具体工程实现。
如果你要 fork 它
可改进的方向(按社区价值排序):
- 跨引擎数值一致性:跟踪 Issue #869 做精度对齐测试套件——大量部署团队都需要。
- 非 NVIDIA GPU 适配:MXFP4 / MXFP8 走 OCP 标准的路径(AMD MI300X / Intel Gaudi 都需要)。
- 量化决策 XAI:AutoQuantize 出的”为什么这层用 NVFP4 而不是 FP8”——给 trust 但 verify 提供决策依据。
- Distributed Hessian 同步:当前
_LocalHessianAccumulator是 single-rank 假设,distributed 训练下要补 all-reduce 同步。 - 更细粒度的 QAD loss 设计:当前 KD loss 是 teacher output + 中间激活,可以加 attention pattern matching / logit rank matching。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/nvidia/model-optimizer (页面存在但深度内容仍在建设中) |
| Zread.ai | 未收录(403) |
| 关联论文 | 无项目自家论文;方法学基底引用 Optimal Brain Surgeon (1992) / LLM-MQ (2023) / SqueezeLLM (2024) |
| 在线 Demo | 无官方 Playground;HF 模型矩阵可直接拉来推理:nvidia/DeepSeek-R1-FP4、nvidia/NVIDIA-Nemotron-3-Ultra-550B-A55B-NVFP4、nvidia/Llama-3.3-70B-Instruct-FP4 |
| 公告博客 | https://nvidia.github.io/Model-Optimizer/announcements/autoquantize/ 与 …/local-hessian/ (NVFP4 + QAD + AutoQuantize 三篇技术博客) |
| Roadmap | https://github.com/NVIDIA/Model-Optimizer/issues/1699 |