GitHub 推荐:击败 Suno v5/v6:HKUST 开源音乐基础模型 YuE2 把乐谱做成白盒
YuE2:可编辑符号化规划的全曲人声音乐基础模型 Repo: https://github.com/multimodal-art-projection/yue 论文: arXiv 2503.08638 (YuE) / 2504.20938 (YuE2) / 2505.19860 (YuE2-turbo) License: Apache-2.0(代码)/ CC BY-NC 4.0(权重)
一句话总结
HKUST M·A·P + ByteDance 联合开源的 YuE2 是当前唯一同时具备「带人声全曲生成 + 乐谱白盒可编辑 + 同源评测体系」的开源音乐基础模型,在 WildSongBench 上 best-of-8 拿到 6.9632,超过 Suno v5/v6。
值得关注的理由
- 唯一开源 SOTA:在 SongBench Avg 上 6.7316,领先 Muse 6.0349、HeartMuLa 6.2483、ACE-Step 6.0118;商业阵营的 Suno v5/v6 仍领先,但 YuE2 把开源质量推到「可对比闭源」的临界点。
- 架构级创新 AR–NAR Mixture-of-Transformers:同一 backbone 同一 attention,按 position mask 路由到 AR/NAR 双投影 + 双 MLP,省 50% 显存——任何「长序列 AR + 并行 NAR」任务都可借鉴。
- 乐谱 token 作为白盒中间产物 模型先 AR 生成 ABC 乐谱再渲染音频,天然支持 agent 二次编辑(翻唱、换词、变速);这是商业产品完全做不到的能力。
项目展示
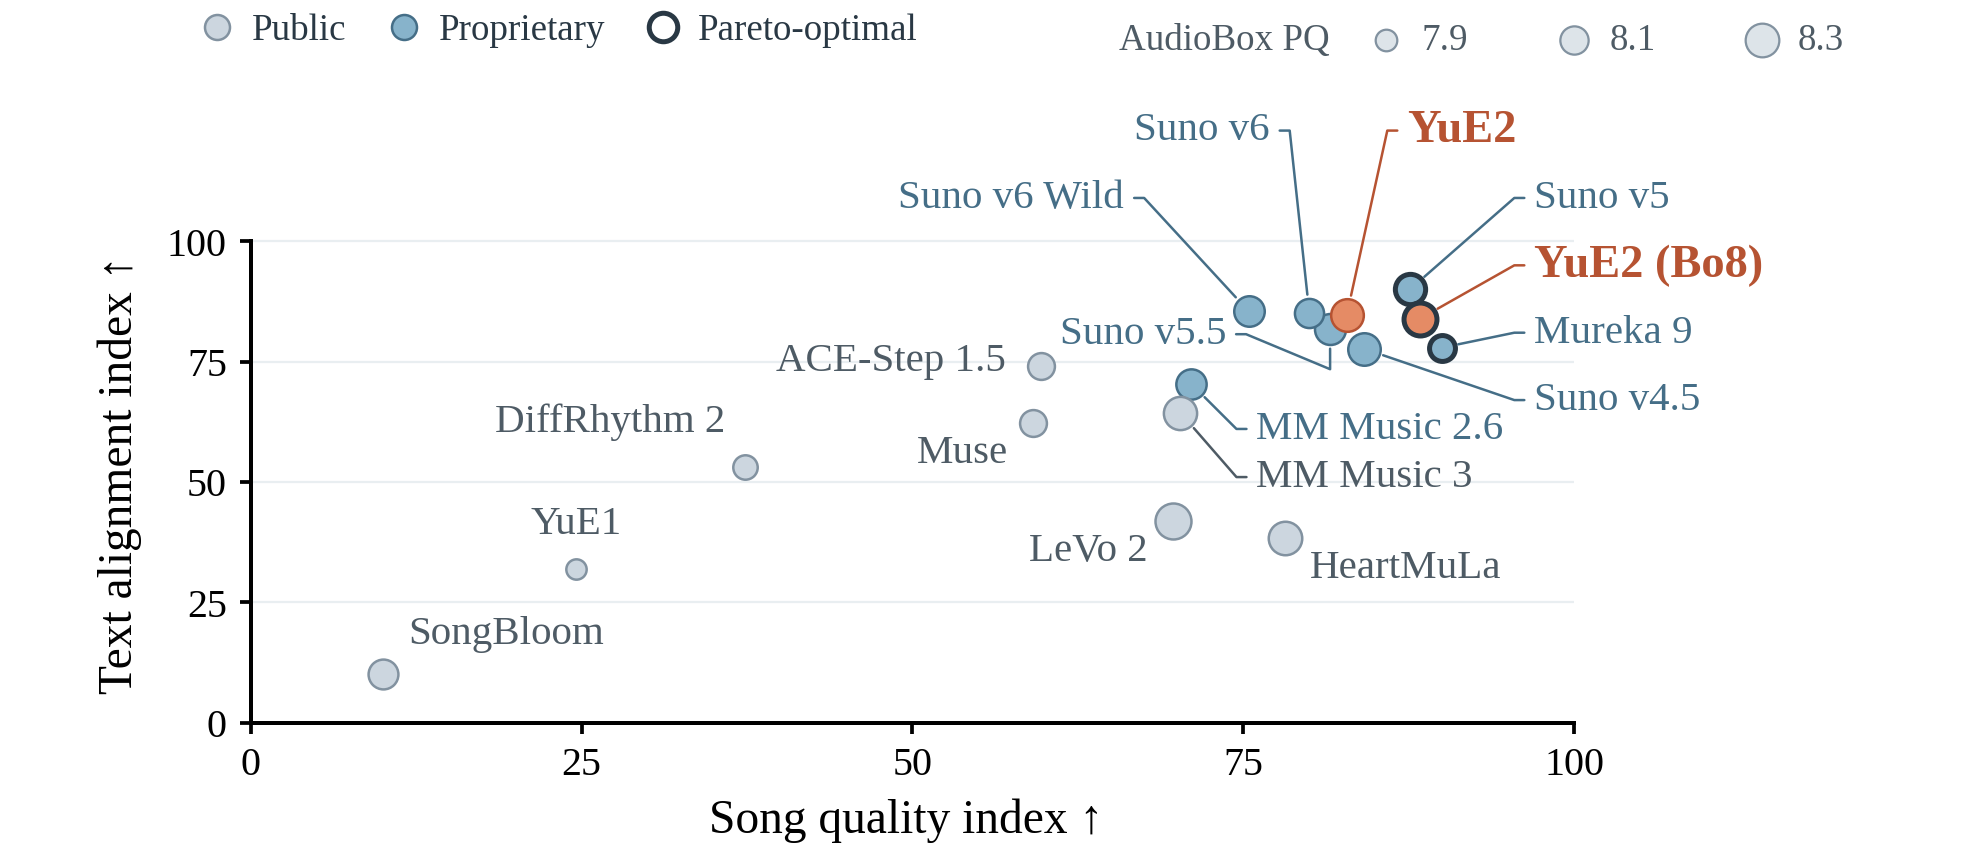 评测 hero:YuE2 best-of-8 在 SongBench Avg 超过 Suno v5/v6
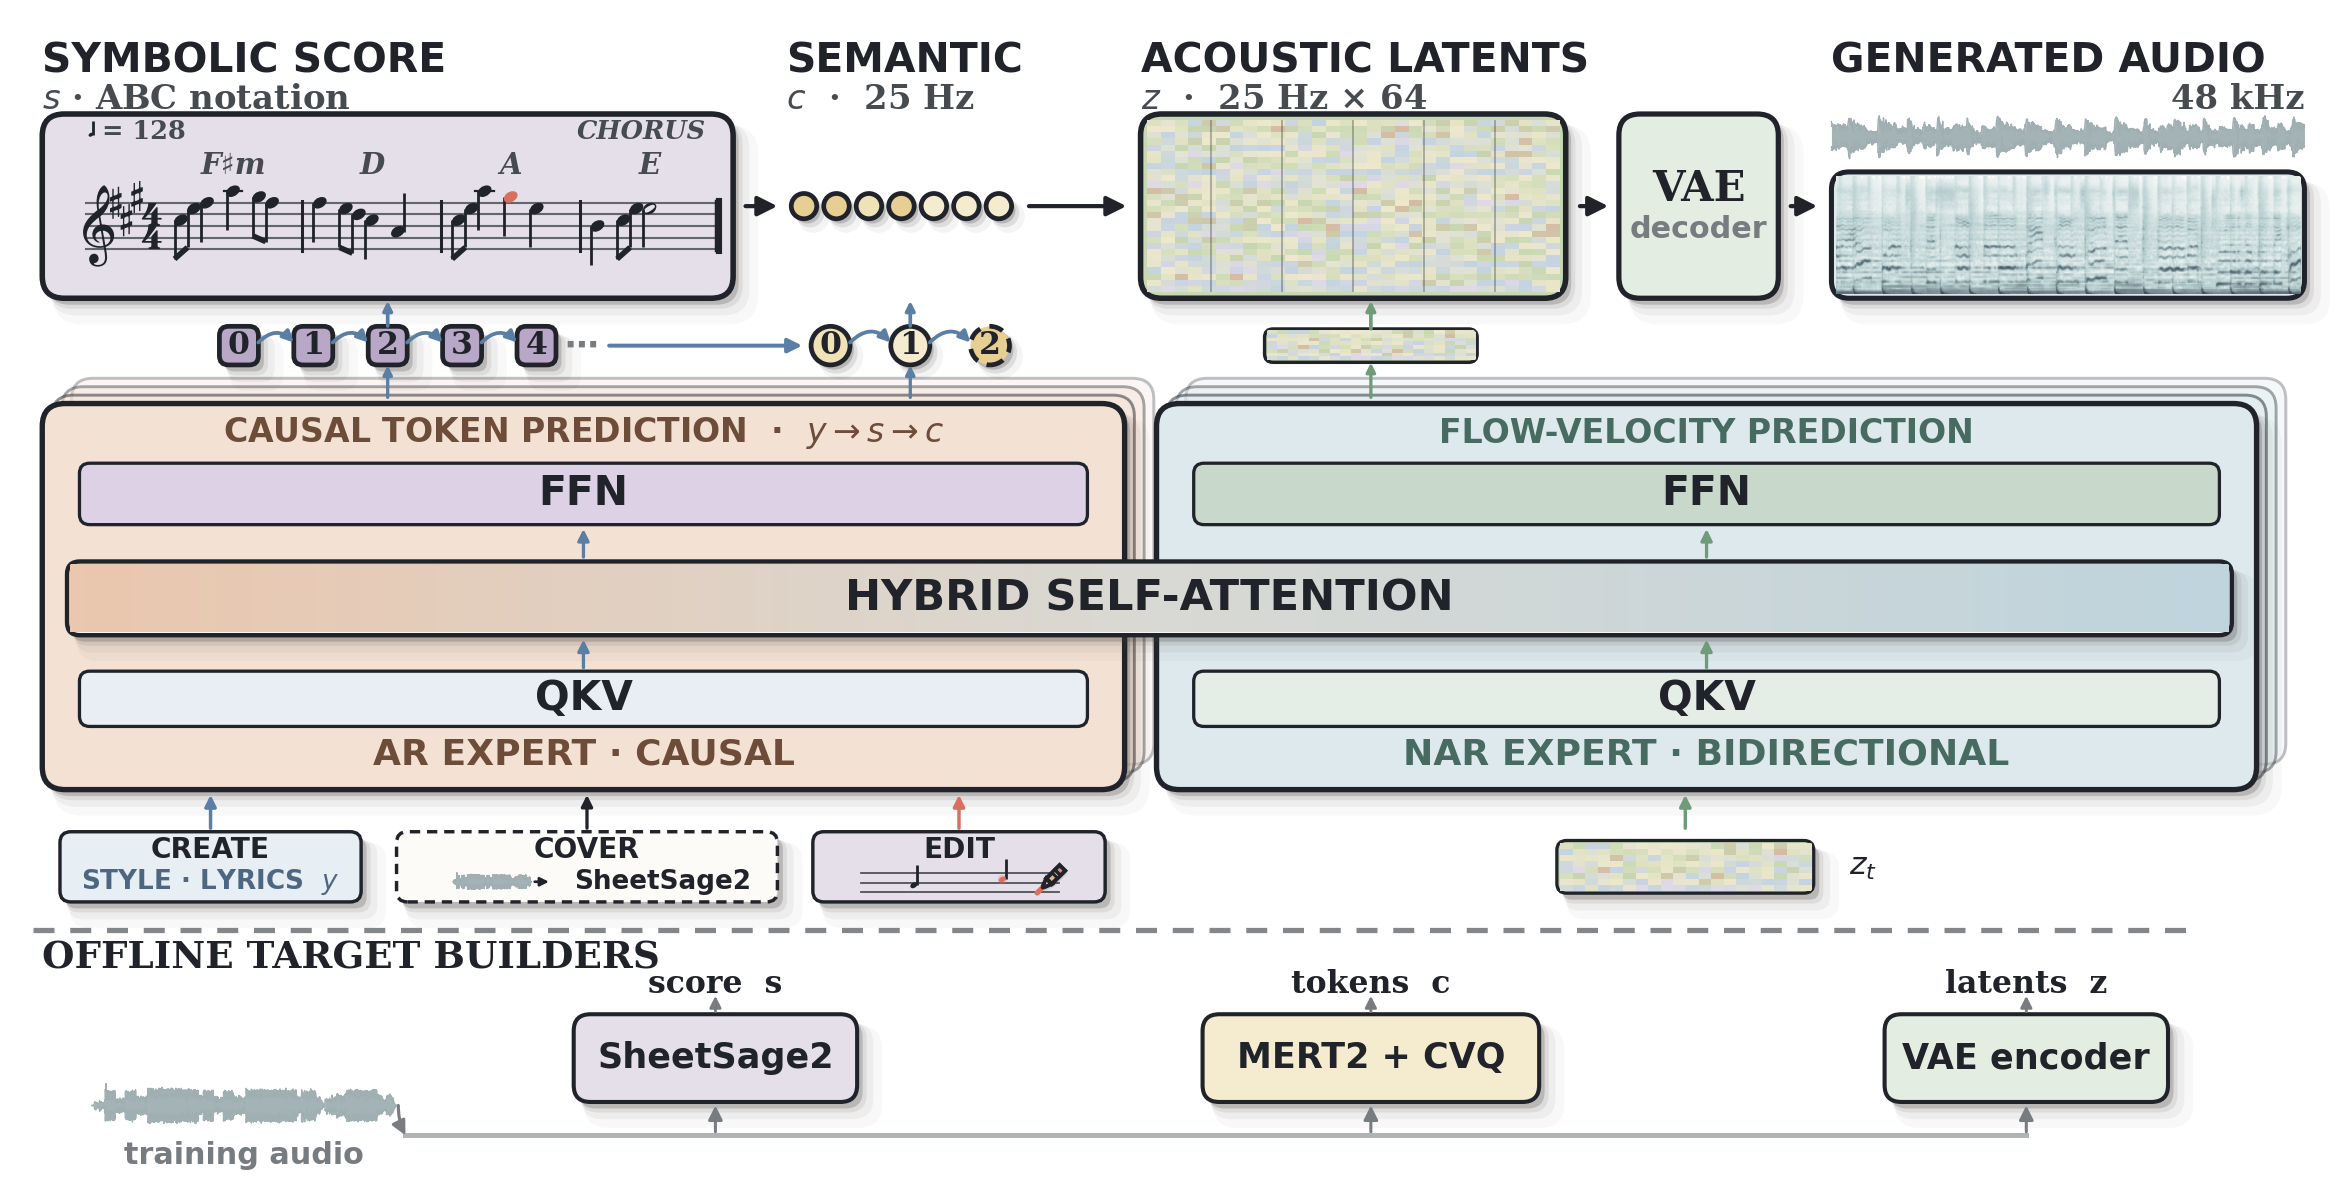 架构总览:乐谱 → 语义 token → 声学 latent → 48 kHz 立体声音频
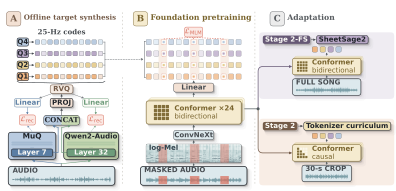 同源生态 MERT2:ConvNeXt + 24 层 Conformer 的自监督音频表示
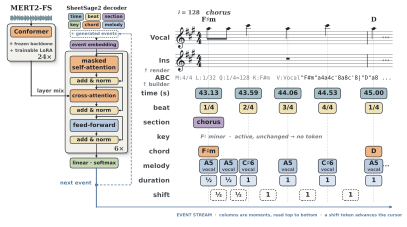 同源生态 SheetSage2:把音频转回 ABC 乐谱(用于翻唱场景)
在线 Demo: Hugging Face Space · YuE | 官网 map-yue2.github.io
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/multimodal-art-projection/yue |
| Star / Fork | 8,304 / 904 |
| 代码行数 | 7,584(Python 78.5% / JSON 12.8% / SVG 8.0%) |
| 项目年龄 | 19.6 个月(首提交 2025-01-26) |
| 开发阶段 | 稳定维护(YuE1 长草 → YuE2 2026-09 重启冲刺) |
| 贡献模式 | 核心少数 + 社区(12 人贡献者,Top1 占比 46.2%) |
| 热度定位 | 大众热门(8.3k stars + 904 forks + 84 watchers) |
| 质量评级 | 代码 优秀 · 文档 优秀 · 测试 充分 |
0. 一句话定位
YuE2 不是又一个「端到端 latent diffusion 出音频」的音乐生成器;它把 「乐谱(ABC)→ 语义 token → 声学 latent → 48 kHz 立体声音频」 四段管线首次完整做成单一 AR–NAR Mixture-of-Transformers(共享 attention、独立归一化/投影/MLP),并以「白盒可编辑」作为产品差异化——同一 checkpoint 既能生成、翻唱,也能由 agent 在乐谱层面对曲式做编辑。
1. 动机与定位
要解决的问题
- 闭源商业系统(Suno/Udio)已达 frontier 质量,但完全不可控:用户无法修改旋律、和弦、段落结构,得到的是一次性不可拆解的波形。
- 开源阵营缺乏带人声的全曲生成器:MusicGen(30s 纯器乐)、Stable Audio(47s、无 vLLM 友好 license)、DiffRhythm/Ace-Step 等开源模型在 SongBench Avg 上与 Suno v5/v6 仍有显著差距。
- 没有公开评测基准:YuE 团队同期发布了 WildSongBench(192 prompts)和配套的 SongBench/SongEval/AudioBox PQ/PER 评估协议,给开源界一个「可重复比较」的标尺。
为什么现有方案不够
- 符号化表示(MusicXML/ABC/MIDI)一直存在,但与神经音频生成是两条平行线:传统算法作曲产出乐谱,神经音频模型产出波形,中间缺一座桥。
- 已有的混合方案(「先写谱再渲染」)大多用规则合成器渲染,音质远低于神经声码器;YuE2 的创新在于「乐谱 → 神经声学 latent → 神经 VAE」,整段神经网络可微、且保留乐谱的可读性。
- 评测体系缺失:没有标准化的「全曲+带人声+多维质量」基准,模型之间只能比片段。
目标用户
- AI 音乐研究者:开源权重 + 论文 + 评测一体化,可复现、可对比。
- 需要歌词+人声+伴奏全曲生成的开发者:风格 prompt + 歌词 → 完整 48 kHz 立体声。
- 乐谱创作/编辑的音乐人:把生成产物作为可二次编辑的乐谱(翻唱、换词、变速)。
- 评测基准构建者:WildSongBench 数据集与评分脚本可独立使用。
2. 作者视角
问题发现
- 学术研究的延续而非 dogfooding:作者团队(HKUST M·A·P + ByteDance)此前已发表 MERT(音频表示),随后 YuE → YuE2 是把「音乐理解」成果推向「音乐生成」的纵向延伸。
- 时机选择恰到好处:2025 年正是 Suno/Udio 把闭源质量推到 frontier 的窗口期,业界需要一个「开源对标」——YuE2 同期发布 WildSongBench + 17 个 setting 的横向评测,等于在「开源阵营」打了一记强心针。
- 同源生态战略:YuE / MERT2 / SheetSage2 / WildSongBench 同一团队同期开源,形成「研究→数据→模型→评测」完整流水线,这是 YuE2 与其他「单点开源」的本质差异。
解法哲学
- 白盒优于黑盒:当所有人都在堆 latent diffusion 端到端时,作者反向把乐谱作为中间产物——牺牲一部分生成多样性的上限,换取「可编辑、可解释、可二次创作」的产品级能力。
- 统一模型覆盖多任务:同一 3.59B 参数的 MoT checkpoint 同时支持「全新生成 / 翻唱 / 编辑」三种 workflow,不为每种任务单独训练一个 checkpoint(参见
cot=「full」/「melody」/「off」三态指令切换)。 - 伦理优先:CC BY-NC 4.0 权重 + Tokenwave.AI 授权合成数据,主动避免版权风险;这与 Stability / Suno 商业化优先的策略形成鲜明对比。
- 明确选择不做什么:
- 不做极致推理优化(#8 fp8/q4、#44 exllamav2 留给了社区 PR);
- 不做通用 latent diffusion 音频(VAE 仅用于声学解码,不承担语义);
- 不做 phoneme / local inpainting 强条件生成(SKILL.md 明确「YuE2 exposes no audio-reference, phoneme-alignment, or local-inpainting argument」)。
背景知识迁移
- 跨域移植 NLP 的 MoT 思路:从「同一 backbone 不同 head」的多任务架构借鉴,但创新点在于共享 attention——AR 与 NAR 用同一 attention 计算,区别仅在 Q/K/V 投影和 MLP,这极大压缩了显存。
- 借鉴 TTS 的 AR→NAR two-stage 范式(如 VALL-E、NaturalSpeech),但推到「乐谱 + 语义 + 声学」三阶段。
- 借鉴 LLM 的 prefix cache / CUDA Graph:自己实现
StaticKVCache与GraphAR,不依赖 vLLM/transformers 的高层抽象——因为「前缀+生成」长度可变、CFG 双分支、CUDA Graph 捕获需要极细控制。
战略图景
- 不是商业产品,是学术 + 开源生态:CC BY-NC 4.0 模型权重、Apache-2.0 代码、独立的 WildSongBench 评测——明确的开源战略。
- 生态定位是基础设施:YuE2 不是「另一个 Suno 替代品」,而是「开源音乐基础模型 + 评测 + 转写 + 表示」四位一体的研究基础设施,社区可以基于它做下游 fine-tune 或新评测。
- 商业化留白:权重 CC BY-NC 而非 Apache,意味着团队保留了商业授权的可能(联系邮件
ryuanab@connect.ust.hk单独谈 licensing)。
3. 架构与设计决策
3.1 目录结构概览
yue/
├── README.md                          # 主文档,强调 「Compose in symbols. Create in sound.」
├── pyproject.toml                     # 依赖精确锁定(torch==2.10.0、transformers==4.57.6)
├── MODEL_LICENSE / LICENSE            # 模型 CC BY-NC / 代码 Apache-2.0 双协议
├── src/yue2/                          # 核心 Python 包(约 3.8K 行)
│   ├── protocol.py          (145)     # 协议常量与 SongRequest / Sampling / GenerationConfig
│   ├── pipeline.py          (398)     # 主入口 YuE2Pipeline:plan / generate_semantic / synthesize / decode
│   ├── modeling_yue2.py     (705)     # YuE2Config + Backbone + DecoderLayer(AR–NAR MoT)
│   ├── nar.py               (261)     # NAR 声学流匹配 + CachedNAR 缓存策略
│   ├── sampling.py          (154)     # AR 自回归 + CFG + window penalty
│   ├── cuda_graph.py        (240)     # 纯 PyTorch 的 CUDA Graph 加速(无 vLLM/Triton 依赖)
│   ├── fast.py              (426)     # 可选 vLLM worker 子进程(subprocess + JSON IPC)
│   ├── modeling_vae.py      (589)     # Oobleck VAE(来自 stable-audio-tools,FP32)
│   ├── quantization.py      (114)     # FP8 AR 线性层(实验性,需 SM ≥8.9)
│   ├── progress.py          (316)     # 零依赖 ASCII 进度条(heartbeat + TTY 适配)
│   ├── protocol.py / storage.py / tokenization_yue2.py / cli.py
├── docs/                              # 生成 / 翻唱 / 编辑 / 评测指南
├── examples/                          # 极简示例 + ABC 乐谱
├── skills/yue2-music/                 # Agent Skill 包(SKILL.md + scripts + references)
├── tests/                             # 13 个测试文件,约 2K 行,覆盖 CPU 跑通的纯 PyTorch 路径
└── .github/workflows/tests.yml # CI:CPU-only 跑全套 pytest分层逻辑:
- 协议层(
protocol.py):token ID 区间、SongRequestdataclass、Sampling/GenerationConfig—— 不依赖 torch,是纯契约。 - 模型层(
modeling_yue2.py+modeling_vae.py):自包含的trust_remote_code实现,与transformers解耦。 - 采样层(
sampling.py+nar.py):纯函数式的 token 生成与 ODE 求解。 - 编排层(
pipeline.py):contextmanager 风格的YuE2Pipeline,对外只暴露 4 个有意义的阶段。 - 可选加速层(
cuda_graph.py+fast.py):默认无依赖,opt-in 引入 vLLM/Triton/CUDA Graph。
3.2 关键设计决策
决策 1: AR–NAR Mixture-of-Transformers(共享 attention,独立投影/MLP/归一化)
- 问题:全曲音乐生成需要 AR 阶段(语义 token)做长序列自回归,又需要 NAR 阶段(声学 latent)做并行流匹配。传统做法是两个独立模型,显存翻倍且 AR 的表示与 NAR 的表示不对齐。
- 方案(
modeling_yue2.py:227-304):每个DecoderLayer同时持有self_attn(AR 路径)和nar_self_attn(NAR 路径),以及mlp和nar_mlp。NAR 推理时通过ar_mask把 Q/K/V 按位置分桶(AR 位置用 AR 投影,NAR 位置用 NAR 投影),但 SDPA 调用只一次——共享 attention。 - Trade-off:牺牲了「两阶段可用不同 backbone」的灵活性,换来约 50% 的显存节省(不需要两份 KV cache)和端到端对齐的表示。
- 可迁移性:高。任何需要「同一序列上 AR+NAR 双任务」的场景(如语音 TTS、视频+文本)都可借鉴这种「mask-routed 共享 attention」模式。
决策 2: 乐谱作为「白盒中间产物」,而非后处理
- 问题:传统音频生成是黑盒——输入 prompt,输出波形,无法修改内部任何成分。
- 方案(
pipeline.py:255-269+protocol.py:115-126):模型先 AR 生成 ABC 乐谱 token(cot=「full」包含旋律+和弦,cot=「melody」仅旋律,cot=「off」跳过乐谱阶段),再 AR 生成语义 token,最后 NAR 声学。SymbolicPlan是可持久化的中间产物(pipeline.py:28-63),含score.abc+abc_tokens.npy+prefix.npy,配 sha256 manifest 防篡改。 - Trade-off:AR 阶段 token 数从「只有语义 token」变成「乐谱 + 语义」,生成时间略增;换来「用户可以编辑 ABC 后用同一 checkpoint 重新渲染」的产品级能力。
- 可迁移性:中。任何「想要可控生成」的多模态任务(图像生成可借鉴 latent code 中间产物,3D 生成可借鉴网格中间产物)都可参考。
决策 3: 三态 CoT(full / melody / off)作为单模型多任务接口
- 问题:不同用户场景需要不同「乐谱可编辑程度」——研究者要 full plan,翻唱者只要 melody,纯创作不要乐谱。
- 方案(
protocol.py:14-18, 90-92):用INSTRUCTIONS字典把 3 种指令模板化为模型 prompt 的前缀;同一模型权重不切换,靠 prompt 切换行为。SongRequest.cot字段做运行时校验。 - Trade-off:相比为每种任务单独 fine-tune 一个 checkpoint,牺牲了一点任务特异性(旋律模式下的和弦是自由的,但模型可能仍偏 full 模式训练),换来了「一份权重覆盖三场景」的简洁性。
- 可迁移性:高。这是 LLM 时代「instruction tuning 替代多模型」的典型范式。
决策 4: 纯 PyTorch CUDA Graph(不依赖 vLLM/Triton)
- 问题:标准 AR 自回归 step 每次 launch 一个新 kernel,吞吐低;CUDA Graph 能消除 launch overhead,但需要固定 batch/shape,CFG 双分支让问题更复杂。
- 方案(
cuda_graph.py:111-230):自实现GraphAR,把 batch=1(或 batch=2 for CFG)的 KV cache 预分配到max_tokens上限,用scatter_按物理 slot 写入每步新 token;_flash_attention_forward用cu_q/cu_k/seqused_k三参数变长 Flash 接口(PyTorch 2.10 私有 API)做 packed attention;同时支持fuse_projections把 Q/K/V 投影合成一个大矩阵(节省 linear kernel launch)。 - Trade-off:紧绑 PyTorch 2.10 私有 API(
torch.ops.aten._flash_attention_forward的seqused_k参数),可移植性差;换来「不需要写 CUDA kernel、不依赖外部 Triton/FlashAttention 包」的纯 PyTorch 体验。 - 可迁移性:中。任何「单请求 AR + CFG + 想用 CUDA Graph 加速」的场景可借鉴,但 API 高度依赖 PyTorch 版本。
决策 5: AR/NAR 内存调度(offload_ar)+ AR/NAR 模型复用同一份权重
- 问题:3.59B 模型 + KV cache 在 24GB 卡上刚好够,但 FP8 / batch 稍大就 OOM。
- 方案(
nar.py:204-225):在 NAR 阶段临时把 AR 不用的模块(embed_tokens, lm_head, 每个 layer 的 AR attention/layernorm/mlp)offload 到 CPU;NAR 结束后还原。_offload_ar是 contextmanager + 严格 try/finally,保证还原。 - Trade-off:牺牲 NAR 阶段切换的延迟(CPU↔GPU 拷贝),换来「同一 24GB 卡能跑 full song + NAR + VAE」的可行性。
- 可迁移性:高。任何「AR+NAR 共享 backbone 但不能并发跑」的场景都可借鉴。
决策 6: 内容寻址的 AR 派生缓存(derive_ar_checkpoint)
- 问题:vLLM 不支持 MoT(双投影)模型,但 AR 部分实际上就是标准 Qwen3。
- 方案(
fast.py:57-106):从原始 safetensors 里抽取出 AR 相关的所有 tensor(embed_tokens/norm/lm_head/ 每个 layer 的self_attn.{q,k,v,o}_proj/mlp.{gate,up,down}_proj),按identity({schema, source, config})内容寻址缓存到~/.cache/huggingface/yue2-ar/<hash>/;同源 model 复用同一派生权重,用fcntl.flock排他锁防止并发写。 - Trade-off:派生过程需遍历所有 shard,但有 manifest + sha256 校验完整性;换来「用户无感知地让 vLLM 加载 AR 派生权重 + 标准 Qwen3 路径享受 vLLM 优化」。
- 可迁移性:高。这是「从非标准架构中抽出标准子图」的通用模式。
决策 7: 进程隔离的 vLLM worker(subprocess + JSON IPC)
- 问题:vLLM 占用整张 GPU,与 NAR/VAE 不能并发;vLLM worker 启动开销大。
- 方案(
fast.py:224-287):vLLM 跑在独立子进程(--worker模式),通过 stdin/stdout JSON line 通信;_Worker用 selectors 做异步读、weakref.finalize保证父进程退出时杀子进程。 - Trade-off:跨进程通信增加延迟,且子进程不能与父进程共享 CUDA context;换来「vLLM 在 NAR/VAE 阶段不占显存 + 主进程可以快速 swap」。
- 可迁移性:高。任何「重型框架 worker + 主进程编排」的架构都可参考。
决策 8: Token 前缀的精确契约 + CFG 负分支保留乐谱
- 问题:classifier-free guidance 需要「正负两前缀」,但如果负前缀丢了乐谱,CFG 会把模型从「乐谱+歌词」模式拽到「纯歌词」模式,破坏一致性。
- 方案(
protocol.py:115-138):token_prefixes与negative_prefix都把 ABC_START + abc_ids + ABC_END 完整保留;只在 instruction 文本部分做差异(positive 是完整指令,negative 是「无 ABC 部分指令」)。test_cfg_keeps_exact_score_and_removes_only_text测试明确锁这一契约。 - Trade-off:负分支的 prefix 更长(多一份 ABC token),但语义连贯性显著提升。
- 可迁移性:高。任何「CFG + 结构化条件生成」的场景都应遵守「只在可变字段做差异」的原则。
决策 9: 内容寻址 + sha256 manifest 的可复现工件
- 问题:科研/复现要求「完全相同的输入得到完全相同的输出」,但模型版本、CUDA 版本、sampling 参数都可能影响结果。
- 方案(
storage.py:24-29, 105-148):write_json用temp+os.replace原子写入;model_identity用 sha256 校验权重;collect_hashes在 result.json 里记录所有工件的 sha256 + bytes;verify_result反向校验。 - Trade-off:每次保存额外做全文件 hash(百 MB 模型权重 → 秒级开销);换来「任何 result.json 都能独立验证完整性 + 防篡改」。
- 可迁移性:高。是科研 / 评测场景的「标准作业」。
决策 10: 零依赖 ASCII 进度条
- 问题:rich/tqdm 是常用进度条库,但额外依赖且行为不可控(容易在 TTY/pipe 下表现不一致)。
- 方案(
progress.py):用sys.stderr+threading.Eventheartbeat + COLUMNS 环境变量,自实现 TTY 适配(≥60 列才刷新,窄终端 5s 刷新一行),并明确「进度条绝不能影响 RNG / 不 inspect tensor」。 - Trade-off:不能做颜色/进度条样式丰富度;换来「零依赖 + 行为可预测 + 不破坏可复现性」。
- 可迁移性:高。任何「科研级 CLI」的进度条场景。
3.3 创新点识别
创新 1: AR–NAR Mixture-of-Transformers(共享 attention)
- 描述:同一 backbone 同一 attention 计算,按 position mask 路由到 AR/NAR 双投影 + 双 MLP。
- 新颖度: 4/5 | 实用性: 5/5 | 可迁移性: 4/5
- 适用场景:任何需要「长序列 AR + 并行 NAR 段」的任务(语音 TTS、视频生成、3D 资产生成)。
创新 2: 乐谱作为可编辑中间产物(「白盒生成」)
- 描述:把符号化表示纳入 AR 推理路径,让模型天然产出可读、可编辑、可重渲染的乐谱。
- 新颖度: 5/5 | 实用性: 4/5 | 可迁移性: 3/5
- 适用场景:音乐生成(直接应用)、图像+layout 中间产物、视频+剧本。
创新 3: 单 checkpoint 三态 CoT(full / melody / off)
- 描述:同一模型权重靠 prompt 切换三种行为,不需要为每种任务 fine-tune 单独模型。
- 新颖度: 3/5 | 实用性: 5/5 | 可迁移性: 5/5
- 适用场景:一切 instruction tuning 场景。
创新 4: 内容寻址的 AR 派生缓存 + Qwen3 兼容派生
- 描述:把 MoT checkpoint 中「AR 等价于 Qwen3」的部分抽出来,让 vLLM 无感加载。
- 新颖度: 4/5 | 实用性: 4/5 | 可迁移性: 4/5
- 适用场景:任何「非标准架构需要套用 vLLM」的场景(MoE、共享参数模型等)。
创新 5: 纯 PyTorch CUDA Graph(packed varlen Flash + cu_q/cu_k)
- 描述:不依赖 Triton/FlashAttention 第三方包,自己用 PyTorch 2.10 私有 API 实现 packed varlen Flash attention + CFG 双分支 + projection fusion。
- 新颖度: 4/5 | 实用性: 5/5 | 可迁移性: 3/5
- 适用场景:紧跟 PyTorch 新版本、对 vLLM 不友好的自定义 attention 场景。
创新 6: SongBench Avg + 17 setting 横向评测
- 描述:WildSongBench 192 prompts × 17 settings(公开/闭源)的标准化对比,是开源音乐生成评测的标杆。
- 新颖度: 4/5 | 实用性: 5/5 | 可迁移性: 5/5
- 适用场景:任何 AI 生成内容(AIGC)的标准化评测。
创新 7: Triton 自定义 LogitsProcessor 实现 window penalty
- 描述:vLLM 的
LogitsProcessor扩展点 + Triton kernel,在 vLLM GPU 推理中实现「最近 N 个 token 的指数衰减重复惩罚」,避免每步 Python 循环。 - 新颖度: 3/5 | 实用性: 4/5 | 可迁移性: 4/5
- 适用场景:任何需要 vLLM 后处理 + 自定义 GPU kernel 的场景。
3.4 可复用模式
- Mask-routed 共享 attention:AR/NAR 用同一 attention,按 position mask 路由投影层 —— 适用场景:双任务同 backbone。
- 内容寻址的派生缓存:
identity({schema, source, config})哈希 → 复用派生产物 —— 适用场景:从非标准 checkpoint 派生标准子图。 - subprocess + JSON-line IPC worker:重型框架隔离进程,主进程编排 —— 适用场景:vLLM / Triton / 自定义推理后端。
- temp + os.replace 原子写入 + manifest sha256:可复现工件的标准作业 —— 适用场景:科研 / 评测。
- CFG 双前缀保留结构化条件:负分支只在可变字段做差异 —— 适用场景:所有 CFG 场景。
- 零依赖 ASCII 进度条(heartbeat + TTY 适配):科研级 CLI —— 适用场景:可复现 CLI。
- contextmanager + try/finally 的资源 offload:临时把模块 offload 到 CPU 后严格还原 —— 适用场景:显存受限的多阶段流水线。
- Agent Skill 接入层(SKILL.md + scripts/):让 LLM agent 调用模型 —— 适用场景:所有想让 LLM 调用本项目的工具。
- 三态 CoT(单模型多任务接口):instruction tuning 替代多模型 —— 适用场景:一切多任务单模型。
4. 竞品交叉分析
4.1 vs Suno / Udio(闭源商业)
- 我们更好:可编辑(白盒 ABC)、开源(可本地部署、可 fine-tune)、可复现(hash 校验工件)、伦理清晰(CC BY-NC)。
- 竞品更好:音质(v5/v6 在 PER、AudioBox PQ 上仍领先)、UI/产品打磨、商用 license 即开即用。
- 不同目标:Suno 是消费品,YuE2 是研究基础设施 + 开源对标。
- 迁移成本:从 Suno 迁移到 YuE2 = 放弃产品 UI + 接受 24GB GPU + 接受生成时间更长。
4.2 vs facebook/musicgen(30s 纯器乐)
- 我们更好:带人声、全曲长度(>2 分钟)、符号化中间产物、可编辑。
- 竞品更好:模型更小(300M/1.5B)、推理门槛低、Meta 生态成熟。
- 不同目标:MusicGen 是「短片段器乐 BGM 生成器」,YuE2 是「全曲带人声主流通行歌曲生成器」。
- 迁移成本:从 MusicGen 迁移到 YuE2 = 显存门槛从 4GB 提升到 24GB + 接受更慢推理。
4.3 vs stabilityai/stable-audio-open(47s)
- 我们更好:带人声、可编辑(MusicGen/Stable Audio 都无中间表示)、全曲长度。
- 竞品更好:commercial-friendly license(CC0/SR)、更小模型、更快推理。
- 不同目标:Stable Audio 是「商业 BGM/SFX 生成器」,YuE2 是「研究/创作工具」。
- 迁移成本:从 Stable Audio 迁移到 YuE2 = license 收紧(CC BY-NC)+ 显存门槛提升。
4.4 vs Ace-Step / DiffRhythm / Muse / LeVo / HeartMuLa 等开源全曲生成
- 我们更好:在 WildSongBench SongBench Avg 上 YuE2 (best-of-8) 6.9632 领先所有可比开源设置;YuE2 6.7316 vs Muse 6.0349、HeartMuLa 6.2483、ACE-Step 6.0118;可编辑性是独家优势。
- 竞品更好:部分模型在 SongEval Avg 上更接近 Suno(如 HeartMuLa 4.5519);部分模型推理更快(如 ACE-Step)。
- 不同目标:大多数开源全曲生成器是「端到端 latent diffusion」,YuE2 是「符号化 + 神经」混合路线。
- 迁移成本:在评测基准层面接近,但从用户视角看,需要重新熟悉 ABC 乐谱 + 3 阶段 pipeline。
4.5 综合竞争结论
- 差异化护城河:唯一开源 + 带人声 + 全曲 + 可编辑 + 同源自建评测/转写/表示生态的玩家。「白盒可编辑」是产品级护城河,不是单点技术——背后是 AR–NAR MoT + 乐谱 token + 流匹配 + VAE 的完整工程栈。
- 竞争风险:
- 闭源 Suno/Udio 继续提升音质和速度;
- 推理门槛(24GB VRAM + flash-attn2 + xcodec 等依赖)是消费级部署最大障碍(#8、#41、#44 issues 都集中在这);
- 极致推理优化(FP8/q4/exllamav2)作者团队不做,留给社区——意味着用户首次体验很可能「装不上、跑不快」。
- 生态定位:不是「Suno 的开源替代品」,而是「AI 音乐研究的基础设施 + 评测标尺」。WildSongBench 让任何后续工作都能用同一 benchmark 比较,这是比模型本身更深的护城河。
套利机会分析
- 信息差:低关注度高质量——8.3K stars 在「音乐生成」垂直已是头部开源项目,但相对 Suno/Udio 的 100M+ 用户群仍是「圈内热门」。对中文 AI 音乐社区尤其有信息差:arXiv 论文 + WildSongBench 评测协议 + 可编辑乐谱生成器三件套几乎没人整合解读。
- 技术借鉴:AR–NAR Mixture-of-Transformers(mask-routed 共享 attention)、CFG 双前缀保留结构化条件、内容寻址派生缓存、subprocess + JSON-line IPC worker——这四个模式对所有「长序列 AR + 自定义 backbone」的 LLM 项目都通用,迁移成本低。
- 生态位:填补「开源可复现 + 标准化评测 + 乐谱可编辑」的空白。WildSongBench 把 SongBench Avg + SongEval Avg + AudioBox PQ + PER 等 9 个维度的评测协议标准化,让任何后续工作都能挂在同一标尺上比较——这是比模型本身更深的护城河。
- 趋势判断:增长中。2026-09 集中 22 commit 是 YuE2 重大版本冲刺(v1 → v2 的发布窗口),对比 14 个月的 YuE1 长草期是质变。闭源 Suno/Udio 仍有音质领先,但模型权重 + 评测 + 数据管线三位一体的「开源基础设施」正成为学术界标准(如 LLaMA/Hugging Face 的成功路径),YuE2 在音乐赛道占据了这个生态位。
风险与不足
- 推理门槛高:24GB VRAM(消费级 4090 刚好)+ flash-attn2 + xcodec + WSL(Windows)依赖组合,对非研究员用户不友好。Issue #41(16 评论)、#8(28 评论)、#44(21 评论)都集中在这。
- 作者明确「不做极致推理优化」:FP8/q4 量化、exllamav2 都留给社区 PR(#8、#44 closed 但仅靠社区),意味着首次用户体验「装不上、跑不快」,社区维护质量决定项目天花板。
- CUDA Graph 紧绑 PyTorch 2.10 私有 API(
torch.ops.aten._flash_attention_forward的seqused_k参数):PyTorch 2.11+ 升级可能 break,迁移需要重写。 - 依赖版本精度可再升级:
pyproject.toml用==锁大版本但无 transitive hash 锁定;生产部署踩到依赖漂移的概率非零。 - 没有独立 CHANGELOG:版本信息散落在 README + GitHub Releases +
pyproject.toml,长期维护略不便。 - 没有 ruff/black/flake8 配置:跨贡献者风格一致性靠人工 review,对外部贡献者友好度下降。
- 模型权重 CC BY-NC 4.0 而非 Apache-2.0:商用受限;商业化需联系
ryuanab@connect.ust.hk单独 licensing。
5. 代码质量评估
5.1 总览
| 维度 | 评级 | 说明 |
|---|---|---|
| 代码质量 | 优秀 | 自包含 modeling_yue2.py 实现 trust_remote code;CUDA Graph / vLLM worker / FP8 都做完整错误检查;契约式 dataclass 校验;contextmanager 严格资源管理 |
| 文档质量 | 优秀 | README + docs/{generation,covers,editing,benchmarks}.md + skills/yue2-music/SKILL.md + 5 个 references/;每个 doc 文件都给出「能做什么 + 不能做什么」的诚实边界 |
| 测试覆盖 | 充分 | 13 个测试文件 / 约 2K 行,覆盖 protocol / sampling / pipeline / NAR / CUDA Graph / vLLM fast / VAE / progress / skill 集成;CI 在 CPU-only 环境跑全套(tests.yml:14 设 CUDA_VISIBLE_DEVICES=「」) |
| CI/CD | 完善 | .github/workflows/tests.yml 在 PR + push 时跑 pytest;pyproject.toml 严格锁版本(torch==2.10.0 / transformers==4.57.6 / vllm==0.19.0) |
| 错误处理 | 规范 | 每个 dataclass 都 __post_init__ 校验;所有数值输入做 isinstance + 范围检查;所有文件操作做原子写入 + hash 校验;_offload_ar 严格 try/finally;_Worker.close() 用 weakref.finalize + 超时降级 SIGKILL |
| API 设计 | 优秀 | YuE2Pipeline 是单一入口 + 4 个有意义的阶段(plan / generate_semantic / synthesize / decode);SongRequest 字段即文档;SymbolicPlan / SemanticResult / SongResult 不可变 dataclass,save/load 对称 |
| 可复现性 | 优秀 | sha256 manifest + request identity hash + 内容寻址 AR 派生 + 严格 RNG 控制;每个 result.json 都自校验 |
| License 清晰度 | 优秀 | 代码 Apache-2.0 / 模型 CC BY-NC 4.0 / 第三方组件各自的 LICENSE 文件单独存放(licenses/ 目录 + THIRD_PARTY_NOTICES.md) |
| 安全/边界检查 | 优秀 | _PrefixCache 检查 capacity;attention 检查 query_chunk_size;FP8Linear.forward 检查 device/dtype/rows 对齐;storage.copy_model_files 检查 destination 非空、文件名白名单、相对路径防 is_symlink 攻击 |
5.2 质量检查清单
- 有测试(单元 + 集成):
tests/13 个文件,覆盖 protocol、sampling、CUDA Graph、NAR、VAE、skill 集成 - 有 CI/CD 配置:
.github/workflows/tests.ymlPR + push 触发 - 有文档(不仅是 README):
docs/4 篇指南 +skills/yue2-music/SKILL.md+ 5 个 references - 错误处理规范:所有数值/路径输入都有类型 + 范围 + 边界校验
- 有 linter/formatter 配置:
pyproject.toml设了 pytest 配置;无独立 ruff/black 配置(依赖社区默认) - 有 CHANGELOG:
/tmp/repo-miner-yue中未找到 CHANGELOG.md(仅README.md第 27 行有「📦 Release yue2-v0.1.6」链接)—— 短板 - 有 LICENSE:
LICENSE(Apache-2.0) +MODEL_LICENSE(CC BY-NC 4.0)+THIRD_PARTY_NOTICES.md+licenses/目录 - 有示例代码 / examples 目录:
examples/generate.py+examples/song.json+examples/melody.abc+examples/score.abc+examples/score-jazz.abc - 依赖版本锁定(lock file):
pyproject.toml精确锁torch==2.10.0、transformers==4.57.6、vllm==0.19.0等,但无requirements.txt风格的 hash 锁定——对生产部署有改进空间
5.3 短板的诚实评估
- 推理门槛高:24GB VRAM + flash-attn2 + xcodec + WSL(Windows)等依赖组合,对消费级用户不友好(#41 issue 集中反映);作者明确「不做极致推理优化」,留给社区(#8 fp8/q4、#44 exllamav2)。
- 没有独立 CHANGELOG:版本信息散落在 README + GitHub Releases +
pyproject.toml,对长期维护略不便。 - 没有 ruff/black/flake8 配置:依赖社区默认风格,跨贡献者风格一致性靠人工 review。
- 依赖锁定精度可再升级:
pyproject.toml用==锁大版本,但无requirements.lock风格的 transitive hash 锁定;某些下游用户可能踩到依赖版本漂移的坑。 - CUDA Graph 紧绑 PyTorch 2.10 私有 API(
torch.ops.aten._flash_attention_forward的seqused_k参数),未来 PyTorch 升级可能 break。 - Windows 便携版是社区需求但官方不支持(#19 issue closed 但仅靠社区)。
5.4 一句话工程总结
「一个把学术创新(AR–NAR MoT + 白盒乐谱)做到工程级完整度(CUDA Graph + vLLM worker + sha256 manifest + Agent Skill)的开源音乐基础模型——它的护城河不是模型权重,而是’研究→数据→模型→评测’四位一体的研究基础设施。」
6. 关键文件索引
| 文件 | 行数 | 关键内容 |
|---|---|---|
src/yue2/pipeline.py | 398 | YuE2Pipeline:plan / generate_semantic / synthesize / decode 四阶段编排 |
src/yue2/modeling_yue2.py | 705 | AR–NAR MoT:DecoderLayer 双 attention/MLP + YuE2ForCausalLM.forward + nar_velocity |
src/yue2/nar.py | 261 | CachedNAR 流匹配 + _offload_ar 内存调度 |
src/yue2/sampling.py | 154 | AR 采样 + CFG 双分支 + window penalty |
src/yue2/cuda_graph.py | 240 | 纯 PyTorch CUDA Graph + packed varlen Flash + Q/K/V/MLP fusion |
src/yue2/fast.py | 426 | vLLM worker(subprocess IPC)+ Triton window penalty + AR 派生缓存 |
src/yue2/quantization.py | 114 | FP8 AR 线性层(实验性,SM ≥8.9) |
src/yue2/protocol.py | 145 | token ID 区间 + SongRequest / Sampling / GenerationConfig 契约 |
src/yue2/storage.py | 148 | sha256 manifest + 模型权重身份校验 + 原子写入 |
src/yue2/progress.py | 316 | 零依赖 ASCII 进度条(heartbeat + TTY 适配) |
src/yue2/modeling_vae.py | 589 | Oobleck VAE(来自 stable-audio-tools,FP32) |
skills/yue2-music/SKILL.md | 154 | Agent Skill 主入口 |
skills/yue2-music/scripts/abc_tools.py | — | 原生 ABC dialect 解析与编辑检查 |
docs/generation.md | 75 | 生成指南(含 plan → audio 完整流程) |
docs/editing.md | 58 | 白盒编辑 + Agent 接入 |
docs/covers.md | 74 | 翻唱流程(SheetSage2 → ABC → melody 模式) |
docs/benchmarks.md | 64+ | 17 setting × 9 维度的 WildSongBench 评测 |
tests/test_nar.py | 247 | NAR 流匹配 + dense reference 比对 |
tests/test_cuda_graph.py | 144 | CUDA Graph 正确性 |
tests/test_protocol.py | 112 | 协议契约锁 |
知识入口
行动建议
-
如果你要用它:
- 优先选 YuE2(2026-09 发布的最新版本,4B 参数 + 28 层 + iTDS turbo),不要用 YuE1。
- 准备 24GB VRAM(4090/RTX 5090),CUDA ≥ 12.8、PyTorch 2.10.0、transformers 4.57.6、vllm 0.19.0(强绑版本)。
- 用
cot=「full」拿可编辑 ABC;用cot=「off」跳过乐谱阶段更快。 - 商用先联系
ryuanab@connect.ust.hk谈 licensing(权重 CC BY-NC 而非 Apache-2.0)。
-
如果你要学它:
src/yue2/modeling_yue2.py:227-304的DecoderLayer+modeling_yue2.py:608-700的nar_velocity:AR–NAR MoT 教科书级实现。src/yue2/cuda_graph.py:纯 PyTorch 写高性能 AR 推理的范例(packed varlen Flash + CFG 双分支 + projection fusion)。src/yue2/protocol.py:契约式 dataclass + token ID 区间定义是协议设计的范本。src/yue2/storage.py:sha256 manifest + temp+os.replace 原子写入是科研可复现的标准作业。src/yue2/fast.py:57-106:内容寻址派生缓存——从非标准 checkpoint 抽出标准子图,让 vLLM 无感加载。
-
如果你要 fork 它:
- 推理优化方向:FP8 量化(
quantization.py已实验性,需 SM ≥8.9 = RTX 4090)、exllamav2 接入(社区 PR 已做)、CUDA Graph 跨 batch 泛化。 - 数据集方向:Tokenwave.AI 授权合成数据的获取流程值得文档化(README 没展开)。
- 评测方向:WildSongBench 192 prompts 是公开资源,可以做「特定风格 vs 通用」子集评测。
- Skill 接入:
skills/yue2-music/是 LLM Agent 接入的范本,可借鉴到自己模型的 LLM 工具调用设计。
- 推理优化方向:FP8 量化(
7. 关键 takeaway
- 如果你是 AI 音乐研究者:YuE2 是当前开源阵营 SOTA;用 WildSongBench 比较你的工作;考虑 fine-tune 派生权重(CC BY-NC 限制下)。
- 如果你是想用 LLM 做音乐生成的工程师:SKILL.md + scripts/ 是接入最快的入口;准备好 24GB GPU;用
cot=「full」拿可编辑 ABC。 - 如果你是想学习 AR–NAR 多任务架构的工程师:
modeling_yue2.py:227-304的DecoderLayer+modeling_yue2.py:608-700的nar_velocity是教科书级实现;cuda_graph.py是「纯 PyTorch 写高性能 AR 推理」的范例。 - 如果你是开源项目维护者:YuE2 的工程实践(sha256 manifest、原子写入、契约式 dataclass、CI CPU-only 跑全套、subprocess worker)是值得复用的标准作业。