21K stars 反应式 Python Notebook:marimo 怎么把 Jupyter 的”隐藏状态”连根拔起
一句话总结
marimo 是一个以纯 Python 文件存储的反应式 notebook——运行一个 cell 自动级联所有依赖 cell,从数据结构上消灭 Jupyter 二十年的”隐藏状态”顽疾,并把 notebook、SQL、交互 UI、AI agent 协作统一到 .py 这一个文件里。
值得关注的理由
- 代际差距级挑战者:用静态 AST 依赖追踪 + 数据流图(DAG)重做 notebook 内核,Jupyter 团队至今没追上来;2025-10 被 GPU 云巨头 CoreWeave 收购,验证赛道成立。
- AI 时代的稀缺答案:MCP 协议 +
marimo pair让 Claude/Cursor 直接改 notebook 时数据流保持一致——这是 Jupyter 给不了的能力。 - 5 合 1 工作台:notebook、脚本、WebAssembly HTML、web app、SQL playground 全在一个
.py文件里;同时替代 Jupyter + Streamlit + Jupytext + ipywidgets + papermill。
项目展示
核心反应式数据流
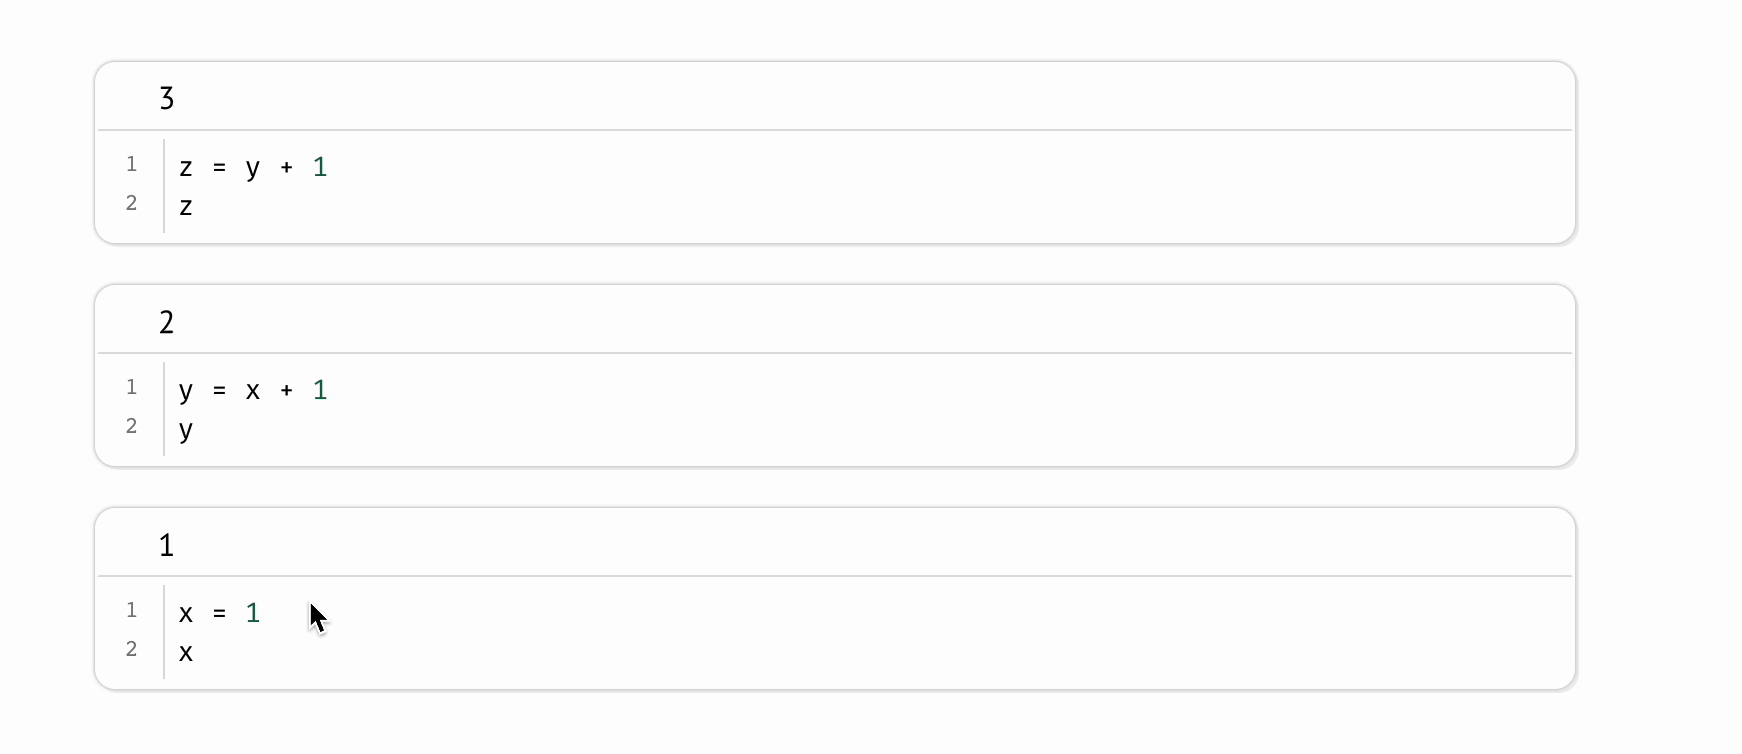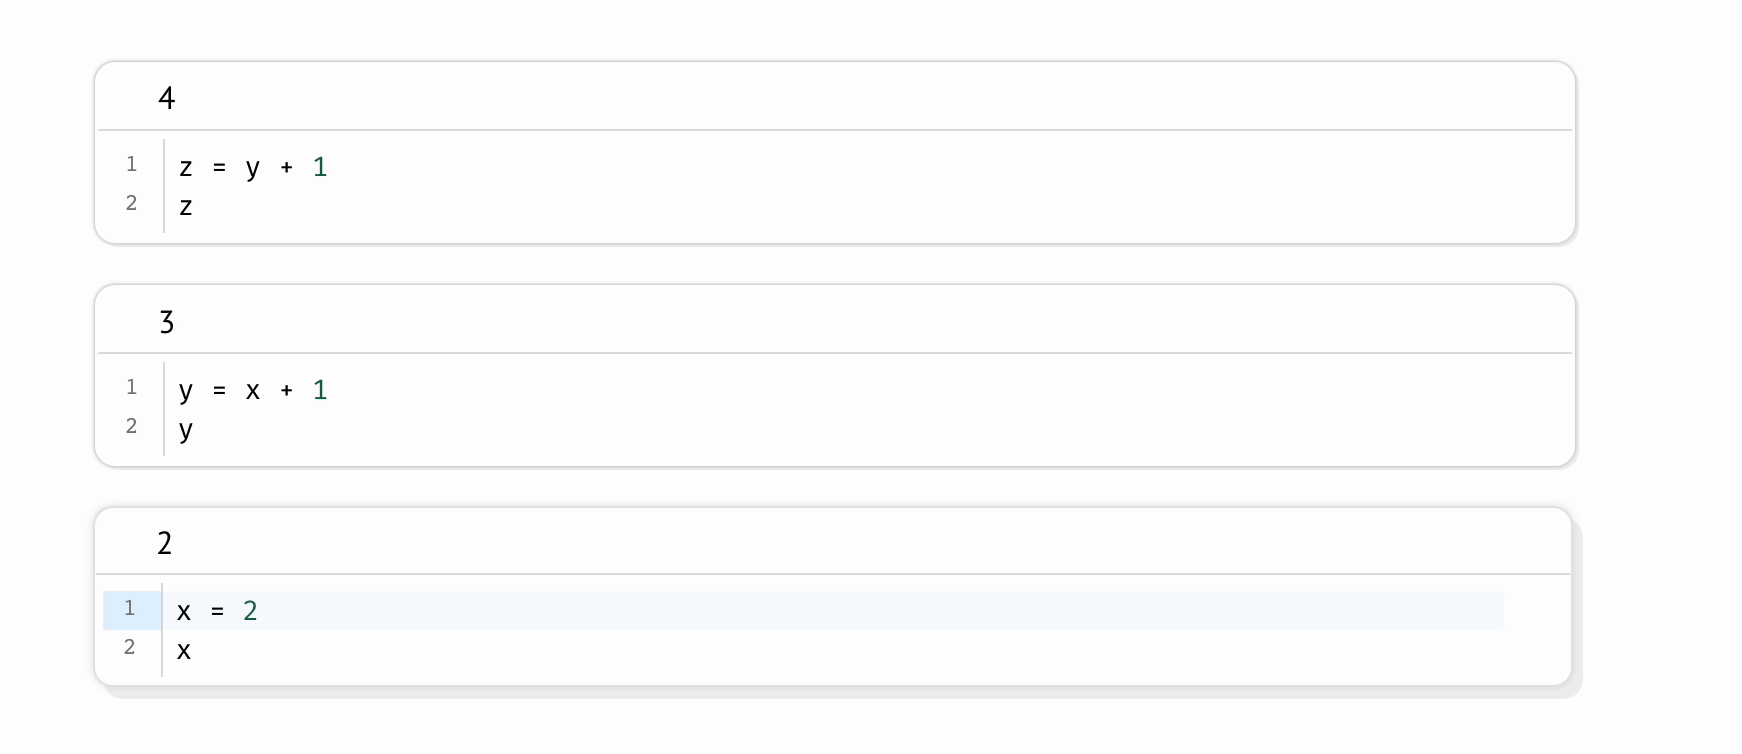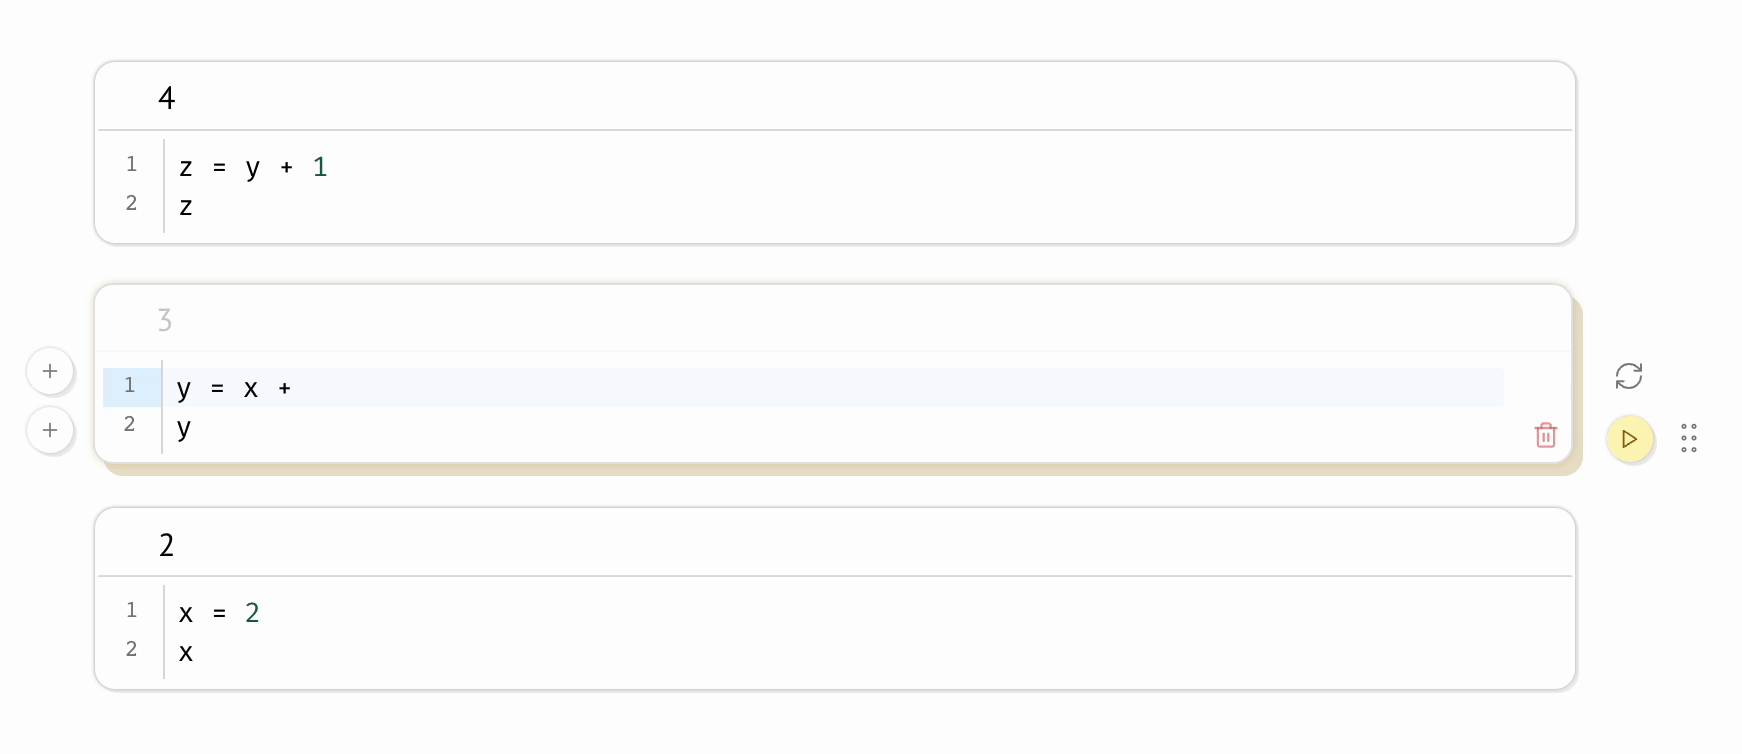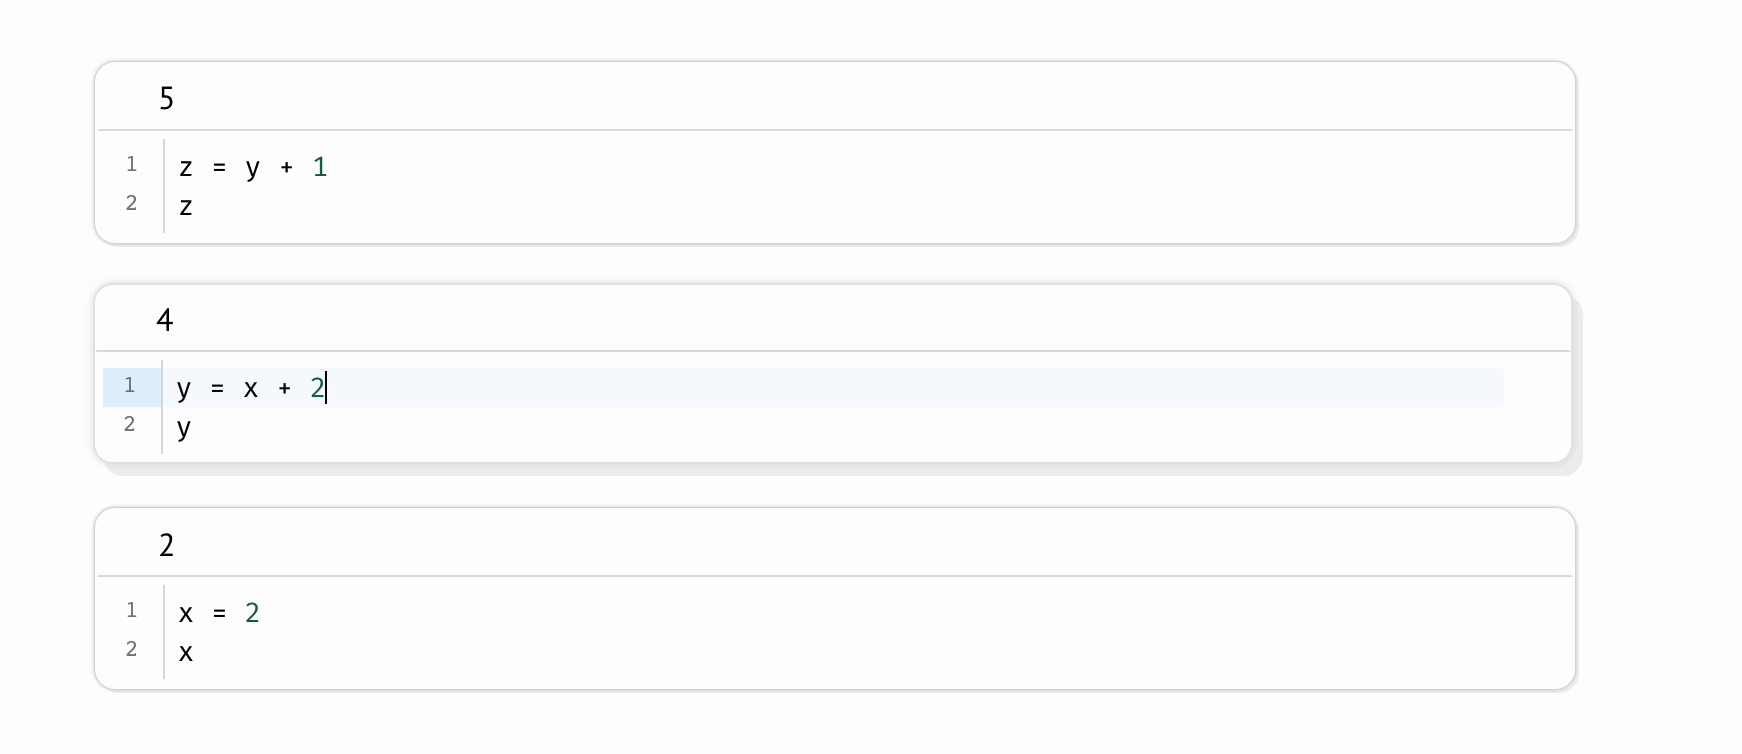 — 类型: demo
运行任意 cell,所有依赖该 cell 的下游 cell 自动重跑——从根上消灭”代码与输出不一致”。
交互 UI 原语(无 callback)
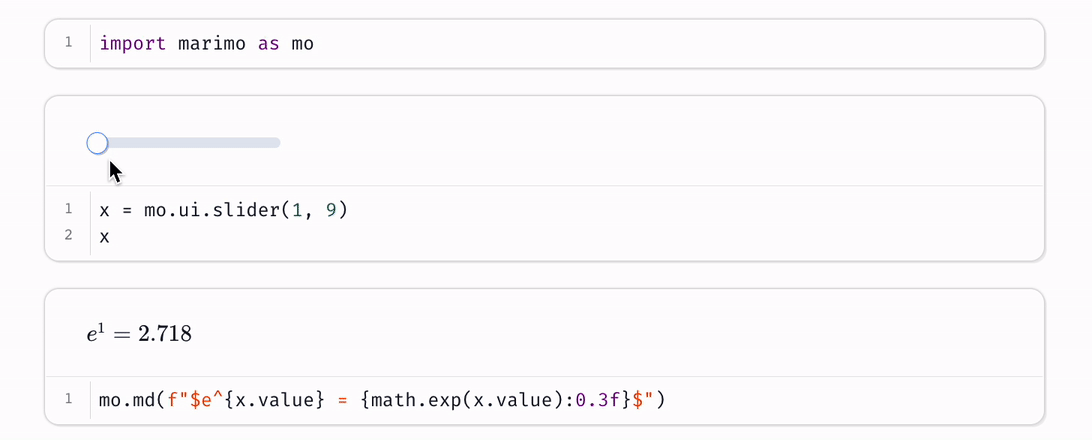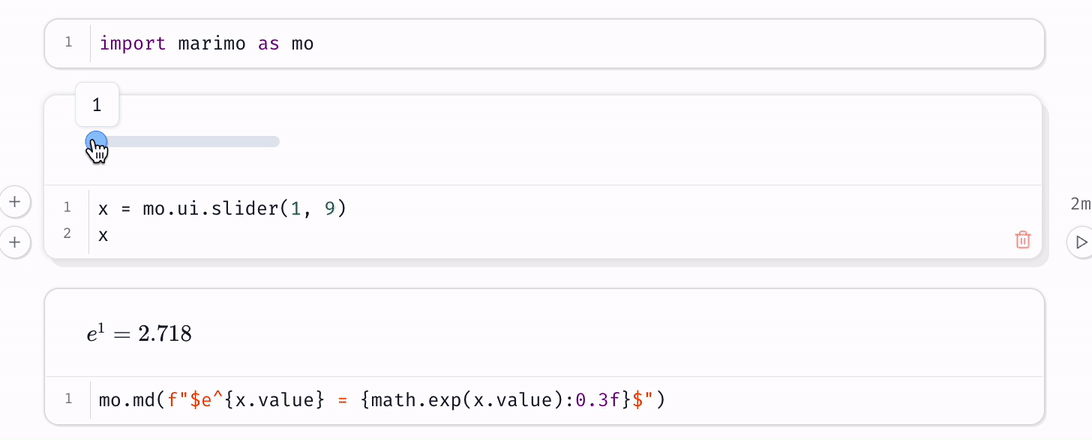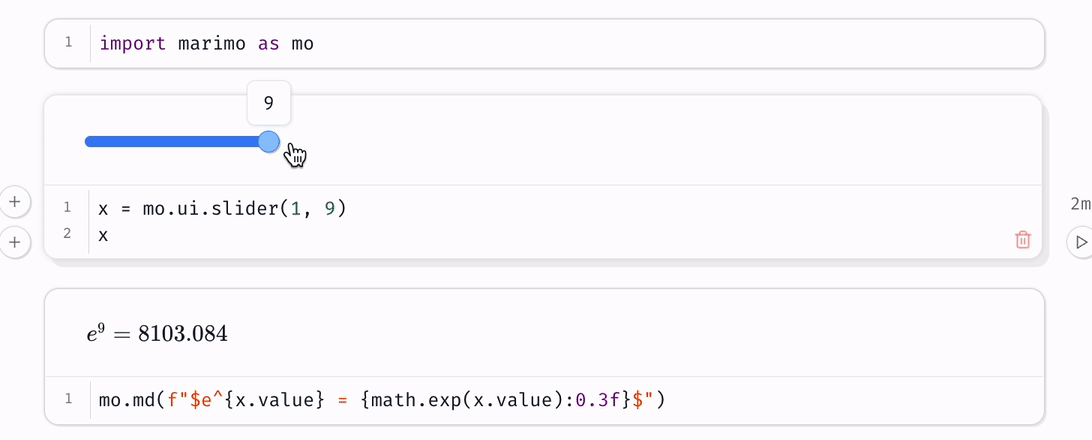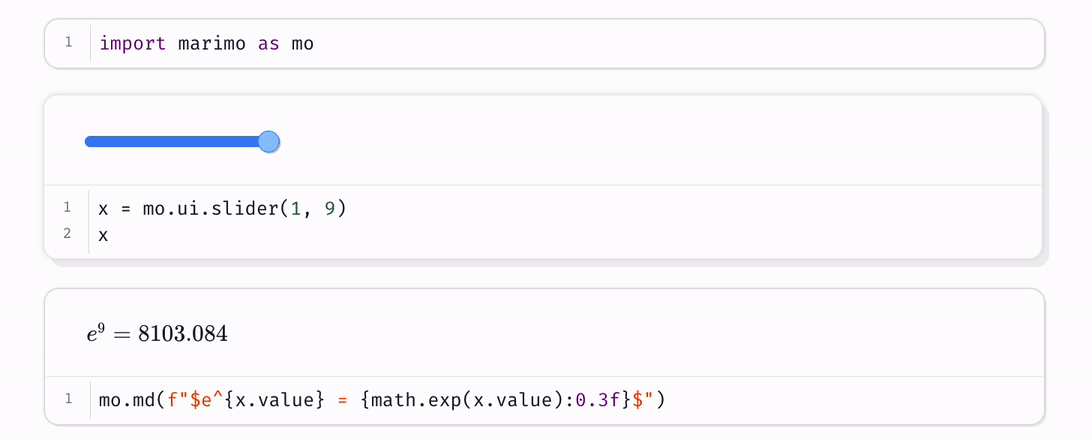 — 类型: demo
mo.ui.slider 返回的对象就是变量,下游 cell 引用即触发重算——告别 observe() 回调。
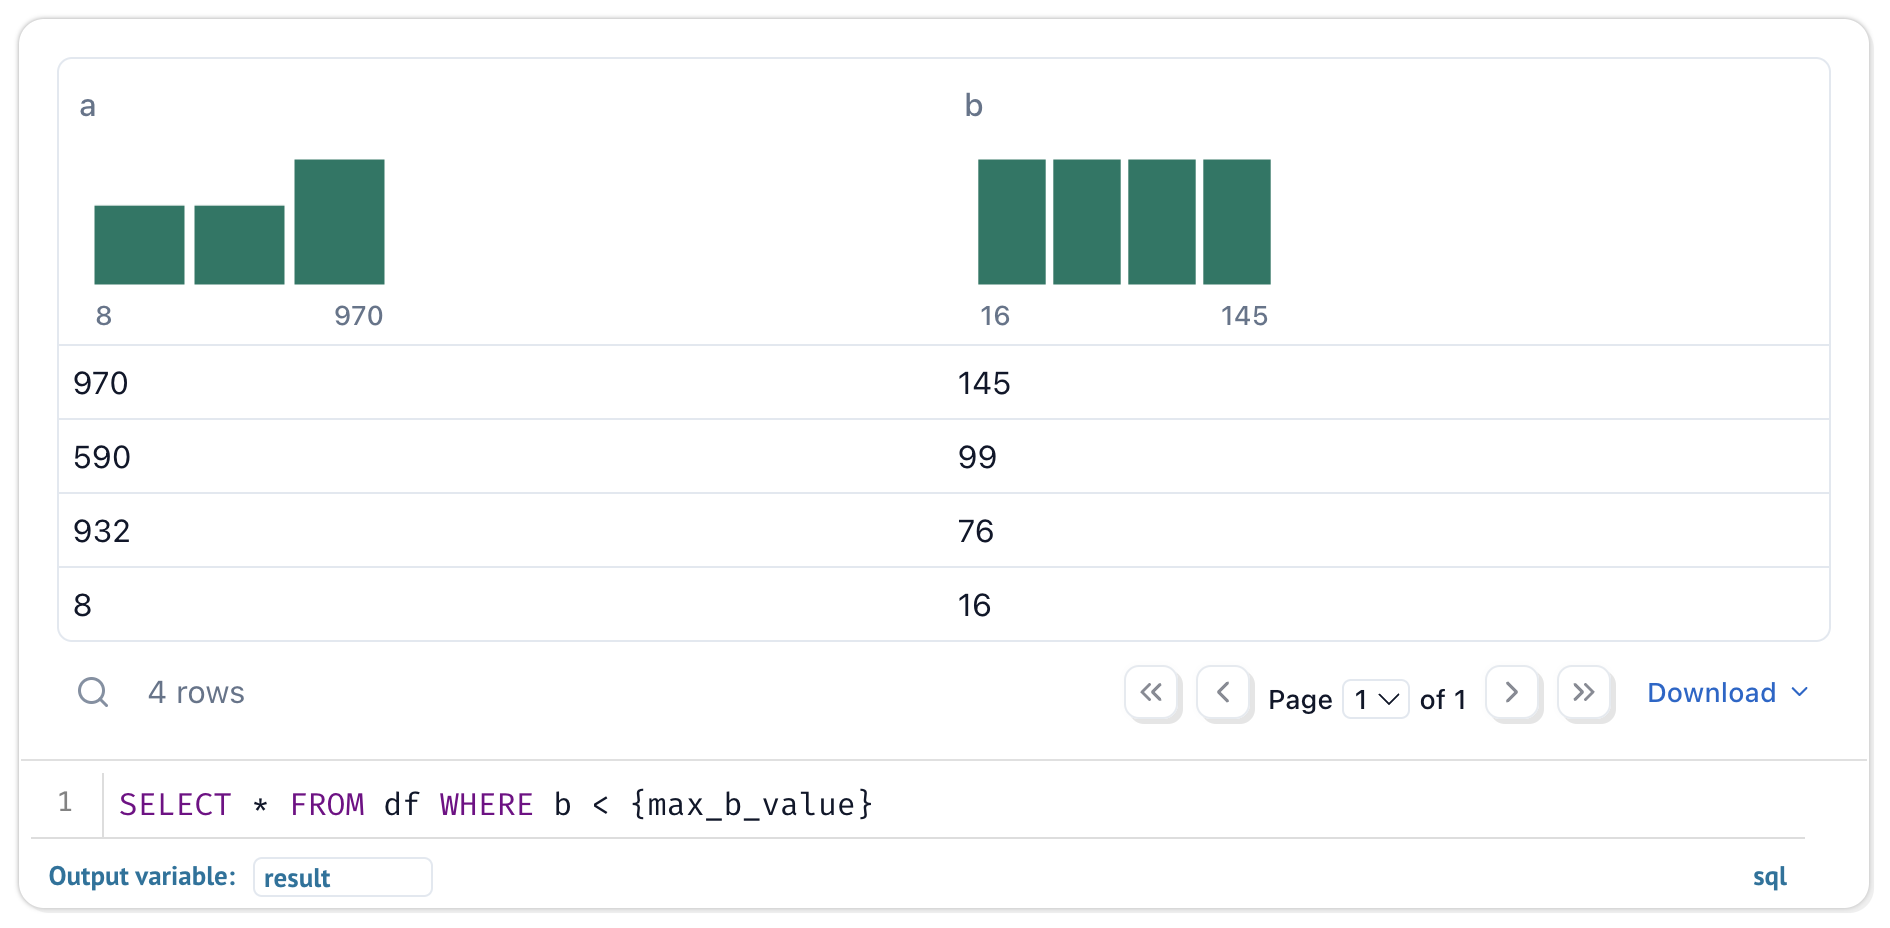
SQL 一等公民
 — 类型: screenshot
mo.sql(f"SELECT ... FROM {df}")——DuckDB/Postgres/MySQL/Snowflake/Iceberg/SQLite 任意切换,dataframe 列自动作为 SQL 上下文。
DataFrame 探索
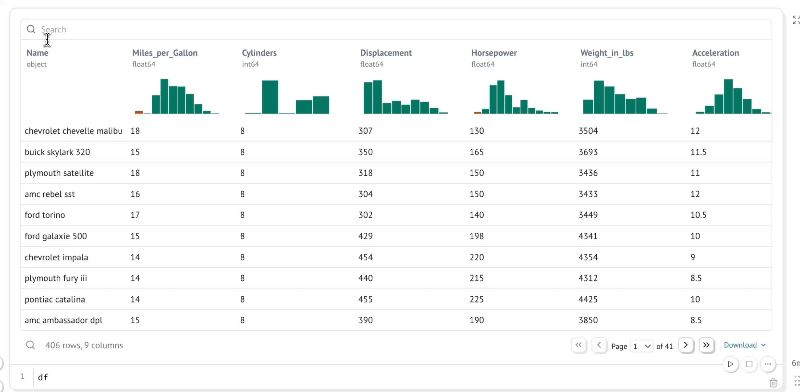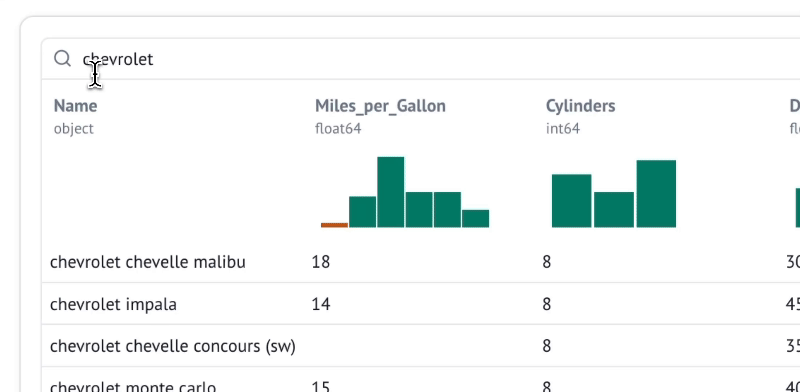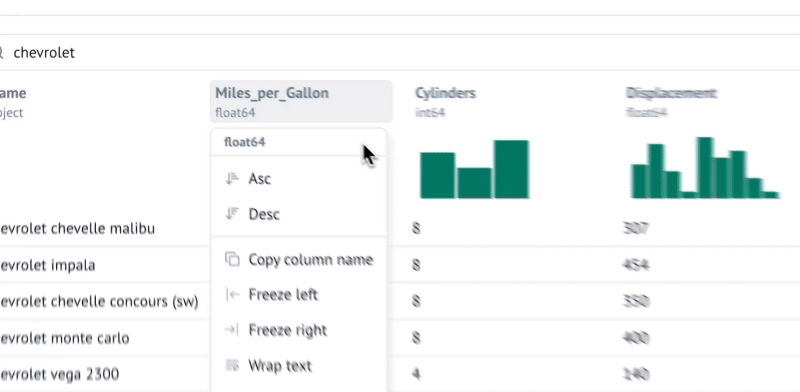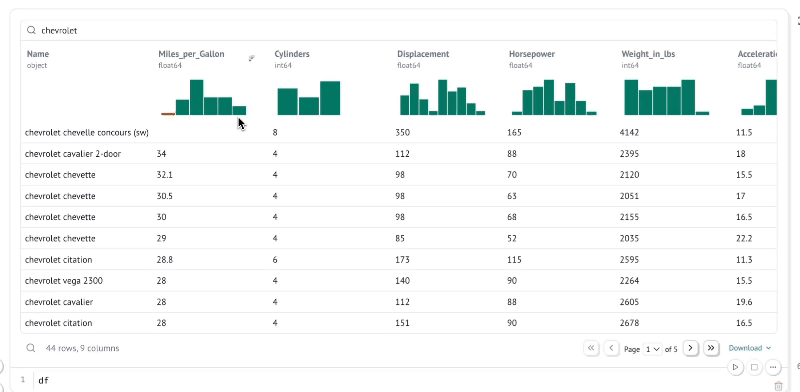 — 类型: demo
视频与在线 Demo:molab.marimo.io(2025-07 推出的云端 notebook 服务,2026-06 接入 CoreWeave GPU)。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/marimo-team/marimo |
| Star / Fork | 21,336 / 1,130 |
| 代码行数 | 585,926 行(Python 56.9% / TypeScript 21.1% / TSX 14.7% / YAML 5.1% / 其他 2.2%),4,180 文件 |
| 项目年龄 | 33.8 个月(2023-08-14 首次提交) |
| 开发阶段 | 密集开发(近 30 天 180 commits,近 90 天 674,近 365 天 2,643) |
| 贡献模式 | 小团队主导 + 社区协作(317 贡献者,Top 1 占比 37.5%,Top 3 约 67%) |
| 热度定位 | 大众热门(5 位数 star 阵营,高速增长:约 15 stars/天) |
| 质量评级 | 代码优秀 / 文档优秀 / 测试充分 |
| License | Apache-2.0 |
| 最新稳定版 | 0.23.9(共 396 tag,100 个 release,语义化版本) |
| 商业化 | Marimo Inc.(2024-11 完成 $5M 种子轮)→ 2025-10 被 CoreWeave 收购 |
作者视角:为什么存在这个项目
创始人/作者背景
Akshay Agrawal(ORCID 0009-0004-6472-0055)和 Myles Scolnick(ORCID 0009-0003-4254-9632)来自机器学习与 Python 工具链背景,分别贡献 1,323 / 2,732 commits。两人在跑 ML 实验时反复撞到 Jupyter 同一个痛点——改一个 cell,忘了重跑,输出和代码对不上。Akshay 2024-05 公开宣战文 Lessons learned reinventing the Python notebook,之后连发三篇哲学文(Reinventing notebooks as reusable Python programs 2025-03 / Python notebooks as dataflow graphs 2025-08 / Turning Python notebooks into AI-Accessible Systems 2025-10),把”数据流图 + 纯 Python 存储 + AI 接入”钉死为项目宪法。
问题判断
Jupyter 看似灵活,本质是五个同时失能:
- 隐藏状态(删 cell 变量还活)——JetBrains 10M 笔记本分析显示 36% 不可复现。
.ipynb是 JSON,不可 git diff、不可python notebook.py、不可被 IDE 正确解析。- UI 控件要手写
observe()callback。 - SQL 是二等公民,dataframe 与数据库要绕一圈。
- AI agent 改 notebook 时无结构化上下文,凭 grep 瞎找。
marimo 创始人看到的是第二个 Jupyter的机会——不是给 Jupyter 打补丁,而是重写存储格式(.py 替代 .ipynb)和执行模型(DAG 替代顺序 cell)。时机为什么是 2023:AST 静态分析(jedi/msgspec)成熟到能在保存时做依赖追踪;Pyodide/WASM 把”notebook 跑在浏览器”做成可量产;2024-2026 的 AI agent 浪潮(Claude/Cursor/MCP)让”可被 agent 编程的 notebook”突然成为新刚需。
解法哲学
- 静态分析,零运行时开销:把反应式做在保存阶段(
marimo/_runtime/dataflow/解析 AST),运行时只做”传播 + 执行”。FAQ 明确承诺”marimo doesn’t slow your code down”——有意放弃运行时 trace 路线。 - 小抽象,大组合:每个能力都是清晰小抽象——
@app.cell/@app.function/mo.ui.slider/mo.sql/mo.persistent_cache,但单仓 “batteries-included” 同时替代 Jupyter + Streamlit + Jupytext + ipywidgets + papermill。 - genuinely open,不是 open-core:Apache-2.0 + GOVERNANCE.md + CLA + Zenodo DOI;用 molab(云端 GPU)/ marimo pair(agent 协作)/ MCP server(AI 接入)走 SaaS 变现,开源版功能没阉割。
- 明确不做什么:不做 ZMQ 内核协议(用 Starlette ASGI + WebSocket 自建);不做
.ipynb双向完美兼容(只单向marimo convert);不做 callback widget(UI 元素即变量)。
战略意图
被 CoreWeave 收购(2025-10)后定位为”AI 时代的可复现 Python 工作台”。三角布局:核心 notebook + 编辑器(开源)、molab(云 GPU 托管)、marimo pair + MCP(AI agent 协作)。CoreWeave 收购兑现了 2026-06 molab 上 GPU——开源工具 + GPU 算力 + AI agent 入口三位一体。
核心价值提炼
创新之处(按新颖度×实用性排序)
- DAG-as-AST:notebook = 数据流图 + 纯 Python 序列化器(
marimo/_runtime/dataflow/5 个子模块:graph/topology/definitions/edges/cycles)。新颖 4/5 / 实用 5/5 / 可迁移 4/5。 - UI 元素即变量(无 callback 反应式 UI):
mo.ui.slider返回对象就是变量,下游 cell 引用自动 re-run;事件经UpdateUIElementCommand转图上”局部重放”。新颖 3/5 / 实用 5/5 / 可迁移 3/5。 - SQL 多后端 duck-typing 引擎路由(
SUPPORTED_ENGINES顺序策略链 +is_compatible探测;dataflow 追踪 SQL 表/列层次引用,dataframe 列作为 SQL 上下文):DuckDB / Snowflake / Iceberg / Postgres / MySQL 不重写代码。DuckDB WASM 还可在浏览器内跑 SQL。新颖 4/5 / 实用 5/5 / 可迁移 4/5。 - Notebook 即 MCP 资源(
marimo/_mcp/):把 notebook 上下文暴露给 Claude/Cursor,让 agent 改代码时数据流保持一致。新颖 4/5 / 实用 4/5 / 可迁移 4/5。 .py即 notebook 存储模型(codegen 反向序列化 +AppKernelRunner/AppScriptRunner双模式):.py可被 git / pytest / ruff / IDE /python notebook.py全部识别。Trade-off 是.ipynb双向转换难。实用 5/5 / 可迁移 5/5。- 多层 cache 矩阵(loader × store 二维:pickle/json/lazy/memory × disk/redis/rest/tiered + 哈希签名持久化):覆盖”内存/磁盘/网络/分层”四象限。新颖 2/5 / 实用 4/5 / 可迁移 5/5。
- Pyodide WASM 自托管(
pyodide/build_and_serve.py静态站,浏览器内完整 kernel + DuckDB WASM):分享即链接,包体大。实用 3/5 / 可迁移 3/5。 - 6 种 cell runtime 状态 FSM(
idle/queued/running/disabled-transitive×success/exception/cancelled/interrupted/marimo-error/disabled)+mo.stop重入控制:换来并发安全。新颖 3/5 / 实用 4/5 / 可迁移 5/5。
可复用的模式与技巧
| 模式 | 适用场景 |
|---|---|
| dataflow 分包(graph facade + topology + definitions + cycles + edges) | 任何数据流引擎的目录组织模板 |
| msgspec.Struct + JSON 通道 + 自动生成 TS 类型 | 高吞吐前后端消息协议(pydantic 5-10x 性能) |
| loader × store 矩阵化抽象 | cache 系统的”格式×介质”二维化设计 |
| SUPPORTED_ENGINES duck-typing 路由 | 插件系统松耦合的策略链模式 |
| Loro CRDT + Starlette 协同编辑 | Python 后端实现轻量实时协作 |
| MCP server 作产品入口 | 老项目接 AI agent 的参考骨架(仅 50 行:setup_mcp_server 接入 StreamableHTTPSessionManager) |
| AST 静态依赖追踪 | ”文档 = 代码”项目的通用模板 |
| Transaction 增量同步协议 | 前后端乐观更新+确认 |
| ContextVar 管理 kernel 单例 | Python 线程安全的全局状态 |
哈希签名持久化缓存(marimo/_save/hash.py) | ML/ETL 实验性 cache |
关键设计决策
决策: .py 即 notebook
问题: .ipynb 是 JSON,git/IDE/pytest/python script 全部失能
方案: codegen 反向序列化 + AppKernelRunner/AppScriptRunner 双模式
Trade-off: 双向 .ipynb 转换难;换来 git / pytest / ruff / IDE 全可用
可迁移性: 高

决策: 静态 AST 依赖追踪
问题: 运行时 trace 开销大且无法在保存时分析
方案: marimo/_runtime/dataflow/ 子包分层,环检测在边加入时即时做
Trade-off: 放弃 exec()/__getattr__ 完美追踪;换来零运行时开销 + 删除 cell 即清变量
可迁移性: 高

决策: UI 元素即变量
问题: ipywidgets 要手写 observe() callback
方案: mo.ui.slider 返回对象就是变量,下游 cell 引用自动 re-run
Trade-off: 失去"局部状态";换来无需 callback
可迁移性: 中

决策: 自建前后端协议
问题: 复用 JupyterLab 协议意味着继承其设计缺陷
方案: Starlette ASGI + WebSocket + msgspec 强类型消息 + Transaction 增量同步 + Loro CRDT
Trade-off: 不能复用 JupyterLab 生态;换来类型安全 + 协作
可迁移性: 中

决策: SQL 多后端 duck-typing 路由
问题: dataframe 与数据库要在 Pandas/Polars/SQLAlchemy 间反复横跳
方案: SUPPORTED_ENGINES 顺序策略链 + is_compatible 探测;dataflow 追踪 SQL 表/列层次
Trade-off: 调试难;换来看 DuckDB/Snowflake/Iceberg 不重写代码
可迁移性: 高
竞品格局与定位
竞品对比矩阵
| 维度 | marimo | Jupyter / JupyterLab | Observable | Pluto.jl | Streamlit |
|---|---|---|---|---|---|
| 反应式执行 | ✅ AST 静态分析 | ❌ 顺序 cell | ✅ JS 引擎内建 | ✅ Julia 编译期类型 | ❌ rerun 整页 |
| 文件格式 | .py 纯 Python | .ipynb JSON | 自有 JSON | .jl 纯 Julia | .py |
| UI 原语 | ✅ 无 callback | ⚠️ ipywidgets 需 callback | ✅ Plot/D3 集成 | ✅ @bind 宏 | ✅ 组件丰富 |
| SQL 一等公民 | ✅ 10+ 引擎 | ❌ 需手写 SQLAlchemy | ⚠️ DuckDB | ❌ 需手写 | ❌ 需手写 |
| AI 集成 | ✅ MCP + marimo pair | ⚠️ Jupyter AI 实验性 | ⚠️ 自有 AI | ❌ 无 | ⚠️ 实验性 |
| WASM 部署 | ✅ 完整 kernel | ⚠️ JupyterLite 有限 | ✅ 浏览器内 | ❌ 无 | ❌ 无 |
| 生态成熟度 | 中(21K stars / 3 年) | 统治(22K+ / 10 年+) | 高(私有) | 小(5K / Julia 专用) | 高(38K / 8 年) |
| Stars | 21k | ~22k | 私有 | ~5k | ~38k |
差异化护城河
- 技术护城河:DAG + 静态分析的反应式内核不可被 Jupyter 短期复制——JupyterLab 7 至今在尝试但路线不同。
- 生态护城河:AI-native(marimo pair + MCP)+ 多后端 SQL(DuckDB/Polars/Snowflake/Iceberg 一行切换)+ 实时协作(Loro CRDT)三层叠加。
- 信任护城河:Apache-2.0 + 正式治理(GOVERNANCE.md / CODEOWNERS / CLA)+ Zenodo DOI + 全职创始团队 + CoreWeave 收购背书。
竞争风险
- JupyterLab 7 + Jupyter AI:Jupyter 团队正在吸收 reactive 思想和 AI 集成,生态基数仍是碾压级别。
- Deepnote / Hex / Observable Canvases 等带 AI 的 SaaS:抢付费市场,molab 起步晚。
- VS Code 战场 2025-11 才 GA:落后 Jupyter 多年,IDE 是命门——开发者离不开 IDE。
生态定位
在 Jupyter(探索)↔ Streamlit(应用)↔ Airflow(pipeline)之间,marimo 是**“AI 时代的 Python 复现性工作台”——把三件事的”可复现 + 可 git + 可 deploy”统一到一个 .py 文件里。AI agent 时代下,marimo 是”agent 改 notebook 但保持数据流一致”**的稀缺答案——这是 molab + CoreWeave + MCP 三件套共同撑起的下一段护城河。
套利机会分析
- 信息差: marimo 21K stars 是大众热门,但在中文技术社区覆盖度远低于 Jupyter;中文文档/教程机会仍在。不是被低估项目,是”被低估的细分场景”——AI agent × 数据科学交叉点。
- 技术借鉴:
dataflow/子包分层模板可直接套到任何”文档 = 代码”项目(DSL notebook、ETL 工具、低代码平台)loader × store矩阵化抽象是 cache 系统的通用设计- msgspec + 自动生成 TS 类型是替代 pydantic 的高性能选项
- MCP server 50 行接入是任何 Python web 服务接 Claude/Cursor 的最小骨架
- Loro CRDT + Starlette 是 Python 后端轻量协同编辑的低成本方案
- 生态位: 填补了”AI agent 时代的可复现 Python 工作台”空白——Jupyter 给不了这个答案,Streamlit 给不了 notebook 范式,Pluto.jl 只服务 Julia。
- 趋势判断: 增长曲线在 2025-10 CoreWeave 收购后明显加速(2025-12 后月度 commit 站稳 200+,2026 年开年突破 250),与 AI agent 浪潮时间窗口重合。后发优势: VS Code 扩展 2025-11 GA 刚补完 IDE 短板,molab GPU 2026-06 刚补完算力短板,2026-2027 是产品完整度补齐 + 商业化兑现窗口。
风险与不足
- 核心团队双核风险:Myles(37.5%)+ Akshay(17%)合计占 55%,bus factor 偏低;2025-10 CoreWeave 收购后核心人员稳定性待观察。
- VS Code 战场迟到:2025-11 扩展才 GA,比 Jupyter 晚 5+ 年,IDE 集成是开发者不可让渡的命门。
- 商业化与开源的边界尚未完全清晰:molab 是云端服务,目前免费 + GPU 计费,但 GPU 资源在 CoreWeave 体系内,开源版与 SaaS 版的长期功能切分有待观察。
- 生态基数差距:Jupyter 22K stars + 几乎所有 ML 库默认支持 + 100+ kernels 跨语言,marimo 21K 仍需 2-3 年才能在生态完整度上对标。
- ipynb 单向转换不可逆:用户从 Jupyter 迁来有 tool,但回不去——锁定风险。
- #3176 持久化缓存仍是 1.0 路线图最大未完成项(39 条评论),从”玩具到生产”的最后一块拼图。
行动建议
-
如果你要用它:
- ✅ 新建 Python 数据/ML 项目首选;尤其是 LLM 应用开发、ETL 探索、ML 实验可复现管理。
- ✅ 想要 “notebook 即 web app” 一键部署(Pyodide WASM / molab 云端)。
- ✅ AI agent 协作场景(marimo pair + MCP 给 Claude/Cursor 数据流上下文)。
- ❌ 跨语言需求(R/Julia/Scala)→ 继续用 Jupyter。
- ❌ 已有大量
.ipynb历史包袱且无迁移计划 → 谨慎评估,marimo convert是单向工具。
-
如果你要学它:
- 核心源码必读:
marimo/_ast/app.py(1.1k 行 App + 装饰器)、marimo/_runtime/runtime.py(2.6k 行 Kernel 唯一执行循环)、marimo/_runtime/dataflow/(1.4k 行 DAG 子包,5 个子模块)。 - 创新点必读:
marimo/_sql/(10+ SQL 引擎 duck-typing 路由)、marimo/_mcp/server/main.py(50 行 MCP 接入)、marimo/_save/(loader × store 矩阵)、frontend/(React + Vite + Loro CRDT)。 - 哲学必读:Akshay 的四篇博客——Lessons learned reinventing the Python notebook / Reinventing notebooks as reusable Python programs / Python notebooks as dataflow graphs / Turning Python notebooks into AI-Accessible Systems。
- 工程实践:
AGENTS.md(仓库根 /marimo//frontend/三份)——给 AI agent 写代码规范的最佳实践。
- 核心源码必读:
-
如果你要 fork 它:
- 多语言 notebook(Rust 内核 + Python DSL?):
marimo/_runtime/dataflow/的静态分析框架可复用。 - 垂直 SQL notebook(专为 Snowflake / Databricks 优化):
marimo/_sql/的多后端路由可作为模板。 - 教学导向 notebook(强调步骤引导 + 防跑偏):
@app.cell/mo.stop/ FSM 状态机可作为控制流基础。 - AI agent notebook(强化 LLM 协作 + 代码生成 + 自我修复):MCP server + marimo pair + Cell 装饰器三件套直接复用。
- 多语言 notebook(Rust 内核 + Python DSL?):
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/marimo-team/marimo — 已收录(2026-04-15 索引),含 4 种执行模式 / DAG 反应式内核 / API / 技术栈 |
| Zread.ai | 未收录 / 不可达(WebFetch 403) |
| 关联论文 | 无(marimo 是工程产品;反应式数据流概念以 blog 形式发布,未在 arXiv 发表) |
| 在线 Demo | https://molab.marimo.io/(云端 notebook,2025-07 上线,2026-06 接入 CoreWeave GPU) |
| 哲学奠基文 | Akshay 博客:Lessons learned reinventing the Python notebook / Reinventing notebooks as reusable Python programs / Python notebooks as dataflow graphs / Turning Python notebooks into AI-Accessible Systems |