GitHub 推荐:4GB 跑 70B:AirLLM 如何用流式加载反量化路线
一句话总结
AirLLM 是一个反主流的「精度无损 + 极低显存」LLM 推理框架,用 layer-by-layer 流式加载让 70B 模型跑在 4GB GPU、405B Llama 3.1 跑在 8GB VRAM——明确不量化、不蒸馏、不剪枝。
值得关注的理由
- 技术路线稀缺:在「不量化就上 GPU」与「量化换显存」之间,airllm 选择了第三条路——用磁盘当内存的延伸。23.6k stars 在「非量化低显存」细分赛道是绝对头部,已确立品类心智。
- 可复用工程模式:meta device + forward hooks 流式注入、weight-only NF4 落盘、shard_num_to_file 严格解析、tied embeddings 永驻 GPU 等设计可迁移到任何「在 transformers 之上做稀疏/分片推理」的场景。
- 明确的商业化故事:airllm → Anima AI → Bloome(多 Agent 云服务)的演化路径完整,是「工程师创业路径」少见的可追踪样本。
项目展示
 — 类型: hero
 — 类型: screenshot,v2 vs 之前的提速(prefetching + 优化 I/O 路径带来的 10% 提升)
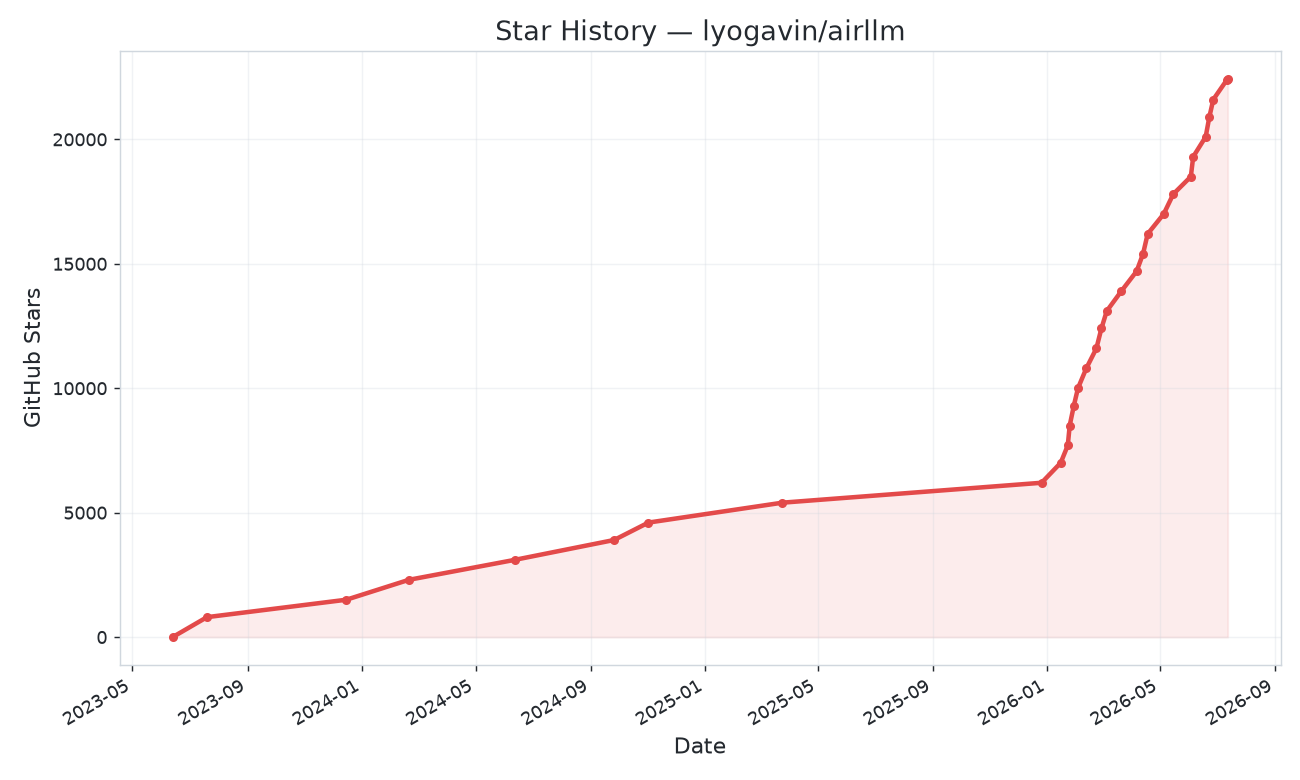 — 类型: screenshot,社会证明
 — 类型: screenshot,反映作者当前商业方向
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/lyogavin/airllm |
| Star / Fork | 23,598 / 2,678 |
| Watcher | 236 |
| 代码行数 | 5,006 行(Python 96.4% / Shell 2.1% / JSON 1.5%),60 文件 |
| 项目年龄 | 37.3 个月(2023-06-12 至今) |
| 开发阶段 | 稳定维护 |
| 贡献模式 | 核心少数 + 社区(11 人,主作者占比 72.3%) |
| 热度定位 | 中等热度(23k stars,分赛道头部) |
| 质量评级 | 代码 B+ 文档 优秀 测试 部分 |
| License | Apache 2.0 |
| 最新版本 | v3.0.1(37 个月仅 2 个 tag) |
作者视角:为什么存在这个项目
创始人/作者背景
Gavin Li(GitHub: lyogavin),Bay area,Anima AI 创始人 & CEO。14.8 年 GitHub 账号,关注结构典型 founder 式(followers 884 / following 11)。公司团队来自 Airbnb / Alibaba / Uber / Yahoo 的 AI 科学家与工程师,定位「让 AI 增强而非替代人类」。68 个公开仓库中真正原创且有产出仅 airllm 一个,其余 fork(skills、ComfyUI、Self-Forcing 等)是个人学习/调研留痕。
问题判断
作者撞上了「公司不发卡但自己又需要 70B 全精度」的供需错位——这不是优化推理速度的需求,而是「能不能跑起来」的硬约束需求。时机精准踩在 Llama 2 70B 开源、Mistral 出圈、ChatGLM/QWen 集体开源的窗口(2023-11 首版)。从 commit 时序看,每个时间点都精准踩「开源最强模型发布日」——2023-12 密集更新、2024-07 跟 Llama 3.1 405B、2026-06 v3.0 + FP8 + DeepSeek-V3,是 GTM-为-新模型 的极致模板。
解法哲学
airllm 明确选择了不做什么:
- 不量化:权重保持 bf16/fp16;4bit/8bit「压缩」只是可选且只为加速 I/O
- 不蒸馏:跑原版 checkpoint,精度与上游社区一致
- 不剪枝:layer 数不变
- 不重写 forward:直接借用 transformers 自身的 generation loop
- 不抢 batch:单 batch 串行流式,与 vLLM 的高吞吐 paged 路线正交
核心价值观:把「模型能跑起来」当公民权利,把「token/s」当奢侈品。Memory hierarchy > arithmetic optimization——磁盘是最大最便宜的 memory,GPU 是最小最贵的,应该让层在两者之间腾挪,而不是把权重挤进 GPU。
战略意图
airllm 是 Anima AI 的「门面开源项目」:README 顶部 Sponsor 链向 bloome.im(AI agent IM 平台)+ godmodeai.co/crazyfaceai.com(AI 玩具/图像编辑)。airllm 自身不直接赚钱,但带来:① 开发者流量(README 多语言 + Colab 模板);② Anima AI 品牌锚点;③ Bloome 平台的二次转化入口。这是「明星个人项目 → 商业化产品」过渡期的典型形态。
无独立 docs 站,主入口即 README +
air_llm/README.md;animaai.cloud 站披露关键叙事「70B 跑 4GB、405B 跑 8GB、不量化不蒸馏不剪枝」。
核心价值提炼
创新之处
按新颖度×实用性排序:
- Meta device + forward hooks 流式注入权重(新颖 4 / 实用 5 / 可迁移 5):在 meta 上建完整 transformers 模型,靠 forward hooks 流式注入每层权重,让任何标准 transformers 模型当天就能流式运行
- Weight-only NF4 落盘 + 推理时反量化(新颖 3 / 实用 5 / 可迁移 4):bitsandbytes 提供 NF4,但「只用它压文件、不用它算 matmul」的用法是 airllm 的 insight——3× I/O 提速 + 几乎无精度损失
- Shard 严格按 index 解析(shard_num_to_file)(新颖 2 / 实用 4 / 可迁移 3):避免 zero-padding width 假设错误(DeepSeek 用 5 位、HF 标准用 2 位)
- Prefetching overlap(新颖 2 / 实用 4 / 可迁移 5):数据库/OS 标准模式应用于 LLM 推理,零成本 10% 提速
- Tied embeddings 永驻 GPU 特判(新颖 3 / 实用 3 / 可迁移 4):其他流式推理框架没处理好这个,会因找不到 lm_head shard 报错
- fp8 + weight_scale_inv verbatim 通道(新颖 3 / 实用 4 / 可迁移 4):避免 fp8 checkpoint 被静默 cast 成 bf16 跑出垃圾结果
可复用的模式与技巧
- 「meta device + forward hooks」模板——任何想包装 transformers 做稀疏/分片推理的库
- 「weight-only NF4 落盘 + 反量化」pattern——任何磁盘 I/O 瓶颈场景
- Shard index 严格解析 + done-marker 持久化——任何吃 HF 多 shard 的工具
- 「AutoModel 按 config.architectures 分发 + 通用 layout 兜底」pattern——任何「复用 transformers/SDK」框架
- 「Monkey-patch .device / .dtype property」黑魔法——任何包装现存框架假装它是另一个 device
- 「tied embeddings 特判」——任何流式 transformers 模型
- Persister 抽象 + 平台注册单例——任何多后端 I/O 库
关键设计决策
决策:在 meta device 上建完整 transformers 模型,靠 forward hooks 流式注入权重
- 问题:要复用 transformers 的 generation 逻辑(KV cache / rotary / sampling)而不重写它
- 方案:
init_empty_weights(include_buffers=False)+set_module_tensor_to_device(..., 'meta')复位 + register_forward_pre_hook/forward_hook 装配 - Trade-off:hook 机制每次有 Python 开销(vs 直接重写 forward),换来「transformers 支持新模型当天就能用」
- 可迁移性:高
决策:per-layer 文件落盘(decomposed persistence)
- 问题:原始 HF checkpoint 是多文件 shard(如 model-00001-of-00004.safetensors),单次加载必然把整层 shards 全读进内存
- 方案:
split_and_save_layers()一次性按model.layers.{i}切分,每层 1 个 safetensors + 1 个.donemarker;空 tied layer 自动跳过 - Trade-off:第一次启动会写 ~2× 模型体积的临时文件;磁盘需要与原始权重相当的空间
- 可迁移性:高
决策:AutoModel 分发 + subclass 兜底
- 问题:transformers 模型家族命名空间不统一(QWenLMHeadModel、ChatGLMModel、LlamaForCausalLM)
- 方案:auto_model.py 维护
ARCH_OVERRIDESdict,按config.architectures[0]命中;其余走AirLLMBaseModel,前提是符合model.embed_tokens / model.layers / model.norm / lm_head标准 layout - Trade-off:需持续维护 overrides;换来「transformers 支持的模型当天就能跑」
- 可迁移性:高
竞品格局与定位
竞品对比矩阵
| 维度 | AirLLM | llama.cpp | Ollama | vLLM | ExLlamaV2 | DeepSpeed ZeRO-Inference |
|---|---|---|---|---|---|---|
| 精度 | bf16/fp16 无损 | 4-8bit 量化 | 4-8bit(底层 llama.cpp) | bf16/fp16 | GPTQ/EXL2 | bf16/fp16 |
| 显存 | 4GB 跑 70B | 4bit 约 20GB | 同 llama.cpp | 24GB+ 起步 | 24GB 跑 70B | 视 offload 配置 |
| 速度 | 慢(磁盘 I/O 主导) | 快(C++ 量化) | 快 | 极快(PagedAttention) | 极快 | 中 |
| 平台 | CUDA / MLX / CPU | CPU + Metal + CUDA + Vulkan | 跨平台 | CUDA 为主 | 仅 NVIDIA | CUDA + CPU |
| 模型格式 | HF 原生 | GGUF(需转换) | GGUF | HF 原生 | 量化后 | HF 原生 |
| 工程语言 | Python + PyTorch | C++ | 跨语言包装 | Python + CUDA | Python + CUDA | Python + DeepSpeed |
| Stars 量级 | 23k | 75k | 100k | 30k | 6k | 36k |
差异化护城河
「精度无损 + 极低显存 + HF 原生」三点合一,无人能复制。其他方案要么量化、要么大显存、要么改格式。这道护城河在「不愿为低显存牺牲推理质量」的用户群(科研、个人爱好者、不方便下量化模型的环境)几乎独占。
竞争风险
- 硬件演进太快:4090/5090 价格下降,4GB 用户池缩小
- 量化精度逼近无损:GGUF/GPTQ 3bit 精度损失下降,「必须 fp16」的人群减少
- Apple Silicon 统一内存:24GB+ M-series 让 macOS 用户脱离 airllm
- DeepSeek FP8 原生 checkpoint:是 airllm 必须跟进的拐点(已跟进 v3.0)
生态定位
AirLLM 是「开源 AI 推理 stack 的 redis-moment」——不追求性能极限,而是把能力边界拉到最远。在 vLLM(高吞吐)+ llama.cpp(量化快)构成的「主流推理栈」之外,开辟了「精度无损 + 极低显存」的第三极。是研究/教育/爱好者场景的基础设施。
套利机会分析
- 信息差:airllm 在中文技术社区关注度相对其 23k stars 量级偏低(早期标签 chinese-nlp/chinese-llm 已淡化),且「精度无损推理」叙事对量化派用户尤其有冲击力
- 技术借鉴:meta device + hooks 流式注入、weight-only NF4、shard index 严格解析这三个模式可直接迁移到 KV cache offload、MoE 稀疏推理、layer-wise RLHF 等场景
- 生态位:填补「不愿量化又没大显存」的用户空白;与 Bloome 多 Agent 云服务的商业化联动是稀缺样本
- 趋势判断:FP8 原生模型增多(DeepSeek-V3、Qwen3)让 airllm 必须跟进但路线依然有效;Apple Silicon 内存扩大反成竞争压力
风险与不足
- 结构性性能硬伤:token/s 显著低于 vLLM/ExLlamaV2,本质是「用时间换显存与精度」。#44「More clever batching of layers」作为长期 open feature-request 反映社区共识——性能瓶颈官方承认但仍未解决
- 安装/分发脆弱:#243「PyPI release broken by dependency drift」反映上游 optimum/transformers 漂移会反复破坏包安装;典型 Python LLM 工具通病
- 多平台兼容性反复打补丁:#79 Mixtral / #59 qwen / #116 mac m2 / #240 optimum 等历史 issue 都是闭合并补
- bus factor 低:核心作者占比 72.3%~94.6%(不同口径),单点故障风险高;近期 commit 主题向 Bloome 商业化倾斜(“Bloome sponsor links to new tracked URL”),纯 airllm 维护节奏在降
- 代码质量参差:in-code commentary 天花板级,但测试覆盖率低(核心 streaming 仅 CLI 手动测试)、无 lint/type check、utils.py 单文件 445 行职责过载、print 调试散落各处
- 版本发布稀疏:37 个月仅 2 个 tag,版本复现和兼容性定位成本高
- 用户体验落差:#258「AI 玩具开箱即失败」(19 评论)显示大量用户期望「像 Ollama 一样一键」但实际需要 layer sharding 预处理——卖点真实,但上手门槛是隐藏摩擦
行动建议
- 如果你要用它:适合「不愿意为低显存牺牲推理精度」的边缘场景(4GB GPU 跑 70B 全精度做评测对照实验、Colab 免费卡跑超大模型做实验)。不适合生产高吞吐服务(用 vLLM)、不适合个人笔记本日常对话(用 Ollama)。预期 token/s 个位数到两位数,做好心理准备
- 如果你要学它:重点阅读三个文件就够——
air_llm/airllm/airllm.py(主推理实现)、air_llm/airllm/airllm_base.py(基础抽象,含 architecture 说明 docstring)、air_llm/airllm/utils.py(layer 切分/压缩/加载)。in-code commentary 是天花板级学习材料 - 如果你要 fork 它:
- 把核心 streaming 路径加上自动化测试(目前只有 CLI 手动)
- 加入 ruff + mypy(1881 行核心代码零 lint)
- 把 utils.py 拆成 loading/splitting/compression 三个模块
- 增加 batching 支持(#44 长期痛点)
- 把 print 调试换成 logging
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/lyogavin/airllm |
| Zread.ai | 未收录(Cloudflare 403 拦截) |
| 关联论文 | 无(核心技术更像工程经验沉淀而非学术创新) |
| 在线 Demo | 无独立 playground;Anima AI 商业化云服务 Bloome(https://bloome.im) |