个人开发者 3 个月 5.4 万 star:Understand-Anything 把代码库变成会教学的知识图谱
一句话总结
Georgia Tech 硕士、个人开发者 Yuxiang Lin 用 2.8 个月、近乎单人做出的现象级项目——一个跑在 Claude Code/Cursor/Codex 等 14+ AI coding agent 里的插件+技能,把任意代码库变成可点击、可搜索、可提问的「会教学」的知识图谱。它的真正创新不在算法(tree-sitter/louvain/dagre 全是现成件),而在三条工程纪律:把 LLM 死死约束在「只填语义、确定性的事交脚本、校验也交脚本」的反幻觉范式里、用结构指纹分级增量把 token 成本压下来、把贵的多 agent 分析固化成可入库可离线探索的纯 JSON 资产。
值得关注的理由
- 「AI 时代独立开发者杠杆」的极端样本:一个人 2.8 个月、561 commit、做到 5.4 万 star(launch 5 天破千),且作者研究方向(graph-based RAG / memory / multi-agent)与项目高度对口——这不是偶然爆款,是学术兴趣的精准工程化落地。它是研究「个人开发者如何借 AI agent 生态杠杆做出现象级项目」的绝佳案例。
- 当下最该抄的 LLM 工程范式:「确定性骨架 + LLM 只填语义 + 脚本做校验」——agent 被显式禁止做任何能确定性计算的事(文件枚举、import 解析全交 tree-sitter 脚本),LLM 只贡献「这块代码属于哪个业务流程」这类语义;连图谱完整性校验都要求 agent 现写校验脚本跑、而非目测。这条反幻觉纪律对任何「用 LLM 产结构化数据」的生产管线都直接适用。
- 「贵分析一次、离线消费无限」的资产化设计:图谱产物是纯 JSON(21 节点类型/35 边类型),生成一次后 dashboard 完全脱离 LLM 运行、可 commit 进 repo 全队共享、新人 day-one 打开即用——这是对「多 agent 流水线烧 token」痛点的产品级正面回应,也是相对 DeepWiki 云服务的本地/隐私差异化。
项目展示
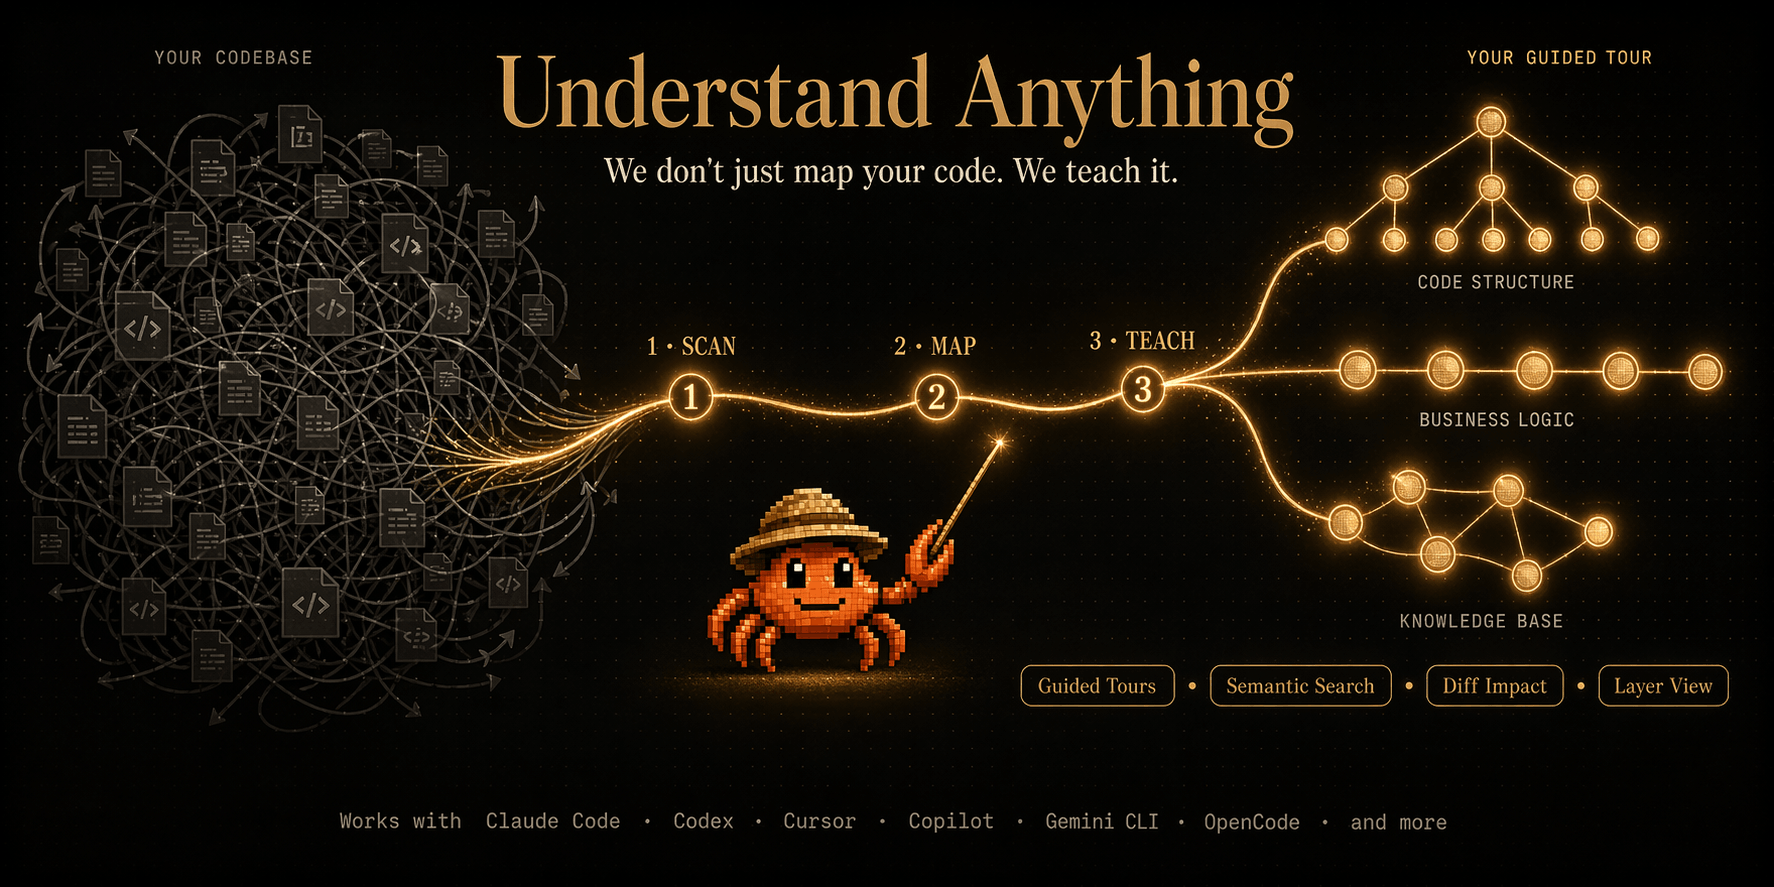
把任意代码库变成可交互的知识图谱。
在线 Demo(以 microservices-demo 为样例的交互式知识图谱):https://understand-anything.com/demo/
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/Lum1104/Understand-Anything |
| Star / Fork | 54,292 / 4,473 |
| 代码行数 | 55,866 行(TypeScript 42.9% + TSX 12.4%[dashboard React] + Python 5.3%;其余 YAML/JSON 为配置、prompt 资产与图谱数据) |
| 项目年龄 | 2.8 个月(2026-03-14 起,极新) |
| 开发阶段 | 密集开发(近 90 天 561 commit,即全部提交集中在 3 个月内爆发) |
| 贡献模式 | 个人主导(Yuxiang Lin/Lum1104,占 86.7%,type User 个人账号) |
| 热度定位 | 大众热门 · 现象级病毒项目(2.8 个月 0→5.4 万 star) |
| 质量评级 | 代码[优秀] 文档[优秀] 测试[充分] |
作者视角:为什么存在这个项目
创始人/作者背景
个人开发者 Yuxiang Lin(Lum1104)—— Georgia Tech 电子与计算机工程硕士、AI Engineer,曾 Tencent/Baidu 实习,研究方向多模态大模型/情感计算,并明确兴趣 Graph-based RAG / Memory Systems / Multi-agent Collaboration(已发 Emotion-LLaMA NeurIPS 2024、另有 MER-Factory 等开源作品)。本项目(代码→知识图谱 + 增量记忆 + 多 agent 流水线)几乎是其研究兴趣 1:1 的工程化落地,技术血统完全对口——非偶然爆款。单人主导(占 86.7%)。
问题判断
README 用「20 万行代码从哪看起」破题:新人/审计者面对陌生大型代码库无从下手——传统手段要么人肉读代码,要么靠云端 wiki 被动问答。作者看到三个缺口:① DeepWiki/Zread 这类云服务要把代码上传第三方(隐私 + 单 repo 被动问答,无本地交互式图谱);② 纯静态分析只画依赖结构(imports/calls),不解释「这文件干什么、属哪个业务流程」——graph that impress 而非 graph that teach;③ 纯 LLM 方案不可复现、烧 token、会幻觉出不存在的边。时机上踩中 Claude Code Plugin/Skill 生态 2025 成熟 + 「让 AI 真正理解整个 repo」成为公认痛点的窗口期。
解法哲学
三条清晰价值观:
- 确定性归确定性,语义归语义:贯穿全代码库的最强信号——能确定性算的(文件枚举/import 解析/校验)绝不让 LLM 算,LLM 只填「意图」这层人/解析器都给不了的语义空格。
- AI-Native but Not AI-Locked:产物刻意做成纯 JSON,生成一次后 dashboard 完全脱离 LLM 运行、可 commit 进 repo 全队共享——对 token 成本(#46)的产品级回应。
- 本地优先 + 分发优先于深度:宁可把一份技能逻辑铺到 14+ 平台、6 种语言、26+ 文件类型,也不做某平台的重度集成。明确不做:云托管、自研解析器(全用 tree-sitter)、重型图算法(louvain/dagre/ELK 都用现成库)。
战略意图
目前 genuinely open(MIT,无 open-core 阉割、无付费墙),有官网 + Discord + Trendshift 徽章,呈现「打造个人技术品牌 + 抢占『AI 代码理解』入口心智」的姿态。/understand-knowledge(分析 Karpathy 式 LLM wiki)暴露更大野心:从「理解代码」扩张到「理解任意知识库」——产品名「Understand Anything」不是修辞。真实风险是可持续性:单人 2.8 个月 54k star,却已背上 14 平台 × 6 语言 × 8 skill × 12 语言解析器的维护面,bus factor = 1。
核心价值提炼
创新之处
- 「确定性骨架 + LLM 只填语义 + 脚本做校验」的反幻觉纪律(新颖度 4/5,可迁移性 5/5):不是泛泛「tree-sitter + LLM 混合」,而是在 prompt 层强制约束——project-scanner 反复强调「Do NOT re-implement file enumeration / import resolution」,全部委派给 bundled 脚本(tree-sitter 做 12 种语言 import 解析、语义分批、归一去重);graph-reviewer 更要求「写一个校验脚本并执行,绝不手工读图校验」。LLM 只贡献 summary/层命名/导览/业务域映射。结构侧可复现(同代码恒同边),语义侧捕意图。这是当下最被低估、最该抄的工程范式。
- 结构指纹三级变更分类驱动的增量更新(新颖度 3/5,可迁移性 5/5):
fingerprint.ts对每文件存内容 SHA-256 + 函数/类/import/export 签名指纹;change-classifier.ts分 NONE/COSMETIC/STRUCTURAL → SKIP/PARTIAL/ARCHITECTURE/FULL 决策矩阵。纯改函数内部逻辑(COSMETIC)根本不触发任何 LLM 调用,配合 git hooks 自动增量——直接压低 token 成本(#46)。 - 产物即资产:纯 JSON 知识图谱(21 节点/35 边类型),生成与探索彻底解耦(新颖度 4/5):图谱固化为
.understand-anything/knowledge-graph.json,dashboard 纯读 JSON 离线运行、搜索/路径查找/导览都不再调 LLM;README 直接教用户把图 commit 进 repo(大图用 git-lfs)全队共享。「贵分析做一次 → 落成可版本化产物 → 廉价消费无限次」。 - 「教学型图谱」的 schema 编码(新颖度 4/5):schema 里把 domain/flow/step 做成独立节点类型,
flow_step边的 weight 用分数编码步骤顺序(1/N,2/N…);domain-analyzer 强制「用代码里真实业务术语、不许编造不存在的流程」。这是「graphs that teach > graphs that impress」从口号落到数据结构的地方。 - 多 agent 流水线 + 健壮归一层(新颖度 3/5):7 阶段编排 9 个专职 sub-agent(project-scanner/file-analyzer/architecture-analyzer/domain-analyzer/graph-reviewer 等),每步产物落中间 JSON 解耦;
merge-batch-graphs.py(49KB) 对 LLM 不守规矩的输出做大量防御性修复(解 envelope、改 legacy 字段、翻转边方向、丢悬空边)——「永远假设 LLM 会偏离 schema 并写归一层兜底」。
可复用的模式与技巧
- Constrained-LLM pipeline:确定性能算的绝不让 LLM 算,LLM 只填语义空格,校验用脚本不用 LLM——所有 LLM 生成结构化数据的生产系统。
- Fingerprint-gated incremental recompute:内容哈希 + 签名指纹分级决定重算粒度——增量索引/文档/缓存失效/CI 选择性重跑。
- Expensive-once, explore-free artifact:贵分析产可版本化 JSON,消费端零 LLM——把 LLM 重计算转成静态产物。
- Single-source, multi-target distribution:一份逻辑 + 薄清单/软链铺 14 平台——开源开发者工具最大化触达的标准打法。
- Defensive normalization layer for LLM output:假设 LLM 偏离 schema,编排侧/合并脚本统一兜底修复——多 agent 编排必备。
- Worker-offloaded lazy graph layout:布局丢 Web Worker(dagre)+ 容器折叠 + 位置缓存——大规模图/树前端可视化。
关键设计决策
| 决策 | 解决的问题 | Trade-off | 可迁移性 |
|---|---|---|---|
| LLM 被显式禁止做确定性工作,只产语义叙事 | LLM 直接读代码画图不可复现、烧 token、幻觉出不存在的边 | 牺牲「纯 prompt 即跑」轻量性(首跑要 pnpm install + build core,#385 摩擦源),换可复现 + 降幻觉 + token 可控 | 高 |
| 结构指纹三级变更分类增量更新 | 每次提交全量重跑 5-6 agent 烧 token 不可接受 | 无 tree-sitter 的语言保守判 STRUCTURAL(宁可错杀) | 高 |
| 纯 JSON 图谱产物,生成与探索解耦 | 云服务每次探索都重调 LLM、图谱无法沉淀共享 | 图谱随代码漂移变陈旧(靠增量缓解)、大图入库膨胀 | 高 |
| dashboard 两阶段惰性布局 + Web Worker + 容器折叠 | 大库大图 dashboard 卡顿(#76) | store 大量 cache-invalidation 逻辑繁琐易错;数千节点对 React Flow 仍是真实压力 | 中 |
| 一份技能逻辑 → 14 平台软链分发 | 覆盖 Claude/Cursor/Copilot/Codex/Gemini 等异构平台 | 受「最低公分母」约束,各平台兼容性差异是 issue 来源 | 高 |
竞品格局与定位
竞品对比矩阵
| 维度 | Understand-Anything | DeepWiki | GitNexus | 纯静态分析 |
|---|---|---|---|---|
| 形态 | 本地 agent 插件 + 离线 dashboard | 云服务 wiki+Q&A | 纯客户端图谱+Graph RAG | IDE 调用图 |
| 隐私 | ✅ 本地,代码不出门 | ❌ 上传云端 | ✅ 本地 | ✅ |
| 教学型图谱 | ✅ 业务域/流程一等公民 | wiki 文档 | 结构图谱 | ❌ 仅结构 |
| token 成本 | 首跑高、探索零 | 用户侧零 | 中 | 零 |
| 安装摩擦 | 高(pnpm/build,#385) | 零(URL 即开) | 低 | 低 |
| Stars | 54k(2.8 月) | 云服务 | ~14k | — |
差异化护城河
主要是信任/心智护城河(54k star + Trendshift + 14 平台覆盖)与工程纪律护城河(constrained-LLM + 健壮归一层 + 增量引擎的大量 battle scar,复刻容易但调到稳难)。算法上无护城河——tree-sitter/louvain/dagre/ELK 全是现成件,核心价值在组合方式与产品框架,可被有资源的团队复制。
竞争风险
最可能被 DeepWiki 这类云入口靠「零摩擦 + 品牌」蚕食增量用户(无安装/无 token/任意 URL 即开);或被某大厂在 IDE 内置同类功能降维打击。自身痛点:首跑 token 成本(#46)、大图 dashboard 性能(#76)、安装链路对非资深用户摩擦(#385)。最大问号是可持续性——bus factor = 1,14 平台 × 6 语言的维护面对单人是沉重负担。
生态定位
「跑在你本地 AI coding agent 里的代码理解层」——填补了「云端被动 wiki(DeepWiki)」与「纯结构静态分析」之间的空白,是 AI coding assistant 生态的一个理解/onboarding 插件。整体「代码库→AI 自动 wiki/图谱」是红海(DeepWiki/Zread/GitNexus/RepoWiki 林立),但本项目以「本地插件 + 教学型可交互图谱 + 14 平台一行装 + JSON 产物离线/可入库共享」切出差异化细分位。
套利机会分析
- 信息差:并非被低估,而是已兑现的现象级项目。真正的稀缺价值在叙事层——「一名个人开发者 3 个月近乎单人做出 5.4 万 star」是绝佳的「AI 时代独立开发者杠杆」选题素材,而非「捡漏低估仓库」。
- 技术借鉴:constrained-LLM pipeline、fingerprint 增量重算、expensive-once 资产化、单源多端分发、LLM 输出防御性归一、Web Worker 惰性图布局——这些与「代码图谱」解耦的工程范式,任何 LLM 生产管线/开发者工具可直接借走。尤其「确定性骨架 + LLM 只填语义 + 脚本校验」是当下最该抄的范式。
- 生态位:填补「本地、教学型、可入库共享的代码知识图谱」空白。
- 趋势判断:「让 AI 理解整个 repo」是真需求且持续火热,本项目踩中窗口。但无算法护城河 + 单人维护 + 与 DeepWiki 云入口的零摩擦优势对比,可持续性存疑——它能否守住地位取决于工程打磨速度与社区/贡献者扩张,而非不可复制的技术壁垒。
风险与不足
- 首跑 token 成本高:多 agent 流水线(5-6 agent 编排)烧 token 是「跑在你自己 agent 里」架构的根本代价(#46)。
- 大图性能痛点:20 万行代码 → 数千节点对 React Flow dashboard 是真实压力,仍是 open issue(#76)。
- 安装摩擦:首跑要 Node≥22 + pnpm install + build core,病毒增长涌入的非资深用户安装/命令注册踩坑(#385)。
- 无算法护城河 + bus factor=1:核心件全是现成库,护城河在心智与工程纪律;单人背 14 平台 × 6 语言维护面,可持续性是最大问号。
- 图谱会漂移陈旧:随代码演进需 auto-update 缓解;大图 JSON 入库膨胀。
行动建议
- 如果你要用它:用 AI coding assistant、要快速理解陌生大型代码库(onboarding/审计/交接)、在意隐私(代码不出本机)、且能接受首跑 token 成本——
/understand一条命令很值。注意它是「理解」工具不是「写代码」工具;只想即开即用问答、不在意云端选 DeepWiki。 - 如果你要学它:重点读
understand-anything-plugin/skills/understand/SKILL.md(7 阶段「大脑」prompt 编排)、agents/9 个子 agent 提示词(多 agent 流水线 + 反幻觉约束)、packages/core的 fingerprint.ts/change-classifier.ts(增量引擎)、图谱 JSON schema(domain/flow/step 编码)、merge-batch-graphs.py(LLM 输出归一)、dashboard 的 Web Worker 布局。这是「constrained-LLM + 资产化 + 增量」工程范式的活教材。 - 如果你要 fork 它:低价值(已是现象级 + 无算法壁垒)。真正该抄的是工程范式——constrained-LLM pipeline、fingerprint 增量、expensive-once 资产化、防御性归一层,迁到自己的 LLM 生产系统。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/Lum1104/Understand-Anything(已收录,14 章节,2026-06-06 更新) |
| Zread.ai | 未验证(返回 403) |
| 关联论文 | 无(本项目无论文;作者另有 Emotion-LLaMA NeurIPS 2024,与本仓库无直接关系) |
| 在线 Demo | understand-anything.com/demo(microservices-demo 交互式知识图谱) |
| 社区视频 | Better Stack walkthrough (YouTube) · Hacker News 讨论 |
| 外部深度视角 | Understand Anything Review (theaiway.net)(「理解」工具非「写代码」工具,token 成本/大图性能是真实痛点) |