3.3K 行种子自己长出技能树:复旦团队的自进化 agent,与它只靠一纸 Markdown 的安全边界
一句话总结:GenericAgent 是复旦知识工场(梁家卿团队)+ 深圳 A³ LAB 出品的极简自进化通用 agent——约 3.3K 行种子(~100 行 loop + 9 个原子工具)+ 把习得技能沉淀为 markdown SOP「技能树」,对电脑/浏览器/安卓/硬件键鼠全系统控制,主打 token 高效。范式新颖、学术血统真实、国产 computer-use 现象级;但「全系统自主控制」的权限边界只写在 markdown 里、无沙箱硬隔离,dual-use 风险被显著低估。
值得关注的理由
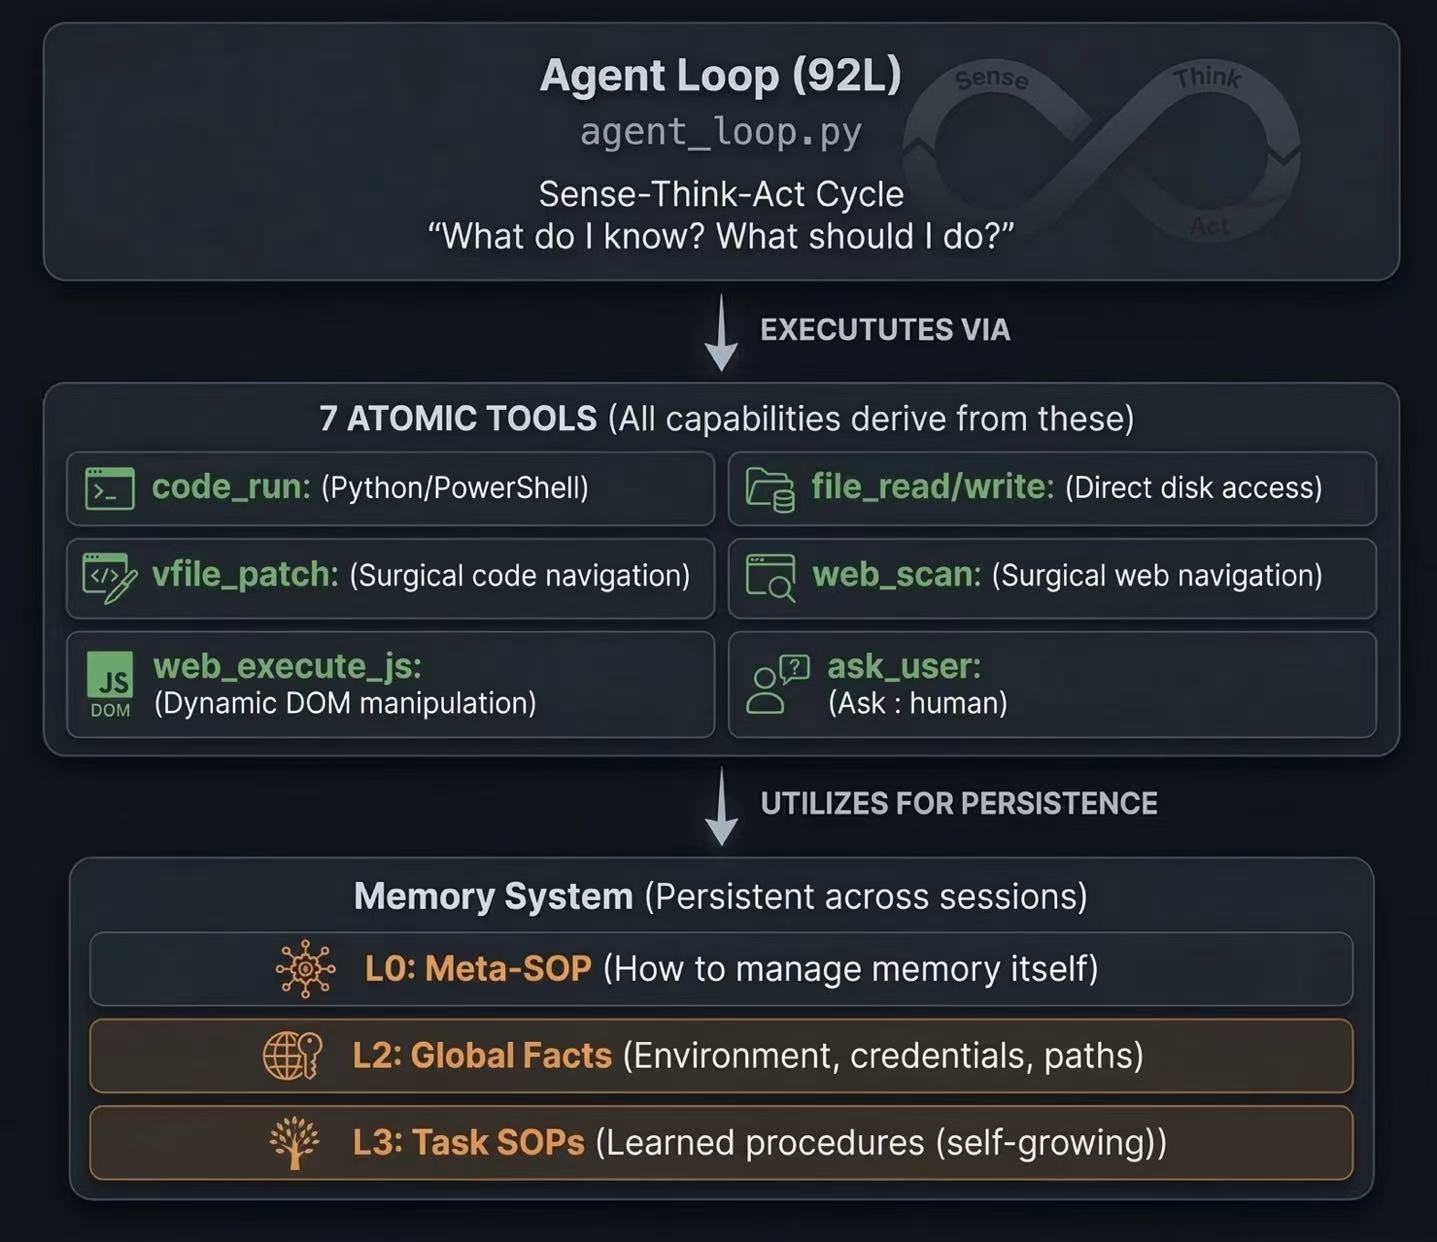
- 「极简种子 × markdown 技能树自生长」是新颖范式。核心是约 100 行的 agent loop + 9 个原子工具,把习得的技能蒸馏成可读、可生长、可审计的 markdown SOP(而非硬编码工具)。这是把 Voyager 的「技能库自进化」从游戏沙盒泛化到真实操作系统的工程化尝试。
- 学术血统真实,非纯营销。作者梁家卿(lsdefine)是复旦大数据学院青年研究员、知识工场(肖仰华团队)体系、经典
attention-is-all-you-need-keras作者;有 arXiv 技术报告(2604.17091)+ 五维 benchmark + 产学落地(政务机器人 DintalClaw)。 - 现象级国产 agent 热度。4.7 个月 12.6K star、Trendshift 收录、机器之心两度报道、Datawhale 出官方教程、20+ 微信群——且有真实生产采纳,非看 demo。
- 它把「token 经济学」摆上台面。核心命题「上下文信息密度最大化」——性能不取决于 context 长度,而取决于有限预算内的决策相关信息密度。这是对「堆 200K-1M 上下文」主流路线的反向思考。
- 它也是一个必须正视的安全样本。一个能驱动带登录态浏览器 + 文件系统 + 键鼠 + 支付宝/微信 + 安卓 + 硬件键鼠的自主 agent,权限边界却只是 markdown 里的几行自律——这是介绍它时绕不开的风险。
项目展示
README 含本土化能力 Demo(自然语言 → 全系统自动执行):
Demo GIF(外卖下单/量化选股/ADB 驱动支付宝记账)见
assets/demo/;社交卡片兜底:https://opengraph.githubassets.com/1/lsdefine/GenericAgent
项目画像
| 维度 | 数据 |
|---|---|
| 全名 | lsdefine/GenericAgent |
| 定位 | 极简自进化通用 agent(~3.3K 种子 + 9 原子工具 + markdown 技能树 + 全系统控制) |
| Star / Fork | 12,670 ⭐ / 1,461 🍴(CSV 抓取 10,372,高速增长) |
| License | MIT |
| 主语言 | Python 85.3%(28K)+ JS 8.1%;总 32,848 行 / 146 文件;注释比 0.154 |
| 建库时间 | 2026-01-16(极新,约 4.7 个月) |
| 开发节奏 | 813 commit;近 90 天 661、近 30 天 248;密集开发 |
| 贡献者 | 66 人,梁家卿主导(~478 commit,54.9%)+ 复旦/深圳团队 + 社区 |
| 作者 | 梁家卿 lsdefine(复旦大数据学院 · 知识工场 · Keras Transformer 作者) |
| 出品 | A³ LAB(深圳 Aquaintelling Technology × 复旦大学) |
| 学术 | arXiv 2604.17091(通讯作者肖仰华);落地政务机器人 DintalClaw |
| 核心种子 | agent_loop.py 133 + ga.py 595 + agentmain.py 308 + llmcore.py 1068 + web ~1.1K ≈ 3.3K |
代码量真相:账面 32.8K 行中,核心种子仅约 3.3K(loop 本体 65 行),
frontends/多 UI(TUI v1/v2/v3、Qt、Telegram、Streamlit)+assets/configure_mykey.py(1406) 占了大头——「3.3K 种子」指极简内核属实,非整仓。
作者视角
问题发现
作者是知识工程(KG+LLM)背景,长期研究「如何在有限表示里最大化有效信息」。把这套直觉迁到 agent 上,发现行业在「堆 context 窗口」的方向上越走越重,而真正瓶颈是信息密度而非容量。技术报告点出长程 agent 两个根本瓶颈:① 上下文爆炸(工具描述、检索记忆、原始反馈累积淹没决策信息);② 经验无法沉淀复用(多数框架把每个 episode 当无状态,成功策略随上下文过期遗忘——「token 随任务线性增长、能力却平坦」)。
解法哲学
三条一以贯之:① 极简种子——核心可读、可自举(README 宣称仓库每条 commit 都由 GA 自主完成);② 信息密度最大化(CIDM)——不扩 context,而用分层按需记忆 + 上下文截断压缩,让 prompt 里始终是高密度决策信息;③ 进化而非预设(don’t preload skills, evolve them)——只给 9 个原子工具做「创世资本」,技能靠解决真实任务时蒸馏出来,长成一棵每个用户独有的技能树。
背景知识迁移
KG/IR 的「最小充分指针」「索引→事实→记录」分层思想直接映射成记忆架构(memory/memory_management_sop.md):L1 索引层硬约束 ≤30 行(像知识图谱的 schema/索引)、L2 事实库、L3 程序性 SOP、L4 会话归档。「No Execution, No Memory(无行动不记忆)」公理本质是 KG 里「事实需可验证溯源」原则。embedding 检索被明确否定(报告称其「存原始日志而非蒸馏知识」),改用关键词触发的显式索引——这是 IR 派对向量检索的不信任。
战略图景
产学落地(DintalClaw 政务 bot、Sophub 技能 hub、Datawhale 教程),把「self-evolving agent」做成可传播的范式 + 技能共享生态。差异化卡位在西方厂商不会碰的中文场景(微信/支付宝/美团 via ADB)+ 极简可审计种子 + token 经济。
核心价值提炼
创新点
1. 上下文信息密度最大化(CIDM)作为统一设计原则 — 新颖度 4/5 · 实用性 5/5 · 可迁移性 4/5
把「agent 性能取决于 context 长度」重构为「取决于有限预算内 decision-relevant 信息密度」,用 4 机制系统落地:极简原子工具(密度 before 执行)+ 分层按需记忆(只保留 always-on 索引层在 prompt)+ 反思自进化(密度随时间复利)+ 上下文截断压缩(压力下保密度)。适用:所有长程、成本敏感的 agent。
2. 索引常驻 + 明细按需 file_read 的分层记忆 — 新颖度 4/5 · 实用性 5/5 · 可迁移性 5/5
L1≤30 行硬约束索引常驻 prompt,L2/L3 靠关键词触发显式 file_read 拉取,明确弃用 embedding 检索。「最小充分指针」「No Execution No Memory」「神圣不可删改」三公理治理。这是本仓最值得抄的设计——比无脑 RAG 更适合 agent。
3. ~100 行 loop + 每轮只传新消息、历史下沉 Session — 新颖度 3/5 · 实用性 5/5 · 可迁移性 5/5
agent_loop.py 每轮只构造一条新消息,完整历史由 llmcore 的 Session 持有;loop 本体仅做「组 prompt → chat → 解析 tool_calls → dispatch → 回灌」,生成器流式输出。极简到可一眼读完的内核。
4. 验证成功才入库的三阶段技能蒸馏 + 闲时自驱进化 — 新颖度 4/5 · 实用性 4/5 · 可迁移性 4/5
start_long_term_update 触发结算,**只提取「行动验证成功」**的信息:环境事实→L2、坑点/前置→L3 精简 SOP、高复用逻辑→code_run 写成 .py 工具固化;reflect/autonomous.py(闲置 30 分钟自主探索)/goal_mode.py(时间预算)/scheduler.py(cron)在无人时驱动进化。
5. 9 原子工具 + code_run 元工具覆盖全系统 — 新颖度 3/5 · 实用性 5/5 · 可迁移性 4/5(须自配隔离)
只保留 9 个原子工具(code_run/file_read/file_patch/file_write/web_scan/web_execute_js/update_working_checkpoint/ask_user/start_long_term_update),code_run 是万能逃生舱(执行任意代码、动态装包、控硬件、把临时能力固化成永久工具)。工具描述极省 context,但 code_run 无沙箱。
6. 保登录态真实浏览器 + UIA→vision 降级 + 硬件键鼠绕反作弊 — 新颖度 4/5 · 实用性 4/5 · 可迁移性 3/5
不用 headless/sandbox 而 CDP 注入真实浏览器(TMWebDriver.py,保登录态);GUI 走 UIA→ui_detect→vision 降级链;网游用 Arduino Leonardo 硬件输入绕反作弊。
可复用模式
- Loop 编排与历史压缩分离:loop 只管编排,历史/裁剪/缓存下沉 Session 层 — 任何要保持内核可读的 agent。
- 原子工具 + code 元工具:少量原子工具 + 一个任意代码执行器替代庞大专用工具集 — token 敏感的通用 agent(务必补沙箱)。
- 索引常驻 + 明细按需读取:≤N 行关键词索引常驻,明细靠 file_read 触发 — 替代 embedding RAG 的 agent 记忆。
- 验证后蒸馏入库:只有工具调用验证成功的经验才写入分层记忆 — 避免错误经验污染的终身学习 agent。
- 闲时自驱 + 时间预算 goal mode:无人值守按 SOP 自主探索 / 预算内持续打磨禁止提前交付 — 后台长跑优化型 agent。
- 降级感知链:UIA→ui_detect→vision、u2→native dump — GUI/移动端自动化。
关键设计决策
- 上下文截断/压缩双层维持密度(token 效率真身):
llmcore.py默认 30K 窗口;trim_messages_history先折叠旧消息的 thinking/tool 标签、不够再 force 压(keep_recent=4)、再不够从最老 user 边界整段 pop;工作记忆锚点每轮重注入(最近 30 轮逐字 + 更早折成每轮一行摘要)+ prompt caching。Trade-off:小窗口内维持高密度、缓存省钱;但真·长程任务会丢早期上下文,30K 是天花板(呼应 #417 死循环)。 - 技能即 markdown SOP(可读/可生长/可审计):技能 =
memory/24 个*_sop.md+ 配套.py,纯文本人和 agent 都能读改、git 可追踪。Trade-off:透明可审计;但同一份 markdown 既是技能库又是安全边界载体——可读即可被 prompt 注入改写。
竞品格局
| 竞品 | 定位 | 优势 | 劣势/差异 |
|---|---|---|---|
| GenericAgent(本项目) | 极简自进化通用 agent | ~3K 种子、markdown 技能树自生长、全系统控制(含登录态/支付/安卓/硬件)、token 高效、中文场景 | 安全仅 markdown 软约束无沙箱、长上下文可靠性存疑、测试近零、6x 待独立验证 |
| Voyager(技能库自进化鼻祖) | Minecraft 自进化技能库 | 学术开创性、技能复用证明 | 单一游戏环境、非通用系统控制(GA 是其桌面泛化版) |
| OpenHands / OpenClaw | 开源自主开发 agent | 社区大、沙箱执行、benchmark 强 | 重型(~53 万行)、多服务编排、无 markdown 技能自生长 |
| Open Interpreter | 本地代码执行 agent | 轻量、上手快、同源 code 元工具 | 能力面窄、无技能树自进化、无跨设备 |
| Claude Code / Codex CLI | 厂商编码 agent CLI | 模型强、生态成熟、稳定 | 会话间无状态、偏编码、不跨设备、上下文高消耗 |
| Anthropic Computer Use / OpenAI Operator | 厂商 computer-use | 原生能力、带沙箱 + 品牌信任 | 闭源、绑厂商、单环境、无自进化沉淀 |
关键对照轴:① 轻量种子(~3K / 9 原子工具)vs 重型框架;② markdown SOP 技能树自生长 vs 固定工具集;③ 全系统/跨设备(电脑+浏览器+安卓+硬件键鼠)vs 单环境;④ <30K 上下文 token 高效 vs 200K-1M 高消耗;⑤ 模型无关 vs 绑厂商。最贴切对标 = Voyager(技能库范式)+ OpenHands(重型反面)。
综合结论——护城河:极简可自举种子 + markdown 技能树自进化 + 全系统控制(含登录态/支付/社交/安卓/硬件)+ token 高效 + 中文场景适配(西方厂商不会碰)。竞争风险:① 安全是 markdown 软约束、无沙箱,企业级难采用;② 长上下文可靠性存疑(#417 死循环、30K 是双刃);③「6x」省 token 未经独立同行评审、benchmark 部分自建;④ 测试近乎为零、注释极低,工程成熟度风险;⑤ 厂商级 computer-use(带沙箱 + 品牌信任)可能从上方碾压「全系统控制」卖点。生态定位:面向极客/研究/中文自动化的轻量自进化 agent + 技能 hub,走「小而进化」差异化。
安全与风险(重点专节)
- 全系统控制面:
code_run无沙箱执行任意代码(ga.py直接subprocess.Popen跑临时.ai.py);web_execute_js任意 JS = 保登录态真实浏览器完全控制(CDP 注入,非 headless);文件读写改;ljqCtrl.py键鼠 + vision;adb_ui.py驱动安卓(demo 直接操作支付宝转账查账、微信批量发消息、美团下单);硬件键鼠(Arduino Leonardo)绕游戏反作弊。这是一个能碰钱、能碰社交、能碰硬件的自主 agent。 - 权限仅 markdown 软约束、无硬隔离:唯一权限边界写在
memory/autonomous_operation_sop.md——「无需批准:只读+cwd 写;需待审:改 SOP/装软件/外部 API/删非临时文件;绝对禁止:读密钥/改核心代码/不可逆操作」。这些是纯 prompt 级自律,代码层无任何 enforcement。grep 全仓确认:sandbox一词只出现在 README 描述竞品,GA 自身无沙箱/容器/权限校验。 - prompt 注入 = 直接武器化:
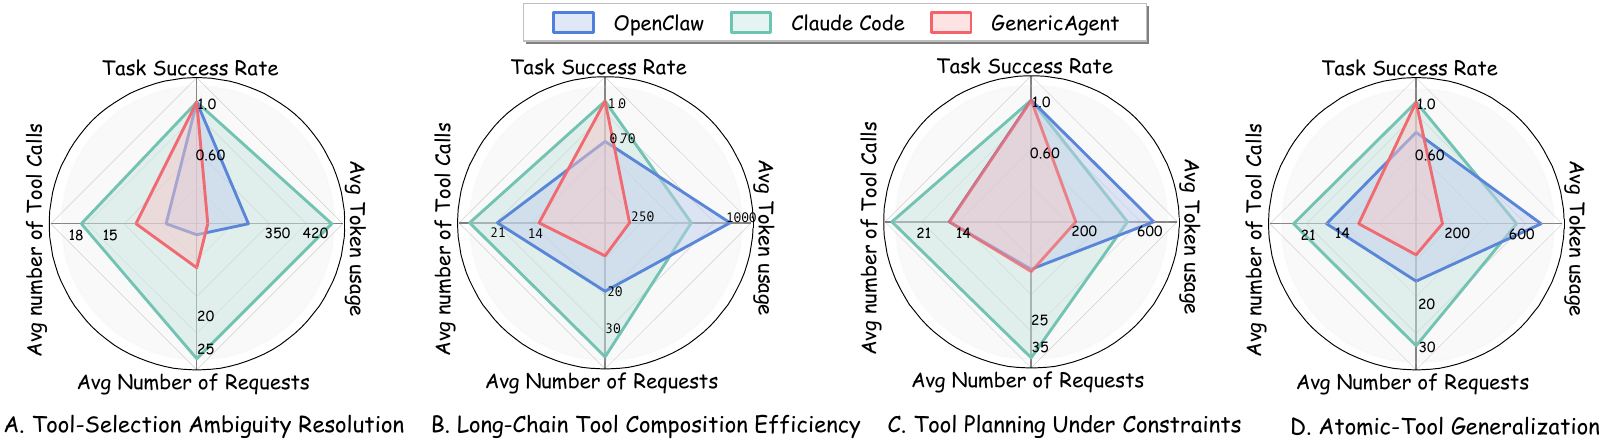
web_scan把页面 HTML 喂回模型;恶意网页/文档里的注入指令可被当作任务,而 agent 手握 code_run + 登录态浏览器 + 文件系统 + 键鼠 + 支付/社交 + 安卓。无隔离意味着一次成功注入即可越过那几行 markdown 红线,做不可逆破坏或资金/隐私泄露。dual-use 风险极高。 - 「6x token」卖点成色:架构机制(30K 窗口 + 分层按需记忆 + 截断压缩 + 缓存)在代码中确实存在且合理,省 token 方向可信。但精确数字(~1/6 token、九轮 -89.6% token/-78% 时长/-84% 调用)来自 README 与技术报告,PDF 摘要本身只写「significantly fewer tokens」并无「6x」;benchmark 多为同团队自建、arXiv 未经同行评审。结论:方向真实、精确倍数待独立验证,且 30K 强约束在 >50K 真长程任务下可能退化/死循环(#417)。
- 测试与可靠性:0 个测试文件、无
tests/、813 commit 中仅约 0.4% 提及 test、无 CI。一个能接管全系统的 agent 却几乎没有自动化测试与回归保障,可靠性主要靠运行期软护栏 + 用户在环。
套利机会分析
- 对做 agent 框架的开发者:「~100 行 loop + 历史下沉 Session」「索引常驻 + 明细按需 file_read」「验证后蒸馏入库」是三个高价值可复用范式,比无脑 RAG/重型框架更优雅。
- 对做 token 成本优化的团队:CIDM 思路 + 分层记忆 + 上下文截断压缩是降本的成体系参考(30K 窗口跑长任务)。
- 对做桌面/移动自动化的人:保登录态真实浏览器(CDP)+ UIA→vision 降级链 + ADB 安卓控制是完整的全系统控制参考(但务必自补沙箱)。
- 对内容创作者:「3.3K 行种子长出技能树」「国产 computer-use 现象级」「复旦学者下场做自进化 agent」「全系统控制只靠一纸 markdown 的安全争议」都是有张力的选题。
- 谨慎使用立场:作为研究/学习范式价值高;作为生产工具需自行加沙箱隔离、且充分评估全系统权限风险。
风险与不足
- 安全无硬隔离(最严重):全系统控制 + 权限仅 markdown 软约束 + 无沙箱 + prompt 注入可武器化——dual-use 风险被显著低估。
- 长上下文可靠性:30K 窗口既是 token 高效的优势,也是天花板;>50K 真长程任务下暴露死循环(#417)。
- 6x token 待独立验证:机制真实但精确倍数源自自建 benchmark + 未评审 arXiv 报告,需打折看待。
- 测试近乎为零:0 测试文件、无 CI、test commit ~0.4%——能接管全系统的 agent 却无自动化保障。
- 前端膨胀 + 注释极低:32K 行里核心种子仅 3.3K,frontends/ 多 UI 占大头;核心文件注释比极低(agent_loop.py 为 0),可读性靠精炼而非解释。
- 错误经验可能被固化:技能蒸馏靠 LLM 自律 + markdown 规则,无客观验证闭环,「验证成功才写」缓解但非根治。
行动建议
- 学它(首选):精读
agent_loop.py(~100 行 loop)+ga.py(9 原子工具)+llmcore.py(上下文压缩)+memory/memory_management_sop.md(分层记忆)+reflect/autonomous.py(自进化)。CIDM + 分层记忆 + 技能蒸馏是范式级可学资产。 - 用它(谨慎):
pip install即可跑;但因无沙箱,强烈建议在隔离虚拟机/容器内运行,且不要授予真实支付/社交账号的登录态;充分了解全系统权限风险。 - fork 它:MIT 可二次开发;若产品化,第一优先补硬隔离沙箱 + 权限 enforcement + 测试/CI。
- 客观看卖点:6x token 方向可信但精确数字待独立验证;「全程 agent 自举」叙事性强但不可独立验证。
知识入口
| 入口 | 链接 | 用途 |
|---|---|---|
| GitHub 仓库 | https://github.com/lsdefine/GenericAgent | 源码 / Issue |
| 技术报告 | arXiv 2604.17091 | 《Token-Efficient Self-Evolving LLM Agent via CIDM》 |
| 复现/评测 | https://github.com/JinyiHan99/GA-Technical-Report | 五维 benchmark + BibTeX(A³ LAB×复旦) |
| 官方教程 | Datawhale hello-generic-agent | 入门教程 |
| 技能 Hub | Sophub(fudankw.cn) | 技能共享生态 |
| DeepWiki | https://deepwiki.com/lsdefine/GenericAgent | AI 架构导览 |
| 核心源码切入点 | agent_loop.py / ga.py / llmcore.py / memory/*.md / reflect/ | 架构研读起点 |
| 作者 | lsdefine.github.io(梁家卿,复旦知识工场) | 学术背景 |