GitHub推荐:3个月2577星:wigolo如何把 Agent 网页能力搬回本地
一句话总结
wigolo 是一个以 MCP 为核心入口的本地 Web 基础设施,把搜索、抓取、抽取、缓存、研究和引用证据整合进一个无需 API Key、按查询零计费的 Agent 工具层。
值得关注的理由
- 在很短时间内验证了需求:项目创建于 2026 年 4 月,约 3.3 个月累计 2,577 个 Star、153 个 Fork,同时保持 1,887 次 commit 的密集开发节奏。
- 解决的是 Agent 的真实基础设施问题:Firecrawl、Tavily、Exa 等服务解决了「让模型访问网页」,但通常依赖云端 API、按量计费;wigolo 试图把这条链路搬到用户自己的机器上,并让查询结果可追溯、可缓存、可复用。
- 技术取舍具有迁移价值:信号驱动的抓取梯、RRF 多引擎融合、byte-offset 证据、端侧重排序和统一 SSRF 防护,都是可以脱离 wigolo 复用到 RAG、爬虫和 Agent 工具中的工程模式。
项目展示
项目的核心叙事是:把原本依赖云 API 的 Web 能力放到 Agent 所在的本机上。
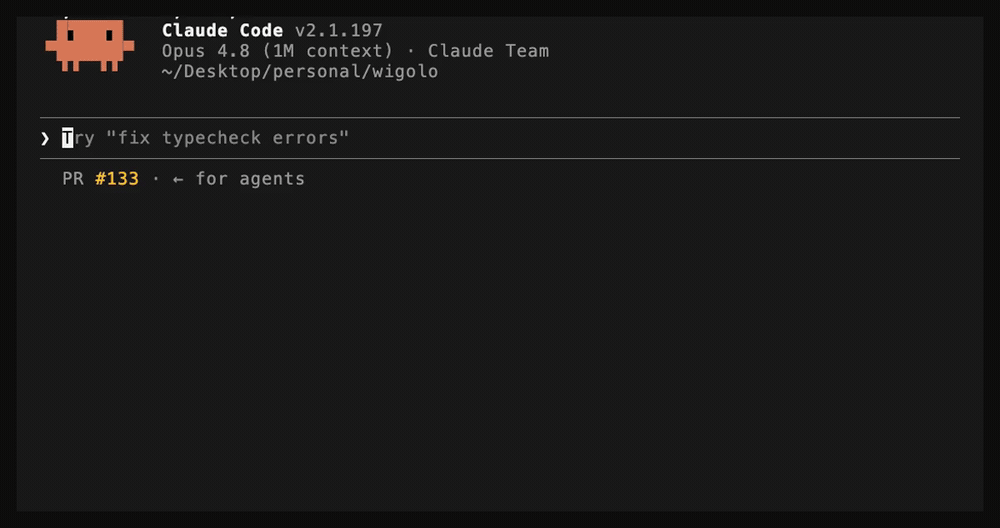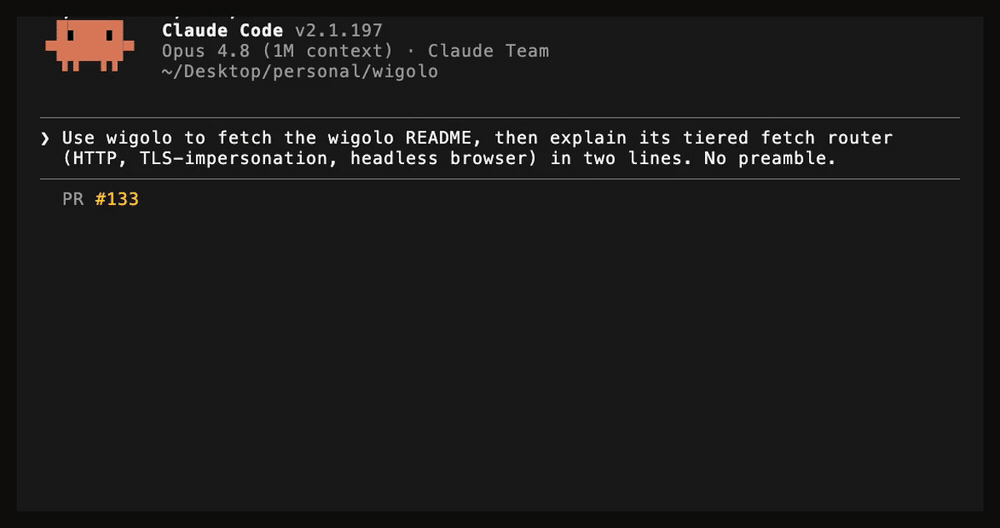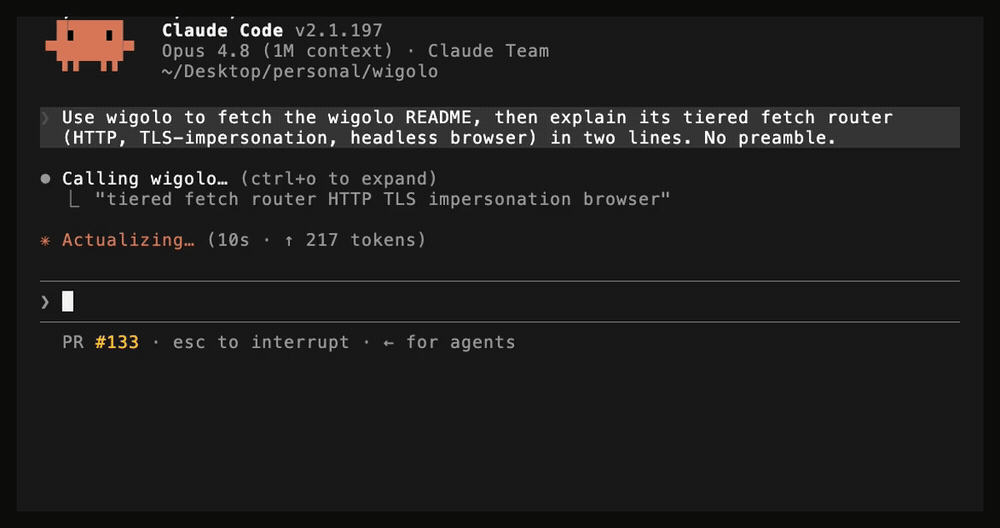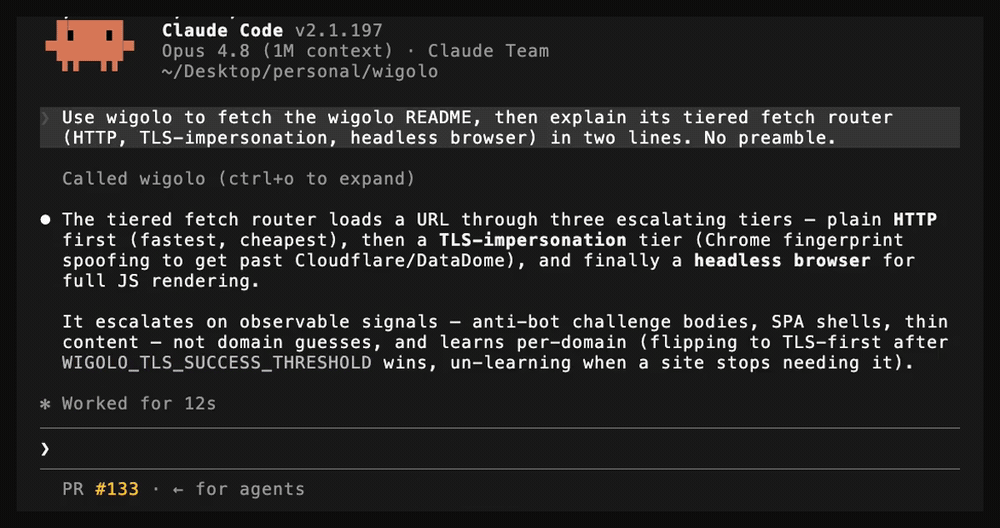
这是一个无需额外 API Key 的 Claude Code 使用演示,展示 MCP 工具如何把实时网页内容带给 Agent。
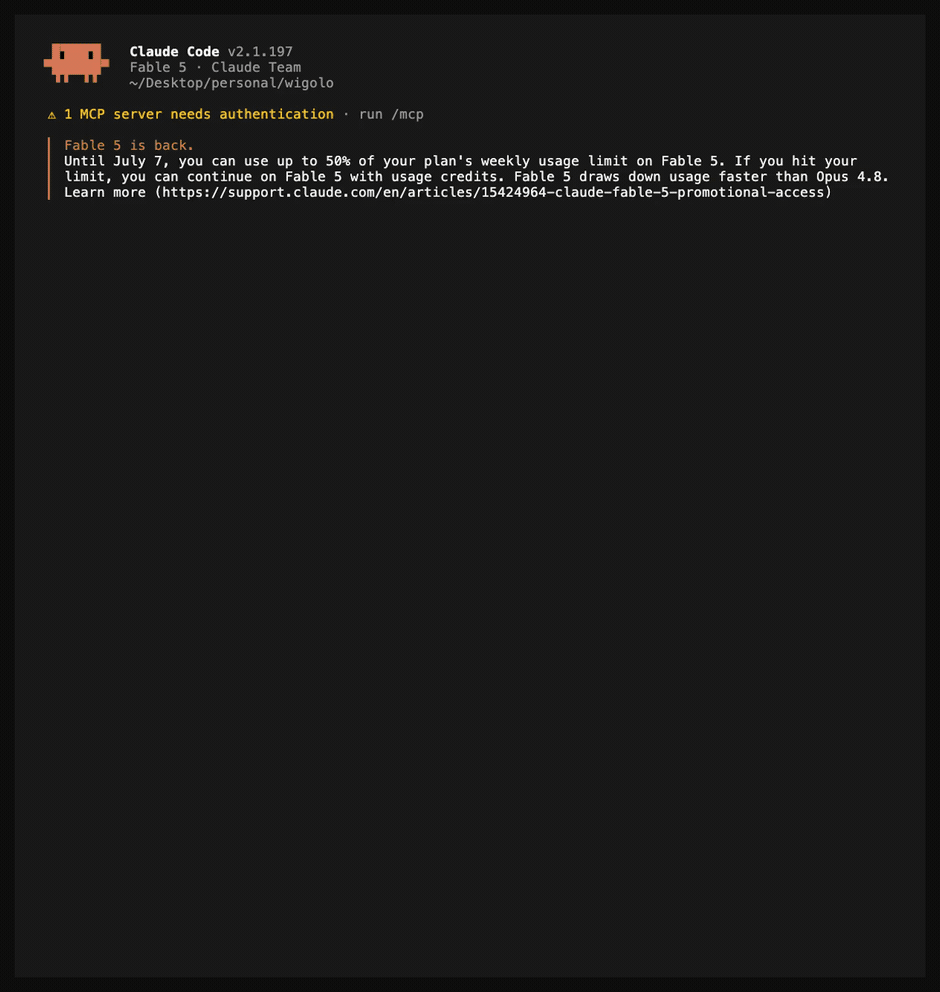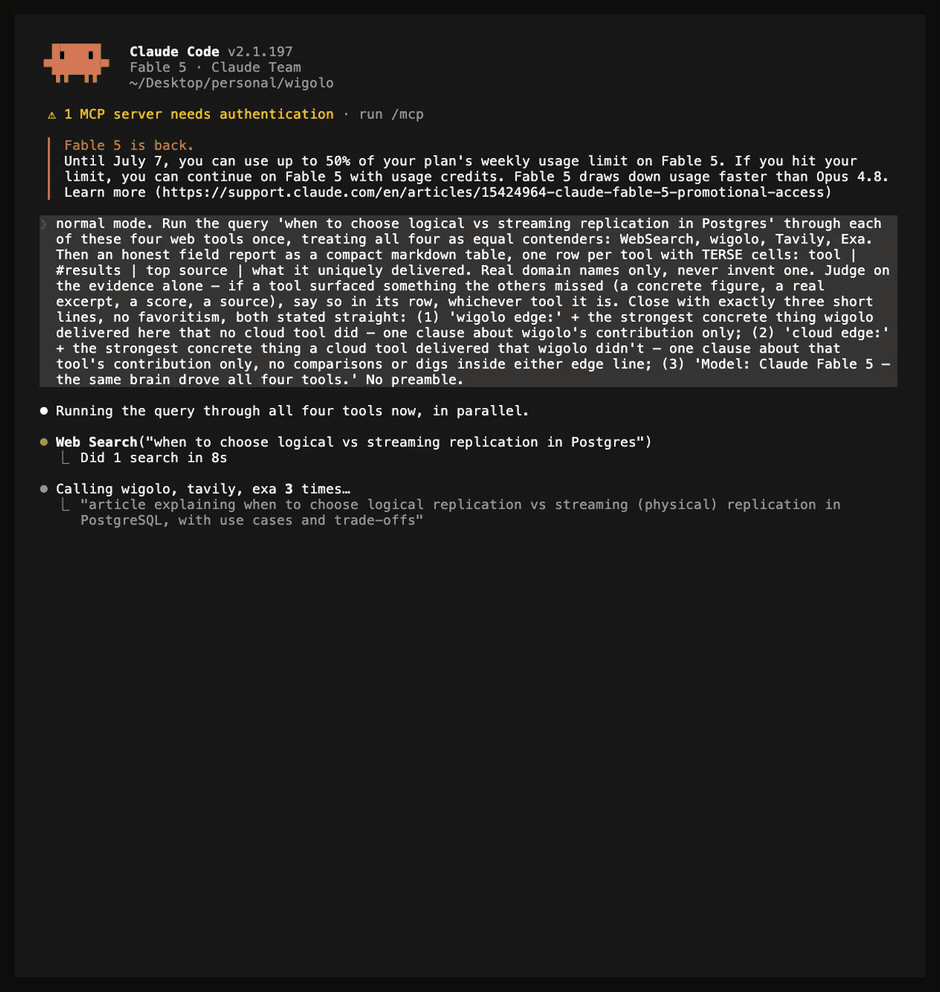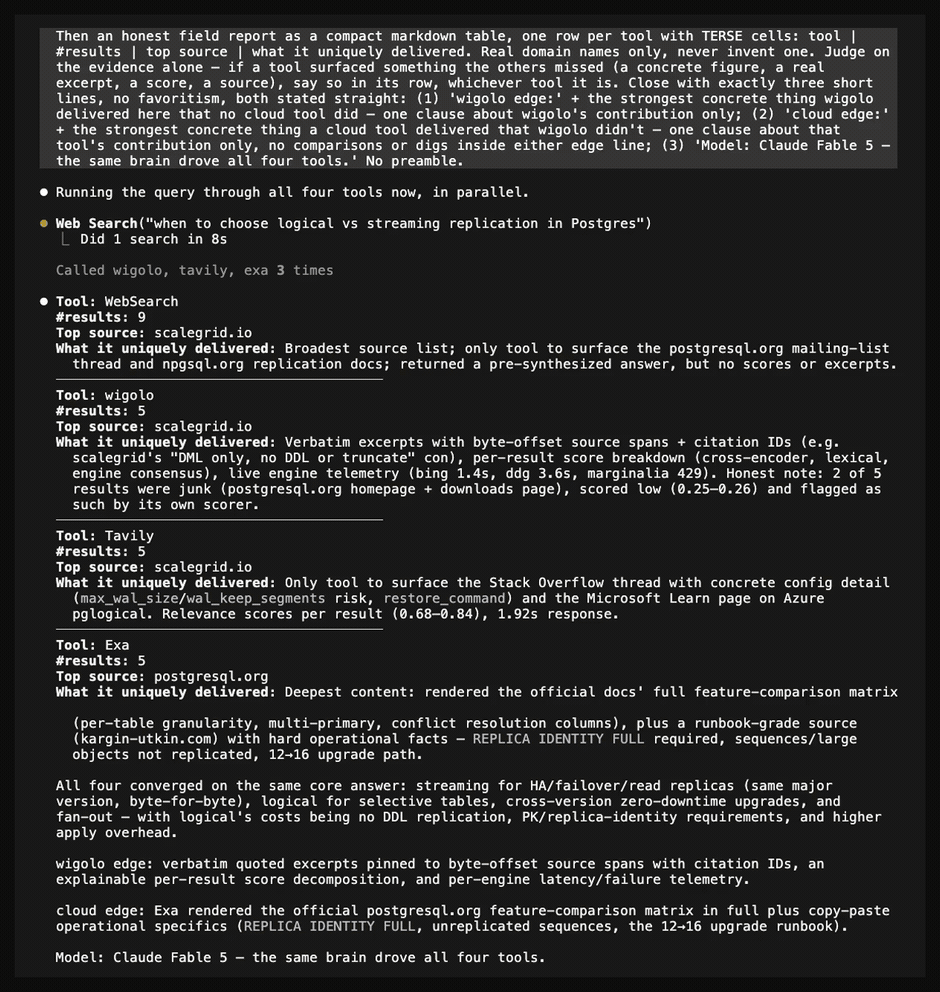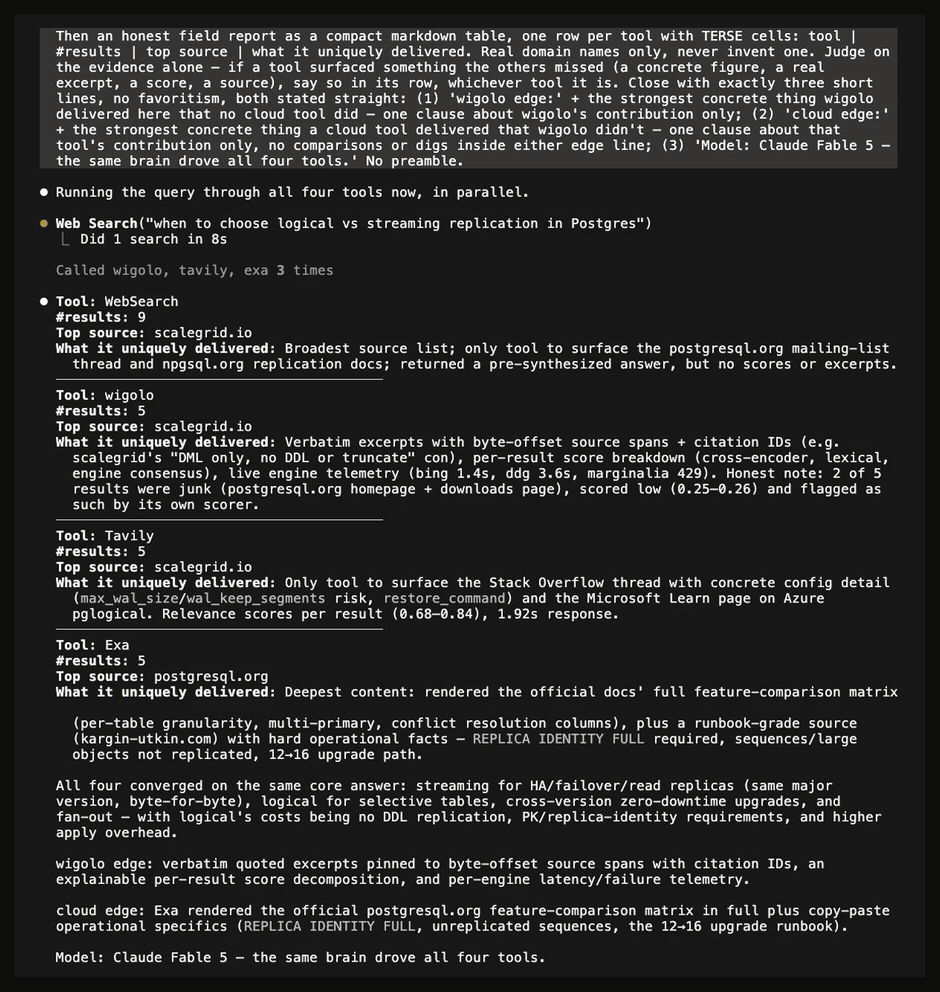
项目用四路实时对比把自己放到付费 Web 搜索服务的竞争语境中,而不是只展示静态 API 示例。
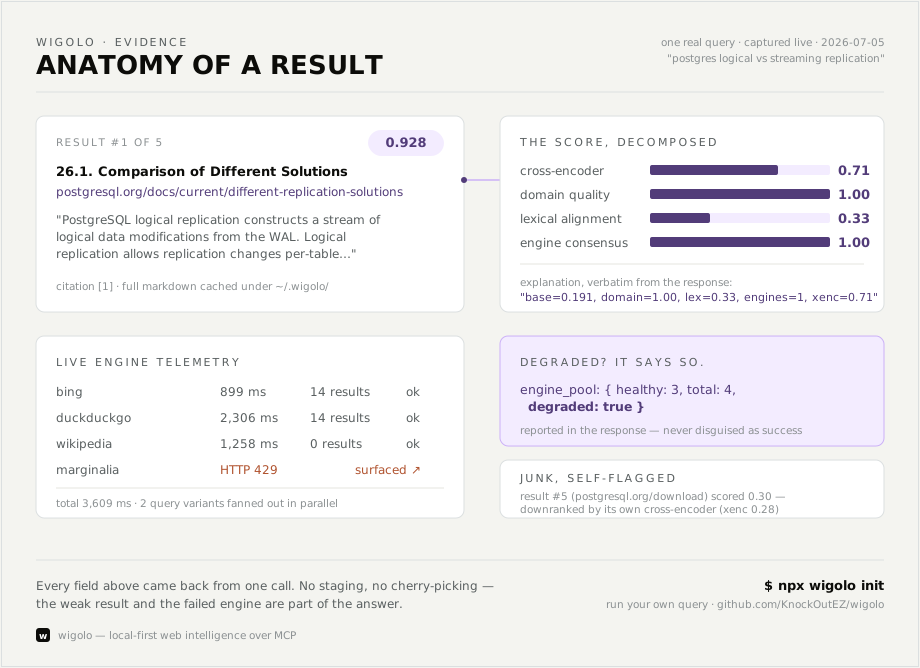
结果不仅返回内容,还展示分数构成、引擎遥测和降级信号,强调可解释性。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/knockoutez/wigolo |
| Star / Fork | 2,577 / 153 |
| 代码行数 | 294,266 行;TypeScript 52.2%、JSON 39.0%、TSX 3.6%、Python 1.9% |
| 项目年龄 | 约 3.3 个月;创建于 2026-04-12 |
| 开发阶段 | 密集开发;最近推送于 2026-07-20 |
| 贡献模式 | 7 人贡献,主作者约占 99% commit,属于单人主导 |
| 热度定位 | 中等热度;在 Agent Web 工具这一细分领域已具备较强可见度 |
| 版本策略 | SemVer;最新 v0.2.1,共 11 个 tag、11 个 Release |
| 许可证 | AGPL-3.0-only;GitHub API 的 License 字段显示为 Other |
| 质量评级 | 代码优秀;文档优秀;测试充分;CI/CD 完善 |
从数字看,wigolo 还处于早期,但不是低投入的概念验证项目:近 30 天 571 次 commit,近 90 天 1,474 次 commit。其代码统计中 JSON 占比较高,原因是项目包含大量测试夹具、站点资源和配置数据;如果只看实现代码,核心仍然是 TypeScript 服务与工具层。
作者视角:为什么存在这个项目
创始人/作者背景
作者 Towhid Khan(GitHub ID:KnockOutEZ)位于孟加拉国达卡,在 pgEdge 从事软件开发,账号已有约 5.9 年历史、拥有 64 个公开仓库。其背景一方面接近 PostgreSQL 和分布式系统,另一方面长期使用 TypeScript / Node.js 开发工具。
wigolo 是作者最近投入权重最高的项目之一,但贡献高度集中:7 位贡献者中主作者贡献约 99% 的 commit。这带来两种同时存在的信号:一是产品方向和实现风格非常统一,二是维护风险尚未通过社区分散。作者把项目描述成「一个独立开发者对抗三个有融资团队」,这个叙事也解释了为什么项目同时重视功能迭代、benchmark、分发和文档。
问题判断
作者判断的不是「搜索结果还不够多」,而是 Agent 获取 Web 内容的整条供应链存在结构性摩擦:
- 现有云服务需要 API Key,查询量越大成本越高;
- 内容经过第三方服务器,隐私边界不在用户手中;
- 搜索、抓取、抽取、重排和引用往往由多个产品拼接,Agent 得面对不同的 schema 和失败模式;
- 普通 snippet 不能稳定地支持可验证引用,模型容易把摘要误当成原文证据。
MCP 的普及提供了合适的切入时机。与其再设计一套 Agent 专用协议,不如直接成为 Claude Code、Cursor、Codex、Gemini CLI、VS Code、Windsurf、Zed 等客户端的 Web 层。npx wigolo init 能一次为多个 Agent 配置连接,降低了协议和分发成本。
解法哲学
wigolo 的设计哲学可以概括为四句话:
- 重活在本地运行:抓取、缓存、索引、嵌入和重排尽量不离开用户机器;Ollama 可作为本地 LLM 提供方。
- 代码优先于模型:canonicalization、rank fusion、去重和 schema 匹配等确定性工作不交给 LLM;只有确实需要判断或生成时才 opt-in 使用模型。
- 观察信号,而不是猜域名:抓取器根据 SPA shell、challenge body、内容稀薄度等实际响应决定是否升级,而不是无条件启动浏览器。
- 失败也要能解释:遇到反爬或 SSRF 拒绝时,返回结构化失败状态和稳定错误码,而不是把错误页面伪装成成功内容。
这意味着它明确放弃了「一个云端 API 负责所有事情」的简单体验,换取本地控制、成本可预测和行为可观测。
战略意图
wigolo 已经不只是一个 npm 包:仓库同时提供 MCP Server、REST、OpenAPI 3.1、SSE、TypeScript/Python SDK、LangChain/CrewAI/LlamaIndex/Vercel AI SDK wrapper、Docker、Homebrew、单文件 binary 和 Agent Skill。这种布局表明作者想建立一个可被不同 Agent 和框架消费的本地 Web 层。
项目目前明确承诺没有付费层,也不会按查询收费;AGPL-3.0 和 CLA 则保留了维护者未来进行商业再授权的空间。因此更准确的判断是:当前是 genuinely open 的基础设施项目,但其许可证和分发方式也为后续商业化保留了弹性。
核心价值提炼
创新之处
-
信号驱动的渐进式抓取梯(新颖度 4/5;实用性 5/5;可迁移性 5/5)
wigolo 依次尝试普通 HTTP、TLS impersonation 和 Playwright headless browser,仅在观察到 SPA shell、挑战页或稀薄内容时升级。它还按域名记录成功的 tier、clearance 和 backoff,并允许用户通过
wigolo tune list/reset查看或清理策略。相比无条件使用浏览器,这种做法把成功率、延迟和资源消耗放进同一个反馈回路。 -
RRF、多种轻量信号与端侧模型组成的排序管线(新颖度 3/5;实用性 5/5;可迁移性 5/5)
18 个搜索引擎先通过 Reciprocal Rank Fusion 合并,再叠加 authority、consensus、recency 等信号,最后使用 ONNX cross-encoder 做语义重排和阈值裁剪。它没有把最终排序完全交给一个黑盒模型,而是保留每一层的可追踪性,适合对稳定性和解释都有要求的 RAG 场景。
-
byte-offset 证据而非普通 snippet(新颖度 4/5;实用性 5/5;可迁移性 5/5)
搜索结果携带原文片段的
source_span,并可使用 numbered、JSON 或 Anthropic tags 等引用格式。这样 Agent 得到的是「可以回到原文位置的证据」,不是一段无法验证来源的摘要。该模式可以直接迁移到企业搜索、长文档问答和 citation-aware 评测。 -
每个 URL 入口都经过统一 SSRF 防护(新颖度 3/5;实用性 5/5;可迁移性 5/5)
fetch、extract、crawl、watch等路径都通过同一套 guard,拒绝 loopback、私有地址、link-local、IPv6 ULA 和 metadata 主机名;重定向还会在每一层重新检查。Issue #206/#207 暴露出的 DNS rebinding / TOCTOU 问题进一步推动了 socket pinning 方向。这是一个容易被忽略、但对 Web 工具尤其关键的架构约束。 -
插件化但不让插件拖垮主服务(新颖度 3/5;实用性 4/5;可迁移性 5/5)
src/plugins/loader.ts从用户目录加载搜索引擎或抽取器,先校验导出,再以单插件错误隔离的方式载入。新增一个搜索引擎约需百行代码,既保持了核心依赖的独立性,也没有把插件框架做成另一套复杂平台。 -
本地凭据的三段式解析链(新颖度 3/5;实用性 5/5;可迁移性 5/5)
凭据优先使用 OS keychain,退化到 AES-256-GCM 加密文件,再退化到环境变量;解析后不回写
process.env,并用进程级 memo 避免重复解密。对需要偶尔调用云 LLM、但默认强调本地运行的工具来说,这是比「所有 SDK 都直接读环境变量」更可审计的方案。
可复用的模式与技巧
- lazy import 重依赖:把 native binding、浏览器和嵌入模型的加载推迟到第一次真正使用,降低 MCP/CLI 冷启动成本。
- 只重试已知可恢复错误:通过
isCorruptArchiveError()区分损坏归档与不可恢复错误,只对前者执行一次缓存清理和重试,避免无脑重试。 - 稳定错误码与可读错误文案分离:以
SSRF_CODES等枚举作为机器接口,文案可以迭代而不破坏上层状态映射。 - 确定性抽取优先,LLM 字段带 provenance:抽取不到的字段保持
null并记录缺失原因,不让模型无来源补全;确需 LLM 推断时显式标记来源。 - 可观察、可重置的 per-domain 策略:自动学习策略必须同时提供 list 和 reset,否则一次错误学习会变成难以排查的隐性配置。
- 框架适配器放在核心之外:核心不依赖 LangChain 等框架,适配器作为薄层单独发布,避免基础能力被某个生态锁死。
关键设计决策
1. 用抓取梯替代固定客户端
- 问题:固定使用 HTTP 会被 SPA 和反爬拦截,固定使用浏览器又会牺牲速度和资源。
- 方案:以响应信号和已学习的域策略决定 tier;TLS 绑定等重依赖使用 lazy import,浏览器由共享 pool 管理。
- Trade-off:单次访问可能比直接用浏览器更复杂、甚至需要升级后才拿到结果,但常规页面的平均成本更低,且同一域名会逐渐收敛到合适策略。
- 可迁移性:高,适用于爬虫、监控和 API 客户端的渐进式降级。
2. 用两阶段排序保留解释能力
- 问题:多引擎结果质量不一,单一排序或纯 ML 排序都难以兼顾召回、速度和解释。
- 方案:先用 RRF 合并排名,再加入权威性、共识度、时效性信号,最后用 ONNX reranker 处理候选集。
- Trade-off:管线比单模型更长,需要维护多个信号和阈值;换来的好处是每层都能独立测试、调参和解释。
- 可迁移性:高,适用于多数据源搜索与 RAG 检索。
3. 把结果建模成证据对象
- 问题:Agent 获得的 snippet 常常无法回指原文,模型容易在引用时产生幻觉。
- 方案:在 markdown 片段上记录起止偏移,同时输出证据分数和引擎共识等元数据。
- Trade-off:需要保留原文和解析边界,存储与处理成本高于简单字符串摘要;但可以减少下游重复抓取,并支持可验证引用。
- 可迁移性:高,尤其适合知识库、代码文档和合规问答。
4. 将安全边界放在基础 fetch 抽象下方
- 问题:只在某一个工具入口做 URL 校验,很容易被 crawl、redirect 或新工具绕过。
- 方案:每个 fetch tier 和每次 redirect 都重新执行 SSRF guard,并以统一错误码向上返回。
- Trade-off:调用链增加少量检查,部分特殊内网用例需要显式处理;但安全约束不会依赖调用方自觉。
- 可迁移性:高,所有接受用户 URL 或 callback URL 的系统都应考虑这种设计。
5. 让本地优先成为默认,而不是降级路径
- 问题:如果本地能力只是云服务不可用时的 fallback,用户仍会自然地走向付费 API,隐私承诺也会变弱。
- 方案:默认 keyless;LLM 为 opt-in;本地缓存、embedding 和 rerank 是正式路径;Ollama 可完成全本地闭环。
- Trade-off:用户需要承担浏览器、模型和 native addon 的安装成本,硬件差异也会带来性能波动;换来成本和数据边界的确定性。
- 可迁移性:中高,适用于开发者工具和隐私敏感的 Agent 应用。
竞品格局与定位
竞品对比矩阵
| 维度 | wigolo | Firecrawl | Tavily | Exa | SearXNG |
|---|---|---|---|---|---|
| 核心定位 | 本地 Agent Web 全栈 | 云端抓取与抽取 API | 面向 LLM 的搜索 API | 神经搜索与内容 API | 自托管元搜索 |
| API Key / 计费 | 默认无需;$0/query | 需要;按量或套餐 | 需要;按量或套餐 | 需要;按量或套餐 | 通常无需第三方 Key,但需自建实例 |
| 本地隐私 | 查询和缓存默认在本机 | 云端处理 | 云端处理 | 云端处理 | 可自托管 |
| 搜索以外能力 | fetch、extract、crawl、cache、research、watch、agent | crawl、scrape、extract 较强 | search、extract | search、content、similar | 主要是搜索 |
| Agent 接入 | MCP、REST、SDK、框架 wrapper | SDK/API 生态成熟 | Agent 框架集成成熟 | API 集成为主 | 需要自行粘合 |
| 证据与解释 | byte-offset、分数分解、引擎遥测 | 主要返回清洗后的内容 | 结果质量依赖服务端系统 | 神经相关性强但解释较少 | 元搜索结果,需下游处理 |
| 主要优势 | 一体化、local-first、可观察 | 稳定性、企业能力、生态 | 上手简单、Agent 心智强 | 语义检索质量 | 自托管成熟、引擎数量多 |
| 主要短板 | 早期、单人维护、本地依赖复杂 | 成本与云依赖 | 成本与云依赖 | 成本与云依赖 | 不负责完整抓取和 Agent schema |
差异化护城河
wigolo 的护城河不是某一个搜索引擎或单一模型,而是把多个环节整合得足够顺滑:
- 技术护城河:可解释证据、渐进式 fetch、端侧 rerank、持久化域策略和统一安全边界形成了组合优势。
- 生态护城河:同一套工具和 schema 同时暴露为 MCP、REST、SDK、框架 adapter、Docker 和 CLI,减少下游集成工作。
- 信任护城河:AGPL-3.0、默认 keyless、无按查询收费和公开 benchmark,针对的是用户对 Agent 云基础设施锁定的反感。
这些优势更像工程整合和产品体验护城河,而不是短期内无法复制的基础算法。若竞争者愿意提供本地版并采用类似协议,单点功能并不难追赶。
竞争风险
- 对 Agent 默认推荐位的竞争:Tavily 等服务在 LangChain 和其他 Agent 框架中更早建立了默认心智。对于只想用几行代码接入 Web 的用户,云服务的简单性会胜过本地控制。
- 对企业抽取能力的竞争:Firecrawl 的云端稳定性、schema 模板、托管浏览器和企业 SLA 是 wigolo 短期难以匹配的。
- 对自托管用户的竞争:SearXNG 加 Firecrawl OSS、BrowserUse 和 Ollama 的组合可以覆盖相近需求;技术用户可能更愿意接受 glue work,以换取每个组件的独立替换。
- 单人维护风险:99% 的贡献集中度意味着作者的时间、判断和安全响应速度是系统性依赖。Issue #156 已承认部分 Agent 集成尚未充分实测,说明兼容性矩阵仍在扩张期。
生态定位
wigolo 位于「Agent tooling × local-first × MCP」的交叉地带,填补的是「Agent 的本地 Web 层」这一空白:SearXNG 更像搜索入口,Firecrawl 更像云端抓取服务,而 wigolo 试图提供一台 Agent 可直接调用、带证据和缓存的本地 Web 机器。
它不是所有场景下的 Firecrawl 替代品,也不是单纯的搜索引擎。更准确的定位是:适合重视隐私、成本可控、可离线或可自托管,并愿意承担一定本地安装复杂度的 Agent 开发者。
套利机会分析
- 信息差:项目已经有 2,577 个 Star,不属于无人关注的隐藏宝石;但在更广泛的企业开发者和中文 Agent 社区中,「MCP Web 全栈 + 本地证据」的定位仍未形成普遍认知。值得关注的不是 Star 数本身,而是它试图把多个付费 API 的组合价值压缩进一个开源本地进程。
- 技术借鉴:优先学习
src/fetch/router.ts的信号驱动升级、src/search/rrf.ts的多源排序、src/search/highlights.ts与src/search/evidence.ts的证据建模、src/watch/ssrf.ts的统一 URL 安全边界,以及src/plugins/loader.ts的故障隔离。 - 生态位:MCP 客户端越来越多,但许多项目仍把搜索、抓取和引用当成外部云服务;一个可审计、可缓存、可换引擎的本地 Web 层具有基础设施价值。
- 趋势判断:Agent 对实时 Web、引用证据、低成本推理和本地模型的需求都在增长。wigolo 的后发优势是能够把 MCP、端侧模型和 local-first 一起设计;风险则是 MCP 客户端或云服务商也可能快速把这些能力内建。
风险与不足
- 开发阶段仍偏早:项目只有约 3 个月,fix commit 占 32%,高于 feature 的 26.5%;这符合快速 beta 迭代,但也说明 API、配置和行为仍可能变化。
- 维护集中度过高:主作者约占 99% commit。测试和 CI 很强,不能完全抵消单人项目在安全响应、兼容性维护和长期路线上的人员风险。
- 本地运行并不等于低复杂度:Playwright、TLS native binding、嵌入模型和浏览器缓存都会带来安装体积、平台差异和冷启动问题。对只需要一次搜索的用户,云 API 依然更省事。
- 反爬能力有天然上限:作者自己承认,依赖 IP reputation 的 managed challenge network 不一定会向数据中心 IP 发放 clearance。抓取梯可以改善成功率,但不能消除网站方的对抗。
- AGPL 限制商业集成:若企业希望把修改后的 wigolo 能力融入闭源网络服务,需要认真评估 AGPL 的传播义务;这既是开源信任的一部分,也可能限制部分采用者。
- 组合系统的质量上限受最弱环节影响:18 个引擎、多个 fetch tier、多个 SDK 和 Agent 适配器扩大了测试矩阵。Issue #156 所反映的集成未实测问题,说明宣传支持范围与真实验证范围之间需要持续收敛。
- 安全修复仍需持续观察:SSRF follow-up 展示了较好的响应意识,但 Web 抓取器天然暴露在 DNS rebinding、redirect、内容解析和浏览器沙箱等攻击面,不能因为有 guard 就视为风险已经消失。
行动建议
-
如果你要用它:
- 个人 Agent、隐私敏感的研究工具、频繁查询的本地开发环境,优先试用 wigolo;它的零计费和本地缓存能抵消安装成本。
- 企业生产服务、对 SLA 和 schema 抽取准确率有刚性要求,先把它和 Firecrawl/Tavily/Exa 做同一组真实页面 benchmark,不要只依据 README 的演示结论。
- 部署前重点检查 SSRF 策略、代理/网络出口、Playwright 依赖、模型下载路径,以及 AGPL 对你的分发方式的影响。
-
如果你要学它:
- 先读
src/fetch/router.ts、src/fetch/tls-tier.ts,理解如何用信号而非配置猜测选择抓取层。 - 再读
src/search/rrf.ts、src/search/rerank.ts、src/search/evidence.ts,学习「候选召回—融合—重排—证据输出」的分层结构。 - 阅读
src/cache/store.ts,关注 FTS 查询清洗、域策略持久化和变化检测,而不只是把 SQLite 当普通 KV 存储。 - 阅读
src/watch/ssrf.ts、src/security/key-store.ts,观察如何把安全和凭据保护放进基础抽象,而非只在 CLI 入口做校验。 - 最后看
.github/workflows/ci.yml和tests/,重点学习 clean-machine smoke、跨平台 native addon 测试和真实 fixtures 的组织方式。
- 先读
-
如果你要 fork 它:
- 先缩小范围,选定一组稳定搜索引擎和一个 Agent 协议,不要同时维护所有 framework adapter。
- 建立公开的真实页面 benchmark,分别测召回、引用准确率、冷启动、抓取成功率和本地资源消耗。
- 优先补充多维护者治理、安全响应流程、兼容性矩阵和版本迁移文档,降低单人主导带来的长期风险。
- 可探索中文网页、企业内网知识库、代理配置和可插拔存储等垂直场景,但必须保持 SSRF guard 和证据 provenance 不被绕过。
知识入口
| 资源 | 链接 |
|---|---|
| 官方仓库 | https://github.com/knockoutez/wigolo |
| 官方站点/架构说明 | https://knockoutez.github.io/wigolo/ |
| DeepWiki | 未收录(当前页面返回 403) |
| Zread.ai | 未收录(当前仅有 loading skeleton) |
| 关联论文 | 无;项目使用 RRF、端侧 embedding 等既有技术,但未关联具体论文 |
| 在线 Demo | README 内嵌 assets/wigolo-demo.gif 与 assets/wigolo-vs.gif,无独立 hosted playground |
| 路线图 | https://github.com/knockoutez/wigolo/issues/13 |
| 安全讨论 | https://github.com/knockoutez/wigolo/issues/207 |
总体判断:wigolo 值得深入学习,但更适合作为「本地 Agent Web 层」的技术样本和快速演进中的候选基础设施,而不是已经完成长期稳定性验证的企业级云服务替代品。它最有价值的地方,不是把 18 个搜索引擎塞进一个仓库,而是展示了如何在成本、隐私、抓取成功率、证据可验证性和 Agent 易用性之间做一组连贯的工程取舍。