把 GPT-2 训练从 45 分钟刷到 90 秒:Muon 优化器就诞生在这个 speedrun
一句话总结
modded-nanogpt 是 Karpathy nanoGPT 的「魔改竞速版」——一个社区 speedrun,把「把 GPT-2 (124M) 训到 FineWeb 验证集 loss ≤ 3.28」的墙钟时间从 llm.c 的 45 分钟一路刷到 1.328 分钟(8×H100);它最大的产出不是速度本身,而是孵化并验证了 Muon 优化器(现已被 Kimi/Moonshot 等千亿模型采用),还把没有博士学位、几乎没有 arXiv 论文的作者 Keller Jordan 凭 GitHub 实绩送进了 OpenAI。
值得关注的理由
- 「小仓库、大叙事」的稀缺标本:5,350 star 远小于其行业影响力——Muon 已被 Moonshot/Kimi 生产采用、被 NorMuon/COSMOS/SOAP+Muon 等多篇论文当基线。讲清「一个 5k star 的业余竞速项目孵化出被千亿模型采用的优化器、把作者送进 OpenAI」这条线,价值远高于表面热度。
- speedrun 作为可证伪的研究方法论:固定任务(8×H100、数据管线不可改)+ 强制统计显著(p<0.01)把每个新技巧的真实增益无情量化,是对「undertuned baseline 论文范式」的实证主义反叛;83 条带统计检验的 record 构成「不可伪造的实证数据库」。
- 前沿训练 trick 的全集:Muon/Newton-Schulz 正交化、Polar Express、NorMuon、value embeddings、U-net skip、FA3 滑窗注意力、ReLU²、logit soft-capping、FP8 matmul、显式通信调度——一份「在固定预算下最快怎么训」的活体最佳实践库。
项目展示
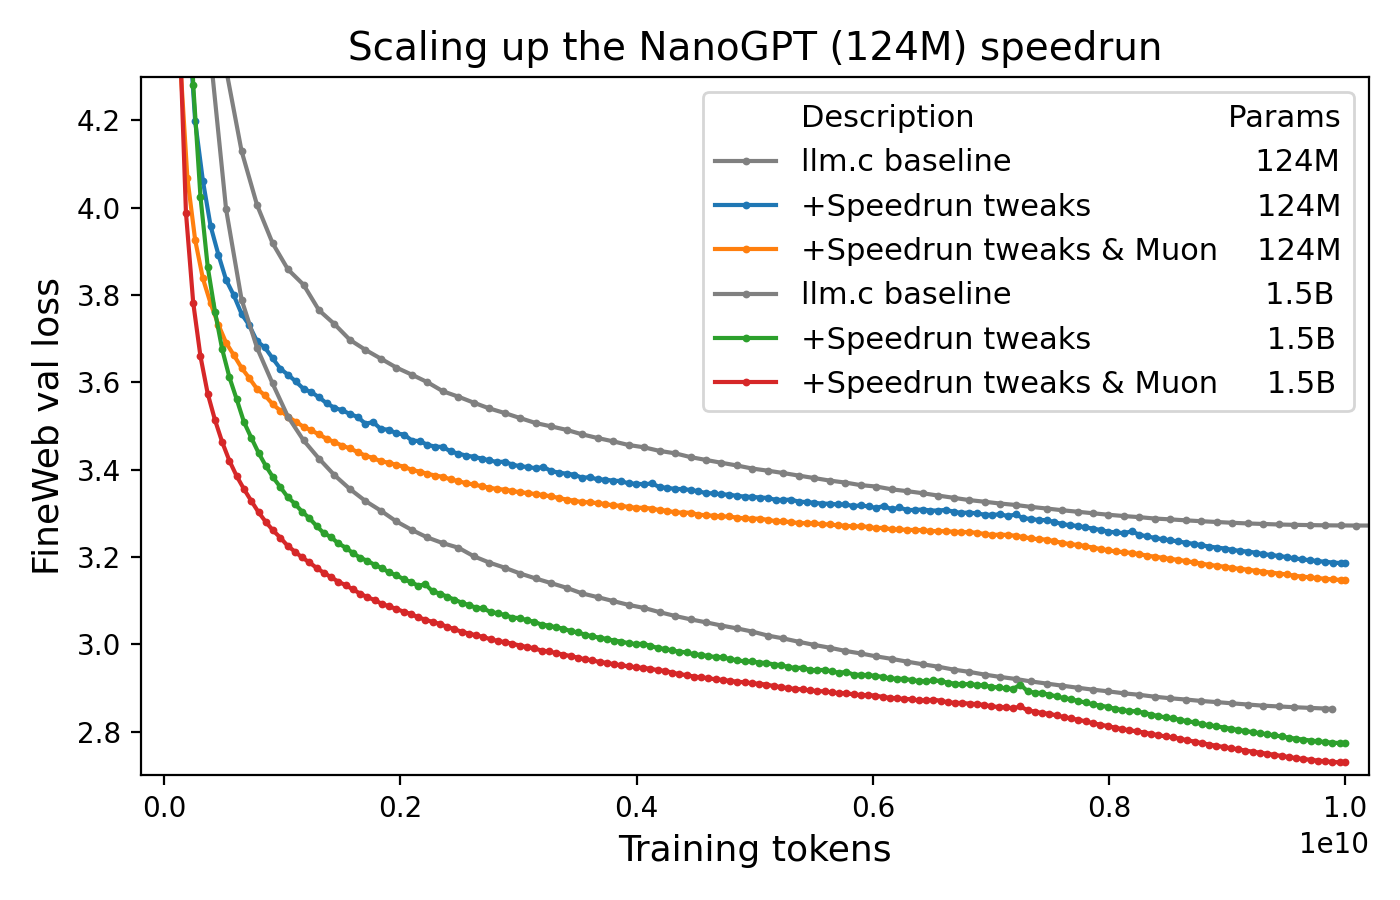
speedrun 提速主线图,直观展示纪录如何被逐代刷新。
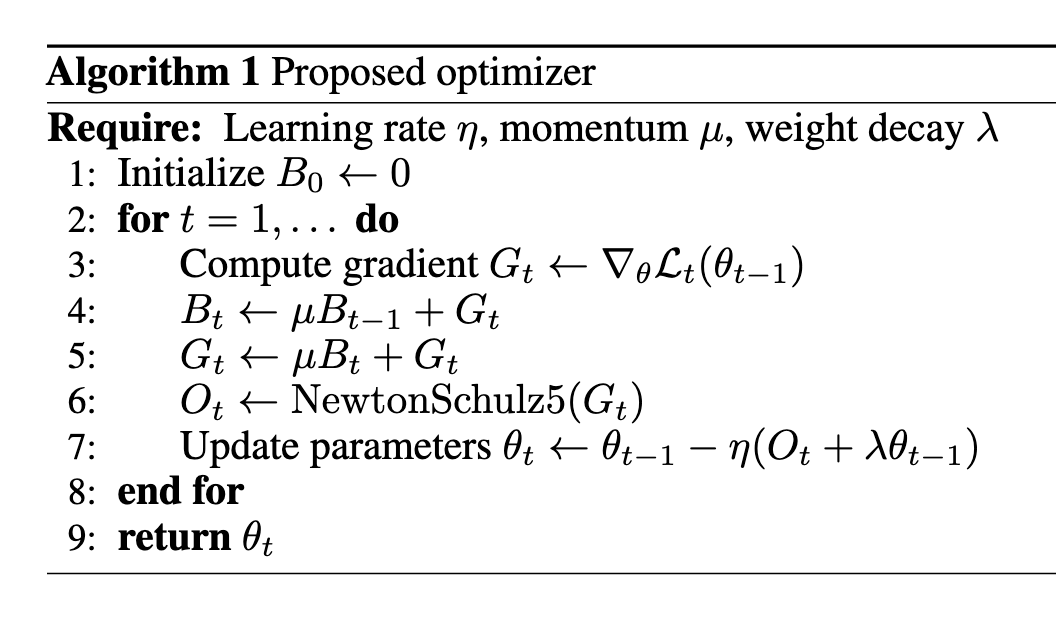
Muon 优化器:动量更新 + Newton-Schulz 迭代近似正交化。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/KellerJordan/modded-nanogpt |
| Star / Fork | 5,350 / 799(star 数 ≪ 行业影响力,典型被低估) |
| 代码行数 | 39,787 行(Python 99.4%,依赖仅 9 个);1461 文件中绝大多数是 records/ speedrun 归档 |
| 项目年龄 | 24.2 个月(首次提交 2024-06-01,仍密集开发) |
| 开发阶段 | 密集开发(两波提速潮:2024-10 |
| 贡献模式 | 核心少数 + 社区(Keller Jordan 主导,73 名贡献者,含多个 AI 自动研究系统) |
| 热度定位 | 大众热门 · 稳步增长(约 150 star/月,持续不衰) |
| License | MIT |
| 质量评级 | 可复现[优] 文档[良·竞速标准] 依赖[优] 工程 trick 清晰度[良] |
作者视角:为什么存在这个项目
创始人/作者背景
Keller Jordan(@KellerJordan,Berkeley,2024-12 加入 OpenAI Technical Staff,参与大模型训练,其 Muon 技术据报道与 GPT-5 级训练相关)。这是本项目最强的叙事钩子:他没有博士学位、几乎没有传统 arXiv 论文,仅凭一篇 Muon 博客 + 这个 speedrun 的硬核成绩,于 2024 年底同时被 OpenAI 和 xAI 看中,最终加入 OpenAI。自带「草根逆袭进 OpenAI」的传播故事,作者可信度极高。
问题判断
它瞄准的是「把 GPT-2 训到目标 loss 的墙钟时间」这个被严格固定的竞速基准。血缘是 karpathy/nanoGPT → llm.c 的 PyTorch trainer:llm.c 基线需 45 分钟 / 10B tokens,本项目用 <90 秒 / <400M tokens 达到同样 loss。差距不来自单点突破,而来自 83 条 record 累积的「架构现代化 + 优化器革命 + 系统/kernel 工程」三层叠加。标准 AdamW 的更新被少数主方向主导、条件数高,正是 Muon 要解决的核心痛点。
解法哲学
可证伪 + 工程实绩 > 论文。Muon 的设计哲学是「能在 GPU bf16 上稳定跑的近似正交化」而非数学上最优的 SVD。作者明确不为 Muon 写 arXiv(arXiv 化交给 Moonshot 完成),认为打磨优化器比发论文更重要。开放竞速把社区变成分布式搜索引擎——记录贡献者超 50 人,甚至包含多个 AI 自动研究系统(hiverge.ai、Locus、Aster 等),即「AI 在为 AI 训练做 speedrun」。
战略意图
把 CIFAR-airbench 的竞速方法论整体搬到 LLM:固定任务、卡墙钟、统计显著、单脚本可复现。不发论文、靠 GitHub 硬核实绩进 OpenAI。Muon 的工业采用路径(NanoGPT 0.7% FLOP 开销 → Llama-405B 0.5% → Kimi/Moonshot 生产采用 → 成为多篇论文基线)证明了「speedrun 发现的技巧能 scale 到真实大模型」这一战略赌注成立。新增的 track_3_optimization(最少步数赛道)进一步把 repo 定位为「中立的优化器学术基准平台」。
核心价值提炼
创新之处
- Muon 优化器(Newton-Schulz 正交化)(新颖度 5/5・实用性 5/5・可迁移性 5/5):对 2D 隐藏层权重先做 SGD-momentum,再用 Newton-Schulz 五次迭代把更新矩阵近似正交化(≈ SVD 的 UVᵀ)。魔法系数
(3.4445, -4.7750, 2.0315)刻意调到最大化零点斜率——产出的不是严格 UVᵀ 但对模型质量无损。选 Newton-Schulz 而非真 SVD 的关键:NS 是纯 matmul、bf16 稳定、FLOP 开销仅 0.5%~0.7%,而 SVD 在 GPU 上慢且需高精度。这是被工业界采用的通用优化器,本项目最大的可迁移资产。 - speedrun 作为研究方法论(新颖度 5/5・实用性 4/5・可迁移性 4/5):把固定任务竞速 + 强制 p<0.01 统计显著当作发现训练现象的「望远镜」。每条 record 附 t 检验,失败/成功对照清晰(如某 PR v1
p=0.9982被拒、v3p=0.0000通过)。已被多个 AI 自动研究系统当 benchmark。 - Polar Express 变系数正交化(新颖度 4/5・实用性 4/5・可迁移性 4/5):把固定系数的 5 次 NS 迭代换成每步不同系数(论文 2505.16932 专门参照本项目设计),融合 Nesterov 动量(FP32)+ 正交化(bf16)于一个 Triton kernel,同样 5 步内更快逼近正交,省 10 个训练步。
- NorMuon + Cautious WD + Mantissa tracking(新颖度 4/5・实用性 4/5・可迁移性 3/5):给 Muon 叠加 Adafactor 式低秩二阶矩(拿 Adam 的自适应收益、几乎零开销);只在衰减方向与梯度同向时才衰减的门控权重衰减;bf16 参数额外存 16 位尾数拼成 fp32 精度更新(比直接 fp32 省一半内存)。
可复用的模式与技巧
- 「以源码自记录」:脚本启动先把自身 + kernel 源码读进变量并写入日志,保证每条记录可精确复现 —— 任何要求强可复现的实验脚本。
- 0-D CPU tensor 喂超参:LR/WD/momentum 用
torch.tensor(0.0, device='cpu')+.fill_()传入 compiled 函数,避免值变化触发 torch.compile 重编译 —— 所有 @torch.compile 下需逐步变更标量超参的训练循环。 - bf16 + 尾数缓冲 ≈ fp32:拆 uint16 高/低位拼 uint32→float32 更新 —— 显存受限但要 fp32 精度的优化器状态。
- 参数 bank + reshape 约束分片:同形矩阵打包、leading 维 padding 到 world_size 整除再切 —— 分布式下对一组同构权重做矩阵级优化器。
- warmup-then-reset 防作弊:先预热 torch.compile 再恢复初始权重计时 —— 需要公平墙钟计时的 benchmark。
关键设计决策
- Muon = 动量 + Newton-Schulz 正交化:只对 2D 矩阵用(embedding/scalar/bias 仍用 Adam),bf16 纯 matmul 实现。Trade-off:换来「放大稀有方向」的训练增益,代价是对参数布局有约束。可迁移性极高。
- 抛弃 backward hook、改显式通信调度:把同形矩阵打包成参数 bank 沿 leading 维切给 8 GPU,用显式
scatter_order+work_order让小参数先 reduce、大矩阵的 reduce 在后台跑完,通信几乎完全被计算掩盖。Trade-off:手工调度复杂、对布局有硬约束。 - 架构层提速 trick 叠加:value embeddings(额外 embedding 表混入 V)、U-net/MUDD 动态混合早期 hidden、FA3 滑窗长短注意力交替、QK-norm + half-truncate RoPE、ReLU² MLP、logit soft-capping、FP8 matmul(lm_head e4m3 前向/e5m2 反向)、训练 2/3 处解 tie embedding↔lm_head。
- 表驱动训练 schedule:batch size 8→16→24、seq_len 896→2048、window 调度 + YaRN、warmup-stable-decay LR、Muon momentum 0.85→0.95、multi-token prediction 权重退火、Adam 仅奇数步更新(省一半开销)。
竞品格局与定位
竞品对比矩阵
| 维度 | modded-nanogpt | karpathy/nanoGPT | karpathy/llm.c | Muon vs AdamW/Shampoo/SOAP |
|---|---|---|---|---|
| Stars | 5.3k | ~59k | ~30k | — |
| 定位 | GPT-2 训练 speedrun | GPT 训练教学基底 | 纯 C/CUDA 训练 | 优化器之争 |
| 目标 | 固定预算下最快 | 教人怎么训 | 无框架也能高效 | 收敛效率 |
| 同 loss 耗时 | <90 秒 | (教学非竞速) | 45 分钟基线 | Muon 比 AdamW 快约 1.35× |
| 可读/可移植 | 低(2154 行单文件、绑 8×H100) | 高(单文件教学) | 中(C 可移植) | Muon 实现轻于 Shampoo/SOAP |
差异化护城河
① Muon 优化器的先发 + 工业验证(Kimi/Moonshot 采用、多篇论文基线);② 83 条带统计显著性的 record 构成的「不可伪造的实证数据库」;③ 50+ 人(含多个 AI 研究系统)的社区飞轮。这三者叠加是单点技术无法复制的。
竞争风险
① 与具体硬件(8×H100)、torch 版本、kernel 深度绑定,可移植性与可读性持续恶化(2154 行单文件、改了 252 次);② 过拟合「124M / 3.28 / FineWeb」这一特定点的风险——部分 trick 可能不 scale(MUDD record 已显式承认要 trim 才能用);③ 优化器创新正被学界/工业快速吸收,Muon 的稀缺性在下降。
生态定位
LLM 训练的「F1 赛车队」——不是给你直接上生产的库,而是前沿训练技巧的发现引擎与公开排行榜;价值在「被下游(论文/工业/教学)抽取技巧」而非「被直接 import」。上游 nanoGPT/llm.c 占据教学与基线心智,本项目用「竞速 + 优化器创新」开辟差异化生态位。
套利机会分析
- 信息差:star(5.3k)远小于行业渗透度(Muon 已被 Kimi/Moonshot 采用、被多篇论文作基线)。讲清「业余竞速项目 → 被千亿模型采用的优化器 → 作者进 OpenAI」这条线,内容价值远高于表面热度。
- 技术借鉴:Muon/NorMuon 优化器、Polar Express 正交化内核、bf16+尾数 fp32 技巧、0-D CPU tensor 喂超参、显式通信调度——都是可独立移植的工程资产。
- 生态位:填补「在固定预算下最快怎么训 GPT」的开放竞速空白,nanoGPT 教基础、llm.c 证下限,本项目卷极限。
- 趋势判断:正向——密集开发未衰减、Muon 工业采用持续扩散;但需注意 trick 对特定点的过拟合风险,迁移到自己场景需自行验证 scale 性。
风险与不足
- 硬绑特定环境:依赖 8×H100、torch==2.10、特定 Triton kernel,跨硬件可移植性差,「90 秒」成绩并非开箱即得(issue #160 反映复现门槛)。
- 可读性恶化:当前 train_gpt.py 已 2154 行单文件、全局 args/model、硬编码魔法数、trick 高度纠缠,新读者门槛陡。
- 可能过拟合特定点:部分 trick 针对「124M / loss 3.28 / FineWeb」调优,未必 scale 到大模型/其他数据。
- 无单元测试/CI、难抽成库:按产品库标准不合格(但按研究竞速脚本标准属同类顶尖)。
- 可及性诉求未满足:社区强烈希望下放到消费级显卡(issue #29,27 评论仍 open)。
行动建议
- 如果你要用它:想低成本复现/学习前沿 GPT 训练 → 直接
./run.sh(需 8×H100);想用 Muon → 看KellerJordan/Muon独立仓更易集成;生产大模型训练可评估 Muon(参考 Moonshot《Muon is Scalable》arXiv 2502.16982 的 weight-decay/scale 修补)。 - 如果你要学它:重点读
train_gpt.py(NorMuonAndAdam 在 367-940 行、polar_express 在 169-248 行、GPT.forward 在 1332-1481 行、训练循环 2093-2141 行);经典 Newton-Schulz 参照records/track_1_short/2024-10-10_Muon/train_gpt2.py(zeropower_via_newtonschulz5);records/目录名即提速技术演化时间线。 - 如果你要 fork 它:Muon/NorMuon、Polar Express、bf16+尾数 fp32、0-D CPU tensor 喂超参、显式通信调度都是可独立抽取的资产;但整体单文件强耦合,抽取需重构。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | deepwiki.com/KellerJordan/modded-nanogpt(已收录,含竞速赛道/架构/优化算法章节) |
| Muon 博客 | Muon: An optimizer for hidden layers(作者亲笔,无 arXiv) |
| 关联论文 | Muon is Scalable for LLM Training (arXiv 2502.16982);The Automated LLM Speedrunning Benchmark (2506.22419);NorMuon (2510.05491) 等 |
| 深度复盘 | NanoGPT Speedrun Living Worklog — Tyler Romero;A Field Guide to NanoGPT Speedrun Optimizations — Evan Conway |
| 在线 Demo | 无(speedrun 本质是离线训练脚本) |