autoresearch 深度分析报告
一句话总结
Karpathy 打造的「AI 自主 ML 研究」范式原型——用不到 1000 行代码实现 LLM agent 过夜自主实验循环,开创了 program.md「Markdown 编程」这一全新交互层级。
值得关注的理由
- 范式定义者:不是又一个 AutoML 工具,而是定义了「LLM agent 自主做 ML 研究」这个新品类,program.md 作为「研究组织代码」的理念可迁移到任何 agent 驱动场景
- 极简设计哲学的标杆:3 个核心文件、约 1000 行代码,三层约束沙盒(不可变评价 / 可变训练 / 指令层)是 agent 安全边界设计的经典参考
- Karpathy 品牌效应下的实战验证:已催生 4 篇 arXiv 论文、跨平台 fork 生态,Shopify CEO 实测获得 19% 验证分数提升
项目展示
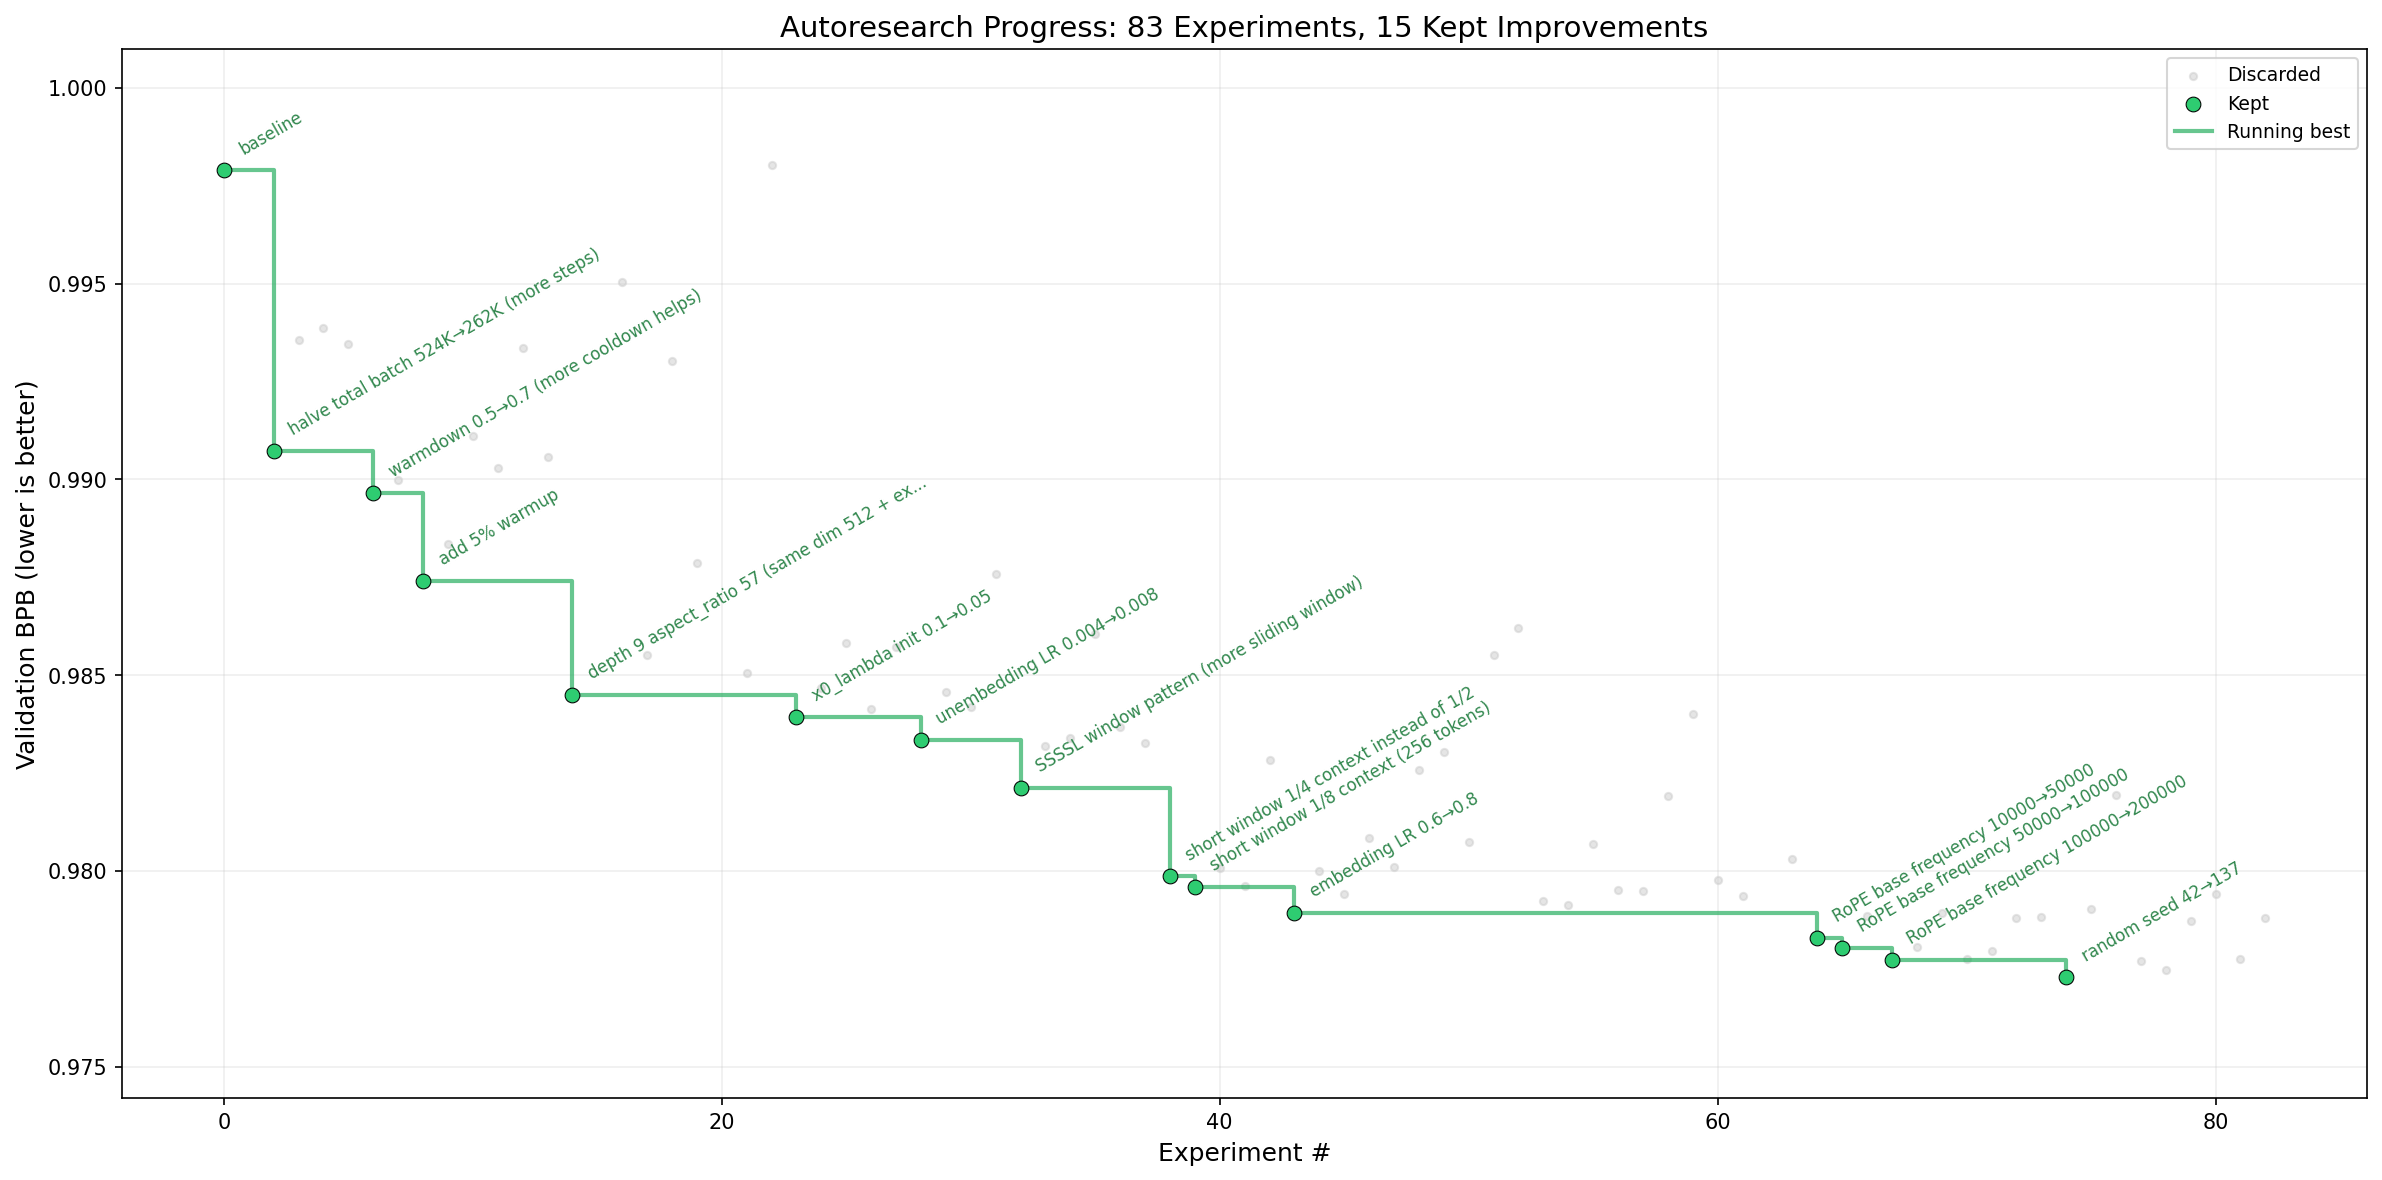
autoresearch 实验进展曲线——agent 自主运行数百次实验,逐步降低验证集 BPB(bits per byte)
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/karpathy/autoresearch |
| Star / Fork | 66,252 / 9,489 |
| 代码行数 | 1,003 行(Python 79.4%, Jupyter Notebook 8.9%, TOML 2.5%) |
| 项目年龄 | 约 1 个月(2026-03-06 创建) |
| 开发阶段 | 密集开发(36 次提交集中在 3 月,3/25 后暂停) |
| 贡献模式 | 单人主导(Karpathy 占 80%+ 提交,11 位贡献者) |
| 热度定位 | 大众热门(一个月内 66K+ stars,Fortune/VentureBeat 等媒体报道) |
| 质量评级 | 代码[优秀] 文档[良好] 测试[无] |
作者视角:为什么存在这个项目
创始人/作者背景
Andrej Karpathy,深度学习领域最具影响力的技术布道者之一。前 Tesla AI 总监、前 OpenAI 联合创始成员、Stanford CS231n 讲师。GitHub 156K 粉丝,从 nanoGPT → llm.c → nanochat → autoresearch 的项目脉络一脉相承,持续在「最小化实现 + 教育性」方向深耕。他的教学背景使代码极度清晰——这反过来让 AI agent 也能「读懂」代码,形成了设计上的正向循环。
问题判断
Karpathy 看到的核心洞察是:当训练代码已经简化到单文件(nanochat 的遗产),而 coding agent 恰好达到了可靠编写 PyTorch 代码的临界点时,修改训练代码这件事本身可以交给 agent。时机选择在 2026 年 3 月——两年前 agent 能力不足以稳定修改训练代码,两年后这类工具可能已大众化。他选择在「agent 刚好够用」的窗口期发布,最大化了先发叙事权。
解法哲学
Karpathy 的解法可以归纳为**「极简约束下的最大自由度」**:
- 明确做什么:单文件修改范围(agent 只改 train.py)、固定 5 分钟时间预算、单 GPU 自包含
- 明确不做什么:不做多 GPU 支持、不做跨平台(让社区 fork)、不做实验管理 UI(TSV + Jupyter 够了)、不做包安装
- 人类角色重新定义:人类不再直接写训练代码,而是编写 program.md——用 Markdown 定义「研究协议」来指导 agent 行为,本质上将研究者从「实验执行者」转变为「实验设计者」
战略意图
autoresearch 在 Karpathy 更大图景中是「AI 做 AI 研究」叙事的最小可行原型。Issue #92 AgentHub 透露了下一步计划——从单 agent 循环扩展为多 agent 协作平台。README 开头的虚构故事(第 10,205 代自修改代码)暗示了他对这个方向的长期信念。目前无明确商业化意图,定位为开源教育性原型。
核心价值提炼
创新之处
-
「Markdown 编程」范式(新颖度 5/5 | 实用性 4/5 | 可迁移性 5/5) program.md 作为 agent 研究指令,定义完整的实验协议(目标、约束、循环逻辑、判定标准、日志格式)。这本质上是一种新的编程层级:用自然语言编写「元程序」来指导代码层的修改。可迁移到任何需要 AI agent 自主迭代的场景。
-
三层约束沙盒(新颖度 4/5 | 实用性 5/5 | 可迁移性 5/5) 不可变评价基准(prepare.py)/ 可变训练代码(train.py)/ 人类指令(program.md)的三层分离。这使 agent 的自主性和实验可信度同时得到保证,是 agent 安全边界设计的经典参考。
-
时间预算驱动的公平实验框架(新颖度 3/5 | 实用性 5/5 | 可迁移性 4/5) 以 wall-clock 时间(300 秒)而非 step 数作为实验终止条件,使不同架构修改在同一硬件上公平比较。前 10 步排除在计时之外避免编译时间干扰。
-
Muon + AdamW 混合优化器(新颖度 4/5 | 实用性 4/5 | 可迁移性 3/5) 按参数形状分组:2D 矩阵权重用 Muon(基于 polar express 正交化的二阶优化器),嵌入和标量用 AdamW,统一封装并用 torch.compile 融合 kernel。
-
Input-dependent 门控的 Value Embedding(新颖度 3/5 | 实用性 4/5 | 可迁移性 3/5) 交替层添加独立值嵌入表,通过 2*sigmoid(gate) 做 input-dependent 缩放,gate 只取输入前 32 通道以节省计算。
可复用的模式与技巧
| 模式 | 描述 | 适用场景 |
|---|---|---|
| Markdown-as-Agent-Protocol | 用 Markdown 文件定义 AI agent 的完整工作协议 | 任何 LLM agent 自主运行场景 |
| Immutable-Baseline Sandbox | 评价标准和数据锁定为只读,限定 agent 可操作范围 | agent 驱动的自动化测试、优化 |
| Git-as-Experiment-Journal | 用 git commit/reset 实现实验 keep/revert,TSV 做日志 | 版本化迭代的自动化流程 |
| GC-Freeze-for-Throughput | 训练启动后冻结 Python GC,定期手动收集 | 延迟敏感的 Python 长时运行程序 |
| Time-Budget Fairness | 固定 wall-clock 时间作为实验终止条件 | 跨架构公平 benchmark |
| Mixed-Optimizer-by-Shape | 按参数形状分组使用不同优化器 | 精细优化策略的深度学习训练 |
关键设计决策
| 决策 | Trade-off |
|---|---|
| agent 只改 train.py | 牺牲优化数据预处理、tokenizer 的自由度,换来实验可比性和安全性 |
| 固定 5 分钟时间预算 | 牺牲跨硬件可比性,换来同硬件不同架构的公平比较 |
| program.md 指令层 | 牺牲实验策略灵活性,换来可预测性和可复现性 |
| git 分支做版本管理 | 增加 agent 出错可能性,换来完整实验历史追溯 |
| 极致扁平目录结构 | 牺牲模块化扩展性,换来 agent 的上下文友好性 |
竞品格局与定位
竞品对比矩阵
| 维度 | autoresearch | AutoResearchClaw | AlphaEvolve | Optuna/Ray Tune |
|---|---|---|---|---|
| Stars | 66,252 | 10,397 | N/A(闭源) | 成熟开源 |
| 修改自由度 | 任意代码修改 | 完整研究流程 | 进化式搜索 | 预定义搜索空间 |
| 聚焦程度 | 极度聚焦(单文件 5 分钟) | 端到端(想法→论文) | 数学/算法问题 | 超参优化 |
| 落地门槛 | 单 GPU 即可 | 需多种 API | Google 内部 | 低 |
| 代码透明度 | ~1000 行完全开源 | 开源但复杂 | 闭源 | 开源成熟 |
| 统计保证 | 无 | 无 | 有论文验证 | 贝叶斯优化等 |
差异化护城河
autoresearch 的护城河是三重的:Karpathy 个人品牌(信任护城河)+ 极简设计哲学(难以复制的品味护城河)+ program.md 范式创新(叙事护城河)。它不是「最强的自动化研究工具」,而是「最优雅的 AI agent 自主实验原型」。
竞争风险
- OpenAI Codex / Anthropic Claude 等平台内置类似功能时,独立工具价值下降
- agent 的实验效率上限——Issue #47 揭示 agent 倾向收敛到增量超参调优,而非探索全新架构
- arXiv 论文 2603.24647 证实经典 HPO 在固定搜索空间内仍优于 LLM agent,但 LLM agent 在开放式代码编辑中更有竞争力
生态定位
教育性原型 + 社区实验平台。类似 nanoGPT 在 LLM 训练教育中的地位,autoresearch 定位为「AI agent 做研究」这个范式的入门级参考实现。已催生跨平台 fork 生态(macOS/Windows/AMD)和多篇学术论文。
套利机会分析
- 信息差: 项目本身已充分曝光(66K stars + 媒体报道),无信息差。但 program.md 范式的可迁移价值尚未被广泛认知,可在非 ML 领域(自动化测试优化、配置调优、代码生成迭代)率先应用
- 技术借鉴: 三层约束沙盒模式可直接迁移到任何 agent 自主操作系统;Markdown-as-Protocol 模式可用于定义 CI/CD agent、测试 agent 等的工作协议;Muon+AdamW 混合优化器适合小规模 LLM 训练场景
- 生态位: 填补了「传统 AutoML 太受限」和「完全自主 AI 研究太宏大」之间的空白——恰好在「足够小到能跑通、又足够真实到有价值」的甜蜜点
- 趋势判断: AI agent 自主研究是明确的增长趋势。autoresearch 作为范式开创者有先发优势,但核心价值在思想而非代码,后来者可以轻松在此基础上构建更复杂的系统
风险与不足
- 无测试、无 CI/CD:代码质量依赖 Karpathy 个人水准,无自动化质量保障,限制了社区贡献的质量控制
- 单人依赖风险:Karpathy 贡献了 80% 代码,最近一次 commit 在 3 月 25 日,后续维护存在不确定性
- agent 收敛瓶颈:Issue #47 揭示 agent 倾向做安全的增量优化而非大胆的架构探索,exploration-exploitation 权衡是根本性未解难题
- 评价指标单一:仅用 val_bpb 评估,无法衡量生成质量、推理能力等更丰富的维度
- License 文件缺失:README 声明 MIT 但无独立 LICENSE 文件,法律上存在模糊性
- Agent 兼容性:Issue #57 暴露 Codex 在持久运行场景下存在局限,目前主要依赖 Claude Code
行动建议
- 如果你要用它: 需要单张 H100 GPU 和 Claude Code 订阅。适合让 AI agent 过夜自主探索训练超参和小型架构修改。如果需要可靠的超参搜索用 Optuna;如果想探索开放式代码修改,autoresearch 是目前最佳选择
- 如果你要学它: 重点关注
program.md(114 行,理解 Markdown 编程范式)→prepare.py(389 行,理解不可变评价层设计)→train.py的 MuonAdamW 类和 GPT 类(理解前沿训练技巧) - 如果你要 fork 它: 最有价值的方向是 (1) 多指标评价(不只 BPB)(2) 多 agent 协作(Issue #92 AgentHub 方向)(3) 更智能的探索策略(解决 Issue #47 的 novelty 问题)(4) 跨语言/跨任务泛化