3.8 个月单人 16K star:oMLX 把 Mac 本地推理的 90 秒等待压到 1 秒
GitHub: https://github.com/jundot/omlx
一句话总结
oMLX 是一个为 Apple Silicon 打造的本地 LLM 推理服务器,专门为 coding agent 优化——它把「agent 每轮改写 prompt 前缀就让整块 KV cache 失效、全量重算」这个痛点,用一套分页 SSD KV 缓存(跨请求甚至跨重启都能复用前缀)+ 连续批处理解决,把 Claude Code 等工具在本地大模型上的首 token 延迟从 30-90 秒压到 1-3 秒。它由首尔独立开发者 Jun Kim 在 3.8 个月里单人冲刺写成,已斩获 16K star。
值得关注的理由
- 现象级独立开发者爆款:一个「白天数据工程师、夜里 AI hacker」的个人项目,从 0 到 16K star 只用了 3.8 个月,1489 次提交、91 个 release(约每 1.3 天一发)。它不是大厂出品、没有 VC,纯靠真实痛点 + 产品力 + MLX 社区 KOL 自发背书。这是「scratch-my-own-itch」叙事的极致样本。
- 一个漂亮的跨域工程移植:作者把数据工程的「冷热数据分层」直觉搬到了 KV cache——把会话缓存当成一个带 LRU、带索引、带原子落盘的持久化存储系统来设计(safetensors 当存储格式、链式 hash 当 key、后台 writer 线程异步刷盘)。这正是推理框架很少认真做、而存储工程师本能会做的事。
- 细分蓝海的精准卡位:在「Apple Silicon 上跑 coding agent」这个高价值细分位,它是独立评测中「唯一在并发下真正做连续批处理的后端」。理解它如何把 vLLM 的服务端优化「下放到单机」,对任何做本地/边缘推理的人都有借鉴价值。
项目展示
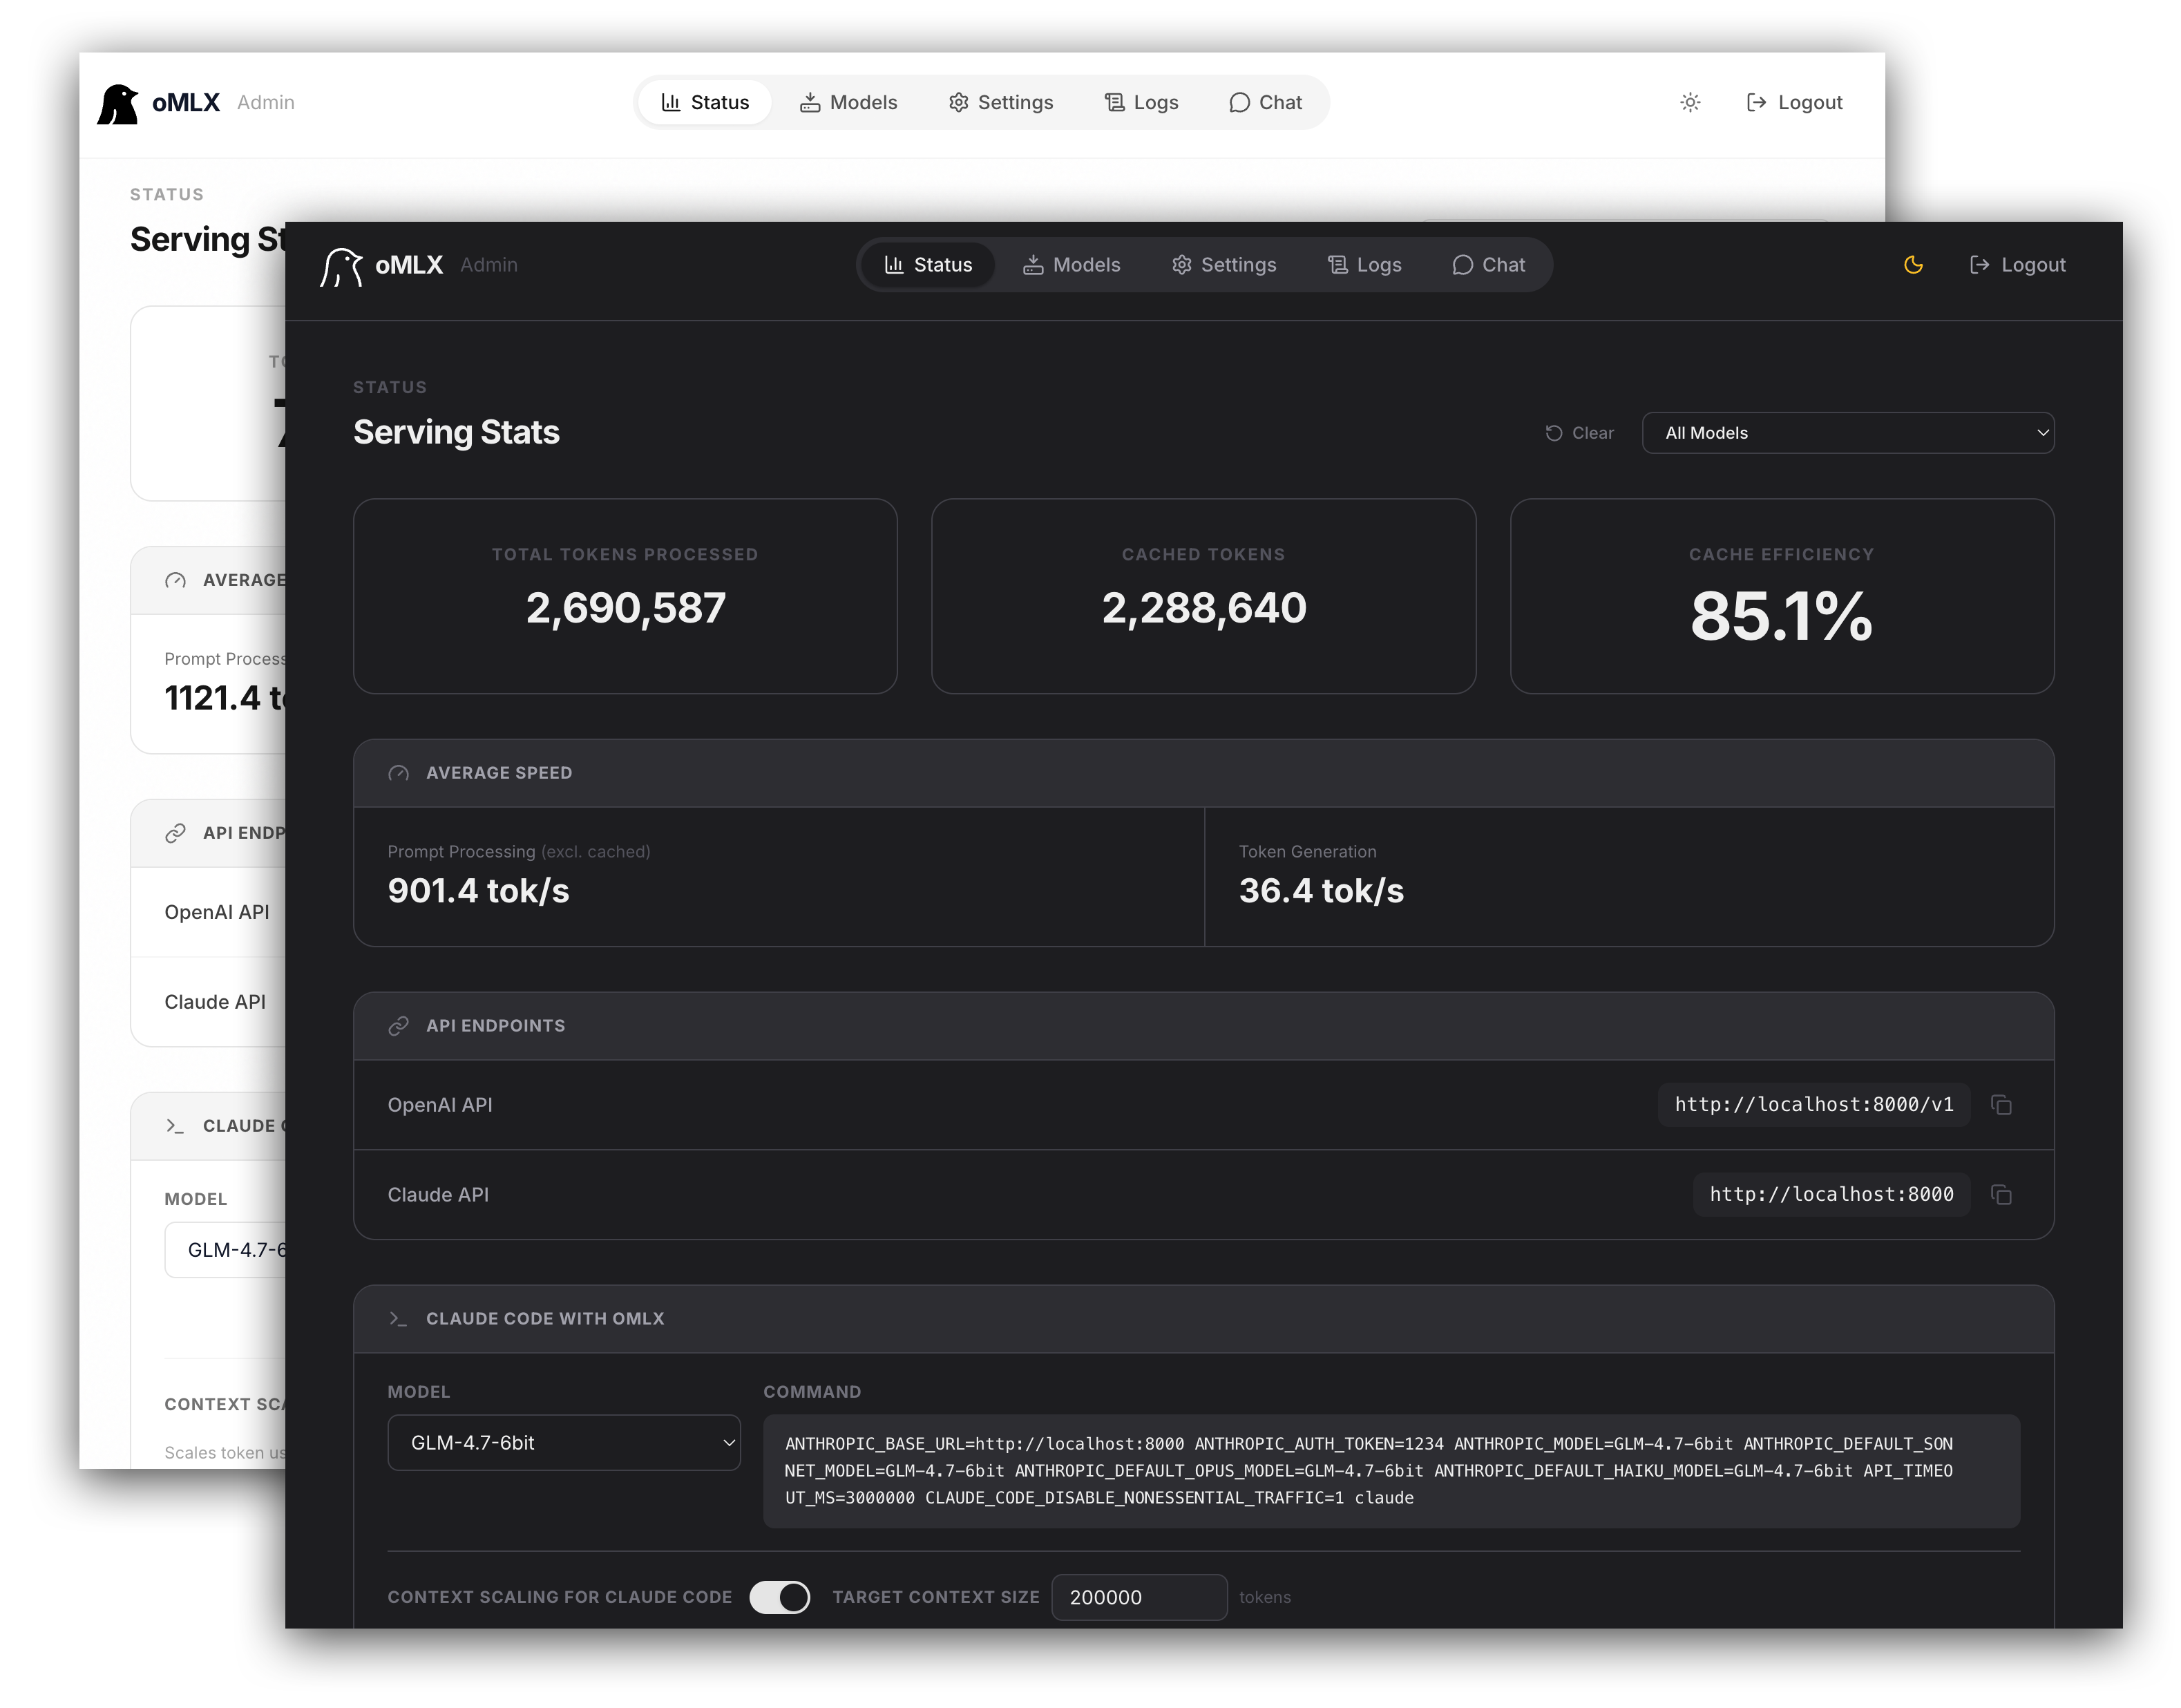
Web 管理控制台——8 语言 i18n、模型管理、实时监控。
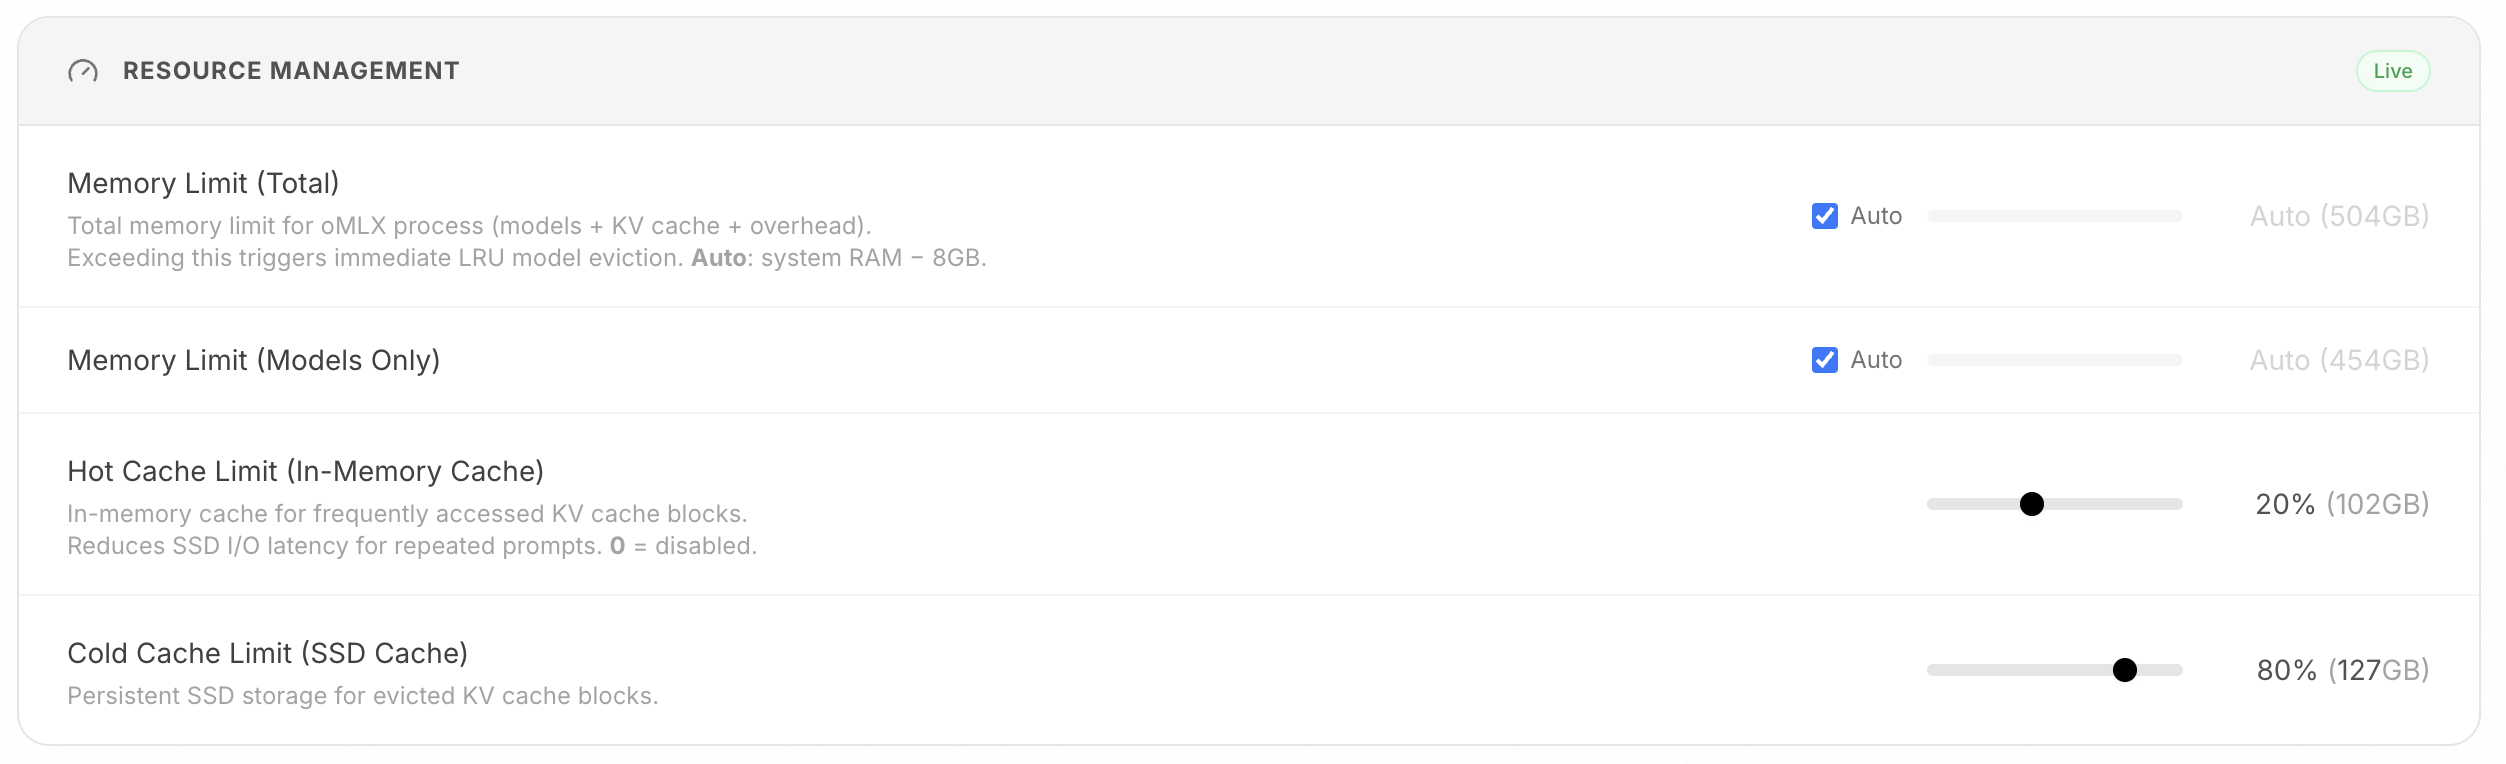
核心创新:Hot RAM 写回层 + Cold SSD 卸载层,前缀缓存跨请求/跨重启复用。
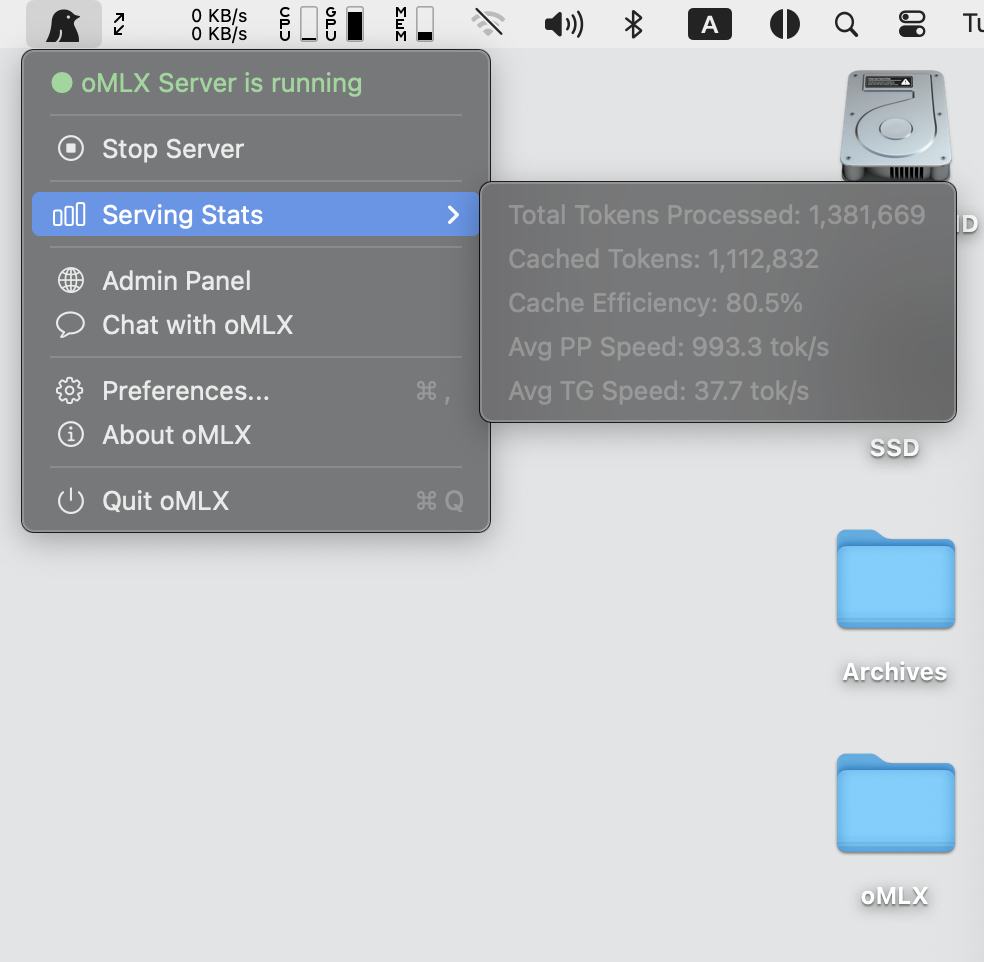
原生 Swift 菜单栏 app(非 Electron),从 macOS 顶栏直接管理推理服务。
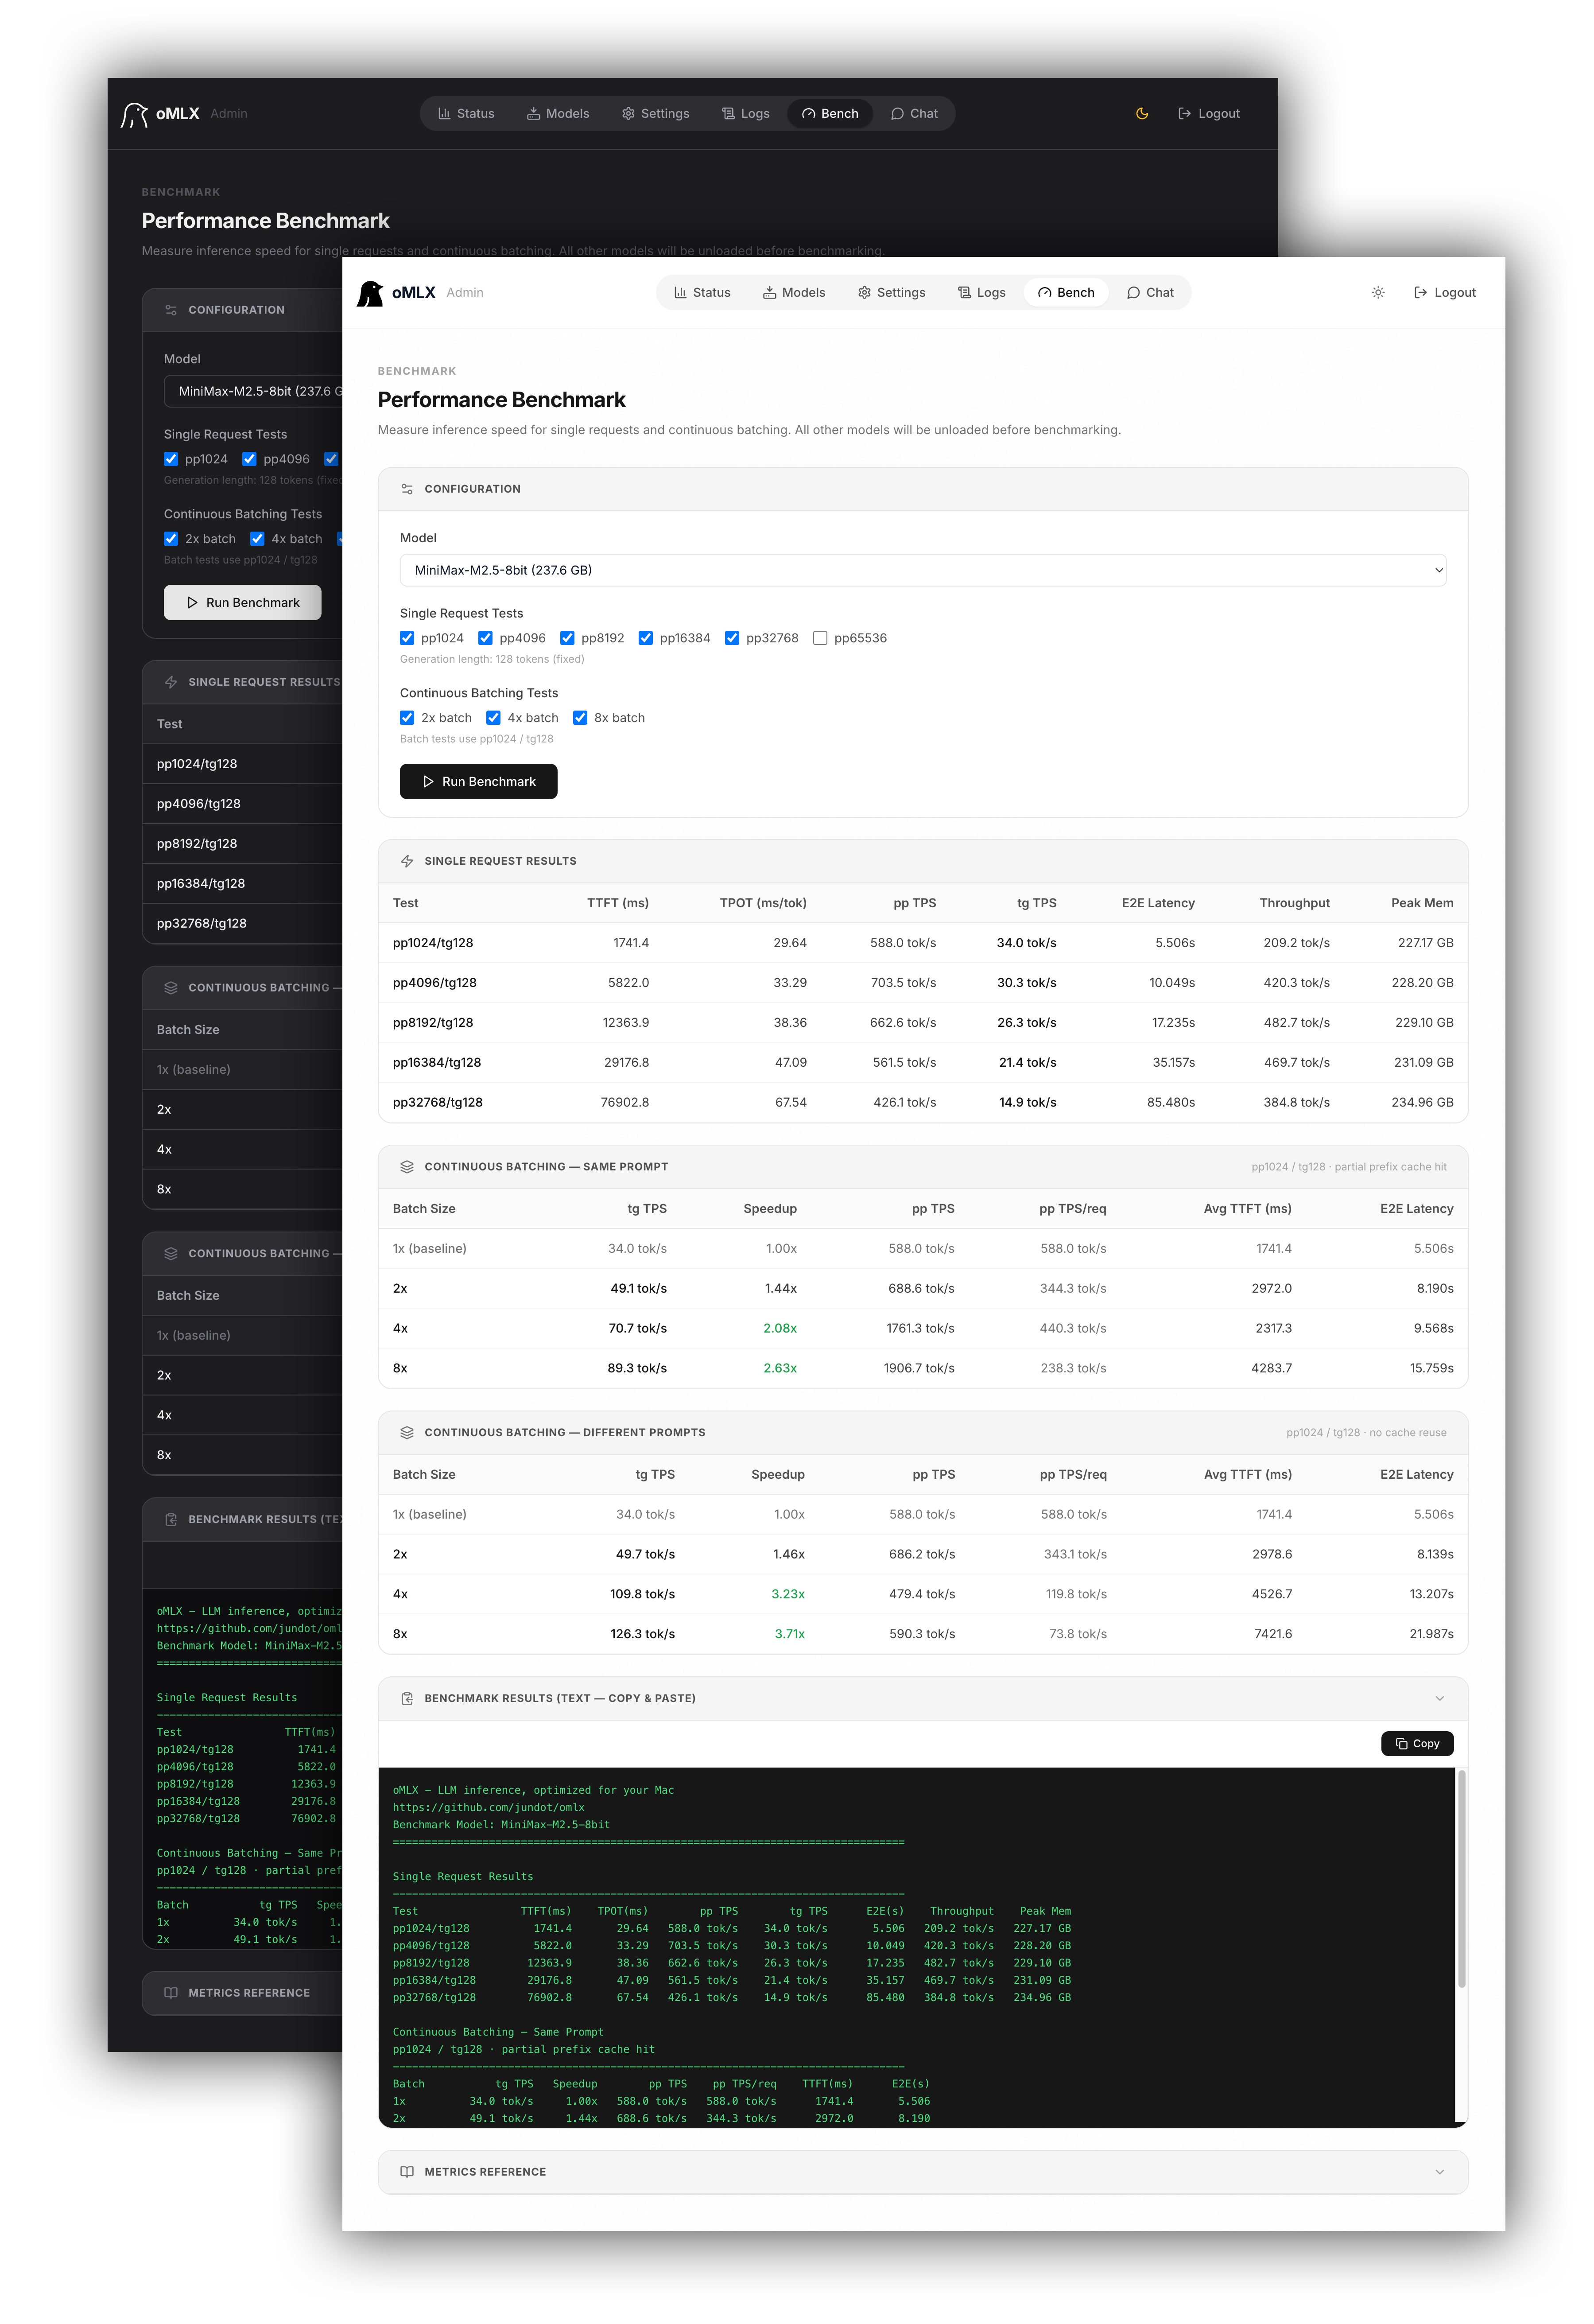
内置性能基准面板。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/jundot/omlx |
| Star / Fork | 16,167 / 1,378 |
| 代码行数 | 19.3 万行(Python 76.4% 推理后端 / Swift 12.2% 菜单栏 app / JS 4.3% web 控制台 / JSON i18n / HTML),527 文件 |
| 项目年龄 | 3.8 个月(2026-02-13 创建) |
| 开发阶段 | 密集开发(近 30 天 421 commit、近 90 天 1236,强度不降反升) |
| 贡献模式 | 单作者绝对主导(jundot 占 70.5% / 1024 commit),但 3.8 月已聚 150 贡献者 |
| 热度定位 | 爆发型新星 · 细分蓝海领跑(Mac 跑 coding agent) |
| License | Apache License 2.0 |
| 质量评级 | 代码「优秀」 文档「良好」 测试「充分」 |
作者视角:为什么存在这个项目
创始人/作者背景
Jun Kim(jundot),首尔独立开发者,bio 自述「Data engineer by day, AI dreamer by night. I build the tools I wish existed for my Mac — then open-source them」。无大厂背书、无 VC,omlx 是他唯一的原创旗舰作品。坦诚致谢上游 waybarrios/vllm-mlx(项目起点),不掠人之美。Bus factor 极高(70%+ 提交集中一人)是其最大风险。
问题判断
纯 dogfooding。作者从「自己在 Mac 上用 Claude Code 接本地模型」的真实场景里,发现了一个被所有现有 server 忽略的痛点:agent 工作流每轮都会改写 prompt 前缀(插入工具结果、压缩历史),而 Ollama/llama.cpp 这类 server 把本机推理当「单轮聊天」优化——KV cache 只在「上下文严格追加」时复用,前缀一变就整块作废、全量重算 prefill。底层 Apple MLX 又只是个库、没有生产级 server 能力。这中间缺的那层,就是 oMLX。
解法哲学
- 跨域下放,而非另起炉灶:不重写推理内核,站在 mlx-lm 的
BatchGenerator上,把 vLLM 服务端的成熟工程(PagedAttention 块管理、prefix sharing、CoW、连续批处理)下放到单机 Apple Silicon。 - 性能与易用性都要:既做底层硬核优化(分页 SSD KV cache、oQ 量化、MTP 投机解码),又做原生 Swift 菜单栏 app + Web admin + 一键集成,拒绝「极客专用」。
- 明确不做:不自造模型格式/量化加载器(oQ 产物是标准 mlx-lm safetensors,不绑定特定 server);不改 upstream 包(追新模型全走 monkey-patch)。
战略意图
genuinely open(Apache 2.0,无 VC,商业化信号克制——仅官网 + Buy Me a Coffee)。路线图(oQ 量化、MTP、VLM/OCR/embedding/reranker 统一服务)显示它在向「Mac 上的本地推理操作系统」扩张,而非停留在单一 LLM runner。
核心价值提炼
创新之处
- 跨请求/跨重启复用的分页 SSD KV cache(新颖度 5/5、实用性 5/5):vLLM 式块管理(
CacheBlock带 ref_count + 内容 hash,O(1) LRU 分配,块去重)+ 链式 hash(每块 hash = SHA256(父块 hash + token_ids + model_name),依赖所有前驱、按 model 隔离)+ 冷热双层(Hot RAM 写回 + Cold SSD 块级 safetensors 落盘,与 mlx-lm 兼容,后台 writer 异步刷盘)。关键是惰性恢复:前缀匹配时先查内存,未命中再问 SSD,命中就建一个纯元数据占位块、KV 数据按需从盘加载。这就是「agent 移动前缀后仍命中历史缓存、服务器重启后缓存还在」的实现,也是它区别于 Ollama/llama.cpp 的根本。 - SSD-only 模式下近零成本 CoW(新颖度 4/5):利用「数据已持久化」前提,多请求共享前缀分叉时不复制 KV 数据,只拷元数据 + 给源块 ref_count 减一,真要用时再从盘回读。
- oQ 数据驱动混合精度量化(实用性 5/5):融合 GGUF K-quant 层位策略 + unsloth Dynamic 2.0 选择性不量化 + BnB MSE 最优 clipping,按每层实测量化敏感度分配比特;产物是标准 mlx-lm safetensors。基准亮眼:2-bit MMLU 14%→64%、HumanEval 0%→78%。
- agent 语义补偿层(新颖度 5/5):
scale_anthropic_tokens按target/actual上报 token 数,让小上下文模型也能触发 Claude Code 在正确时机 auto-compact;SSE keep-alive 防长 prefill 期间客户端读超时。把「适配 agent 真实行为」做进协议层——这是别家想不到的细节。
可复用的模式与技巧
- 链式 hash 前缀缓存:每块 hash = SHA256(父块 hash + 本块内容 + 隔离 key),天然支持「最长公共前缀命中 + 多租户隔离」——任何前缀复用的缓存/去重系统。
- 冷热双层 + 惰性恢复:热层 RAM + 冷层持久化,命中冷层时先建元数据占位、数据按需回读——突破内存上限的缓存。
- 异步落盘三件套:推理线程序列化为 raw bytes → pending-write buffer(落盘前即可读)→ 后台 writer 刷盘 + ENOSPC 恢复 + 队列深度随内存缩放——热路径不能阻塞在 syscall 的写密集系统。
- 适配器 + 内部 IR 做多协议网关:
BaseAdapter+InternalRequest/Response,新协议只加一个 adapter——同时兼容 OpenAI/Anthropic 多家 API。 - vendor-by-patch 追前沿上游:pin 精确 commit +
sys.modules注入 +model_type门控 + 文档化退出路径——强依赖快速演进上游、又要可复现的项目范本。
关键设计决策
最值得学的是复用 mlx-lm BatchGenerator 做连续批处理、自己只做调度:从零写 token 级连续批处理代价巨大,作者的关键洞察是「mlx-lm 已经在 token 级实现了连续批处理,直接拿来当后端」。Scheduler 只维护 vLLM 式的 waiting 队列 + running 集合做调度,批处理本身交给上游。这种「吃 upstream 红利、自己只补缺失的那层」的取舍,是单人在 3.8 个月做出生产级 server 的关键——配合 patches/ 把上游未发版的新模型 PR 1:1 拷进来、按 model_type 门控,能比 upstream 更快支持 DeepSeek V4/Qwen3.6 等前沿模型。
竞品格局与定位
竞品对比矩阵
| 维度 | oMLX | Ollama | llama.cpp | Apple MLX/mlx-lm |
|---|---|---|---|---|
| 定位 | Apple Silicon agent server | 通用本地 runner | C++ 推理引擎 | 底层框架(库) |
| 为 agent 优化 | ✅ 持久化前缀缓存 + 连续批处理 | ❌ 前缀变即失效 | ❌ | — |
| SSD KV 持久化 | ✅ 跨重启复用 | ❌ | ❌ | ❌ |
| 跨平台 | 仅 macOS/Apple Silicon | Linux/Win/Mac | 全平台 | macOS |
| 与 oMLX 关系 | — | 正面竞品 | 正面竞品 | 依赖(被 oMLX 补全) |
| Star | 16K | ~14万 | ~8万 | ~2万 |
差异化护城河
技术护城河(分页 SSD 持久化 KV cache 是「唯一在 agent 多轮场景做到前缀缓存跨请求/跨重启复用」的实现,工程深度 + Apple 平台稳定性补偿构成高复制壁垒)+ 信任护城河(单作者纯产品力 + MLX 社区 KOL 背书 + genuinely open)。生态护城河相对弱(绑 Apple Silicon、用户基数远小于 Ollama)。
竞争风险
最大威胁是 Ollama——若它把「持久化前缀缓存 + 连续批处理」补齐(已在 0.19+ 走 MLX),凭生态可快速吞噬这块细分市场。其次是 Apple 若把 server 能力收进 mlx-lm 官方。此外,单作者 bus factor 极高(70%+ 提交集中一人)是项目延续性的隐忧。
生态定位
Apple Silicon × coding agent 的细分蓝海卡位者——「Mac 上跑本地 coding agent 的最优 server」,定位精准但市场天花板受限于 Apple 大内存机型 + 本地 agent 用户规模。中日韩用户占比极高(i18n zh/ko/ja/zh-TW 高频更新)是其传播底盘。
套利机会分析
- 信息差:已是被充分发现的爆款,但「学习价值」被低估——它是「单人 3.8 月把服务端推理优化成功下放到 Apple Silicon 本地」的活教材,叙事性 + 技术深度俱佳,非常适合作为「现象级个人项目」选题。
- 技术借鉴:链式 hash 前缀缓存、冷热双层 + 惰性恢复、异步落盘三件套、适配器 + 内部 IR 多协议网关、vendor-by-patch 追新模型——这些与「Apple Silicon」本身无关,可迁到任何前缀复用推理系统、写密集存储、多协议网关。
- 生态位:填补「为 Apple Silicon 单机、为 agent 工作方式而建的生产级 server」空白,是 Mac 本地 agent 工作流的关键基础设施。
- 趋势判断:本地 AI、隐私、coding agent 都是上升趋势,Apple 大内存机型普及 + 本地模型能力提升利好 oMLX;最大变数是 Ollama 是否补齐这块短板。
风险与不足
- 激进缓存策略的系统级风险:把内存压到极限 + 大量 SSD 落盘,可能拖垮 macOS 内核(#300 kernel panic、Metal/IOKit 竞态),稳定性 vs 极致吞吐是核心张力。作者用「延迟 8 步再 clear_cache」等针对性补偿应对,但这是持续的攻防。
- 追前沿模型的维护负担:高频适配新模型族(各家 chat template/tool parser 各异),新模型一出就可能死循环(#934 qwen 无限循环是全仓最热 issue)。模型覆盖广度是卖点也是最大负担。
- 单作者 bus factor:70%+ 提交集中一人,项目延续性高度依赖作者个人投入。
- 硬件碎片化:oQ/MTP 等自研优化在 M 系列各代表现割裂(#1097 老 M1 吃不到红利),且整体绑定 Apple Silicon + 建议 64GB+ 内存,受众天花板明确。
- 单请求延迟 trade-off:多并发吞吐是强项,但单请求 token 生成在某些场景比 llama.cpp Metal 后端慢 3-7×——它换的是「agent 多轮 + 并发」而非「单请求最低延迟」。
行动建议
- 如果你要用它:在 Mac(M3/M4 大内存)上跑 Claude Code/Cursor 等本地 coding agent——它是当前最优选择,OpenAI/Anthropic drop-in,改 base_url 即可。单用户单轮短上下文场景直接用 MLX/llama.cpp 反而更省开销;它的价值集中在 agent 长上下文 + 并发。
- 如果你要学它:重点读
omlx/cache/paged_cache.py(块管理/链式 hash/CoW/惰性恢复)、omlx/cache/paged_ssd_cache.py(SSD 冷层 + 异步落盘)、omlx/scheduler.py(连续批处理 + Apple 稳定性补偿)、omlx/api/adapters/(双协议网关)、omlx/patches/*/README.md(vendor-by-patch 范本),配合 DeepWiki。 - 如果你要 fork 它:最有价值的是把「链式 hash 前缀缓存 + 冷热持久化分层」「异步落盘三件套」「vendor-by-patch 追上游」这几套机制抽出来——它们是通用工程财富,不限于 Apple Silicon。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/jundot/omlx(已收录,14 大节含架构/引擎/缓存) |
| Zread.ai | 返回 403,未能确认 |
| 关联论文 | 无 oMLX 专属论文;技术血统 vllm-mlx 被 EuroMLSys ‘26 收录;arXiv:2511.05502 MLX/Ollama/llama.cpp 横评 |
| 官网/基准 | https://omlx.ai · https://omlx.ai/benchmarks |
| 社区讨论 | Show HN: oMLX – SSD-backed KV cache cuts coding agent TTFT from 90s to 1s |