GitHub 推荐:5K stars 数学建模 Agent:单人 16 个月做出中文数模圈事实标准
一句话总结
一个北京独立开发者用 16 个月、99 次提交、4 个角色化 Agent(Coordinator/Modeler/Coder/Writer)+ 34 套论文模板,做出了中文数学建模竞赛的「端到端 AI 流水线」:从赛题 PDF 到可直接提交的 Typst/LaTeX 论文,号称「把 3 天压缩到 1 小时」。
值得关注的理由
- 细分赛道的事实标准:5,378 stars / 411 forks 是「中文大学生数模 + AI Agent」垂类的头部,竞品 lyc102/ifml、zhangye-zoe/MathModelAgent 等都已被其覆盖;学术派 MM-Agent 虽拿了 NeurIPS 2025 论文却未达到同等工程化深度。
- SKILL-first 架构的可迁移价值:把整套工作流蒸馏成 6 个 SKILL.md(
1start-mathmodel→6verity),支持npx skills add jihe520/MathModelAgent --all跨 Harness 复用——这是「方法论沉淀」型项目少见的资产形态。 - 强工程化 + 透明技术债:类型注解 / 中文 Google 风格 docstring / 强制 lint hook(ruff + biome)/ macOS 已签名 + Apple 公证的桌面版都已就位;与此同时 README 主动标注 HIL、Evaluator、Web Search、RAG、A2A Hand Off 都「未实现」——这种「做完了什么 + 没做什么」的清晰边界本身值得学习。
项目展示
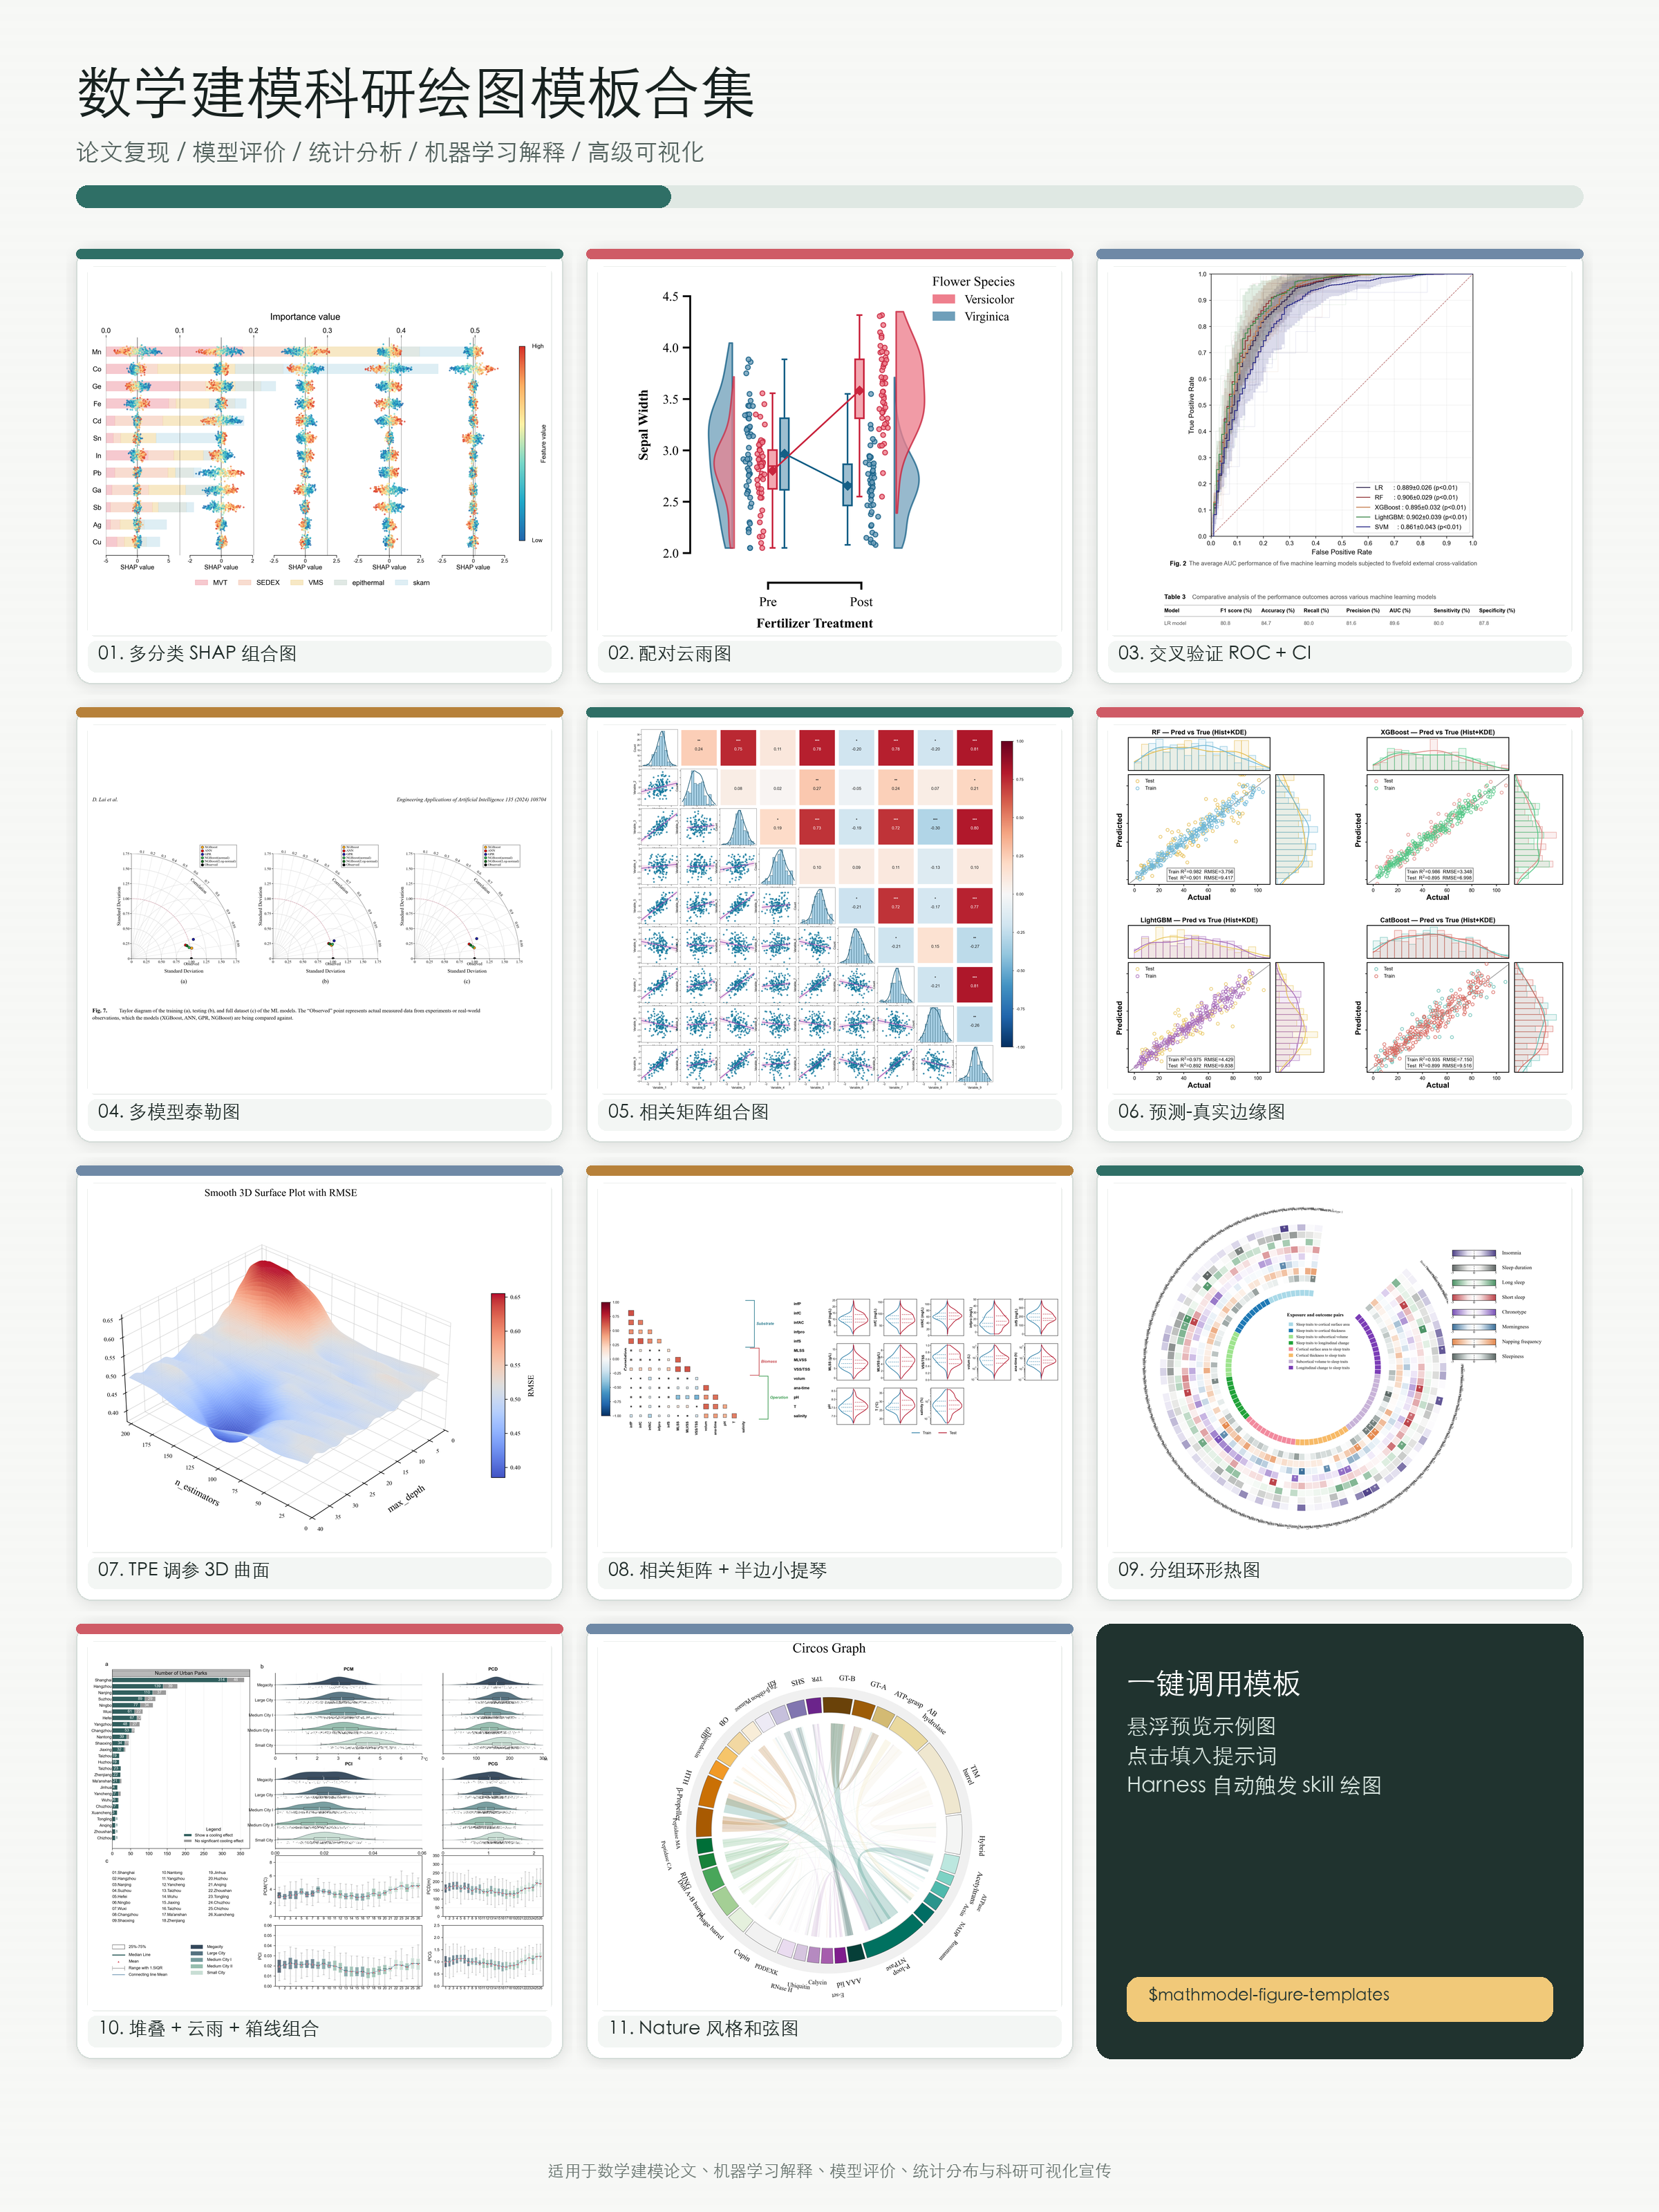
数模竞赛最核心的产出物——配图模板。这是项目差异化资产的代表:模板的多样性与规范性直接决定论文质量。
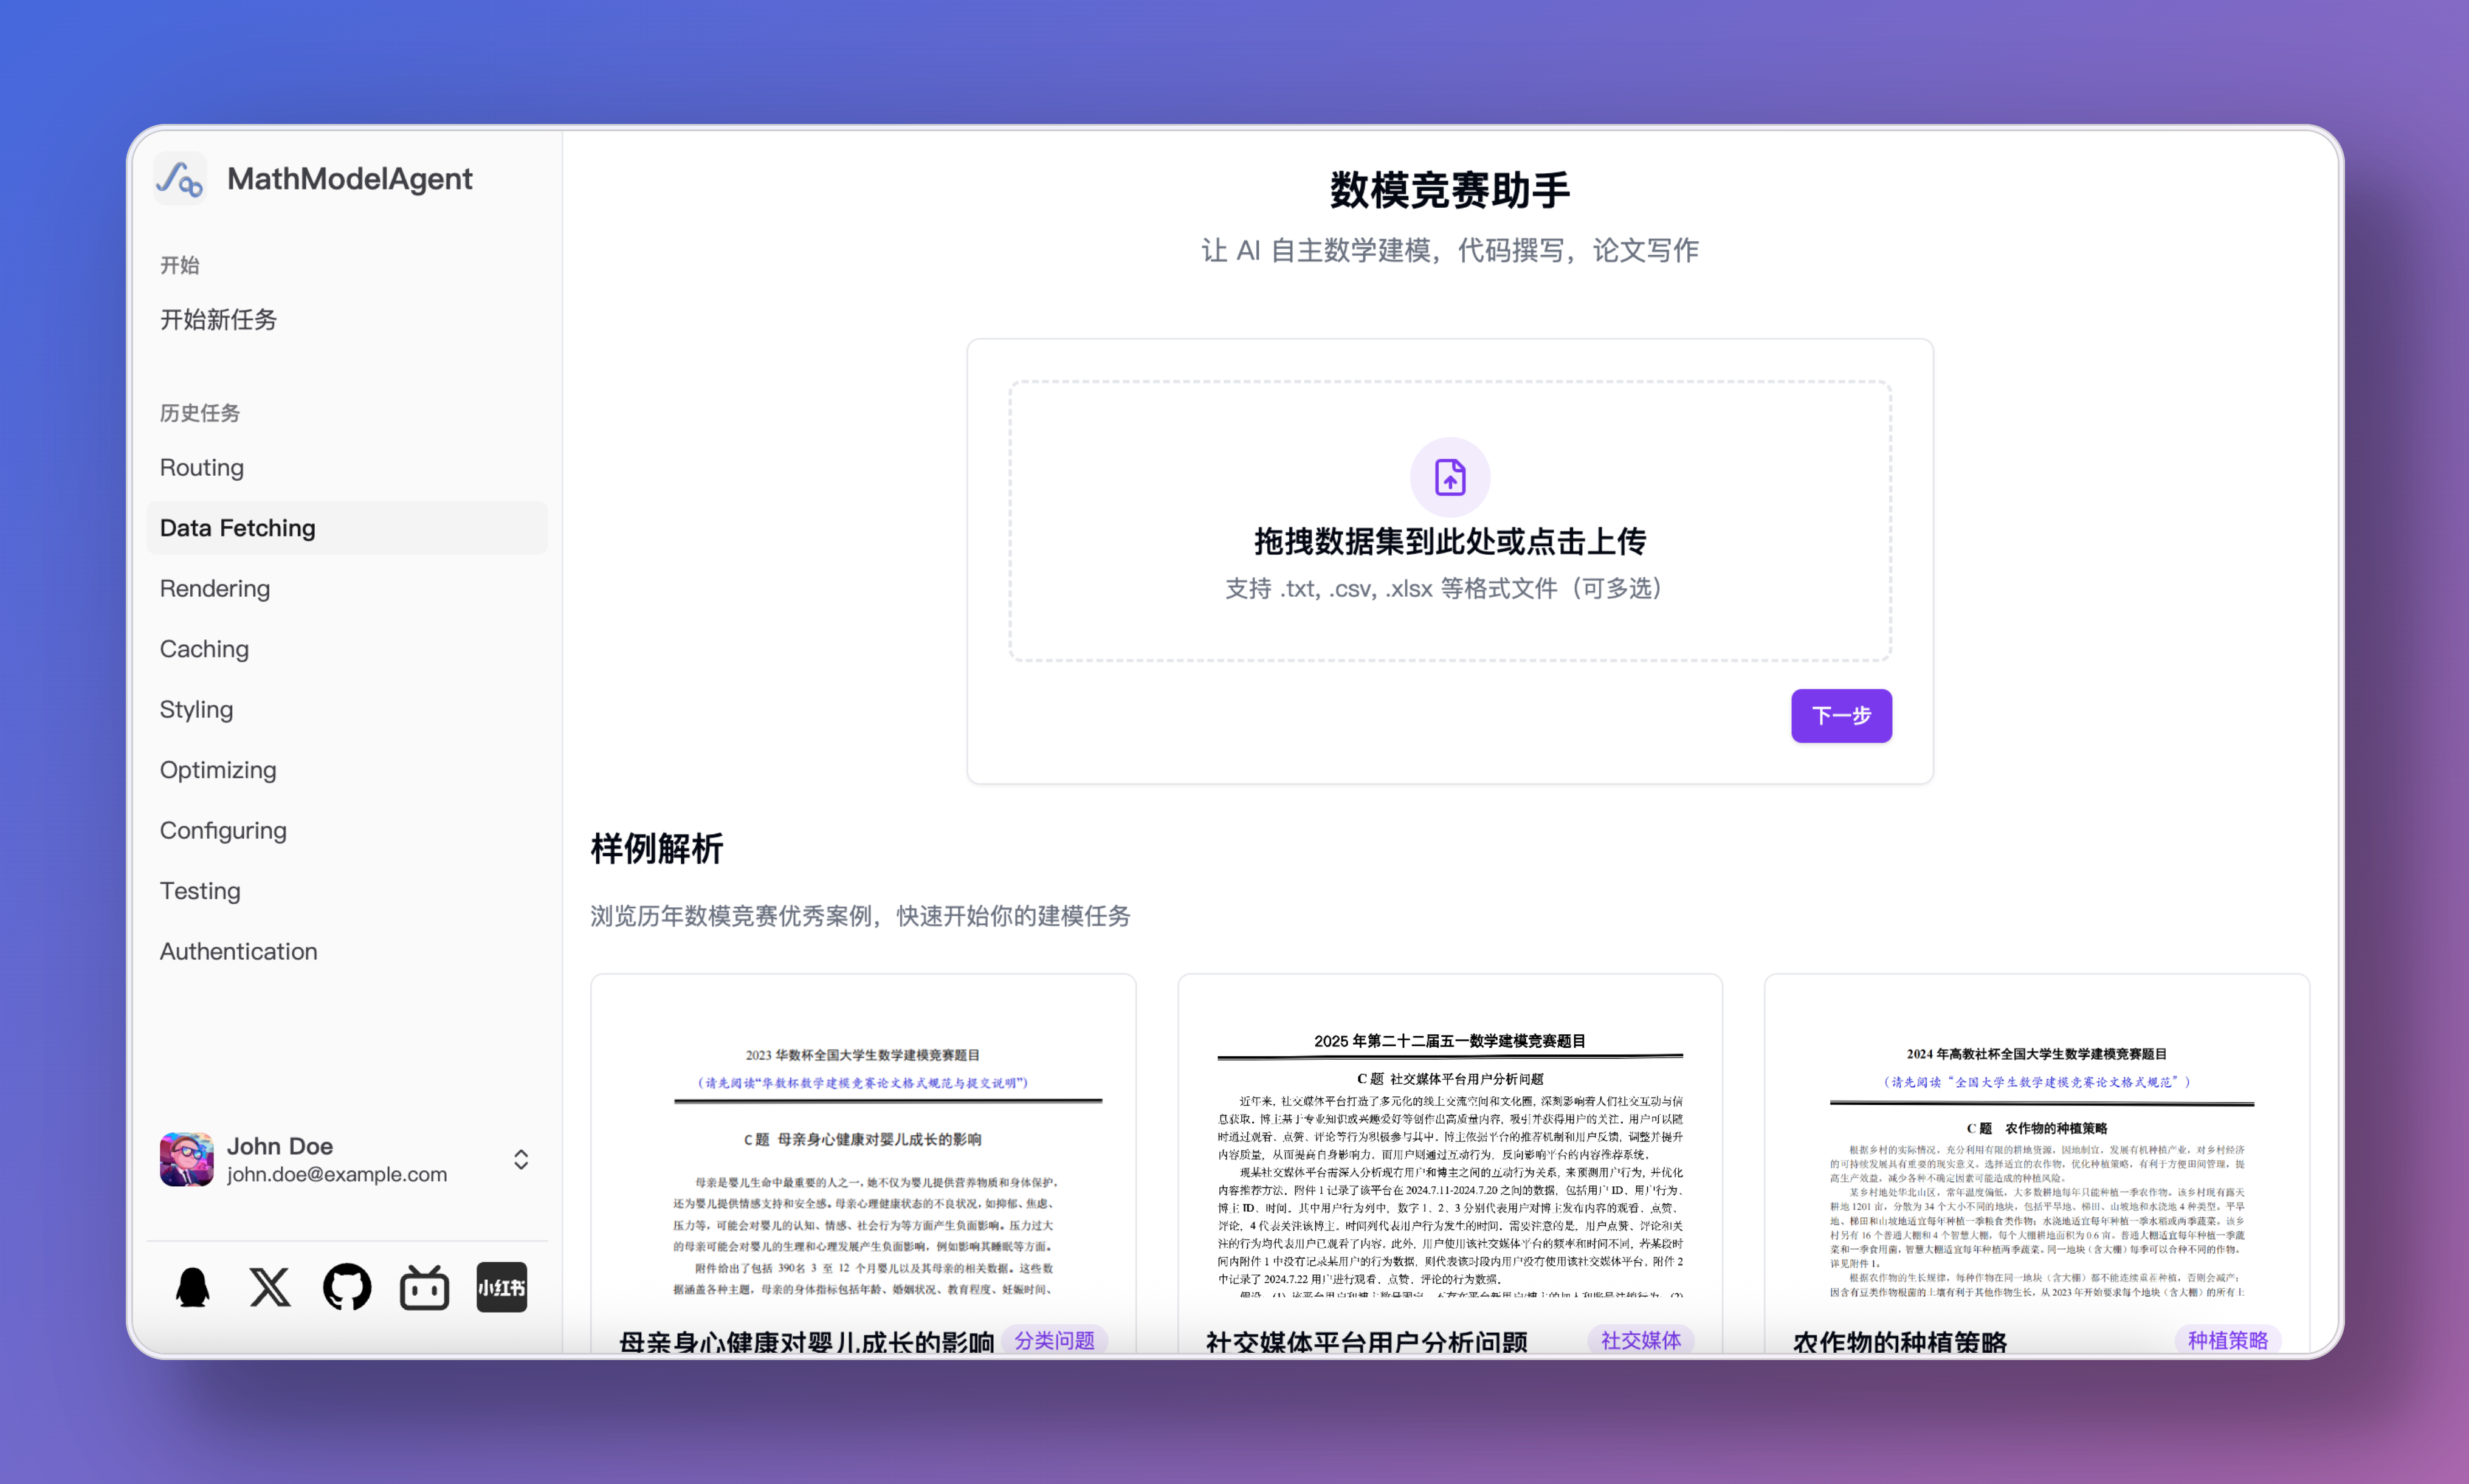
Coordinator / Modeler / Coder / Writer 四 Agent 协同聊天面板,体现「角色分工 + A2A Schema」的核心交互形态。
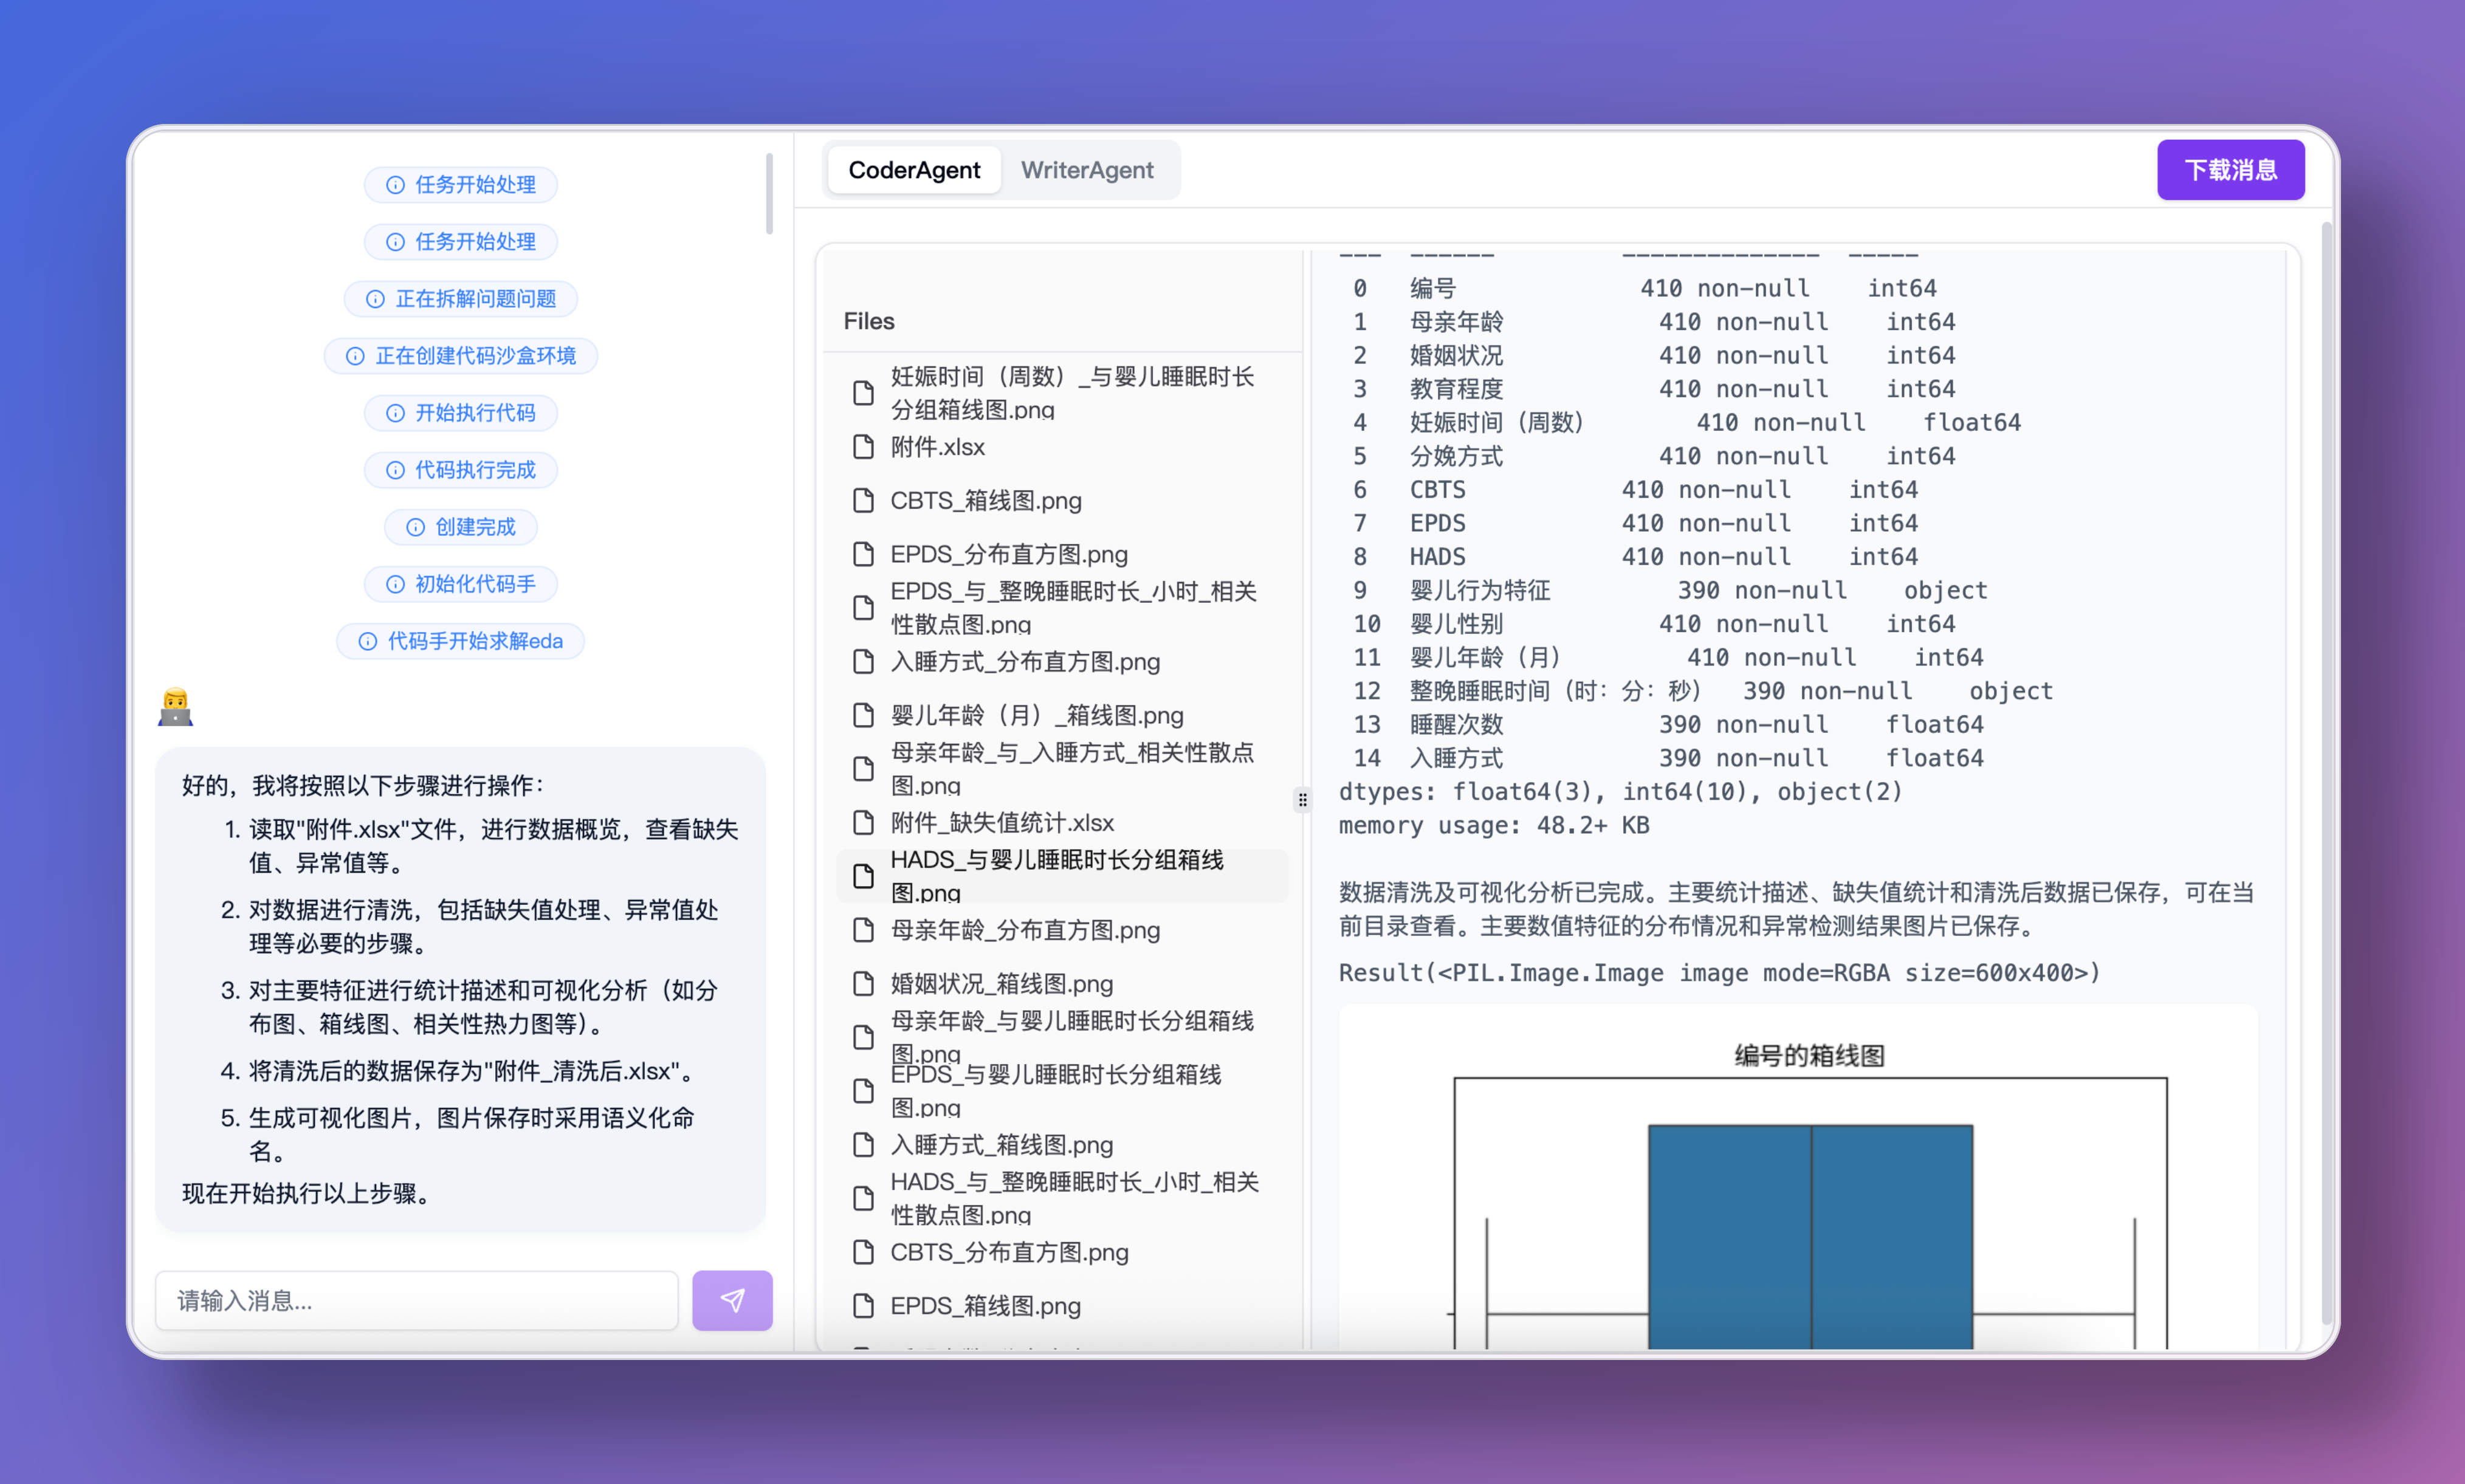
Coder Agent 的本地 Jupyter 内核工作台:数据清洗、建模、可视化都在这里完成,然后由 Writer Agent 落笔。
多 LLM Provider 接入示意(OpenAI / Anthropic / DeepSeek / Qwen / 302.AI 等),每个 Agent 可独立配置模型、Key 和上下文窗口。
B 站与 README 双向引流的 Demo 视频
mathmodelagent.mp4因公众号嵌入限制未直接展示,可访问 https://mathmodel.top/home 观看。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/jihe520/mathmodelagent |
| Star / Fork | 5,378 / 411(Watcher 27) |
| 代码行数 | 21,647 行(Python 36.8% / YAML 22.7% / TeX 17.7% / TS 6.5% / Vue 3.1%);后端 Python 约 6,317 行 |
| 项目年龄 | 16.3 个月(首提交 2025-05-05) |
| 总 commit / 贡献者 | 99 / 13(主作者 Sanjin/jihe520 占比 81.4%) |
| 开发阶段 | 低维护(近 30 天 2 commit、近 90 天 6 commit;月分布呈 2025-05=28 → 2025-09=17 → 2025-10=1 → 2026-05=14 双脉冲衰减) |
| 开发模式 | 职业选手型 Side Project(周末占比 23.2%、深夜占比 28.3%——显著高于纯玩票项目) |
| 热度定位 | 细分赛道头部(中文数模垂类事实标准;通用 Agent 框架不可替代) |
| 质量评级 | 代码 B+ / 文档 A / 测试 D(核心 Agent 零测试) / CI/CD F(无 GitHub Actions) |
| License | 未声明(开源但无 OSI 协议,公众号引用需注明) |
作者视角:为什么存在这个项目
创始人/作者背景
Sanjin(jihe520),北京,账号 8.6 年老 GitHub 用户,公开仓库 22 个,粉丝 105。同期维护 social-push / mindpocket / sci-box / Gutchain 等多个 AI Agent / 工具类项目,把「独立开发者 + 一人多产品」的范式做到位。mathmodelagent 是其 Top 1 项目(其余均 < 600 stars),是真正的「代表作」。8.6 年的账号年龄 + 13 位贡献者中的主导地位说明这不是赶热潮的产物,而是长期观察 + 多次迭代的结果。
问题判断
作者做了两年 Multi-Agent 数模项目并开源,洞察到一个被通用 LLM 工具忽视的卡点:「数学建模竞赛」的真正难点不是 LLM 推理能力,而是工作流的强模板化(论文结构、图表规范、引用格式)+ 子问题之间的强依赖(建模→代码→图表→论文段落的链式传递)。这是一个「LLM Agent 的最佳应用面」——前提是把工作流拆得足够细。
时机选择:2025 年 1 月开仓,恰逢 Claude 3.5 Sonnet / GPT-4o 把长上下文与工具调用稳定性推到可工程化阶段;同时也是美赛/国赛赛季前——这是「技术可行性 × 季节性需求」的双重窗口。
解法哲学
- 不替代人的判断,只替代重复劳动:策略选择、模型假设这类高价值判断留给人;清洗、编码、画图、排版、引用这类重复劳动给 Agent。
- 多 Agent 角色分工 + 显式 A2A Schema:Coordinator→Modeler→Coder→Writer→Verifier 流水线 + Pydantic 强类型 JSON 传递 +
MAX_JSON_RETRIES=3。拒绝「单模型 prompt hack」,因为难以调试。 - 端到端 → 分段可重入:每个子问题独立走「建模→代码→论文」三步,依赖通过 Schema 显式传递——这正是 issue #63 揭示「端到端一次性生成」长上下文天花板的设计层回应。
- SKILL-first 而非 Harness-first:把工作流蒸馏成 6 个 SKILL.md,让 Claude Code / Codex / Pi 等 Harness 直接驱动,避免被自研 Harness 绑架。
战略意图
- 短期:桌面版分发(macOS 已签名 + Apple 公证;Windows 待签名)降低学生部署门槛。
- 中期:SKILL 单独发布为
npx skills add jihe520/MathModelAgent --all可安装的包,跳出数模向「长流程 + 模板密集」的任意任务渗透(如白皮书、综述报告)。 - 长期:从「单场竞赛助手」升级为「科研写作自动化平台」,与姊妹项目 sci-box(科研图表 SKILL)联动。
- 商业化路径:暂未明示 SaaS / 托管版,但桌面版 + 自托管 + 多 LLM Provider 的产品形态本身已是「开源 + 增值服务」的成熟范式。
数据源:Phase 1 已通过 WebFetch 官网 https://mathmodel.top/home 与 README 采集核心叙事;本节推断基于代码(CLAUDE.md / SKILL.md / Issue #67 等)的作者意图识别。
核心价值提炼
创新之处
按新颖度×实用性排序:
- SKILL-first 而非 Harness-first(新颖度 4/5、实用性 5/5、可迁移性 5/5):把整套方法论蒸馏成可被任何 Harness 加载的 SKILL.md 资产,是「方法论沉淀」型项目的少见范式——知识可移植,用户不被自研 UI 绑架。
- 「图后必须 print 数据特征」强制 prompt 规范(新颖度 4/5、实用性 5/5、可迁移性 5/5):解决 LLM 看不到图、只能拿 stdout 写图注的核心痛点:
print("【图X数据特征】R²=...MAE=...")。方法粗暴但极有效。 - Agent 工具调用完整性保护(新颖度 3/5、实用性 4/5、可迁移性 5/5):
_is_safe_cut_point+_validate_and_fix_tool_calls防孤立 tool 消息触发 API 400;75% 阈值 → LLM 总结 + 安全切割点——长轮次 tool-use Agent 的通用解法。 - 本地 Jupyter + E2B 云沙箱双解释器抽象(新颖度 3/5、实用性 4/5、可迁移性 5/5):
BaseCodeInterpreter抽象 + 本地版 UTF-8 强制 + 中文字体注入;E2B 应对「学生电脑参差」的部署现实。 - Typst + LaTeX 双排版引擎 + 34 套模板(新颖度 3/5、实用性 5/5、可迁移性 4/5):老用户 LaTeX vs 新生代 Typst 的兼容策略;
5writing/SKILL.mdAskUserQuestion 选引擎,默认 LaTeX 兜底;6verity自动识别.typ/.tex走不同编译链。 - 多 LLM 配置(每 Agent 独立 model/key/context_window)(新颖度 2/5、实用性 4/5、可迁移性 4/5):成本敏感的多角色 Agent 标配;自研
LLMFactory替代 LiteLLM 换取可控性。 - 6 HIL 决策动作数据模型(新颖度 3/5、实用性 3/5、可迁移性 4/5):
HIL_CHECKPOINTS4 节点 + 6 决策动作——设计先行、闭环 TODO,是少见的人机协作 Agent 暂停-恢复模式。
可复用的模式与技巧
- A2A Schema + 多 Agent 流水线:分阶段跨领域任务的标配。适用:任何「X → Y → Z」链式产出。
- Provider 抽象 + 多 LLM 配置:成本敏感型多角色 Agent 必备。适用:要让用户「按角色优化 token 成本」的场景。
- Jupyter 本地 + 云沙箱双解释器 + NotebookSerializer:Jupyter-based Agent 的部署现实解。适用:科学计算类 Agent。
- Redis Pub/Sub + WebSocket + 落盘兜底:长任务实时反馈的工程范式。
asyncio.wait(chat_task, cancel_wait_task)实现可中断的 Stop。适用:5~30 分钟级 AI 任务。 - 「图后 print 数据特征」+ 全局 rcParams 注入:vision-less 数据可视化的 prompt+rcParams 双锁。适用:任何需要「LLM 自审图表」的 Agent。
- SKILL-first 而非 Harness-first:方法论可移植资产。适用:知识密集 + 长流程场景。
- 桌面版分发(内嵌 Claude Code + 1 个 API Key 起步):降低 LLM App 使用门槛的硬工程。适用:技术学生 / 非开发者用户。
关键设计决策
- 决策:四角色多 Agent + 显式 A2A Pydantic Schema(
CoordinatorToModeler/ModelerToCoder/CoderToWriter)- 问题:单模型「熵增」,prompt hack 难调试
- 方案:流水线 + JSON 强类型 Schema +
MAX_JSON_RETRIES=3 - Trade-off:流程长 / token 多,但换来「单步可重跑、可定位失败」
- 可迁移性:高
- 决策:Agent 基类记忆压缩 + 工具调用完整性保护
- 问题:长轮次 CoderAgent 撑爆 context;乱删产生孤立 tool 消息触发 API 400
- 方案:75% 阈值 → LLM 总结 + 安全切割点 + 请求前清洗悬挂 tool_calls
- Trade-off:总结可能丢细节,但保住工具一致性(issue #63 长上下文天花板的缓兵之计)
- 可迁移性:高
- 决策:多 LLM 配置 + Provider 抽象(自研替代 LiteLLM)
- 问题:不同 Agent 适合不同模型;旧版 LiteLLM 切换耦合深
- 方案:
LLMFactory4 角色独立装配;BaseProvider+ 3 实现;Anthropic 与 OpenAI 走不同 tool schema - Trade-off:自研比 LiteLLM 重但可控
- 可迁移性:中
- 决策:本地 Jupyter + E2B 云沙箱双解释器
- 问题:学生电脑参差,需要可重入 / 可中断 / 可隔离
- 方案:
BaseCodeInterpreter抽象 +LocalCodeInterpreter(UTF-8 强制 + 中文字体注入)+E2BCodeInterpreter,共用NotebookSerializer - Trade-off:本地版要 Python + Redis;E2B 依赖外网
- 可迁移性:高
- 决策:Redis Pub/Sub + 消息落盘(
logs/messages/{task_id}.json)- 问题:长任务 5~30 分钟需要流式 + 不丢消息
- 方案:
redis_manager.publish_message+ws_router订阅 + 落盘兜底 - Trade-off:多 Redis 依赖 + 落盘 IO 开销
- 可迁移性:高
- 决策:预校验配置 →
LLMConfigError(与ValueError区分)- 问题:旧版缺 API Key 时跑 CoordinatorAgent 才报错,调试路径长
- 方案:workflow 入口前 fail-fast
- Trade-off:前端需处理 400 / 500
- 可迁移性:高
竞品格局与定位
竞品对比矩阵
| 维度 | mathmodelagent | lyc102/ifml | MM-Agent (NeurIPS 2025) | docs.reaslab.io | 通用 Agent(deer-flow/MetaGPT) |
|---|---|---|---|---|---|
| 形态 | 端到端 Web+桌面+SKILL | Prompt 清单 | 学术方法 + 论文 | 闭源 SaaS | 通用 Harness + Library |
| Stars | 5,378 | ~1k(估) | 数百 | 闭源 | 7-10w(远超) |
| 多 Agent 编排 | 强(4 角色 + A2A Schema) | 无 | 中 | 闭源不可见 | 强 |
| 论文模板 | 34 套(Typst+LaTeX 双引擎) | 无 | 学术模板 | 桌面模板 | 需自己写 |
| 开箱即用度 | 高(桌面版 1 个 API Key) | 中 | 低(论文级) | 高(但需注册) | 低 |
| 中文数模适配 | 深度(子问题节奏 / 配图规范) | 浅 | 学术通用 | 中 | 无 |
| 开源完整度 | 100% | 100% | 论文级 | 0%(闭源) | 100% |
| 学术背书 | 无 | 无 | NeurIPS 2025 / ICML 2025 AI4MATH | 无 | 无 |
| SKILL 化资产 | 有(6 SKILL.md) | 无 | 无 | 无 | 无 |
差异化护城河
- 端到端流水线最深:从赛题 PDF → 多 Agent 协同 → Typst/LaTeX 论文 → 编译 → 验收,整链路自闭环。
- 模板资产最全:34 套(14 中文 + 3 英文 × 双引擎)模板 + 17 个数学建模专用图表模板。
- SKILL 化资产沉淀可跨 Harness:
npx skills add jihe520/MathModelAgent --all让方法论不被自研 UI 绑架。 - 中文数模圈用户基数:5,378 stars + mathmodel.top 平台 + sci-box 联动 = 中文数模场景的「默认入口」。
竞争风险
- 学术派 MM-Agent 若开源:方法论一旦补齐工程化就是直接威胁。
- HIL / Evaluator 闭环未完整 + issue #63 长上下文天花板:是「能不能跑出 Top 2% 论文」的硬伤。
- 单人主导 75% commits:维护者精力有限,issue #67 显示社区 contributor 主动提议 Web Search / RAG / HIL / Feedback 但维护者态度暧昧。
- 测试覆盖 0%:核心 Agent / Workflow / Tools 零测试,重构风险大。
- License 未声明:开源但无 OSI 协议,企业使用有合规风险。
生态定位
中文数模垂类的「事实标准」+ 「数模场景的 Cursor」——既是工具也是社区入口。通用 Agent 框架(deer-flow / MetaGPT / learn-claude-code)覆盖的是「通用长程任务」,mathmodelagent 覆盖的是「特定场景的端到端工作流 + 模板 + 规范」,两者错位竞争。
套利机会分析
- 信息差:低(垂类头部 5K stars,已经不是被低估的潜力股)。但是对 Agent 开发者来说,作者的 SKILL 化思路与
npx skills add分发范式是值得学习的「方法论迁移」范式——大多数 AI 工具还在卷 UI 和 SaaS。 - 技术借鉴:① A2A Schema + 强类型 JSON 传递;② 工具调用完整性保护(防孤立 tool 消息);③ 「图后 print 数据特征」+ 全局 rcParams 注入;④ Redis Pub/Sub + 落盘兜底的长任务反馈模式——四条都是可立即迁移到任何 LLM Agent 项目中的工程技巧。
- 生态位:在「中文数模」垂类已无空白可填;真正的空白是「其他长流程 + 模板密集」的细分赛道(如白皮书、综述报告、学术论文综述)——这正是作者战略图景中提到的中期方向。
- 趋势判断:在「Harness 能力趋同 + 模型能力趋同」的趋势下,SKILL 化的领域方法论沉淀将成为差异化主战场。mathmodelagent 的 SKILL 资产是其穿越模型周期的护城河。
风险与不足
- 技术债明显:test/refactor 双 0%;commit 中 refactor 仅 2%;核心 Agent / Workflow / Tools 无任何测试覆盖——意味着每次 Agent 编排改动都是「带病上线」。
- 关键功能未闭环:HIL、Evaluator、Web Search、RAG、A2A Hand Off 都在 README 明确标注「未实现」;issue #63 长上下文天花板是「端到端一次性生成」假设的硬伤。
- 单人主导 + 维护疲劳:近 30 天仅 2 commit、近 90 天 6 commit,月分布已从 28 → 17 → 1 → 14 → 骤降;8.6 年老账号 + 多产品并行,Sanjin 精力有限是真实的项目风险。
- License 缺失:开源但未声明 OSI 协议,企业使用与二次分发存在法律模糊。
- CI/CD 空白:无 GitHub Actions,仅靠
.claude/hook_lint.sh的本地 PostToolUse ruff/biome 检查——质量保障主要靠人工。
行动建议
- 如果你要用它:作为中文数模参赛工具,桌面版(macOS 已签名,Windows 待签名)+ 1 个 API Key 是最低门槛方案。建议先用「中文 LaTeX 模板」跑美赛/国赛,把 17 套图表模板与「图后 print 数据特征」规范用足。注意:不要把 5,378 stars 当作「学术背书」——它没有论文级评测。
- 如果你要学它:重点关注
backend/app/core/agents/agent.py(记忆压缩 + 工具完整性保护)、backend/app/core/prompts/(4 Agent system prompt)、backend/app/core/workflow.py(编排)、backend/app/core/llm/(Provider 抽象)、skills/5writing/SKILL.md(论文写作 SKILL 范式)。这五个文件组合起来就是「多 Agent + SKILL-first」的最小可复用工程模板。 - 如果你要 fork 它:① 把 issue #63 的「长论文分段续写 + 检查点」做实(这是核心痛点);② 把 HIL 6 决策动作落地为工作流;③ 把测试覆盖补到核心 Agent / Workflow(哪怕 10% 也比 0% 好);④ 加 LICENSE(推荐 Apache-2.0);⑤ 探索非数模场景的 SKILL 迁移(如科研综述、白皮书)。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 未收录(页面仅 Loading,无实质内容) |
| Zread.ai | 未收录(Cloudflare 403 拦截) |
| 关联论文 | 无独立 arXiv;同类 MM-Agent 有 NeurIPS 2025 / ICML 2025 AI4MATH 论文 |
| 在线 Demo | https://mathmodel.top/home(截图演示 + 视频);GitHub Releases 提供桌面端下载(macOS / Windows) |