Jane Street 的 magic-trace:把没人会用的 Intel PT 变成一键看进程最后 10ms 在干嘛
一句话总结
量化交易公司 Jane Street 用 OCaml 写的高分辨率性能追踪工具——把 CPU 里早在 2013 年就存在、却因「采集难、输出不可读、无快照工作流」而几乎没人用的 Intel Processor Trace(Intel PT)封装成开箱即用的命令行工具:零代码改动、约 40ns 函数调用级分辨率、2-10% 开销,事后快照某事件前约 10ms 的完整控制流,在 Perfetto 时间轴上可视化。它专治传统采样式 profiler 抓不到的「微秒级延迟尖刺」,真实业务代码仅约 9.3K 行 OCaml。
值得关注的理由
- 把一个被冷落的硬件能力做成「人人可用」的范本:Intel PT 能全量记录程序控制流,但要啃
perf_event_open/libipt、原始输出近乎不可读。magic-trace 用环形缓冲快照 + 硬件断点零侵入 attach + 自动符号解析 + 一键输出 Perfetto,把它从「内核开发者专属」变成「一条命令」。这是「产品化一个晦涩底层能力」的教科书案例。 - 罕见的硬核系统工程 + 函数式语言组合:用 OCaml(Jane Street 的 Core/Async/Command 生态,甚至未发布的 OxCaml 编译器扩展:unboxed 元组、or_null 空值类型、栈分配)写贴着 Linux 内核/Intel 硬件的工具——这本身反直觉。它还是「函数式语言能否零分配写系统工具」的存在性证明。
- 诚实暴露「封装外部工具」的架构双刃剑:magic-trace 本质是解析
perf script文本输出,这让它继承了跨内核/perf 版本/CPU 微架构的解析脆弱性(issue #196/#191 的崩溃根源)。它的「能力探测 + 优雅降级」层和巨型%expect_test金标夹具(15.6 万行内联真实 perf 输出做端到端回归)都是应对这道裂缝的工程智慧,值得学。
项目展示
magic-trace 项目 Logo。
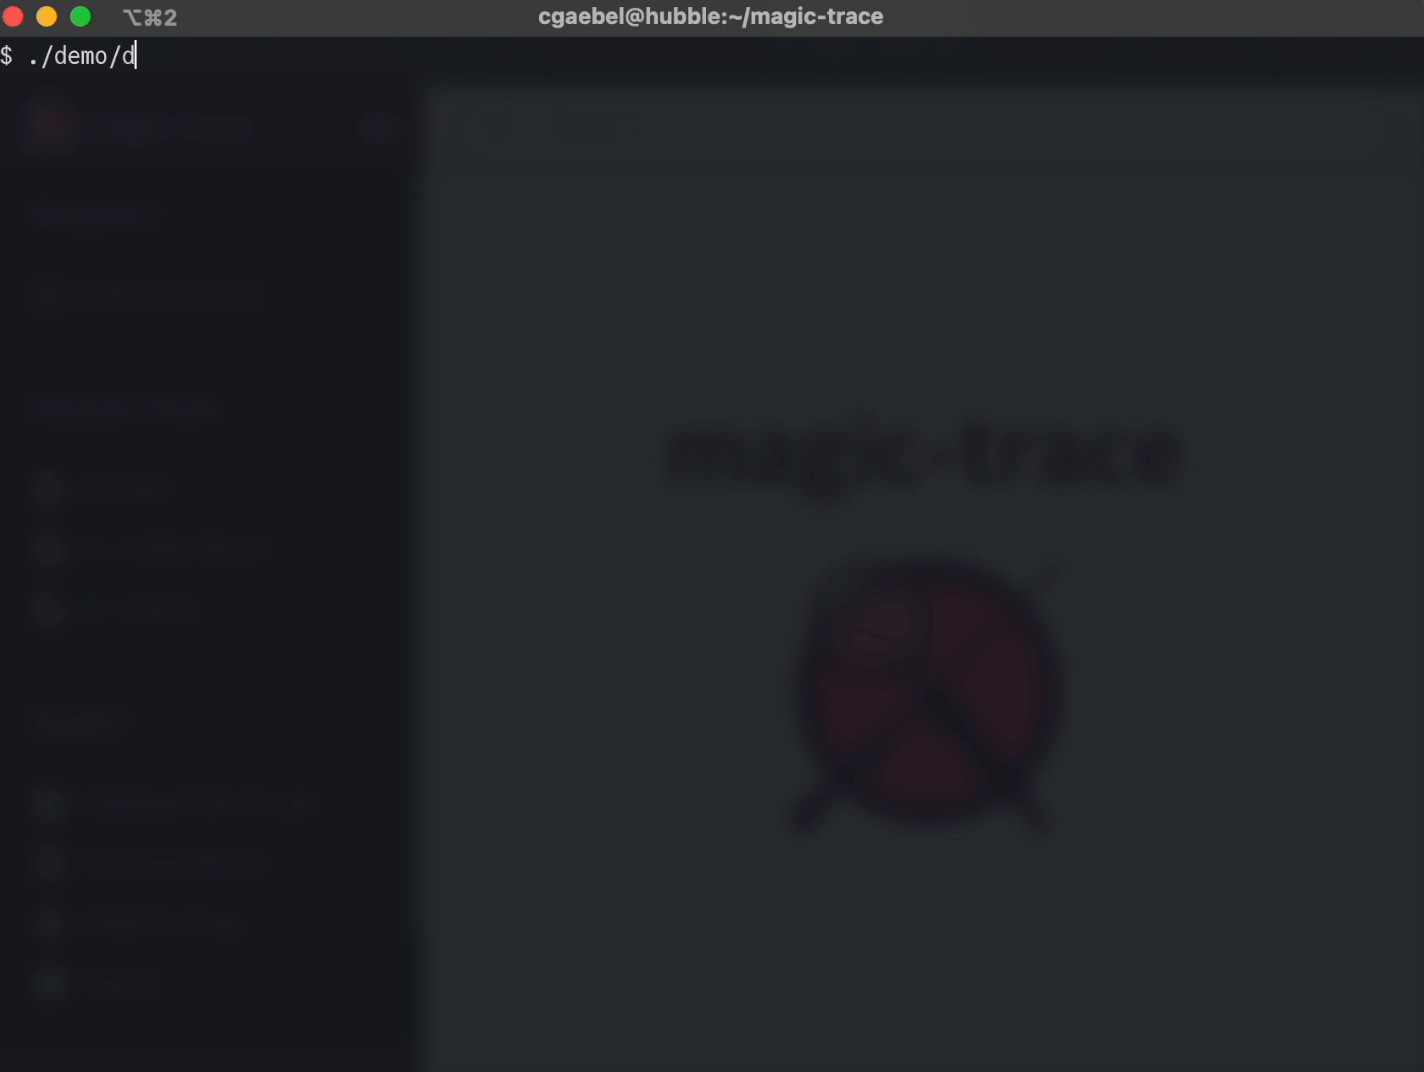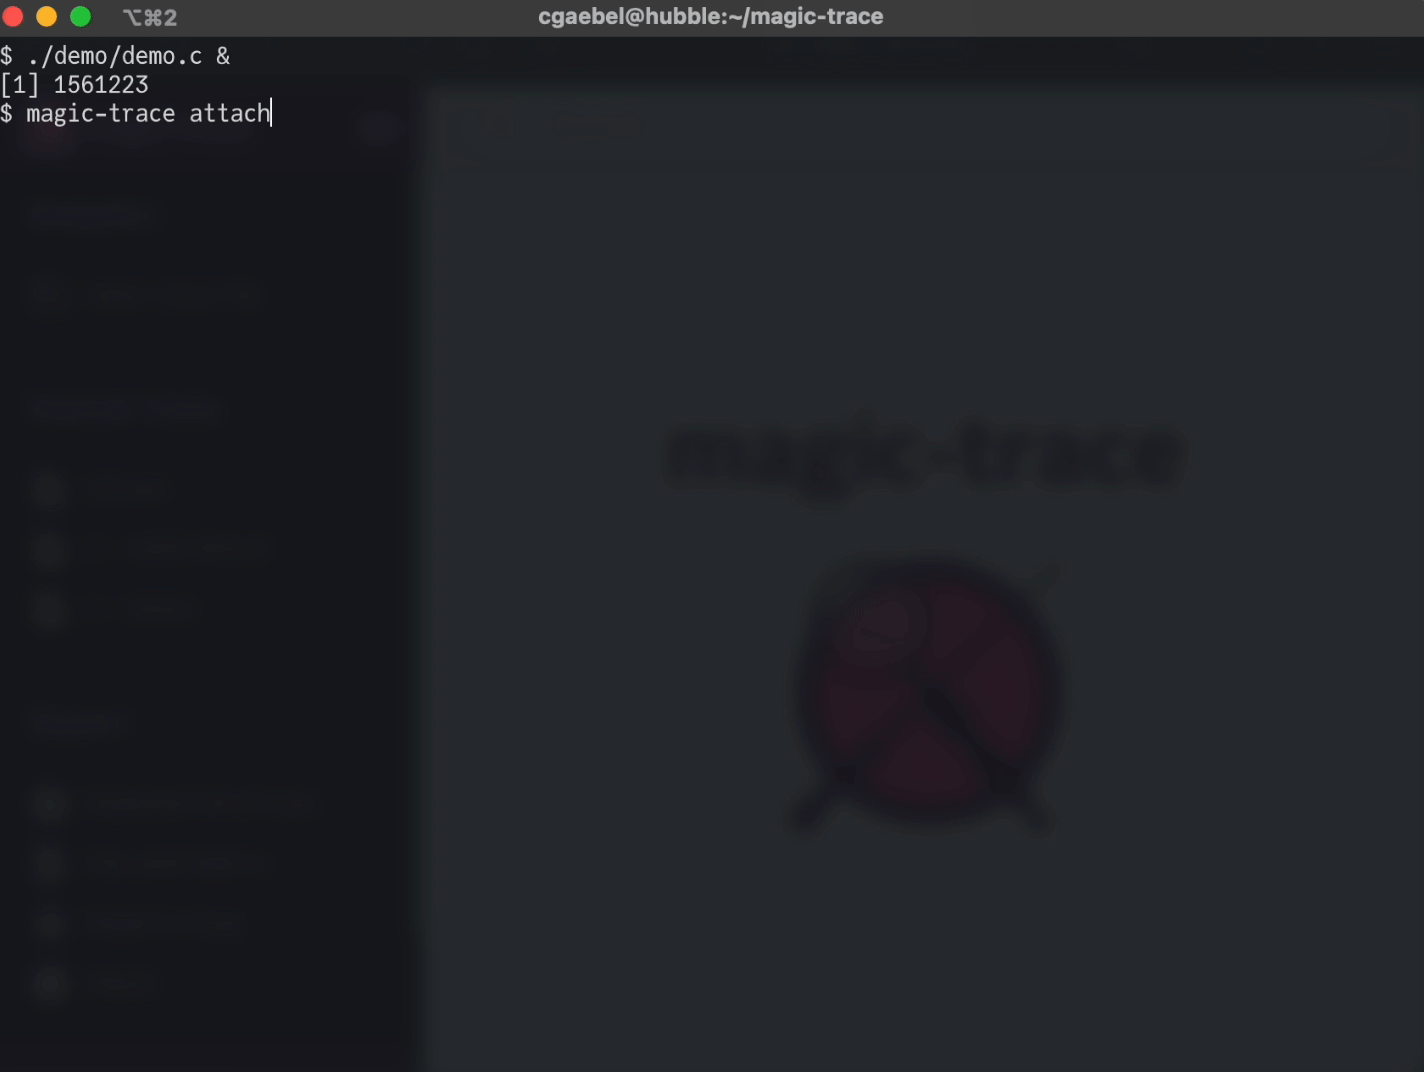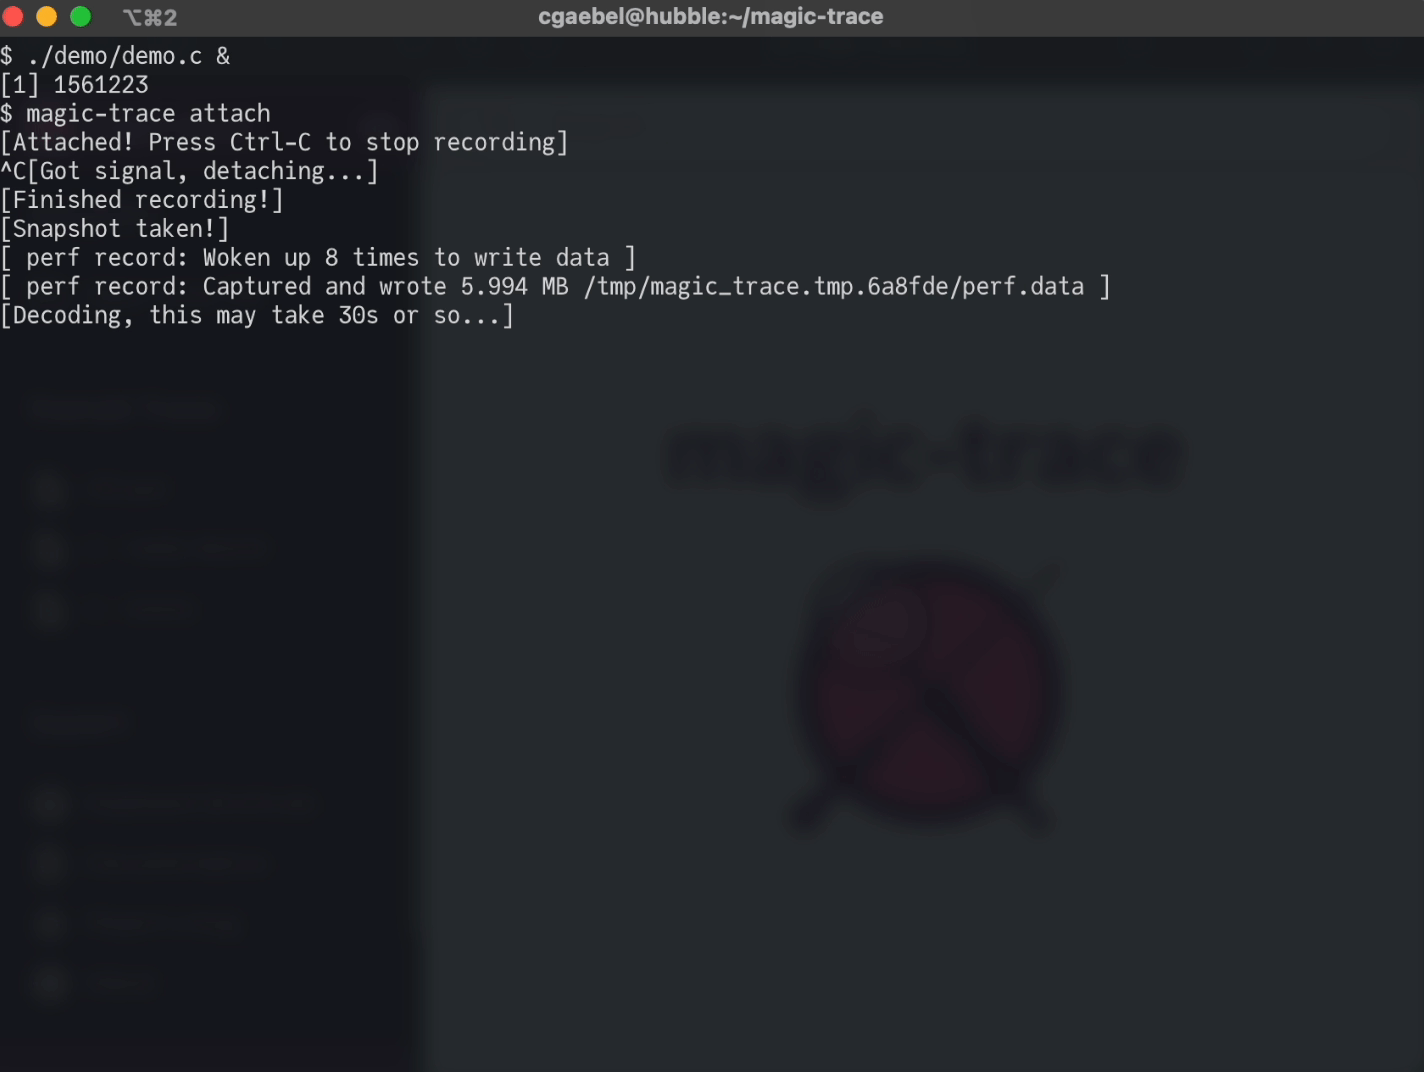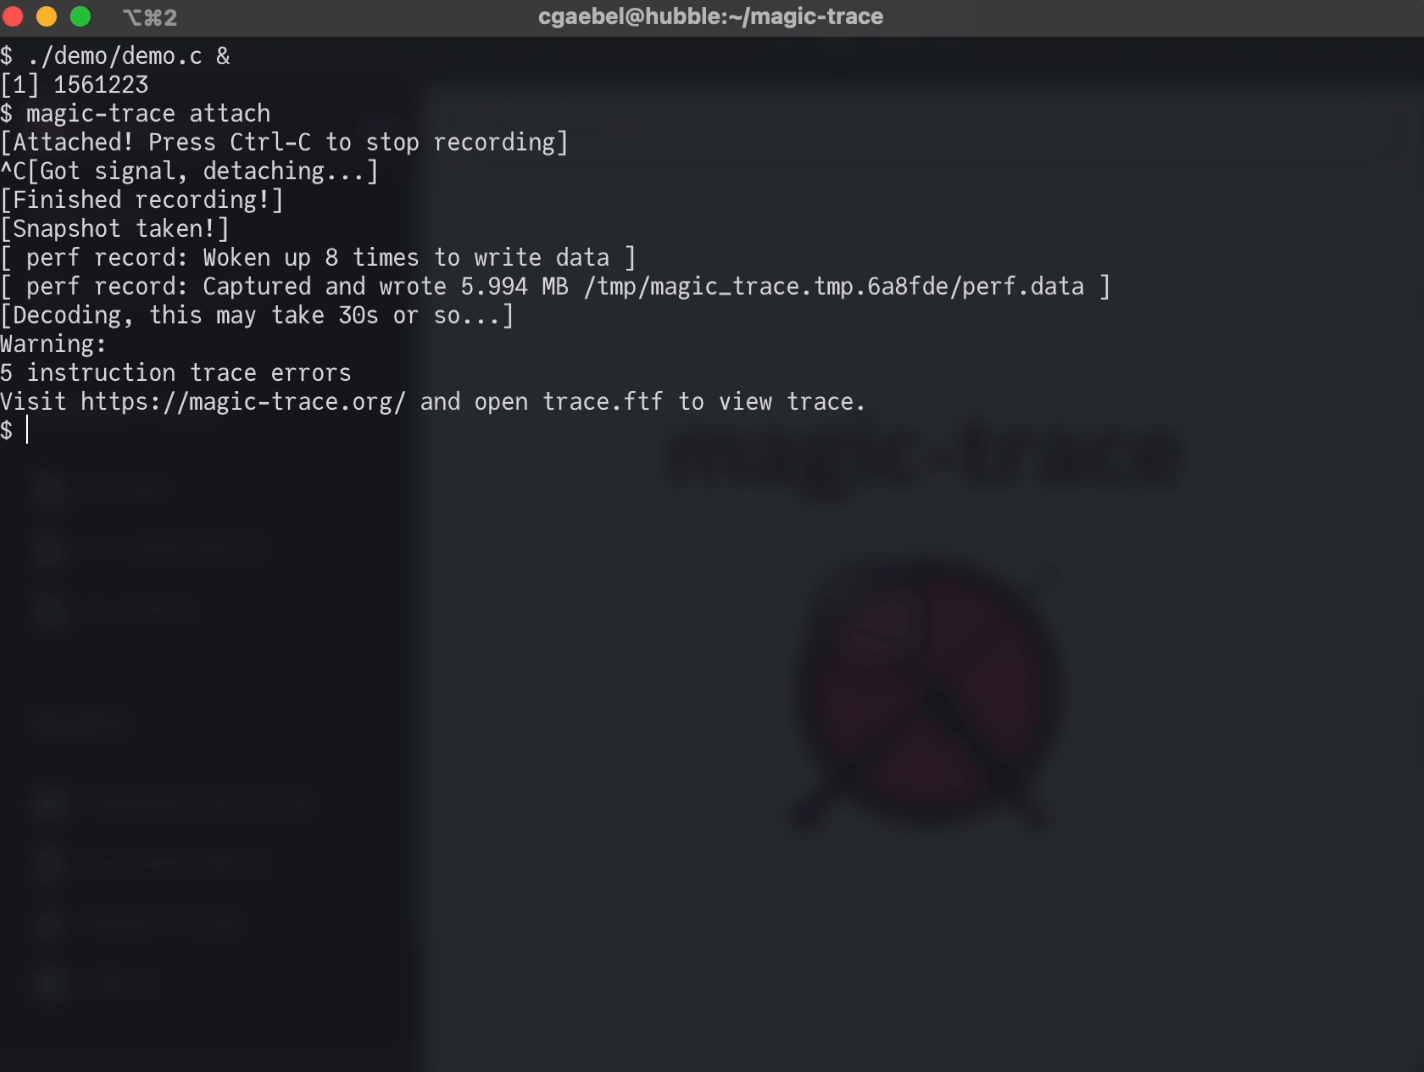
Stage 1:attach 到运行中进程采集。
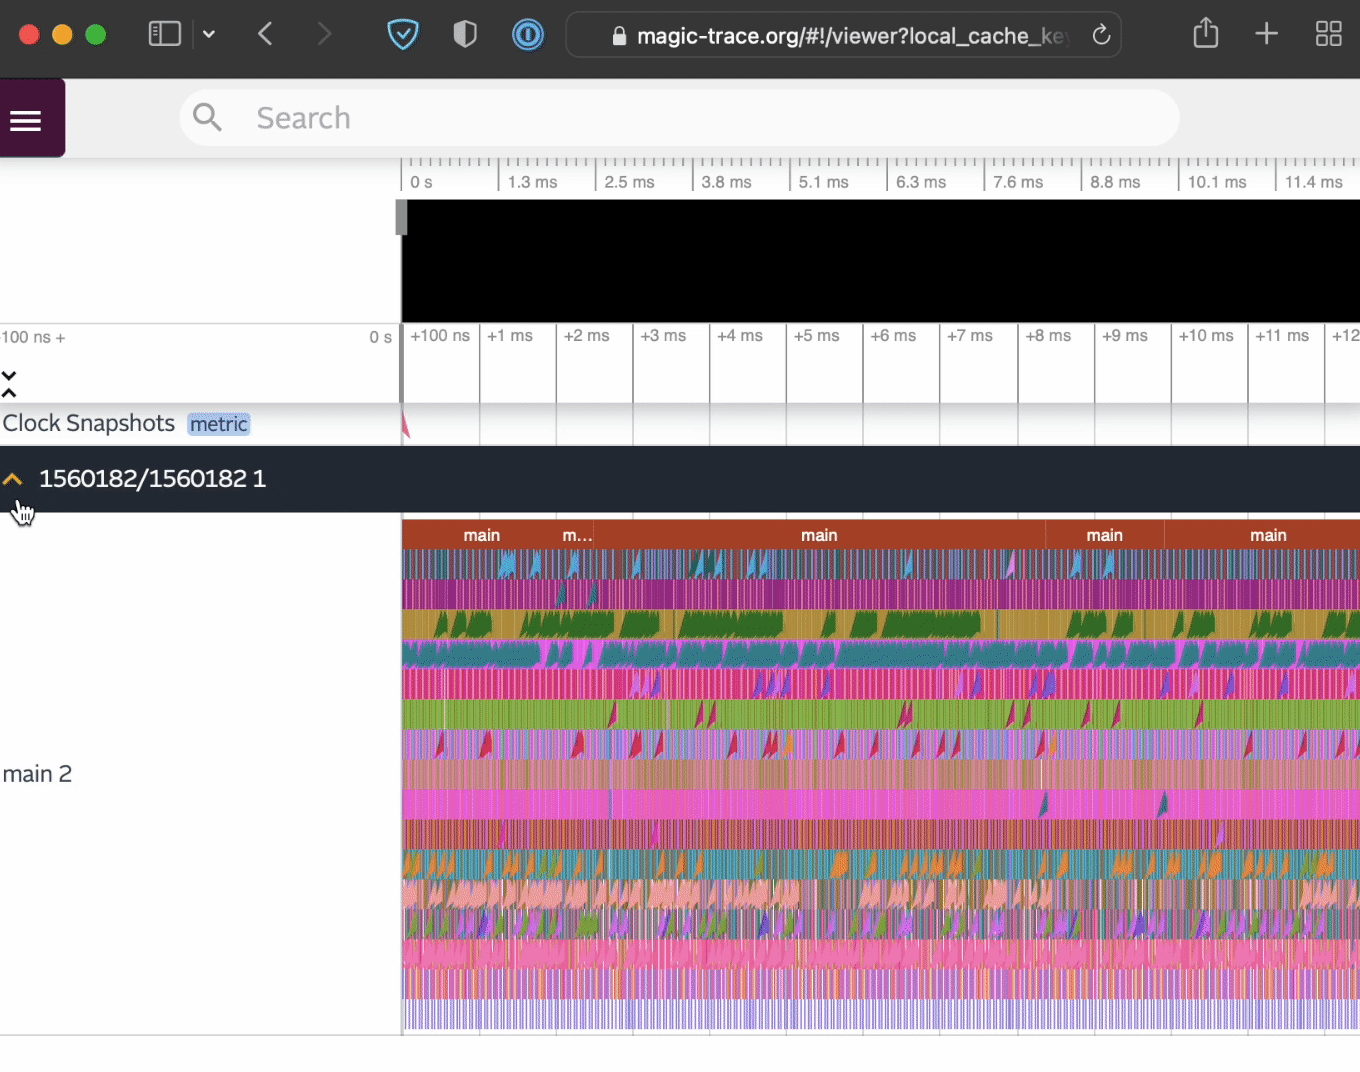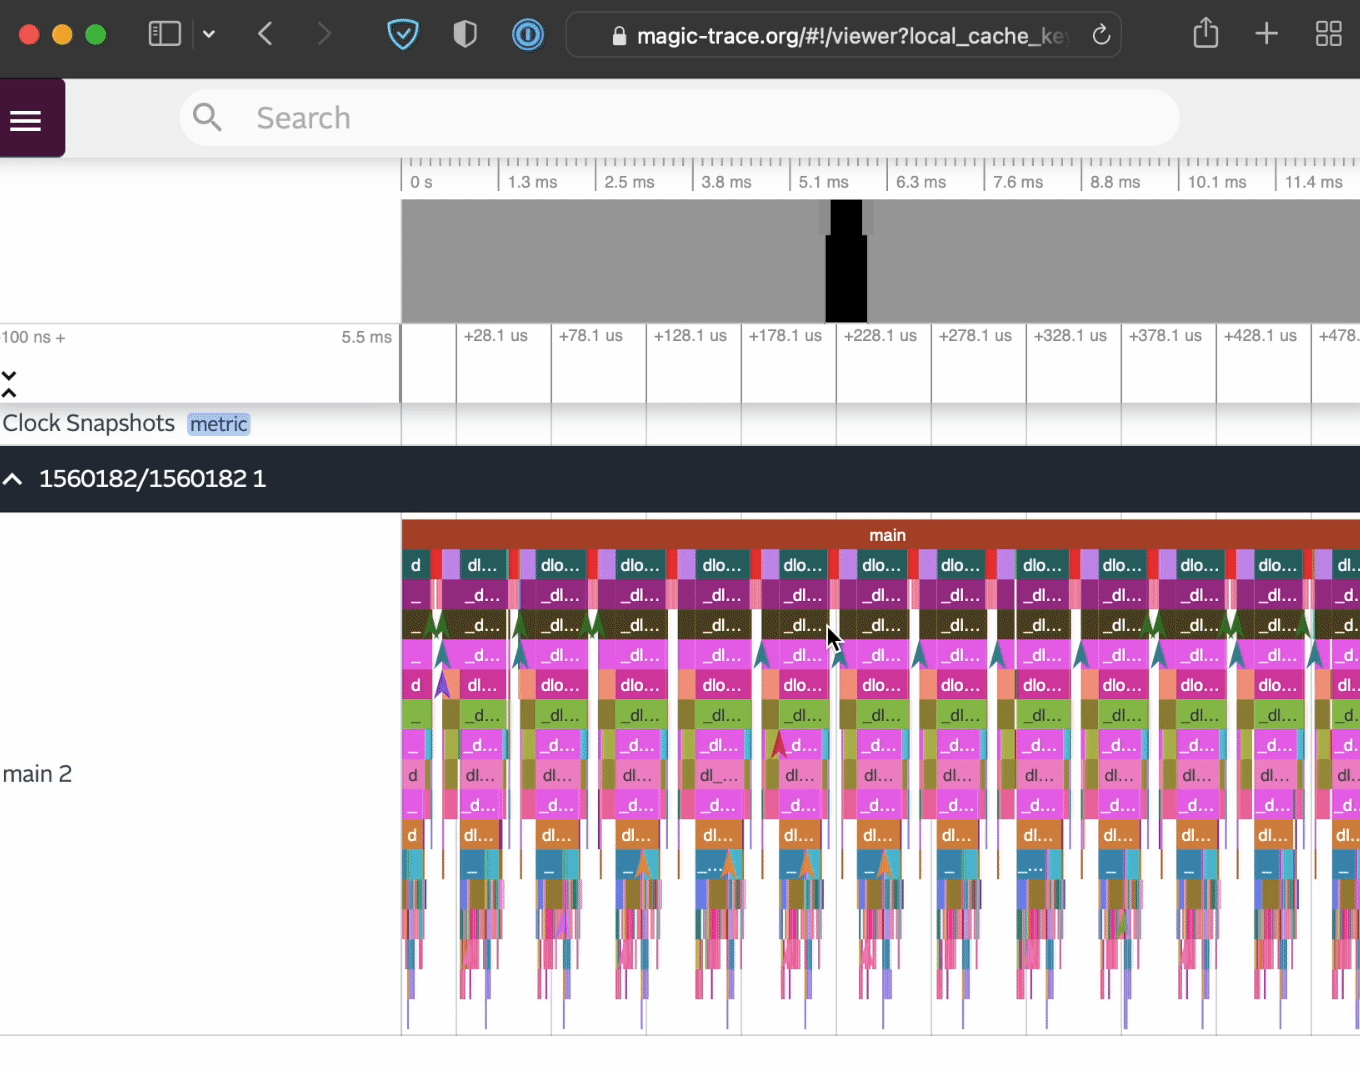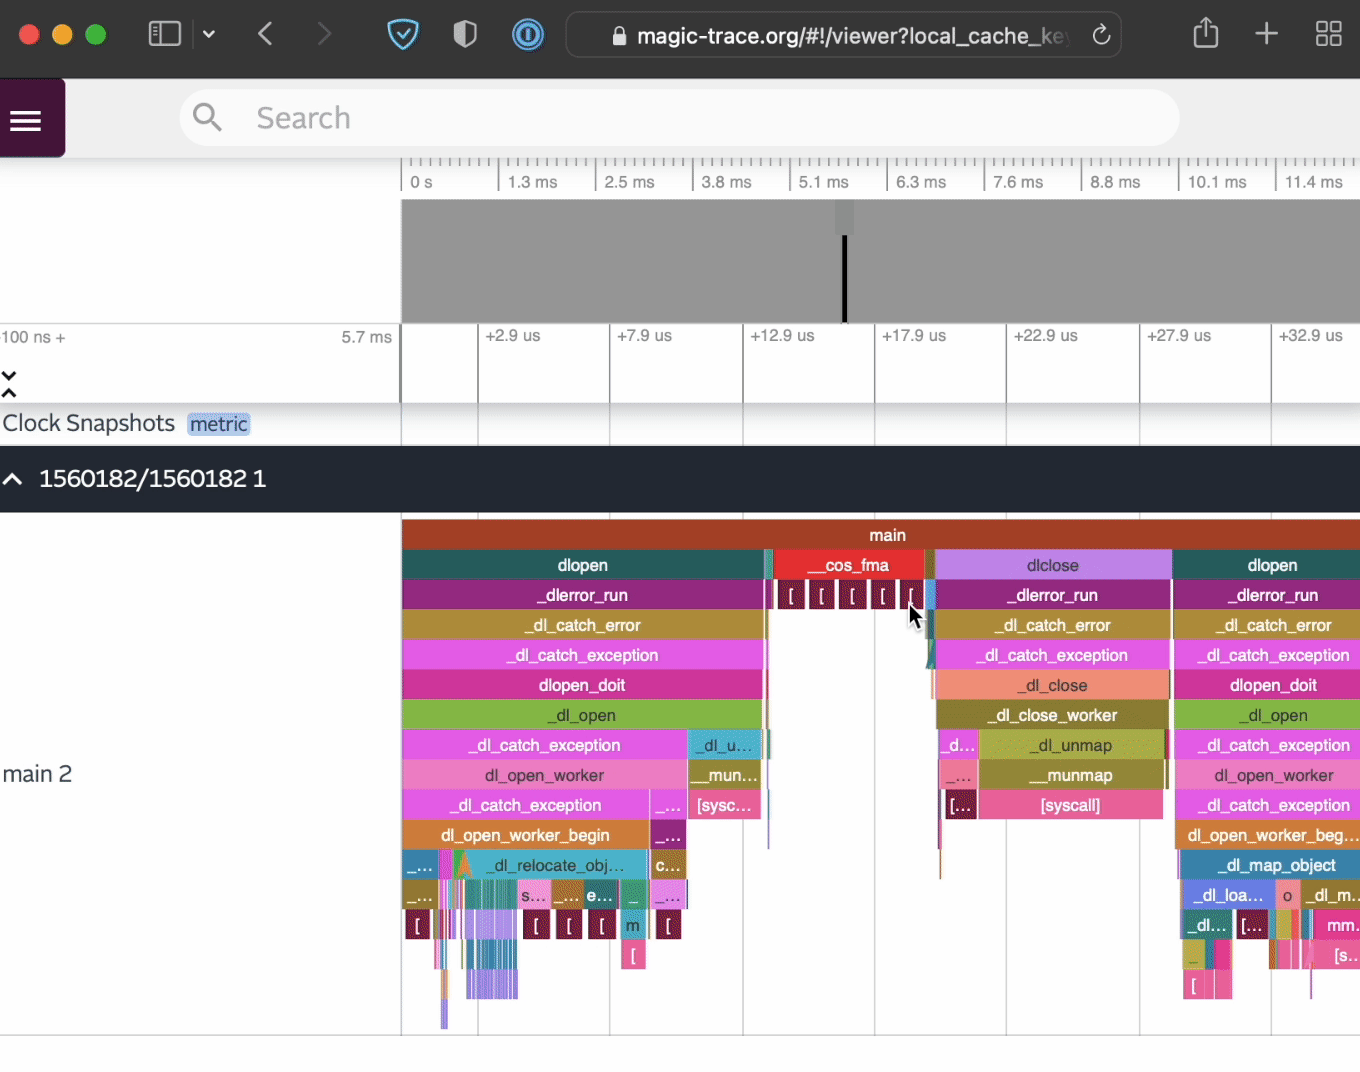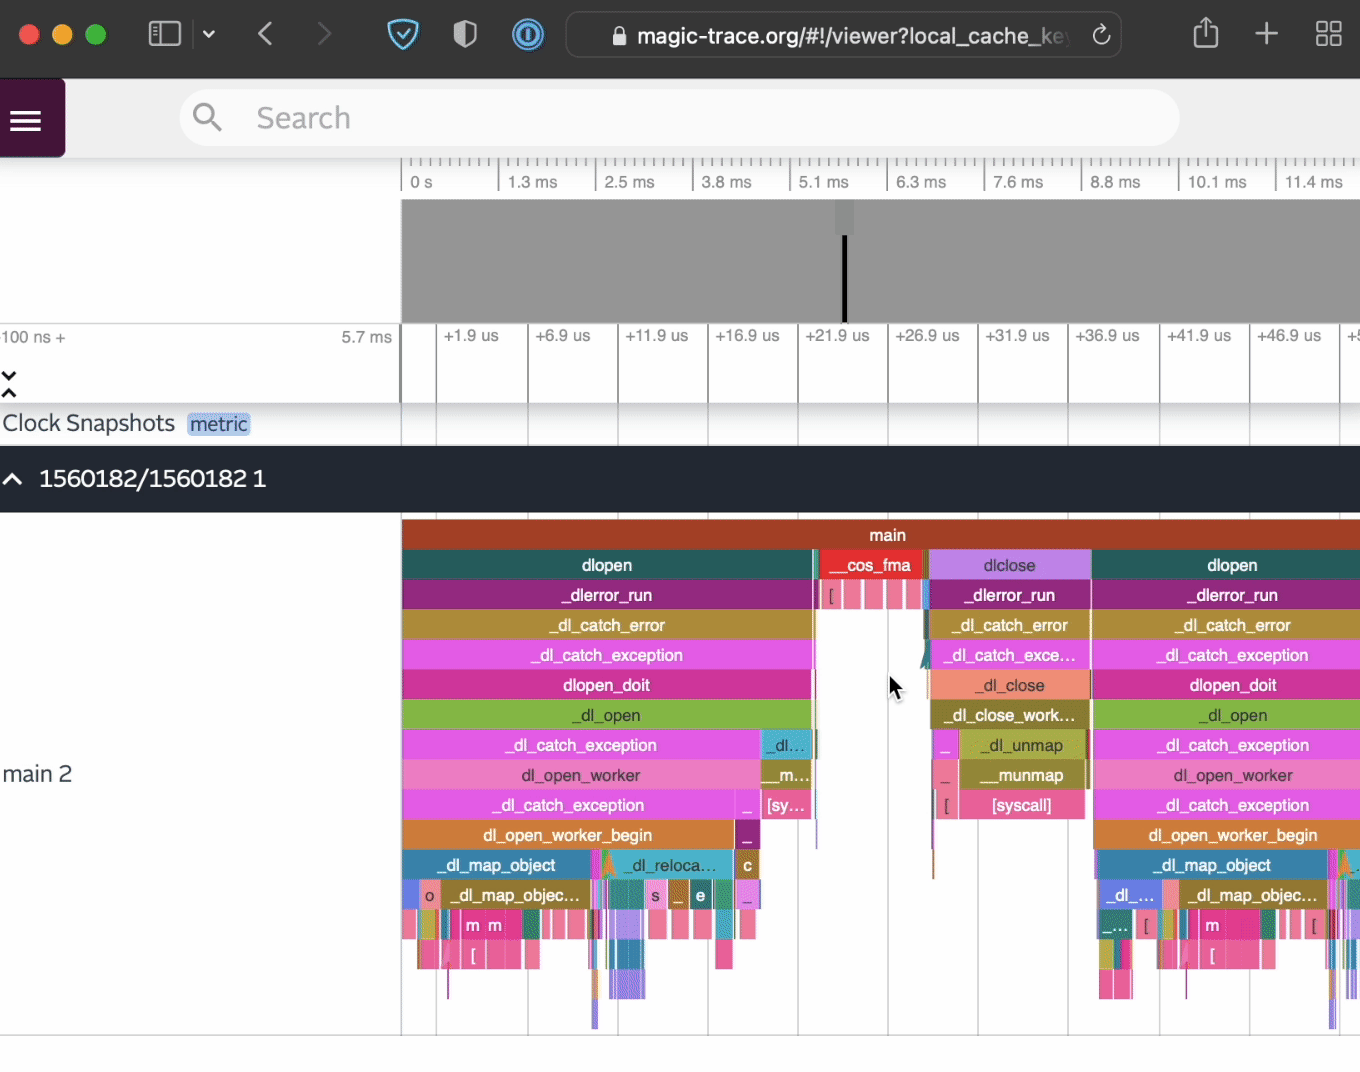
Stage 3:在 Perfetto 时间轴上从毫秒一路放大到单个纳秒级事件、浏览调用栈。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/janestreet/magic-trace |
| Star / Fork | 6,081 / 191 |
| 代码行数 | 业务本体 src/ 约 9.3K 行 OCaml(tokei 报 169K 严重虚高:其中 ~92%/15.6 万行是 test/ 的 %expect_test 金标夹具,是数据不是逻辑) |
| 项目年龄 | 4.4 年(2022-01-26 起,源于 2021 暑期实习项目) |
| 开发阶段 | 低维护(成熟稳定,近 90 天 9 commit,2022 上半年一次性灌注 67%) |
| 贡献模式 | Jane Street 团队(双核心 Clark Gaebel/cgaebel + Tudor Brindus/Xyene) |
| 热度定位 | 大众热门 · 细分赛道事实标准(持续吸星) |
| 质量评级 | 代码[优秀] 文档[良好] 测试[充分] |
作者视角:为什么存在这个项目
创始人/作者背景
由 Jane Street(量化做市/高频交易公司,全球 OCaml 头号工业用户、400+ 开源 OCaml 仓库) 出品,是其全部公开仓库中 star 最高的旗舰开源项目。双核心工程师 Clark Gaebel(cgaebel)+ Tudor Brindus(Xyene)。项目起源于 Jane Street 2021 年暑期实习项目(Tristan Hume 等参与),后转为正式工程项目。作者是「用 OCaml 跑微秒级交易系统」的一线性能工程师——magic-trace 不是练手玩具,而是源于内部刚需。
问题判断
这类交易系统 99% 时间在等网络包,要在远低于 250 微秒内响应。传统采样式 profiler 在微秒尺度约等于无用——采样间隔根本采不到关键代码路径,而程序员往往需要的不是「崩溃那一刻的栈」,而是「慢请求之前那段完整的控制流」。作者看到 Intel PT 这个能全量记录硬件控制流的能力 2013 年起就在 CPU 里,但「采集难(啃 perf_event_open/libipt)+ 原始输出不可读 + 无快照工作流」三座大山把它挡在普通工程师之外。时机上踩中了 Intel PT 在内核/perf 工具链逐步成熟(5.4-5.14)与 Perfetto 作为可复用可视化后端出现两个窗口。
解法哲学
极端克制的 MVP 主义,代码处处可见「刻意不做」:只做环形缓冲快照模式、只在触发函数命中时快照、只可视化函数级控制流(不带数据值)。最能体现美学取向的是 attach 机制——标准做法是往目标进程塞一个 IPC server,但他们宁愿去啃 perf_event_open 用硬件断点实现真正零侵入的 attach(「有时标准做法到不了理想的用户体验」)。这是「把脏活藏在干净 UX 后面」的写照。生态上 genuinely open:可视化直接复用 Google 的 Perfetto,不自建。
战略意图
对 Jane Street 是基础设施 + 开源招牌(其 400+ OCaml 仓库里少数面向圈外、有真实外部用户的明星项目),无 SaaS/托管/企业版意图(隐私政策明确「不上传你的代码或 trace」)。direct_backend(备用 libipt 后端)的保留与 OxCaml 的使用还揭示第二层战略:它也是团队验证「OCaml + 自研编译器扩展能否胜任系统级编程」的试验场。
核心价值提炼
创新之处
- 硬件断点实现零侵入 attach(新颖度 5/5):不往目标进程注入 IPC server,而对目标 pid 的函数地址开一个执行型硬件断点(
PERF_TYPE_BREAKPOINT+HW_BREAKPOINT_X)的perf_event_open,mmap 一页环形缓冲读命中事件、连带抓前两个参数寄存器;单快照模式用PERF_EVENT_IOC_REFRESH 1让断点命中一次后自动失效防过载。trace.ml还有一处精妙竞态修复:先Scheduler.yield()让 epoll 注册 fd,再 enable 断点,避免断点在 epoll 监听前就触发并自我失效。 - 环形缓冲快照(flight recorder)模型(新颖度 4/5,可迁移性 4/5):默认不全量记录(PT 数据每秒数百 MB),让 perf 用
--snapshotoverwrite 定容环形缓冲(root 4M/否则 256K),只在 Ctrl+C/函数命中/退出时 dump 前约 10ms 控制流。把「全量 PT 不可用」变成「轻量常驻可用」。 - 能力分级 + 优雅降级层(新颖度 3/5,可迁移性 5/5):
perf_capabilities.ml把内核/perf 版本(snapshot-on-exit 5.4、kcore 5.5、ctlfd 5.10、dlfilter 5.14)、CPU 代际、权限差异折叠成一组能力位,用决策矩阵选最优采集/控制机制并逐级降级(ctlfd FIFO → 信号 → 老式 SIGUSR2),缺啥精确提示「装 perf ≥X.Y」。 - 巨型内联 %expect_test 金标夹具做端到端回归(新颖度 4/5):把整段真实原始 perf/PT 追踪文本内联进
[%expect {| ... |}](hello_world_with_kernel_tracing.ml一个文件 6.3 万行),每个 case 往往对应一次真实的 perf 输出变体(go 的tr strt tr end、cbr 双空格、garbage offset…),是 bug 的「战疤档案」。 - OxCaml 实验性编译器扩展在热路径上 dogfooding(新颖度 5/5,可迁移性 1/5):解码/符号化热路径大量用 unboxed 元组
#(...)(85 处)、or_null/Null空值类型避免 option 装箱、iarray、栈分配stack_;CI 跑5.2.0+ox编译器。是「函数式语言零分配写系统工具」的存在性证明。
可复用的模式与技巧
- 能力探测 + 优雅降级:把外部依赖(内核/perf/CPU)的版本差异收成一组 flag,决策矩阵选机制 + 缺失精确提示——包装任何系统级 CLI 的工具都该有这层。
- Flight recorder(覆写环形缓冲 + 触发快照):常驻低开销记录、只在关键时刻 dump 历史——生产可观测性、崩溃前现场还原。
- 采集自研 / 可视化复用 Perfetto(fxt):不自建时间轴 UI,输出标准 Fuchsia Trace Format,甚至内置 cohttp server + iframe 直接 serve 本地 Perfetto UI。
- 内联金标夹具端到端回归:真实外部输出文本直接钉进 expect-test,每个变体一个 case——解析器/编译器防回归。
- mapped-time 归一规避下游精度损失:已知 Perfetto 用 float 表示时间、大跨度丢精度,则把所有事件减去最早事件时间。
- 资源文件 crunch 进单一静态二进制:dune 构建期把 perf-dlfilter 的
.so/UI 资源编译并嵌入(ocaml-crunch),发布零外部依赖(配合 UPX 压缩)。
关键设计决策
| 决策 | 解决的问题 | Trade-off | 可迁移性 |
|---|---|---|---|
| 硬件断点触发快照(非注入 IPC server) | 想在函数命中时触发又不侵入目标进程 | 死绑 Linux perf_event_open + x86 寄存器,换真正零侵入 attach | 中 |
| 环形缓冲覆写 + 触发时快照(非全量记录) | 全量 PT 每秒数百 MB、trace 爆炸 | 只能看触发点前约 10ms,换常驻低开销 + 可加载小 trace | 高 |
能力差异收敛到单一 Perf_capabilities 位标志层 | 内核/perf/CPU 代际组合爆炸 | 一整层复杂度,换碎片化生产环境的鲁棒性与可诊断性 | 高 |
解码解析 perf script 文本(非自解 PT 二进制) | 自解 libipt 工作量巨大(direct_backend 退场) | 省下重写解码器,但继承 perf 文本格式全部脆弱性(#196/#191 崩溃根源) | 低(反面教训) |
| 输出统一 Fuchsia Trace Format + 复用 Perfetto | 既要紧凑可加载 trace 又不想自建 UI | 绑定 Perfetto 生态,换零 UI 维护成本 | 高 |
竞品格局与定位
竞品对比矩阵
| 维度 | magic-trace | Linux perf | Tracy | rr | uftrace |
|---|---|---|---|---|---|
| 机制 | Intel PT 硬件全控制流 | 通用性能事件 | 插桩式 | record-replay | 函数 enter/exit |
| 插桩 | ✅ 零插桩 | 零插桩 | ❌ 需改源码 | 零插桩 | ❌ 需编译期插桩 |
| 工作流 | 快照式(事后看前 10ms) | 原始/无快照 | 长期内嵌 | 确定性重放 | 函数图 |
| 开箱即用 | ✅ 一键出 Perfetto | ❌ 输出不可读 | 中 | 中 | 中 |
| 约束 | Intel only / 多数 VM 不支持 | 通用跨架构 | 跨平台 | 较通用 | 跨架构 |
差异化护城河
技术护城河——把 Intel PT + 硬件断点 attach + 自动符号化 + Perfetto 一键打通,这套交集近乎无直接对手;信任护城河——Jane Street 背书 + 真实生产 dogfooding + genuinely open。
竞争风险
最现实的不是被竞品替代,而是自身架构脆弱性——「封装 perf 文本输出」让它继承跨内核/perf/CPU 的解析负担(#196 Scanf 崩溃、#191 解码越界),换个 perf 版本或 CPU 微架构输出格式一变就崩;另受 Intel-only + 多数虚拟机不支持 的硬约束限制云端普及(作者本人也自曝此短板)。相比 Tracy 无法携带「数据/数值」信息、单事件开销更高。
生态定位
Intel PT 这一硬件能力的「普及层/友好前端」,与 perf(底座,它实际调用 perf 驱动 PT 并解析其文本)、Perfetto(可视化后端)形成上下游共生而非零和竞争。在「Intel PT 函数级 + 快照式 + 零插桩 + 开箱即用」这一交集是细分蓝海里的事实标准。
套利机会分析
- 信息差:不算被低估,而是「稳态高口碑」——6k star + MIT + 大厂背书 + 近乎零维护仍持续吸星,已是 Intel PT 细分赛道的事实标准。可挖掘价值不在「捡漏」,而在「把一个极难用的硬件能力讲透」——选题角度应是技术深度(Intel PT 原理、环形缓冲快照、硬件断点 attach、内核/硬件 bug 踩坑史)而非冷门发现。
- 技术借鉴:能力探测+优雅降级、flight recorder 环形缓冲、采集自研+可视化复用 Perfetto、内联金标夹具回归、mapped-time 归一、资源 crunch 进二进制——这些与「追踪」解耦的工程范式,任何系统/可观测性工具可直接迁移。
- 生态位:填补「让 Intel PT 人人可用」的空白;与 perf/Perfetto 共生。
- 趋势判断:低延迟系统调试需求持续,Intel PT 工具链在成熟;但 Intel-only + VM 限制是天花板,且「封装 perf」的维护负担长期存在。它更可能保持「细分标杆 + 技术教学样本」地位,而非爆发式扩张。
风险与不足
- 架构脆弱性:强依赖解析 perf 文本/二进制输出,跨 perf 版本/内核/CPU 微架构格式碎片化是最现实的兼容性战场(#196/#191)。
- 硬约束:仅 Linux、仅 Intel(Skylake+)、多数虚拟机不支持——云端部署受限。
- 低维护:成熟后近一年仅 26 commit,多为 issue 驱动的解码/符号修复。
- 能力边界:只看控制流、不带数据值(相比 Tracy);单事件开销高于插桩式工具。
- OxCaml 依赖:CI 跑未发布的自研编译器扩展,外部贡献者构建门槛高、可移植性差。
行动建议
- 如果你要用它:在 Intel(Skylake+)Linux 物理机/裸金属上调试微秒级延迟尖刺、罕见抖动、崩溃前控制流——magic-trace 是目前最易用的选择(
attach -pid/run/-trigger <symbol>)。云上 VM 多不支持需注意;要跨平台/带数据信息用 Tracy,要确定性重放调试用 rr,要通用用 perf。 - 如果你要学它:重点读
src/perf_tool_backend.ml(硬件断点 attach + 环形缓冲快照)、src/perf_capabilities.ml(能力探测 + 优雅降级矩阵)、src/perf_decode.ml(perf 文本解析 + 防御式兜底)、src/trace_writer.ml(Fuchsia/Perfetto 输出 + mapped-time 归一)、test/的%expect_test金标模式。配合 Jane Street 官方博客 blog.janestreet.com/magic-trace 与 direct_backend 的诚实复盘。 - 如果你要 fork 它:低价值(细分标杆已立 + Intel/Linux 强约束)。真正该抄的是工程范式——能力探测+降级、flight recorder、采集自研+复用 Perfetto、内联金标夹具,迁到自己的可观测性/系统工具。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/janestreet/magic-trace(已收录,含架构/perf backend/符号解析/内核追踪) |
| Zread.ai | 未验证(返回 403) |
| 关联论文 | 无(工程工具;Intel PT 见 Intel 官方手册) |
| 在线 Demo / 可视化器 | magic-trace.org(官方 Perfetto 风格 trace 查看器,拖入 .fxt.gz 即可视化) |
| 官方深度博客 | blog.janestreet.com/magic-trace(强烈推荐,含踩坑史) |
| 外部深度视角 | All my favorite tracing tools (Tristan Hume,作者之一)(少有的「自曝短板」视角) |