GitHub推荐:HF 官方语音 Agent 框架:640 commits 把 OpenAI Realtime 协议塞进开源级联栈
一句话总结
Hugging Face 官方 voice agent 旗舰项目,把整条 VAD→STT→LLM→TTS 级联栈包装成 OpenAI Realtime API 兼容的 WebSocket 服务,让任何现有 OpenAI Realtime 客户端(OpenAI SDK、LiveKit、Pipecat 适配层)都能零改造切换到自托管后端。
值得关注的理由
- 协议兼容性是其天然护城河:在「开源级联栈 + OpenAI Realtime 协议兼容」这个精确交集下,本项目是 OSS 圈唯一同时满足「完整协议兼容 + 任意 STT/TTS/LLM 可换」的项目。
- 6 种 STT + 5 种 TTS + 4 种 LLM 组合,CUDA / Apple Silicon / CPU 同一份 CLI 都能跑;
--local_mac_optimal_settings一键启用 Mac 全家桶。 - 不是 demo,是产品:已经在 Reachy Mini 机器人量产环境运行(“thousands of Reachy Mini robots”),经历 24 个月 640 commits + 13 个 semver 版本迭代。
项目展示

项目主视觉,README 顶部 600px
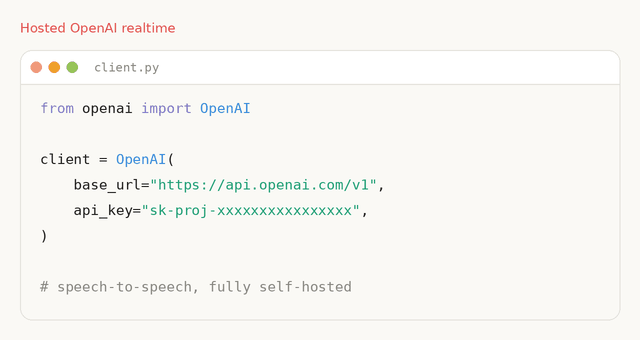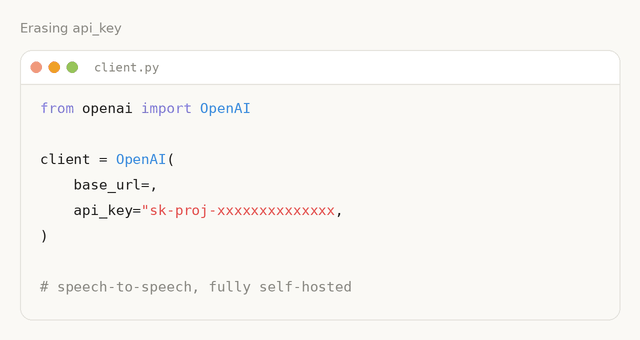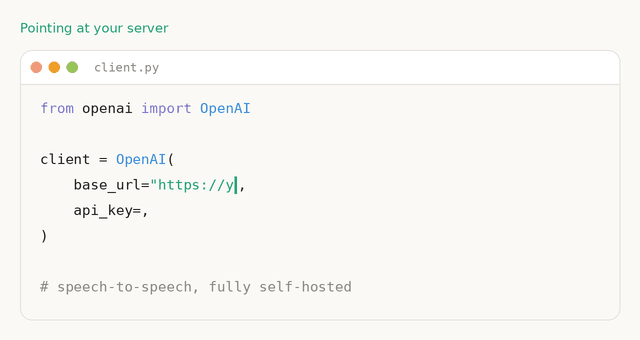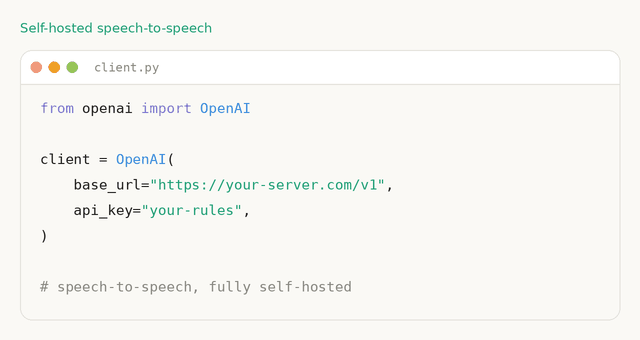
核心叙事动图:把 OpenAI Realtime 客户端的 endpoint 从 OpenAI hosted 切到自托管 S2S server,一目了然说明「协议兼容」卖点
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/huggingface/speech-to-speech |
| Star / Fork | 9,185 / 1,139 |
| 代码行数 | 31,354 行(Python 80.6% · JavaScript 10.2% · CSS 7.1% · 其他 0.9%) |
| 项目年龄 | 23.8 个月(首次提交 2024-08-07) |
| 总 commit | 640(近 90 天 200,近 30 天 58) |
| 贡献者 | 39 人(Top 1 ≈ 46.5%,Top 2 合计 76.5%) |
| 开发阶段 | 密集开发(职业项目 · 周末 1.7% / 深夜 10.0%) |
| 贡献模式 | 核心少数 + 社区(主要是 HF 内部 andimarafioti/eustlb/A-Mahla 三人) |
| 热度定位 | 大众热门(voice agent 赛道头部开源项目) |
| 版本 | v0.2.11(共 13 个 semver tag,2 个 GitHub Release,仍在 0.2.x 频繁 patch) |
| 质量评级 | 测试 A- · 文档 A · CI/CD A · 错误处理 A · 类型 B+ · 综合 A- |
作者视角:为什么存在这个项目
创始人/作者背景
核心开发者 andimarafioti(483 commits via aliases)和 eustlb(53 commits)就是原 eustlb/speech-to-speech 个人实验仓库的作者,那是 2024-08 GPT-4o Realtime 风格 modular S2S 爆发期的早期 prototype。HF 在 2025 上半年把项目收编为官方 voice agent 旗舰,让个人 prototype 升级为完整产品。这个「踩过坑的人写出来的代码」的故事,可以从代码细节里感受到——MLX 全局锁、speculative turn tracker、cancel scope 的细粒度都是只有实战过才会主动写的。
问题判断
作者看到了三件事:
- OpenAI Realtime API 闭源、贵、不可私有化——但客户端生态已经开始依赖这套协议
- 其它开源级联框架(Pipecat / LiveKit)模型替换机制粗,对 OpenAI Realtime 协议没有一等公民支持
- 端到端 full-duplex(moshi 类)虽然延迟低,但完全丧失可替换性——STT 想换、LLM 想换、TTS 想换时整个模型要重训
时机:HF Inference Providers 路由器在 2025 成型,vLLM/llama.cpp 都能跑 OpenAI 协议,开源实时语音栈终于能像换 SaaS endpoint 一样换后端。
解法哲学
- 简单 vs 功能完整 → 偏功能完整:每段都很简单(一个 handler 一对队列),但拼起来有 interrupt、speculative turn、generation counter、discard guard、tool calling(regex 解析 + native 双路径)、WebRTC + WS 双传输、LLM proxy、usage metrics——是为生产设计的 cascade,不是 paper-style toy
- 性能 vs 易用性 → 偏易用性:
pip install speech-to-speech && speech-to-speech一行启动;性能优化(CUDA graphs、MLX 量化、global MLX lock)隐藏在 CLI flag 后 - 明确不做什么:不做端到端 full-duplex 模型(明确选择 cascade)、不替代 LLM serving(只是 client)、不内置 ASR/TTS 训练流程(消费现成开源模型)、不做完整 TURN/STUN 服务器(WebRTC 留出 env var 让用户接自建 TURN)
战略意图
- 位置:HF 官方 voice agent 旗舰。同账号下还有 transformers 16.3w stars、lerobot 2.6w stars、diffusers 3.4w stars、trl 1.9w stars 等头部项目——这个 repo 不需要担心「没人用」
- 商业化路径:genuinely open(不是 open-core)。变现路径靠:① Reachy Mini 硬件销售(机器人栈跑这个 repo);② HF Inference Providers 上 Qwen3/GPT-oss 等模型被 voice agent 流量带动;③ 企业私有化部署时对 HF Pro/Enterprise 服务的间接需求。项目本体不出任何付费 tier、不闭源协议层
- 生态定位:HF Hub 模型 ↔ Voice Agent 价值链中的「工具层」——Hub 上的开源 STT/TTS/LLM 通过这个 pipeline 进入生产 voice agent,反向给 Hub 模型带流量
核心价值提炼
创新之处
-
OpenAI Realtime 完整协议兼容层(api/openai_realtime/ 整个子目录)
- 用 Pydantic 直接接
openai.types.realtime.*事件 schema,配套 WebRTC GA 的output_audio_buffer.clear等新字段 - RuntimeConfig 支持 deep-merge partial session.update,不丢旧字段
- per-conn state(ConnState)通过 session_id 隔离,LLM Proxy 把同一 upstream 暴露成 OpenAI HTTP endpoint
- 新颖 4/5 · 实用 5/5 · 可迁移 4/5
- 用 Pydantic 直接接
-
CancelScope generation counter + discard flag 算法(pipeline/cancel_scope.py 86 行)
- 用单一原子 int + bool 替代传统双 Event + bool 信号方案
- 解决「speculative turn 上轮 TTS sentinel 还没发,下一轮 reopen 已经来了」的 race condition
- 借鉴数据库 MVCC 思路,用在实时语音上是首创
- 新颖 4/5 · 实用 5/5 · 可迁移 3/5
-
PipelineUnit 池化 + SESSION_END drain + quarantine(api/openai_realtime/pipeline_unit.py)
- 每个 unit = 一套完整的独立 pipeline(queues/handlers/cancel_scope/speculative_turns)
- 启动时一次性 build N 个 unit,运行时 claim/release
- 单元卡死有 quarantine 机制(drain 超时 180s 进 quarantine,但 handlers 仍能跑直到 SESSION_END 真到,避免跨会话泄漏)
- 新颖 3/5 · 实用 5/5 · 可迁移 4/5
-
SpeculativeTurnTracker 4 维状态机(pipeline/speculative_turns.py 419 行)
- 4 维状态:latest_revision / committed_revision / pending_reopen / reopen_grace
- 专门解决 VAD soft-end 时的「提前送 STT + reopen 取消」问题
- voice agent 圈子里看不到第二份这样系统化的实现
- 新颖 5/5 · 实用 4/5 · 可迁移 2/5
-
MLX 全局 RLock + 平台感知自动降级(utils/mlx_lock.py 171 行)
- RLock + owner/thread/handler/depth/acquired_at 全维度跟踪,方便 debug
- MLXLockContext 超时优雅降级而非崩溃
- 检测到 macOS + pool size>1 + enable_live_transcription 三者同时,自动关 live transcription 防 MLX 锁争用
- 新颖 3/5 · 实用 4/5 · 可迁移 5/5
可复用的模式与技巧
-
BaseHandler 抽象 + Queue 编排(baseHandler.py + thread_manager.py):Generic[InT, OutT] 的 run() loop 自动处理 timeout get、sentinel (PIPELINE_END/SESSION_END)、cancel_generation 检查、计时、错误捕获、清理——每个 handler 是 thread 节点,Queue 解耦阶段之间。任何多阶段流式处理 pipeline 都可套用
-
HfArgumentParser 把所有 CLI flag 收敛到 19 个 dataclass(arguments_classes/):用 transformers 提供的 HfArgumentParser 把每个 handler 的 dataclass 注册成独立 argument group;parse_arguments() 内置「—llm_backend 预解析 → 只注册对应 backend 的 dataclass」避免字段冲突。HF 内部通用 pattern
-
WebRTC + WS 双传输 + 同一份协议(WebSocketTransport + WebRTCSession):在 FastAPI app 上同时挂 /v1/realtime (WS) 和 /v1/realtime/calls (SDP POST);WebRTC session claim 同 pool 中的 PipelineUnit;WebSocketTransport 和 WebRTCTransport 共用同一 SessionTransport 接口。任何实时 multimodal 项目想双传输都可套
-
runtime config 共享 mutable 状态(api/openai_realtime/runtime_config.py):OpenAI Realtime 的 session.update 是 partial update——RuntimeConfig 用 Pydantic 模型支持 deep-merge,被 VAD/LLM/TTS 三方读取。任何需要 hot-reload 配置的实时服务都适用
关键设计决策
-
OpenAI Realtime 协议作为一等公民对外接口(/v1/realtime WS + /v1/calls WebRTC)
- 问题:用户已有 OpenAI Realtime 客户端/SDK,要零改造迁移到自托管后端
- 方案:直接 import openai.types.realtime.* 作为事件 schema,RealtimeService 做 client event ↔ internal pipeline message 双向翻译
- Trade-off:牺牲「自己发明协议的灵活性」(必须追 OpenAI 事件演进),换「任何 OpenAI Realtime 客户端零改造接入」
-
Generation counter + discard flag 的 CancelScope 替代旧的「两个 Event+bool」信号
- 问题:barge-in 时 LLM/TTS 流式中断的协议工程难题,旧方案依赖 Event.set() 短脉冲 + discard bool,在异步 send_loop 和流式 handler 线程之间容易出 race
- 方案:handler 在流式开头捕获 gen、流式中间 is_stale(gen) 判定、send_loop 用 _generation_is_discardable 决定丢弃
- Trade-off:牺牲「任何 handler 都能随意抛 Output」的简单性,换来「barge-in 不可能丢新响应/不可能泄漏旧响应」的硬保证
-
模块化 + 工厂 + 平台 marker 依赖(pyproject.toml + get_*_handler)
- 问题:用户硬件各异(CUDA / MPS / CPU)、模型偏好各异
- 方案:pyproject.toml 用
platform_system == 'Darwin'等 marker 自动选 mlx 包;get_*_handler() 工厂按 CLI flag 装配;opt extra 把可选 backend 打散到 pip extras - Trade-off:牺牲「开箱即用单一推荐 stack」的简洁性,换来「几乎所有合理组合都能跑」的覆盖度
竞品格局与定位
竞品对比矩阵
| 维度 | HF speech-to-speech | OpenAI Realtime API | Pipecat | LiveKit Agents | Moshi |
|---|---|---|---|---|---|
| 开源 | Apache-2.0 | 闭源 | BSD | Apache-2.0 | Apache-2.0 |
| 协议兼容 | OpenAI Realtime 一等公民 | 协议源头 | 需自己接 OpenAI adapter | WebRTC 优先 | 自有协议 |
| 模型可换 | 6 STT + 5 TTS + 4 LLM | 锁死 | 灵活 | 灵活 | 不可换 |
| 硬件 | CUDA / MPS / CPU | 仅云端 | 任意 | 任意 | 任意 |
| 架构 | 4-stage cascade | 闭源端到端 | pipeline 框架 | WebRTC SFU | 端到端 full-duplex |
| 生产案例 | Reachy Mini 量产 | 大规模商用 | 多家 | 多家 | 实验 |
差异化护城河
- 协议兼容 + 模块化双优势:唯一同时做到「完整 OpenAI Realtime 协议兼容 + 任意 STT/TTS/LLM 可换」的项目
- 硬件全覆盖:CUDA / MPS(MLX 全栈)/ CPU 同一份 CLI;
--local_mac_optimal_settings一键启用 Mac 最佳实践 - 生产级工程细节:PipelineUnit 池化、CancelScope generation 算法、SpeculativeTurnTracker reopen candidate、LLM proxy 与 voice pipeline 解耦——这些是「踩过坑才能写出来」的代码
- Reachy Mini 量产背书:真实硬件产品在用,不是 demo
竞争风险
- OpenAI 推 Realtime API GA 后客户端/工具链成熟度领先,HF 这边要持续追协议演进
- Moshi 代表的端到端路线在延迟/简洁度上有理论优势,如果开源 full-duplex 模型质量跟上,cascade 的可换性优势会被部分抵消
- Pipecat / LiveKit 的「框架 + transport」一体化路线对想快速搭 demo 的开发者更友好
生态定位
在「Hugging Face 模型 ↔ 语音 Agent」价值链中占据「工具层」——Hub 上的开源 STT/TTS/LLM 通过这个 pipeline 进入生产 voice agent,反向给 Hub 模型带流量。
套利机会分析
- 信息差:项目本身已被市场充分认识(9185 stars + HF 官方背书),但其设计哲学(协议层卡位 + 完整可换)+ 关键算法(CancelScope / SpeculativeTurnTracker)的「设计思路」对外传播仍少,是学习 voice agent 实时协议工程的最佳范本
- 技术借鉴:
- CancelScope generation+discard 算法 → 任何多生产者单消费者流式音频/文本协议都可复用
- PipelineUnit 池化模式 → 任何 GPU 显存够换并发的实时服务都适用
- SpeculativeTurnTracker 4 维状态机 → 任何「异步追踪-提交」场景通用
- MLXLockContext → 任何 Apple Silicon 多模型服务都适用
- 生态位:在「开源 voice agent 栈 + OpenAI Realtime 协议兼容」交集下的唯一头部选择,填补了「想私有化 voice agent 又不想放弃 OpenAI 客户端生态」的空白
- 趋势判断:voice agent 赛道 2024-2026 集中爆发(OpenAI Realtime / LiveKit / Pipecat / Moshi 都在快速迭代),HF 这边通过「开源 + 协议兼容 + 全模块可替换」的精确卡位占据有利位置;OpenAI Realtime 协议本身在持续演进(GA 事件、WebRTC 支持),HF 持续追协议的工程能力是关键护城河
风险与不足
- TTS 流式分块 + 队列缓冲仍是当前核心延迟痛点(issue #24 仍 open);最近的应对是切换到 Qwen3-TTS / Pocket TTS / ChatTTS 等更小流式 chunk 的后端
- fix 比例 15% 高于 feature 12.5%,说明项目进入「边角打磨期」,核心功能已搭好但仍需持续打磨体验
- 测试对真实模型推理的覆盖依赖外部资源(Parakeet/Qwen3 等),CI 跑不了全链路
- mypy 配置宽松(
ignore_missing_imports = True、check_untyped_defs = false),类型安全是「软保证」 - archive/ 目录保留历史代码但没明确标注 deprecated,新人可能误用
- v0.2.x 连续 12 个 patch 版本说明接口还在微调,用户升级需注意 breaking change
行动建议
-
如果你要用它:
- 已经对接 OpenAI Realtime 客户端的应用 → 改
base_url即可迁移到自托管后端,几乎零成本 - Mac 本地做 voice agent 原型 → 用
--local_mac_optimal_settings一键启用 MLX 全家桶 - 机器人 / 边缘硬件 → 用
--mode socket+ docker-compose.yml 模板,含 llama.cpp 内嵌 - 自托管 LLM 服务商 → 用
responses-api/chat-completions后端指向 vLLM/llama.cpp
- 已经对接 OpenAI Realtime 客户端的应用 → 改
-
如果你要学它:
- 重点看
src/speech_to_speech/baseHandler.py→ 经典的 cascade handler 抽象 - 重点看
src/speech_to_speech/pipeline/cancel_scope.py→ CancelScope generation+discard 算法 - 重点看
src/speech_to_speech/pipeline/speculative_turns.py→ SpeculativeTurnTracker 4 维状态机 - 重点看
src/speech_to_speech/api/openai_realtime/整个子目录 → OpenAI Realtime 协议兼容实现 - 重点看
src/speech_to_speech/api/openai_realtime/README.md→ 协议层架构图 + 算法详解(含 sequenceDiagram)
- 重点看
-
如果你要 fork 它:
- 改进方向 1:把 TTS 流式分块 + 队列缓冲(#24)的延迟进一步压低
- 改进方向 2:补上真实模型端到端测试(即使 CI 跑慢一点也行)
- 改进方向 3:把 archive/ 目录明确标注 deprecated 或清理
- 改进方向 4:mypy 收紧配置(虽然项目偏实用主义,但可以分模块渐进收紧)
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 已收录(2026-07-07,含完整架构总览) |
| Zread.ai | 未收录(403) |
| 关联论文 | 无(项目本身不绑定单一论文) |
| 在线 Demo | 无官方 hosted demo(推荐 pip install speech-to-speech + 本地启动) |
| 协议层文档 | api/openai_realtime/README.md(含架构图 + CancelScope 算法详解) |
| 外部深度视角 | CSDN 中文深度文 — 独立提出「协议兼容是核心战略选择」判断 |