不给答案、给引导:港大 DeepTutor 用 10+ Agent 重做 AI 家教(5 个月 2.4 万 Star)
一句话总结:DeepTutor 是港大 HKUDS 数据智能实验室开源的 agent-native 个性化 AI 辅导系统——10+ 个专门化 Agent 跑在同一套标签驱动的 agentic 引擎上,解题不直接给答案而是引导式溯源、出题先诊断薄弱点再标定难度、数学动画生成后还会自己抽帧看了再改,配一套三层学习者记忆引擎做跨会话个性化,有 arXiv 论文背书、Apache-2.0 可私有部署。
值得关注的理由
- AI 教育从「问答」走向「agentic 辅导」的标杆样本。它不是 ChatGPT 套个 RAG,而是把解题、出题、研究、可视化、数学动画、教材生成编排成一组有教学意图的专门化 Agent。解题走「PLAN → 子目标循环 → 合成」的多步分解、强制内联引用溯源
[source-id],刻意不一次吐答案——直面「AI 让学生变懒」的批评。 - 论文方法真的落到了代码里。arXiv 论文《DeepTutor: Towards Agentic Personalized Tutoring》(作者含马毅 Yi Ma + LightRAG 团队 + Chao Huang)提出的「引用溯源式辅导 + 难度标定出题 + 静态知识×动态记忆混合个性化」三大方法,逐一在代码中可验证,不是 marketing。
- 少见的「视觉自审」闭环。math_animator 生成数学动画后,用 ffmpeg 在 15%/50%/85% 时间点抽真实渲染帧 → 喂给多模态评审 Agent 看 → 发现视觉问题再定向修复。这是罕见的「Agent 真正看到自己的产物再改」的 agentic 自纠设计。
- 港大 HKUDS 学术血统 + 工程产品化双线。HKUDS(LightRAG 36K / RAG-Anything 21K 等爆款出品方,7.7 万总 star)把检索/图谱积累迁到教育方向,5.3 个月做出后端 + 前端 + CLI + 文档 + Docker 的全栈可部署产品,是「学术实验室高频产品化」的典型。
项目展示
README 媒体丰富(HKUDS 项目惯例),核心功能截图:
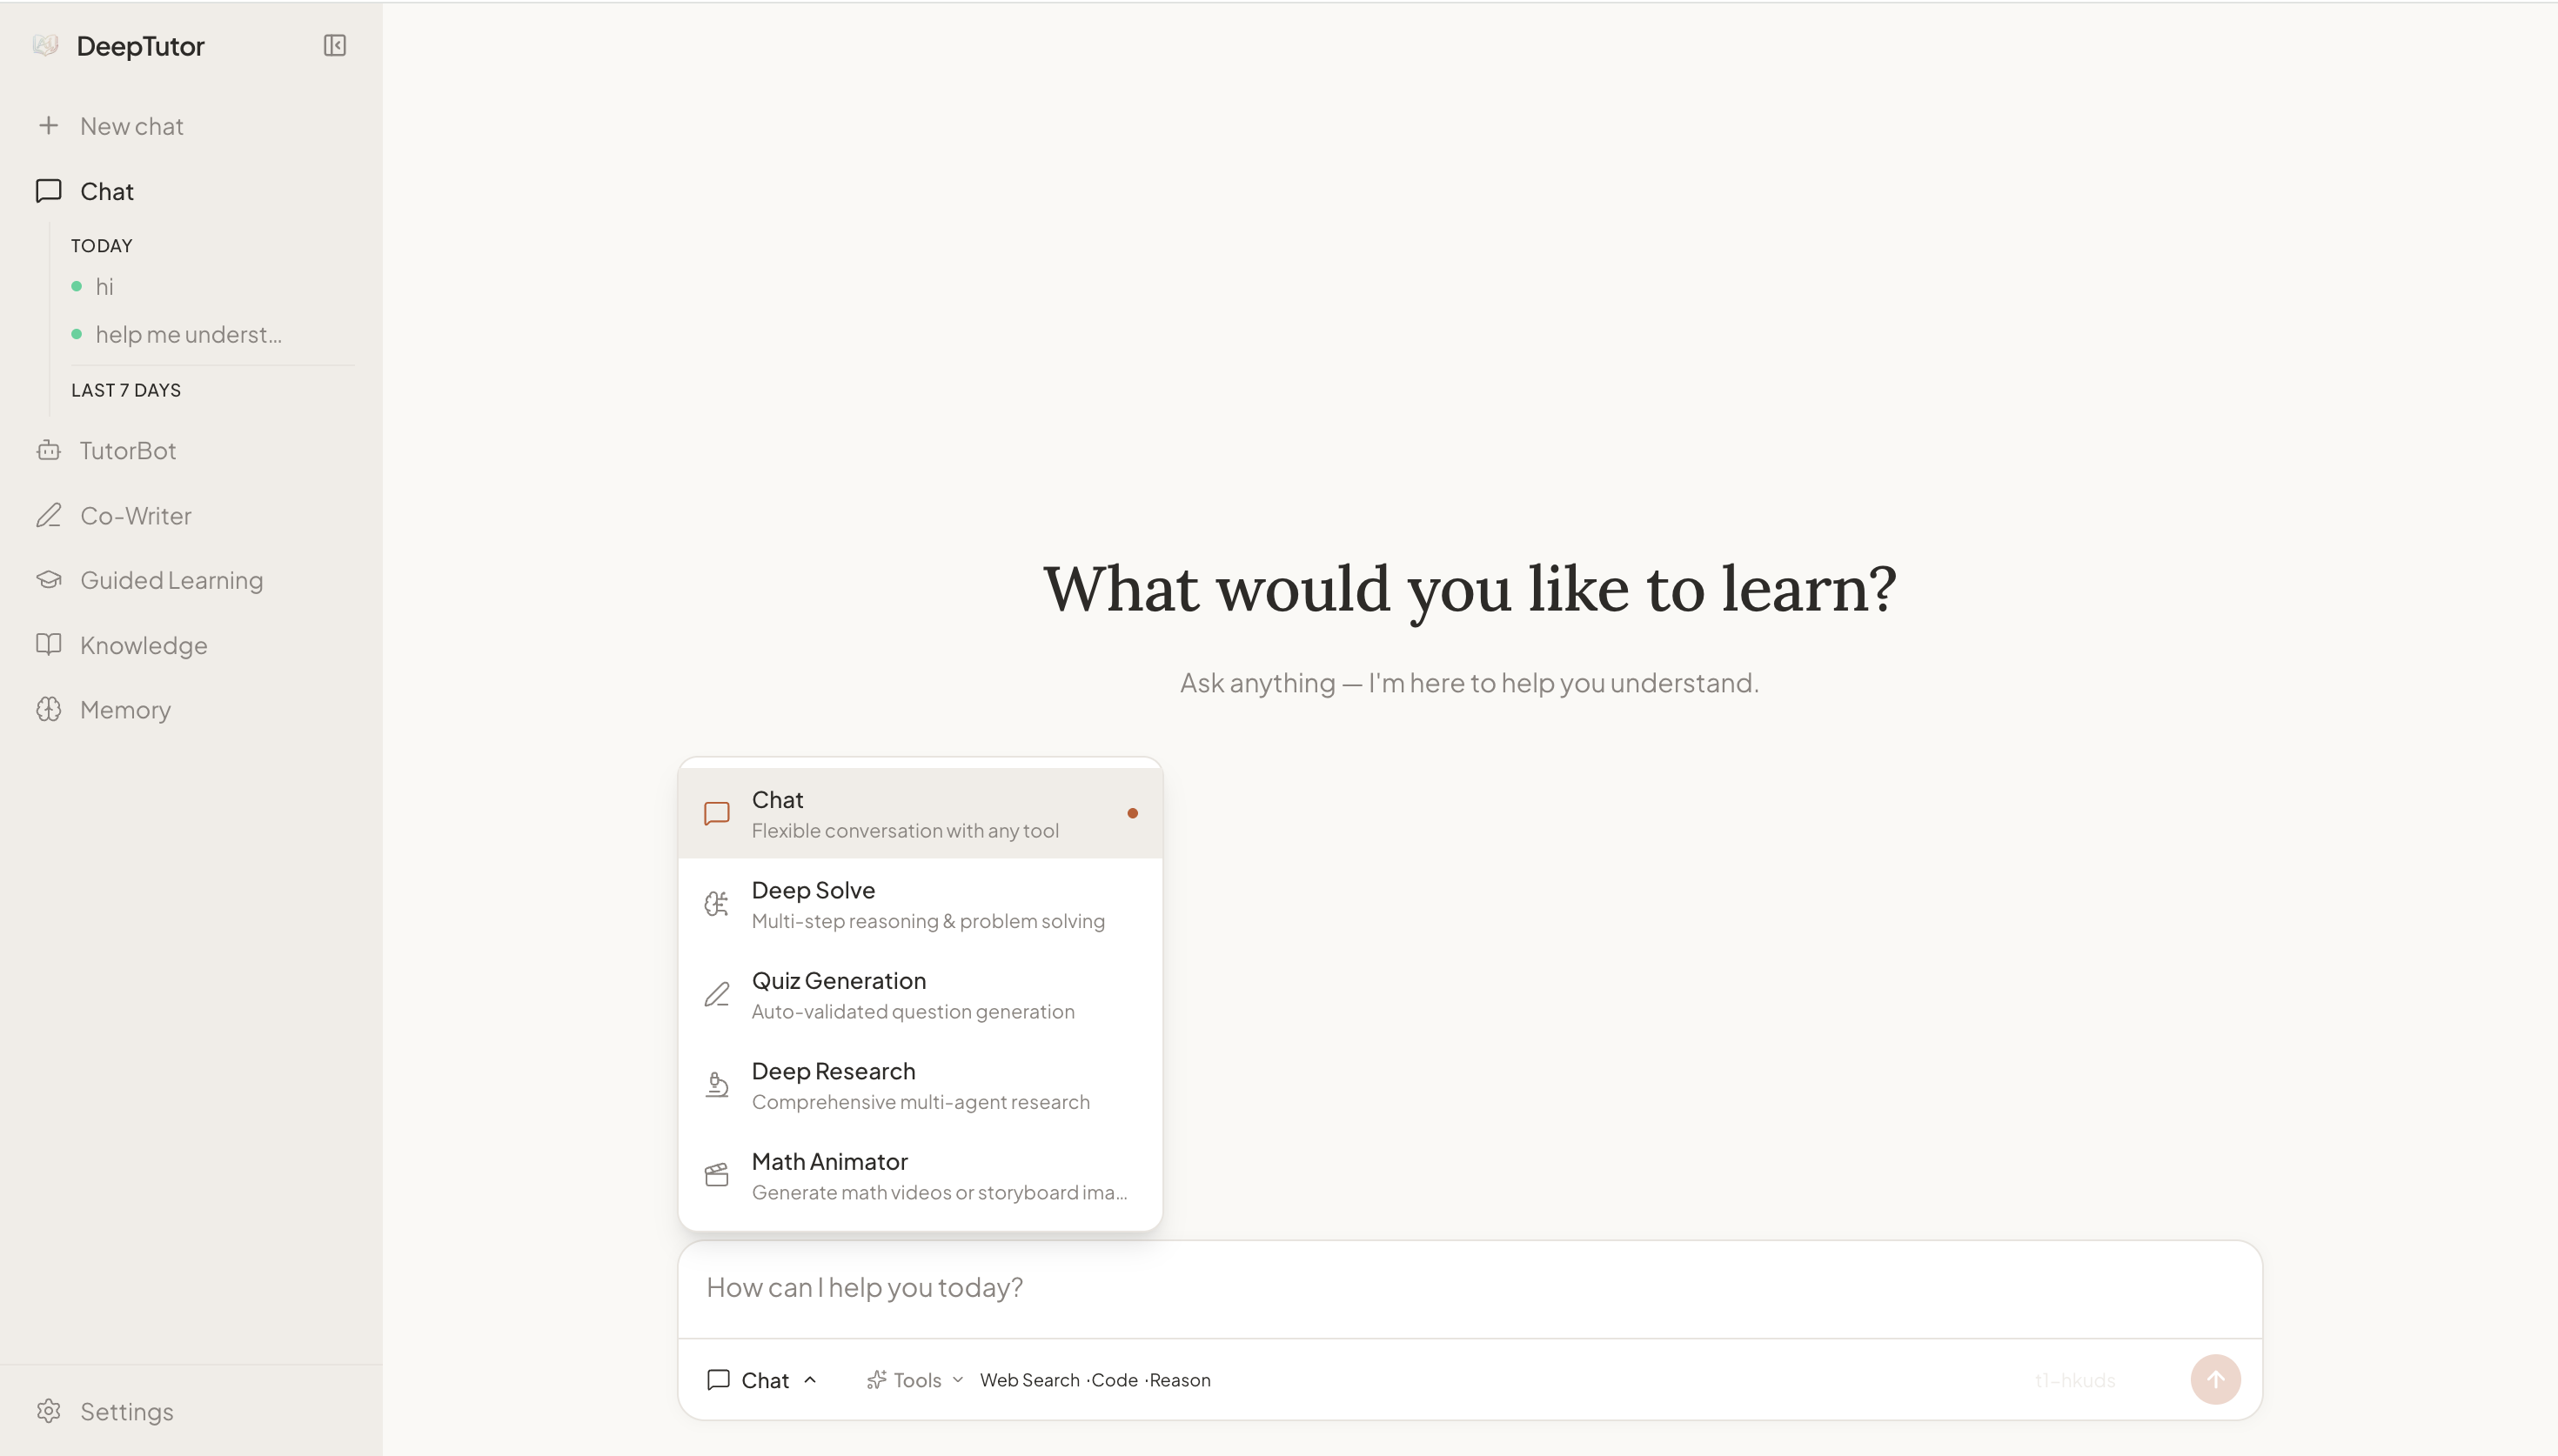


论文:https://arxiv.org/abs/2604.26962;社交卡片兜底:
https://opengraph.githubassets.com/1/HKUDS/DeepTutor
项目画像
| 维度 | 数据 |
|---|---|
| 全名 | HKUDS/DeepTutor |
| 定位 | agent-native 开源个性化 AI 辅导系统 |
| Star / Fork | 24,617 ⭐ / 3,327 🍴(CSV 抓取时 16,356,爆发型增长) |
| License | Apache-2.0 |
| 主语言 | Python 57.8%(后端)+ TSX 22.9%(前端)+ Astro(文档) |
| 代码规模 | 21.5 万行(Python 12.4 万 + TSX 4.9 万 + 文档站);1,294 文件;注释比 0.119;291 个运行时依赖 |
| 建库时间 | 2025-12-28(极新,约 5.3 个月) |
| 开发节奏 | 764 commit;近 90 天 392、近 30 天 80;两轮爆发冲刺 |
| 版本 | 40 个 tag,最新 v1.4.2(2026-05-28,约每 4 天一发) |
| 贡献者 | 78 人,主力 Bingxi Zhao(Frank)约 202 commit + 全球社区 |
| 出品方 | HKUDS 港大数据智能实验室(Chao Huang 教授领衔) |
| 学术背书 | arXiv 论文 + 自建 TutorBench 基准(+10.8% 个性化 / +29.4% agentic 推理) |
作者视角
问题发现
通用 LLM 充当辅导时有三个结构性缺陷:① 缺个性化(每次对话从零开始,不记得学习者的薄弱点);② 直接给答案不利学习(一问就吐完整解法,剥夺学生推导过程);③ RAG 在教育场景只会「检索-拼接」,给不出溯源到知识来源的引导式反馈。HKUDS(Chao Huang 团队,关联马毅、LightRAG 班底)做了大量 RAG/知识图谱基础设施后判断:检索增强只是底座,真正缺的是把检索、解题、出题、可视化编排成有教学意图的 agentic 流程,并让系统跨会话记住学习者。
解法哲学(三条原则代码可验证)
- agent-native(单一 agentic 引擎 + 多专门 Agent):
deeptutor/core/agentic/loop.py是一个能力无关的标签驱动调度器,chat/solve/research/question 全跑同一个 loop,只是各自声明不同标签词表。 - 引导式而非直接给答案:solve 走
PLAN → solve_step(THINK/TOOL/FINISH/REPLAN 循环)→ synthesize,每步是「可验证子目标」而非一次给答案;solve/prompts/en/pipeline.yaml要求「Cite retrieved passages inline as [source-id]」——引用溯源是硬约束。 - 静态知识 × 动态记忆:solve/chat 的 pipeline 同时吃
kb_name(静态 RAG 知识库)和memory_context(动态学习者记忆)——论文「混合个性化引擎」的代码落点。
背景知识迁移(一处重要校正)
DeepTutor 把实验室在检索/图谱上的积累迁到教育,但当前 RAG 已不是 LightRAG:deeptutor/services/rag/factory.py 显示 v1.4.0 把 RAG 重构为 LlamaIndex-only(hybrid BM25/向量融合),历史的 lightrag 字符串被一律归一为 llamaindex。所以「LightRAG 血统」是团队基因层面的,不是当前实现——这点需客观区分。
战略图景
HKUDS 教育落点 + 学术产品化双线:arXiv 论文(含自建 TutorBench + 学生模拟器评测)做背书,开源 self-hosted 产品做流量与生态。需客观看待:5.3 个月 24.6K star 是「实验室品牌 + 矩阵导流(Discord/飞书/微信群)+ 真实需求」叠加的结果,并非纯自发增长。
核心价值提炼
创新点
1. 单一 label-driven agentic 引擎驱动全部教学能力 — 新颖度 4/5 · 实用性 5/5 · 可迁移性 5/5
用声明式 LabelProtocol(allowed, terminal, intermediate, final, tool_label) 把 chat/solve/research/question 统一到一个能力无关循环。LLM 每轮第一行只写一个标签(chat 用 FINISH/TOOL/THINK/PAUSE,solve 用 PLAN/THINK/TOOL/FINISH/REPLAN),loop 据此决定终止/调工具/续跑/协议修复。能力特异逻辑通过 LoopHost Protocol 回调注入。适用:任何多能力共享 ReAct 引擎的 agent 平台。
2. 三层(L1/L2/L3)可读可编辑的学习者记忆引擎 — 新颖度 4/5 · 实用性 4/5 · 可迁移性 5/5
services/memory/store.py:L1 = 原始 trace 事件 append-only 日志;L2 = 按 surface 聚合的文档;L3 = 4 槽位(recent 近期摘要 / profile 画像 / scope 知识范围 / preferences 偏好)。consolidator 用 LLM 把 L1 增量压缩成 L2/L3 的结构化 ops(AddOp/EditOp),按 backlog 触发再消化。纯 Markdown 文件 + 原子写,用户可在 Memory Workbench 直接编辑。这是论文「动态学习者记忆」的落点。适用:需跨会话长期记忆且要人类可审计的 agent。
3. 真实渲染帧驱动的视觉自审闭环 — 新颖度 5/5 · 实用性 3/5 · 可迁移性 4/5
agents/math_animator/ 走 5 阶段(concept_analysis → concept_design → code_generation → render → summary)。renderer.py 跑 Manim 渲染动画;visual_review.py 用 ffmpeg 在 15%/50%/85% 时间点抽帧 → 转多模态 image → 喂给 VisualReviewAgent 视觉评审。CodeRetryManager(max 4)同挂 repair_callback(编译报错修复)+ review_callback(视觉问题修复)。适用:代码生成可视化/UI 的 agentic 自纠流水线。
4. 难度标定 + 历史错题诊断驱动的个性化出题 — 新颖度 3/5 · 实用性 5/5 · 可迁移性 4/5
question/prompts/en/pipeline.yaml 携带 difficulty: easy|medium|hard,且出题前先跑诊断 pass——读 Prior quiz history 找出答错的子主题/难度/题型,再把检索偏向薄弱点、不重复题干。把「难度标定」与「学习者记忆个性化」缝在一起。适用:自适应练习/测评系统。
5. 引用溯源式辅导(prompt 硬约束 + citation_manager 后处理) — 新颖度 3/5 · 实用性 5/5 · 可迁移性 5/5
solve 强制 [source-id] 内联引用;research 的 mode_strategy.py 用 enable_inline_citations/enable_citation_list 控制,配 866 行 citation_manager.py。grounding 落到可信溯源。适用:任何需可信溯源的 RAG。
可复用模式
- 声明式标签协议 + Host 回调分层:能力无关 loop 只认标签,能力特异逻辑走回调 — 多能力共享 agent 引擎。
- L1 原始流 → LLM consolidate → L2/L3 结构化文档(ops diff):分层长期记忆 — 需可审计、可人工编辑的 agent 记忆。
- 进程内能力委派:不可变子上下文派生 + 事件流 call_id 标记:防子 Agent 输出污染主历史 — 多 Agent 编排。
- 产物渲染→截帧→多模态自审→定向修复:agentic 自纠 — 代码/可视化生成。
- 标签控制流 + 三级 JSON 兜底(markdown 抽取/json_repair/fallback)+ 能力探测降级:面向异构/本地模型的鲁棒输出 — 任何要兼容弱模型的 agent。
关键设计决策
- Orchestrator + Registry + Capability 门面三层路由:CLI/WebSocket/SDK 全走同一个
ChatOrchestrator.handle(context),按active_capability从CapabilityRegistry取能力跑在独立StreamBus上;Registry 用importlib动态加载 builtins + entry-point 插件。Trade-off:多一层间接,换来多入口统一 + 能力可插拔。 - Auto 模式进程内能力委派:
agents/auto/delegation.py用dataclasses.replace构造不可变子上下文,子能力跑在子 StreamBus,事件转发时注入call_id让 turn_runtime 过滤掉子输出,只有 Auto 的最终合成进历史;delegate_with_retry提供最多 3 次重试 + 前端「Retry K/N」badge。 - 标签协议替代 JSON 强制输出(应对 #15):核心控制流不靠模型吐 JSON(三引号等易解析崩,弱/本地模型尤甚),而靠「第一行单标签 + 自由正文」;确需 JSON 处走
utils/json_parser.py三级兜底;call_llm用supports_response_format()探测后端能力后降级。 - Provider 无关 + 15 渠道 TutorBot 运行时:
base_agent.py经 services.llm 工厂路由原生 OpenAI/Anthropic SDK(v1.0.0-beta.3 弃用 litellm),支持 Ollama/LM Studio/llama.cpp/vLLM/NIM 等本地后端;tutorbot/channels/有 15 个消息渠道(Discord/Slack/Telegram/飞书/钉钉/企微/WhatsApp/QQ/Matrix 等)做持久自治辅导 bot。
竞品格局
| 竞品 | 定位 | 优势 | 劣势(相对 DeepTutor) |
|---|---|---|---|
| DeepTutor(本项目) | agent-native 开源全栈辅导 | 多 Agent 能力全栈、三层记忆个性化、引用溯源、开源 self-hosted、论文背书 | 自部署摩擦大、结构化输出鲁棒性、学习成效待验证、增长有导流加持 |
| Khanmigo | 闭源标杆(Khan Academy + GPT) | 内容权威、规模大、机构渠道强 | 闭源、不可自部署、不可换模型、创始人承认离「超级家教」尚远 |
| Squirrel AI(松鼠 AI) | K12 自适应学习(中国) | 知识图谱细(1 万+ 知识点)、大规模数据闭环、线下网点 | 闭源、绑硬件/线下、学习者自由度低、偏 K12 应试 |
| Socratic / Photomath | 拍照解题单点 | 移动端体验成熟、识题快 | 给答案不给路径、无记忆、无 agentic 辅导链路、闭源 |
| Synthesis / Duolingo Max | 对话式家教 / 语言学习 | 产品打磨、动机设计好 | 闭源 SaaS、场景窄 |
| 开源同类(OpenTutor 等) | 开源 self-hosted 轻量辅导 | 轻量、可私有 | 体量与能力广度远不及、无论文背书(topic 匹配候选均 <200 star) |
关键差异化轴:① agent-native 多 Agent vs 单模型套壳;② 开源 self-hosted vs 闭源 SaaS(教育数据隐私/可控的实质卖点);③ 多模态拍照解题 + DeepResearch + 数学动画 + 教材生成的能力全栈 vs 单点;④ 学术论文 + TutorBench 基准背书 vs 纯商业产品。
综合结论——护城河:agent-native 能力全栈(解题/出题/研究/可视化/动画/co-writer/book)+ 三层学习者记忆个性化引擎 + grounding 溯源 + 开源 self-hosted + 论文背书,五者叠加目前无开源对手能全配齐。竞争风险:① 自部署摩擦显著(Docker/NAS/CORS/本地模型/Manim+ffmpeg 系统依赖,#301/#3/#115/#463)② 多 Agent 结构化输出鲁棒性(#15,标签协议+json_repair 大幅缓解但非根除)③ 学习成效待第三方独立验证(自建基准 + 学生模拟器有自证嫌疑,「会不会让学生变懒」之问未解)④ 增长有 HKUDS 矩阵导流加持,非纯自然 ⑤ AI 教育赛道同质化,引导式辅导+RAG 叙事正被快速复制。
套利机会分析
- 对「想搭多能力 agent 平台」的开发者:
core/agentic/loop.py的「声明式标签协议 + LoopHost 回调」是把多能力统一到一个 ReAct 引擎的优秀范式,比为每个能力各写一套循环优雅得多,可直接借鉴。 - 对「要给 agent 加长期记忆」的团队:三层记忆引擎(L1 原始流 → LLM consolidate → L2/L3 结构化文档 + ops diff)是一套干净、可审计、对人类可读可改的 agent 记忆方案,比单一对话摘要或纯向量记忆更适合需要透明度的场景。
- 对「做代码/可视化生成自纠」的人:math_animator 的「渲染→ffmpeg 抽帧→多模态自审→定向修复」闭环,是「Agent 看自己产物再改」的可迁移参考。
- 对「面向本地/异构模型」的工程师:「标签控制流替代 JSON + 三级 JSON 兜底 + 能力探测降级」是兼容弱模型的务实经验,能省下大量解析崩溃的踩坑。
- 对 AI 教育内容创作者:「AI 教育从问答到 agentic 辅导」+「港大开源矩阵」+「不给答案给引导」叙事张力强,题材稀缺度高。
风险与不足
- 自部署摩擦显著:Docker/NAS/CORS、本地模型(LM Studio)兼容、Manim+ffmpeg 系统级依赖都是踩坑点(#301/#3/#115/#463),开箱即用体验未完全打磨好。
- 多 Agent 结构化输出鲁棒性:模型输出含三引号等会导致 JSON 解析崩(#15);标签协议 + json_repair 已大幅缓解,但弱模型下非根除。
- 学习成效待第三方验证:+10.8% 个性化 / +29.4% agentic 推理来自自建 TutorBench + 学生模拟器,有自证嫌疑;「AI 家教会不会让学生变懒」的根本质疑(Sal Khan 公开反思)尚未解决。
- 记忆引擎无向量化检索:三层记忆是纯 Markdown 文档,跨主题召回与规模化能力有限。
- 增长有矩阵导流加持:HKUDS 实验室品牌 + 社群导流是增速的重要变量,需与「纯自发需求」区分。
- 快速迭代期,稳定性仍在收敛:fix 占比约 47.5%、5.3 个月 40 release——问题在被高频修,但也意味着稳定性未定型;注释比 0.119 偏低(靠详尽 docstring 弥补)。
行动建议
- 用它:Docker 一键私有部署(docker-compose×3),导入文档建知识库 → 体验引导式解题/出题/DeepResearch/数学动画;支持 Ollama/LM Studio 等本地模型,教育数据可留本地。
- 学它:精读关键路径——
deeptutor/core/agentic/loop.py(标签引擎)+runtime/orchestrator.py+agents/auto/delegation.py(能力委派)+services/memory/store.py(三层记忆)+agents/math_animator/visual_review.py(视觉自审)+utils/json_parser.py(JSON 鲁棒兜底)。 - fork 它:Apache-2.0,可二次开发;82 个外置 prompt YAML 与代码解耦,便于定制教学风格/换语言;能力可通过 Registry 的 entry-point 插件模型扩展。
知识入口
| 入口 | 链接 | 用途 |
|---|---|---|
| GitHub 仓库 | https://github.com/HKUDS/DeepTutor | 源码 / Release / Issue |
| arXiv 论文 | https://arxiv.org/abs/2604.26962 | 《DeepTutor: Towards Agentic Personalized Tutoring》方法/评测权威来源 |
| 官方文档站 | https://hkuds.github.io/DeepTutor/ | 6 大能力 + 部署(含中文 /zh/) |
| 产品官网 | https://deeptutor.info | 产品演示 |
| DeepWiki | https://deepwiki.com/HKUDS/DeepTutor | 架构解读 |
| HKUDS 组织 | https://github.com/HKUDS | LightRAG / RAG-Anything 等矩阵串联 |
| 本地源码关键路径 | deeptutor/core/agentic/loop.py / services/memory/store.py / agents/math_animator/ | 架构研读起点 |