langextract 深度分析报告
一句话总结
Google 出品的 LLM 信息抽取库——以”精确源定位(Source Grounding)“为核心差异化,从非结构化文本中提取结构化信息时,每个实体都映射回源文本的精确字符位置。
值得关注的理由
- 精确源定位是杀手级特性:在医疗/法律等需要可验证提取的场景,能追溯每个实体到源文本精确位置,这是 Instructor、Marvin 等竞品没有的
- Google Health 背景的领域深度:核心开发者是 Google Health 的 ML 工程师兼医师科学家,医学背景直接驱动了”可验证性优先”的设计哲学
- 34.8K Star 的极速增长:8 个月从 0 到 34.8K Star,被 Google Developers Blog、Hacker News、DataCamp 等广泛报道
项目展示
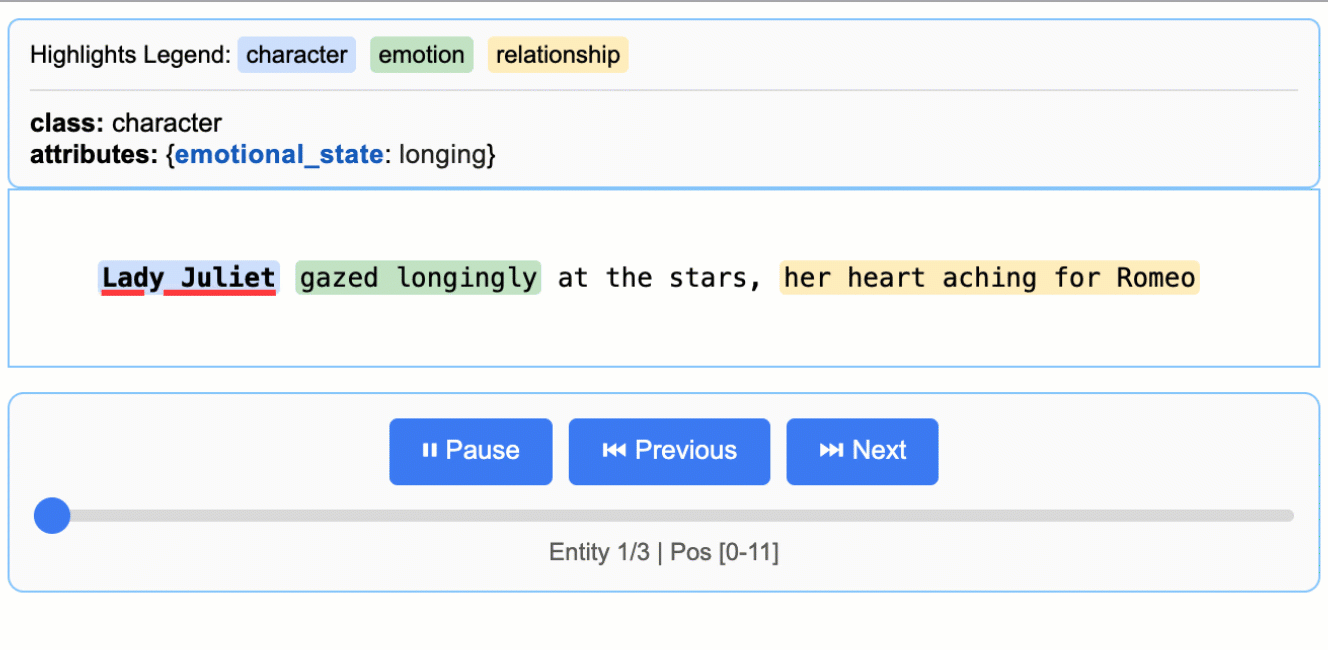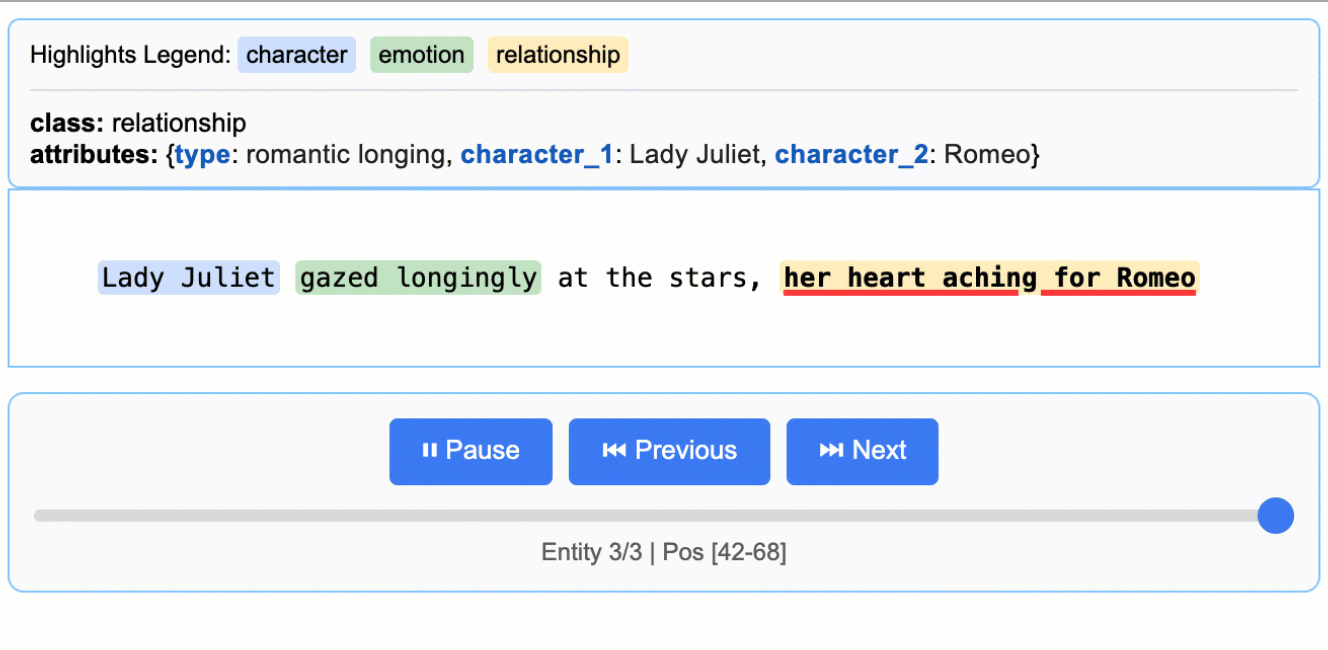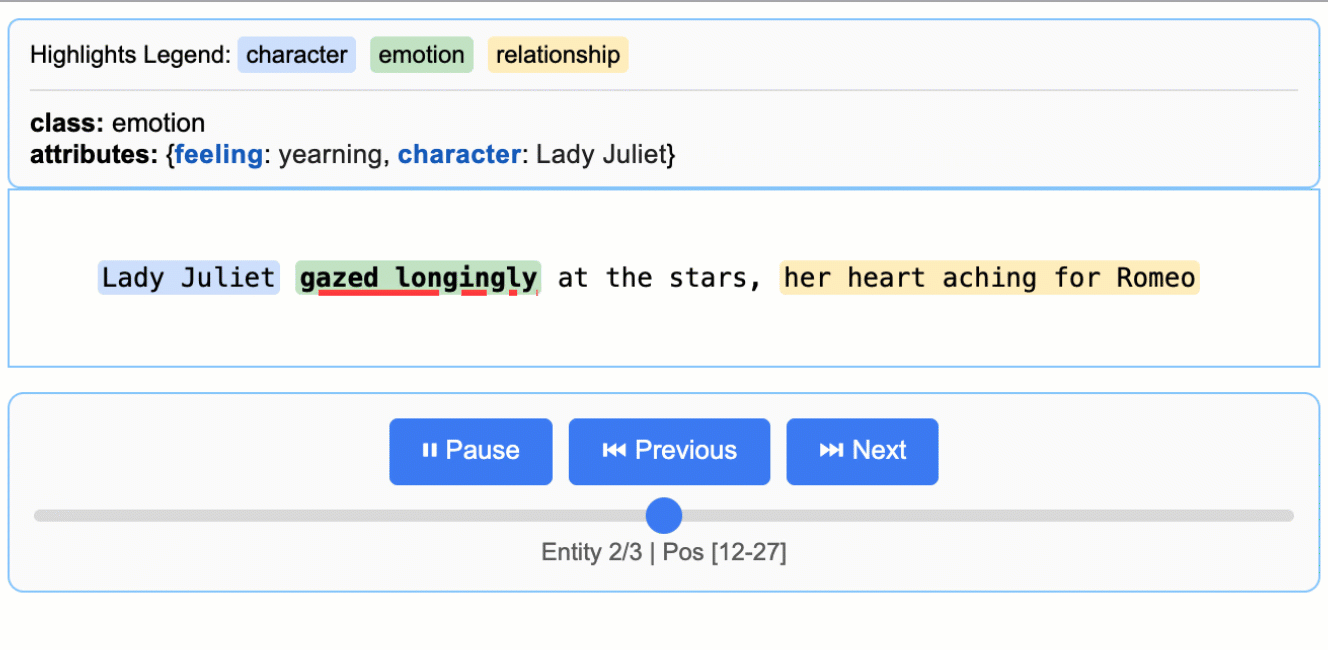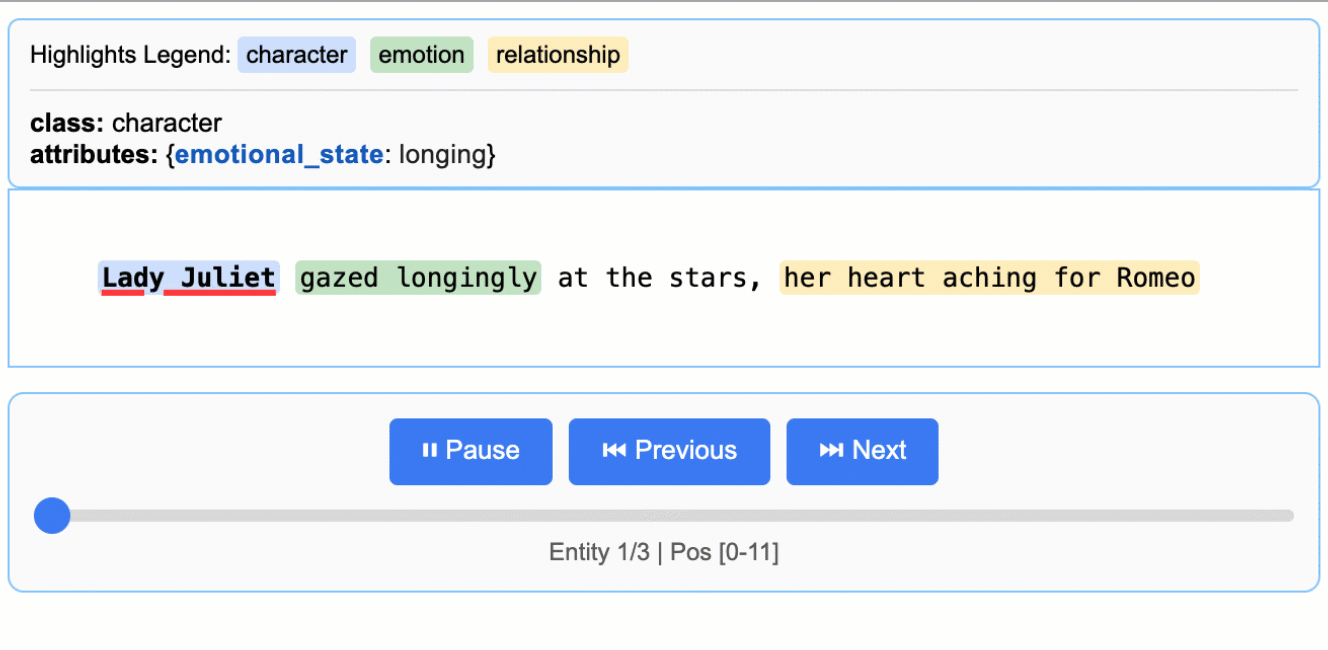 对《罗密欧与朱丽叶》文本的实体提取与高亮可视化——每个提取的实体都映射回源文本的精确位置
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/google/langextract |
| Star / Fork | 34,827 / 2,336 |
| 代码行数 | 24,190 (Python 95%) |
| 项目年龄 | 8 个月 |
| 开发阶段 | 成熟维护期(v1.1.1,核心功能稳定) |
| 贡献模式 | 单人主导(aksg87 贡献 90%+) |
| 热度定位 | 大众热门(34.8K Star) |
| 质量评级 | 代码[良好] 文档[优秀] 测试[基本] |
作者视角:为什么存在这个项目
创始人/作者背景
核心开发者 Akshay Goel (@aksg87) 是 Google Health 的 ML 软件工程师,同时也是医师科学家(有 Google Scholar 页面)。这种”医生+工程师”的双重身份直接塑造了项目的核心设计——在医疗场景中,信息提取的”可验证性”比”速度”更重要。项目从临床报告结构化出发,后泛化为通用文本提取库。
问题判断
现有 LLM 提取工具(Instructor、Marvin)解决了”从文本中提取结构化数据”的问题,但没解决”如何验证提取结果是否正确”的问题。在医疗/法律领域,一个错误的提取可能导致严重后果。作者看到了”从提取到可验证提取”的关键差距。
时机选择:2025 年 Gemini API 的 Controlled Generation 能力成熟,使得”精确字符位置映射”这种细粒度控制变得可能。
解法哲学
- 源定位优先——每个提取实体都精确映射到源文本字符位置,自动生成交互式 HTML 可视化
- 少样本示例驱动——通过 few-shot examples 定义提取任务,无需模型微调
- 长文档分块策略——分块 + 并行 + 多轮提取解决”大海捞针”问题
- 非 Google 官方产品——README 明确声明”This is not an officially supported Google product”,保持了个人项目的灵活性
战略意图
从 Google 视角看,这是 Gemini 生态的关键应用层工具。通过默认集成 Gemini API,展示 Gemini 在结构化输出方面的能力,同时通过插件系统支持 OpenAI 和 Ollama,降低试用门槛。PyPI 发布(langextract)说明瞄准了广泛的开发者采用。
核心价值提炼
创新之处
- 精确源定位(Source Grounding)(新颖度 5/5 × 实用性 5/5)——每个提取实体映射到源文本的精确字符位置,自动生成交互式 HTML 可视化。在竞品中独一无二
- 长文档分块+多轮提取策略(3/5 × 5/5)——解决了 LLM token 限制下的”大海捞针”问题,对长报告提取至关重要
- 交互式 HTML 可视化自动生成(4/5 × 4/5)——提取结果自动渲染为可点击的高亮页面,极大降低了人工验证成本
- 插件化 LLM Provider 系统(2/5 × 4/5)——支持 Gemini、OpenAI、Ollama,通过插件机制可扩展自定义 Provider
可复用的模式与技巧
| 模式 | 适用场景 |
|---|---|
| 源定位(字符级实体-文本映射) | 任何需要可追溯 LLM 输出的场景 |
| 少样本示例驱动的任务定义 | LLM 应用中无需微调的快速适配 |
| 长文档分块+并行+多轮提取 | 处理超过 context window 的文档 |
| importlinter 模块间导入约束 | 需要架构边界守护的 Python 项目 |
| 插件化 Provider 系统 | 需要支持多 LLM 后端的应用 |
关键设计决策
- Gemini 优先但不锁定:默认使用 Gemini 的 Controlled Generation,但通过 Provider 插件支持 OpenAI/Ollama。Trade-off:Gemini 上的效果最好,但不限制用户选择
- 字符级源定位 vs 句子级:选择精确到字符而非句子,增加了实现复杂度,但在医疗场景下精确度至关重要
- importlinter 架构守护:使用 import-linter 工具强制执行模块间的导入规则,防止架构腐化
竞品格局与定位
竞品对比矩阵
| 维度 | langextract | Instructor | Marvin | Sparrow |
|---|---|---|---|---|
| 定位 | 可验证信息提取 | 通用结构化输出 | 轻量 AI 框架 | 文档提取 |
| Star | 34.8K | ~11K | ~3K | 5.1K |
| 源定位 | 字符级精确映射 | 无 | 无 | 无 |
| 可视化 | 自动 HTML 生成 | 无 | 无 | 有 |
| 长文档 | 分块+多轮提取 | 无内置 | 无内置 | 有 |
| LLM 支持 | Gemini/OpenAI/Ollama | 多 Provider | OpenAI 为主 | 多模态 |
| 视觉/布局 | 纯文本 | 无 | 无 | 支持 |
差异化护城河
“精确源定位+交互式可视化”的组合是核心护城河。在需要可验证提取的垂直领域(医疗、法律、金融),这个能力是硬需求。Google 品牌背书 + Gemini 生态联动进一步巩固了信任度。
竞争风险
- Instructor 如果添加源定位功能,凭借更大的社区和更通用的定位可能蚕食市场
- 项目高度依赖 aksg87 一人维护(112/132 commits),42 个 open PR review 瓶颈明显
- 非 Google 官方支持产品意味着没有正式的长期维护承诺
生态定位
Gemini 生态的关键应用层工具,位于”LLM API → 结构化信息提取”的落地层。在通用提取(Instructor)和文档提取(Sparrow)之间,以”可验证提取”切入差异化细分。
套利机会分析
- 信息差: 34.8K Star 热度极高,但 Watcher 仅 160,多数关注者未深入研究。源定位模式的技术价值远超表面看到的”又一个 LLM 提取库”
- 技术借鉴: 源定位(字符级实体-文本映射)模式可直接迁移到任何需要 LLM 输出可追溯性的场景
- 生态位: 填补了”可验证 LLM 信息提取”空白,在医疗/法律等受监管行业有刚性需求
- 趋势判断: 项目已进入维护期(近 90 天仅 8 commits),但核心功能稳定。关注 Gemini Realtime API 和 Vertex AI 集成的演进方向
风险与不足
- 单人维护风险:aksg87 贡献 90%+ 代码,42 个 open PR 积压无人 review
- 非 Google 官方产品:明确声明不是 Google 官方支持,长期维护无保障
- Gemini 偏好:虽支持多 Provider,但源定位效果在 Gemini 上最优,切换到 OpenAI/Ollama 可能有质量损失
- 纯文本限制:不支持文档布局/视觉理解(Sparrow 的优势领域)
- 开发节奏放缓:2025-08 月 99 commits 的爆发后,当前月均仅 1-4 commits
行动建议
- 如果你要用它: 适合需要”可验证提取”的场景(医疗报告、法律文件、金融摘要)。如果只需要通用结构化输出,Instructor 更成熟;如果需要文档布局理解,用 Sparrow
- 如果你要学它: 重点关注
langextract/annotation.py(源定位实现)、langextract/extraction.py(核心提取逻辑)、langextract/inference.py(LLM 推理编排)、langextract/providers/(插件化 Provider 系统) - 如果你要 fork 它: 优先方向——(1) 多语言 tokenizer 支持(#32 高需求);(2) 重试机制增强(#257);(3) 文档布局/视觉理解能力
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | deepwiki.com/google/langextract |
| Zread.ai | zread.ai/google/langextract |
| 关联论文 | Learning to Extract Structured Entities Using Language Models(方向相关) |
| 在线 Demo | RadExtract - HuggingFace Spaces |