Memori 深度分析报告
一句话总结
SQL 原生的 AI Agent 记忆引擎——不依赖向量数据库,用关系型数据库为 LLM 应用提供持久化记忆层,主打企业级合规和可解释性。
值得关注的理由
- SQL 原生架构的差异化选择:在竞品(mem0、letta)都依赖向量数据库时,Memori 用 SQL 原生方案降低运维复杂度,对已有 RDBMS 基础设施的企业更友好
- 增长势头强劲:8 个月内从 0 到 12.4K Star,有真实商业产品(Memori Cloud)和在线 Playground
- AI Agent 记忆层是基础设施级赛道:LLM 应用从无状态到有状态的演进是确定性趋势,记忆层是必经之路
项目展示
 Memori Labs 品牌标识
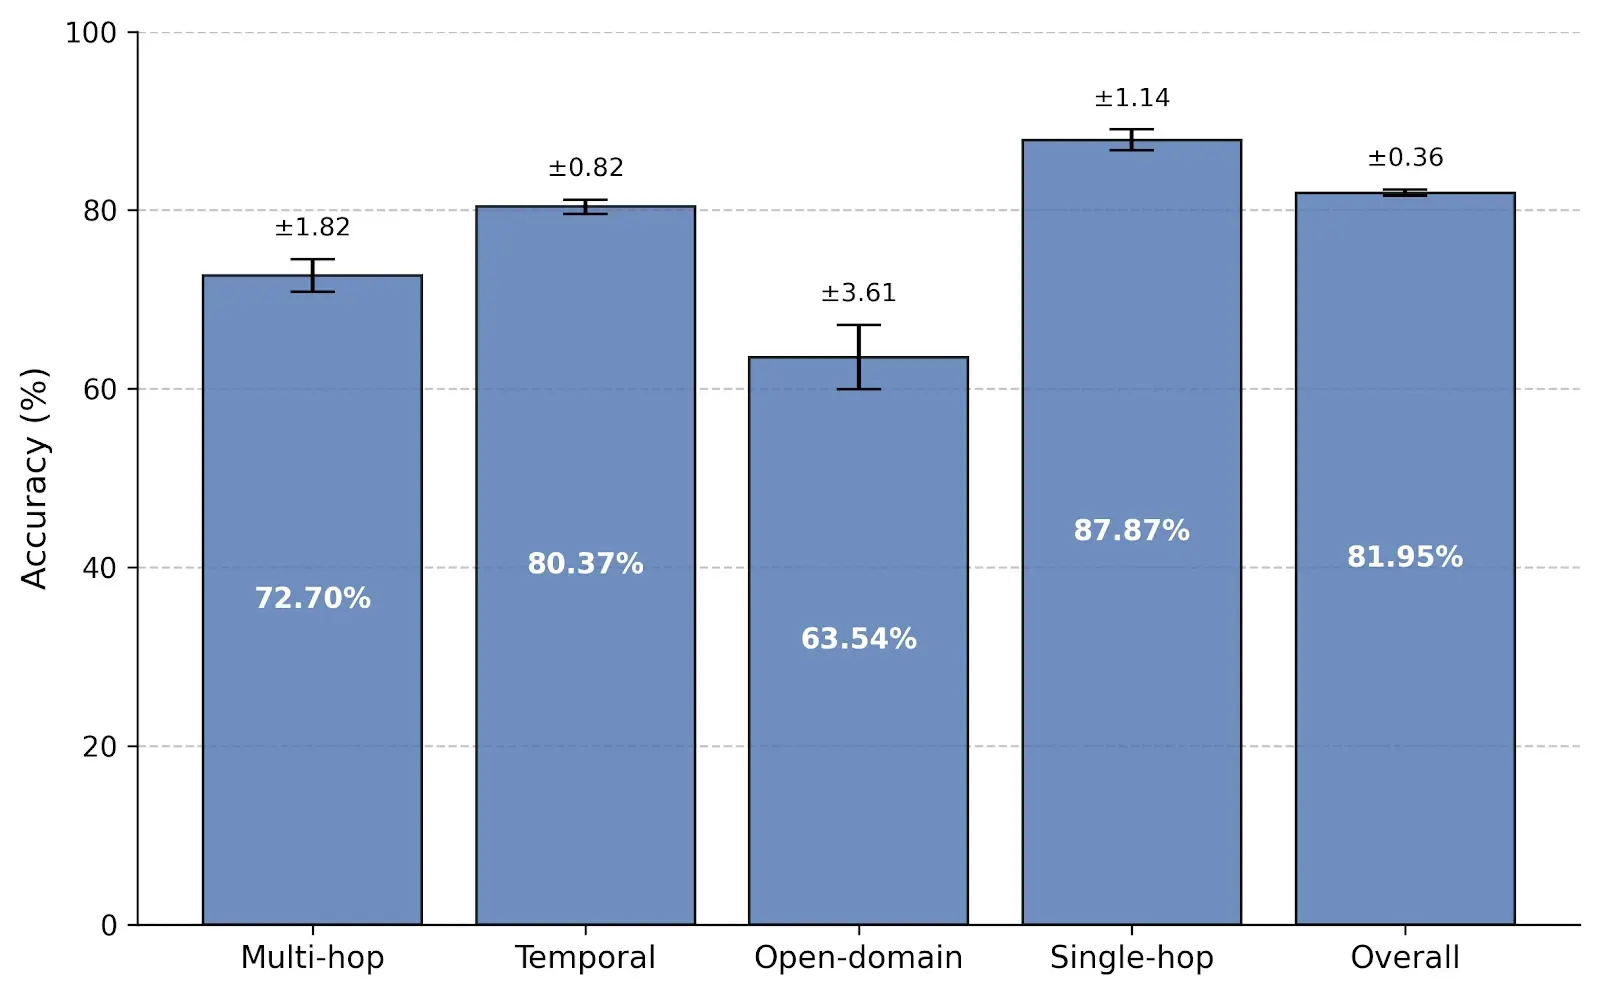 LoCoMo 基准测试:Memori 以 81.95% 准确率领先,仅使用 4.97% 的 full-context tokens
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/GibsonAI/Memori |
| Star / Fork | 12,422 / 1,114 |
| 代码行数 | 53,866 (Python 54.8%, JSON 34.7%, MDX 10.9%, TypeScript 5.9%) |
| 项目年龄 | 8 个月 |
| 开发阶段 | 密集开发(近期 ~45 commit/月) |
| 贡献模式 | 小团队主导(5 人核心,31 人总贡献) |
| 热度定位 | 大众热门(12.4K Star,月均 1,500 新增) |
| 质量评级 | 代码[良好] 文档[优秀] 测试[基本] |
作者视角:为什么存在这个项目
创始人/作者背景
MemoriLabs(原 GibsonAI)是一家 LA 创业公司,团队具有企业 AI 和数据库背景。GibsonAI 最初可能是数据库公司,后转型为 AI 记忆层产品。有 Microsoft DevRel 人员(Boburmirzo,105 commits)深度参与开发,核心维护者 harshalmore31 贡献 201 次 commit。联合创始人 mcmontero 是 Struck Studio 创始人 & Montero Ventures。
问题判断
作者看到的关键问题:LLM 应用是无状态的,每次对话都从零开始。现有解决方案(mem0 等)依赖向量数据库,对企业来说引入了额外的运维复杂度和数据主权风险。时机选择:2025 年 AI Agent 从 demo 走向生产部署,记忆层从”nice to have”变为”must have”。
解法哲学
- SQL 原生 > 向量数据库——利用企业已有的 PostgreSQL/MySQL 基础设施,不引入新的数据存储依赖
- 自动分类——对话自动分类为事实、偏好、规则和摘要四种类型,而非简单的向量相似度检索
- 零延迟增强——记忆提取异步后台处理,不阻塞主请求路径
- 最小接入摩擦——“一行代码”集成,降低开发者试用门槛
战略意图
典型的开源 + Cloud 商业模式:Memori 开源版作为获客漏斗,Memori Cloud(托管版)+ BYODB(自托管企业版)作为商业化路径。PCI/SOC 2 合规定位瞄准金融和医疗等受监管行业。
核心价值提炼
创新之处
- SQL 原生记忆存储(新颖度 4/5 × 实用性 4/5)——用 SQLAlchemy 抽象层支持 9+ 数据库后端,避免向量数据库锁定
- 四类型自动分类记忆(3/5 × 4/5)——将对话记忆自动分为事实/偏好/规则/摘要,比纯向量检索提供更精准的上下文
- LoCoMo 基准 81.95% 准确率 + 4.97% token 使用(3/5 × 5/5)——证明了在大幅减少 token 消耗的同时维持高准确率
- MCP 协议支持(2/5 × 4/5)——顺应 Model Context Protocol 趋势,可作为 Claude/其他 LLM 的记忆 MCP server
可复用的模式与技巧
| 模式 | 适用场景 |
|---|---|
| SQLAlchemy 多数据库抽象层 | 需要支持多种数据库后端的 Python 项目 |
| 异步后台记忆增强 | 需要后台处理但不阻塞主路径的 AI 应用 |
| LLM Provider 抽象(6+ 提供商) | 需要支持多 LLM 的应用 |
| 双 SDK(Python + TypeScript)策略 | 需要同时服务后端和前端开发者的开源项目 |
关键设计决策
- SQL 原生 vs 向量数据库:牺牲了语义相似度检索的便利性,换来了运维简单性和企业合规性
- Retrieval Agent 架构:用 LLM agent 做记忆检索和分类,而非纯向量检索。Trade-off:增加了 LLM 调用成本,但提高了记忆质量
- 开源 + Cloud 双轨:核心引擎完全开源,Cloud 版提供托管和企业功能
竞品格局与定位
竞品对比矩阵
| 维度 | Memori | mem0 | letta | cognee |
|---|---|---|---|---|
| Star | 12.4K | 50.6K | 21.7K | 14.4K |
| 存储架构 | SQL 原生 | 向量数据库 | 自定义 | 知识图谱 |
| 定位 | AI 记忆引擎 | 通用记忆层 | Agent 平台 | 知识引擎 |
| 企业合规 | PCI/SOC 2 | 基本 | 基本 | 基本 |
| 接入门槛 | 低(1 行代码) | 低 | 中 | 低(6 行) |
| 数据库支持 | 9+ SQL/NoSQL | Qdrant/Chroma | PostgreSQL | Neo4j |
差异化护城河
SQL 原生架构 + 企业合规定位。对于已有 PostgreSQL/MySQL 基础设施且不想引入向量数据库的企业,Memori 是最自然的选择。LoCoMo 基准的领先成绩也提供了技术可信度。
竞争风险
mem0 的先发优势和 50K Star 生态宽度是最大威胁。如果 mem0 也支持 SQL 后端,Memori 的核心差异化将被削弱。此外 letta 作为更完整的 Agent 平台,可能在上层覆盖记忆需求。
生态定位
细分市场——AI 记忆层赛道第三名,以 SQL 原生 + 企业合规切入差异化细分。市场仍在快速发展,格局未定。
套利机会分析
- 信息差: Watcher 仅 54(vs 12.4K Star),说明深度关注者少,多数 Star 来自短期曝光。实际技术价值可能被低估或高估
- 技术借鉴: SQL 原生记忆存储模式、四类型自动分类、异步后台增强三个设计可直接借鉴
- 生态位: 填补了”不依赖向量数据库的 AI 记忆层”空白
- 趋势判断: AI Agent 记忆层是确定性趋势,但赛道竞争激烈。Memori 需要在 mem0 进一步扩张前建立足够的企业客户基础
风险与不足
- 赛道竞争激烈:mem0 (50K Star) 遥遥领先,letta (21K) 和 cognee (14K) 紧追
- 公司历史短:MemoriLabs 仅 ~2 年历史,核心团队 5 人,可持续性存疑
- 部分基础功能缺失:删除记忆(#303)、本地 LLM 支持(#250)等基本功能未完善
- Cloud 产品稳定性:API 端点返回 401 Unauthorized(#368)暗示产品仍不成熟
- Star/Watcher 比异常:12.4K Star vs 54 Watcher,部分热度可能来自短期推广而非深度使用
- 代码量中 JSON 占 34.7%:大量 JSON 文件可能是测试数据或配置,实际代码量可能被高估
行动建议
- 如果你要用它: 适合已有 SQL 基础设施且不想引入向量数据库的场景。与 mem0 对比:Memori 更适合企业合规要求高的场景;mem0 更适合快速原型和社区生态丰富的场景
- 如果你要学它: 重点关注
memori/core/memory.py(核心记忆逻辑)、memori/database/sqlalchemy_manager.py(SQL 原生存储)、memori/agents/retrieval_agent.py(检索 agent) - 如果你要 fork 它: 优先方向——(1) 补全记忆删除和本地 LLM 支持;(2) 增加更多数据库后端;(3) 优化 LoCoMo 基准性能
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | deepwiki.com/GibsonAI/Memori |
| Zread.ai | zread.ai/GibsonAI/Memori |
| 关联论文 | 无(有自有 LoCoMo 基准白皮书) |
| 在线 Demo | memorilabs.ai/playground |