Graphiti 深度分析报告
一句话总结
面向 AI Agent 的时序知识图谱引擎,核心创新是双时序(bi-temporal)数据模型——让 Agent 不仅记住事实,还能追踪事实”何时为真、何时失效”,填补了 RAG 和 Agent Memory 领域在时间感知上的根本空白。
值得关注的理由
- 时序知识图谱的开源领导者:24K Stars,论文被学术界引用(arXiv 2501.13956),在 DMR 基准上达 94.8%(优于 MemGPT 93.4%),是”Agent 需要什么样的记忆”这个问题的最前沿实践
- 增量式知识构建:与 GraphRAG 的批处理根本不同——每次只处理一条 Episode,自动做实体解析、矛盾检测和时序推理,无需全图重算
- 丰富的生态扩展:4 种图数据库(Neo4j/FalkorDB/Kuzu/Neptune)、6+ LLM 供应商、MCP Server、混合搜索(3 路检索 × 5 种重排),架构抽象层设计成熟
项目展示
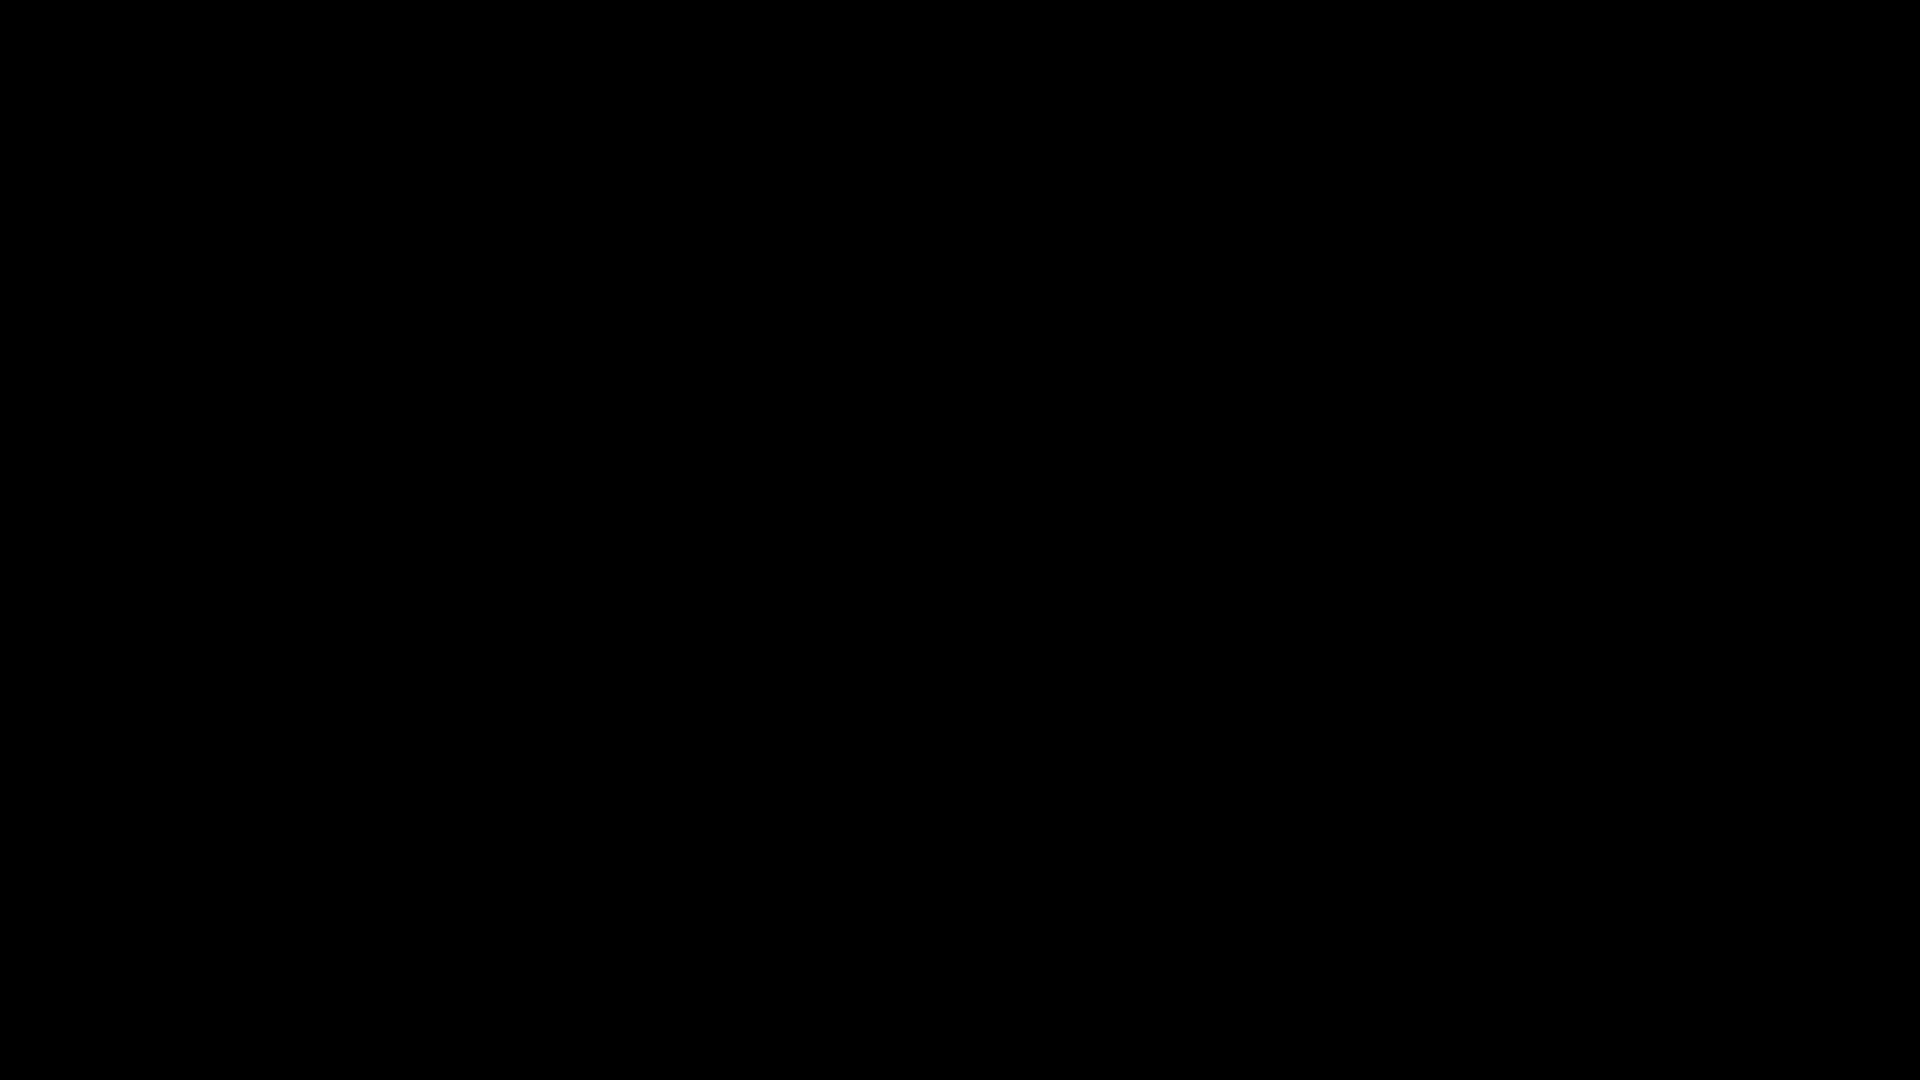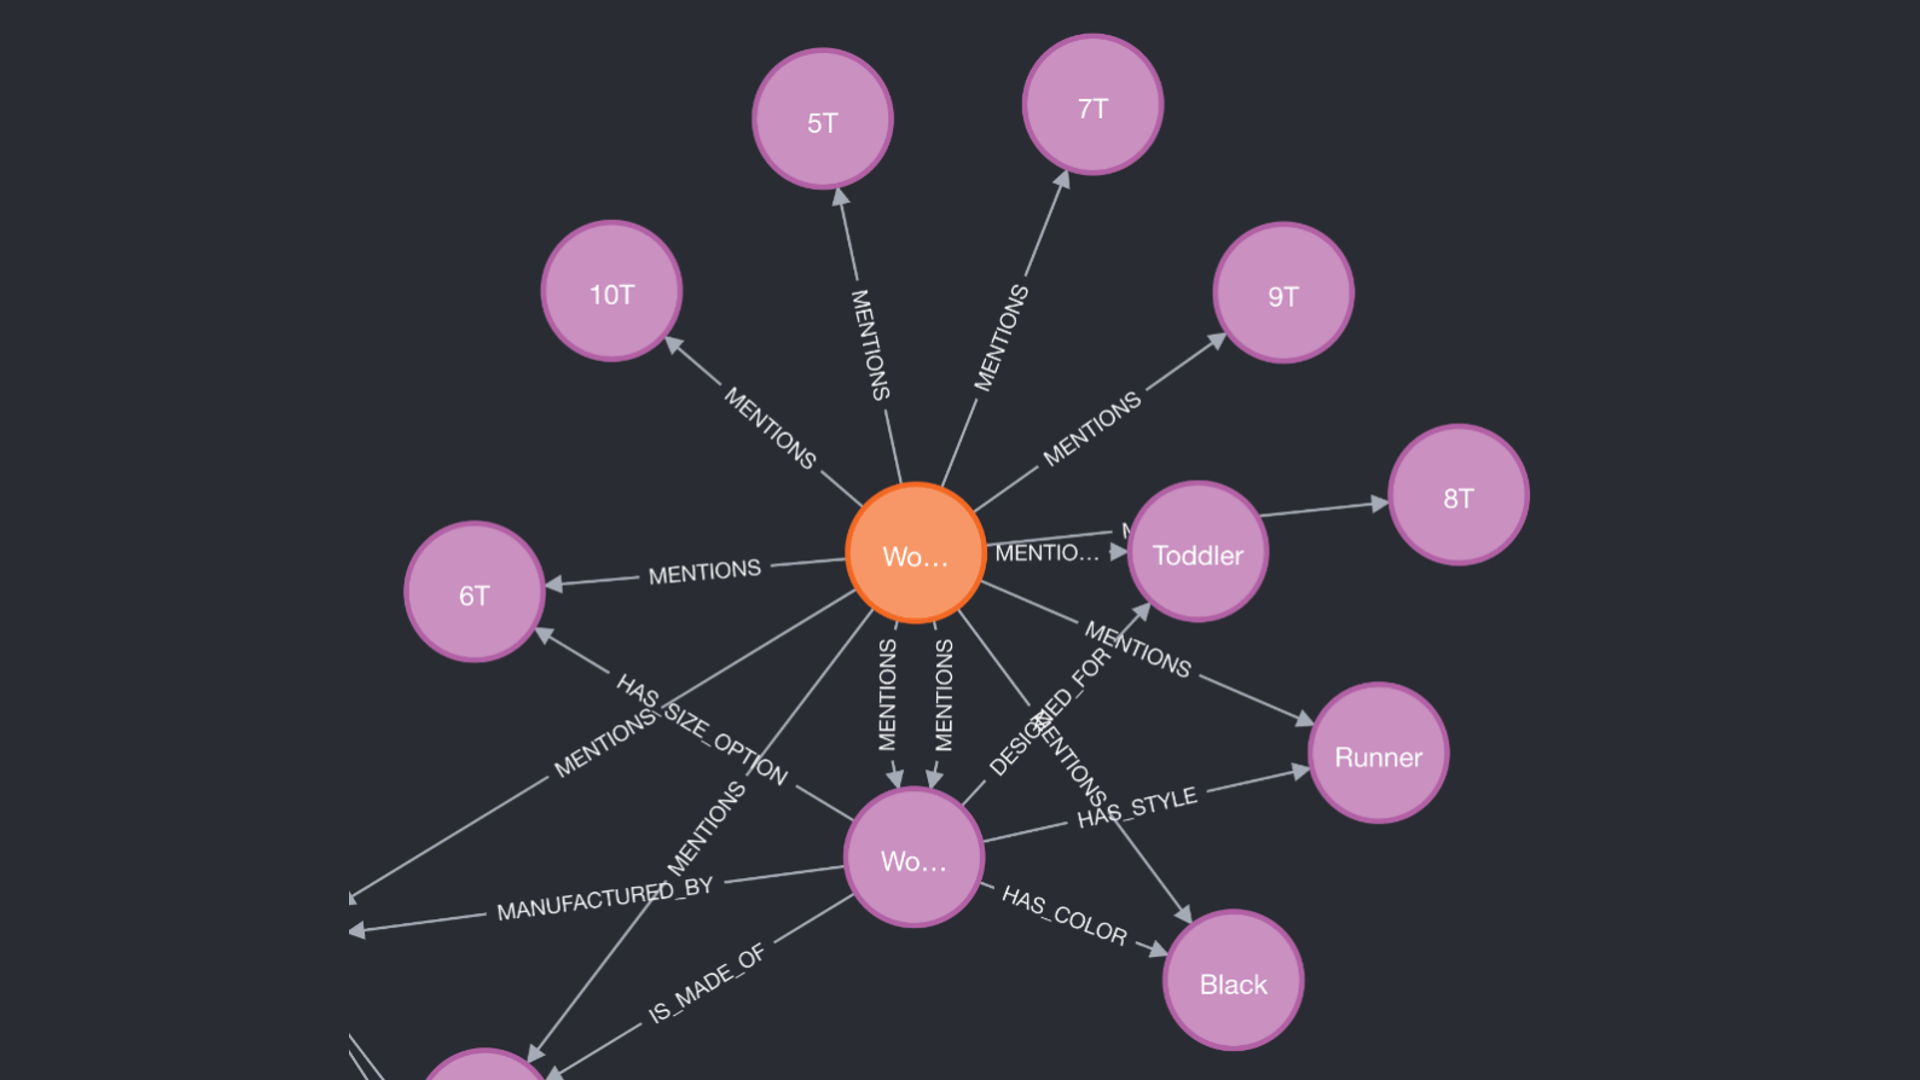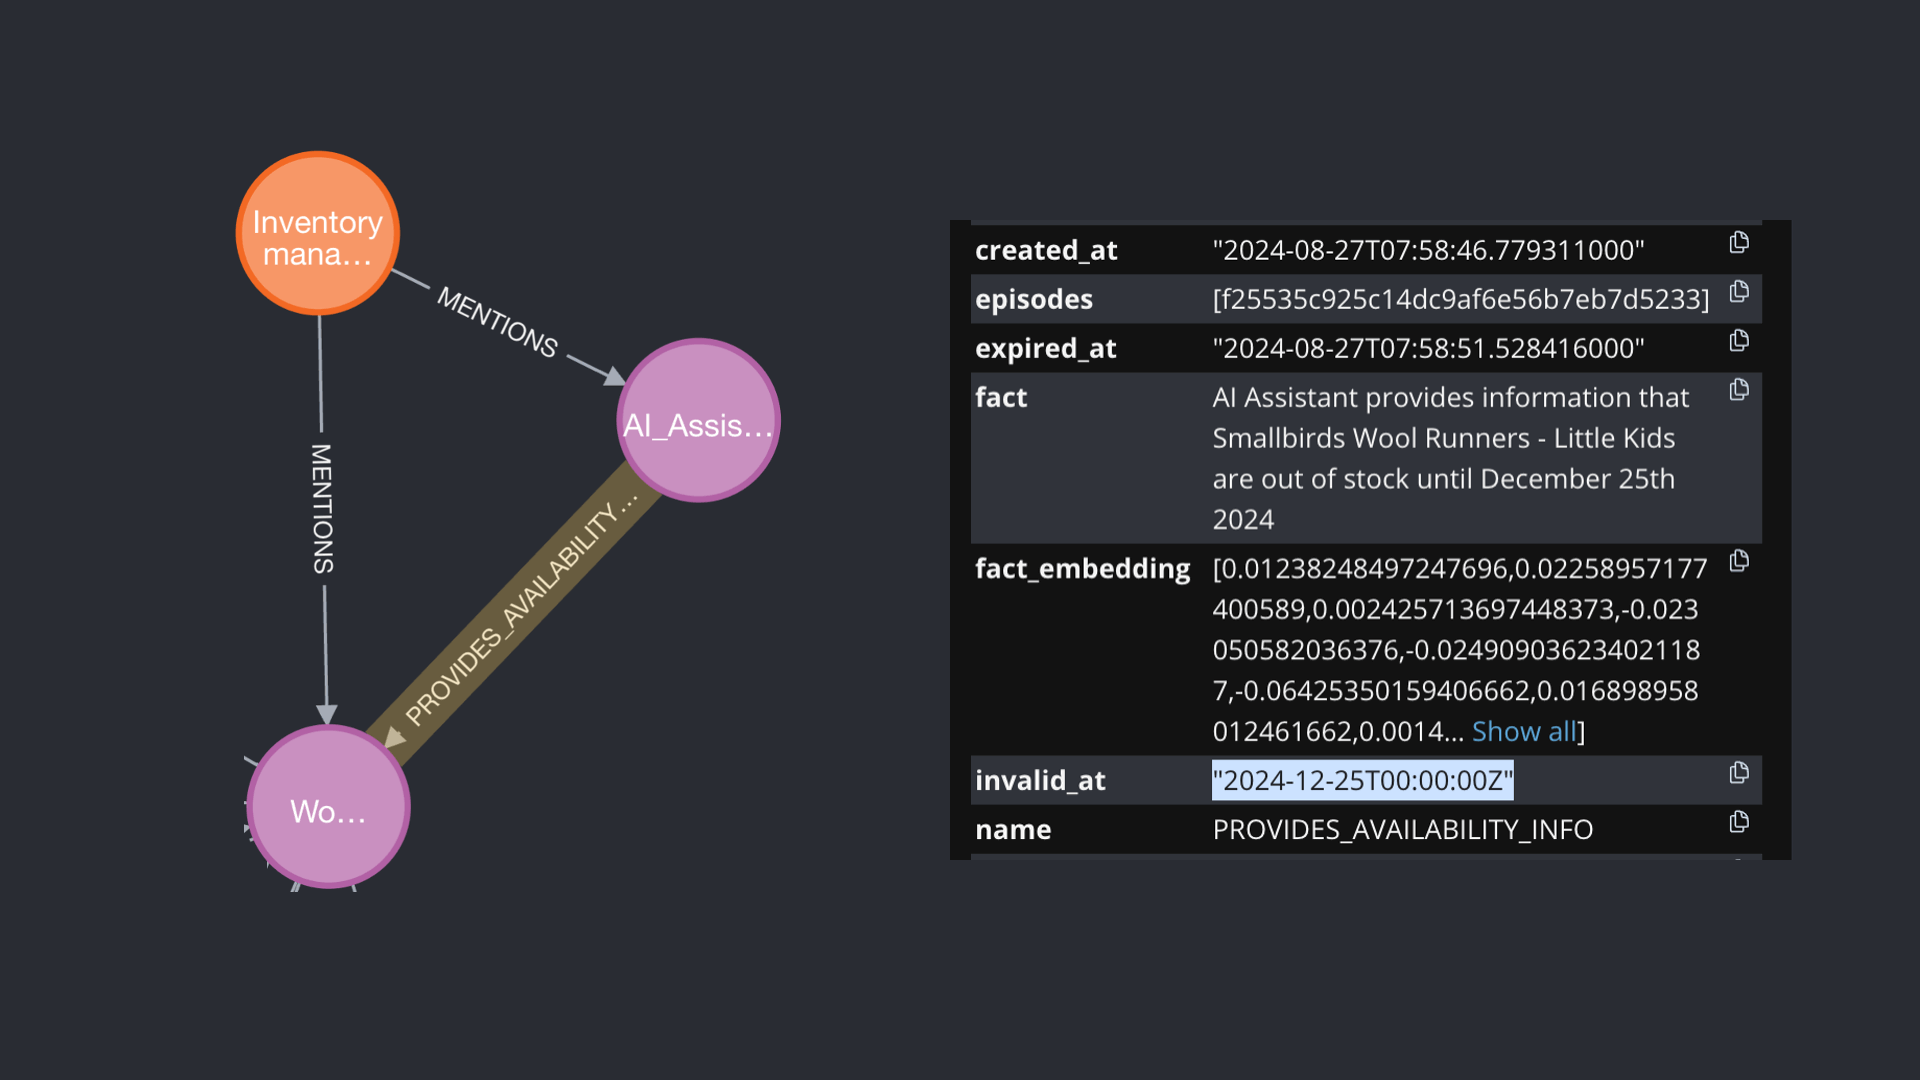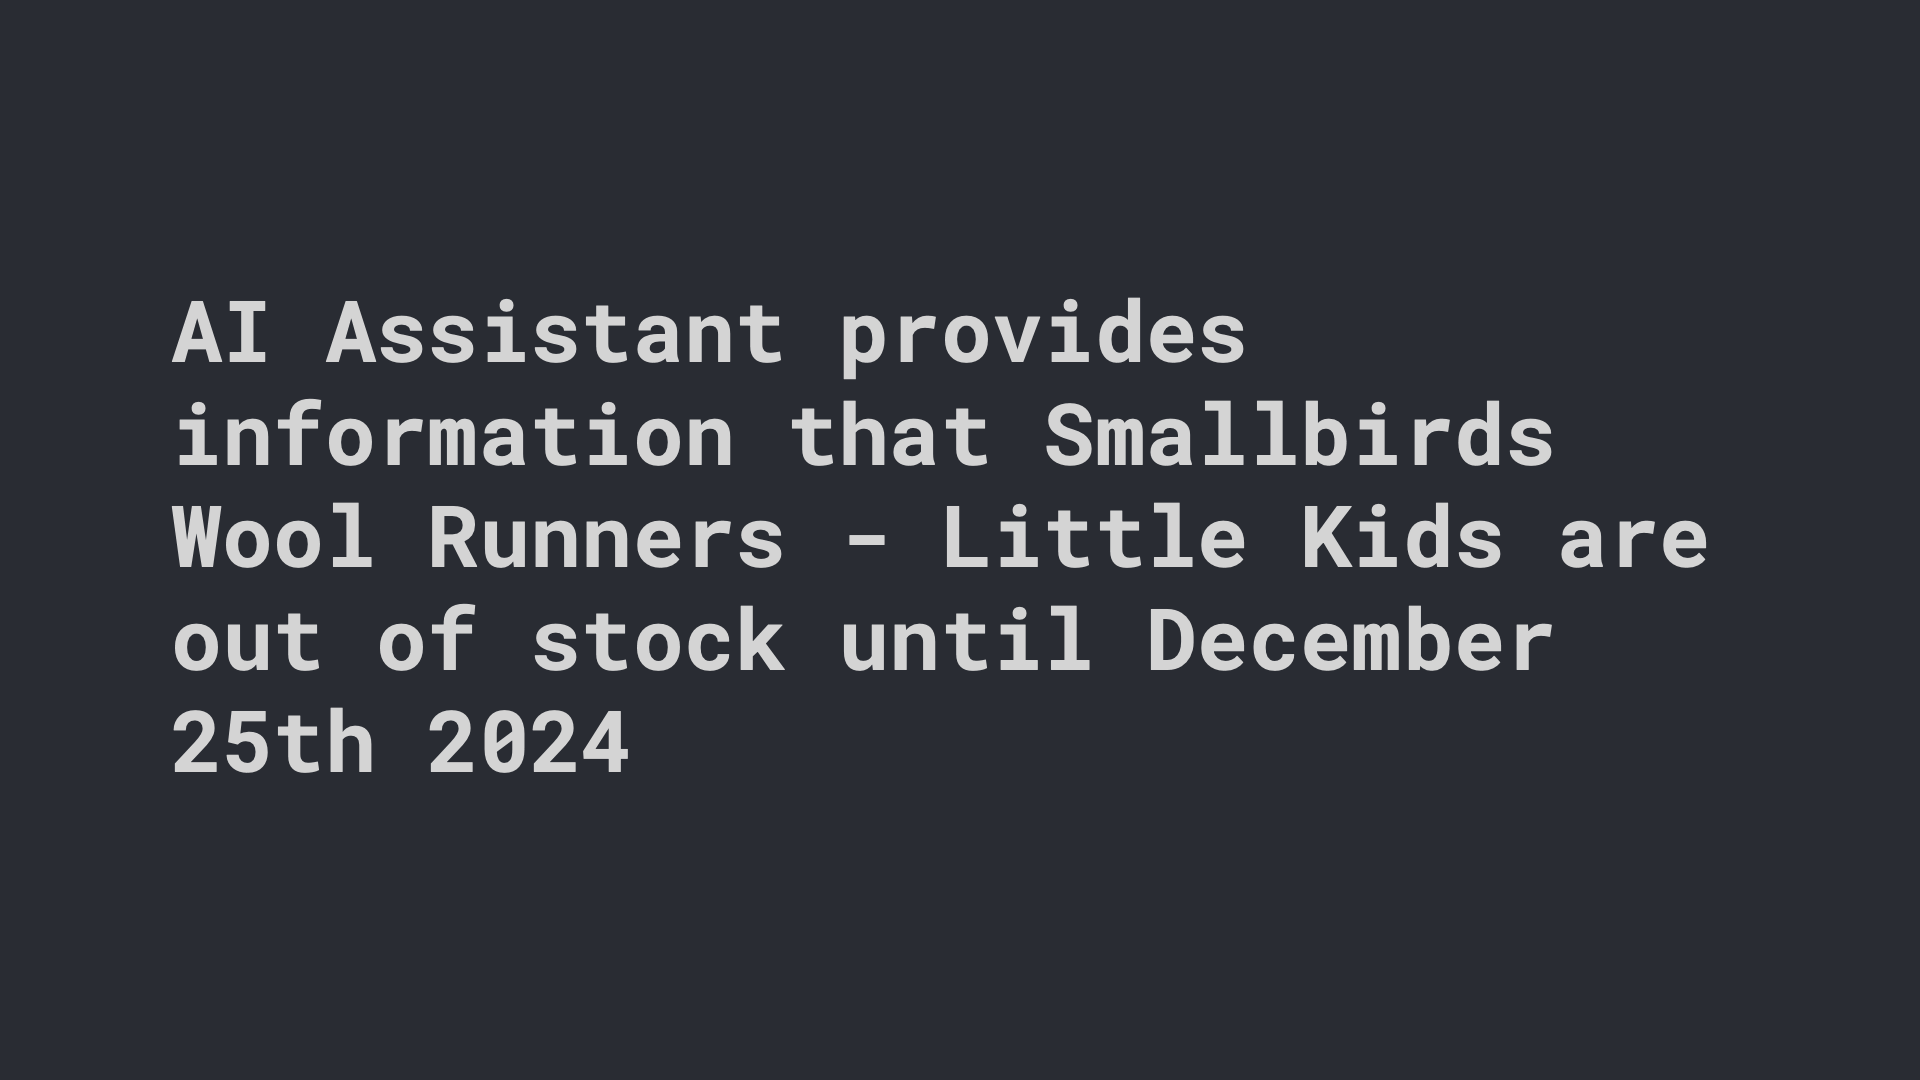
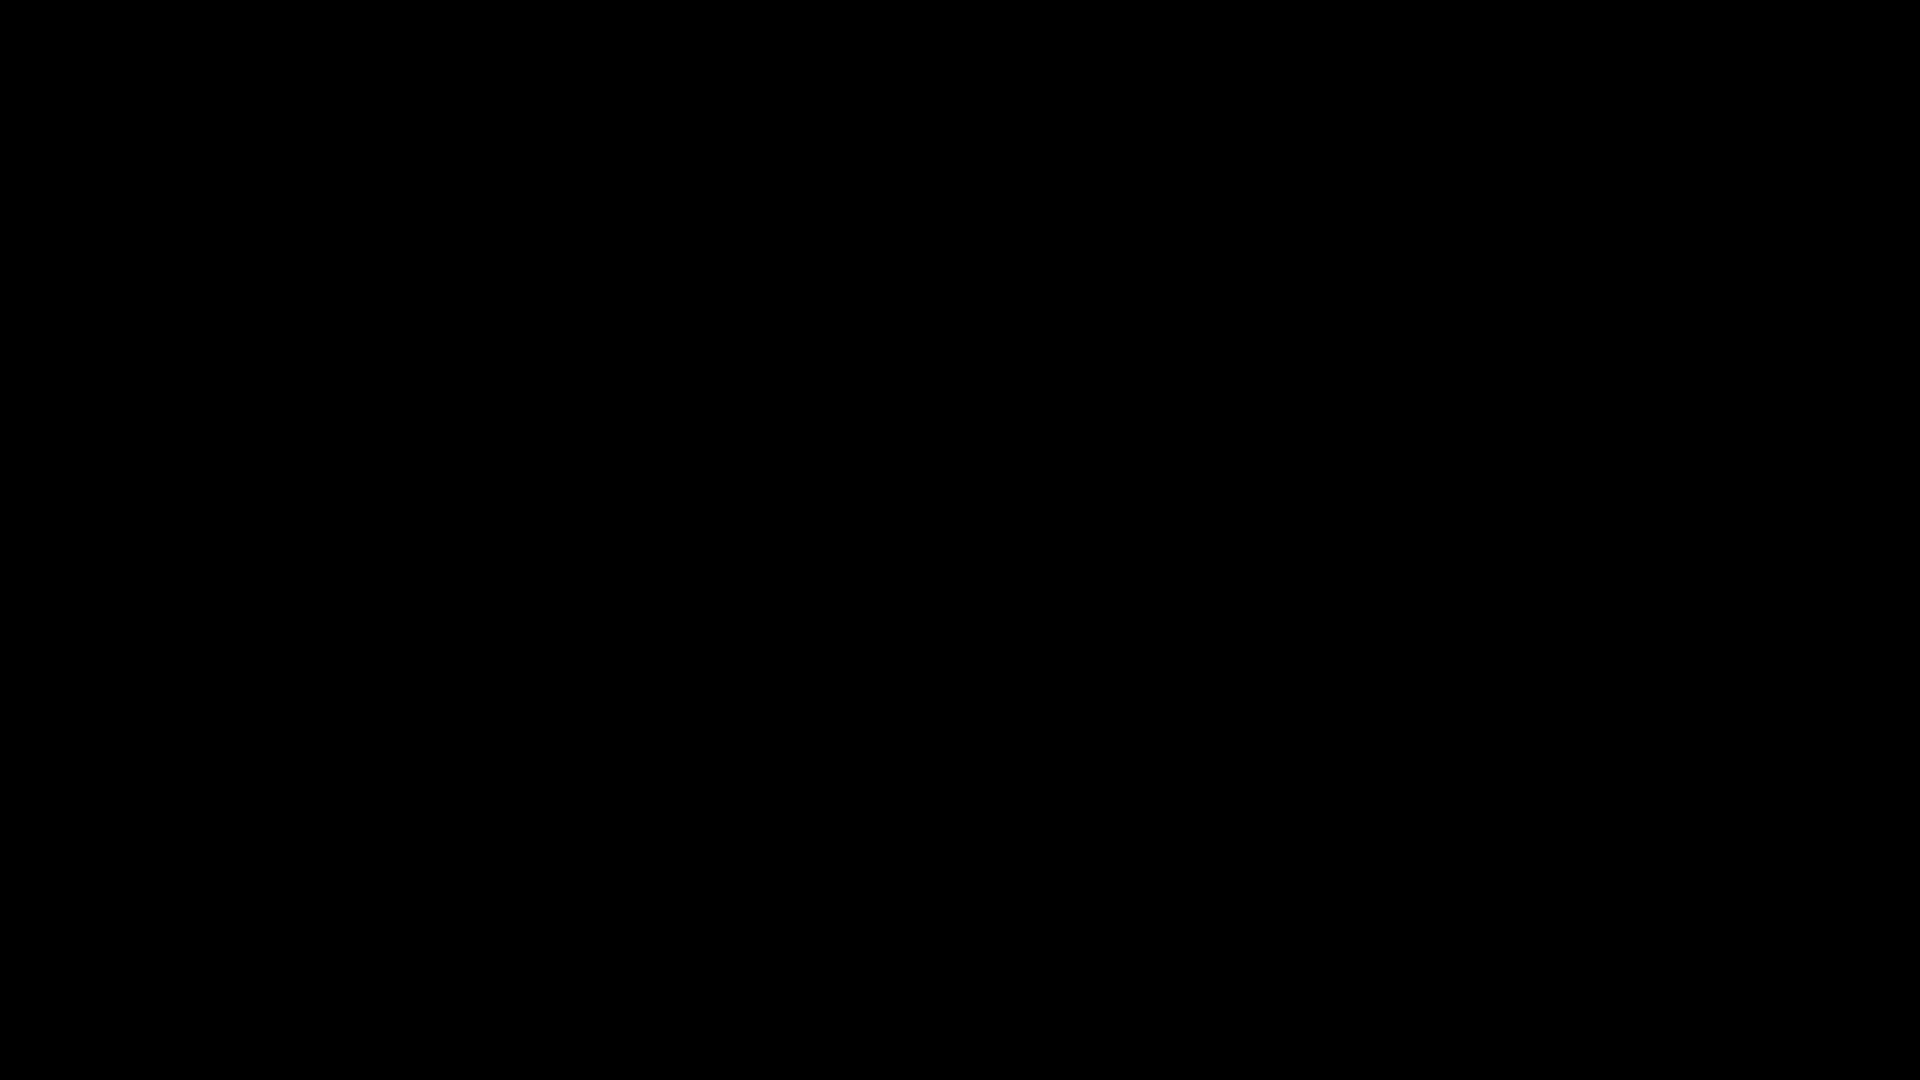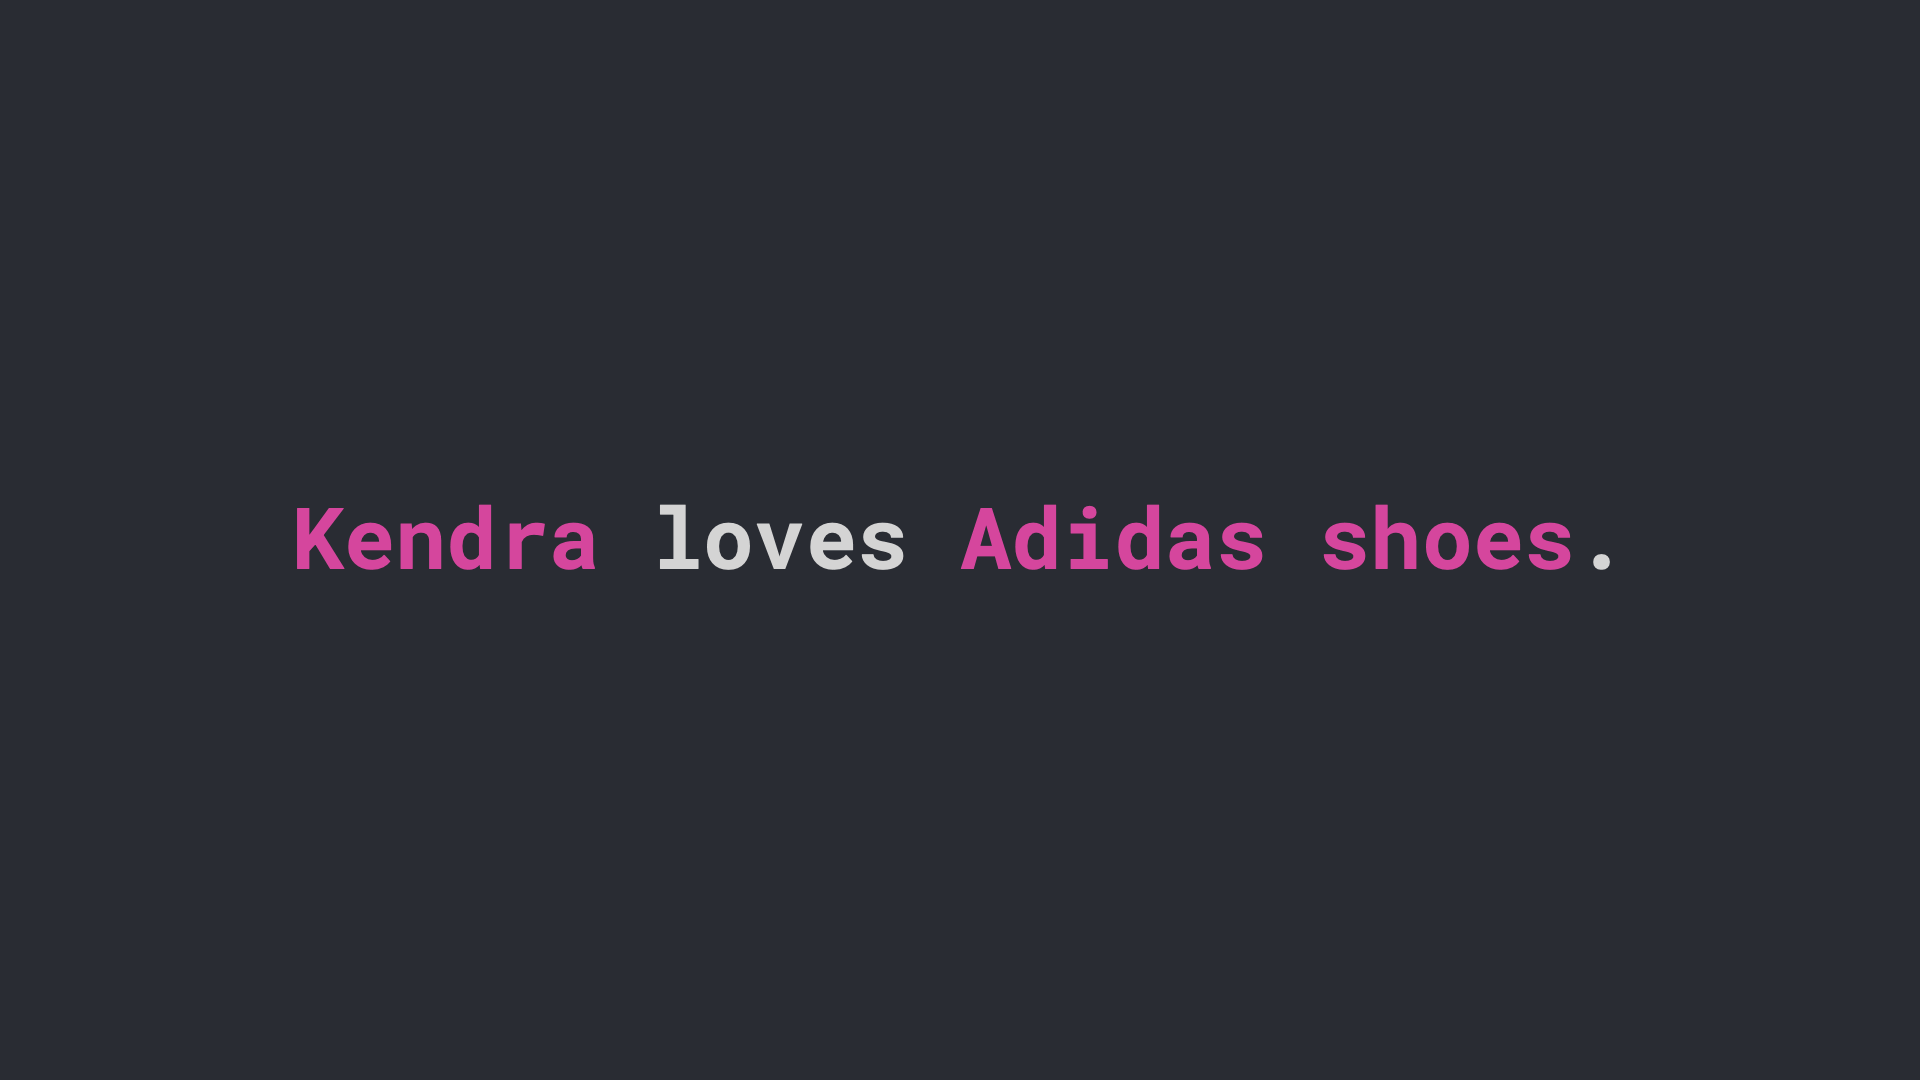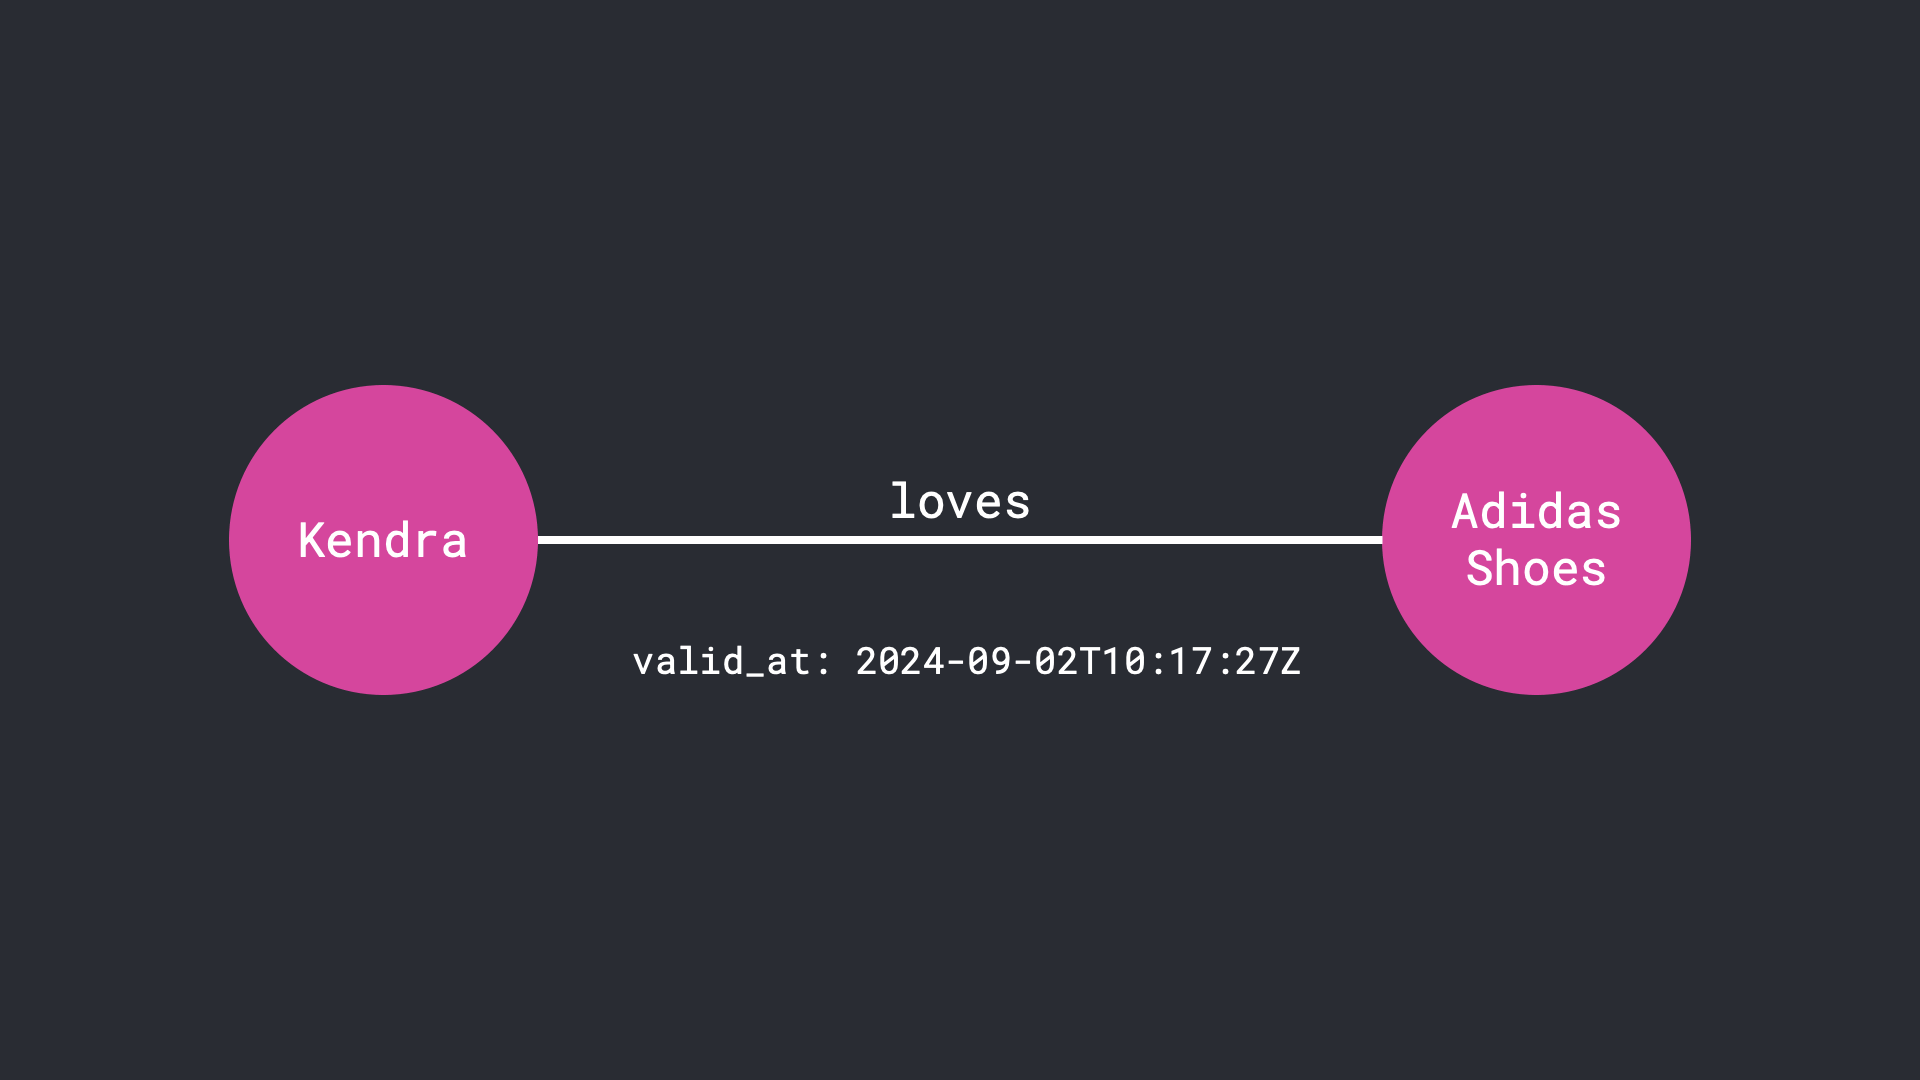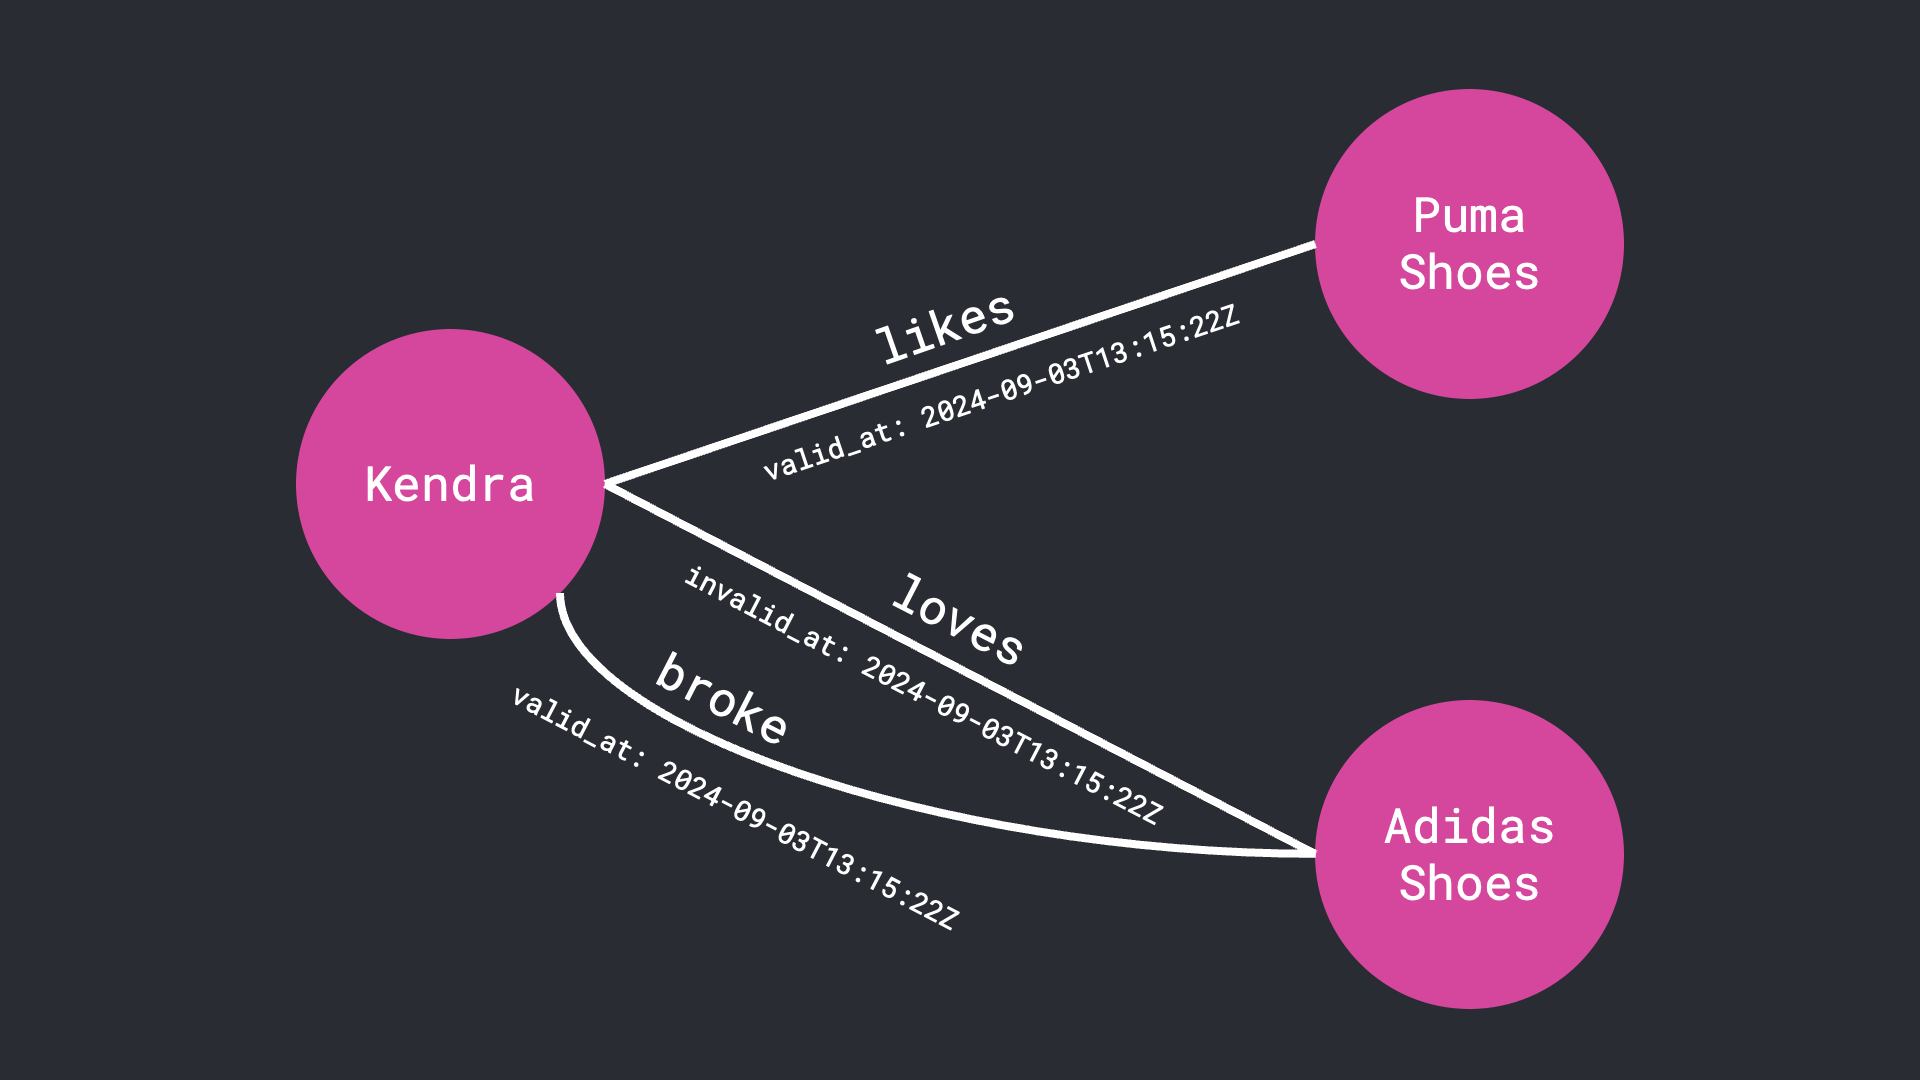 时序知识图谱:实体和关系随时间变化,旧事实自动标记为失效
 支持结构化+非结构化数据的增量摄入
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/getzep/graphiti |
| Star / Fork | 24,076 / 2,385 |
| 代码行数 | 43,798 (Python 100%) |
| 项目年龄 | 19 个月(2024-08 创建) |
| 开发阶段 | 密集开发(月均 42 commits,v0.28.2,v0.30.0 开发中) |
| 贡献模式 | 公司团队主导(3 核心开发者占 81%) |
| 热度定位 | 大众热门(24K Stars,日均 +42) |
| 质量评级 | 代码[良好] 文档[良好] 测试[充分] |
作者视角:为什么存在这个项目
创始人/作者背景
Zep 是一家美国 AI Agent 基础设施创业公司,核心团队包括 Daniel Chalef(联合创始人/CTO,2009 年注册 GitHub)和 Preston Rasmussen(核心开发者,论文一作,数学背景)。公司产品线围绕 “Agent Memory” 展开,Graphiti 是旗舰开源项目(24K Stars),商业化平台 Zep 基于其构建。
问题判断
作者团队在 arXiv 论文中明确指出了现有方案的三个根本缺陷:
- 传统 RAG 依赖批量处理和静态文档摘要,无法反映数据的实时变化
- 知识图谱缺少事实的时间有效性窗口,无法区分”现在为真”与”过去为真”
- 派生事实无法追溯到原始数据来源
核心洞察:Agent 需要的不是”文档检索”,而是”随时间演化的事实图谱”。
解法哲学
- 图优先而非向量优先:图结构天然支持关系推理和多跳遍历,但不放弃向量——混合搜索是最终方案
- 增量而非批处理:每次
add_episode只处理一条新数据,通过 episode window 提供上下文,自动做实体解析和矛盾检测 - 双时序是核心:
valid_at/invalid_at(事实何时为真)+created_at/expired_at(数据库何时记录),让系统能回答”X 什么时候是真的” - 多后端抽象:不绑定特定图数据库或 LLM 供应商
战略意图
开放核心商业模式:
- 开源 Graphiti(Apache-2.0)作为引擎核心,吸引开发者生态
- 商业化 Zep 平台提供多租户管理、仪表盘、SLA 等企业功能
- PostHog 遥测追踪开源用户使用模式,指导商业化方向
- Neo4j、FalkorDB 官方博客合作扩大生态影响力
核心价值提炼
创新之处
-
双时序(Bi-temporal)数据模型(新颖度 5/5 | 实用性 4/5 | 可迁移性 4/5)
- EntityEdge 上的
valid_at/invalid_at+created_at/expired_at - 提取 prompt 要求 LLM 从文本解析时间表达式
- 矛盾检测 prompt 识别新事实何时使旧事实失效
- 搜索支持时间过滤
- EntityEdge 上的
-
Episode-based 增量知识构建管线(新颖度 4/5 | 实用性 5/5 | 可迁移性 4/5)
- Episode 输入 → 检索上下文 → LLM 提取 Entities → 实体去重/解析 → LLM 提取 Edges/Facts → 边去重/矛盾检测 → 写入图数据库
- 通过 episode window(最近 N 条)提供上下文,无需全图重算
-
多策略混合搜索 + 可插拔重排(新颖度 3/5 | 实用性 5/5 | 可迁移性 5/5)
- 3 种检索(cosine_similarity / BM25 / BFS 图遍历)× 5 种重排(RRF / MMR / CrossEncoder / node_distance / episode_mentions)
- 15+ 种预置搜索配方,Pydantic 声明式配置
-
Saga 机制(有序 Episode 链)(新颖度 3/5 | 实用性 4/5 | 可迁移性 3/5)
- v0.28+ 新增:SagaNode → EpisodicNode → NEXT_EPISODE 链
- 同一对话线程的 Episode 形成有序链,支持高效时序查询
-
图社区检测 + LLM 层次化摘要(新颖度 3/5 | 实用性 4/5 | 可迁移性 4/5)
- Label Propagation 算法检测社区
- LLM 对社区内实体做 pairwise summarization,生成 CommunityNode
可复用的模式与技巧
- ABC + Operations 接口多后端抽象:GraphDriver 定义统一接口,4 个后端各自实现 12 个 operations 文件的对称结构
- Pydantic 声明式搜索配置 + Recipes:SearchConfig 模型 + 15+ 预置配方,开发者无需理解底层
- LLM 统一客户端 + 结构化输出:tenacity 指数退避、可选缓存、Token 追踪、OpenTelemetry 集成
- Prompt Protocol + TypedDict 版本化:每个 prompt 模块实现 Protocol + TypedDict,通过 prompt_library 统一访问
- RRF/MMR 混合重排:多路检索结果融合的通用工具
- Union-Find 实体解析:批量去重中的传递性合并算法
- semaphore_gather 并发控制:限制并发的异步批处理工具
关键设计决策
-
Episode 作为数据摄入的原子单位
- Trade-off:增量处理避免了全图重算的开销,但每次 episode 都需要多次 LLM 调用(提取+去重+矛盾检测),成本不低
-
4 种图数据库的对称抽象
- Trade-off:最大化用户选择,但 Kuzu 需要 RelatesToNode_ 变通(嵌入式图数据库不支持边属性),增加维护成本
-
PostHog 遥测默认启用
- Trade-off:帮助团队了解使用模式指导商业化,但可能引起隐私顾虑
竞品格局与定位
竞品对比矩阵
| 维度 | Graphiti | mem0 (50K★) | GraphRAG (31K★) | MemGPT/Letta (21K★) |
|---|---|---|---|---|
| 核心结构 | 时序知识图谱 | 向量存储+可选图谱 | 社区摘要图(静态) | 对话状态管理 |
| 数据更新 | 增量(单 episode) | 增量 | 批处理(全图重算) | 实时对话 |
| 时间感知 | 原生双时序 | 无 | 无 | 无 |
| 检索方式 | 混合 3 路 + 5 种重排 | 向量相似度 | LLM 摘要链 | 上下文窗口 |
| 图数据库 | 4 后端 | 可选 Neo4j | NetworkX(内存) | 无 |
| License | Apache-2.0 | Apache-2.0 | MIT | Apache-2.0 |
| 适用场景 | Agent 长期记忆 | 用户画像 | 文档问答 | 对话 Agent |
差异化护城河
双时序数据模型是核心技术护城河——目前没有任何竞品实现了事实级别的时间有效性追踪。论文级学术背书(arXiv + 多次被引)和 Neo4j/FalkorDB 官方合作构成生态护城河。
竞争风险
mem0(50K Stars)在更广泛的 Agent Memory 市场占据优势,如果其图谱功能从 Pro 层级下放到开源版本,将直接威胁 Graphiti。此外,GraphRAG 如果加入增量更新能力,也会蚕食 Graphiti 的场景。
生态定位
时序知识图谱用于 Agent Memory 这一精确技术赛道的开源领导者。与 mem0(向量优先)和 MemGPT(对话状态优先)形成差异化定位,实际上三者可以互补——Graphiti 管知识层,MemGPT 管对话层,mem0 管用户画像层。
套利机会分析
- 信息差: 24K Stars 但实际深度使用者可能不多(LLM 调用成本是门槛),技术深度被 Stars 数充分反映
- 技术借鉴: 双时序数据模型、Episode-based 增量管线、混合搜索配方系统、多后端抽象层——这些模式可迁移到任何知识图谱或 RAG 系统
- 生态位: 精确填补了”时序感知的 Agent 记忆”空白,在 GraphRAG(静态批处理)和 mem0(向量优先)之间开辟了独特赛道
- 趋势判断: 日均 +42 Stars 且增长持续,Agent Memory 是 2025-2026 的热门赛道,MCP 协议集成进一步扩展触达
风险与不足
- 开发集中度过高:3 核心开发者占 81% 提交,社区外部贡献极少
- LLM 调用成本:每次 episode 需要多次 LLM 调用(提取+去重+矛盾检测),运营成本不低
- 本地 LLM 支持不成熟:Ollama 等本地模型的结构化输出兼容性是反复出现的痛点
- Label Propagation 潜在死循环:
while True无最大迭代限制(Issue #402) - PostHog 遥测默认启用:可能引起隐私顾虑
- 竞争压力:mem0(50K Stars)和 GraphRAG(31K Stars)在更广泛市场有更强品牌
行动建议
- 如果你要用它: 适合需要”事实级时序追踪”的 Agent 场景(如客服记住用户偏好变化、投研追踪公司动态)。纯文档问答选 GraphRAG,简单用户画像选 mem0。注意 LLM 调用成本
- 如果你要学它: 重点关注
graphiti_core/graphiti.py(add_episode 管线)、edges.py(双时序模型)、search/search_config.py(混合搜索配置)、driver/driver.py(多后端抽象)、prompts/(提示词工程模式) - 如果你要 fork 它: (1) 优化本地 LLM 兼容性(结构化输出适配);(2) 修复 Label Propagation 死循环风险;(3) 添加遥测 opt-out 机制;(4) 降低 LLM 调用次数(合并提取+去重步骤)
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | deepwiki.com/getzep/graphiti |
| Zread.ai | zread.ai/getzep/graphiti |
| 关联论文 | Zep: A Temporal Knowledge Graph Architecture for Agent Memory |
| 在线 Demo | 无(需本地部署,商业版 Zep 提供托管服务) |