GitHub 推荐:18 年 45K stars:错误监控事实标准 Sentry 的 8 个可迁移架构
一句话总结
Sentry 是一家把「Issue 当作一等公民」做透的开发者可观测性平台:把错误、trace、replay、profile、log 串在同一条事件流上,从单一规则的 PyCharm 内部脚本演化成 14 年商业 SaaS 头部,今天的整套设计 —— 从二级配置灰度归并到消费者驱动的反压 —— 几乎每一项都能直接迁移到任何规模化 SaaS。
值得关注的理由
- 它是 Error Tracking 行业的事实标准:GitHub、Atlassian、Vercel、Cloudflare、Slack、Microsoft、Disney+、Lyft、Anthropic 都是公开点名客户;Sentry 在开发者心智里约等于「崩溃监控」。
- 架构资产密度极高:3M 行代码(Python + TSX 双核),却沉淀了 8 个高可复用性的设计方案—— DSL 化配置灰度、多 variant 指纹、消费者驱动反压、PendingBuffer 分桶等,适合任何规模化 SaaS 借鉴。
- 从单点工具到全栈平台的演化范本:14 年间从「合并重复崩溃的 Issue 跟踪器」升格为「Error + APM + Replay + Logs + Seer AI + Uptime + Build Distribution」全栈可观测性平台,是观察单点失措 → 产品矩阵化的最佳活样本。
项目展示
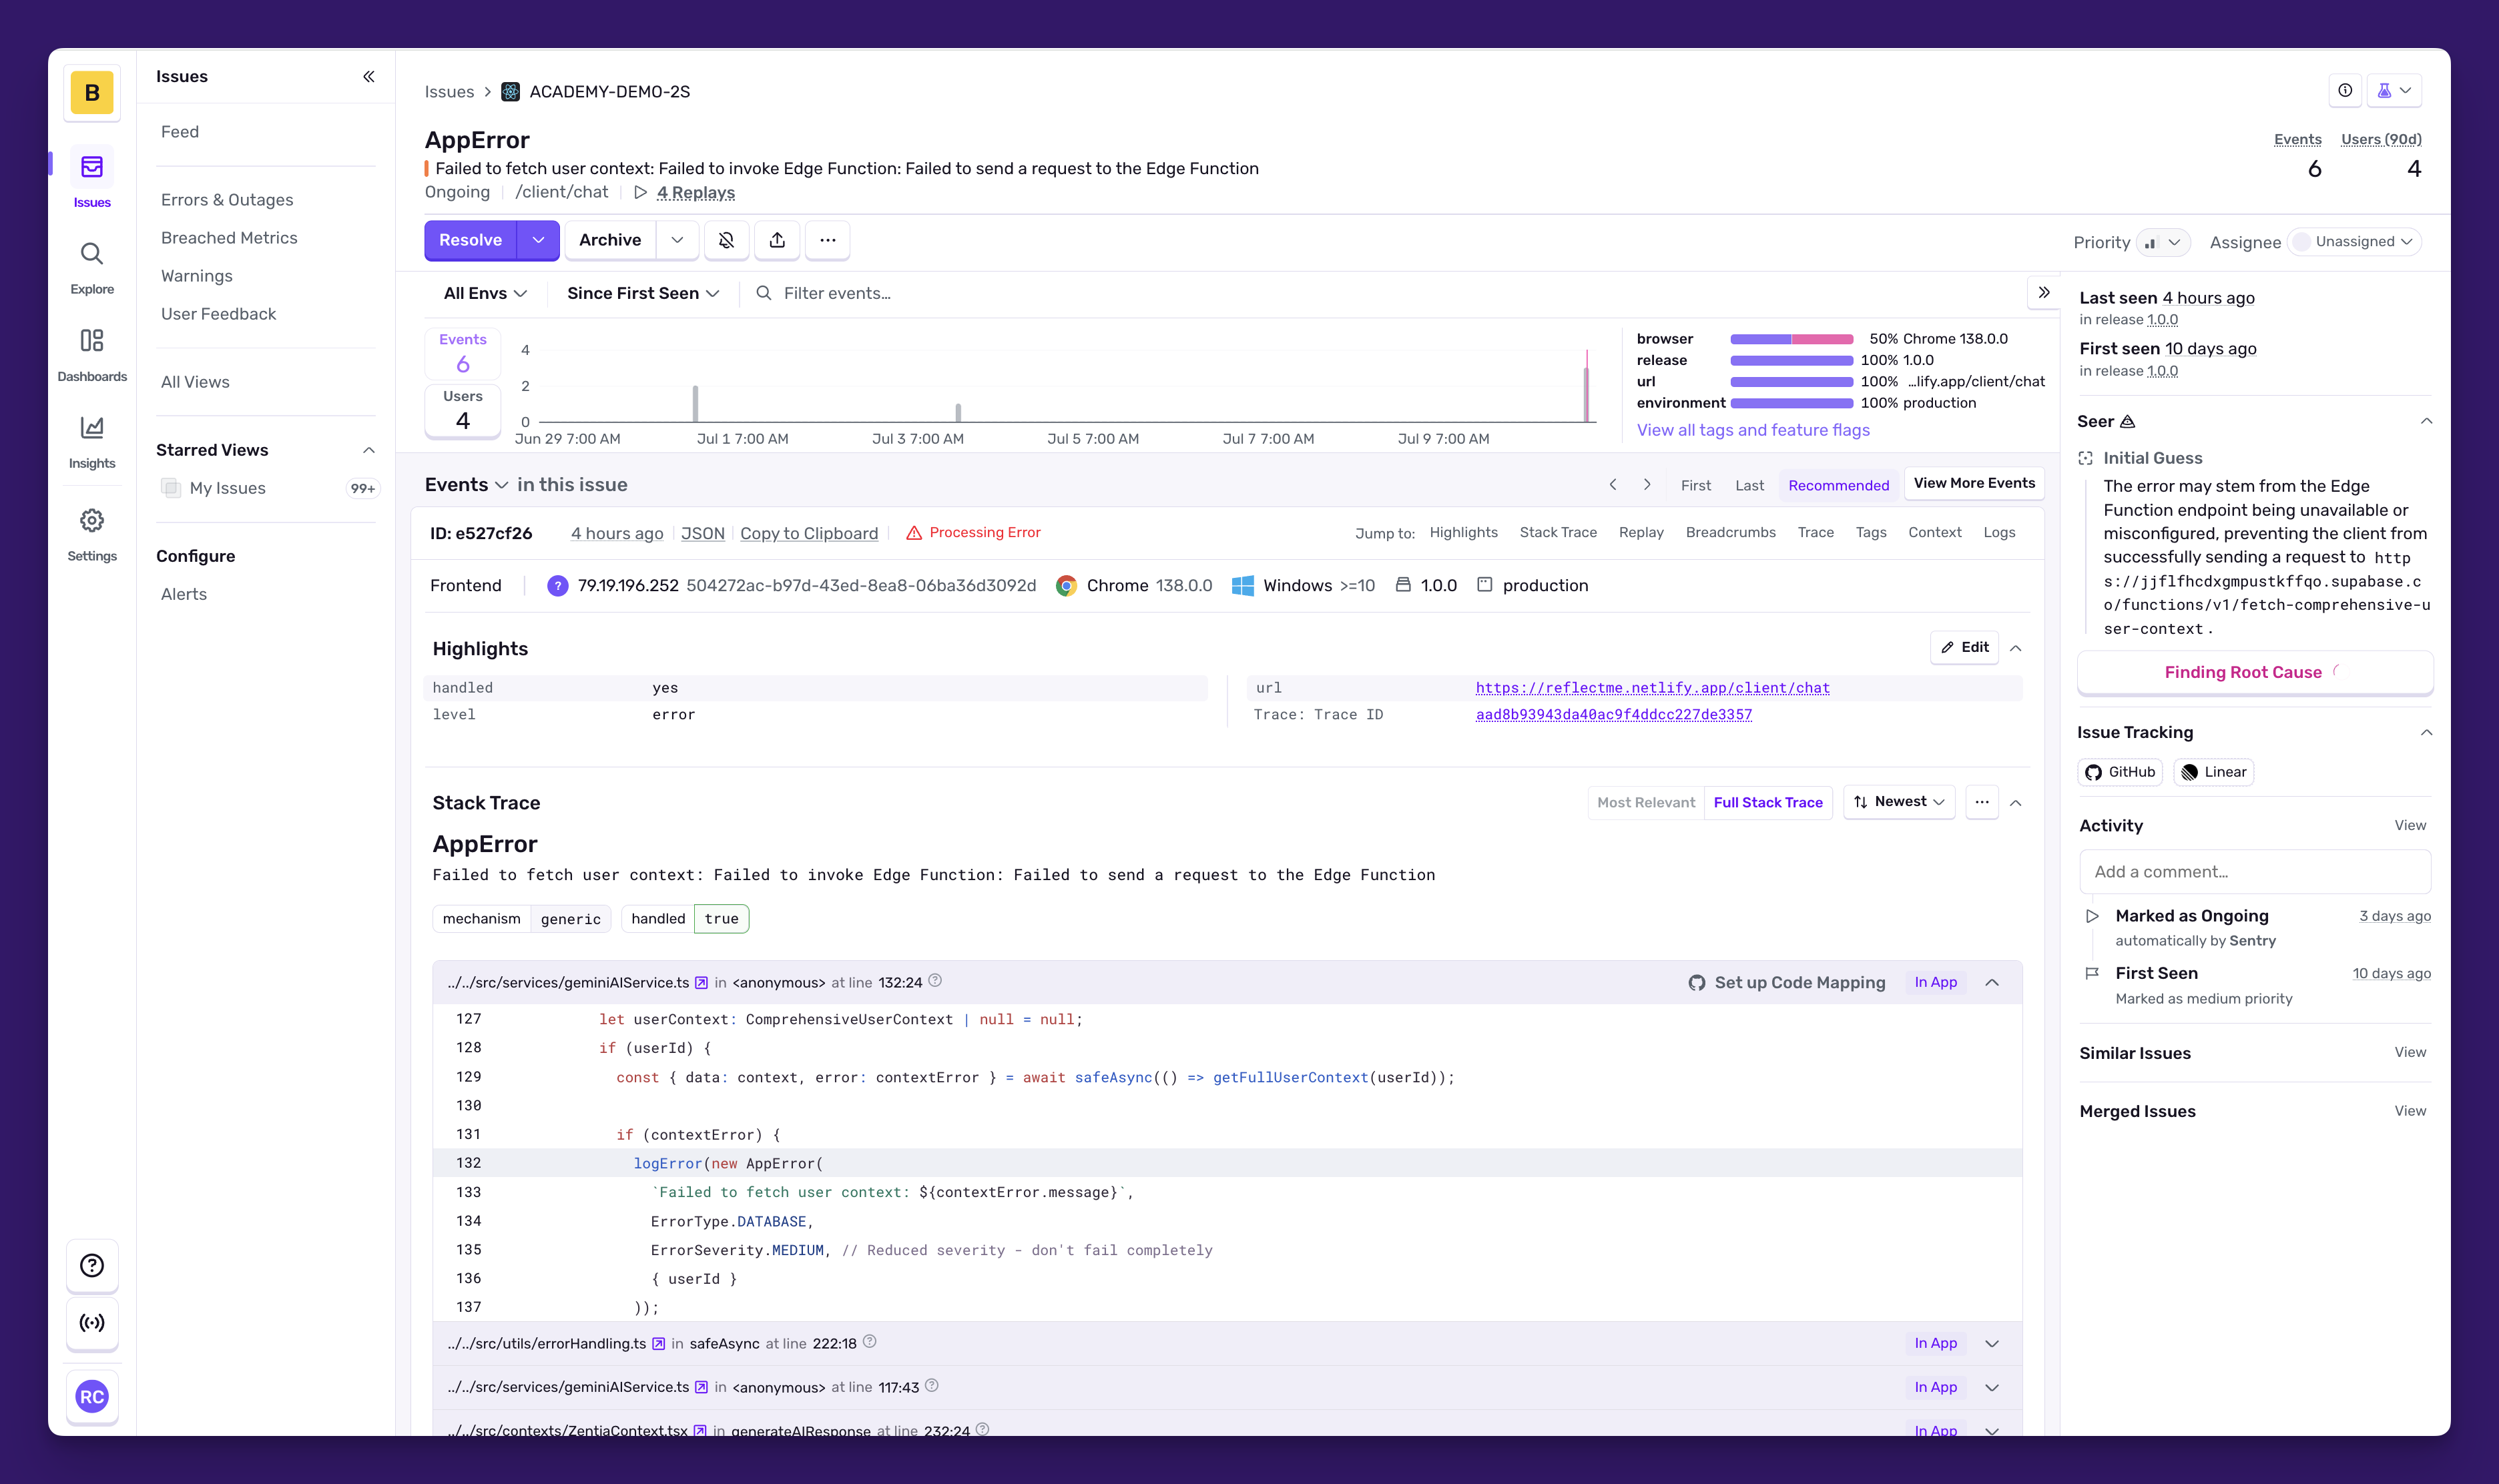
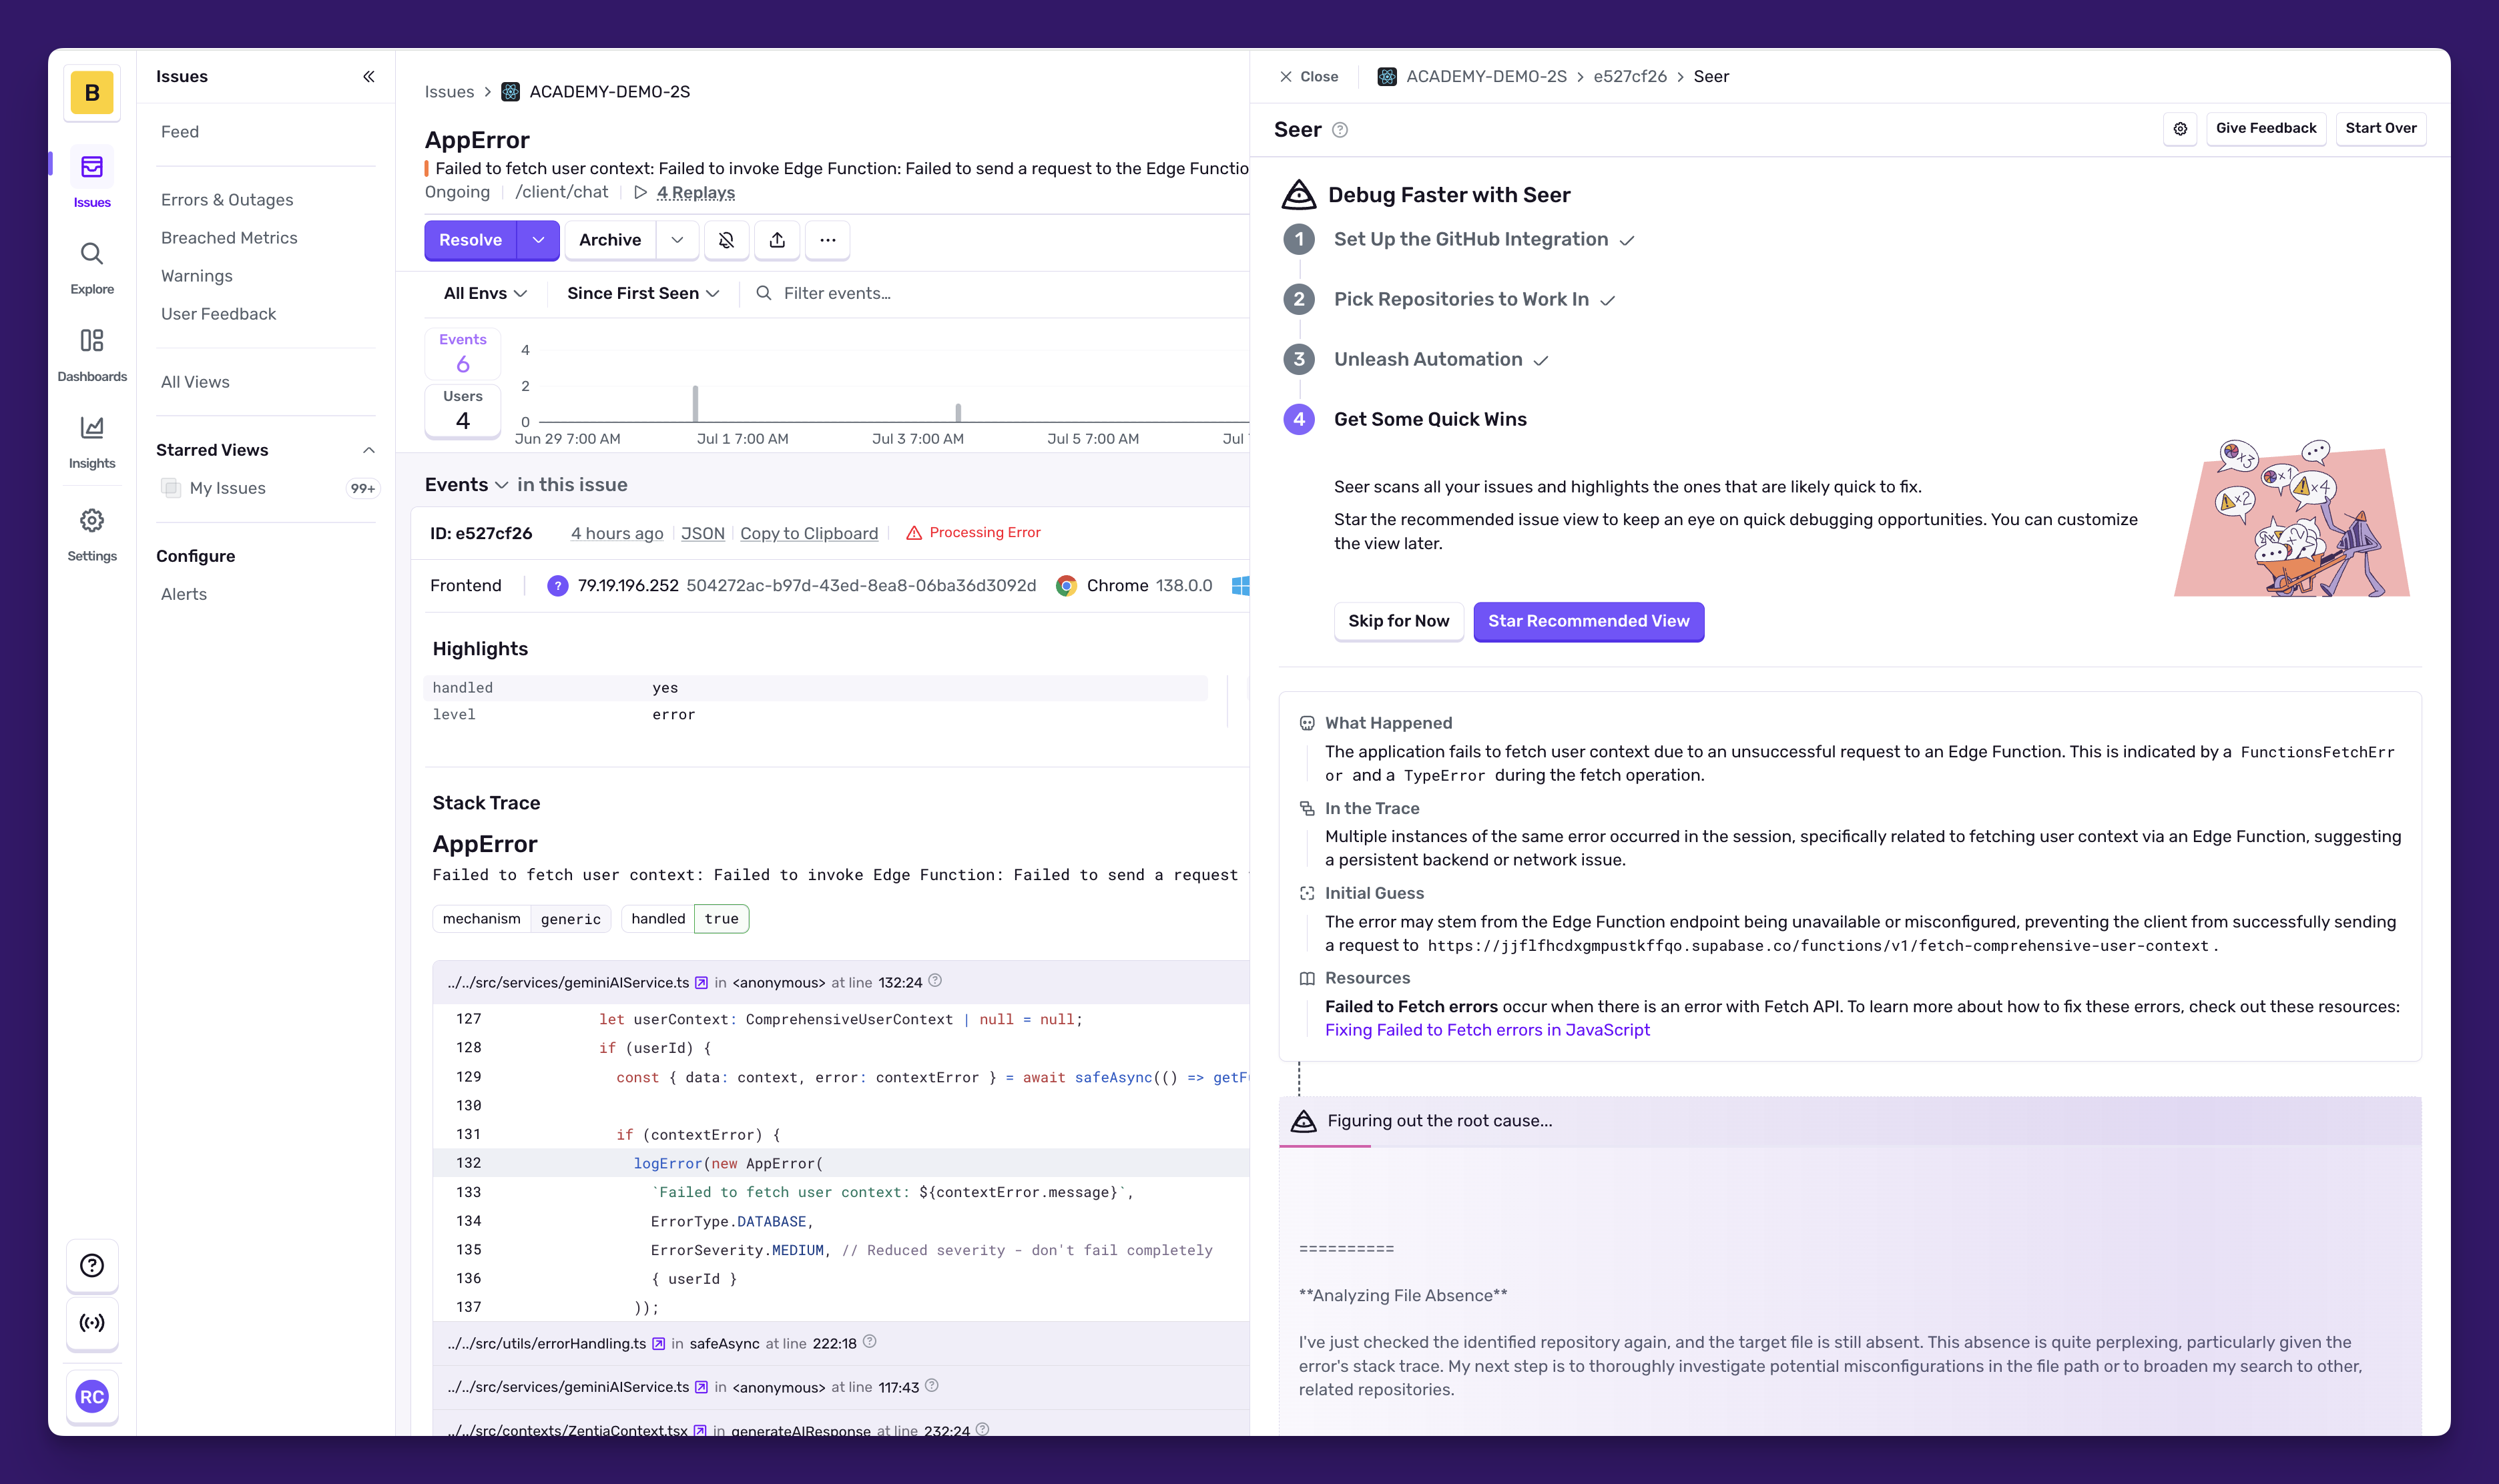
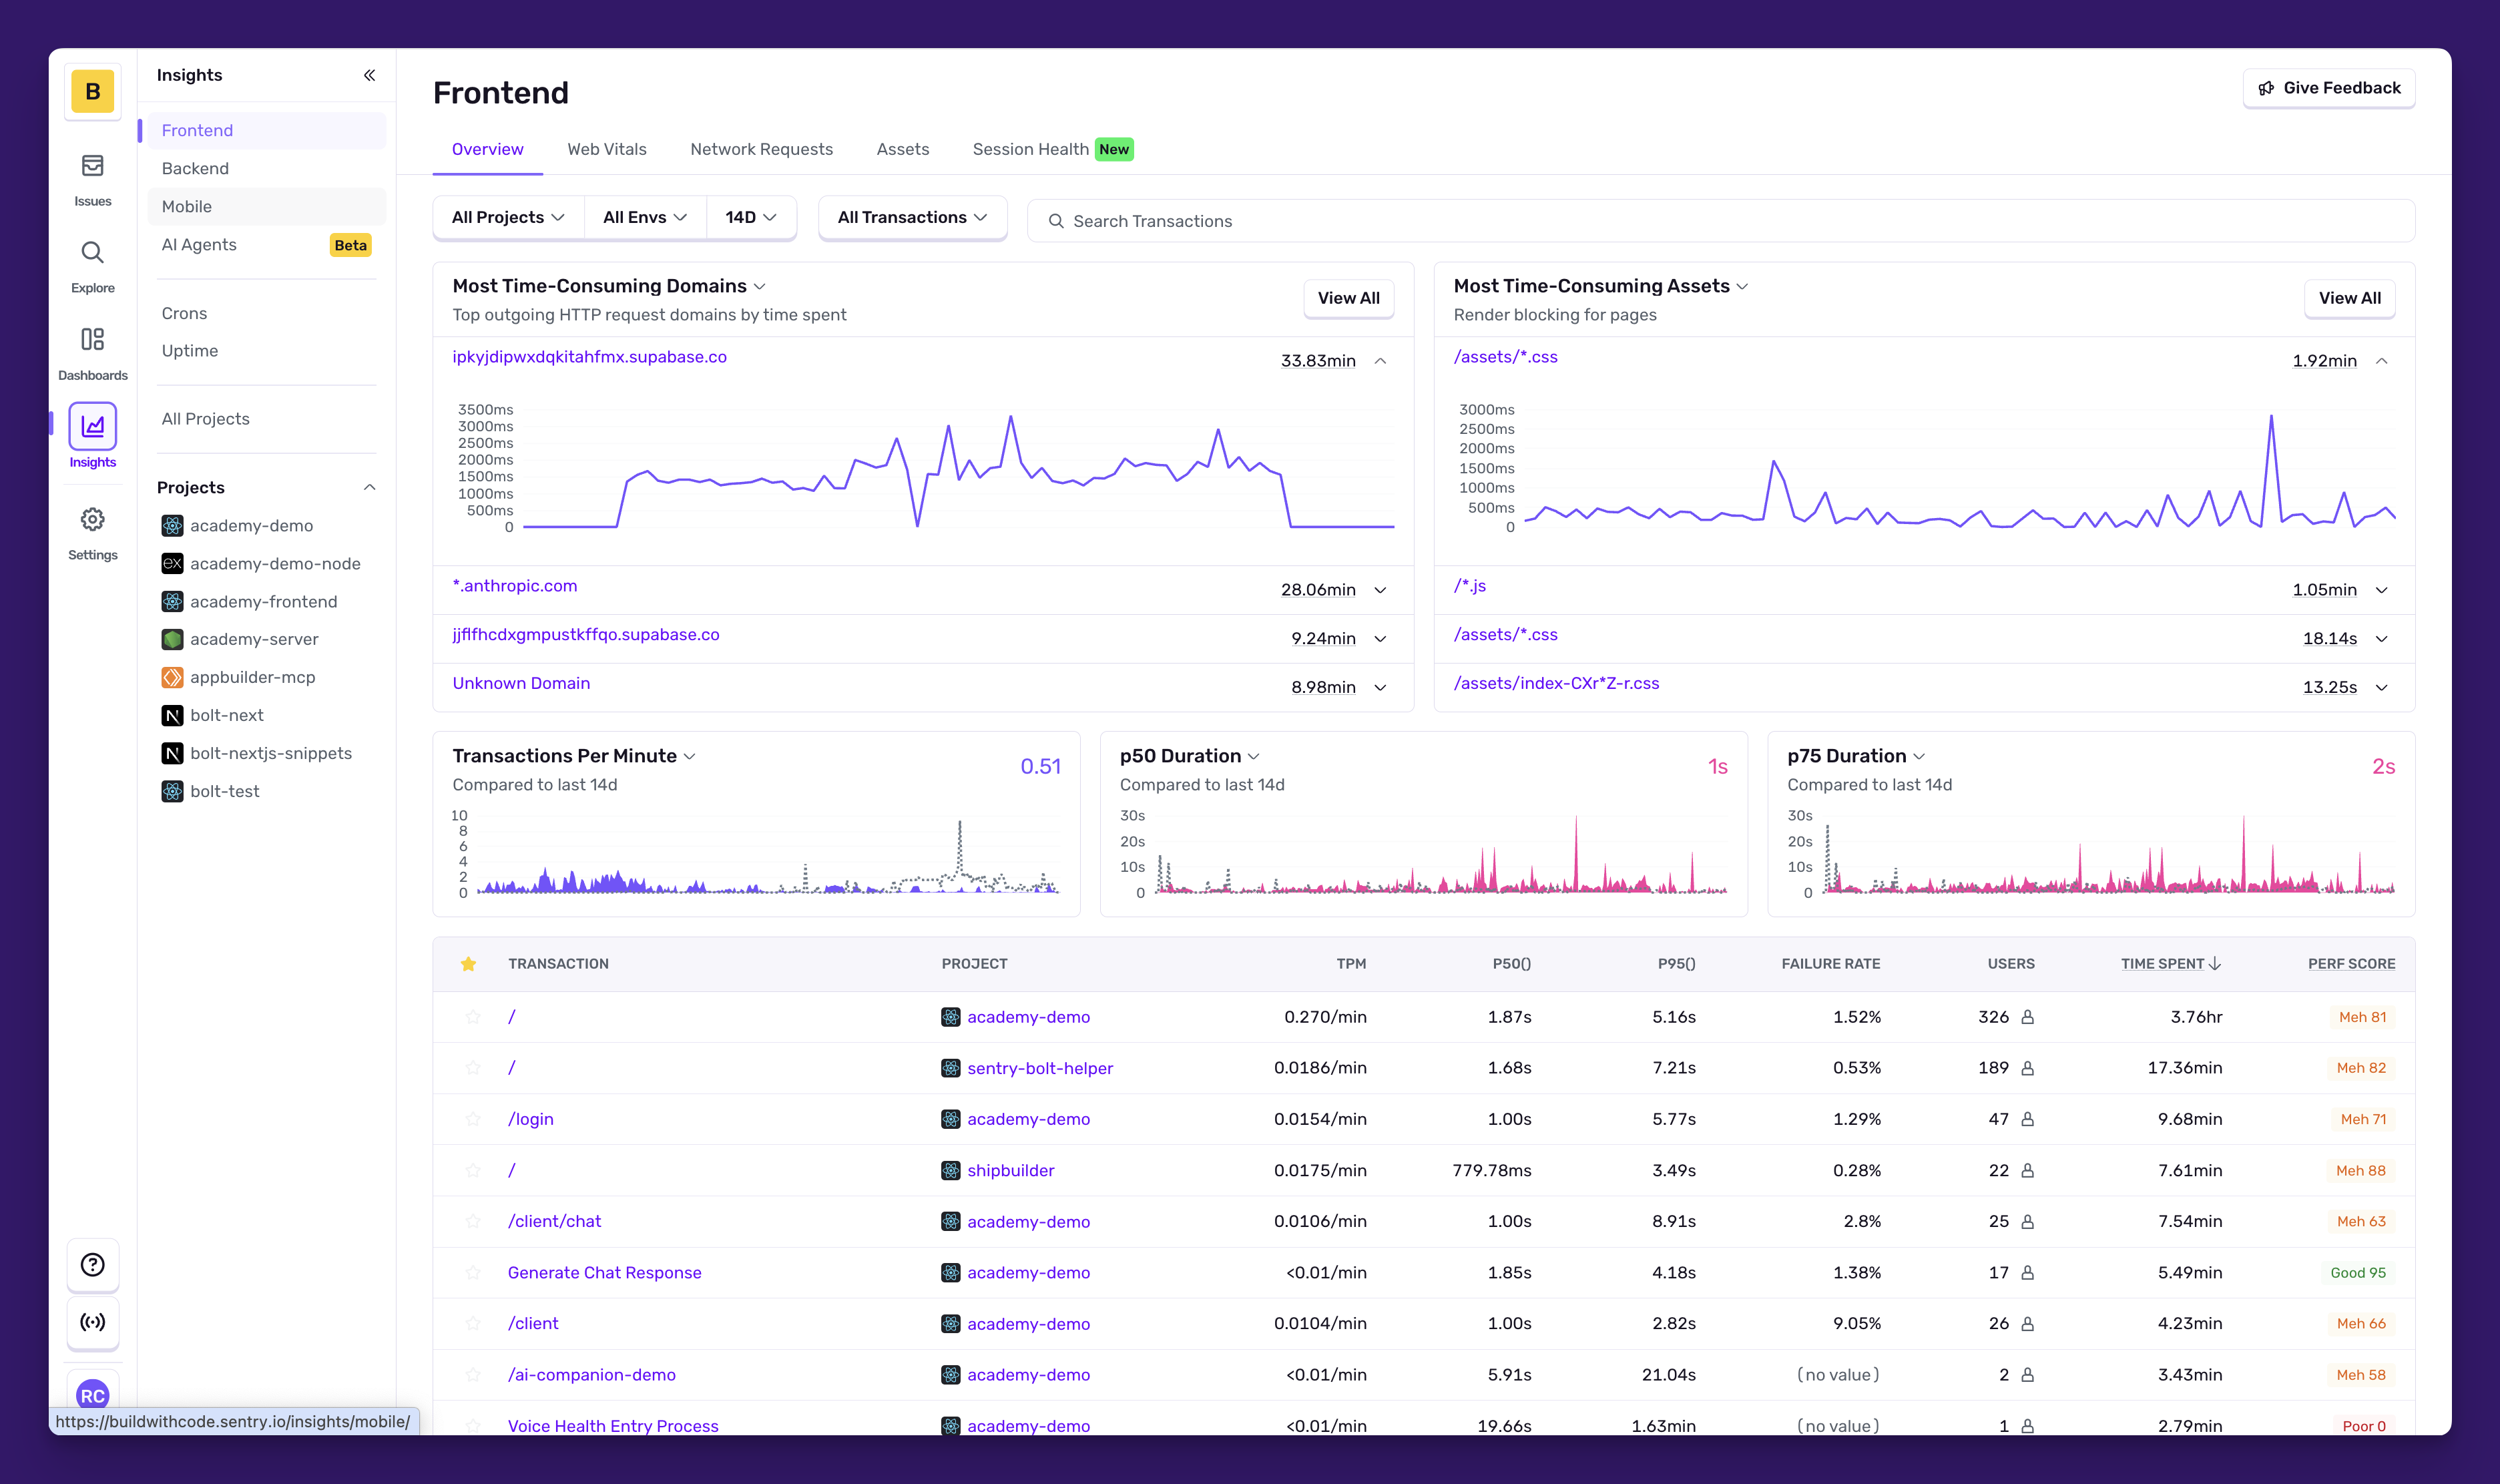
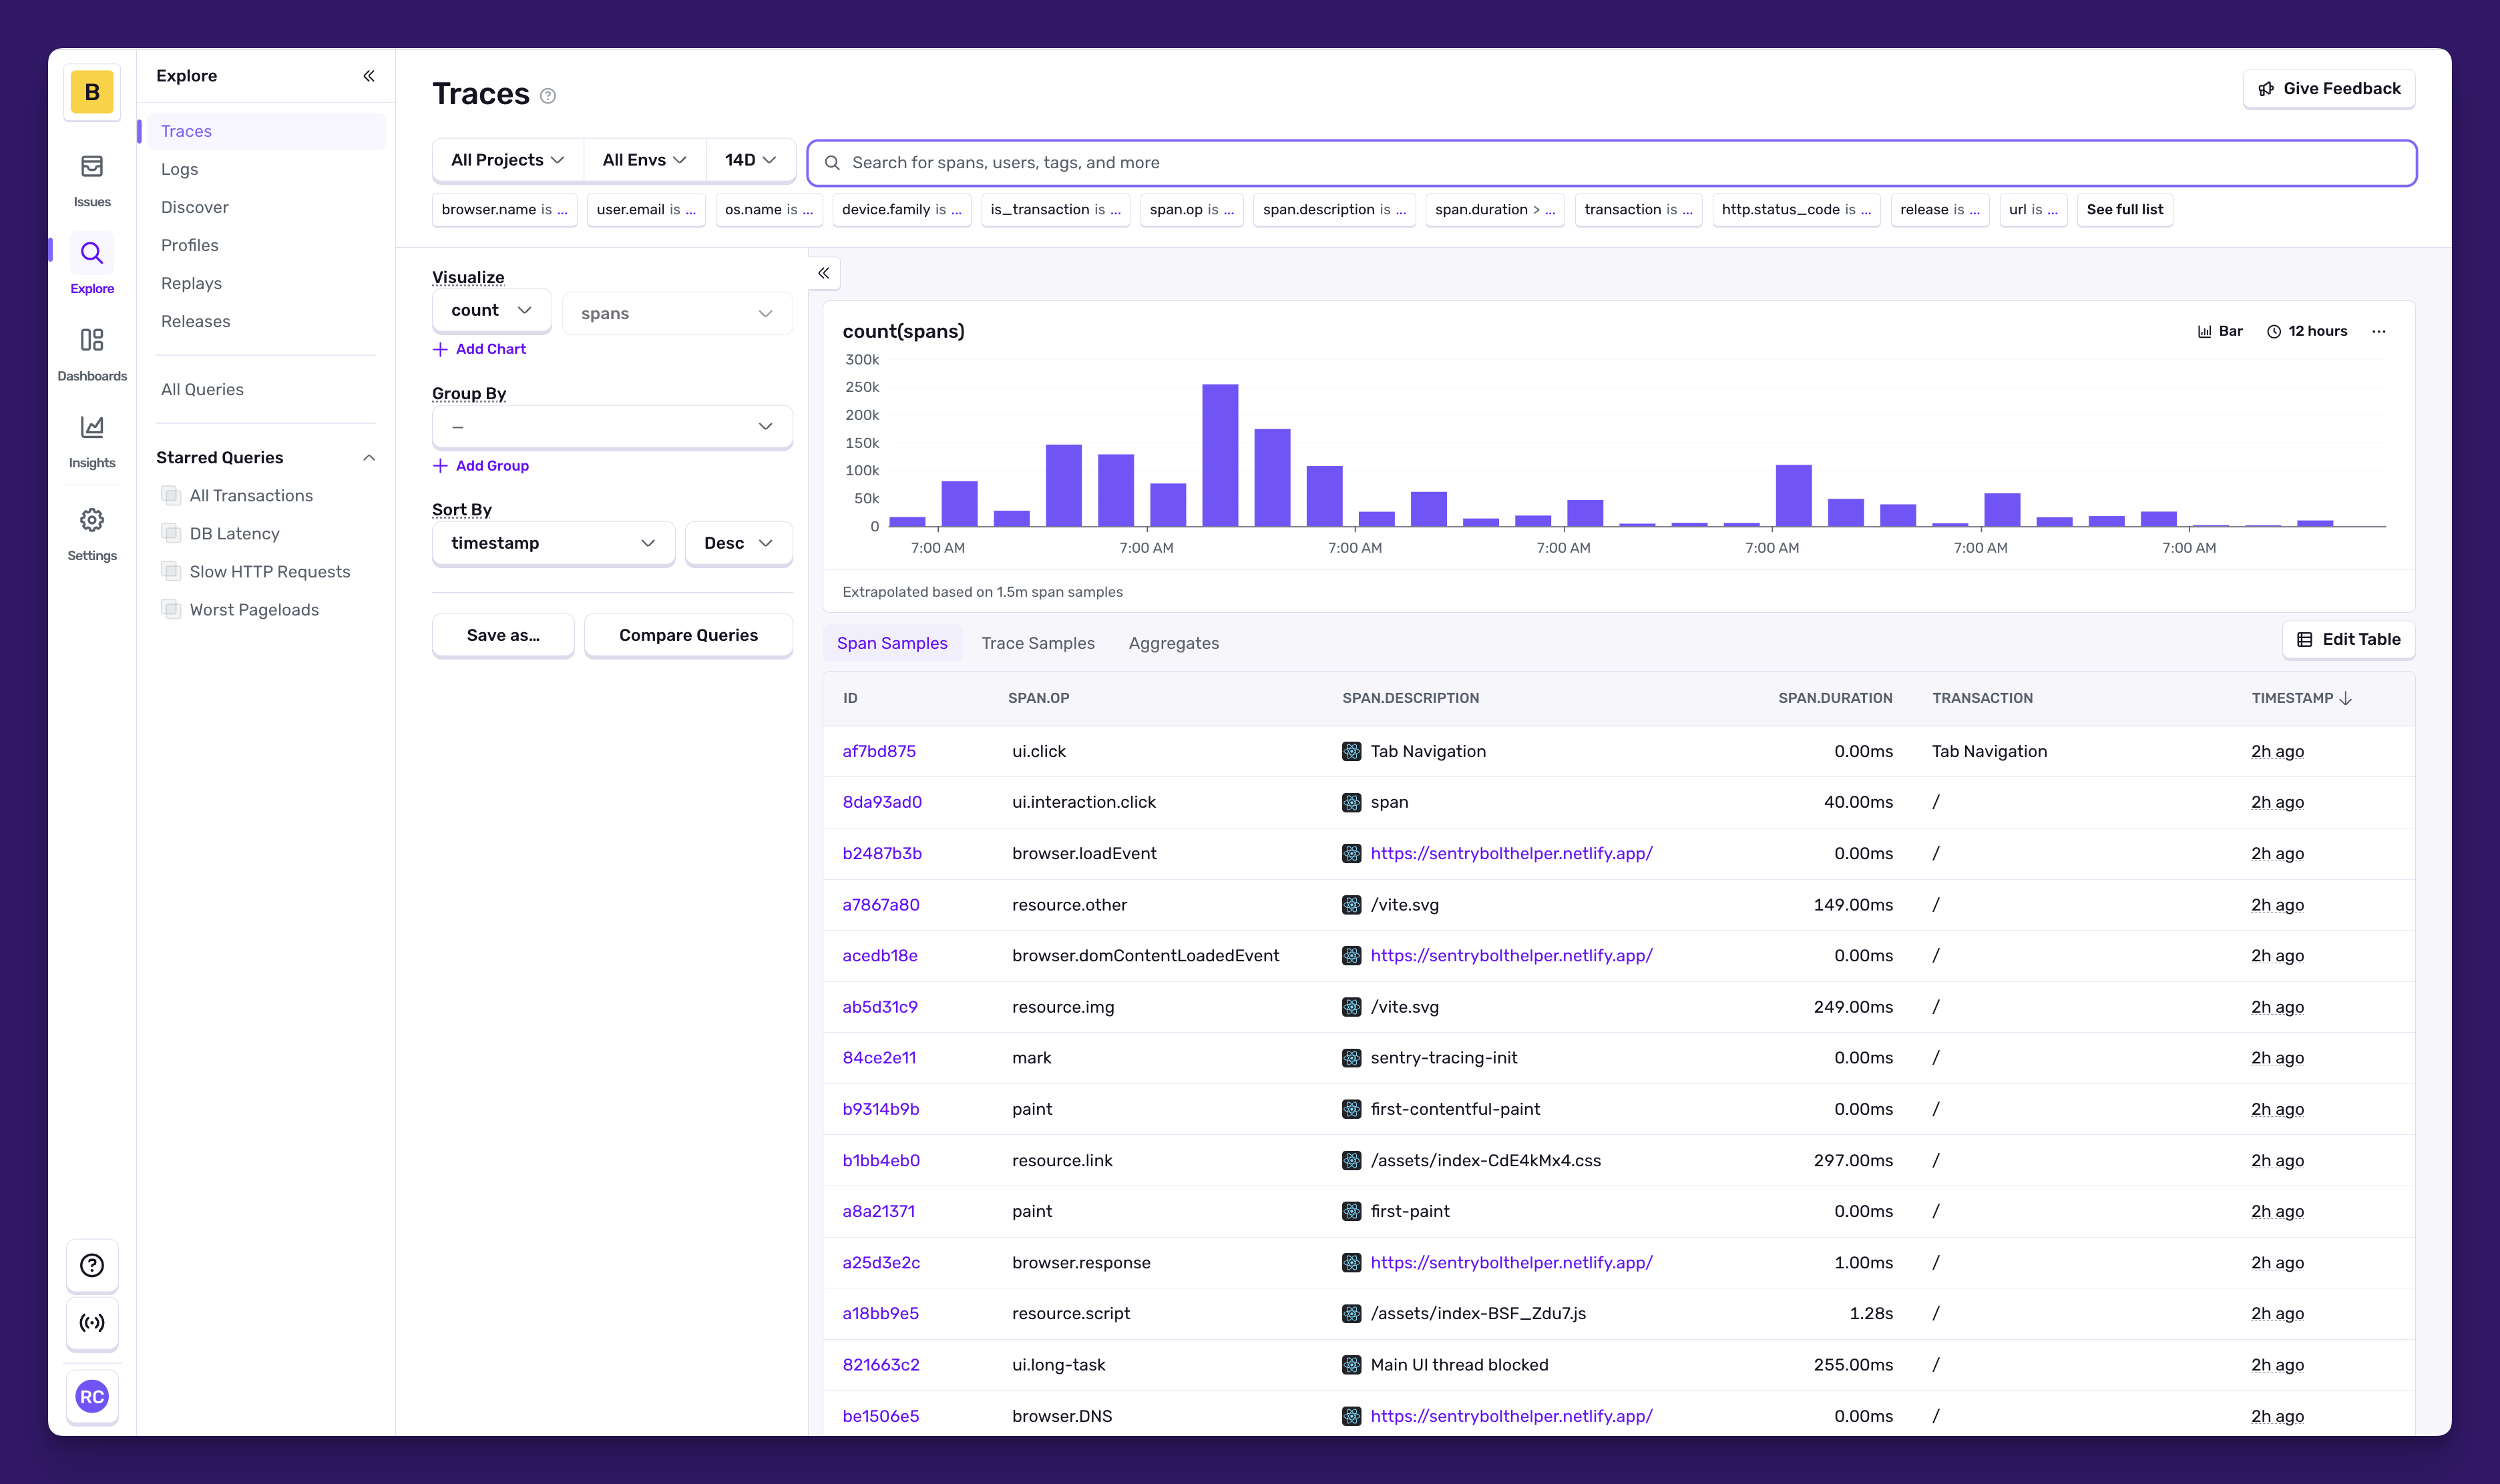
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/getsentry/sentry |
| Star / Fork | 45,388 / 4,904(watchers 671) |
| 代码行数 | 2,985,731 行(Python 48.8% + TSX 41.3% + JSON 5.3% + 其他) |
| 项目年龄 | 221 个月(首提交 2008-05-12;开仓 2010-08-30) |
| 开发阶段 | 密集开发(日均 ~60 commit,近 30 天 1,990 / 近 90 天 5,341) |
| 贡献模式 | 核心团队 + 社区协作(Top 1 1,158 人;创始人 David Cramer 仍亲自贡献 ~6.3%) |
| 热度定位 | 大众热门(充分定价,不存在低估套利) |
| 质量评级 | 代码 优秀 / 文档 优秀 / 测试 充分 / CI 完善 |
| License | Functional Source License(FSL:每个版本发布 2 年后转宽松开源) |
| 最新版本 | v1.13.5(490 个 tag;2024 年前后从「年份版本」重置为 v1.x SemVer) |
作者视角:为什么存在这个项目
创始人/作者背景
David Cramer (dcramer) 与 Evan Purkhiser 2008 年起在 Disqus 维护 Python 错误监控(raven-python 前身),属于 dogfooding 出身——亲自生产环境负责 Sentry 以外的所有问题需要「半夜手动在 Splunk 检索」。两人启动 Sentry 的源动力是看到所有告警都是裸 exception log,没有 stacktrace + release + environment + context 的自动绑定、没有自动去重、没有主动告警。2010 年开仓期是「亲历痛点 + GitHub OSS 浪潮 + SaaS 基础设施成熟」三重窗口契合。
公司化(Functional Software, Inc.,品牌 Sentry)后,14 年间由 dcramer 主导架构走向(1,158 名贡献者中他仍占 ~6.3%,是事实上的首席架构师)。这种「创始人 14 年亲自写代码」姿态在商业开源项目里罕见,是 Sentry 技术叙事可信度的根。
问题判断
Sentry 看到时点是应用监控领域的一个真空位置——
- 传统 APM(New Relic / AppDynamics)以基础设施/服务端指标为主,缺「应用层语义」的栈帧级捕获。
- 日志聚合(Splunk / ELK)只有事后检索,缺「自动去重 / 自动分桶 / 主动告警」。
- 同类 Error Tracker(Rollbar / Bugsnag / Airbrake)只能单一错误视角,且架构上无法演进到「traces + metrics + replays + AI」一体化。
Sentry 的选择是:把错误当作 Issue 对象分桶、让 release 与 environment 自动绑定、并预留「Issue 旁边可以附 trace / log / replay」的扩展点。
解法哲学
Sentry 的设计选择有四个清晰的反面:
- 简单 vs 完整 → 选了「大而全 monolith」。Sentry 坚持 Django monolith + React monolith 作为可演进底盘,而不是拆成微服务——与 Datadog 截然相反的思路。
- 性能 vs 易用 → 在事件入栈侧(Relay 边缘代理)选择 Rust + 极致采样偏向性能,在 SaaS 平台侧偏向易用与生态(SDK 多语言 + 自动上下文捕获)。
- 开放 vs 封闭 → 选择「Open-core 偏向 + FSL 许可」:源码可见、社区可商用 self-hosted,但 SaaS 化能力(Seer AI、advanced replays、Uptime)只对托管客户提供。这与 Elastic、HashiCorp、Confluent 的开源策略同形。
- 不做什么 → 不重做 dashboard / notebook / 自定义查询 DSL;坚持「Issue + Trace」为唯一核心对象。
战略意图
Sentry 在公司级图景中是 核心产品:围绕它构建了 Seer(AI Debugging)、Agent Monitoring、Uptime、Cron、Build Distribution 等横向扩张。商业化意图明显——托管 SaaS + 企业版自托管(FSL 限)+ AI 增值服务(Seer credits)+ 新模块上锁(Uptime/Cron 仅托管)。
2023-11 MIT → FSL 切换是「防止云厂商白嫖」的典型反应,与 Elastic、Redis、MongoDB 同形。该决策引发社区争议并刺激了 GlitchTip 等真 MIT 开源分叉填补合规空白。
核心价值提炼
创新之处
按「新颖度 × 实用性 × 可迁移性」排序:
| 创新 | 新颖度 | 实用性 | 可迁移性 |
|---|---|---|---|
| 二级 grouping 配置过渡(Dual-config in-flight transition) | 4/5 | 5/5 | 5/5 |
| Enhancer + Fingerprint 双 DSL(PEG 解析器 + AST + 热加载) | 4/5 | 5/5 | 4/5 |
| Variant-based Hashing(System/App/Custom 多变体并行) | 5/5 | 4/5 | 3/5 |
| Seer AI 相似度兜底(熔断 + 多级 ratelimit 串行 gate) | 4/5 | 5/5 | 4/5 |
| Bias Combinator 链(Ordered 多策略协同采样) | 4/5 | 5/5 | 4/5 |
| 消费者驱动的 Backpressure(Health-check + MessageRejected) | 3/5 | 5/5 | 4/5 |
| PendingBuffer Router(per-model 自定义 Celery 队列 + 攒批落地) | 3/5 | 5/5 | 5/5 |
| Hybrid Cloud Outbox(单 codebase 双部署形态) | 4/5 | 5/5 | 4/5 |
可复用的模式与技巧
- GroupType 抽象(统一 Issue 模型 + detector 注册):让错误 / 性能问题 / 资源饱和度共享同一 Issue 生命周期与告警通道。适用:可观测性平台、客服工单、内容审核。
- Multi-variant Hashing:同一数据并行计算多套指纹并存,运行时切换。适用:内容标签、用户画像多维度、搜索相关性。
- DSL + PEG 解析器作为用户扩展点:用户在不修改代码前提下扩展行为。适用:CDN 规则、特征平台、计费规则、风控规则。
- Dual-config 灰度过渡:算法升级时新旧配置并行计算。适用:索引重建、特征再训练、推荐模型 V2。
- 消费者驱动的 Backpressure:下游健康度反馈给上游边缘。适用:流处理、消息队列、CDN 限流。
- PendingBuffer 分桶攒批:高频 counter 用 Redis 缓冲 + 异步落 DB。适用:点赞 / 浏览 / 限流 / leaderboard。
- Circuit Breaker + Rate Limit 串行 gate:外呼服务故障不影响主链路。适用:API 网关、第三方依赖、AI 兜底。
- Hybrid Cloud Outbox:单 codebase 双部署。适用:开源 + SaaS 双形态产品(GitLab、NextCloud、Mattermost 都可借鉴)。
关键设计决策
1. Multi-variant Fingerprint(System / App / Custom / Checksum / Fallback 五套变体)
- 问题:客户多套归并规则同时跑,运行时还要支持新旧配置过渡。
- 方案:
BaseVariant抽象类 + 五种子实现;每个变体独立计算哈希,结果写入GroupHash表的多字段。 - Trade-off:牺牲了归并一致性简单性,换来了「配置可灰度切换」+「用户自定义指纹可叠加」。
- 可迁移性:高。任何需要「算法可灰度升级」的系统(推荐、风控、特征工程)都适用。
2. Enhancer + Fingerprint 双 DSL(基于 parsimonious PEG 解析器)
- 问题:客户希望在不修改代码的情况下调整归并逻辑,但不开放 Python 执行权限。
- 方案:自研小型 DSL(
function:foo* +app -group category=error),用 EBNF 语法 + NodeVisitor 编译成 AST;项目级 + 组织级叠加生效;正则片段可热加载。 - Trade-off:DSL 学习曲线 + 调试复杂(错误信息需行 / 列定位),换得「零代码扩展 + 可回放 + 可版本化」。
- 可迁移性:高。任何需要「不暴露内部代码就能配置」的系统(CDN 规则、风控 DSL、计费规则)都适用。
3. 二级 Grouping 配置过渡期(Dual-config in-flight transition)
- 问题:归并算法升级(每年一版 WINTER_2023 → FALL_2025)时,存量事件需要并行计算新旧两套哈希,避免「升级当天」产生历史 Issue 与新 Issue 重复。
- 方案:
SecondaryGroupingConfigLoader用 rate-limited + lock 模式分批把项目从旧配置切到新配置;过渡期内 ingest 阶段同时计算 secondary hash;用户可见 hash 列表不变(仍按 primary 归并),secondary hash 用于把已存在的 Group 关联到新 hash。 - Trade-off:过渡期计算 + 存储成本翻倍,换取「业务侧无感切换」+ 失败可回滚。
- 可迁移性:高。任何升级会影响「已存在数据指纹」的系统都适用(搜索索引重建、特征向量再训练、推荐模型 V2 上线)。
4. Seer AI 相似度兜底(仅在哈希归并失败时调用)
- 问题:纯哈希归并在面对
try/except包装、变量名替换、代码混淆等场景时漏掉真正相同的 root cause。 - 方案:
should_call_seer_for_grouping串 8 个 gate(事件合法 / 平台合法 / 自定义指纹排除 / race condition 排除 / 熔断 / killswitch / 栈帧超长排除 / 速率限制),过 gate 后才把 stacktrace 发给 Seer 独立服务;返回「相似 hash」后用find_grouphash_with_group把事件合并到现有 Group。 - Trade-off:增加了 RPC 延迟 + Seer 配额成本 + 训练数据依赖,换取「真正 root cause 召回率」+ 高价值 Issue 合并。Circuit breaker + ratelimit 保证外呼故障不影响 ingest 通路。
- 可迁移性:中高。任何「规则引擎 + ML 兜底」混合架构都适用。
5. Dynamic Sampling — Bias Combinator 链(8 个 Ordered Bias 顺序叠加)
- 问题:tracing 成本爆炸时,需要在边缘(Relay)端做智能采样,但不同组织 / 项目 / 环境 / 版本的优先级不同。
- 方案:
OrderedBiasesCombinator把 8 个Bias子类(health-check 忽略、replay-id 提升、environment 提升、recalibration、latest-release 提升、低量事务提升、最低采样率、低量项目兜底)按RuleType顺序叠加;最终编译成 Relay 端的 JSON 规则列表下发给边缘。 - Trade-off:bias 链顺序敏感(新 bias 插入位置需谨慎);换来「边缘侧自适应采样 + 业务上下文感知」。
- 可迁移性:高。任何需要「多策略协同决策」的分布式系统都适用(CDN 缓存、消息路由、API 限流组合)。
7. Redis 增量缓冲器(buffer/redis.py + PendingBufferRouter)
- 问题:高频事件触发「
times_seen自增 +last_seen更新」等 PG UPDATE,单事件 5+ 次写。 - 方案:Redis
PendingBuffer按 model_key 分桶攒批 + Celery task 周期落地 PG;PendingBufferRouter支持 per-model 自定义 Celery 队列路由。 - Trade-off:增加 Redis 依赖 + 秒级一致性窗口,换得「PG 写入降低 1-2 个数量级」+ 多租户隔离写入热点。
- 可迁移性:高。任何高频 counter / leaderboard / 点赞计数场景可复用。
8. Hybrid Cloud + Outbox(hybridcloud/ 抽象层)
- 问题:getsentry(SaaS 控制面)与 sentry(社区核心)需要共享数据模型但部署形态不同。
- 方案:用「Outbox 模式 + 服务注册表」让两套部署通过 Kafka 消息同步;ORM 模型共享,行为在 SaaS 侧 override。
- Trade-off:增加 outbox 写放大 + 一致性窗口,换得「同一 codebase 双部署形态」+ 上游合并零阻力。
- 可迁移性:高。开源 + 商业双形态产品都适用(GitLab、NextCloud、Mattermost 都用同类抽象)。
9. Backpressure Monitor(健康度驱动的自适应拒绝)
- 问题:当 Kafka 消费端(store/post-process)跟不上生产端时,需要在 Relay 侧拒绝低优先级事件,但不能简单 drop。
- 方案:
start_service_monitoring()周期性查询 Redis 集群内存使用率 → 计算unhealthy_services→ 通过record_consumer_health写入 Redis → Relay 端定期读取 →create_backpressure_step用MessageRejected让 Arroyo 把消息回退到 Kafka 重试。 - Trade-off:实现复杂度高(多语言协调 Python ↔ Rust ↔ Kafka),换来「自适应保护下游 + 0 数据丢失 + 优先级调度」。
- 可迁移性:中高。任何「消费者驱动的反压」流处理系统都适用。
竞品格局与定位
竞品对比矩阵
| 维度 | Sentry | GlitchTip | Highlight.io | Rollbar | Bugsnag | Datadog |
|---|---|---|---|---|---|---|
| 形态 | Open-core (FSL) + SaaS | MIT 真开源 | 开源 + 云双形态 | 闭源 SaaS | 闭源 SaaS | 闭源 SaaS |
| Stars | 45K | ~1.5K | ~8K | 闭源 | 闭源 | 闭源 |
| 覆盖广度 | Issues + Traces + Profiling + Replay + Logs + APM + RUM + Uptime + Cron + Seer AI | 仅 Error tracking | Replay + Error + Logs + APM | Error + deploy correlation | Error + 移动稳定性 | Error + Metrics + Traces + Logs + APM + Security 一体化 |
| SDK 数量 | 30+ 语言 | 复用 Sentry SDK | 中等 | 多家标准 | 业内领先(移动) | 自家 agent |
| 自托管难度 | 高(Kafka + ClickHouse + Relay) | 极低(docker-compose) | 中 | 不支持 | 不支持 | 自家控制 |
| AI 调试 | Seer(托管端) | 无 | 起步 | 无 | 无 | Watchdog |
| 价格门槛 | 免费层 + SaaS | 免费 | 免费层 + SaaS | 按事件计费 | $47/月起步 | $$$ |
差异化护城河
- 生态护城河(最强):30+ 语言 SDK、30+ 第三方集成、14 年品牌沉淀、开发者心智 ≈「崩溃监控 = Sentry」。
- 信任护城河:David Cramer 仍亲自写代码(commit 占比 6.3%),「创始人=首席架构师」姿态罕见。
- Issue 抽象护城河:将「Issue 当作一等公民」做透,自动归并 / regression / auto-resolve 的体验至今无替代者。
竞争风险
- Highlight.io 最可能在「现代云原生团队 + 中小规模自托管」场景切走 Sentry 自托管份额——MIT 真开源 + Replay/Logs/APM 一体化 + TypeScript-first 现代化技术栈。
- Datadog 在「企业级一站式 + 已有 metrics/logs 预算」场景竞争 Issue / Traces 模块;通常不会互迁,是共生态。
- AI-native 新物种(Honeycomb + 自研 Seer、专门 LLM 调试工具如 LangSmith / Helicone)可能在「AI/LLM 应用调试」这一新赛道切走增量。
- FSL 切换后引发的真开源分叉(GlitchTip 等)填补了合规 OSS 空白。
生态定位
Sentry 在生态中扮演 开发者调试体验的事实标准 + 全栈可观测性平台的主要玩家之一。不与 Datadog / Grafana 正面竞争 metrics / logs,而是把「Issue + Trace」作为不可替代的开发者入口,再向上扩张 AI Debugging、Agent Monitoring、Uptime、Cron、Build Distribution。
套利机会分析
- 信息差:低关注度但高质量?否——这是已被充分定价的大众热门 OSS;价值在架构资产而非「被忽略的潜力股」。
- 技术借鉴:8 个高可迁移性架构模式(详见上方)——任意规模化 SaaS 都可直接迁移。
- 生态位:填补了「错误 = 一等公民 + 全栈可观测 + AI Debugging」这一空白,且 14 年无替代者。
- 趋势判断:项目仍在加速(2025-2026 月均 1-2K commit),AI 调试赛道还在早期;自托管份额有流失给 Highlight.io 的风险,但 SaaS 头部地位稳固。
风险与不足
- License 风险:FSL 切换后社区合规可用性变窄,企业自托管客户需评估 FSL 是否被法务接受。
- Monolith 体积:3M 行代码 + Kafka + ClickHouse + Relay + 多语言 SDK 协调,自托管运维成本极高。
- 架构拐点后的迁移风险:v25.x → v1.x 的版本号重置(2024 年前后)是一次重大架构 / 产品调整,对外部集成与下游 SDK 兼容性影响需关注。
- AI 调试赛道新风险:Seer 是托管 SaaS 独家,自托管用户无法使用,可能成为未来商业化进一步拉大差距的点。
- Issue Type 抽象的复杂度:错误 / 性能问题 / NEL / Replay 都统一为 GroupType 后,抽象学习曲线变高,新贡献者上手成本上升。
- 数据可见性陷阱:Issue #70473 揭示 Snuba + Relay + 采样链路任一环配置漂移即可让 transactions 静默归零——分布式追踪体系「数据正确性难验证」是根本问题。
行动建议
如果你要用它
- 小团队 / 创业团队:直接走 sentry.io 免费 tier(5K events / 月 / 1 user)——错误监控的默认起点,无需多想。
- 中大型团队 / 多语言栈:Sentry 全栈套件(Issue + Trace + Profiling + Replay)是首选;如果已被 Datadog 占据 metrics / logs,Sentry 作为 Issue + Trace 层叠在 Datadog 之上是常见的「两个 SaaS 共存」方案。
- 自托管需求:评估 FSL 是否被法务接受;如果不接受,转看 Highlight.io;如果接受精简错误监控需求,可评估 GlitchTip(drop-in Sentry 兼容)。
- AI / LLM 应用:Seer + Agent Monitoring 在 SaaS 端领先;如果是自托管则看不到 AI 价值,需重新评估 ROI。
- 移动优先:Bugsnag 的稳定性评分仍是移动端的行业标准;纯移动 App 可考虑 Bugsnag,全栈场景再回 Sentry。
如果你要学它
重点关注以下文件 / 模块(学习顺序建议):
src/sentry/grouping/—— 核心:归并算法、enhancer DSL、fingerprint DSL、二级配置过渡、Seer AI 兜底。这是 Sentry 的最大心智资产。src/sentry/event_manager.py—— 事件入栈主流程。src/sentry/ingest/+src/sentry/processing/—— Kafka 流水线 + backpressure monitor。src/sentry/dynamic_sampling/—— Bias Combinator 链。src/sentry/buffer/—— Redis 增量缓冲器。src/sentry/hybridcloud/—— Outbox 模式 + 服务间 RPC。static/app/—— React 前端 monolith。relay/(独立仓库 getsentry/relay)—— Rust 边缘代理。docs/architecture/与.sentry-refactor-tasks/—— 架构决策记录与重构任务。
如果你要 fork 它
可改进方向:
- AI 调试的本地化:在 self-host 也能跑 Seer 等价物(开源 LLM 调试助手)。
- MIT 真开源回归:社区对 FSL 切换的不满持续存在,重新 MIT 化可能带来流失贡献者回流。
- Microservice 拆分:把 monolith 拆为 ingest / group / alert / dashboard 微服务可降低自托管门槛。
- 前端技术栈现代化:React monolith 可以演进到 RSC + Edge Rendering。
- Seer 等价 OSS 实现:用 OSS LLM 复现 Seer 的 stacktrace 相似度判断,做出自托管版 AI 调试。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 未收录 |
| Zread.ai | 未收录 |
| 关联论文 | 无(商业产品,无对应学术论文) |
| 在线 Demo | 无官方公开 playground——可通过 sentry.io 注册免费 tier 试用;self-host 通过官方 Docker / install 脚本本地起栈 |
| 官方架构博客 | sentry.io / blog(「The Architecture of Sentry」系列经典参考) |
| 最佳替代评测 | Pydantic: Best Sentry Alternatives — 独立视角:FSL 切换后 GlitchTip 等 MIT 分叉被视为合规替代 |
报告说明:本报告基于 collect_repo_facts.py 确定性采集 + Phase 1/2/3 三阶段 LLM 分析。Phase 2 由于仓库规模(111K commits)触发 git log --format= 超时,core_files / hot_dirs / commit_type_distribution 数据缺失,已在报告中如实说明,避免编造。月度 commit 演化与版本号重置(v25.x → v1.x)等历史脉络基于采集到的 dev_rhythm.monthly_distribution + evolution.tags 推断。