GitHub推荐:4 个月 6535 Stars:OpenSEO 把 SEO 工具接入 AI Agent
一句话总结
OpenSEO 是一个 MIT 开源、可自托管、按数据用量付费的 SEO 全栈工具,试图用 MCP 和 Agent Skills 把关键词研究、外链分析、排名追踪与站点审计直接交给 Claude Code、Codex 等 AI Agent 调用。它的核心不是再做一个 Dashboard,而是把 SEO 数据变成 Agent 可编排的工具层。
值得关注的理由
- 热度与成熟度形成反差:项目公开约 4.7 个月即获得 6,535 Stars、709 Forks,但当前仍是 v0.1.1,核心贡献者 95% 以上集中在一人身上。
- 不是又一个 SEO Dashboard:OpenSEO 把 MCP 作为一等入口,同时提供 26+ 个工具、Agent Skills 和双通道输出,让 AI Agent 能消费结构化 SEO 数据,而不只是让人点击网页。它把数据工具层与工作流层明确分开。
- 工程取舍值得学习:在 Cloudflare Workers 的边缘运行时约束下,项目用惰性加载边界、构建期依赖闭包检查、D1/Postgres schema parity 和精确的第三方 API 计费信封解决实际问题。
项目展示
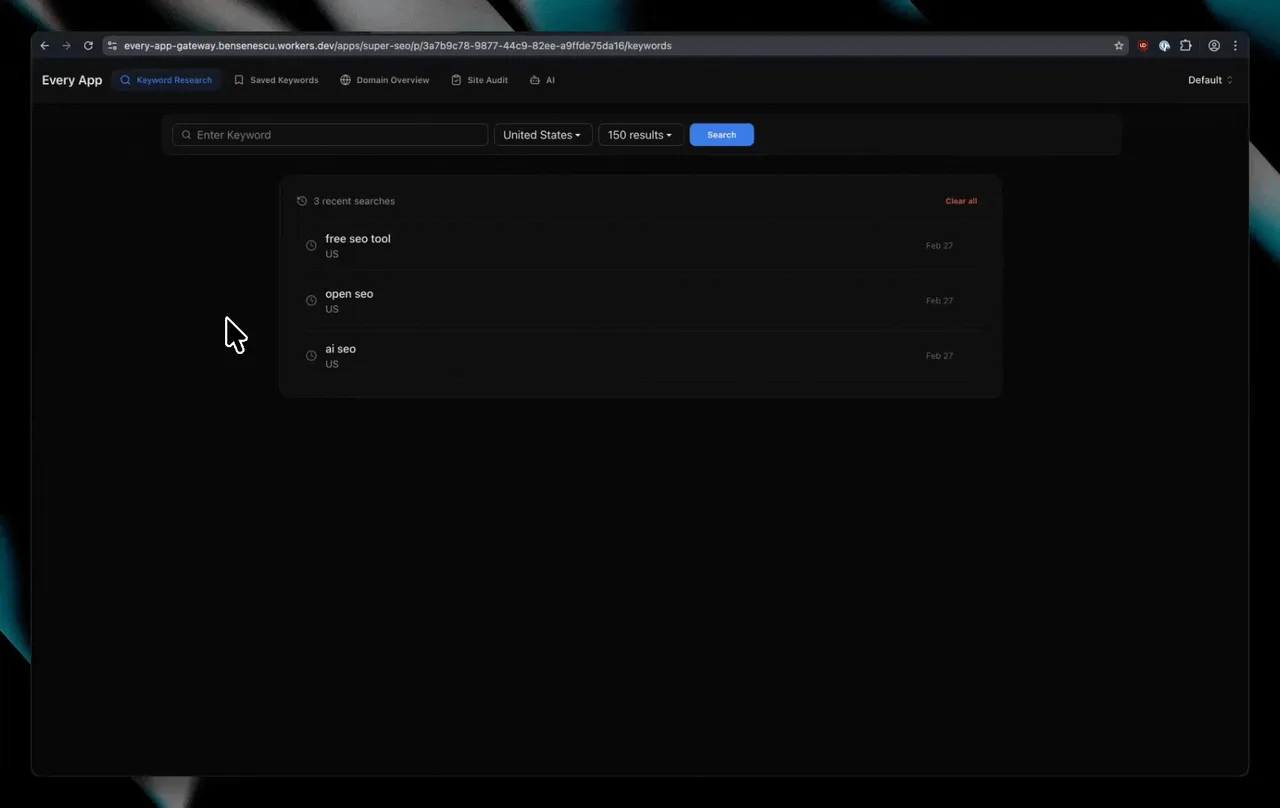
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/every-app/open-seo |
| Star / Fork | 6,535 / 709 |
| 代码行数 | 249,322(其中 JSON 53.7%,TypeScript 23.9%,TSX 13.9%;JSON 含大量生成产物) |
| 项目年龄 | 约 4.7 个月(2026-02-27 首次提交) |
| 开发阶段 | 密集开发:近 30 天 110 个 commit,最近仍在持续推送 |
| 贡献模式 | 单人主导:12 位贡献者,Ben Senescu 占约 95.2% commit |
| 热度定位 | 大众热门;但仍属于高速演进中的早期产品 |
| 版本 | v0.1.1;30 个 tag、29 个 Release |
| License | MIT |
| 质量评级 | 代码优秀;文档优秀;测试充分;CI/CD 完善 |
GitHub stargazer 时间序列采样受 API 403 限制,无法给出可靠的近期增长跨度;因此不编造日/月增长曲线。仅从公开时间、Stars、Forks 与提交密度判断,项目属于爆发式获得关注的新项目。
作者视角:为什么存在这个项目
创始人/作者背景
仓库归属于 Every App(every-app),组织自称「The open source personal software platform」。组织成立时间较短,OpenSEO 是其投入权重最高、Stars 远超其他公开仓库的项目。实际研发高度集中于 Ben Senescu:他贡献了 371 次 GitHub contribution,远高于其他贡献者。
这更像是围绕核心开发者建立的产品型开源组织,而非成熟基金会式社区。作者在 SEO 工作流、Cloudflare 边缘应用和 AI Agent 集成之间做了跨域组合,项目也明显带有 dogfooding 和产品化色彩。
问题判断
作者判断传统 SEO 工具存在三个结构性问题:
- Ahrefs、Semrush 等采用固定订阅,轻量用户也要承担较高月费;
- 产品功能不断堆叠,独立开发者和小团队只需要其中一部分;
- SEO 数据仍停留在面向人工点击的 Dashboard 中,无法被 Claude Code、Codex 等 Agent 直接编排。
OpenSEO 因此没有试图自建一个与 Ahrefs 规模相当的网页索引,而是以 DataForSEO 为数据底座,把「开源 UI + 自托管 + BYOK + MCP + Agent Skills」组合成一个更轻量的入口。
解法哲学
- 保留价值,去除臃肿:强调 focused workflows,而不是复制大型营销套件的全部功能。
- AI-first 而非 AI 外挂:关键词研究、SERP、外链、搜索表现和 AI 可见性都通过 MCP 暴露给 Agent。
- 透明的成本边界:自托管用户使用自己的 DataForSEO key;托管版本按用量计费,而非用模糊的无限套餐隐藏数据成本。
- 用户拥有部署权:核心代码 MIT 开源,提供 Docker 和 Cloudflare 两种自托管路径,托管服务主要出售便利性而不是锁死核心功能。
战略意图
OpenSEO 采用接近 open-core 的商业路径:核心代码开放,托管版本提供更省事的部署、认证、计费和多设备使用体验。官方文档将托管部署定位为公网、团队场景,将 Docker 定位为本地场景,并以 DataForSEO BYOK/按量计费作为成本模型。
当前没有正式公开路线图,但代码和文档显示战略方向很清晰:补齐传统 SEO 套件能力,扩展 AI Search/GEO 可见性,再通过 MCP 和 Agent Skills 把 SEO 操作变成可复用工作流。
核心价值提炼
创新之处
-
MCP + Agent Skills 的 SEO 原生入口
- 将关键词研究、SERP 分析、外链、站点审计、Search Console 和 AI 可见性封装为 MCP 工具。
- 新颖度:4/5;实用性:5/5;可迁移性:3/5。
- 真正的价值不在于「支持 MCP」四个字,而在于把数据工具层与工作流层分开:MCP 负责能力暴露,Agent Skills 负责重复执行的任务模板。
-
惰性加载边界的构建期强制检查
- DataForSEO 等 SDK 体积较大,静态导入可能使 Worker 启动包触及内存限制。项目通过
loadDataforseoSections()建立唯一动态导入边界,并由自定义 Vite 插件扫描静态导入闭包,发现 denylist 模块泄漏就让构建失败。 - 新颖度:4/5;实用性:5/5;可迁移性:5/5。
- 这把「靠开发者记住不要静态 import」升级为「构建系统自动阻止回归」,是整个仓库最值得迁移的模式之一。约束被编码进了构建系统。
- DataForSEO 等 SDK 体积较大,静态导入可能使 Worker 启动包触及内存限制。项目通过
-
按量付费 API 的 Billing Envelope
- DataForSEO 可能出现「任务失败但已扣费」。项目让 API 响应统一携带 billing 元数据,通过
assertOk()和DataforseoChargedTaskError区分已扣费失败、未扣费失败和参数校验失败。 - 新颖度:3/5;实用性:5/5;可迁移性:4/5。
- 这不是普通的错误处理,而是把供应商计费语义提升到领域模型,避免业务层漏记账或重复扣费。财务正确性不再依赖团队约定。
- DataForSEO 可能出现「任务失败但已扣费」。项目让 API 响应统一携带 billing 元数据,通过
-
D1 + Postgres Schema Parity
- 同时支持 Cloudflare D1/SQLite 和 Postgres,并通过
schema-parity.test.ts检查两套 schema 结构一致。 - 新颖度:3/5;实用性:4/5;可迁移性:4/5。
- 代价是双 schema 维护,收益是用户可以从零成本本地部署逐步迁移到更强的数据库后端。
- 同时支持 Cloudflare D1/SQLite 和 Postgres,并通过
-
关键词数据源路由
- DataForSEO Labs 覆盖 94 个国家;对其余地区自动回退到 Google Ads 关键词数据接口,从而扩大到 217 个国家。项目诚实保留不同数据源的能力差异:回退数据没有 keyword difficulty、intent 和 SERP feature。
- 新颖度:3/5;实用性:5/5;可迁移性:3/5。
- 这是一个产品层面的数据质量取舍:宁可返回能力较弱的结果,也不让非主流地区直接无法使用。
可复用的模式与技巧
- Feature-first 三层架构:
repository → service → server function/MCP tool,让数据访问、业务规则与外部入口各自稳定。 - Metered Client:通过
createDataforseoClient(customer)将鉴权、额度检查、供应商调用和实际成本追踪封装到客户端边界,避免每个 feature 各自实现计费。 - Lazy Boundary + Build-time Enforcement:动态导入边界配合构建期依赖闭包检查,适合所有边缘运行时大型 SDK 场景。
- Per-request Postgres 客户端:使用 AsyncLocalStorage 维护请求级连接上下文,避免 Cloudflare Workers 跨请求复用 socket;Cloudflare Workflows 的每个 step 再用
pgStep()重新建立上下文。 - MCP 双通道输出:同时返回人类可读的
text表格和机器可读的structuredContent,兼容只展示文本的客户端与需要结构化数据的 Agent。
关键设计决策
1. 以 Cloudflare 为主平台,但保留 Docker/Postgres
- 问题:需要低成本部署、边缘运行和多租户能力。
- 方案:Cloudflare Workers、D1、R2、Durable Objects、Workflows、Hyperdrive 组成默认运行面,同时通过 Docker 和 Postgres 支持更传统的自托管。
- Trade-off:获得极低的部署门槛和边缘能力,但平台特性较多,初期与 Cloudflare 深度耦合。
- 可迁移性:中。边缘运行时的连接隔离、惰性加载和 workflow 经验可迁移,但具体绑定不可直接复制。
2. 用计费边界约束第三方数据调用
- 问题:feature 代码自由调用底层 API 时,容易漏掉余额检查和实际成本追踪。
- 方案:托管模式下所有调用经过 metered client;成功后记录供应商返回的真实成本,失败时根据是否已扣费分类。
- Trade-off:类型和调用约束更复杂,但把财务正确性从「团队规范」变成代码结构。
- 可迁移性:高,适用于任何按量计费的 LLM、搜索或支付 API。
3. 多认证模式共享一套用户上下文
- 问题:本地免认证、Cloudflare Access 和托管邮箱认证的身份来源不同。
- 方案:
resolveUserContextFromHeaders()根据AUTH_MODE选择不同 resolver,最终统一输出 user、emailVerified、organization 和 project 上下文。 - Trade-off:需要维护多个认证 resolver,且客户端与服务端的
AUTH_MODE必须保持一致;换来部署模式之间共享业务层。 - 可迁移性:高,适用于同时提供本地开发版、企业 SSO 和托管 SaaS 的产品。
4. 显式注册 MCP 工具
- 问题:MCP SDK 的泛型需要每个工具保留具体的 input/output schema。
- 方案:显式调用
server.registerTool(),而不是通过循环和弱类型辅助函数批量注册。 - Trade-off:代码较冗长,但工具契约、校验和客户端元数据更清晰。
- 可迁移性:中。
竞品格局与定位
竞品对比矩阵
| 维度 | OpenSEO | Ahrefs | Semrush | SE Ranking |
|---|---|---|---|---|
| 产品形态 | MIT 开源,可自托管,也有托管版 | 闭源商业 SaaS | 闭源商业 SaaS | 闭源商业 SaaS |
| 定价逻辑 | 托管费 + 实际数据用量;自托管 BYOK | 固定订阅,套餐门槛高 | 固定订阅,功能/额度复杂 | 订阅,偏代理商和团队 |
| 数据底座 | DataForSEO | 自有大规模索引 | 自有大规模索引 | 商业数据平台 |
| AI Agent 接入 | 原生 MCP + Agent Skills | 主要面向网页 UI/API 生态 | 功能全面但 Agent 原生性较弱 | 有 GEO/报告能力,但不可自托管 |
| 功能范围 | 关键词、外链、排名、审计、GSC、AI 可见性 | 外链、关键词、内容、竞争情报成熟 | SEO、广告、内容、社媒、营销套件完整 | 排名追踪、白标、团队报表成熟 |
| 适合用户 | AI-native 开发者、独立站长、小团队、隐私/成本敏感用户 | 专业 SEO 和企业 | 企业营销团队 | 代理商和中小团队 |
差异化护城河
OpenSEO 的护城河目前不是数据规模,而是组合式产品体验:开源透明度、自托管权、按用量计费、MCP 工具和 Agent Skills。它把 SEO 数据变成可被 Agent 编排的基础设施,这一定位比「再做一个 Ahrefs 仿品」更有辨识度。
竞争风险
最现实的风险是 Ahrefs、Semrush 等成熟厂商直接提供高质量 MCP 接入。它们拥有更强的数据、品牌和企业支持,一旦把 Agent 入口补齐,OpenSEO 的功能差距会被放大。另一类风险来自数据供应商依赖:OpenSEO 自己并不拥有搜索索引,DataForSEO 的价格、覆盖和服务稳定性会直接影响产品体验。
生态定位
OpenSEO 位于传统 SEO SaaS、开源自托管软件和 AI Agent 工具三者交叉处。它在传统 SEO 套件市场属于红海新进入者,但在「AI-native SEO + 可控成本 + 自托管」这个细分切口具有先发优势。与只做反向链接 MCP 的 pucilpet/crawlgraph-mcp 相比,OpenSEO 是完整产品;与 Ahrefs/Semrush 相比,它更像 SEO 数据和工作流的开放入口。
套利机会分析
- 信息差:这是一个短期内迅速获得大众关注、但版本仍早期的项目。适合关注其架构和产品方向,不应把 6,535 Stars 误读成基础设施成熟度。
- 技术借鉴:优先学习
leanWorkerBundle、DataForSEO metered client、schema-parity.test.ts、src/server/mcp/instrumentation.ts和specs/0002-hosted-dataforseo-metering-with-autumn.md。 - 生态位:它把「SEO 数据」从人工 Dashboard 迁移到 AI Agent 可调用的工具层,适合围绕 MCP 做 SEO 自动化、内容规划和竞品研究产品。
- 趋势判断:AI 搜索可见性、GEO 和 Agent Skills 都处在增长阶段。OpenSEO 的后发优势在于把这些能力与成熟 SEO 工作流放在一个开源产品中;短板是数据源和平台依赖尚未形成真正的技术壁垒。
风险与不足
- 成熟度不足:4.7 个月、v0.1.1、390 commits 说明执行力强,也说明 API 和部署方式仍可能快速变化。
- 贡献集中度过高:核心作者约占 95% commit。作者离开或商业方向调整时,社区接管能力尚未被验证。
- Cloudflare 耦合:Issue #1、#5、#27 等反复围绕 Cloudflare 部署和 Docker 自托管,说明「可自托管」仍需要区分「能部署」与「平台无关」。
- Agent 操作闭环未完成:Issue #98 显示 MCP 能列出和读取项目,却尚不能创建项目;从查询型工具到完整任务执行仍有缺口。
- 团队能力尚未成熟:Issue #87 请求多用户/IAM,表明个人工具向团队 SaaS 迁移时,组织边界、角色和权限仍在补齐。
- 底层数据供应商依赖:DataForSEO 决定数据覆盖、成本和可用性;OpenSEO 的「开放」不等于摆脱了外部数据依赖。
- 测试与统计口径需谨慎:提交分类中
test类型几乎为零,但仓库实际有约 87 个测试文件和 Playwright E2E,说明 commit message 统计不能直接等同于测试覆盖率。
行动建议
- 如果你要用它:适合希望降低 SEO 订阅成本、接受配置 DataForSEO、并且愿意使用早期软件的开发者和小团队。个人本地实验优先 Docker;公网团队使用再评估 Cloudflare、Postgres、认证和备份。不要将 v0.1.1 当作稳定基础设施,先锁定版本并验证数据成本。
- 如果你要学它:先读
specs/0002-hosted-dataforseo-metering-with-autumn.md和specs/0004-keyword-data-source-routing.md,再看src/server/lib/dataforseo/、src/server/mcp/、src/server/workflows/、src/middleware/ensure-user/。重点关注如何把供应商限制、计费语义和边缘运行时约束编码进架构。 - 如果你要 fork 它:优先补平台解耦、完整 MCP CRUD 闭环、多用户/IAM、数据源抽象和迁移文档;不要先扩展更多 SEO 功能,先把部署、认证、计费和数据质量的边界稳定下来。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | every-app/open-seo Overview |
| Zread.ai | 未收录 |
| 关联论文 | 无 |
| 官方文档 | OpenSEO Docs |
| 在线 Demo | OpenSEO;未验证到无需账户的独立 Playground |
| 官方组织 | Every App |