Chandra OCR 深度分析报告
一句话总结
用 4B 参数的视觉语言模型端到端替代整个 OCR pipeline,以仅 1,700 行核心代码实现 SOTA 精度(85.9%),支持 90+ 语言的复杂文档识别,由 marker/surya 明星团队打造。
值得关注的理由
- SOTA 精度 + 极小模型:4B 参数在 olmOCR benchmark 上达到 85.9%,超越 7B 的 olmOCR 2(82.4%),参数量比前代 Chandra 1 减半但精度提升
- 明星团队验证:Datalab 创始人 Vik Paruchuri 此前打造了 marker(33K Star)和 surya(19.5K Star),文档智能领域连续三个爆款
- 范式转换:用 VLM 端到端替代传统「检测→识别→布局重构」的多阶段 OCR pipeline,HTML 作为统一中间表示是原创性工程方案
项目展示
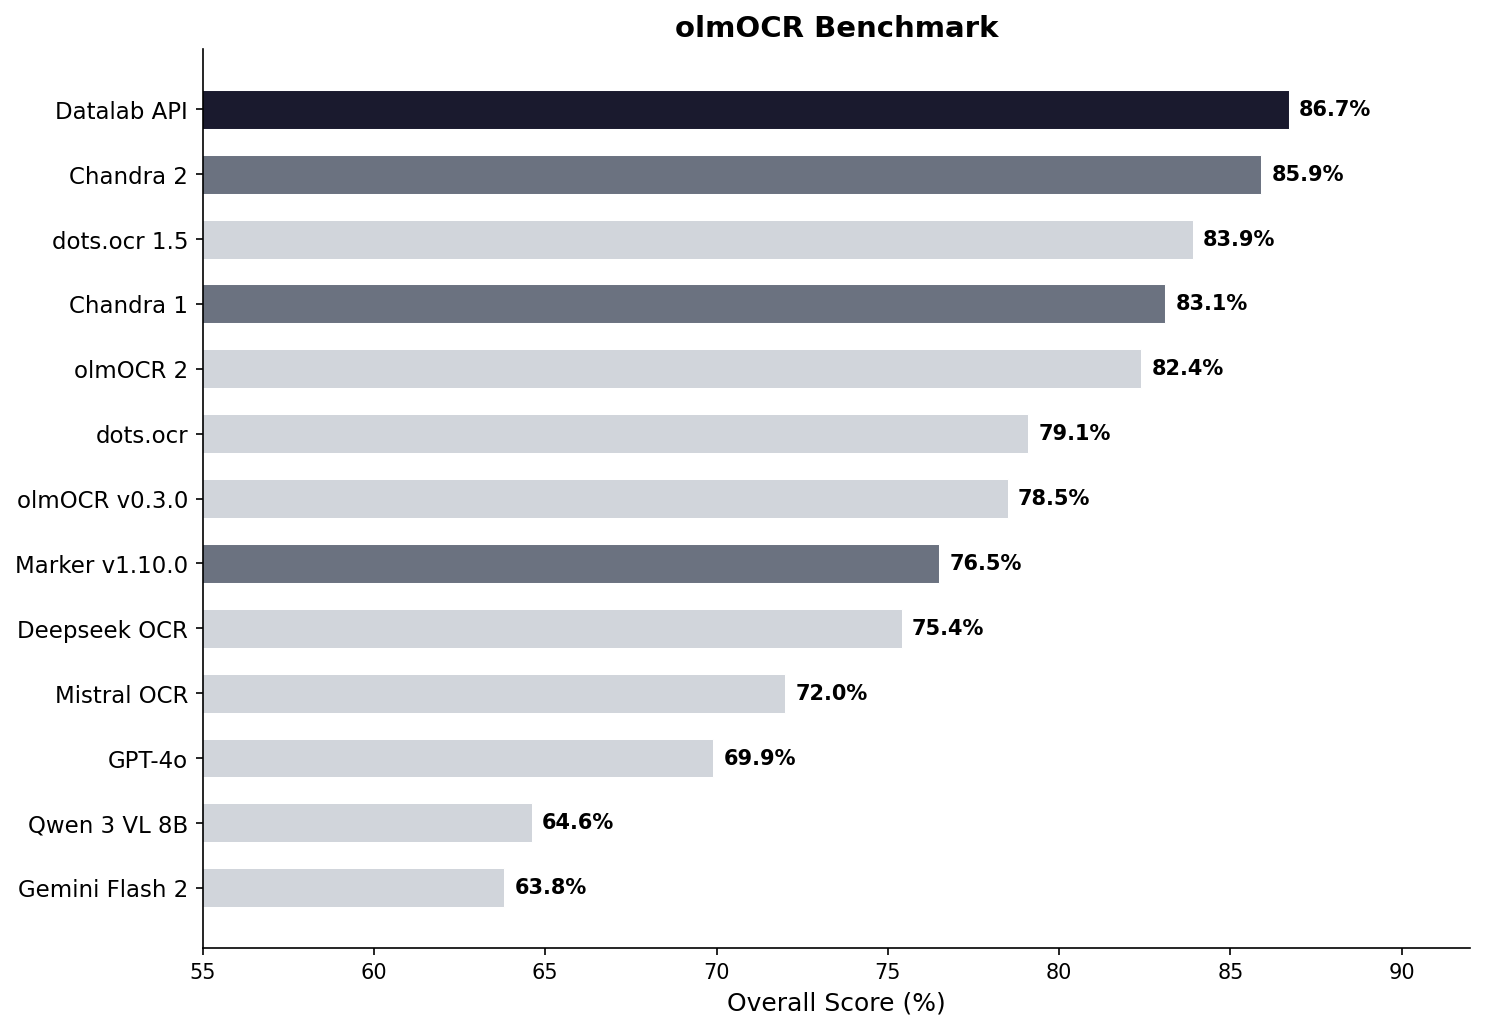
Chandra 2 在 olmOCR benchmark 上以 85.9% 的得分位居开源模型第一。
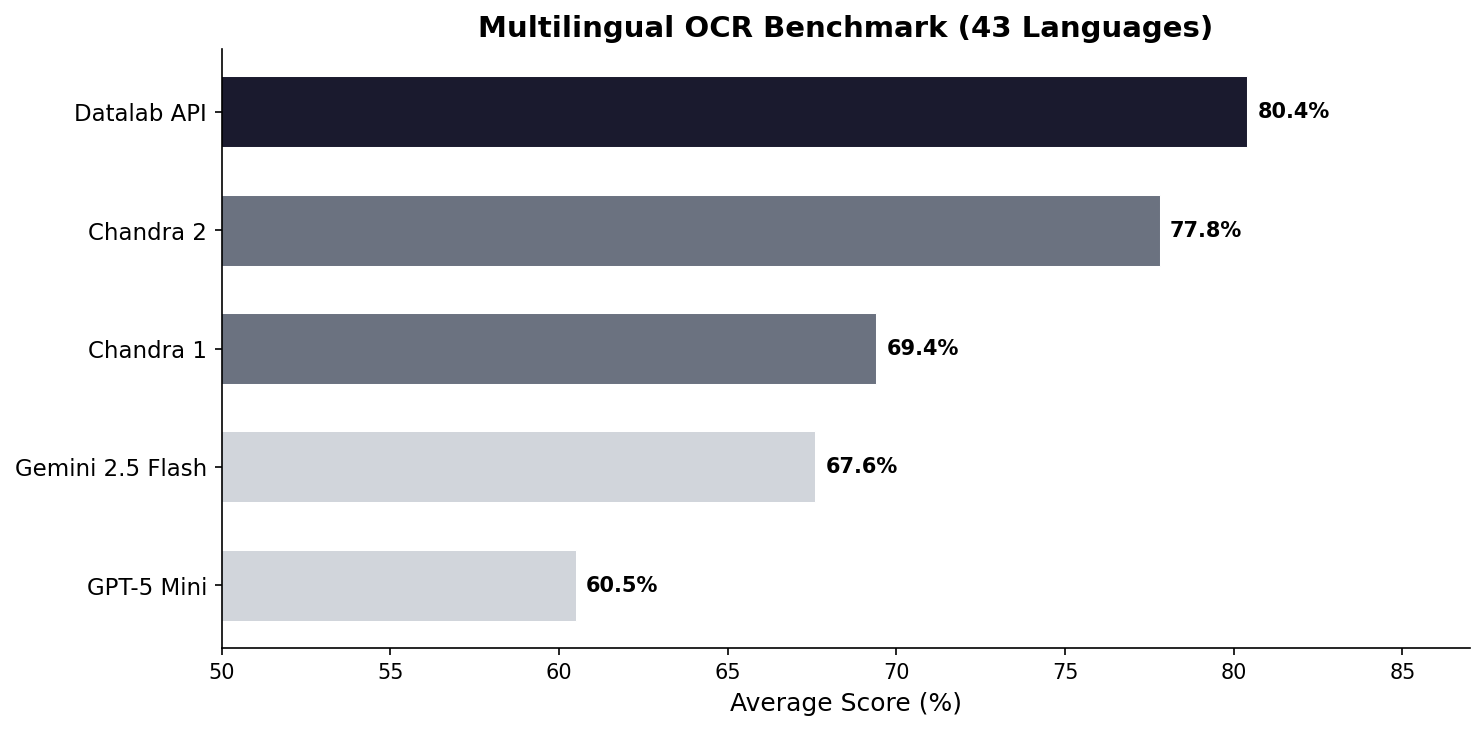
多语言评测:支持 90+ 语言,平均 77.8%,远超 GPT-5 Mini(60.5%)和 Gemini 2.5 Flash(67.6%)。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/datalab-to/chandra |
| Star / Fork | 8,342 / 853 |
| 代码行数 | 1,807(核心 Python 仅 1,347 行,极精简) |
| 项目年龄 | 5.3 个月(2025-10-08 创建) |
| 开发阶段 | 脉冲式迭代(v0.2.0,v2 发布引发第二波爆发) |
| 贡献模式 | 单人主导(Vik Paruchuri 占 93%,3 位贡献者) |
| 热度定位 | 中等热度(8.3K stars),v2 发布单日最高 878 Star |
| 质量评级 | 代码[良好] 文档[良好] 测试[不足] |
作者视角:为什么存在这个项目
创始人/作者背景
Vik Paruchuri(@VikParuchuri,4,206 followers)是 Datalab 创始人,此前创办了在线数据科学教育平台 Dataquest(百万级用户)。他在文档智能领域连续打造了三个爆款项目:marker(33K Star,PDF→MD)、surya(19.5K Star,OCR/布局检测)、chandra(8.3K Star,VLM OCR)。Datalab 已完成 350 万美元种子轮融资,团队位于美国。
问题判断
从 marker 和 surya 的开发过程中,Vik 深刻认识到传统 OCR pipeline 的根本局限:多模块串联(检测→识别→布局→重构)的误差逐级放大。marker 需要先用 surya 做布局检测再做文本提取,链路长、维护复杂。VLM(视觉语言模型)的出现提供了端到端解决方案的可能——用一个模型直接理解整页文档的文本、表格、公式、手写体和空间关系。
解法哲学
「用一个 VLM 端到端替代整个 OCR pipeline」。核心思路:不再分步做检测-识别-布局,而是把整页文档图像直接输入 VLM,让模型一次性输出带布局标注的 HTML。这是「系统简化」的经典案例——用更强大的单一模型消除模块间的信息损失。
设计约束极其精简:整个核心包仅 1,700 行 Python,远低于竞品(PaddleOCR 数十万行)。这不是功能不足,而是刻意的架构选择——将复杂性推入模型本身,代码层只做最薄的胶水。
战略意图
Chandra 是 Datalab「Document Intelligence」产品线的核心模型层。产品矩阵形成完整闭环:surya(底层检测)→ chandra(核心 OCR)→ marker(上层应用)。开源版通过 OpenRAIL-M 许可证的精巧设计——允许研究/个人/小创业公司使用,但禁止与 Datalab API 竞争——既保证了社区活力,又保护了商业护城河。商业 API 准确率更高(86.7% vs 85.9%),自然形成升级路径。
核心价值提炼
创新之处
-
VLM-as-OCR 范式:HTML 作为统一中间表示(新颖度 5/5 | 实用性 5/5 | 可迁移性 4/5) 模型不输出纯文本,而是输出带布局标注的 HTML——每个
<div>包含data-bbox(归一化坐标 0-1000)和data-label(18 种语义标签)。VLM 在预训练中大量接触 HTML,生成 HTML 比自定义格式更自然。布局和内容在同一输出中,避免二次推理。 -
自适应重复 token 检测与渐进温度重试(新颖度 4/5 | 实用性 5/5 | 可迁移性 5/5)
detect_repeat_token()直接回应了 VLM 生成退化问题(Issue #62)。反向缩放阈值(短序列需更多重复才报警)、双位置检查(处理退化后恢复的边缘情况)、渐进温度重试(每次 +0.2,最高 0.8)。这套机制可直接用于任何 VLM/LLM 推理场景。 -
极轻量 vLLM 客户端设计(新颖度 3/5 | 实用性 5/5 | 可迁移性 5/5) vLLM 后端仅依赖
openai库(OpenAI 兼容 API),不需要安装 torch 或 vLLM 本体。base 安装仅 11 个依赖,无 CUDA 要求。客户端可在任何环境运行(甚至 ARM Mac),重型推理交给远程 GPU。 -
Bbox 归一化坐标系(0-1000)(新颖度 3/5 | 实用性 4/5 | 可迁移性 4/5) 所有布局坐标归一化到 0-1000 的整数空间,与输入分辨率解耦。模型只需学习一种坐标体系,
output.py的parse_layout()再根据实际图像尺寸反归一化。 -
GPU 自适应 vLLM Docker 启动器(新颖度 3/5 | 实用性 4/5 | 可迁移性 4/5) 内置 10 种 GPU 的 VRAM 配置表(T4 16GB 到 H100 80GB),自动计算
max_batched_tokens和max_num_seqs。一键chandra_vllm命令拉取并配置 Docker 容器。
可复用的模式与技巧
- 双后端推理门面:
InferenceManager统一 vLLM 和 HuggingFace 两个后端,只负责原始生成,所有后处理在统一层完成。适用于任何多后端 ML 推理项目 - 分层 pip install:base(仅 API 客户端)→ hf(本地推理)→ all(含应用),避免不必要的 PyTorch 安装。ML 项目最佳实践
- VLM 提示词约束:在提示词中明确限定 38 种 HTML 标签和 14 种属性,收窄生成空间。适用于任何需要结构化输出的 VLM 应用
- ThreadPoolExecutor + 渐进重试:线程池并发 API 调用,每个请求独立重试,失败时提高 temperature。适用于批量 API 调用场景
- 图像网格对齐缩放:
scale_to_fit()将图像调整为 28 像素网格对齐(匹配 ViT patch size),像素总量控制在合理范围。适用于任何 VLM 图像输入预处理
关键设计决策
-
HTML 作为中间表示而非自定义格式:VLM 已在预训练中大量接触 HTML,生成 HTML 比学习新格式更自然可靠。HTML 可可靠地转换为 Markdown、JSON 或布局数据。代价是输出冗余(HTML 标签开销),但换来了解析鲁棒性。
-
提示词区分两种模式:
ocr_layout(带 bbox 坐标,用于布局分析)和ocr(纯内容,更快更准)。让用户根据场景选择精度/速度的权衡。 -
OpenRAIL-M 许可策略:代码 Apache-2.0 完全开源,模型权重 OpenRAIL-M 限制竞争使用。精确保护了商业 API 的利益,同时不阻碍研究和小型创业公司使用。
竞品格局与定位
竞品对比矩阵
| 维度 | Chandra 2 | PaddleOCR | tesseract | olmOCR 2 | dots.ocr 1.5 |
|---|---|---|---|---|---|
| 方法论 | VLM 端到端(4B) | 传统 pipeline | 传统引擎 | VLM(7B) | VLM(1.7B) |
| olmOCR 分数 | 85.9% | N/A | N/A | 82.4% | 83.9% |
| 多语言 | 90+ 语言,77.8% | 80+ 语言 | 100+ 语言 | 有限 | 未知 |
| 布局保持 | HTML + bbox | 有 | 无 | 有 | 有 |
| 部署门槛 | 需 GPU(vLLM) | CPU 可用 | 极轻量 | 需 GPU | 需 GPU |
| 代码规模 | 1,700 行 | 数十万行 | 数十万行 | 中等 | 未知 |
| 许可 | Apache-2.0 + OpenRAIL-M | Apache-2.0 | Apache-2.0 | 完全开放 | 未知 |
差异化护城河
- 精度壁垒:4B 参数达到 SOTA,说明微调数据和训练方法的功力——这不是用更大模型堆出来的
- 产品矩阵壁垒:marker/surya/chandra 构成文档处理全栈,上下游数据和经验互相反哺
- 评测数据壁垒:自建 benchmark 和多语言评测数据集,掌握评测标准的话语权
竞争风险
- 部署门槛是最大短板:4B VLM 需要 GPU,消费级显卡(RTX 3060 Ti)性能严重不足(Issue #57),而 PaddleOCR/tesseract 在 CPU 上即可运行
- vLLM 稳定性(重复 token 生成、频繁报错)影响生产可靠性
- 印度语系幻觉问题(Issue #71)暴露多语言能力的长尾缺陷
- PaddleOCR(74.9K Star)的生态规模是 10 倍,在「够用就行」的场景中 VLM OCR 是大材小用
生态定位
VLM-OCR 新范式的领跑者。在传统 OCR(PaddleOCR/tesseract)和通用多模态模型(GPT-4o/Gemini)之间,占据了「专业文档智能 + 端到端 VLM」的独特交叉位置。
套利机会分析
- 信息差: 中等偏高。v2 发布(2026-03-18)引发的第二波增长(单周 +2,800 Star)尚在进行中,中文社区报道较少但增长势头很强
- 技术借鉴: (1) VLM 输出 HTML 作为中间表示的方案可用于任何需要结构化文档理解的场景;(2) 重复 token 检测 + 渐进温度重试可直接用于任何 VLM/LLM 推理;(3) 分层 pip install 是 ML 项目依赖管理的最佳实践
- 生态位: VLM-OCR 新范式的领跑者,填补了传统 OCR 和通用多模态之间的空白
- 趋势判断: VLM 端到端替代传统 pipeline 是文档智能领域的确定性趋势。Chandra 以极精简代码(1,700 行)验证了这一范式的可行性。随着 GPU 成本下降和 vLLM 成熟,部署门槛将持续降低
风险与不足
- 部署门槛高:4B VLM 需要 GPU,消费级显卡性能严重不足(RTX 3060 Ti 上 7 页 PDF 需 19 小时),大量潜在用户望而却步
- vLLM 稳定性:重复 token 生成(#62)、频繁报错(#17)是核心质量问题,虽有重试机制但根本原因在上游
- 测试极其薄弱:仅 1 个集成测试(18 行),
output.py(最复杂模块)和detect_repeat_token(核心可靠性机制)均无测试 - 单人维护:Vik 占 93% commits,bus factor 为 1。脉冲式开发(2 个月空窗期)说明项目优先级随创始人精力波动
- 多语言长尾缺陷:印度语系严重幻觉(#71),90+ 语言的覆盖广度与深度不均
- 模型权重限制:OpenRAIL-M 禁止与 Datalab API 竞争使用,限制了大型企业的商业部署
行动建议
- 如果你要用它: 优先使用 vLLM 后端 + 足够 VRAM 的 GPU(建议 A10 24GB 以上)。
pip install chandra-ocr && chandra input.pdf ./output即可上手。对性能敏感场景考虑 Datalab 商业 API - 如果你要学它: 重点关注
chandra/model/vllm.py(142 行,双后端设计的精简范例)、chandra/output.py(245 行,HTML→Markdown/JSON 的解析管线)、chandra/prompts.py(114 行,VLM 结构化输出的提示词工程)、chandra/model/util.py(101 行,重复 token 检测算法) - 如果你要 fork 它: (1) 为
output.py和detect_repeat_token添加单元测试;(2) 优化消费级 GPU 性能(量化、分片);(3) 改善印度语系等长尾语言的识别质量;(4) 考虑添加流式输出支持
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | deepwiki.com/datalab-to/chandra |
| HuggingFace 模型 | datalab-to/chandra-ocr-2 |
| 官方 Benchmark | datalab.to/benchmark/overall |
| 免费 Playground | datalab.to/playground |
| Discord | discord.gg/KuZwXNGnfH |
| 关联论文 | 无(工程驱动项目) |