10.2k star 的 CocoIndex:两个前 Google 工程师把「增量索引」做成数据工程界的 React
一句话总结
CocoIndex 是为 AI/RAG/agent 构建实时增量数据管道的引擎——核心命题是 Target = F(Source):你只声明「目标状态是源数据的纯函数」,引擎自动推导计算图、算最小工作量,源数据或转换代码一变就只重算受影响的 Δ,免去全量重建(号称任意规模仓库亚秒级新鲜度、re-index 80-90% 命中缓存)。它由两位前 Google 大规模索引/数据基础设施技术负责人打造,Rust 写性能核心 + Python 暴露易用 API,自比「React for data engineering」。
值得关注的理由
- 把 Google 内部「增量索引」经验产品化为开源 infra:Google 的搜索索引几十年前就解决了「一个网页变了不重建整个倒排索引、只重算受影响的 posting」。CocoIndex 本质是把这套工业级增量计算搬到 AI 数据管道——填补了 LlamaIndex「全量重建」与传统 ETL「无 AI 语义」之间的空白,最直接对标 Pathway。
- 「连改代码都能正确失效」是业界少见的技术深度:大多数缓存只按数据变化失效,CocoIndex 用双指纹——源/输入指纹 + 函数 AST 规范化的 code 指纹(改注释/格式/docstring 不误失效,改逻辑才失效),再叠加
detect_change上下文(模型/配置版本),实现「数据、代码、配置三维任一变都精确重算」。这是 80-90% 缓存命中的关键。 - 创始团队与赛道严丝合缝:双前 Google data-infra 技术负责人全职高强度投入(双人占 60% 提交),已从 50+ 个 alpha 打磨到 v1.0 正式版,工程深度(crash 恢复、单写者 batcher、端到端血缘)后来者难短期复刻。
项目展示
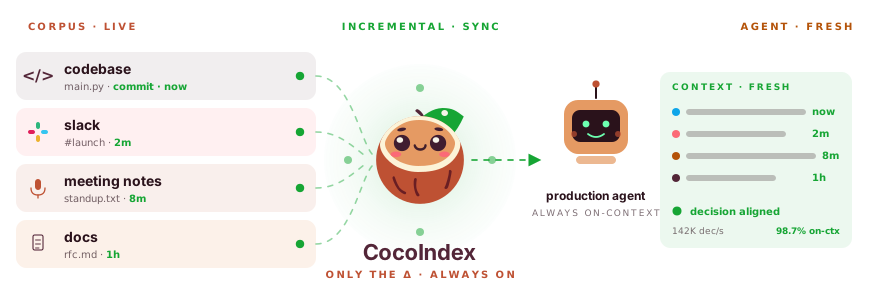 企业语料 → CocoIndex 增量同步引擎 → 生产 AI agent,「只重算 Δ」。
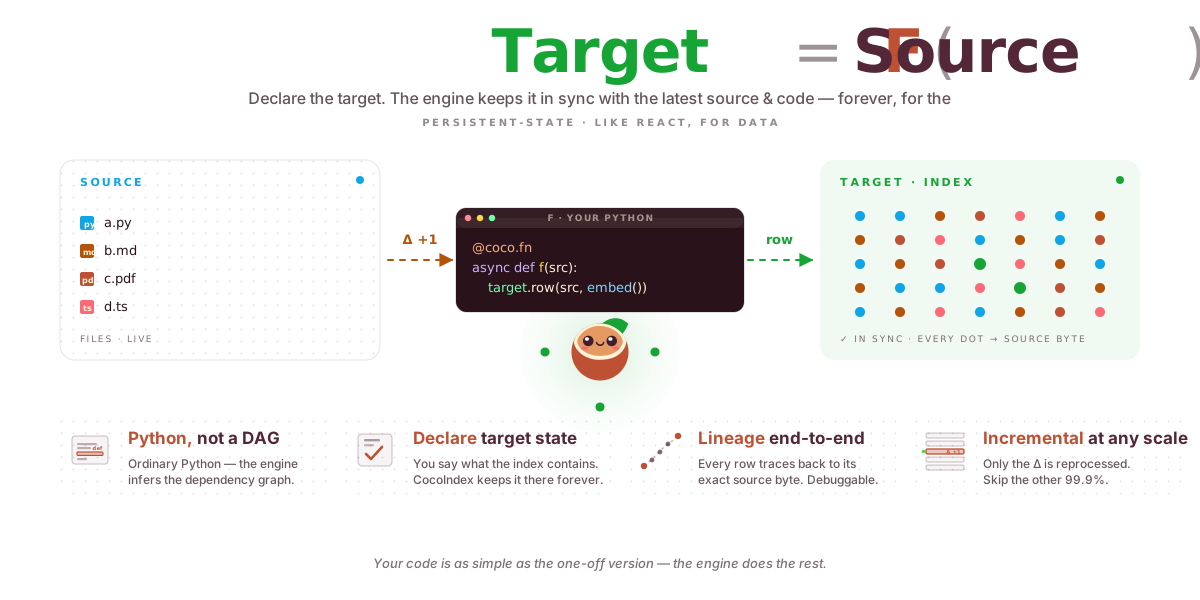 核心范式「React for data engineering / Target = F(Source)」。
媒体为官网托管矢量图,发布前建议复核链接可达性。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/cocoindex-io/cocoindex |
| Star / Fork | 10,219 / 801 |
| 代码规模 | 12.8 万行(Rust 44.3% + Python 41.0% ≈ 1:1,pyo3/maturin 混合);真实分布:Rust 核心引擎 rust/core 仅约 12k 行精炼内核(execution/state_store)+ Rust SDK ~40k + Python SDK ~28k + 30k Python 测试;JSON 8.9% 几乎全是 lock 文件 |
| 项目年龄 | 15.2 个月(2025-03 创建) |
| 开发阶段 | 密集开发(204 tags 月均 13 版超高频,50+ alpha 后已发 v1.0 正式版,latest v1.0.7) |
| 贡献模式 | 团队驱动(双前 Google 创始人占约 60% commits,85 贡献者,无 AI 代写 bot) |
| 热度定位 | 大众热门(高速增长,agent/RAG 数据管道风口) |
| 质量评级 | Rust 核心[优·工业级] Python SDK[优] 测试[良-优·真 DB e2e] CI[优] 文档[优·示例驱动] |
| License | Apache 2.0 |
作者视角:为什么存在这个项目
创始人/作者背景
两位创始人都是前 Google 技术负责人:Linghua Jin(CEO,GitHub badmonster0,前 Google Search/Healthcare 大规模 indexing/data infra,UPenn 硕士,Pear VC 背景)+ Jiangzhou He(georgeh0,前 Google,自定位「Data Infra for AI」)。双人合计约 60% 提交 + 30+ 社区贡献者。这是「前 Google 大规模索引团队把内部增量计算经验产品化为开源 infra」的典型路径,可信度与赛道高度匹配。无公开融资轮次。
问题判断
为 AI/agent/RAG 持续供给「永远新鲜」的上下文:源数据(代码库、PDF、Slack、邮件)一直在变,但把它们变成可检索上下文(chunk→embed→写向量库/图库)传统上是「全量重建」——慢、贵、还会在两次批处理之间留下「上下文鸿沟」。LlamaIndex/LangChain 把「索引」当成一个 loader 步骤,没有引擎级的增量与失效记忆;传统 ETL(dbt/Airflow)有调度但无 AI 语义、增量粒度粗。
解法哲学
①声明式 Target=F(Source):用户写的代码和「一次性脚本」一样简单,引擎负责增量;②双重失效(核心哲学):源变→单点重算,代码变→按 code 指纹失效记忆化结果(区别于一切「只按数据变化失效」的缓存);③Rust 核心 + Python API 的硬边界:性能/正确性关键路径全在 Rust,Python 只是声明层;④明确不做什么:不做推理、不做检索、不做向量库——只做「源→目标」的增量数据管道(自己是连接 8 类源与 6 类目标的「控制平面」)。
战略意图
Open-core:Apache 2.0 开源引擎 + cocoindex.io 商业站 + 旗舰 cocoindex-code(面向 Claude Code/Cursor 的 MCP 代码索引 server,宣称 re-index 80-90% 命中缓存、70% 更少 token)。skills/cocoindex/ 内置一个给 AI coding agent 用的 skill(让 agent 写出正确的 v1 代码)。对抗 LlamaIndex 的方式不是做更大的框架,而是做更底层的「引擎」,让别人在上面建。
核心价值提炼
创新之处
- AST 规范化的 code 指纹做记忆化失效(新颖 4 / 实用 5 / 可迁移 4):
_compute_logic_fingerprint对函数源码做 AST 规范化(ast.parse→剥装饰器/docstring→ast.dump)再哈希——注释/空白/格式/docstring 改动不会误失效,改逻辑才失效;源码取不到退化到字节码哈希。运行时每个 fn 把 logic_fp 注册进全局 registry,命中时校验「这条记忆依赖的所有 code 指纹是否仍存在」——代码改了指纹变、旧依赖不在 registry 即失效。 - Target=F(Source) 声明式 + 持久化 reconcile(React-for-data)(新颖 4 / 实用 5 / 可迁移 3):每个组件有一个从源稳定派生的 StablePath,
process()期间所有declare_*收集进有序表,pre_commit把本轮声明与 LMDB 中上一轮快照做三阶段 diff(reconcile→delete 未命中旧项→bump version),产出对外部系统(向量库/Postgres/图库)的最小写操作——这就是 React 的 reconciliation,只是 diff 一端在内存、一端在 LMDB。 - 倒排 owner 索引 = 端到端血缘 + 目标跨源迁移(新颖 4 / 实用 4 / 可迁移 3):
__target把每个目标项 → 拥有它的组件 StablePath,既是「每个目标可溯源到唯一源组件」的前向血缘,又支撑源项移动时的并发抢占式所有权转移(detection sub-pass 探冲突 + 指数退避重试)。 - memo_states 软校验(廉价签名 vs 昂贵内容解耦)(新颖 4 / 实用 4 / 可迁移 4):命中后还能调用户的 state 函数——mtime 变但内容哈希不变 → 复用产出值、只更新状态元数据,避免重算 embedding。
- EngineProfile 宿主无关泛型核心(新颖 3 / 实用 4 / 可迁移 4):Rust 内核全程对
Prof: EngineProfile泛型,关联类型抽掉一切 host 细节,核心把记忆化 blob 当不透明字节,memo 校验全在 Python 侧;rust/py只是 EngineProfile 的一个 Python 实现——为未来原生 Rust SDK 留路。 - detect_change 上下文并入失效(新颖 4 / 实用 4 / 可迁移 4):
ContextKey(..., detect_change=True)(如 embedder 模型版本)的指纹折进失效逻辑——数据、代码、配置/模型三者任一变都重算。 - 单写者 LMDB batcher + 五阶段 crash-safe 提交(新颖 3 / 实用 4 / 可迁移 4):所有写过单写者 batcher 合并 fsync(宣称 10-100× 并发吞吐),提交分 precommit→sink apply→commit→GC→component memo 五阶段,
pending_process_token+ 多状态项做崩溃恢复。
可复用的模式与技巧
- Flush-plan 模式:先 populate 灌内存→运行期累积→产出「可跨重试重放的序列化 diff」→并入 CommitPlan 原子落盘,把「读改写」与「事务提交」彻底解耦。
- Lazy-decode(Stored→Ready):prefetch 只存 bytes,首次访问才解码;finalize 时按需 decode 被依赖引用的项保护其不被 GC。
- 借用视图避免深拷贝:
Arc<Vec<MemoizedValue<'static>>>+ 每次重试构造Cow::Borrowed视图共享字节。 - OnceLock + deferred-set:副作用缓冲到「不可再重试」点之后才施加。
- Detection sub-pass:在任何 mutation 前先纯读探测冲突 →
PendingRetry让外层零成本重试。 - 持久化不可变结构做廉价克隆:provider registry 用
rpds::HashTrieMapSync,每组件 view O(1) clone。 - client_error vs internal_error 二分:贯穿全栈区分「用户错误」与「引擎 bug」,配 retryable 与 on_error 级联。
关键设计决策
- live_component 实时增量(亚秒级新鲜度):source connector 暴露 LiveMapView(localfs 用 inotify),每个 live 组件有 per-subpath 合并队列(新 op 到来标旧 op
Superseded天然去抖);Delete 同步写 tombstone 即便 handler 抛错也保留重试网;remount 走 cancel_and_drain(每组件 30s 超时),超时则 leak orphan drain、下轮兜底——明确的 liveness over quiescence 取舍。
竞品格局与定位
竞品对比矩阵
| 维度 | CocoIndex | Pathway | LlamaIndex | LangChain | Unstructured |
|---|---|---|---|---|---|
| Star | 10.2k | ~13k | ~43k | ~110k | ~12k |
| 定位 | 增量索引引擎 | 流式增量处理 | RAG 框架 | LLM 编排 | 文档 ingest |
| 引擎级增量 | ✅ Δ-only | ✅ 流计算 | ❌ 全量重建 | ❌ | ❌ |
| code 指纹失效 | ✅ AST | ❌ | ❌ | ❌ | ❌ |
| 端到端血缘 | ✅ owner 倒排 | 部分 | ❌ | ❌ | ❌ |
| AI 语义原生 | ✅ chunk/embed | 通用 | ✅ | ✅ | ✅ 解析 |
| 关系 | 引擎/控制平面 | 直接对标 | 互补(喂数据) | 上层 | 互补(前处理) |
差异化护城河
①双指纹(源 + AST code 指纹)+ detect_change 上下文 = 业界少见的「三维失效」;②StablePath owner 倒排索引带来的真·端到端血缘;③Rust 内核 + EngineProfile 的工程深度(crash 恢复、单写者 batcher、抢占协议)后来者难短期复刻;④28 个示例 + AI-coding-agent skill 的「让 agent 帮你写对」分发策略。
竞争风险
- Pathway 正面竞争:若补上 code-aware 失效与声明式索引语义可正面交锋。
- 上游框架挤压:LlamaIndex/LangChain 若把「增量索引」做成一等公民会从上层挤压。
- 教育成本高:「下层引擎」要用户理解 component path / target state 心智模型。
- 生产化短板:CHANGELOG 缺失(#2023)、统一超时(#2054)、crates.io 未发布、原生 Rust SDK 未完。
生态定位
AI 数据栈的「增量索引控制平面」——卡在「源连接器」与「向量/图/仓库目标」之间,靠细粒度增量 + 血缘 + Python 声明式差异化,open-core + MCP(cocoindex-code)双轮驱动。与 LlamaIndex(喂数据)、Unstructured(前处理)互补而非替代。
套利机会分析
- 信息差:题材正当 agent/RAG 实时数据管道风口,作者背景过硬、已 v1.x、增长加速,且
cocoindex-code(MCP server)外溢成生态——属仍在上升期、值得现在介入的标的,传播叙事现成(「React for data engineering」「Δ-only 增量索引」)。 - 技术借鉴:双指纹失效(源 + AST code 指纹)、detect_change 三维失效、StablePath 持久化 reconcile、倒排 owner 血缘、flush-plan 模式、EngineProfile 宿主无关核心——这些脱离索引场景,对任何「增量构建/缓存系统」「特征平台」「CDC 同步」「需溯源的数据资产」都直接可抄。
- 生态位:填补「细粒度增量 + 端到端血缘 + AI 语义原生」的数据索引引擎空白。
- 趋势判断:踩中 AI 数据新鲜度刚需,前 Google 背景 + Rust 工程深度是壁垒;最大变数是用户教育成本与 Pathway 的正面竞争。
风险与不足
- 教育成本高:要理解 component path / target state 等下层引擎心智模型。
- 生产化短板:CHANGELOG 缺失、统一超时机制在做、原生 Rust SDK 未完、crates.io 未发布(Rust 核心目前仅经 Python 包分发)。
- 正面竞争:Pathway 是成熟流式增量引擎,正面交锋压力大。
- 少量 PyO3 边界语义损失(如
Superseded被并入Executed,代码注释已自陈)。 - 商业化早期:无公开融资轮次,open-core 变现路径待验证。
行动建议
- 如果你要用它:你在构建 RAG / 长程 agent / coding agent、需要数据源变化时实时增量更新索引(而非全量重建)——CocoIndex 是当前最贴合「细粒度增量 + 血缘」的引擎,
pip install cocoindex起步,先跑 28 个示例。要通用流计算选 Pathway;要 RAG 上层框架选 LlamaIndex(可与 CocoIndex 互补:CocoIndex 喂数据、LlamaIndex 检索);只要文档解析选 Unstructured。 - 如果你要学它(最高价值路径):精读
rust/core/src/engine/execution.rs(reconcile + 五阶段提交)、context.rs(记忆化缓存 + flush-plan)、python/cocoindex/_internal/function.py的_compute_logic_fingerprint(AST code 指纹)、target_state.rs(倒排 owner 血缘)、live_component.rs(实时增量)。这套增量引擎工程是脱离场景的通用财富。 - 如果你要 fork/借鉴它:最值得搬走的是双指纹失效、flush-plan 模式、EngineProfile 宿主无关核心这几套通用工程,搬到你自己的增量构建/缓存/特征平台。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 已收录(12 章:架构/编程模型/内置函数/存储后端/示例) |
| Zread.ai | 未确认(直连 HTTP 403) |
| PyPI | cocoindex v1.0.7(Python ≥3.11,主分发渠道) |
| crates.io | 未发布(Rust 核心统一经 Python 包分发,原生 Rust SDK 开发中) |
| 官网 / 博客 | https://cocoindex.io |
| 关联论文 / 在线 Demo | 无论文;以 examples/(28 个双语示例)+ cocoindex-code MCP server 作可运行体验 |